Примечание автора: команда, которая одновременно работает с OpenAI, Claude, Gemini и Qwen, может в одном аккаунте разделить токены по проектам, задать каждому токену лимит, срок действия, белый список моделей и группу, а затем сверять расходы по журналу токенов.
Руководитель разработки, который подключает модели нескольких провайдеров, обычно сталкивается с тремя проблемами. Первая — ключи разбросаны по кабинетам разных вендоров, и сложно понять, у кого какой ключ. Вторая — в конце месяца счёт не сходится с проектами: непонятно, сколько потратил каждый проект. Третья — когда один ключ используют несколько человек, чтобы отключить одного сотрудника, приходится аннулировать весь ключ. В этой статье рассказано про один аккаунт APIYI + токены, разделённые по проектам: подход, который переводит управление несколькими моделями в компании в конкретные шаги настройки.
Это не очередной ликбез на тему «зачем нужен сервис-прокси API». Каждый пункт настройки ниже соответствует описанию токенов и групп в документации APIYI apiyi.com. Все цифры, касающиеся лимитов скорости и групп, будут с пометкой, что взяты из текста документации.
Что это даёт: после прочтения вы сможете создать для каждого проекта отдельный токен, ограничить, сколько он может потратить, как долго действует, какие модели может вызывать и через какую группу работает, а также увидеть расходы каждого проекта в журнале токенов.
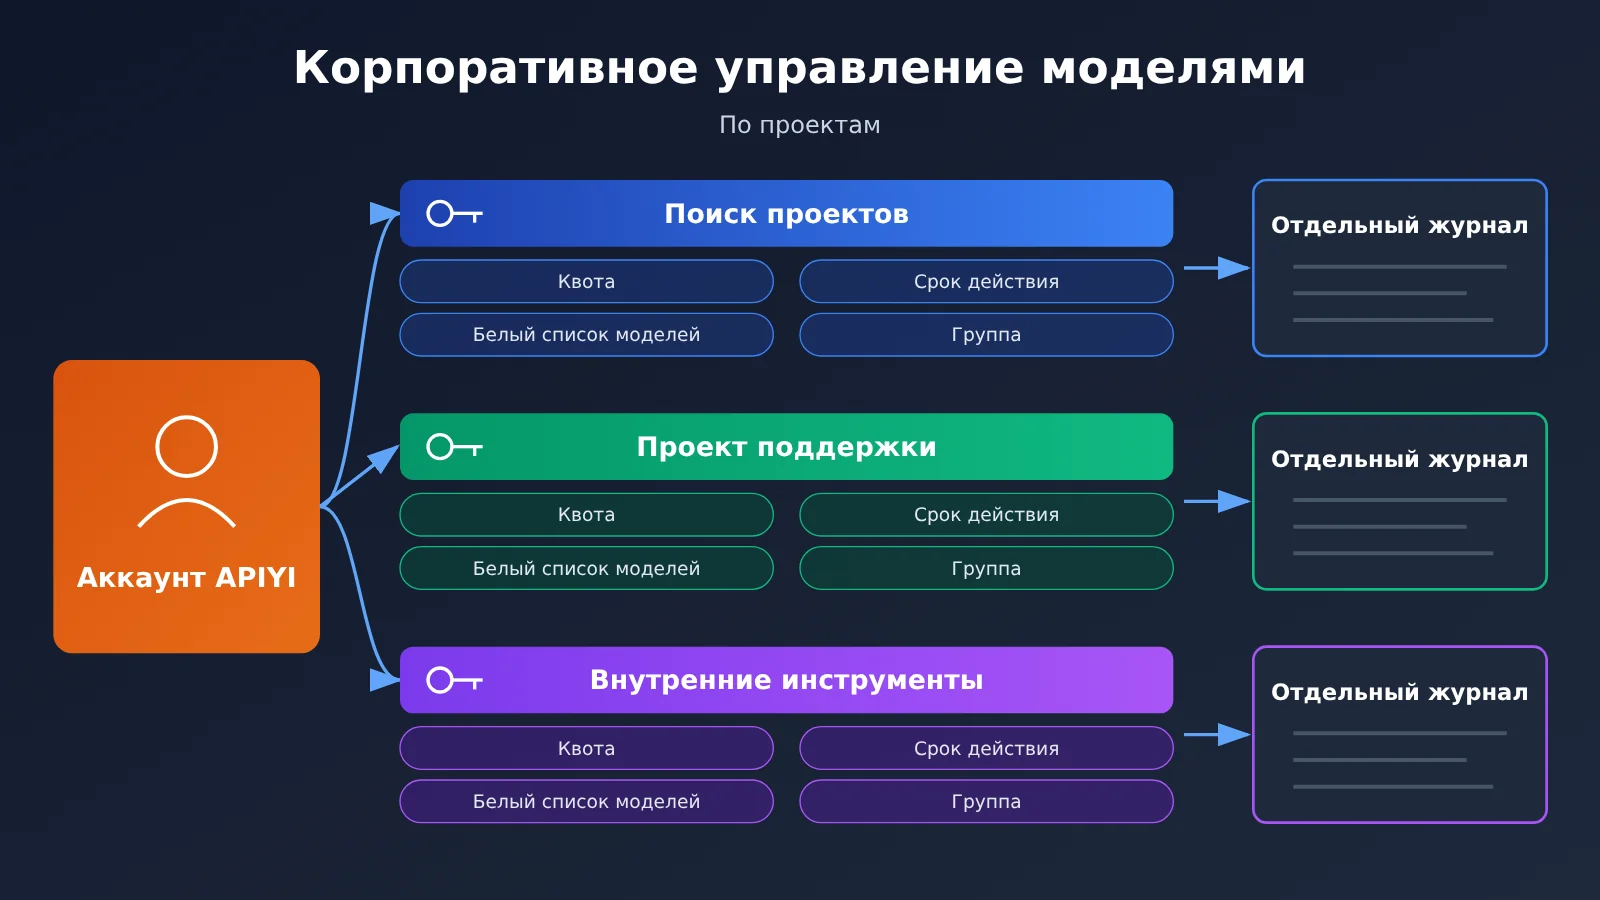
Ключевые моменты управления несколькими моделями в компании: ключи, квоты и логи по отдельным проектам
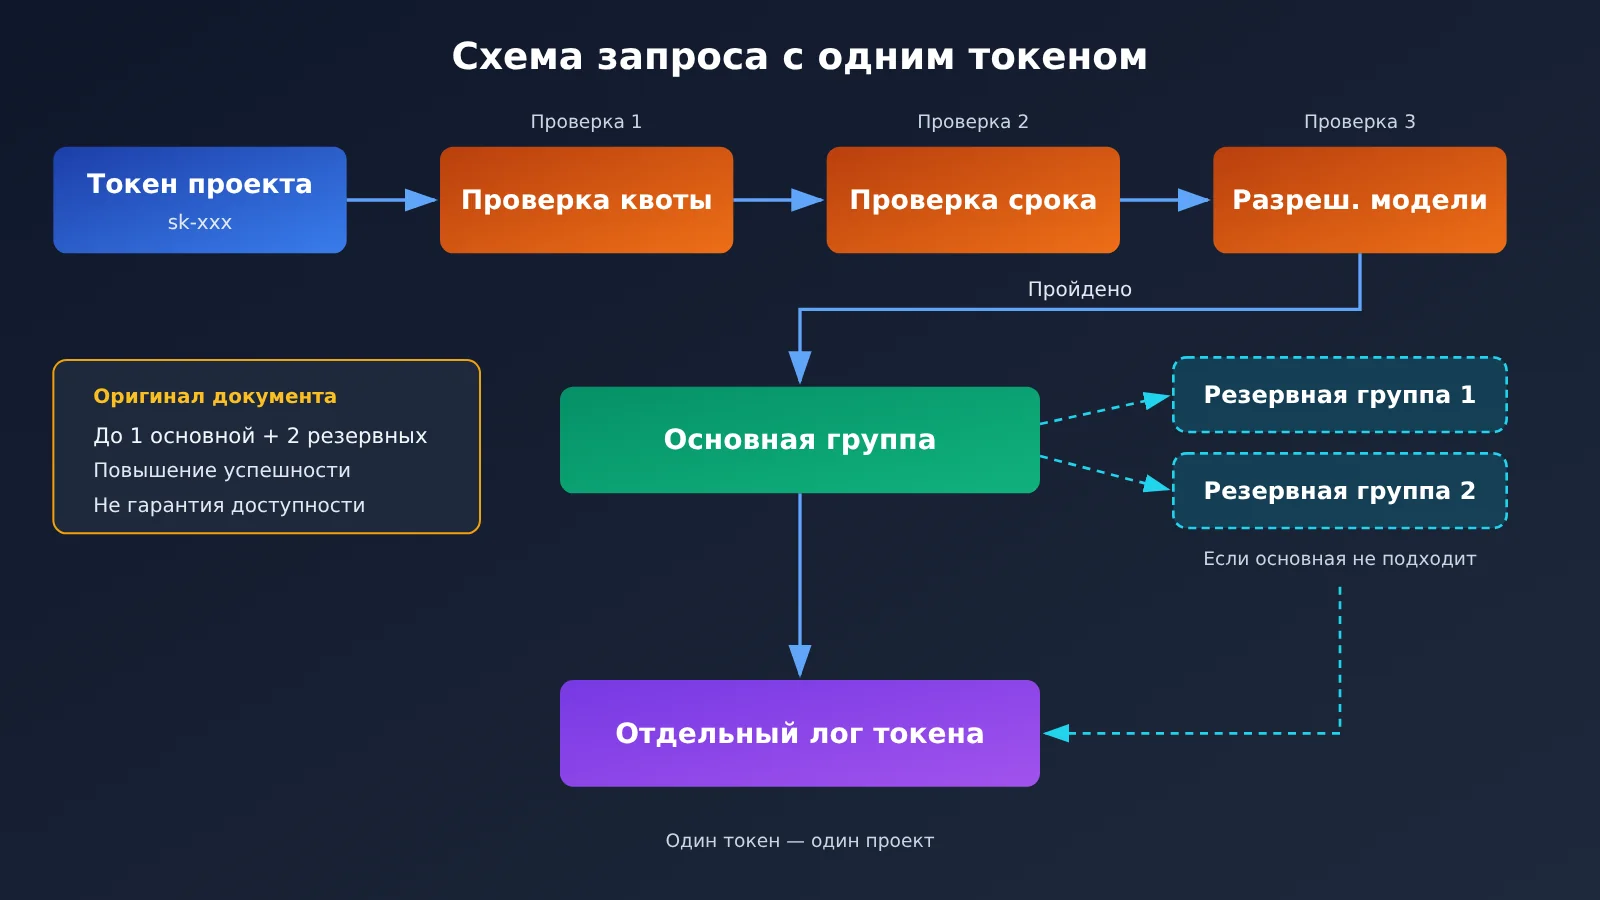
Главное в управлении несколькими моделями в компании — разделить границы управления, а не собирать всё в один универсальный ключ. В APIYI токен — это API-ключ, он начинается с sk-. В документации указано, что для каждого токена можно отдельно задать квоту, срок действия, доступные модели и группу; расход, остаток квоты и журнал вызовов тоже ведутся отдельно.
| Пункт | Описание | Ценность для руководителя разработки |
|---|---|---|
| Создавайте токены по проектам | После регистрации автоматически создаётся один токен по умолчанию; затем можно создавать отдельные токены для разных проектов и участников | Отключение конкретного человека или проекта не влияет на остальных вызывающих |
| Отдельные квоты и срок действия | Для каждого токена можно задать лимит квоты и срок истечения | Можно заранее ограничить перерасход бюджета и окончание срока у подрядчиков |
| Белый список моделей | Если белый список не задан, доступны более 200 отобранных моделей всей платформы (по документации); после настройки — только указанные модели | Защита от самовольного переключения проекта на дорогую модель |
| Группа определяет канал и множитель | Группа определяет upstream-провайдера, доступные модели и коэффициент тарификации | Одна и та же модель в разных группах может давать разный фактический счёт |
| Логи разделены по токенам | Расход и журнал вызовов каждого токена просматриваются отдельно | В конце месяца сверка сразу привязывается к проектам |
Почему при управлении несколькими моделями на предприятии токены разделяют по проектам
Сразу стоит прояснить один момент: когда один токен используют несколько человек, лимит скорости привязан к аккаунту, а не к количеству токенов. В документации сказано, что для одного аккаунта обычно нет проблем в пределах 100 RPM, а TPM не учитывается. Это формулировка из документации, а не результат нагрузочного теста и не SLA.
Поэтому смысл разделения токенов не в том, чтобы обойти лимит скорости, а в управленческой изоляции. Один токен — один проект или один участник: если что-то пошло не так, можно остановить только этот токен, а при разборе расходов — смотреть только по нему. Если все используют общий токен по умолчанию, расход в логах смешивается: его не разделить по проектам и нельзя точечно отключить конкретного вызывающего.
Группы и правила резервирования в управлении несколькими моделями на предприятии
Группа — это канал доступа к ресурсам. Согласно документации, для одного токена можно настроить не более одной группы по умолчанию и двух резервных групп. Резервирование означает: если группа по умолчанию не может удовлетворить запрос, система автоматически переключается на резервную группу. В документации резервирование описано как «повышение вероятности успешного вызова», а не гарантия доступности, поэтому не стоит понимать это как «никогда не падает».
Для подавляющего большинства текстовых моделей достаточно группы Default. Для эксклюзивных моделей, например видео, нужно выбирать отдельную группу; если в токене этой группы нет, соответствующую модель вызвать не получится. Также обратите внимание: «200+ моделей» — это общее число отборных моделей на сайте, а не значит, что каждая модель находится в группе Default. Ориентируйтесь на группу, указанную на странице конкретной модели.
Быстрый старт: управление несколькими моделями в компании — 5 шагов к токенам по проектам
Ниже — пример команды с тремя проектами: поиск с расширением, чат-бот поддержки и внутренний инструмент для написания текстов. На нём покажем весь процесс настройки. Всё делается на странице токенов: https://api.apiyi.com/token.
Шаг 1. Планируем токены: один проект или один человек — один токен
Сначала составьте таблицу планирования токенов, а уже потом идите в панель управления создавать их. Так вы не будете придумывать на ходу и переделывать, а в итоге не вернётесь к схеме «один ключ на всех».
| Имя токена | Кто использует | Белый список моделей | Группа по умолчанию | Резервная группа | Рекомендации по лимиту и сроку действия |
|---|---|---|---|---|---|
proj-search |
Сервис с расширенным поиском | gemini-3.8-flash, qwen3.8-max |
Default |
Настраивается из доступных групп на странице модели | Лимит под месячный бюджет, бессрочный |
proj-support |
Чат-бот поддержки | claude-sonnet-5-5 |
Default |
Настраивается из доступных групп на странице модели | Лимит под месячный бюджет |
team-writing-zhang |
Личный инструмент участника | claude-opus-5-5 |
Default |
Не задаётся | Небольшой лимит, задать срок истечения |
vendor-outsource |
Аутсорсинговая команда | Только модели, необходимые для сдачи проекта | Default |
Не задаётся | Лимит и срок действия совпадают с договором; по истечении отключается автоматически |
Рекомендации по управлению в таблице — это наше мнение. Какие группы доступны для конкретной модели, смотрите на странице этой модели, не копируйте таблицу один в один.
Шаг 2: создайте токен и настройте четыре ограничения
При создании нового токена на странице токенов последовательно заполните четыре пункта:
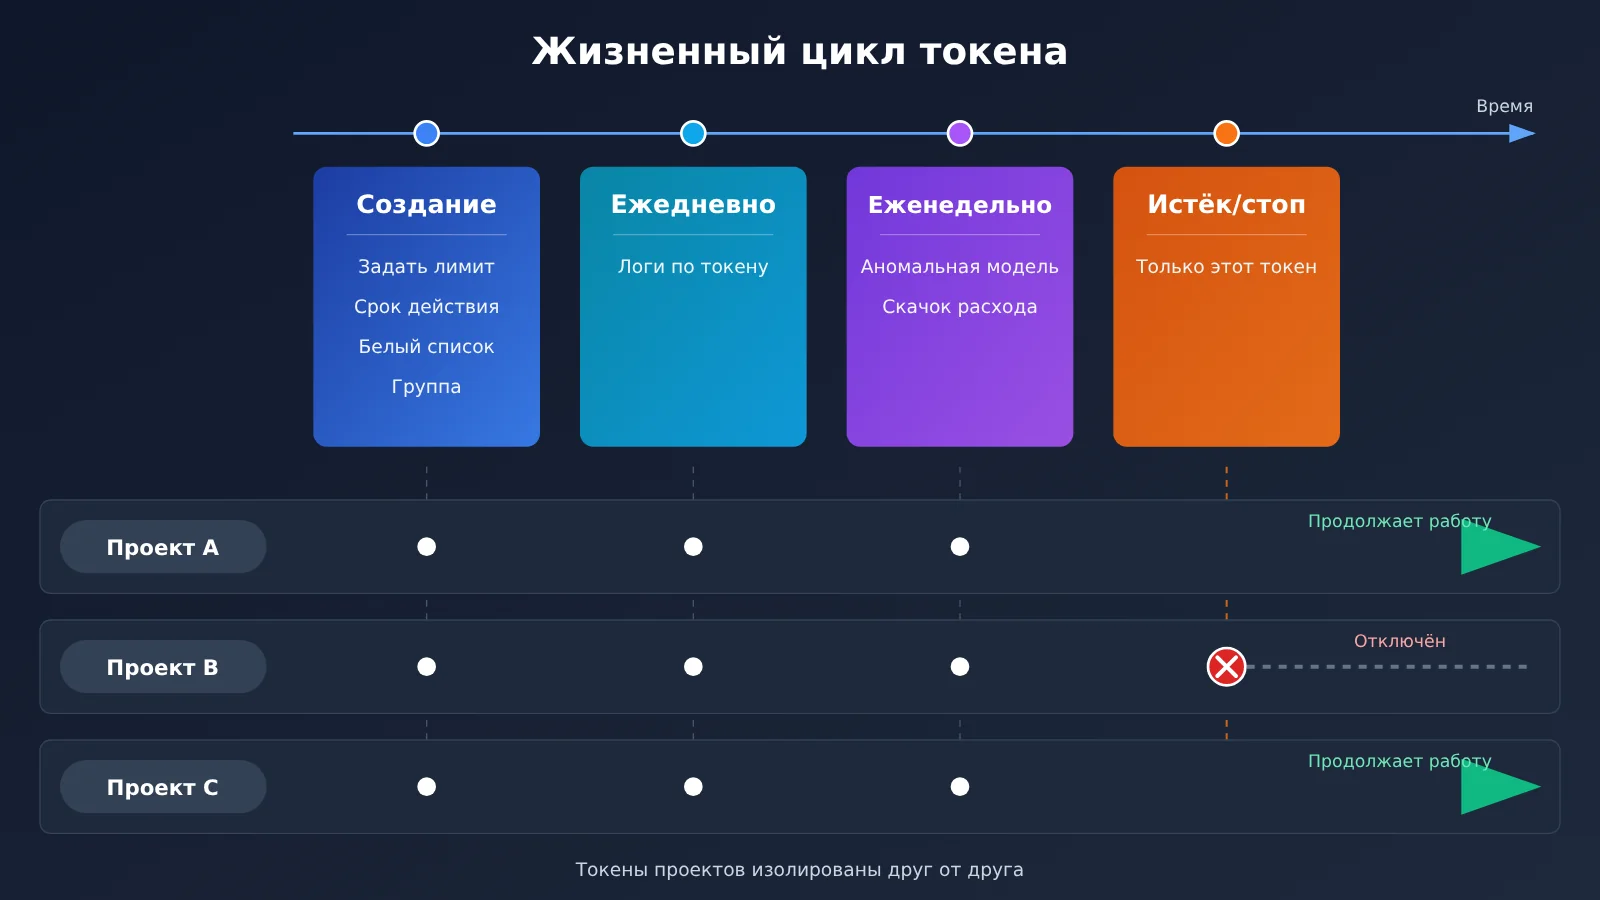
- Квота: укажите её исходя из месячного бюджета проекта. Когда квота закончится, с этого токена перестанут списываться средства, а другие токены продолжат работать как обычно.
- Срок действия: для подрядчиков и временных участников его обязательно нужно устанавливать — после истечения срока отзывать токен вручную не придётся.
- Доступные модели (белый список): отмечайте только те модели, которые действительно нужны проекту. Если поле не заполнить, это фактически откроет доступ ко всем моделям сайта — так лучше не делать.
- Группа: сначала выберите группу по умолчанию, а затем при необходимости добавьте до 2 резервных групп.
Шаг 3: поместите ключ в переменные окружения и задайте отдельные имена переменных для каждого проекта
Ключ не стоит жёстко прописывать в коде или репозитории. Рекомендуется для каждого проекта использовать отдельное имя переменной окружения: например, в среде развёртывания задать APIYI_KEY_SEARCH=sk-... и APIYI_KEY_SUPPORT=sk-..., а затем читать их в соответствующем сервисе. Так при ротации ключа для одного проекта достаточно будет изменить одну переменную.
Шаг 4: Вызов через OpenAI-совместимый интерфейс
APIYI предоставляет OpenAI-совместимый интерфейс. Для подключения достаточно изменить всего два параметра:
base_url— укажитеhttps://api.apiyi.com/v1api_key— читайте из собственной переменной окружения проекта, напримерos.environ["APIYI_KEY_SEARCH"]
При использовании официального Python SDK всё сводится к одной строке инициализации: client = OpenAI(api_key=os.environ["APIYI_KEY_SEARCH"], base_url="https://api.apiyi.com/v1"). Дальше можно вызывать client.chat.completions.create(model="gemini-3.8-flash", messages=[...]). Если подставить в model модель вне белого списка, этот токен не сможет выполнить вызов. Именно такого эффекта и добивается белый список.
Шаг 5: Раз в неделю проверяем журнал токенов, в конце месяца сверяем по токенам
Расход, остаток лимита и журнал вызовов для каждого токена можно просматривать отдельно. Рекомендую раз в неделю смотреть журналы всех токенов и обращать внимание на две вещи: не появились ли неожиданные модели и не взлетела ли резко кривая расхода. В конце месяца сводим данные по токенам — так получаем затраты в разрезе проектов.
🎯 Технический совет: при первом внедрении советую сначала отключить токен по умолчанию или оставить его только администратору, а затем на странице токенов APIYI apiyi.com создавать их одну за другой по таблице планирования выше. Так с первого дня все вызовы в журнале будут привязаны к конкретному проекту.
Счёт за управление множеством моделей на предприятии: сменил модель — изменился счёт
Самое лёгкое, что упускают команды с несколькими моделями: меняешь модель, меняешь группу — и счёт меняется вместе с ними. Цены ниже взяты из сводной таблицы моделей APIYI, это базовые цены за миллион токенов по умолчанию, данные обновлены 2026-11-16 09:39 (UTC+8).
| ID модели | Цена ввода | Цена вывода | Чтение кэша | Эндпоинты / группы по документации | Доступные платформы |
|---|---|---|---|---|---|
claude-opus-5-5 |
$4 | $20 | $0.2 | эндпоинты chat и messages | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | по странице модели | APIYI |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | эндпоинты chat и messages; группы ClaudeCode, Default, SVIP | APIYI |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse с множителем 0.5×, Default и SVIP — 1× | APIYI |
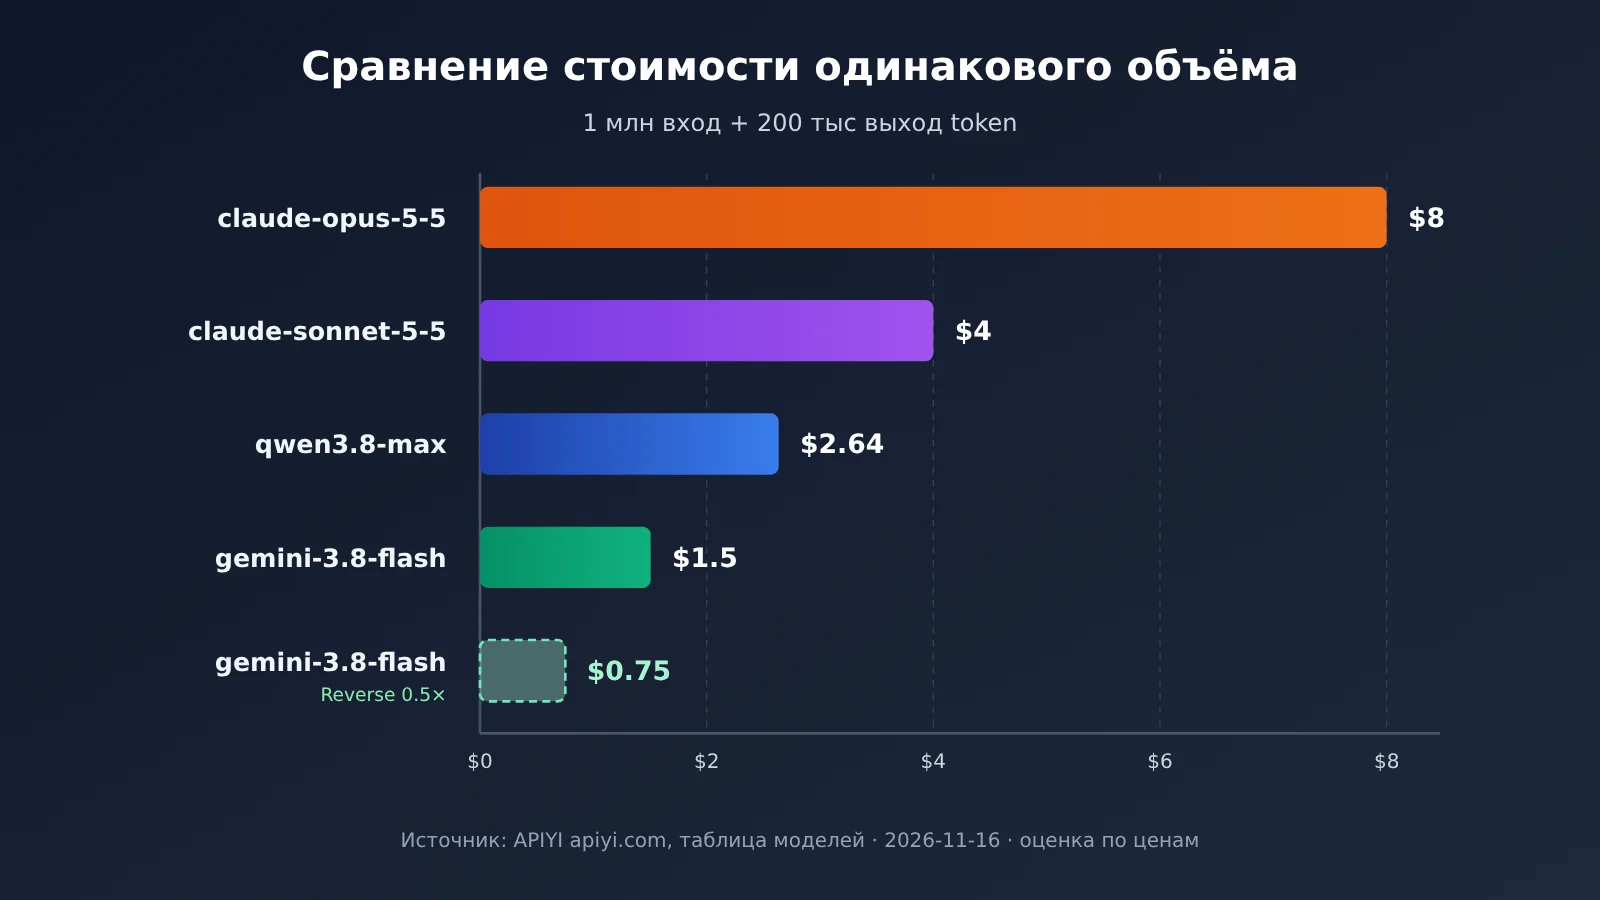
Согласно документации, формула оплаты по факту использования такая: токены ввода × цена ввода + токены вывода × цена вывода. Предположим, проект ежемесячно расходует 1 млн токенов ввода и 200 тыс. токенов вывода — вот оценка по базовым ценам:
claude-opus-5-5: 4 + 0.2 × 20 = $8claude-sonnet-5-5: 2 + 0.2 × 10 = $4qwen3.8-max: 1.65 + 0.2 × 4.95 = $2.64gemini-3.8-flash(Default, 1×): 0.75 + 0.2 × 3.75 = $1.5; если идти через Gemini_Reverse (0.5×), с пересчётом по множителю получится примерно $0.75
Видно, что при одном и том же объёме работы смена модели даёт разницу в стоимости в несколько раз, а смена группы напрямую меняет фактическое списание. Так что белый список и группы для токена — это, по сути, установка верхнего предела цены за проект. Когда проверяете модель и цену, ориентируйтесь на список моделей на APIYI apiyi.com. Сначала确认 — точнее, сначала уточните, в каких группах состоит модель и какой у неё множитель, а уже потом добавляйте её в соответствующий токен. Адрес для вызовов везде один — https://api.apiyi.com/v1: при смене модели достаточно поменять параметр model, base_url менять не нужно.
Если команда оценивает только что выпущенную модель, например qwen4-max, которую Alibaba Cloud выпустила 2026-11-16, учтите: её пока нет в сводной таблице, и в интерфейсе цен платформы она тоже не находится. Модель ещё не размещена, мы добавим её в ближайшее время; модель и цена — по списку моделей платформы. До размещения не вписывайте её ни в какие планы по белому списку токенов.
Модели тарификации при управлении парком моделей в компании: не смешивайте оплату по объёму и оплату по запросам
В документации для текстовых моделей рекомендуется «оплата по объёму в приоритете». Оплата по запросам — это фиксированная цена за каждый запрос, и применяется она в основном к изображениям и видео. Если один и тот же токен используется и для текста, и для генерации картинок, в логах появятся записи сразу двух видов: тарификация по токенам и тарификация по запросам. Единицы измерения у них разные, складывать их в лоб нельзя.
Надёжнее поступить так: для текстовых проектов и для проектов с генерацией изображений и видео создавать отдельные токены. Для видео и других эксклюзивных моделей отдельная группа нужна и так, а после разделения и настройка групп, и единицы в счетах выглядят куда понятнее.
| Способ тарификации | Как считается (формулировка из документации) | Типичное применение | Рекомендация по разделению токенов |
|---|---|---|---|
| По объёму | входные токены × цена входа + выходные токены × цена выхода | текстовые диалоги, код, резюме | отдельный токен для текстового проекта, в документации рекомендуется приоритет оплаты по объёму |
| По запросам | фиксированная цена за каждый запрос | генерация изображений и видео | отдельный токен для изображений / видео плюс соответствующая эксклюзивная группа |
Что касается расчётов: в документации указано, что пополнение идёт по фиксированному курсу 1:7 и это можно совмещать со скидками на пополнение, а фактические списания смотрите в консоли. Процедуры закупки, договоры и счета в рамки этой статьи не входят — если нужно, уточняйте напрямую у платформы.
💡 Совет по выбору: для дорогих моделей (например,
claude-opus-5-5) создайте отдельный токен с небольшим лимитом и выдавайте его только тем, кому он действительно нужен. А в токене для повседневных массовых задач держите только недорогие модели. На APIYI apiyi.com сначала сверьте группы и коэффициенты по списку моделей, и только потом распределяйте — так вы избежите неожиданного счёта в конце месяца.
Частые вопросы о управлении множеством моделей в компании
Вопрос 1: Что такое управление множеством моделей в компании с разбивкой токенов по проектам?
Это когда в рамках одного аккаунта для каждого проекта или сотрудника создаётся отдельный API-ключ (токен), у каждого свои квота, срок действия, белый список моделей и группа. Расход и логи вызовов ведутся отдельно по каждому токену — поэтому отключение и сверка делаются точно до проекта.
Вопрос 2: Если создать много токенов, ограничение скорости удвоится?
Нет. В документации прямо сказано: ограничение скорости привязано к аккаунту и не зависит от количества токенов. В документации написано, что для одного аккаунта обычно нет проблем в пределах 100 RPM, TPM не проверяется. Это лишь то, что написано в документации, а не SLA. Разделение токенов нужно для управленческой изоляции, а не для повышения квоты.
Вопрос 3: Если настроены резервные группы, сбоев уже не будет?
Нет. По документации, у одного токена может быть максимум 1 группа по умолчанию плюс 2 резервные группы; резервная группа автоматически переключается, когда группа по умолчанию не может выполнить запрос, и это повышает вероятность успешного вызова. На стороне бизнес-логики всё равно должны оставаться повторные попытки и деградация.
Вопрос 4: Что будет, если не задать белый список моделей?
В документации сказано: если белый список не задан, токен может использовать все 200+ отобранных моделей на платформе. С точки зрения управления это довольно рискованно — проект может случайно переключиться на дорогую модель. В корпоративных сценариях рекомендуется включать в каждый токен только те модели, которые проекту действительно нужны.
Вопрос 5: У меня уже есть код с OpenAI SDK — как переделать его на вызовы по токенам проектов?
Нужно изменить всего два места: задать `base_url` равным `https://api.apiyi.com/v1` и изменить `api_key` так, чтобы он читался из собственной переменной окружения проекта. Токен создаётся на странице токенов в APIYI apiyi.com; для смены модели достаточно поменять параметр `model`.
Вопрос 6: Почему какая-то видеомодель не вызывается с моего токена?
Видео и другие специализированные модели требуют отдельной группы. Если в токене эта группа не настроена, модель будет недоступна. Посмотрите на странице этой модели, к какой группе она относится, и добавьте её в настройки групп токена; можно также создать отдельный токен для видеонаправления.
Вопрос 7: Почему за одну и ту же модель разные проекты списывают разные суммы?
Обычно это из-за разных коэффициентов групп. Например, на странице модели `gemini-3.8-flash` указано, что коэффициент группы Gemini_Reverse равен 0.5×, а Default и SVIP — 1×. При сверке нужно проверять модель и группу вместе, а не смотреть только на прайс-лист.
Вопрос 8: Какие есть ограничения у такого подхода?
Разделение токенов решает задачу изоляции ключей, квот и логов, но не повышает ограничение скорости аккаунта и не заменяет повторные попытки и мониторинг на стороне бизнеса. Новые модели нужно ждать, пока их добавят на платформу, прежде чем включать в белый список. Конкретные цены и группы — на странице моделей APIYI apiyi.com.
Ключевые выводы по управлению несколькими моделями в компании
- Токен — это ключ: он начинается с
sk-; создавайте отдельный токен для каждого проекта или сотрудника, чтобы можно было отключать их по отдельности. - Четыре ограничения задавайте вместе: квоту, срок действия, белый список моделей и группу. Пропустите хотя бы одно — и в управлении останется лазейка.
- Ограничение скорости привязано к аккаунту: в документации указано, что в пределах 100 RPM обычно проблем нет, а TPM не учитывается; разделение токенов не увеличивает квоту.
- Страховка — не гарантия: максимум 1 группа по умолчанию + 2 резервные группы (по документации). Их задача — повысить вероятность успешного вызова.
- Смена модели меняет счёт: фактическое списание определяют цена за единицу модели и множитель группы. Сверка по токенам делает картину понятнее.
- Текст и генерацию изображений учитывайте раздельно: у оплаты по потреблению и за вызов разные единицы, поэтому отдельные токены упрощают сверку.
- Единая точка входа: все проекты работают через
https://api.apiyi.com/v1, а права и счета различаются только токенами.
Итог
Для управления несколькими моделями в компании не нужен универсальный ключ, открывающий панели всех вендоров. Достаточно разделить права по проектам:
- Токены — по проектам: один токен на проект или сотрудника. Отключение и ротация не влияют друг на друга.
- Ограничьте квоту и модели: квотой контролируйте общий расход, а белым списком и группами — цену за единицу.
- Сверяйте журналы по токенам: раз в неделю проверяйте аномалии, в конце месяца суммируйте затраты по каждому токену.
Совет: сначала составьте таблицу планирования токенов, как в первом шаге этой статьи, а затем создайте каждый токен на странице токенов APIYI (apiyi.com). При сверке моделей, цен и групп ориентируйтесь на список моделей платформы — так вы за один раз наведёте порядок в счетах за несколько моделей.
📚 Справочные материалы
-
Центр документации APIYI: токены и группы, режимы тарификации, сводная таблица моделей
- Ссылка:
docs.apiyi.com - Описание: соответствуют путям
/faq/token-and-groups.md,/faq/token-billing-modes.md,/models.md,/models/gemini-3-8-flash.md; информация о токенах, группах и ценах в этой статье приводится по этим источникам.
- Ссылка:
-
Описание Qwen4-Max от Alibaba Cloud Bailian: информация от производителя
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max - Описание: модель была выпущена производителем 2026-11-16; статус размещения на платформе уточняйте в списке моделей.
- Ссылка:
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI; подробные инструкции по настройке токенов и групп можно найти в центре документации.