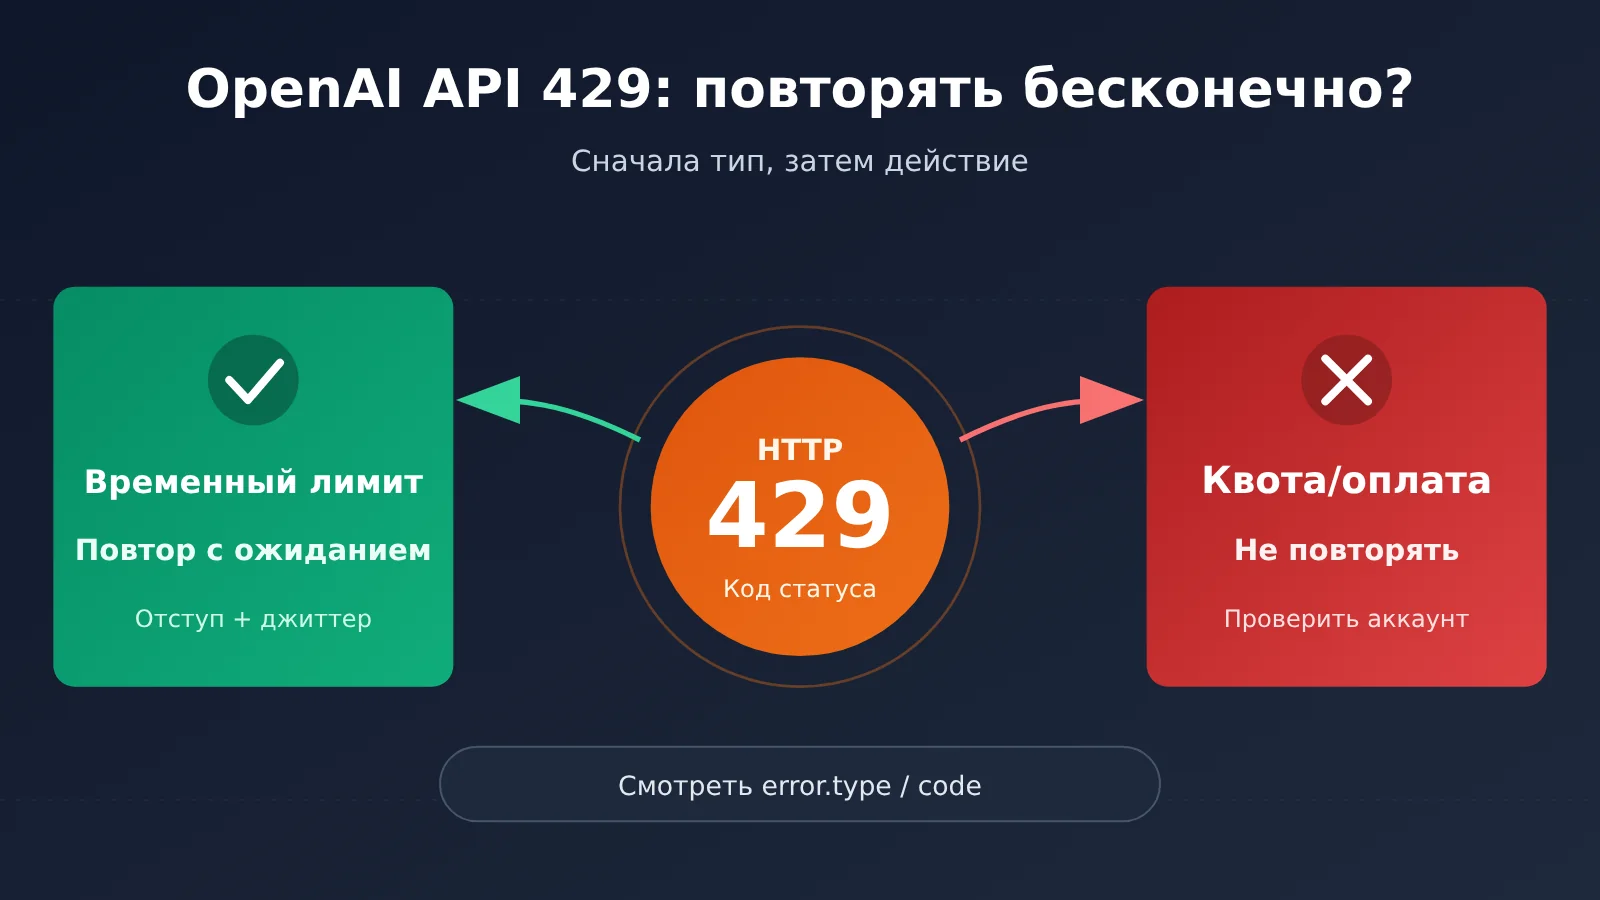
Не надо повторять до бесконечности. Ответ 429 от OpenAI API — это не значит «сейчас чуть подождём, и всё наладится». Повтор с ожиданием уместен только для временного ограничения скорости. Исчерпанная квота, сбой биллинга или ограничения на уровне организации сами не восстановятся — сколько ни повторяй, вы только забьёте очередь.
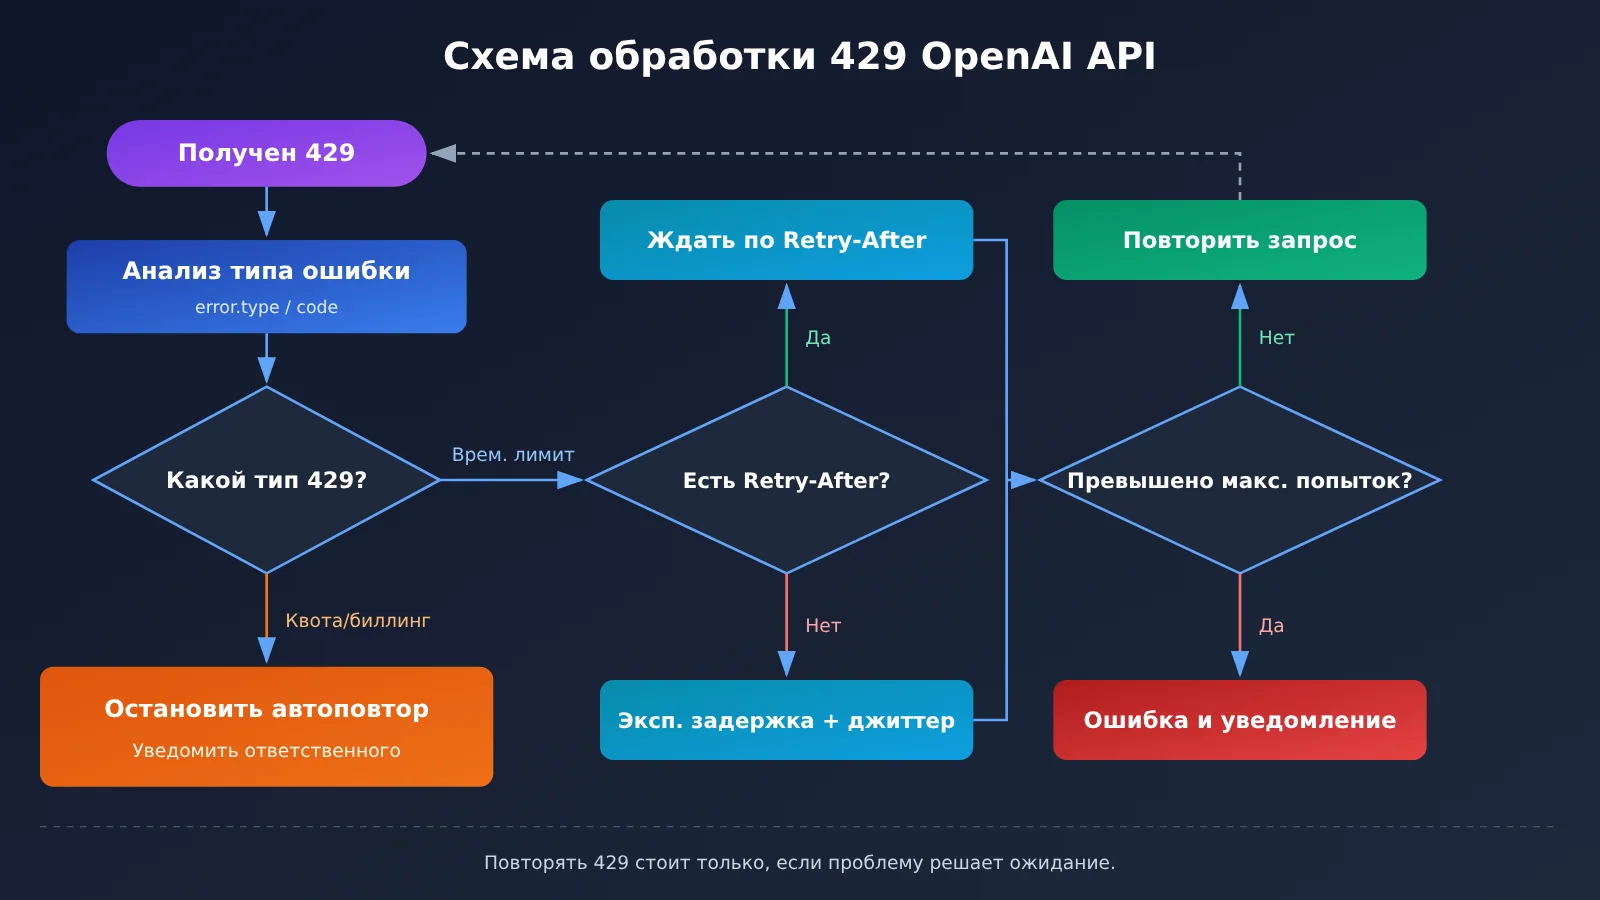
Правильный путь — сначала разобраться в тексте ошибки, поле error.type и доступном error.code, чтобы понять, к какому типу относится 429. Если это временное ограничение скорости и есть рабочий Retry-After, ждите ровно столько, сколько он указывает. Если его нет — используйте экспоненциальную задержку со случайным джиттером и ограничьте число попыток.
Что вы узнаете из этой статьи?
- На какие как минимум категории делятся 429 от OpenAI API и как обрабатывать каждую из них.
- Как связаны
Retry-After, экспоненциальная задержка и случайный джиттер, и когда что применять. - Почему автоматические повторы в официальном SDK, очередь задач и ручная кнопка «Повторить» вместе усиливают 429.
- Чем отличаются решения для узкого места по числу запросов и по токенам, а также на что обратить внимание, если ошибка случилась посреди потокового запроса.
Навигация: Перед основным текстом — таблица понятий и краткий обзор влияния: они помогут унифицировать термины и найти то, что касается именно вас. В разделе «Объективные факты» собрано описание 429 из официальной документации OpenAI, включая классификацию ошибок, правила повторов и поведение SDK. В разделе «Анализ и выводы» — практическая реализация: как менять стратегию в зависимости от типа узкого места, проектировать состояния очереди, выявлять наложение повторов и учитывать смысловые различия при переходе на другой шлюз.
Что нужно знать: концепции для понимания ошибки 429 в OpenAI API
| Концепция | Краткое объяснение |
|---|---|
| HTTP 429 | Статус «Too Many Requests». OpenAI API использует его для обозначения ограничения скорости, а также ограничений квоты или объёма использования |
| Ограничение скорости (Rate Limit) | Верхний предел количества запросов, которые можно отправить за определённый период. OpenAI отдельно учитывает количество запросов и объём токенов |
| RPM / TPM | Количество запросов в минуту и количество токенов в минуту. Превышение любого из этих лимитов может вызвать 429 |
error.type / error.code |
Структурированные поля в теле ответа с ошибкой. Позволяют определить конкретную причину 429 — это надёжнее, чем ориентироваться только на код состояния |
| Retry-After | Поле в заголовке ответа, показывающее, через сколько сервер рекомендует повторить запрос. Если значение корректно, лучше следовать ему |
| Экспоненциальная задержка (Exponential Backoff) | После каждой неудачной попытки время ожидания увеличивается кратно, например 1 секунда, 2 секунды, 4 секунды, с установкой верхнего предела |
| Случайный разброс (Jitter) | Добавление случайной величины к времени ожидания, чтобы множество клиентов не повторяли запросы в один и тот же момент |
| Потоковый вывод (Streaming) | Модель возвращает содержимое по мере генерации. Если вывод уже начался, при ошибке посередине нельзя просто повторить весь запрос заново |
| Наложение повторных попыток | Ситуация, когда SDK, бизнес-очередь и ручные действия пользователя повторяют запросы независимо друг от друга, из-за чего фактическое количество запросов умножается |
Кратко о последствиях: что 429 от OpenAI API значит для разных ролей
| Роль | Основное влияние | На что обратить внимание |
|---|---|---|
| Бэкенд-разработчик | Ошибка в логике повторов превращает кратковременное ограничение скорости в постоянный сбой | Различать типы 429 и держать логику повторов в одном слое |
| Ответственный за пакетную обработку и задачи обработки данных | Крупные пакеты легко упираются сразу в оба лимита — по числу запросов и по токенам | Ритм отправки, объём контекста, устройство очереди и её состояние |
| Продукт и фронтенд | Пользователи снова и снова жмут «Повторить» и плодят новые 429 | Говорить пользователю, когда стоит попробовать снова, или объяснять, что дело в состоянии аккаунта |
| Эксплуатация и владельцы аккаунта | 429, связанные с квотой и биллингом, кодом не лечатся | Вовремя замечать и разбираться с состоянием аккаунта, а не пускать авторетраи на самотёк |
Объективные факты: как официальная документация OpenAI описывает 429
Этот раздел опирается на публично поддерживаемые OpenAI руководства по кодам ошибок, руководство по ограничению скорости запросов (rate limits) и статью справочного центра о диагностике 429; дата проверки — 2026-11-17. Это постоянно обновляемые документы, и проверить, когда соответствующий материал появился впервые, невозможно, поэтому мы не подаём его как новость дня — только как действующее описание правил.
Разные источники ошибки 429 в OpenAI API
Ключевая позиция официальной документации: код 429 может означать не одно и то же, поэтому причину нужно определять по тексту ошибки, error.type и доступному error.code. Временные ограничения скорости и ограничения квоты, биллинга или использования на уровне организации обрабатываются по-разному.
Первое — это «слишком много или слишком частые запросы в текущем окне»; когда окно обновится, всё обычно восстанавливается. Второе связано с состоянием самой учётной записи: например, закончилась квота, есть проблема с оплатой или достигнут лимит использования на уровне организации. Такие проблемы сами по себе не исчезнут со временем.
| Тип 429 | Характерный признак | Решается ли ожиданием | Рекомендуемое действие |
|---|---|---|---|
| Ограничение числа запросов | Текст ошибки указывает на лимит числа запросов, обычно code равен rate_limit_exceeded |
Обычно да | Следовать Retry-After или использовать экспоненциальную задержку с джиттером |
| Ограничение по токенам | Текст ошибки указывает на лимит токенов | Обычно да, но легко снова вызвать срабатывание | Пока делаете задержку, уменьшайте количество токенов в одном запросе |
| Квота / биллинг / ограничения организации | Текст ошибки указывает на квоту или биллинг, обычно code равен insufficient_quota |
Нет | Прекратить автоматические повторы и уведомить ответственного за работу с учётной записью |
Стоит подчеркнуть: конкретное значение error.code нужно определять по фактическому ответу и официальной документации. Коды в таблице выше — лишь распространённые примеры. В коде не стоит делать выводы только по жёстко заданным строкам; кроме того, сохраняйте исходный текст ошибки для разбора по логам.
Лимиты на количество запросов и объём токенов могут действовать раздельно
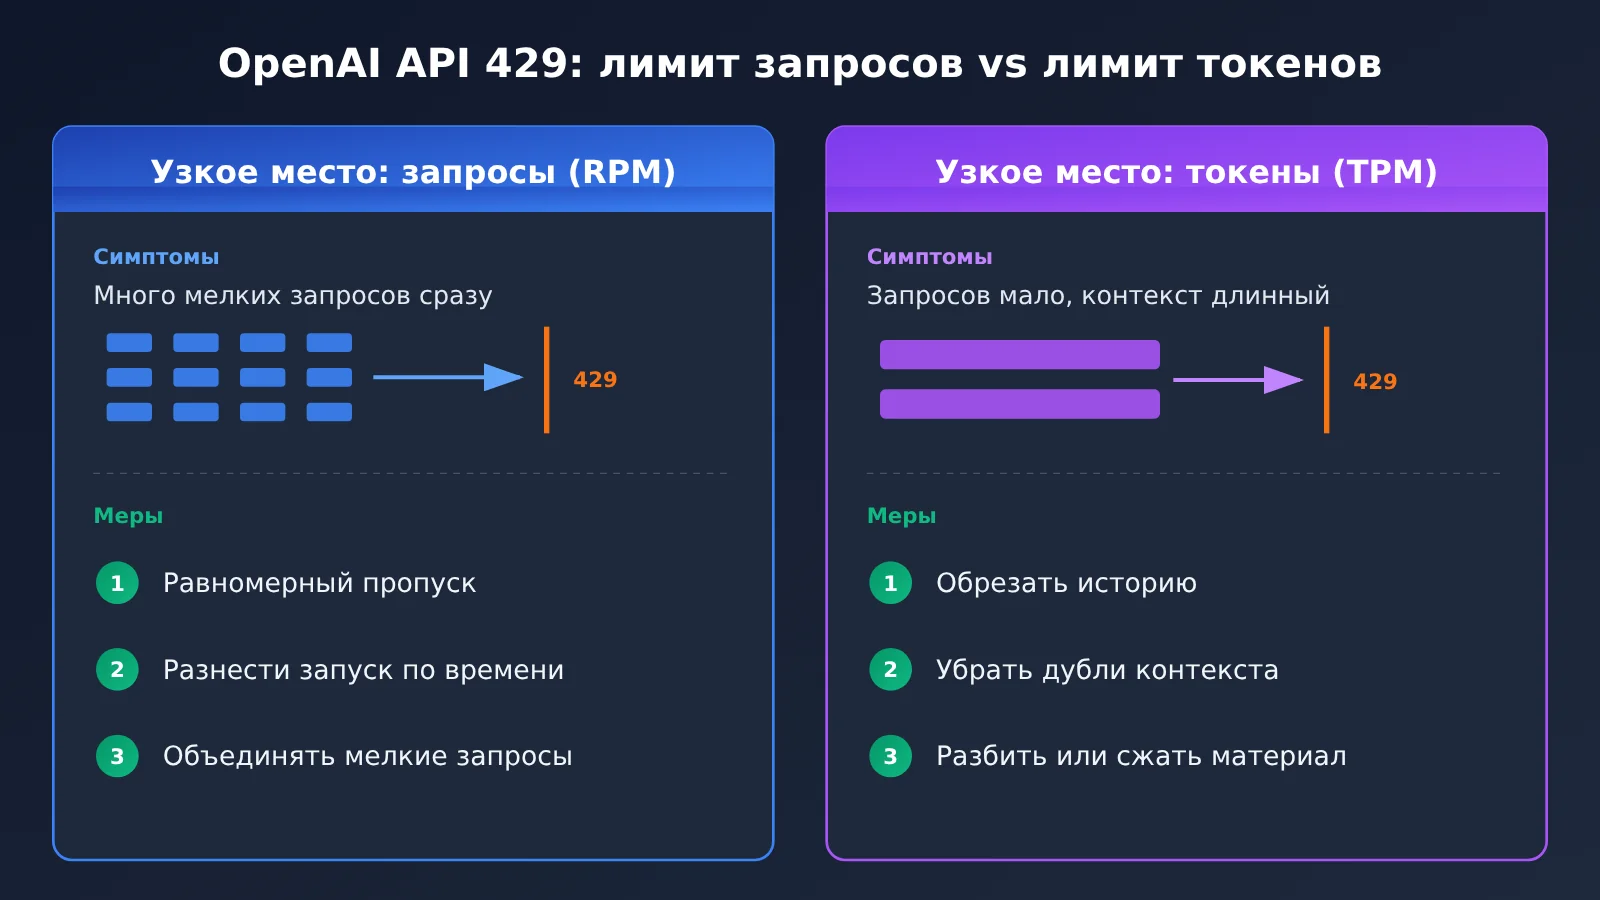
В руководстве по ограничению частоты запросов говорится, что лимиты считаются по нескольким параметрам. Чаще всего встречаются ограничения на количество запросов и объём токенов, причём они действуют независимо друг от друга. То есть даже если до лимита запросов ещё далеко, можно раньше упереться в лимит токенов из-за длинного контекста в каждом запросе. И наоборот: множество совсем небольших запросов может быстрее исчерпать лимит запросов.
OpenAI передаёт в заголовках ответа информацию, связанную с rate limit, например сколько запросов и токенов осталось и когда сбрасывается каждый из лимитов. Эти заголовки помогают ещё до реального получения 429 понять, к какому ограничению вы ближе.
Официально рекомендуемый подход к повторам при OpenAI API 429
Для временных ограничений скорости, которые имеет смысл повторять, официальные рекомендации сводятся к двум правилам:
- Если есть действительный Retry-After — следуйте ему. Это самый прямой сигнал от сервера, он точнее любых догадок клиента.
- Если Retry-After нет — используйте экспоненциальную задержку со случайным джиттером. Время ожидания растёт с каждым неудачным повтором, а сверху добавляется случайная величина — так все клиенты не начнут повторять запрос одновременно.
Оба правила работают при условии, что этот 429 относится к типу, который решается ожиданием. Если проблема в квоте или биллинге, то даже самый точный алгоритм задержки будет просто крутиться вхолостую.
Поведение автоматических повторов в официальном SDK
Официальный SDK OpenAI автоматически повторяет запросы при подходящих ошибках ограничения скорости; конкретное поведение зависит от настроек клиента. На примере Python SDK: это регулируется параметром max_retries, а можно установить его в 0 и отключить автоматические повторы.
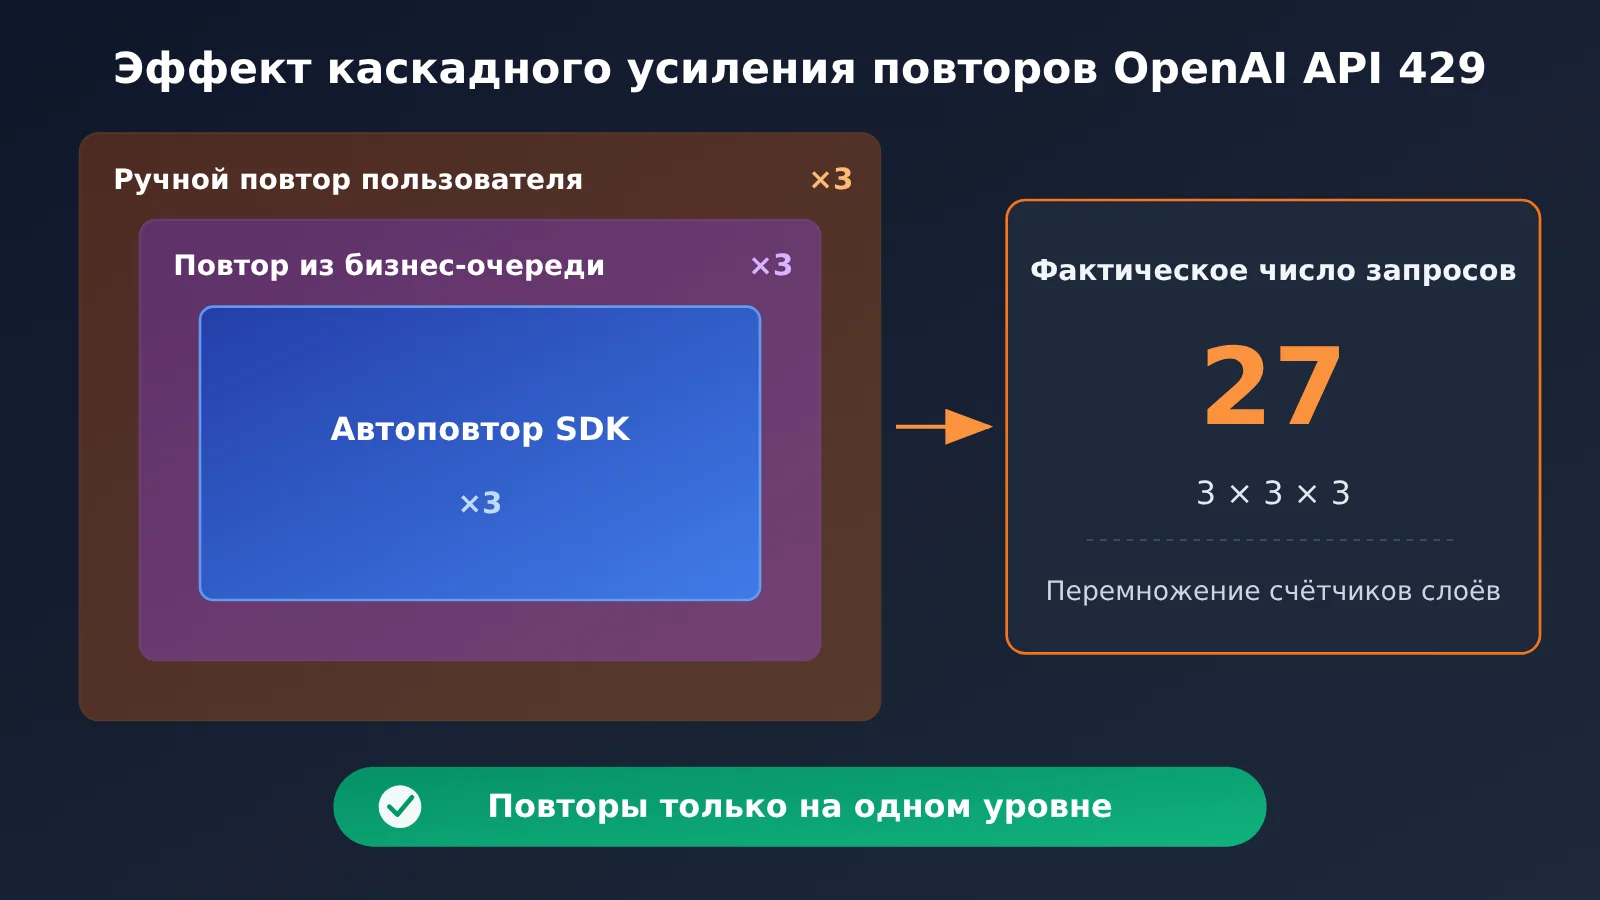
Это значит, что даже если в вашем бизнес-коде нет ни строчки логики повторов, запрос мог уже несколько раз повториться. Если бизнес-уровень обернёт это ещё одним слоем повторов, фактическое число запросов будет произведением обоих.
Если потоковый запрос падает на середине, его нельзя всегда повторять целиком
В официальной документации упоминается ещё одна граница, которую легко упустить: если потоковый вывод уже начался, возникшую после этого ошибку нельзя во всех случаях исправлять повторной отправкой всего запроса. Пользователь мог уже увидеть часть содержимого, а система, принимающая данные, — уже обработать часть из них. Прямое повторение приведёт к дублированию контента, несогласованности до и после, а также к повторному расходу токенов.
Анализ и выводы: как обрабатывать 429 в OpenAI API на практике
Ниже — инженерные выводы, основанные на перечисленных фактах, а не дословные формулировки OpenAI.
Пример экспоненциальной задержки при 429 от OpenAI API, который можно сразу адаптировать
Этот пример иллюстрирует несколько принципов: отключаем автоматические повторные попытки SDK и передаём их обработку бизнес-логике; ошибки, связанные с квотой, сразу пробрасываем; в первую очередь соблюдаем Retry-After; если его нет — используем экспоненциальную задержку с полным джиттером; ограничиваем максимальное число попыток.
import random
import time
from openai import OpenAI, RateLimitError

# Отключаем автоматические повторы SDK, чтобы они не накладывались на нашу логику ниже
client = OpenAI(max_retries=0)

# Типы 429, которые бессмысленно повторять (ориентируйтесь на реальные ответы и официальную документацию)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """Разбирает Retry-After в секундах; если значение некорректно — возвращает None. Разбор HTTP-даты при необходимости можно добавить."""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # Проблемы с квотой/биллингом — передаём в процесс обработки аккаунта
            if attempt == max_attempts - 1:
                raise  # Превысили лимит попыток — передаём в очередь или в систему алертов
            wait = parse_retry_after(e.response)
            if wait is None:
                # Полный джиттер: берём случайное значение из диапазона [0, экспоненциальный потолок]
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
Значения max_attempts, base и cap в примере — это только отправная точка, а не рекомендация. У разных аккаунтов разные уровни лимитов, да и задачи бывают разными, поэтому не существует единого числа параллельных запросов или повторных попыток, подходящего для всех аккаунтов. Ориентируйтесь на данные собственного мониторинга.
Подстройка под тип узкого места: узкие места по запросам и по токенам требуют разных решений
Повторные попытки с задержкой (backoff) решают только вопрос «как подождать на этот раз», но не «почему мы снова и снова упираемся в лимит». Чтобы сократить количество 429, сначала надо понять, в какую именно стену мы бьёмся.
Узкое место по числу запросов: главное — растянуть ритм отправки. На входе в очередь обеспечьте равномерный пропуск — например, через token bucket или с фиксированным интервалом, — чтобы лавина задач не вылетала в одну и ту же секунду. Пакетные задачи тоже запускайте с разнесением по времени, а не так, чтобы всё стартовало в один момент.
Узкое место по токенам: главное — уменьшить объём одного запроса. Что обычно раздувает запрос: в каждом ходе диалога целиком передаются длинный системный промпт и история; один и тот же большой документ снова и снова уходит в разных запросах; в модель впихивают весь материал, хотя на деле нужен только один фрагмент. Сначала обрежьте, сделайте выжимку или найдите нужный фрагмент, а потом отправляйте. Часто это работает гораздо лучше, чем просто увеличивать число повторов.
Состояния очереди: важно различать «ожидание повторной попытки» и «блокировку аккаунта»
Во многих системах есть только два состояния — «в очереди» и «ошибка». Когда приходит 429, это приводит к двум типам неверных решений: временное ограничение скорости принимают за ошибку и попросту выбрасывают задачу, а проблему с квотой принимают за обычную очередь и ждут бесконечно.
Разумнее разделить два вида 429 на два разных состояния и показывать их по-разному:
| Состояние очереди | Условие срабатывания | Что показывать | Что делать дальше |
|---|---|---|---|
| Ожидание повторной попытки | Временное ограничение скорости | Время следующей попытки, число уже сделанных попыток | Повторить автоматически в назначенное время; при достижении лимита перевести в «ошибку» |
| Блокировка аккаунта | Квота, биллинг, ограничения на использование организации | Причина блокировки (например, недостаточная квота) | Приостановить все последующие задачи этого аккаунта, уведомить ответственного |
| Ошибка | Превышен лимит попыток или другая неисправимая ошибка | Тип ошибки и исходное сообщение | Ручное вмешательство или деградация бизнес-логики |
У «блокировки аккаунта» есть ещё один побочный эффект. Остальные задачи под тем же аккаунтом с большой вероятностью тоже наткнутся на тот же 429 — в такой ситуации нужно ставить на паузу всё целиком, а не давать каждой задаче по очереди упираться в одну и ту же стену.
Диагностика наложения повторов: SDK, очередь, кнопка ручного повтора
Если вы заметили, что при 429 повторные попытки только усугубляют ситуацию, первым делом проверьте, не работают ли одновременно несколько уровней повторов. Типичная цепочка выглядит так: SDK автоматически повторяет запрос несколько раз, бизнес-очередь после сбоя задачи ещё несколько раз ставит её обратно в очередь, а пользователь на фронтенде видит ошибку и вручную нажимает «Повторить». Эти три уровня умножаются друг на друга, и один исходный запрос может превратиться в десяток с лишним реальных запросов. Причём они часто попадают в одно окно ограничения частоты — и только сильнее упираются в лимит.
При разборе стоит проверить каждый уровень по очереди:
- Уровень SDK: уточните фактическое значение
max_retries— не полагайтесь на значение по умолчанию, которое помните. - Уровень очереди: проверьте, ставится ли задача автоматически обратно в очередь после сбоя и есть ли у повторной доставки задержка перед повтором.
- Уровень интерфейса: убедитесь, что кнопка «Повторить» заблокирована на время ожидания и показывает время следующей попытки.
- Уровень логов: присвойте каждому исходному заданию уникальный ID и посчитайте, сколько запросов оно реально отправило.
Принцип простой: на одной цепочке должен остаться только один уровень, отвечающий за повторы, остальные уровни только передают состояние.
Для стриминговых сценариев стратегию восстановления после 429 в OpenAI API нужно продумывать отдельно
Если стриминговый запрос получает 429 при установке соединения, пока ещё ничего не выведено, с ним можно поступить как с обычным запросом. Но как только вывод начался, решение о том, «повторять ли запрос», должно оставаться за бизнес-логикой. Например, явно сообщите пользователю, что генерация прервана, и дайте ему выбрать повторную генерацию; или отбросьте уже выведенную часть и замените её целиком. Не повторяйте запрос в фоне молча — иначе в интерфейсе появятся два дублирующихся фрагмента.
При переходе на другие платформы не копируйте семантику 429 от OpenAI
Классификация ошибок, значения error.code, поведение Retry-After и заголовки ответа, описанные в этой статье, — это семантика официального API OpenAI. Если вы вызываете модель через сторонний шлюз, сервис-прокси или агрегатор (например, APIYI), коды ошибок, измерения ограничения частоты и рекомендации по повтору нужно брать из документации самой платформы — проверять отдельно, нельзя просто копировать поведение OpenAI. Разумнее всего сделать на уровне интеграции слой нормализации ошибок: сопоставить 429 из разных источников с тремя состояниями, о которых речь в статье — «ждать и повторить / блокировка аккаунта / неудача», — и передать их в единый модуль повторов.
Изменения, за которыми стоит следить
Документация OpenAI по кодам ошибок и по ограничениям скорости постоянно обновляется. Уровни лимитов, единицы измерения, поля заголовков ответа — всё это может меняться. Рекомендую сохранять в коде логи с исходным текстом ошибок и регулярно сверять логику с официальной документацией. Кроме того, не записывайте в конфигурацию по умолчанию утверждение «все 429 решаются ожиданием». Как только эта гипотеза сработает при исчерпанной квоте, цена окажется высокой — очередь задач, которая всю ночь прокручивается вхолостую.
По сути, 429 — это сервер говорит «помедленнее», а иногда ещё и «этот путь пока не проходит». Понять, какой именно случай перед вами, и решить — ждать, менять подход или остановиться — важнее любого изощрённого алгоритма повторов. Как сказано в «Лунь юй», раздел «Цзы Лу»:
«Не желай скорости, не смотри на мелкую выгоду. Погонишься за скоростью — не достигнешь; погонишься за мелкой выгодой — большого дела не сделаешь.»