Resumo: A Google Decisions API pontua diretamente opções fixas, sem gerar texto. Este artigo usa os preços públicos para estimar seu custo em tarefas de classificação, moderação e roteamento, e combina dados oficiais e de terceiros para explicar seus limites de aplicação.
Conclusão antecipada: O Google lançou, em 11 de novembro de 2026, a Gemini Decisions API (ID do modelo gemini-decision-1). Ela pode, em uma única requisição, realizar de 1 a 1.000 decisões independentes sobre a mesma entrada, com preço de entrada de US$ 0,10 por milhão de tokens e sem custo de tokens de saída generativa. Com base nos preços públicos, ao verificar 1.000 regras em um mesmo documento de 10K tokens, o custo fica em cerca de 1/20 do custo do Gemini 3.5 Flash-Lite, uma economia teórica de 94,9%. Para 1.000 mensagens, cada uma classificada uma vez, a economia teórica é de 73,1%. Os testes oficiais do Google indicam uma vantagem de custo de cerca de 4,7 vezes. Em testes práticos de terceiros com uma única tarefa, essa vantagem é de cerca de 1,5 vezes. Tarefas que fazem apenas classificação, moderação e roteamento, e cujas respostas podem ser previamente limitadas a opções fixas, são as mais adequadas para usar essa API e reduzir custos.
A seguir, o texto explica primeiro o mecanismo de funcionamento dessa interface e os três tipos de decisão; depois, usa fórmulas que podem ser recalculadas para estimar o custo de três cenários típicos de negócio e explicar a diferença entre o “cerca de 5 vezes” oficial e as medições de terceiros. Em seguida, compara os dados de velocidade publicados pelo Google com a avaliação independente da Artificial Analysis e discute se a precisão atende aos requisitos de produção. Por fim, apresenta um exemplo mínimo de chamada, uma tabela de seleção e uma lista de verificação de custos antes do lançamento.
Para saber: conhecimento prévio de terminologia
| Termo | Explicação |
|---|---|
| Decisions API | Interface de julgamento lançada pelo Google, que dá resultados e probabilidades diretamente para opções fixas |
| Gemini Decision 1 | Modelo dedicado que sustenta essa interface, com ID de modelo gemini-decision-1 |
| Token | Unidade básica de processamento e cobrança do modelo; textos, imagens e outros conteúdos são convertidos em Tokens |
| Shared Input | A parte da entrada compartilhada por todos os julgamentos de uma mesma requisição |
| Closed-set Decision | Julgamento cujo intervalo de respostas é definido de antemão, como “sim/não” ou “escolha uma entre A/B/C” |
| noul | Julgamento binário, que retorna a probabilidade de “Yes” |
| choice | Escolha de um item entre 2 a 255 opções predefinidas |
| score | Pontuação em níveis ordenados predefinidos, com resultado expresso como valor esperado ponderado |
| Confidence | Estimativa de probabilidade de que o modelo acerte o resultado escolhido |
| Single Forward Pass | O modelo calcula as pontuações de cada opção em um único passo, sem gerar texto token a token |
| Context Window | Volume total de conteúdo que uma requisição pode comportar; neste modelo, 262.144 Tokens |
| TPM / RPM | Tokens por minuto / requisições por minuto que podem ser processados — os limites de throughput |
1 O que o Google lançou: a Gemini Decisions API responde especificamente a perguntas de julgamento
1.1 A diferença entre o Gemini Decision 1 e os modelos generativos tradicionais
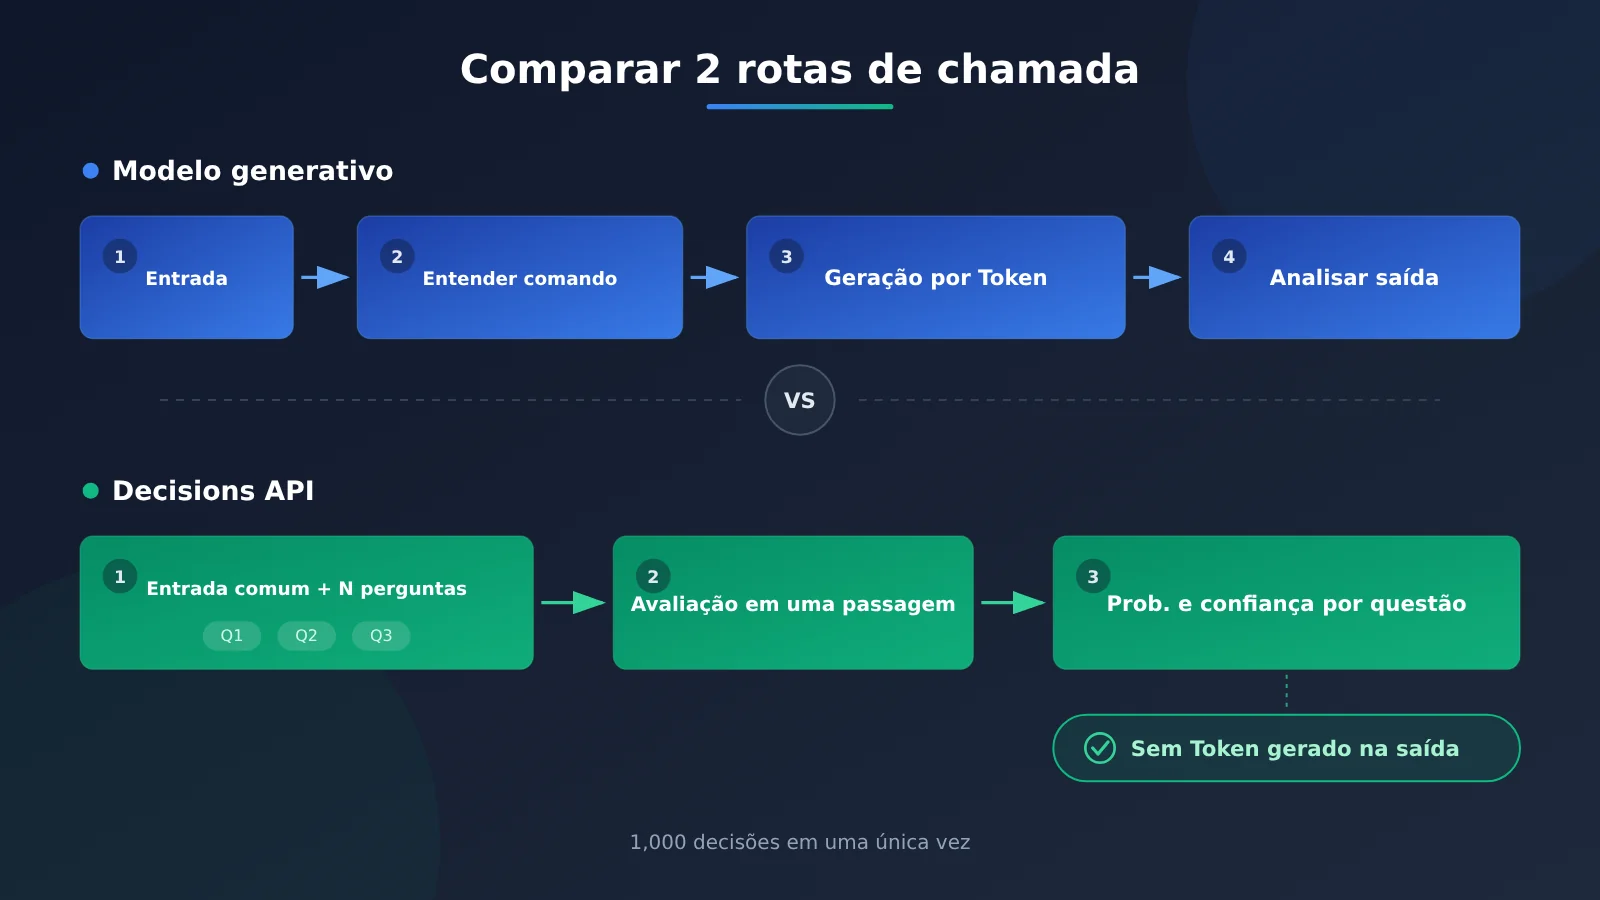
A Gemini Decisions API foi disponibilizada em 11 de novembro de 2026 por meio da Gemini Developer API v1beta, com endpoint REST POST https://generativelanguage.googleapis.com/v1beta/decisions. Sua função central é fazer julgamentos probabilísticos sobre opções predefinidas, retornando o resultado do julgamento, a probabilidade de cada opção, a confiança e o consumo de Tokens. A entrada aceita texto, imagem, áudio, vídeo e PDF.
O fluxo dos modelos generativos tradicionais para tarefas de classificação é: ler o conteúdo, entender a instrução e então gerar uma resposta token a token, que o desenvolvedor ainda precisa interpretar. A Decisions API muda o processo: lê o conteúdo compartilhado e depois pontua diretamente as opções predefinidas de cada pergunta. Tarefas como classificação, moderação e roteamento precisam apenas de um rótulo ou de um “sim/não”; gerar uma resposta longa ocupa custo de saída e deixa a resposta mais lenta. Eliminar essa etapa é justamente a origem da redução de custo e de latência.
1.2 Que tarefas as três formas de julgamento da Decisions API cobrem
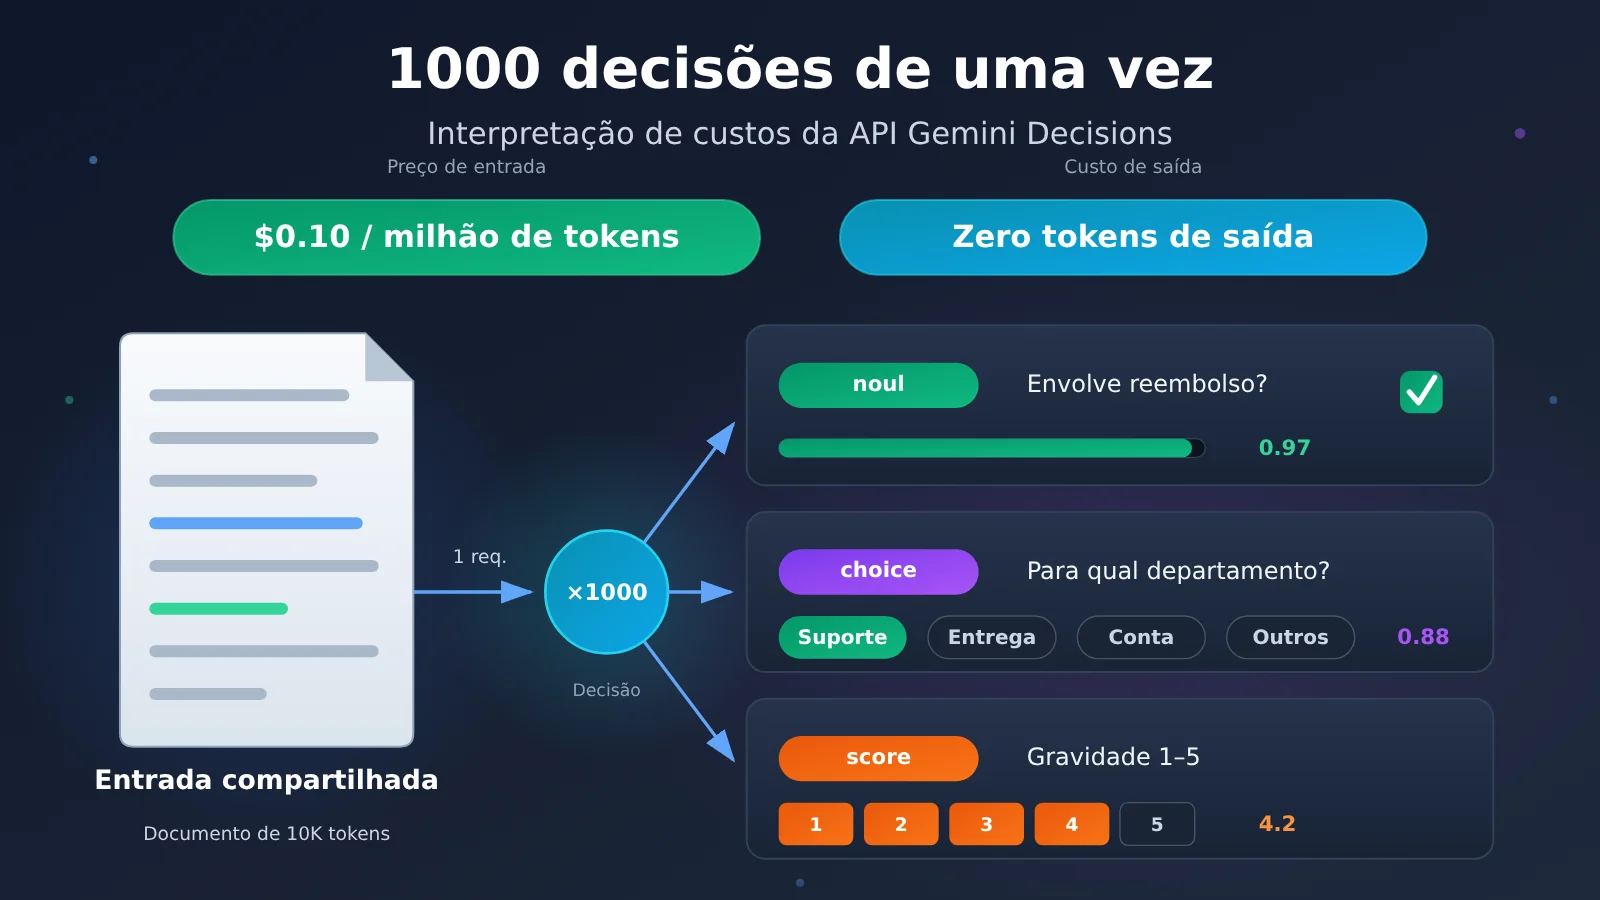
Tome como exemplo uma mensagem de atendimento ao cliente: “Comprei um fone na semana passada e o lado esquerdo não tem som. Pedi o reembolso há três dias e ninguém me respondeu. Se não resolverem, vou reclamar na plataforma.” Para essa única mensagem, é possível fazer, na mesma requisição, três perguntas independentes entre si.
| Tipo de julgamento | Pergunta de exemplo | Conteúdo retornado | Tarefas típicas |
|---|---|---|---|
| noul | Esta mensagem envolve reembolso? | Probabilidade de “Yes”, como 0,97 | Se há violação, se menciona preço, se precisa escalar para revisão |
| choice | Para qual setor encaminhar: pós-venda / logística / conta / outro? | “Pós-venda” selecionado, com a probabilidade de cada opção | Triagem de tickets, classificação de artigos, seleção de ferramentas por Agent |
| score | Qual a gravidade da reclamação em uma escala de 1 a 5? | Valor esperado ponderado calculado a partir das probabilidades de cada nível, como 4,2 | Relevância, gravidade, pontuação de prioridade de leads |
choice aceita de 2 a 255 opções e score aceita de 2 a 255 níveis. O score retorna um valor esperado calculado a partir das probabilidades de cada nível, portanto pode ser usado diretamente para ordenação ou definição de limites, sem precisar extrair a nota de um texto de avaliação.
2 Quanto a API Decisions do Google pode realmente economizar: três cenários de negócio para fazer as contas
2.1 Por que a entrada compartilhada pode reduzir o consumo de tokens
A estrutura de cobrança da Decisions API tem três características: a entrada compartilhada é cobrada apenas uma vez por requisição; as instruções de cada pergunta continuam sendo cobradas como tokens de entrada; e o resultado da decisão não gera custos de saída generativa. Para comparação, o preço padrão oficial do Gemini 3.5 Flash-Lite é de 0,30 dólar por milhão de tokens de entrada e 2,50 dólares por milhão de tokens de saída (preço oficial de 13 de novembro de 2026).
Seja S o número de tokens de uma entrada compartilhada, Q o número de perguntas independentes sobre essa entrada, Tq o número médio de tokens por pergunta, To o número médio de tokens de saída por pergunta no modelo generativo e N o número de entradas. Sob a suposição simplificada de que “as duas interfaces têm a mesma quantidade de tokens de entrada cobráveis”:
Custo da Decisions API  C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Custo do Flash-Lite      C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
Taxa de economia        = (1 − C_D / C_F) × 100%
Este é um modelo de cálculo para entender o mecanismo; o Google não fornece uma taxa de economia fixa. Cada interface terá seus próprios custos de codificação de instruções e formatação, e o custo real deve ser determinado pelos tokens cobráveis retornados por cada uma.
2.2 De 1 avaliação para 1.000 avaliações: como o custo muda
A tabela abaixo é um exemplo teórico derivado dos preços públicos, sem teste de carga real. Na situação ①, as 1.000 avaliações são todas sobre o mesmo documento: são 1.000 perguntas independentes feitas a uma única entrada, uma carga completamente diferente de “analisar 1.000 documentos, uma vez cada”.
| Cenário de negócio | Premissas principais | Decisions API | Flash-Lite | Economia teórica |
|---|---|---|---|---|
| ① Verificar 1.000 regras em um documento | Documento de 10K tokens, 20 tokens por regra, Flash-Lite com 20 tokens de saída por regra, ambos consolidados em uma única requisição | $0.003 | $0.059 | 94.9% |
| ② Classificar 1.000 mensagens, uma vez cada | 300 tokens por mensagem, 50 tokens de instrução de avaliação, 10 tokens de saída no Flash-Lite | $0.035 | $0.130 | 73.1% |
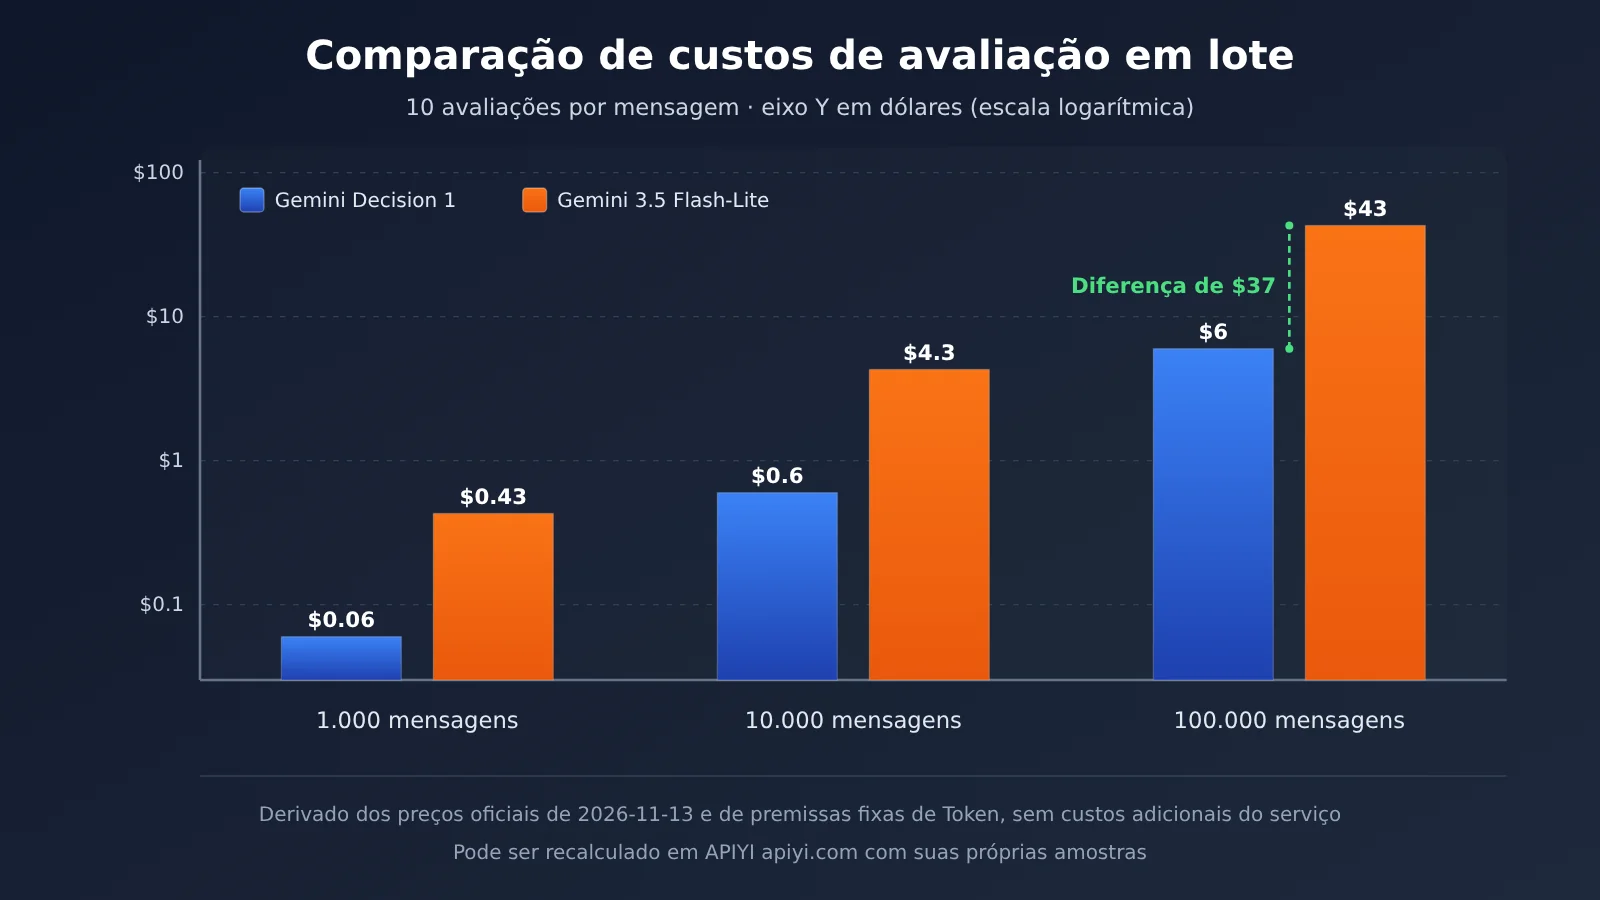
| ③ Fazer 10 avaliações em cada uma de 1.000 mensagens | 300 tokens por mensagem, 30 tokens por avaliação, 10 tokens de saída por avaliação no Flash-Lite, uma requisição por mensagem | $0.060 | $0.430 | 86.0% |
Os três cenários mostram duas coisas. No cenário ②, cada requisição carrega apenas uma pergunta e ainda assim há 73.1% de economia teórica — a origem é o preço unitário de entrada cair para um terço e o custo de saída ir a zero. Nos cenários ① e ③ a economia é maior porque a entrada compartilhada é diluída entre várias perguntas, enquanto o Flash-Lite precisa gerar saída para cada pergunta.
Ampliando a escala com os parâmetros do cenário ③: ao processar 100 mil mensagens e 1 milhão de avaliações no total, o custo de invocação do modelo no Decisions API é US$ 6, contra US$ 43 no Flash-Lite — uma diferença de US$ 37. Esse valor cobre apenas a taxa de invocação do modelo, sem contar retries, revisão humana depois de erros de julgamento, upgrade para modelos mais fortes, transmissão e armazenamento e custos de reengenharia.
Se quiser recalcular com suas próprias amostras de negócio, comece rodando o mesmo lote de dados em um modelo generativo, registre os tokens reais de entrada e saída e depois aplique a fórmula acima. A APIYI apiyi.com permite chamar Gemini, GPT, Claude e vários outros modelos generativos com uma única chave API, o que facilita montar essa linha de base de custo rapidamente.
2.3 Por que o “cerca de 5 vezes” do Google não é uma resposta universal
Quando o Google fez o lançamento, divulgou que, em seus testes oficiais, o custo do Decision 1 era aproximadamente 1/4.7 do Gemini 3.5 Flash-Lite. O testador independente RanThis, em 12 de novembro de 2026, usando chamadas reais de API, apresentou outro conjunto de números: 100 mensagens em inglês e 20 mensagens em vietnamita, com cada requisição fazendo apenas um julgamento binário.
- Acurácia: das 100 decisões em inglês, o Decision 1 acertou 99, e o Flash-Lite acertou 98.
- Custo: o custo estimado por mil decisões em inglês foi de $0.0113 e $0.0166, respectivamente; o Decision 1 ficou cerca de 32% mais baixo, o que representa uma diferença de aproximadamente 1.5 vez.
- Latência: a latência mediana por requisição foi de 0.18 s e 0.58 s, respectivamente.
- Consumo de tokens: o Decision 1 cobrou, em média, cerca de 113 tokens de entrada por requisição, enquanto o Flash-Lite cobrou cerca de 47 tokens de entrada mais 1 token de saída.
A razão da diferença é clara: a sobrecarga de instruções e de formato da própria interface Decisions mais do que dobra a quantidade de tokens de entrada cobrados, o que anula parte da vantagem de preço unitário. Quando a entrada é curta, cada requisição faz apenas uma pergunta e o modelo generativo só precisa emitir um token, a economia é mínima. Quando RanThis agrupou 10 perguntas do mesmo e-mail em uma única requisição ao Decision 1 e comparou com 10 requisições separadas ao Flash-Lite, a diferença subiu para cerca de 5.4 vezes; nesse comparativo, o Flash-Lite não fez o mesmo agrupamento, então é uma comparação entre formas diferentes de requisição.
Portanto, as variáveis que afetam a economia real são: o comprimento da entrada compartilhada, o número de perguntas por entrada, o comprimento da saída do modelo generativo, se ambos os lados fizeram agrupamento de requisições e a sobrecarga fixa da própria interface. A derivação da fórmula, os benchmarks oficiais e as medições de terceiros vêm de condições diferentes e devem ser considerados separadamente na escolha.
3 Concluir 1.000 julgamentos de uma só vez: para que tipo de trabalho a Decisions API realmente serve?
3.1 Revisão de documentos: um único documento corresponde a várias regras
O cenário que melhor aproveita a vantagem da entrada compartilhada é “material longo + muitas regras”. Um contrato, documento de licitação ou manual de produto precisa ser comparado item a item com uma lista de conformidade: se inclui cláusula de inadimplência, se prevê transferência de dados para o exterior, se o prazo de pagamento excede 60 dias, se falta a data de assinatura etc. Quanto mais longo o material e maior o número de regras, mais a entrada compartilhada é diluída — e a economia teórica de 94,9% do cenário ① é resultado justamente dessa estrutura.
Outra vantagem desse tipo de tarefa é que os resultados podem ir direto para uma tabela. Cada regra corresponde a um julgamento noul, que retorna probabilidade e confiança; o programa pode marcá-los por limiar como “aprovado / reprovado / pendente de revisão”, e a equipe de revisão olha apenas os itens que precisam de revisão.
3.2 Roteamento de agentes e classificação de conteúdo
A cada etapa, o agente precisa decidir a próxima ação: se deve pesquisar na web, executar código ou encaminhar a tarefa para outra ferramenta. Esse tipo de decisão tem opções fixas, é invocado com frequência e é sensível à latência; por isso, é adequado concluir tudo de uma vez com choice. Os usos internos divulgados pelo Google também se concentram aí: o Gemini Notebook o usa para escolher o modelo e o nível de raciocínio de acordo com a natureza da pergunta, reduzindo a latência de consultas comuns em até 40%; o Google Search o usa para fazer verificações de segurança em ferramentas MCP e identificar conteúdo adversarial; o CC escolhe rapidamente uma reação entre mais de 200 Emojis candidatos. Esses são dados do próprio Google; o efeito real para desenvolvedores externos depende da carga de cada um.
O fluxo de produção de conteúdo é outro cenário em que essa abordagem se estende. Depois de coletar uma notícia de IA, o sistema precisa decidir se ela é um evento novo, se tem relevância para desenvolvedores, se envolve preço de API, se tem fonte oficial, se serve para virar tutorial — e atribuir uma nota ao valor do conteúdo. Essas seis condições são independentes entre si e podem entrar em uma única requisição da Decisions para concluir a triagem; os tópicos aprovados seguem então para um modelo generativo fazer pesquisa, redação e refinamento. Este é um exemplo de solução desenhada com base nas capacidades da interface. A etapa de geração na segunda metade do fluxo pode alternar entre diferentes modelos sob demanda via APIYI apiyi.com, comparando qualidade de escrita e custo.
3.3 Os três limites de 1.000 perguntas
- As perguntas precisam ser independentes entre si. Julgamentos dentro da mesma requisição não conseguem ler os resultados uns dos outros. Fluxos com dependência de ordem, como “primeiro decidir se é uma reclamação e depois classificar por tipo de reclamação”, exigem que o programa combine os resultados e, se necessário, faça uma nova requisição.
- 1.000 perguntas compartilham uma janela de contexto de 262.144 Tokens. A entrada compartilhada e todas as perguntas ocupam juntas essa janela; quanto mais longa a instrução de cada pergunta, menor o espaço disponível para o material.
- Os dados oficiais de baixa latência cobrem apenas requisições de pequeno porte. Nos testes do Google, a faixa em que a latência se mantém aproximadamente estável é de 1–100 perguntas por vez e contexto de até 16K Tokens. Com 1.000 perguntas e um contexto próximo da capacidade máxima, a latência precisa ser medida na prática.
4 Além de barata, a precisão e a velocidade da Gemini Decisions API conseguem atender aos requisitos de produção?
4.1 Dados de velocidade e aplicações internas divulgados pelo Google
O tempo de computação mediano do modelo divulgado pelo Google é de 50–100 ms, e a latência ponta a ponta é de 150–250 ms; as condições de teste são de 1–100 perguntas por vez e contexto de até 16K tokens. Esses dados mostram que ela é adequada para ser usada em fluxos em tempo real, como o roteamento de cada etapa de um Agent ou a triagem imediata de mensagens do usuário. A latência mediana de 0,18 segundo por pergunta medida na prática pela RanThis também fica próxima desse intervalo.
4.2 O que as avaliações de terceiros nos dizem
Os primeiros resultados do Decision Index v2.1, da Artificial Analysis, são calculados combinando pontuações brutas com tarefas reais. Os custos na tabela abaixo são o custo combinado das tarefas desse benchmark, uma base de cálculo diferente do “preço por milhão de tokens”.
| Modelo de decisão | Pontuação geral | Tempo por tarefa | Custo estimado por milhão de tarefas | Taxa de acerto nas 15 tarefas do AA-Paperclip |
|---|---|---|---|---|
| Drex Max v1.1 | 72,62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66,23 | 92 ms | $156 | 35,5% |
| Gemini Decision 1 | 65,98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60,25 | 206 ms | $339 | — |
Dois pontos merecem atenção. Primeiro, o preço por token do Gemini Decision 1 é baixo, mas, nessa distribuição de tarefas, o custo estimado por milhão de tarefas é maior do que o do Drex Max e do Jev; isso mostra que a forma das requisições e a estrutura das tarefas podem mudar a economia final. Segundo, no teste de documentos do AA-Paperclip, a proporção de documentos em que o Decision 1 concluiu todas as 15 decisões de uma só vez e acertou todas foi de 33%. Concluir várias decisões de uma vez reduz o custo, mas a precisão de cada item ainda precisa ser verificada separadamente.
4.3 Use a confiança para evitar que erros sejam executados automaticamente
A confiança é a estimativa de probabilidade que o modelo faz do próprio resultado e pode ser usada para decidir quais resultados executar automaticamente e quais encaminhar para revisão humana. Ao entrar em produção, recomenda-se combinar três práticas:
- Defina limites de confiança: por exemplo, quando a confiança na decisão de reembolso for inferior a 0,85, encaminhe para atendimento humano; somente acima do limite ela deve ser rotulada ou direcionada automaticamente.
- Adicione uma opção other ao choice: quando nenhuma das opções for adequada, o modelo ainda escolherá uma delas; incluir “outros / não é possível determinar” consegue bloquear parte das entradas fora do escopo, e também é possível adicionar um noul separado para fazer uma verificação de escopo.
- Mantenha restrições de código para operações de alto risco: valores de reembolso, bloqueio de contas, bloqueios de conformidade e outras ações devem ter, além do julgamento do modelo, regras codificadas e revisão humana.
5 Como os desenvolvedores devem usar e escolher a Gemini Decisions API?
5.1 Como fazer a primeira requisição
O SDK oficial google-genai para Python exige a versão 3.2 ou mais recente; também há suporte ao SDK JavaScript e a REST. A integração requer uma chave API do Google AI Studio. O exemplo abaixo foi organizado com base na estrutura do SDK oficial e faz, para a mesma notícia, um julgamento binário e um julgamento de classificação ao mesmo tempo. Ele não foi realmente executado nem validado neste artigo; consulte o guia oficial do desenvolvedor para conferir os nomes dos campos.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input: entrada compartilhada por todas as perguntas, cobrada apenas uma vez
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions: julgamentos independentes; o nome da chave é o ID da pergunta
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # resultado de cada pergunta, probabilidade de cada opção e confiança
print(result.usage)    # uso de tokens cobrados; esta é a base para calcular custos
O papel dos quatro campos principais é este: input contém o conteúdo compartilhado; questions contém as perguntas independentes (para o tipo score, veja no guia oficial como definir os níveis); answers traz os resultados dos julgamentos e as probabilidades; e usage traz os tokens cobrados. Ao calcular custos, use sempre o valor real de usage; a seção 2.3 já mostrou que o custo fixo da interface afeta bastante o custo por pergunta.
Para fazer a comparação de custos, também precisamos de uma linha de base com um modelo generativo. Abaixo, usamos a interface compatível com OpenAI da APIYI para chamar o Flash-Lite e realizar a mesma classificação, registrando o uso de tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # use o nome real da lista de modelos da plataforma
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # tokens de entrada e saída, para aplicar na fórmula da seção 2.1
Ver o script de comparação em lote: calcula o custo das duas interfaces para o mesmo lote de amostras
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # preço padrão oficial do Flash-Lite, USD por milhão de tokens
DECISION_IN = 0.10                 # preço de entrada do Decision 1; a saída não é cobrada

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """Combina todas as perguntas de cada amostra em uma única requisição generativa e acumula o custo real de cobrança"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Recebe os tokens de entrada de usage retornados a cada chamada da Decisions API e calcula o custo total"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 Dica para começar rápido: primeiro selecione de 200 a 500 amostras reais de negócio, execute com modelos generativos para obter a acurácia de linha de base e o consumo de tokens, e depois compare com o
usageda Decisions API. A APIYI apiyi.com oferece uma interface compatível com OpenAI e créditos gratuitos de teste para novos usuários, o que é ideal para concluir rapidamente esta etapa de teste de linha de base.
5.2 Quando escolher a Decisions API e quando continuar usando modelos generativos
| Tipo de tarefa | Solução recomendada | Motivo |
|---|---|---|
| Revisão de um mesmo documento longo em relação a várias regras | Decisions API | A entrada compartilhada dilui o custo, e os julgamentos são independentes entre si |
| Roteamento de ferramentas de Agent e seleção de modelo | Decisions API | Opções fixas, baixa latência |
| Verificação de segurança de conteúdo e de violações | Decisions API | Várias condições noul independentes, com possibilidade de usar a confiança para encaminhamento |
| Classificação de tickets de atendimento e etiquetas de pós-venda no e-commerce | Decisions API | Conjunto fixo de etiquetas |
| Seleção de tópicos e pontuação de prioridade de leads | Decisions API | Adequado para score em escalas predefinidas |
| Resumo, reescrita, redação | Modelos generativos | Precisa gerar linguagem natural |
| Pesquisa complexa, argumentação, proposição de novas ideias | Modelos generativos | Precisa de raciocínio aberto |
| Fluxos em que os julgamentos têm dependência sequencial | Orquestração procedural + várias requisições, ou modelos generativos | Questões dentro da mesma requisição não podem referenciar umas às outras |
A saída estruturada dos modelos generativos (JSON Schema) também consegue restringir a resposta a um formato fixo, mas ela ainda gera conteúdo token por token e cobra pela saída; as probabilidades precisam de tratamento adicional para serem obtidas. A Decisions API retorna diretamente a probabilidade e a confiança de cada opção, e a saída não é cobrada; o preço disso é que ela só consegue responder a perguntas cujas opções foram definidas previamente.
5.3 O que mais entra no cálculo de custos antes de ir para produção
Além do preço unitário, os itens abaixo afetam diretamente o “custo total por decisão correta”:
- Consumo real de tokens: use
usagecomo referência; em cenários de entrada curta com uma única pergunta, o custo fixo por requisição tem o maior peso. - Limites de requisições: a camada gratuita oferece 200 RPM, 50.000 TPM e 10.000 RPD; o Tier 1 pago oferece 1.500 RPM, 1 milhão de TPM e 50.000 RPD. Requisições com contexto longo costumam atingir primeiro o limite de TPM.
- Ausência de cache e processamento em lote: não há suporte a Context Caching, Batch API nem inferência Flex/Priority; ao reutilizar o mesmo documento longo, você não aproveita os descontos de cache.
- Restrições funcionais: não é possível incluir mídia no comando da pergunta nem passar diretamente o histórico completo de conversa, blocos de raciocínio ou de chamada de ferramentas; para diálogos de múltiplas rodadas, é preciso primeiro organizar tudo como entrada de texto.
- Erros de julgamento e revisão humana: a proporção de casos de baixa confiança encaminhados para revisão humana e os custos de retrabalho após um julgamento incorreto precisam entrar no custo unitário.
- Condições de tratamento de dados: na camada gratuita, os dados podem ser usados para melhorar produtos do Google; a tabela oficial de preços indica que a camada paga não é usada para essa finalidade. Antes de processar documentos de clientes, confirme qual camada está sendo usada.
- Adaptações de engenharia: reescrever comandos generativos como perguntas do tipo noul / choice / score, definir limiares e lógica de fallback exige investimento de desenvolvimento.
Se você pretende integrar por meio de uma plataforma de API de terceiros, confirme se ela oferece suporte ao endpoint dedicado /v1beta/decisions; plataformas que só suportam Chat Completions não conseguem chamar a Decisions API diretamente. Antes de usar a APIYI (apiyi.com), consulte a lista de modelos e endpoints no centro de documentação ou entre em contato com a plataforma para confirmar o suporte.
6 Conclusão: tarefas de classificação, moderação e roteamento podem ser entregues à Gemini Decisions API
Voltando à pergunta do título, a conclusão tem três pontos:
- Tarefas com opções fixas merecem prioridade no Decisions API. Com base no preço público, a economia teórica por classificação de questão única é de cerca de 73%, e a moderação de mil regras sobre o mesmo documento longo economiza cerca de 95% teoricamente; a vantagem medida em questão única de terceiros é de cerca de 32%.
- “Uma entrada, múltiplas questões independentes” é a estrutura com maior potencial de custo. A entrada compartilhada é cobrada apenas uma vez; quanto mais questões, quanto mais longa a entrada, e quanto mais longa a saída do modelo generativo, maior a diferença.
- A métrica final é o custo total por decisão correta em produção. O preço unitário dos tokens e o limite de 1.000 questões são o ponto de partida; a precisão, a proporção de trabalho manual após a triagem por confiança, as cotas e os custos de engenharia juntos determinam o benefício real.
Um caminho mais seguro é: primeiro obter a linha de base do modelo generativo com amostras reais, depois comparar usage e precisão no Decisions API, projetando a camada de julgamento separadamente da camada de geração. A seleção de modelos e a comparação de custos da camada de geração podem ser feitas através do APIYI apiyi.com com uma interface unificada.
📚 Referências
- Guia do desenvolvedor e tabela de preços da Google Gemini Decisions API: capacidades da interface, limitações, cotas e preços oficiais
- Link:
ai.google.dev -
Descrição: ID do modelo, tipos de questão, janela de contexto, limites de taxa e uso do SDK
-
Artigo de lançamento do blog oficial do Google: data de lançamento, dados de latência e casos de uso internos
- Link:
blog.google -
Descrição: tempo de computação de 50–100 ms, vantagem de custo de cerca de 4,7x, casos como Gemini Notebook
-
Endpoint REST da Gemini Decisions API
- Link:
generativelanguage.googleapis.com/v1beta/decisions -
Descrição: endpoint oficial para chamadas via REST
-
Artificial Analysis Decision Index v2.1: avaliação de modelos de decisão por terceiros
- Link:
artificialanalysis.ai -
Descrição: pontuação abrangente, tempo de tarefa, custo por milhão de tarefas e taxa de acerto total do AA-Paperclip
-
Teste independente do RanThis (2026-11-12): teste em pequena escala baseado em chamadas reais
- Descrição: comparação de custo por questão, latência e gasto de tokens, além dos resultados de requisições combinadas de múltiplas questões
Autor: Equipe técnica da APIYI
Contato técnico: Sinta-se à vontade para nos contatar na página inicial do APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com