Em 9 de novembro de 2026, o Google Cloud anunciou duas novas configurações de sistema para a oitava geração de TPUs: TPU 8tx e TPU 8i Max. O TPU 8i Max integra dois TPUs 8i no mesmo encapsulamento. A capacidade de processamento, a SRAM on-chip e a largura de banda da HBM dobram ao mesmo tempo. O sistema é voltado para cenários de inferência com contextos longos, alta concorrência e colaboração entre vários agentes.
Não se trata apenas de lançar um chip com mais capacidade de processamento. As informações já foram confirmadas pelo anúncio oficial do Google, por um anúncio de parceria publicado ao mesmo tempo pela AMD e por notas divulgadas por vários veículos de imprensa. Em vez de apenas listar as especificações do chip, este artigo usa cálculos práticos de KV Cache para explicar uma mudança importante: o gargalo da inferência com agentes está deixando de ser “a velocidade dos cálculos” e passando a ser “se os dados conseguem chegar a tempo às unidades de processamento”.
O principal benefício: ao terminar de ler, você vai conseguir estimar por conta própria quanta memória de vídeo uma solicitação com contexto longo exige, entender as causas da parede da memória e avaliar o que um projeto de sistema como o TPU 8i Max pode significar para o seu serviço de agentes.
Visão geral: principais informações sobre a TPU 8i Max e o contexto longo para agentes
| Item | Detalhes |
|---|---|
| Data de lançamento | 9 de novembro de 2026 |
| Anunciado por | Google Cloud |
| Natureza do produto | Configuração de sistema da oitava geração de TPUs; não é um chip independente com um projeto totalmente novo |
| Empacotamento | Duas TPUs 8i integradas no mesmo encapsulamento |
| Melhorias confirmadas oficialmente | Capacidade computacional, SRAM e largura de banda HBM são o dobro das da TPU 8i |
| Parâmetros divulgados em briefing à imprensa | 384 GB de HBM, largura de banda HBM de 17,2 TB/s e 768 MB de SRAM |
| Cenários-alvo | Contexto longo, inferência com alta concorrência, colaboração entre vários agentes, análise de vídeos longos, entre outros |
| Disponibilidade | A página oficial do produto informa “Coming soon”; preços e data de disponibilidade geral (GA) ainda não foram anunciados |
Vale destacar que, no anúncio, o Google diferencia deliberadamente chip de sistema. O ciclo de projeto de um chip leva anos, enquanto uma configuração de sistema pode ser adaptada mais rapidamente a novas cargas de trabalho com ajustes no encapsulamento, na memória, na rede e nos componentes de segurança. A TPU 8i Max é resultado dessa abordagem: o chip mantém o projeto da TPU 8i, e as mudanças acontecem nos níveis de encapsulamento e de sistema.
Por que o contexto longo de agentes consome mais memória do que um chat comum
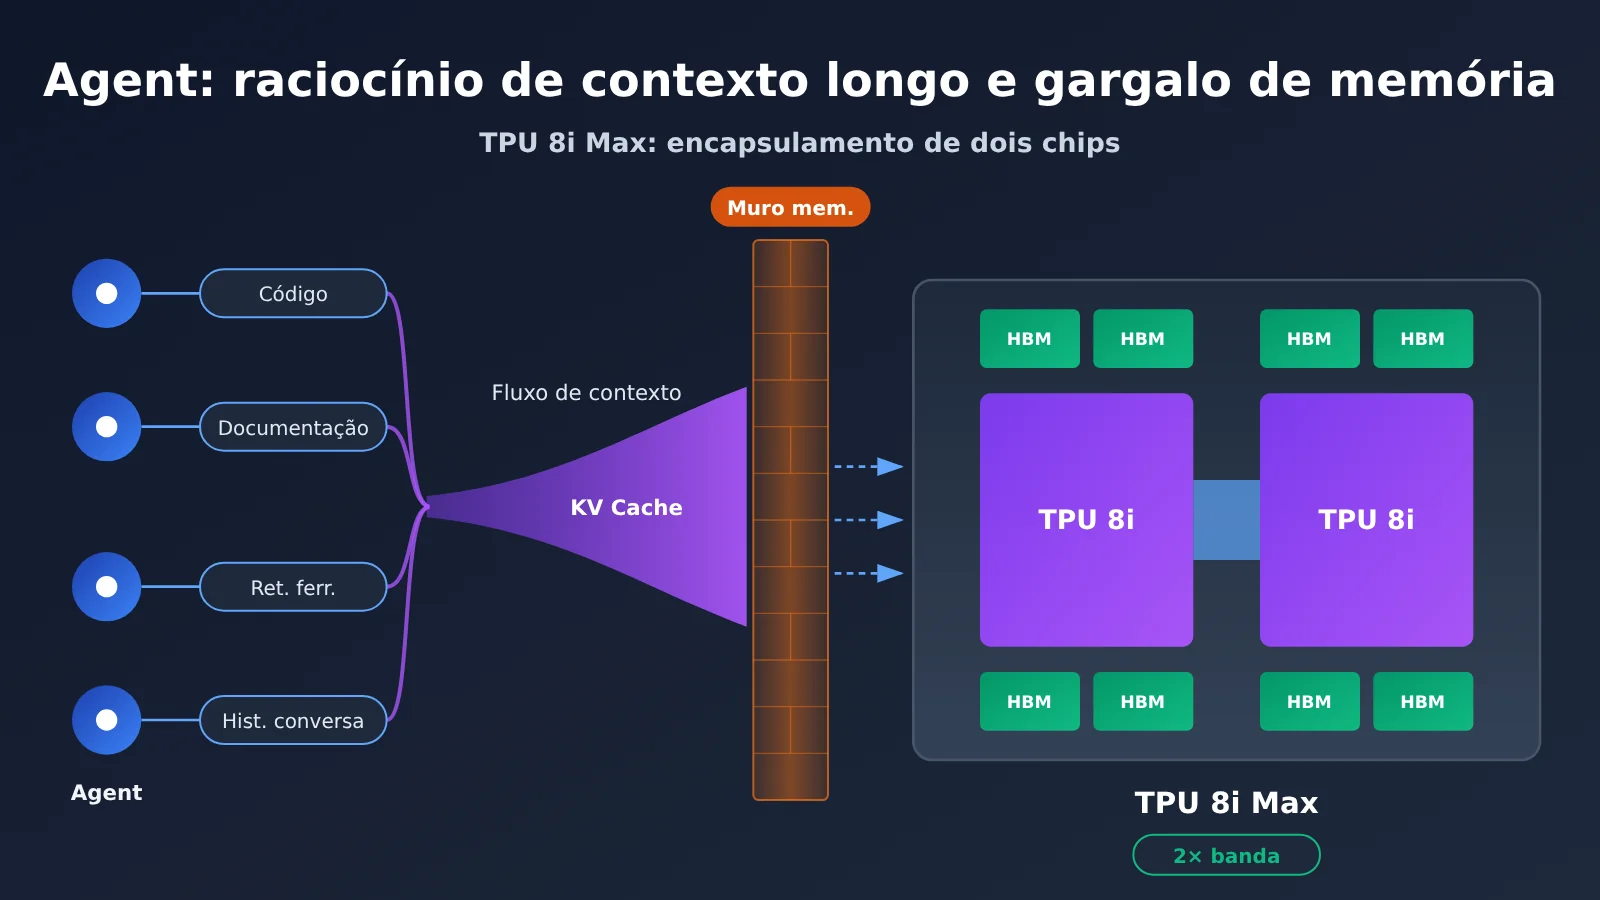
Em geral, uma conversa comum segue o padrão “pergunta e resposta”. O contexto cresce devagar, e o estado pode ser descartado quando a sessão termina. Com agentes, é diferente: eles dividem um objetivo em várias subtarefas, consultam materiais externos continuamente, usam ferramentas, continuam raciocinando com base nos resultados e mantêm o estado salvo enquanto aguardam respostas. A saída de cada etapa é acrescentada ao contexto, que só aumenta.
Por exemplo, durante uma tarefa, um agente de desenvolvimento de software pode precisar lidar ao mesmo tempo com:
- Base de código: centenas de arquivos de código-fonte e suas dependências
- Documentação do projeto: descrição da arquitetura, especificações de interfaces e padrões de codificação
- Histórico da conversa: várias rodadas de esclarecimentos e alterações nos requisitos do usuário
- Resultados de ferramentas: logs de compilação, saídas de testes e rastreamentos de erros
- Resultados de agentes auxiliares: respostas de agentes encarregados de testes, revisão e refatoração
A concorrência é outro fator importante. Quando um agente principal cria quatro agentes auxiliares, o sistema passa a ter cinco contextos independentes ao mesmo tempo. Cada contexto precisa permanecer na memória durante a inferência. É por isso que o Google cita a “colaboração entre vários agentes no desenvolvimento de grandes projetos de software” como um dos cenários típicos da TPU 8i Max. Vale esclarecer que a referência do Google a um “contexto na escala de milhões de tokens” descreve um cenário de uso pretendido, não uma especificação fixa de contexto máximo já anunciada.
Como o KV Cache cresce linearmente com contextos longos de agentes
Para que serve o KV Cache
Ao gerar cada novo token, o Transformer precisa usar a Query do token atual para calcular as pontuações de atenção em relação às Keys de todos os tokens anteriores. Em seguida, usa os pesos obtidos para calcular uma soma ponderada dos Values dos tokens anteriores. Se as Keys e os Values de todo o histórico fossem recalculados a cada novo token, o volume de computação aumentaria rapidamente com o tamanho da sequência. O KV Cache armazena as Keys e os Values já calculados para os tokens anteriores, reutilizando-os e trocando memória por capacidade de processamento.
O custo é que esse cache continua crescendo conforme aumentam o tamanho do contexto e o número de solicitações simultâneas. A fórmula abaixo corresponde ao layout de memória do KV Cache no vLLM:
M_KV = 2 × L × H_KV × D × B × T × N
| Parâmetro | Significado | Valor para Llama 3.1 70B |
|---|---|---|
| 2 | Dois caches: um para Key e outro para Value | 2 |
| L | Número de camadas do Transformer | 80 |
| H_KV | Número de cabeças de atenção Key/Value | 8 (GQA) |
| D | Dimensão de cada cabeça KV | 128 |
| B | Número de bytes por elemento | 2 (BF16) |
| T | Número de tokens por solicitação | Varia conforme o cenário |
| N | Número de solicitações simultâneas | Varia conforme o cenário |
Exemplo de cálculo do KV Cache do Llama 3.1 70B
Vamos calcular primeiro para um único token: 2 × 80 × 8 × 128 × 2 = 327.680 bytes, ou seja, cerca de 320 KiB por token. Esse número não parece tão grande, mas cresce rapidamente quando multiplicado pelo tamanho do contexto.
| Cenário | Tamanho do contexto | Concorrência | KV Cache teórico |
|---|---|---|---|
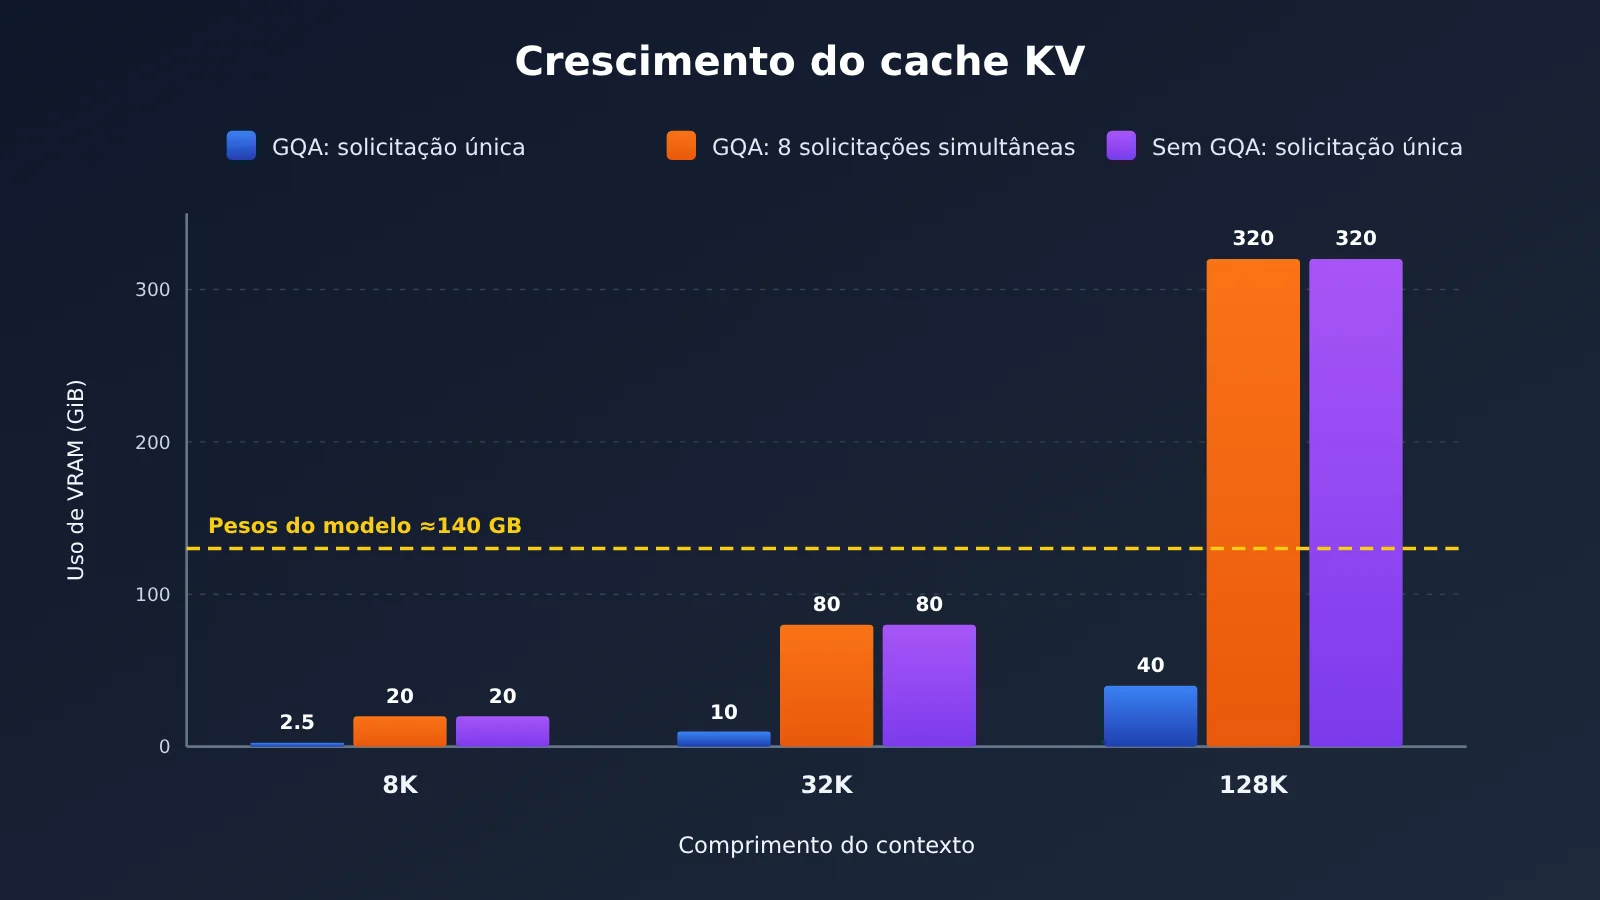
| Tarefa curta | 8K | 1 | 2,5 GiB |
| Tarefa de código média | 32K | 1 | 10 GiB |
| Agent com contexto longo | 128K | 1 | 40 GiB |
| Vários Agents em paralelo | 128K | 8 | 320 GiB |
Os valores acima consideram apenas o KV Cache; não incluem os pesos do modelo, a área de trabalho do runtime nem o espaço desperdiçado por fragmentação. Para comparação, só os pesos de um modelo com 70 bilhões de parâmetros ocupam cerca de 140 GB quando armazenados em BF16. Ou seja, o KV Cache necessário para 8 sessões simultâneas com contexto de 128K já é mais que o dobro do tamanho dos pesos do modelo.
Impacto do GQA no uso de memória do KV Cache
O Llama 3.1 70B tem 64 cabeças de atenção, mas apenas 8 cabeças KV. Isso é o GQA (Grouped-Query Attention): a cada 8 cabeças de Query corresponde um grupo compartilhado de Key/Value. No cálculo, é preciso usar 8, e não 64; do contrário, o resultado fica 8 vezes maior.
Um exercício contrafactual ajuda a entender o valor do GQA. Se o modelo usasse atenção multi-head padrão, com KV independente para cada uma das 64 cabeças, o KV Cache de uma única solicitação de 128K passaria de 40 GiB para 320 GiB — o mesmo que o total usado por 8 solicitações simultâneas com GQA. O MQA reduz ainda mais o número de cabeças KV, para apenas 1, economizando memória, mas é preciso avaliar o impacto na qualidade do modelo. Além disso, a quantização do KV Cache (por exemplo, reduzindo de BF16 para 8 bits) pode cortar o uso de memória pela metade, mas é necessário avaliar a perda de precisão.
O script abaixo reutiliza a fórmula acima e ajuda a estimar rapidamente o tamanho do KV Cache do seu modelo para diferentes tamanhos de contexto e níveis de concorrência:
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """Estima o KV Cache em GiB pela fórmula M_KV = 2 × L × H_KV × D × B × T × N."""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B: 80 camadas, 8 cabeças KV, dimensão 128, BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
O que é, afinal, a parede de memória no raciocínio de Agents com contexto longo?
Capacidade, largura de banda e SRAM são três dimensões independentes
Um dos erros mais comuns ao falar sobre a parede de memória é confundir “ter muita memória” com “ter memória rápida”. Na prática, o sistema de memória de um acelerador de IA envolve pelo menos três métricas independentes:
| Métrica | O que determina | O que significa para um Agent |
|---|---|---|
| Capacidade de HBM | Quantos dados podem ser armazenados | Quantos pesos do modelo e quantos KV Caches podem ser mantidos ao mesmo tempo — ou seja, quantos contextos simultâneos podem ser atendidos |
| Largura de banda da HBM | Quantos dados podem ser transferidos por unidade de tempo | Se os pesos e o KV Cache conseguem chegar rapidamente aos núcleos de computação a cada Token gerado |
| SRAM no chip | Armazenamento de alta velocidade mais próximo dos núcleos de computação | Se os dados acessados com frequência podem ficar no chip, reduzindo a espera por acessos repetidos à HBM |
A HBM é, essencialmente, uma DRAM que usa empilhamento de várias camadas e encapsulamento avançado para permitir acesso altamente paralelo. A SRAM é mais rápida e fica mais próxima das unidades de computação, mas tem alto custo por unidade de capacidade e ocupa uma área física limitada. Por isso, os aceleradores modernos costumam usar uma hierarquia de memória em vários níveis, em vez de buscar apenas aumentar a capacidade de um único tipo de memória.
Prefill e Decode têm necessidades de dados bem diferentes
A inferência de LLMs é dividida em duas etapas. Na etapa de Prefill, todo o contexto de entrada é processado de uma vez e o KV Cache é criado. Muitos Tokens podem ser calculados em paralelo, o que caracteriza uma tarefa intensiva em computação. Na etapa de Decode, os Tokens de saída são gerados um a um. Cada etapa processa apenas um novo Token, mas precisa ler todos os pesos e todo o KV Cache. Como o volume de computação é pequeno e o de transferência de dados é grande, essa etapa é intensiva em largura de banda.
Uma estimativa idealizada ajuda a entender a pressão sobre o Decode. O KV Cache de uma única solicitação com 128K ocupa cerca de 40 GiB (aproximadamente 43 GB), e é preciso ler tudo isso a cada Token gerado. Com a largura de banda de HBM de aproximadamente 8,6 TB/s por chip TPU 8i, só a leitura do KV Cache leva cerca de 5 milissegundos. Com os 17,2 TB/s do TPU 8i Max, o limite inferior fica em torno de 2,5 milissegundos. Essa estimativa ignora a leitura dos pesos, a sobreposição com a computação e a divisão paralela, mas já mostra que, quanto maior o contexto, mais o tempo de Decode passa a ser dominado pela transferência de dados, e não pela computação.
Por que as unidades de computação ficam “esperando pelos dados”?
Quando um núcleo de computação consegue realizar muito mais operações por segundo do que a memória consegue fornecer dados, a unidade fica ociosa enquanto espera. Isso é a parede de memória. Para um Agent, contextos longos aumentam a quantidade de dados lidos em cada etapa de Decode; alta concorrência aumenta o volume de KV Cache que precisa permanecer na memória; e várias rodadas de raciocínio exigem que o cache seja lido e atualizado repetidamente. Com esses três fatores combinados, os ganhos marginais de simplesmente aumentar o pico de desempenho computacional ficam cada vez menores.
🎯 Recomendação técnica: antes de avaliar sua aplicação de Agent, vale medir a latência até o primeiro Token (TTFT) e a velocidade de geração com diferentes comprimentos de contexto. Observe como a latência muda à medida que o contexto aumenta. Com a APIYI, em apiyi.com, você pode alternar entre modelos como Claude, Gemini e GPT usando a mesma chave API, o que facilita comparar o desempenho de cada modelo com contextos longos.
Como o encapsulamento de dois chips do TPU 8i Max amplia a largura de banda da memória
Como dois TPU 8i são combinados
O TPU 8i Max é a quarta configuração de sistema da oitava geração de TPUs. O Google percebeu que, quando vários agentes processam simultaneamente grandes bases de código, vídeos longos ou documentos complexos, o gargalo muitas vezes não está no poder de processamento, mas na velocidade com que os chips leem e trocam dados. A solução foi integrar dois TPU 8i de baixa latência no mesmo encapsulamento e colocar o dobro de silício na mesma área ocupada no rack.
| Indicador | TPU 8i | TPU 8i Max | Variação |
|---|---|---|---|
| Encapsulamento do chip | Chip único | Dois chips | — |
| Capacidade de processamento | Base | 2 vezes | Dobra |
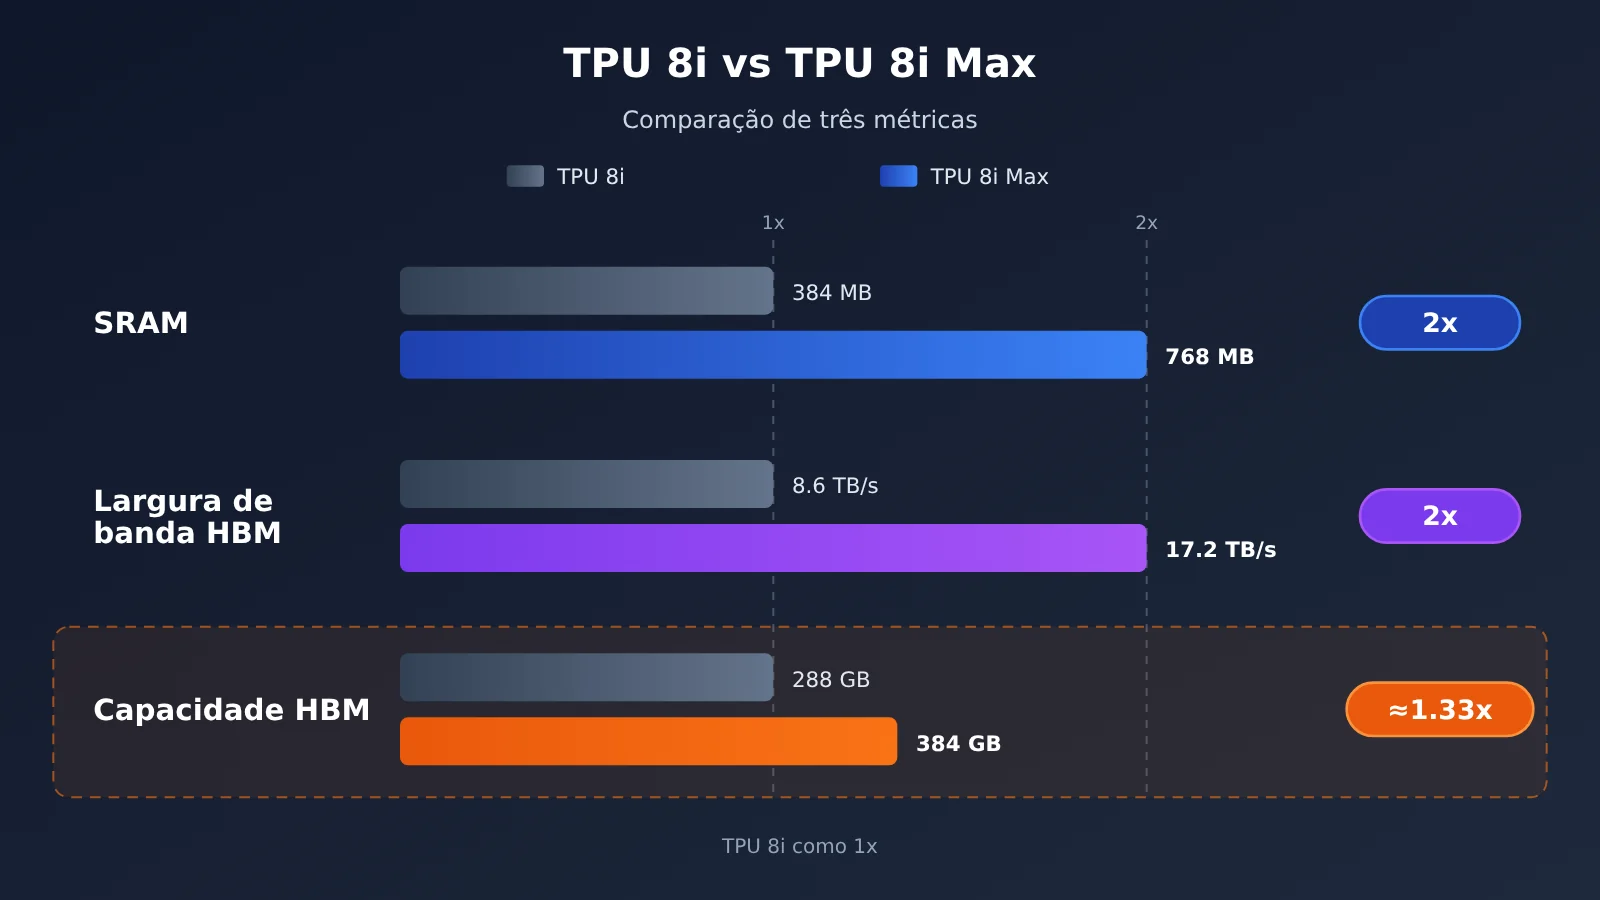
| SRAM no chip | 384 MB | 768 MB | Dobra |
| Largura de banda HBM | 8.601 GB/s | 17.200 GB/s | Aproximadamente o dobro |
| Capacidade HBM | 288 GB | 384 GB | Aumento de aproximadamente 33% |
Observação: os dados do TPU 8i vêm do artigo técnico de arquitetura do Google, publicado em abril de 2026. Os valores absolutos do TPU 8i Max foram divulgados em uma nota à imprensa em 9 de novembro. O artigo oficial confirma explicitamente que a capacidade de processamento, a SRAM e a largura de banda HBM dobraram.
Por que ampliar esses recursos em conjunto é mais importante do que aumentar apenas o poder de processamento
Se apenas a capacidade de processamento aumentar, a etapa de decodificação ficará ainda mais limitada pela largura de banda. Se apenas a largura de banda aumentar, as unidades de processamento podem ficar sem dados suficientes. O TPU 8i Max amplia a capacidade de processamento, a SRAM e a largura de banda HBM em proporções semelhantes, mantendo aproximadamente a relação entre “velocidade de fornecimento de dados e velocidade de processamento” no equilíbrio do projeto original. Com o dobro de SRAM, mais dados acessados com frequência permanecem no chip, reduzindo ainda mais as idas e voltas à HBM.
A capacidade HBM aumenta apenas cerca de 33%, não dobra
Esse é o detalhe mais fácil de informar errado. A largura de banda HBM dobra, passando de cerca de 8,6 TB/s para 17,2 TB/s, mas a capacidade HBM aumenta apenas cerca de 33%, de 288 GB para 384 GB. Considerando os cálculos anteriores, dá para entender o que isso significa: no TPU 8i Max, há mais largura de banda por GB de memória, então é mais rápido ler o mesmo volume de KV Cache. Mas o aumento na quantidade total de contexto que ele consegue “armazenar” ao mesmo tempo é muito menor do que o aumento na largura de banda.
Em outras palavras, o principal benefício do TPU 8i Max não é dobrar o limite de contexto de um único modelo, mas permitir que o sistema processe com mais eficiência um grande número de contextos simultâneos. Quando a capacidade não é suficiente, ainda é necessário recorrer a técnicas de software, como descarregamento de KV Cache, quantização e divisão entre vários chips.
Comparação da arquitetura de memória entre GPU e TPU 8i Max
Para entender o posicionamento da TPU 8i Max, podemos usar a arquitetura Rubin mais recente da NVIDIA como referência de GPU.
| Dimensão | GPU NVIDIA Rubin | Google TPU 8i Max |
|---|---|---|
| Unidade de medida | Uma GPU | Pacote com dois chips TPU |
| Capacidade de HBM | 288 GB HBM4 | 384 GB HBM (divulgado pela imprensa) |
| Largura de banda da HBM | 22 TB/s | 17.2 TB/s (divulgado pela imprensa) |
| Armazenamento no chip | Varia conforme a configuração da arquitetura | 768 MB de SRAM (divulgado pela imprensa) |
| Interconexão entre chips | NVLink 6 | Rede de baixa latência Boardfly (arquitetura TPU 8i) |
| Ecossistema de software | CUDA e principais mecanismos de inferência | JAX, TorchTPU e back-ends de TPU para vLLM / SGLang |
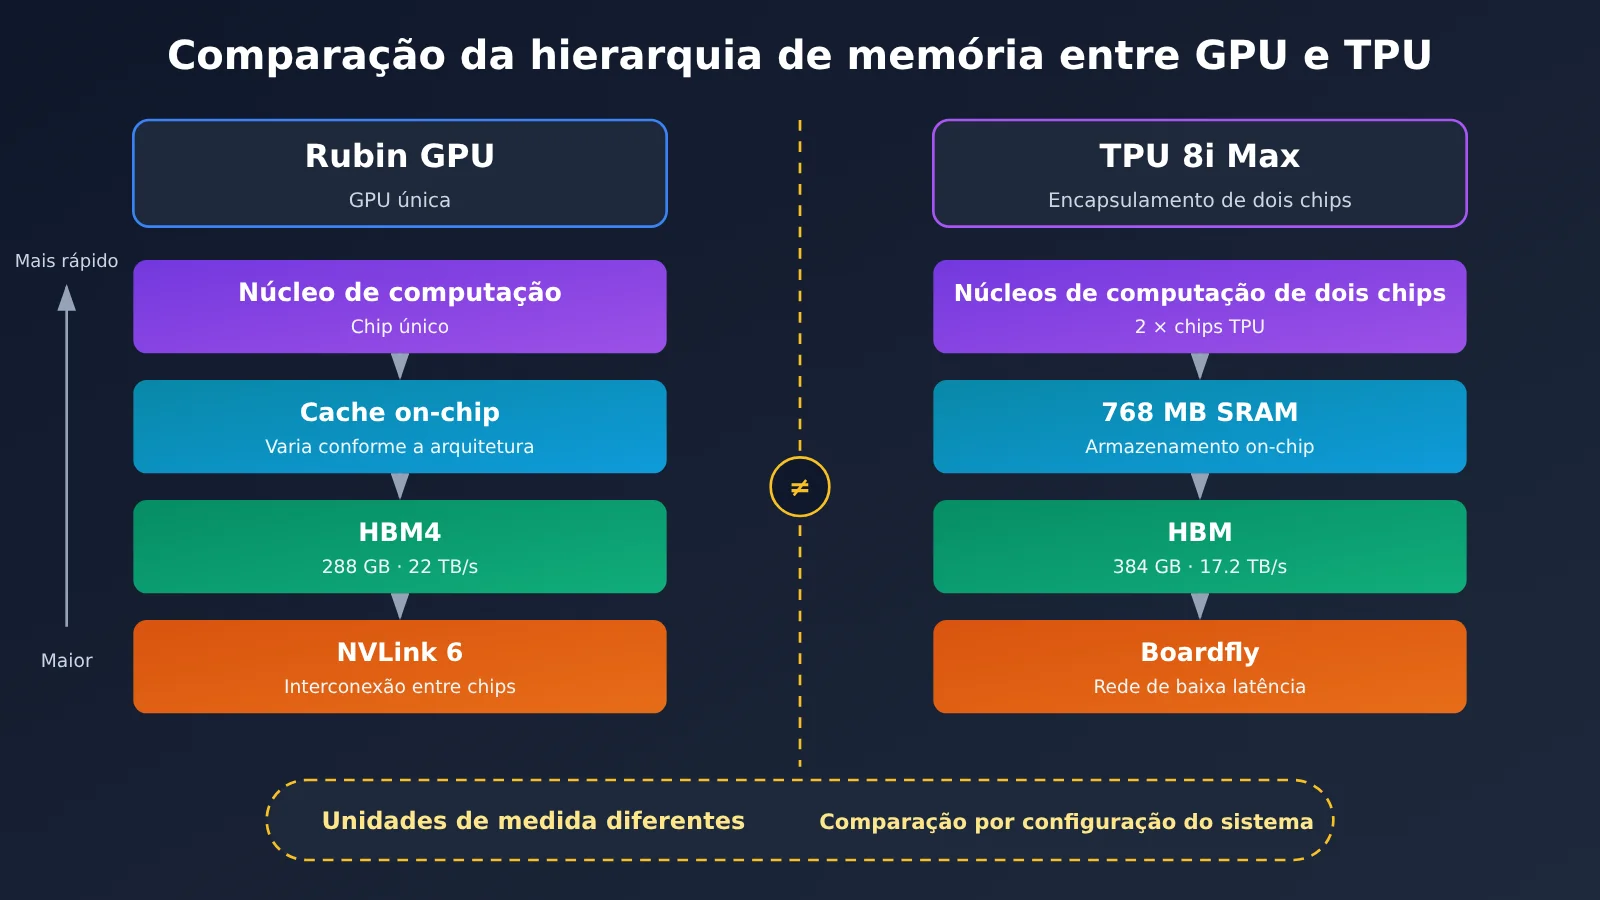
Esta tabela não deve ser usada para fazer uma classificação simplista. Os 384 GB e os 288 GB se referem a configurações diferentes: um pacote com dois chips, de um lado, e uma única GPU, do outro. A geração da HBM, o tipo de interconexão, a arquitetura de computação e a configuração do sistema completo também são diferentes. Considerando apenas a largura de banda, a Rubin individual é superior; considerando apenas a capacidade, a TPU 8i Max é maior. Mas nenhum desses aspectos deve ser analisado fora do contexto da escala do sistema.
O que vale a pena comparar é quanto contexto concorrente efetivo o sistema inteiro consegue sustentar de forma estável com o mesmo consumo de energia, espaço no rack e custo — e qual é a taxa de transferência, a latência e a eficiência energética ao manter esses contextos. Até 10 de novembro de 2026, ainda não há testes independentes e publicamente verificáveis da TPU 8i Max. Para fazer esse tipo de comparação no nível do sistema, será preciso aguardar os dados após o lançamento comercial.
💡 Recomendação: para a maioria das equipes que desenvolvem agentes por meio de APIs, não é necessário decidir se a infraestrutura subjacente usa GPU ou TPU. Na prática, é mais útil comparar a latência e o preço por unidade de diferentes modelos em contextos longos. Você pode testar vários modelos em paralelo pela interface unificada da APIYI, em apiyi.com, usando comandos da sua operação real.
Análise do impacto do TPU 8i Max para desenvolvedores de agentes
Diferencie janela de contexto, concorrência real e latência de inferência
A janela de contexto informada pelo modelo indica apenas “quanto cabe em teoria”. Isso não significa que o servidor consiga manter essa quantidade de sessões simultâneas nem que a latência seja aceitável nesse comprimento. Os cálculos anteriores já mostraram que, para a mesma janela de contexto de 128K, o cache KV de 8 sessões é 8 vezes maior que o de uma única sessão. Para quem desenvolve, é importante analisar estes três indicadores separadamente:
- Janela de contexto: o tamanho máximo que o modelo consegue processar, determinando quantas informações cabem em uma única chamada
- Capacidade real de concorrência: quantas sessões longas podem ser mantidas ao mesmo tempo no hardware disponível, limitada pela capacidade de HBM
- Latência de inferência: o TTFT depende do volume de cálculo do Prefill; a velocidade de geração de tokens depende da largura de banda e do tamanho do cache KV
Três técnicas que estão se popularizando para reduzir o problema
O hardware resolve apenas metade do problema da parede de memória; a outra metade está no software. O TPU Sync, que o Google também lançou como código aberto, além das versões do vLLM e do SGLang para TPU, se baseiam nas técnicas a seguir:
| Técnica | Problema que resolve | Custos ou pontos de atenção |
|---|---|---|
| Descarregamento de KV Cache | Transfere caches que não estão sendo usados temporariamente da HBM para a DRAM do host, um SSD ou armazenamento compartilhado, superando o limite de capacidade | A recuperação exige tempo de transferência e depende de DMA eficiente e transmissão assíncrona |
| Quantização de KV Cache | Reduz o número de bytes por elemento, diminuindo diretamente o uso de capacidade e largura de banda | É preciso avaliar o impacto na precisão |
| Separação entre Prefill e Decode | Distribui o Prefill, intensivo em computação, e o Decode, intensivo em largura de banda, entre nós diferentes | É preciso transferir o KV Cache rapidamente entre os nós |
| Cache de prefixos | Reutiliza o mesmo comando de sistema e os mesmos prefixos do histórico para evitar a repetição do Prefill | Depende da frequência com que os prefixos das solicitações se repetem |
Os dados divulgados pelo Google para o TPU Sync mostram que a latência de transferência do KV Cache pode cair mais de 90%, e que, em cenários com cache de prefixo para contextos de 64K, o TTFT pode diminuir em até 90%. No entanto, esses testes foram feitos com a TPU Ironwood de sétima geração. Além disso, o README do GitHub lista atualmente v7x e v6e como os hardwares validados ativamente; portanto, esses resultados não podem ser atribuídos diretamente à TPU 8i Max.
Impacto real no desempenho e no custo de recursos
Para quem chama a API, essas otimizações de baixo nível acabam se refletindo em dois pontos: se a latência de solicitações com contexto longo permanece estável e se o custo por Token diminui. No lado da aplicação, você também pode adotar a ideia de “ocupar menos memória”: simplifique o comando do sistema e mantenha o prefixo estável para aproveitar o cache, resuma as saídas das ferramentas antes de reinseri-las no contexto e passe aos subagentes apenas os trechos necessários, em vez de todo o histórico.
O exemplo abaixo mede a latência até o primeiro Token com saída em streaming para diferentes tamanhos de contexto, facilitando a observação do impacto do crescimento do contexto no Prefill:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
Ver o código de teste em lote para vários modelos e tamanhos
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Uma única chave para alternar entre vários modelos
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # Número de repetições do trecho, usado para ampliar aproximadamente o contexto

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 Comece rápido: cadastre-se em APIYI apiyi.com para receber créditos de teste gratuitos. Mantenha
base_urlcomohttps://api.apiyi.com/v1no script acima e, em poucos minutos, você terá curvas de TTFT de vários modelos para diferentes tamanhos de contexto.
Impacto no setor
- A personalização em nível de sistema ganha velocidade: ao usar a abordagem de “mesmo chip, sistemas diferentes”, o Google lançou rapidamente configurações voltadas a cargas de trabalho específicas. Isso mostra que a concorrência entre aceleradores está deixando de se concentrar nos parâmetros de um único chip e passando a priorizar o design do sistema.
- A integração entre software e hardware se torna padrão: o TPU 8i Max foi lançado junto com o TPU Sync, o Agent Compute Engine e um mecanismo de inferência para TPU. A solução para o gargalo de memória depende tanto da largura de banda do hardware quanto do escalonamento de software.
- A comercialização ainda está no início: assim como o 8t, o 8i e o 8tx, o TPU 8i Max está marcado como Coming soon. Ainda não há preço público nem data oficial de disponibilidade; sua relação custo-benefício ainda precisa ser verificada na prática.
Perguntas frequentes (FAQ)
Q1: O que é o TPU 8i Max?
O TPU 8i Max é uma configuração de sistema TPU de oitava geração anunciada pelo Google em 9 de novembro de 2026. Ela integra dois TPUs 8i no mesmo encapsulamento, dobrando a capacidade de computação, a SRAM integrada e a largura de banda da HBM em relação ao TPU 8i. O sistema foi projetado principalmente para inferência com contextos longos, alta concorrência e colaboração entre vários agentes. Não se trata de um chip totalmente novo.
Q2: A capacidade de HBM do TPU 8i Max dobrou?
Não. Segundo as informações divulgadas no briefing para a imprensa, a capacidade de HBM aumentou de 288 GB para 384 GB, um acréscimo de cerca de 33%. O que dobrou foi a largura de banda da HBM (de aproximadamente 8,6 TB/s para 17,2 TB/s) e a SRAM (de 384 MB para 768 MB). Capacidade e largura de banda são métricas distintas e não devem ser confundidas.
Q3: Já é possível usar o TPU 8i Max? Qual é o preço?
Em 10 de novembro de 2026, a página oficial do produto no Google Cloud indicava o TPU 8i Max como Coming soon. Ainda não foram divulgados um preço público ou uma data oficial de disponibilidade geral (GA), e também não há testes de desempenho independentes que possam ser verificados publicamente. Por enquanto, as únicas referências disponíveis são as declarações oficiais do Google e os parâmetros do briefing para a imprensa.
Q4: O TPU 8i Max permite que um único modelo tenha contexto de milhões de tokens?
O Google cita contextos na faixa de milhões de tokens como um cenário de uso pretendido, mas isso não corresponde a uma especificação máxima fixa já divulgada. O tamanho do contexto que um modelo consegue processar depende, antes de tudo, do próprio modelo. O hardware determina quantas solicitações simultâneas podem ser atendidas nesse tamanho e se a latência continua aceitável.
Q5: Como desenvolvedores de aplicativos podem verificar o impacto de contextos longos na latência?
A forma mais direta é medir o TTFT e a velocidade de geração usando contextos reais do negócio com diferentes tamanhos:
1. Acesse APIYI apiyi.com, crie uma conta e obtenha uma chave API e uma cota gratuita para testes.
2. Use o script de teste deste artigo e defina `base_url` como `https://api.apiyi.com/v1`.
3. Com o mesmo conjunto de contextos, alterne entre vários modelos e compare como a latência aumenta conforme o tamanho do contexto cresce.
Q6: Quais são as limitações da quantização e do descarregamento do KV Cache?
A quantização reduz diretamente o uso de memória e de largura de banda, mas pode causar perda de precisão. Por isso, é preciso avaliá-la na tarefa desejada. O descarregamento ajuda a superar os limites de capacidade da HBM, mas a recuperação dos dados exige tempo de transferência. Se a transferência entre os níveis de armazenamento não for rápida o suficiente, a latência pode até aumentar. Nos dois casos, é necessário ajustar os parâmetros considerando o nível de concorrência e as metas de latência.
Principais conclusões sobre contexto longo em agentes e TPU 8i Max
- O gargalo mudou: a inferência de agentes está deixando de depender apenas do poder computacional e passando a exigir equilíbrio entre processamento e fornecimento de dados pela memória.
- O KV Cache cresce linearmente: no Llama 3.1 70B, cada token ocupa cerca de 320 KiB; uma única solicitação com 128K tokens consome aproximadamente 40 GiB.
- GQA é essencial: com 8 cabeças KV, o cache ocupa apenas um oitavo do espaço usado pela atenção multi-head padrão.
- A decodificação depende da largura de banda: para gerar cada token, é preciso ler o KV Cache inteiro. Com contextos longos, a largura de banda passa a determinar a latência.
- Escalonamento sincronizado: na TPU 8i Max, o poder computacional, a SRAM e a largura de banda da HBM dobram juntos, enquanto a capacidade da HBM aumenta apenas cerca de 33%.
- O software também importa: transferência de dados, quantização, separação entre prefill e decodificação e cache de prefixo são os principais recursos para reduzir o impacto do gargalo de memória.
- Teste na prática: use a interface unificada da APIYI, em apiyi.com, para comparar a latência de contexto longo de vários modelos.
Resumo
Os principais pontos sobre o gargalo de memória na inferência de agentes com contexto longo:
- Origem da pressão: códigos, resultados de ferramentas e saídas de subagentes se acumulam continuamente. Com vários agentes em execução simultânea, o KV Cache pode crescer ainda mais.
- Abordagem de hardware: a TPU 8i Max não se limita a aumentar o poder computacional. Ela amplia em conjunto a capacidade de processamento, a SRAM e a largura de banda da HBM para equilibrar o processamento e o fornecimento de dados.
- Limites de aplicação: o aumento da capacidade da HBM é limitado, e o produto ainda não está disponível comercialmente. Seu valor real depende de testes em nível de sistema.
Para a maioria dos desenvolvedores, o mais prático neste momento é entender a estrutura de custos do KV Cache, controlar o crescimento do contexto na aplicação e acompanhar as mudanças na latência e nos preços dos serviços de modelos para contextos longos. Recomendamos usar a APIYI, em apiyi.com, para comparar o desempenho de vários modelos com dados reais de negócio. A plataforma oferece uma interface compatível com a OpenAI e créditos gratuitos para novos usuários.
📚 Referências
- Google Cloud Blog – Apresentação do TPU 8tx e do TPU 8i Max: anúncio técnico oficial do lançamento
- Link:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Observação: confirma o encapsulamento com dois chips e o dobro da capacidade de computação, da SRAM e da largura de banda da HBM
-
Google Cloud – Por dentro da TPU de oitava geração: análise detalhada da arquitetura da TPU de oitava geração
- Link:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
Observação: especificações originais da TPU 8i e arquitetura de rede Boardfly
-
Google Cloud – Apresentação do TPU Sync: biblioteca para transferência de KV Cache e pesos
- Link:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Observação: arquitetura de memória multinível e dados de testes de KV Cache Offloading (baseados no Ironwood)
-
Network World – Google mira os próximos gargalos de infraestrutura de IA: cobertura da coletiva de imprensa
- Link:
networkworld.com/article/4245897 -
Observação: valores absolutos de capacidade e largura de banda da HBM e da SRAM do TPU 8i Max
-
GitHub do Google TPU Sync: repositório de código aberto
- Link:
github.com/google/tpu-sync - Observação: informações sobre compatibilidade de hardware e status do desenvolvimento
Autor: Equipe técnica da APIYI
Contato para conversas técnicas: fale conosco pela página inicial do site da APIYI. Para mais informações sobre integração, acesse o centro de documentação em docs.apiyi.com.