Nota do autor: gpt-6-sol e gpt-6.1-sol têm o mesmo preço de entrada e saída, mas o multiplicador para leitura de cache é duas vezes menor no segundo. Este artigo mostra como reduzir o custo de cache em conversas longas alterando apenas o campo model da solicitação.
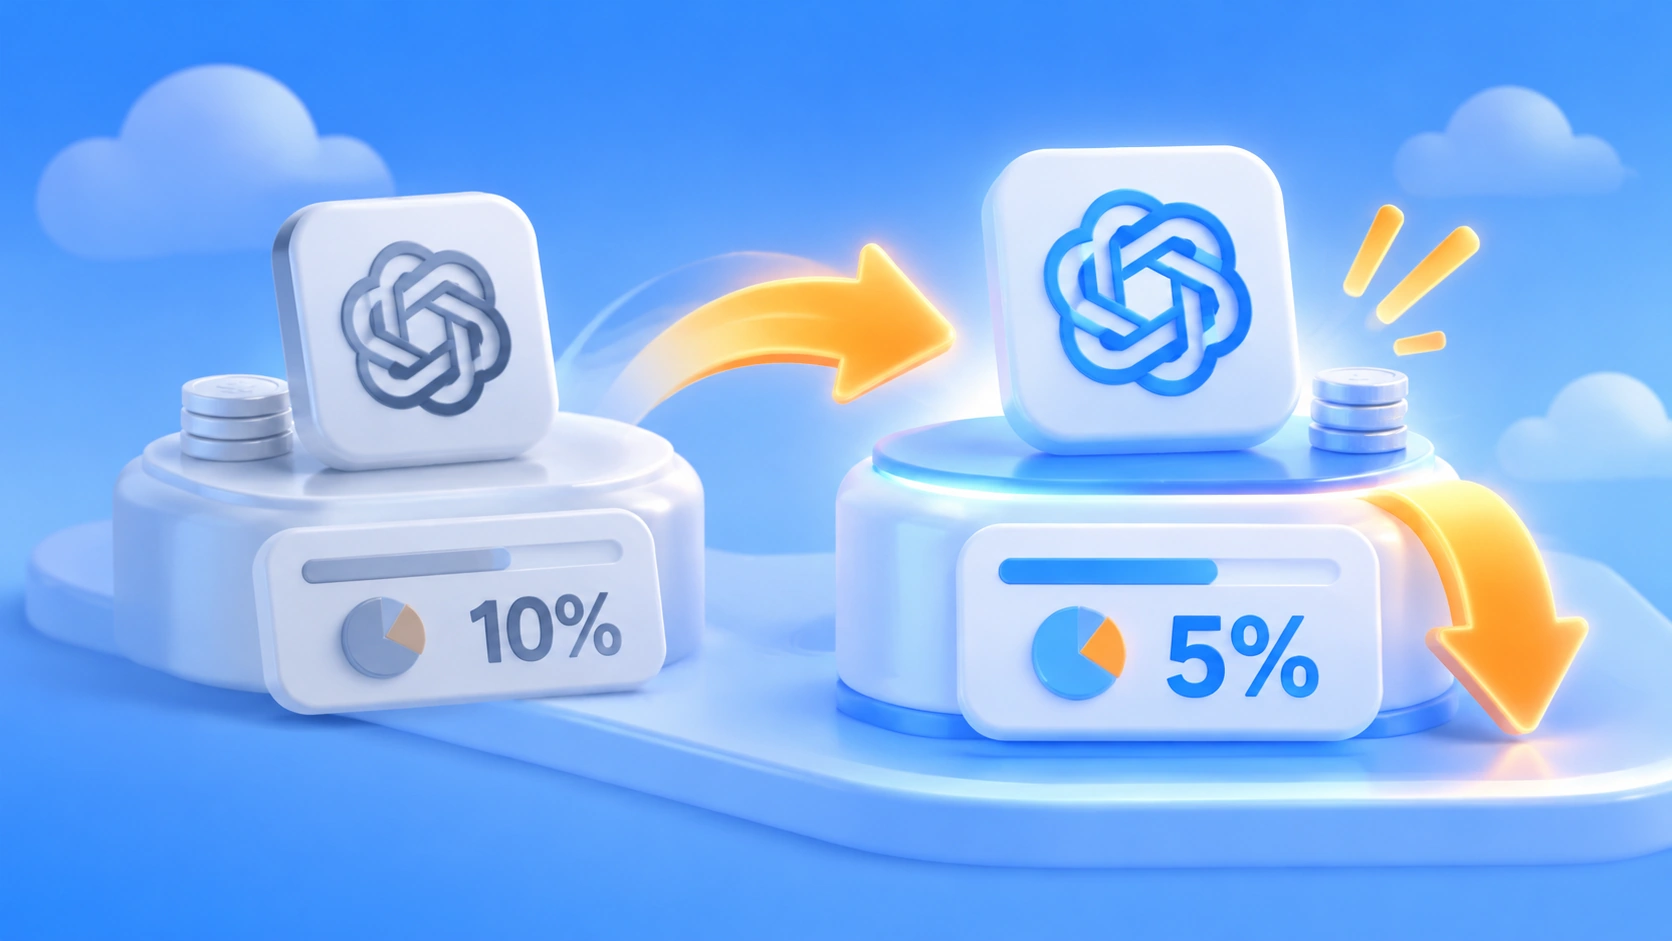
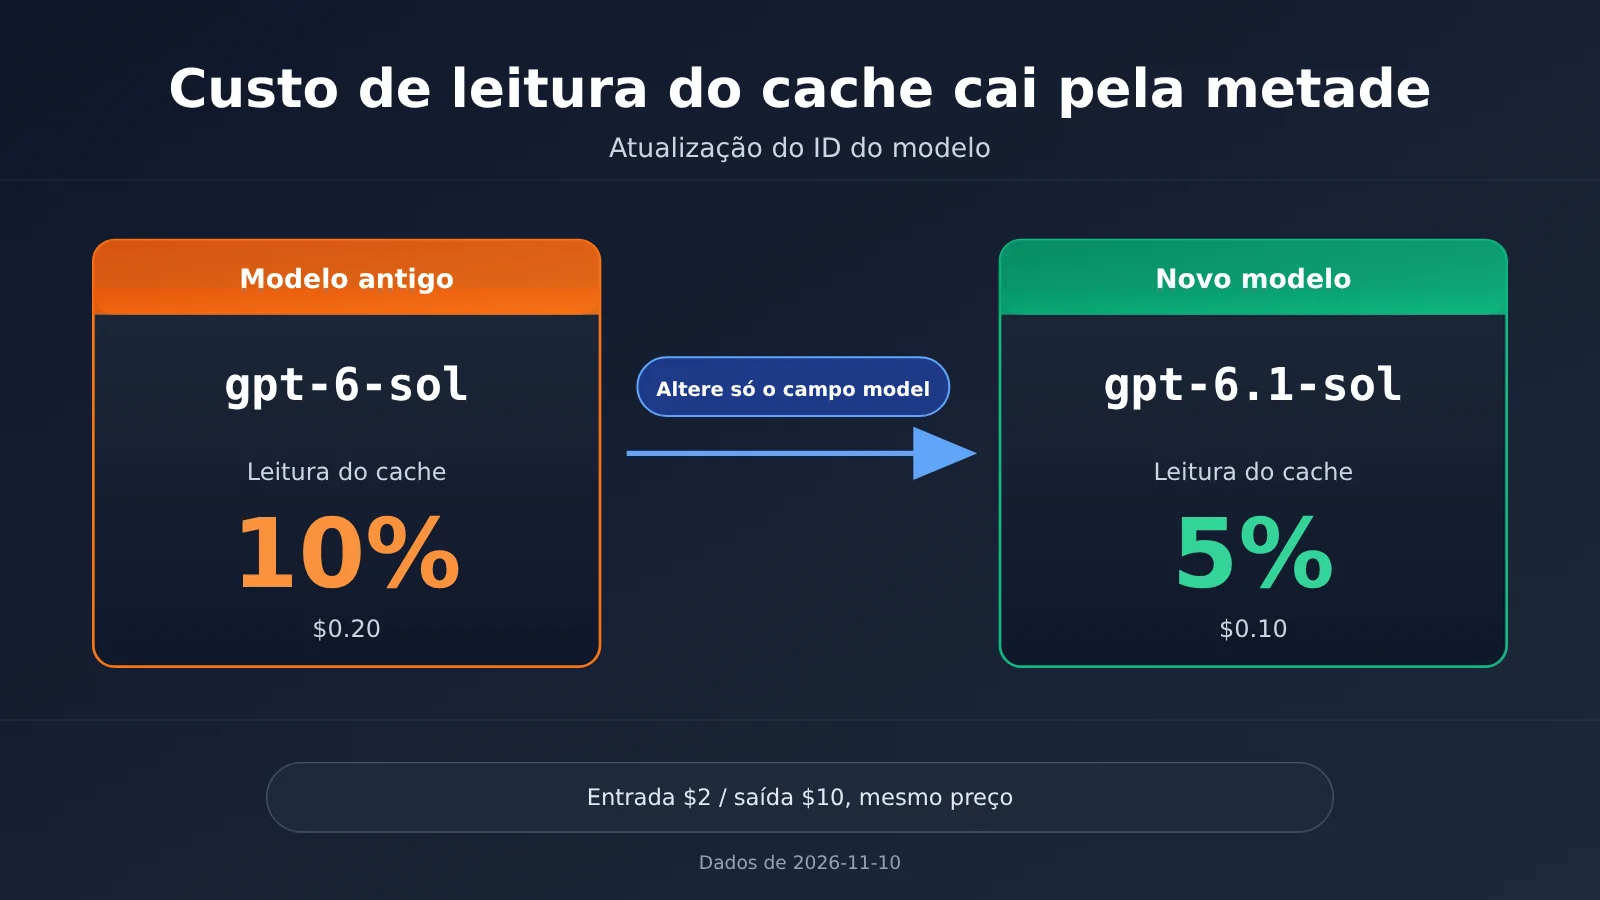
Muitos desenvolvedores já usam 6.1 Sol, 6.1 Terra e 6 Luna no dia a dia. Mas, ao abrir a configuração do projeto, podem encontrar uma solicitação de um serviço antigo ainda usando gpt-6-sol. Este artigo apresenta uma mudança simples: trocar gpt-6-sol por gpt-6.1-sol. O preço de entrada e saída não muda, mas o custo da leitura de cache cai de 10% para 5% do preço de entrada.
Isso não é uma promoção nem significa que você precisa mudar de plano. A diferença de preço entre as duas versões do Sol aparece diretamente na tabela oficial de preços da OpenAI, e os multiplicadores na lista da plataforma APIYI seguem os valores oficiais. Basta alterar uma string na solicitação.
Principal benefício: ao terminar este artigo, você saberá qual ID de modelo alterar, quanto poderá economizar na leitura de cache e por que não deve generalizar essa redução pela metade para modelos além do Terra e do Luna — especialmente, não para o Luna.
Principais pontos sobre os preços do gpt-6-sol e do gpt-6.1-sol
Vamos começar pela tabela mais importante. Todos os preços são por milhão de tokens. Os dados são de 2026-11-10, com base na tabela oficial da OpenAI para o nível padrão, e foram conferidos com os multiplicadores retornados pela API de preços da APIYI.
| ID do modelo | Preço de entrada | Preço de saída | Preço de leitura em cache | Leitura em cache como % do preço de entrada |
|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 10% |
gpt-6.1-sol |
$2 | $10 | $0.10 | 5% |
A tabela deixa claro um ponto: os dois modelos Sol têm exatamente os mesmos preços de entrada e saída. A única diferença está na leitura em cache. Em solicitações curtas de uma única rodada, quase não dá para perceber essa diferença. Mas, em cenários que repetem comandos de sistema longos, definições extensas de ferramentas ou históricos longos de conversa, os tokens lidos do cache costumam representar boa parte da entrada da solicitação. Uma diferença de duas vezes no multiplicador se acumula ao longo do tempo.
Por que vale a pena prestar atenção à leitura em cache do gpt-6.1-sol
O Prompt Cache funciona assim: quando o prefixo de uma solicitação é igual ao de uma solicitação anterior, esses tokens são cobrados pelo preço de leitura em cache, e não pelo preço integral de entrada. Aplicativos como agentes, assistentes de programação e bots de atendimento enviam novamente o mesmo comando de sistema e o histórico de mensagens a cada rodada, por isso costumam ter uma alta taxa de acerto no cache.
Nesse tipo de carga de trabalho, o preço unitário da leitura em cache costuma afetar a fatura de forma mais direta do que o preço de entrada. A leitura em cache do gpt-6-sol custa $0.20, enquanto a do gpt-6.1-sol custa $0.10. Com a mesma quantidade de tokens atendidos pelo cache, o primeiro custa o dobro. Se o seu serviço ainda usa o ID antigo e mantém conversas longas, você acaba pagando continuamente a mais pelo mesmo contexto.
Como os multiplicadores da plataforma correspondem aos preços oficiais
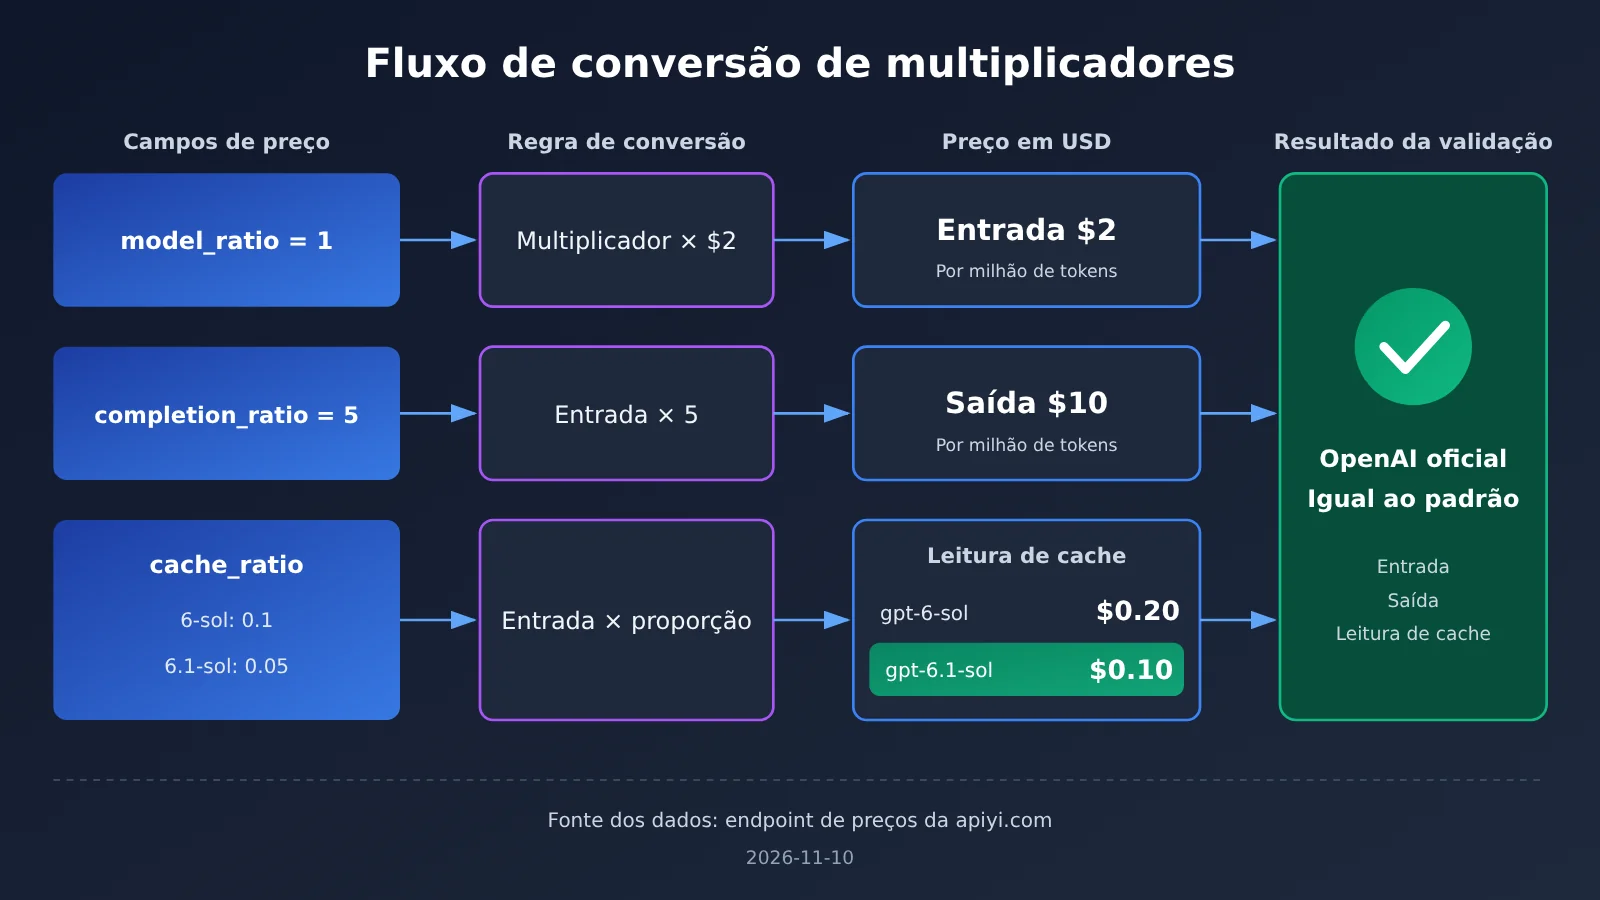
A tabela de preços da APIYI expressa os preços por meio de multiplicadores. Nos dados retornados em 2026-11-10, os dois modelos Sol aparecem na lista com os seguintes multiplicadores:
| Campo | gpt-6-sol |
gpt-6.1-sol |
Significado |
|---|---|---|---|
| model_ratio | 1 | 1 | Multiplicador 1 corresponde a uma entrada de $2 por milhão de tokens |
| completion_ratio | 5 | 5 | A saída custa 5 vezes o valor da entrada, ou seja, $10 |
| cache_ratio | 0.1 | 0.05 | A leitura em cache custa 10% / 5% do valor da entrada |
Usando como referência “multiplicador 1 = entrada a $2 por milhão de tokens”, os dois modelos custam $2 na entrada e $10 na saída; a leitura em cache custa, respectivamente, $0.20 e $0.10. Os valores correspondem exatamente à tabela oficial. Vale lembrar que esse cálculo considera apenas os multiplicadores do próprio modelo, sem incluir multiplicadores de grupo. Para saber o valor final, consulte o grupo associado à sua conta e a lista de modelos da plataforma. Para conferir os preços, acesse diretamente a página de preços dos modelos da APIYI em apiyi.com e verifique esses três multiplicadores.
Como calcular o custo de cache em sessões longas com o gpt-6.1-sol
Olhar só para o preço por token não deixa a diferença muito clara. Veja este exemplo simples: suponha que uma sessão de Agent tenha 100 rodadas e que, em cada solicitação, cerca de 50 mil tokens do prefixo sejam atendidos pelo cache. Ao longo de toda a sessão, isso totaliza 5 milhões de tokens lidos do cache.
| Item de cálculo | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| Total de tokens lidos do cache | 5 milhões | 5 milhões |
| Preço por milhão de tokens lidos do cache | $0.20 | $0.10 |
| Custo de leitura do cache | $1.00 | $0.50 |
| Entrada e saída | Mesmo preço | Mesmo preço |
Esse é o valor de uma única sessão. Se você tiver milhares de sessões semelhantes por dia, a leitura do cache representa uma economia consistente de 50%. Como os preços de entrada e saída são exatamente os mesmos, trocar para gpt-6.1-sol não aumenta o custo das outras partes: a economia vem justamente da redução pela metade na leitura do cache.
Claro, esse exemplo pressupõe que o cache realmente seja acionado. Se o prefixo das solicitações mudar a cada vez — por exemplo, porque você coloca um timestamp ou um ID aleatório no início do comando de sistema —, a taxa de acerto do cache será muito baixa, e o ganho de trocar o ID do modelo também será limitado. Nesse caso, coloque primeiro o conteúdo fixo e deixe o conteúdo variável para o final. Depois, considere trocar o ID: assim, o resultado será mais expressivo.
Guia rápido: como trocar gpt-6-sol por gpt-6.1-sol
A mudança é bem pequena: os dois IDs de modelo estão disponíveis hoje na lista de modelos da APIYI, e você pode usar a mesma chave API para fazer chamadas, sem precisar contratar ou comprar um novo plano. Basta alterar o campo model no corpo da requisição.
Método simples: faça a troca em 3 etapas
- Localize o ID antigo: faça uma busca global por
gpt-6-solno repositório e no centro de configurações. Tome cuidado para não alterar strings que já usam o novo ID, comogpt-6.1-sol. Para evitar isso, procure o valor completo entre aspas. - Altere o campo model: troque
model="gpt-6-sol"pormodel="gpt-6.1-sol". Mantenha a inicialização do cliente como está, combase_url="https://api.apiyi.com/v1"e sua chave API atual. - Valide com uma pequena parte do tráfego: faça a troca primeiro em uma parte das requisições e confira o campo de tokens em cache no
usageretornado. Depois de confirmar que os acertos de cache estão normais, aplique a mudança a todas as requisições.
Com o SDK oficial do Python da OpenAI, por exemplo, a inicialização do cliente fica assim: client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Na chamada client.chat.completions.create(model="gpt-6.1-sol", messages=messages), basta alterar o valor de model. Não é necessário mexer em messages nem nos outros parâmetros.
Recomendamos centralizar a configuração
Se o nome do modelo estiver escrito diretamente em vários pontos do projeto, aproveite a troca para centralizá-lo em uma configuração. Você pode, por exemplo, definir o ID do modelo em uma variável de ambiente, como OPENAI_MODEL=gpt-6.1-sol, e acessá-la no código com os.getenv("OPENAI_MODEL", "gpt-6.1-sol"). Assim, quando uma nova versão for lançada, você só precisará alterar uma configuração, em vez de procurar e substituir o valor em todo o repositório.
Também recomendamos ler as configurações do cliente a partir de variáveis de ambiente, como OPENAI_BASE_URL=https://api.apiyi.com/v1. Como a interface é compatível com a OpenAI, você pode continuar usando o SDK, o LangChain e vários frameworks de agentes como antes. Basta conferir os valores de base_url e model.
🚀 Comece agora: antes de trocar o ID, confira na lista de modelos da APIYI, em apiyi.com, se
gpt-6.1-solestá disponível para o seu grupo de conta. Depois de confirmar, a troca se resume a alterar uma string no campomodelda requisição. Novos usuários também podem usar a cota de teste gratuita para validar o modelo com uma pequena parte do tráfego.
Armadilhas comuns durante a troca
- Alterar apenas alguns serviços: o serviço principal usa o novo ID, mas tarefas agendadas e scripts de processamento em lote offline continuam com o ID antigo. Nesse caso, você verá os dois modelos na fatura.
- Lista de permissões de modelos no gateway: se o gateway interno ou a camada de proxy validar os nomes dos modelos por uma lista de permissões, adicione
gpt-6.1-solantes de fazer a troca. - Logs e monitoramento agrupados por nome do modelo: se os painéis calcularem os custos por modelo, acompanhe os IDs novo e antigo em conjunto depois da troca. Caso contrário, você pode pensar, por engano, que o volume de chamadas diminuiu.
Comparação dos descontos de cache de gpt-6.1-sol, Terra e Luna
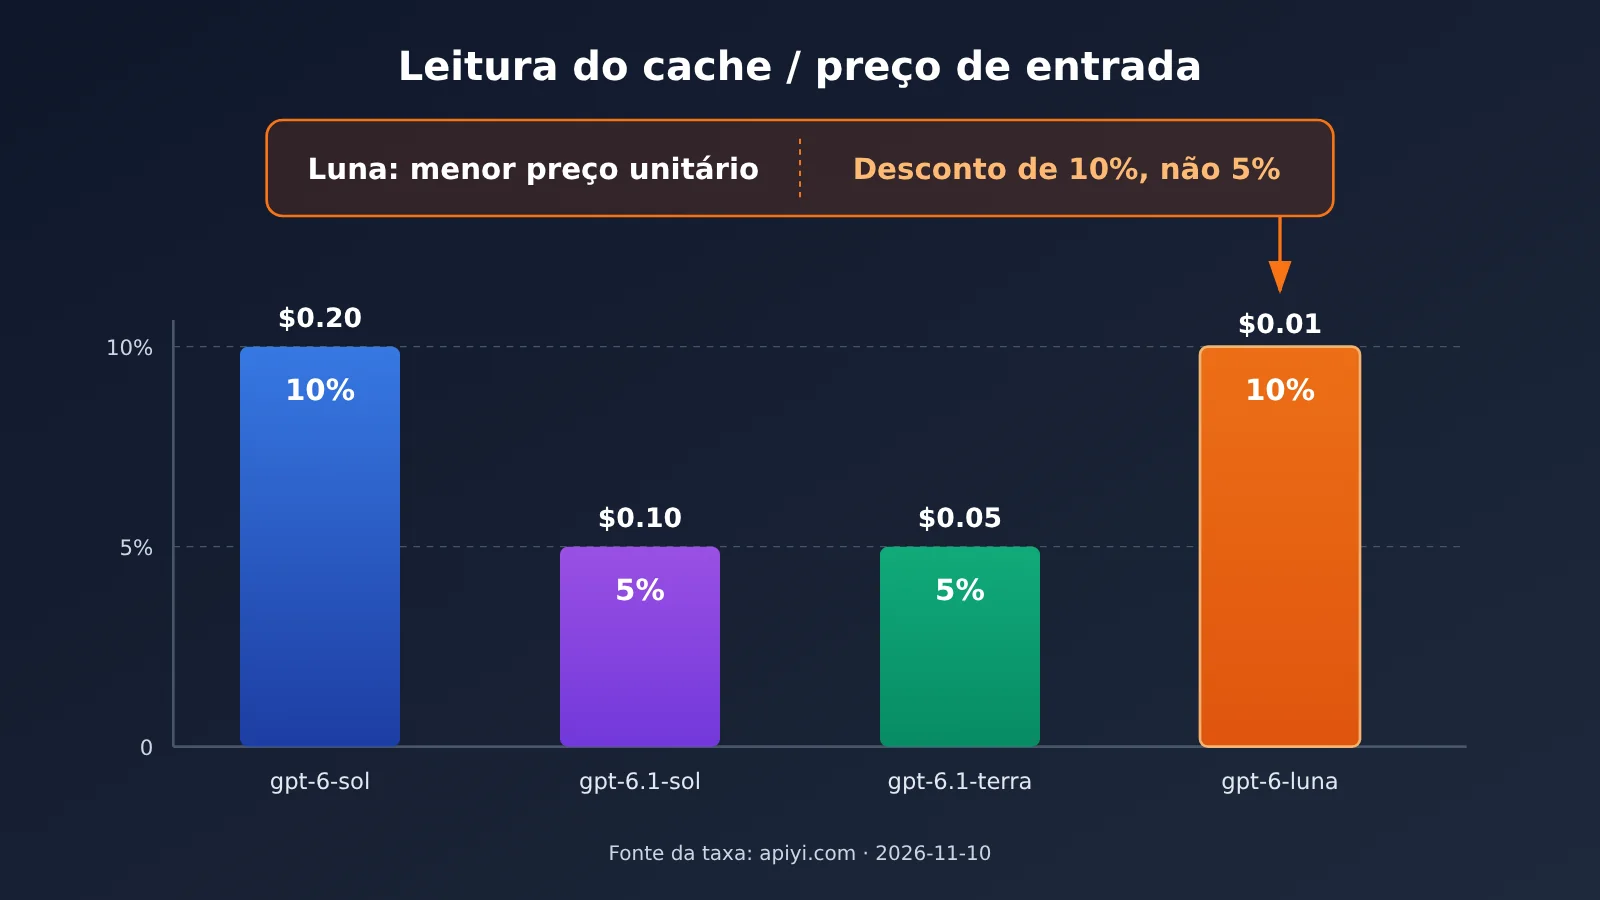
Muitos desenvolvedores usam vários modelos ao mesmo tempo e acabam chegando a uma conclusão intuitiva: se a leitura em cache do Sol 6.1 custa 5%, será que os outros modelos também seguem essa regra? Na prática, o multiplicador da leitura em cache é definido para cada modelo e não pode ser generalizado. Veja a comparação dos preços oficiais e dos multiplicadores da plataforma na mesma data:
| ID do modelo | Preço de entrada | Preço de saída | Preço de leitura em cache | cache_ratio | Plataformas disponíveis |
|---|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 0.1 | APIYI apiyi.com, OpenAI oficial |
gpt-6.1-sol |
$2 | $10 | $0.10 | 0.05 | APIYI apiyi.com, OpenAI oficial |
gpt-6.1-terra |
$1 | $5 | $0.05 | 0.05 | APIYI, OpenAI oficial |
gpt-6-luna |
$0.10 | $0.50 | $0.01 | 0.1 | APIYI, OpenAI oficial |
Análise comparativa
Comparação com Terra: a leitura em cache de gpt-6.1-terra também custa 5% do preço de entrada, e o preço unitário absoluto é ainda menor. Mas este artigo discute qual ID usar dentro da mesma faixa do Sol. Terra pertence a outra faixa de capacidade; decidir se vale a pena trocar Sol por Terra é uma questão de escolha do modelo e não faz parte do escopo desta mudança.
Comparação com Luna: gpt-6-luna tem o menor preço unitário absoluto, e a leitura em cache custa apenas $0.01. Porém, o desconto de cache é de 10% do preço de entrada, não de 5%. Portanto, a conclusão de que “trocar Sol por 6.1 reduz pela metade o custo de cache” só vale para a faixa do Sol. Não use essa regra para estimar o orçamento de Luna.
💡 Sugestão: se sua tarefa exige a capacidade da faixa do Sol, trocar o ID antigo diretamente por
gpt-6.1-solé a opção com benefício mais previsível e menor risco. Se você está avaliando uma redução de custos ao mudar de faixa, use a mesma chave API na APIYI para testar diferentes modelos e compare os resultados. Depois, estime o custo real considerando os multiplicadores de cache.
Perguntas frequentes (FAQ)
Q1: Qual é exatamente a diferença de preço entre gpt-6-sol e gpt-6.1-sol?
A diferença está apenas na leitura em cache. A entrada custa US$ 2 por milhão de tokens e a saída, US$ 10 para ambos. A leitura em cache custa US$ 0,20 no `gpt-6-sol` e US$ 0,10 no `gpt-6.1-sol`, ou seja, 10% e 5% do preço de entrada, respectivamente. Dados de 10/11/2026: os preços oficiais e os multiplicadores da plataforma coincidem.
Q2: Preciso comprar outro plano ou criar uma nova conta para mudar para o gpt-6.1-sol?
Não. Os dois IDs de modelo estão na lista de modelos da APIYI, e você pode usar a mesma chave API para fazer chamadas. Basta alterar o campo `model` na solicitação. O `base_url` e o método de autenticação do cliente continuam iguais.
Q3: Como converter os multiplicadores da APIYI em preços em dólares?
Considerando que “multiplicador 1 = US$ 2 de entrada por milhão de tokens”: `model_ratio` igual a 1 corresponde a US$ 2 de entrada; `completion_ratio` igual a 5 corresponde a US$ 10 de saída; e `cache_ratio` igual a 0.05 corresponde a US$ 0,10 por leitura em cache. O valor efetivamente cobrado também depende do grupo da conta. Consulte a lista de modelos da APIYI em apiyi.com.
Q4: Em quais cenários a mudança para o gpt-6.1-sol traz mais benefícios?
Principalmente em cenários de contexto longo e alta taxa de acerto do cache:
– **Agentes com várias interações**: o prompt do sistema, as definições de ferramentas e o histórico de mensagens são enviados novamente a cada interação.
– **Assistentes de código**: o mesmo conjunto de arquivos do repositório é enviado repetidamente como contexto.
– **Perguntas e respostas com base em uma base de conhecimento**: um prefixo fixo com documentos longos é combinado com perguntas variáveis dos usuários.
Q5: Também posso estimar que Luna e Terra têm “metade do preço na leitura em cache”?
Não é possível fazer essa generalização. A leitura em cache do `gpt-6.1-terra` custa 5% do preço de entrada, enquanto a do `gpt-6-luna` custa 10%. O Luna tem o menor preço absoluto por unidade, mas o percentual de desconto no cache não é de 5%. Para estimar o orçamento, calcule cada modelo usando seu próprio `cache_ratio`.
Q6: Por que a conta não caiu muito depois que mudei o ID?
O motivo mais comum é uma baixa taxa de acerto do cache. Por exemplo, se o prefixo da solicitação contém um carimbo de data e hora ou um campo aleatório, cada chamada pode ser cobrada como entrada completa. Outra possibilidade é que alguns serviços ainda estejam usando o ID antigo. Confira os campos de tokens em cache no `usage` da resposta e consulte no console da APIYI os detalhes das chamadas por modelo.
Q7: A qualidade das respostas pode mudar depois da troca?
Os dois modelos pertencem ao mesmo nível de capacidade, mas versões diferentes podem apresentar resultados distintos em tarefas específicas. Para fazer a mudança com segurança, compare os modelos primeiro com uma pequena parte do tráfego ou em um conjunto de testes. Depois, faça a troca completa quando confirmar que as respostas atendem aos requisitos do negócio.
Principais pontos sobre o preço da leitura em cache do gpt-6.1-sol
- Mesmo preço, cache diferente: as duas versões Sol têm o mesmo preço de entrada ($2) e de saída ($10), mas o preço da leitura em cache cai pela metade.
- Valores da leitura em cache:
gpt-6-solcusta $0.20 egpt-6.1-sol, $0.10 por milhão de tokens. - Mais vantajoso em sessões longas: quanto mais acertos de cache, maior a economia ao mudar para
gpt-6.1-sol. - Só uma alteração: basta mudar o campo
modelda requisição; não é necessário contratar um novo plano. - Não aplique essa regra à Luna: a leitura em cache da Luna custa 10% do preço de entrada, não 5%.
- Como começar: use a mesma chave API na APIYI para validar com um pequeno volume de tráfego antes de fazer a substituição completa.
Resumo
Principais pontos ao trocar gpt-6-sol por gpt-6.1-sol:
- Estrutura de preços: os preços de entrada e saída são exatamente iguais. A leitura em cache cai de 10% para 5% do preço de entrada. Dados de 2026-11-10.
- Escopo da alteração: os dois IDs estão na lista de modelos da plataforma. Basta substituir o nome do modelo na requisição;
base_urle a chave API permanecem iguais. - Limites de aplicação: a redução pela metade no preço da leitura em cache vale apenas para a linha Sol. Calcule os multiplicadores de cache de Terra e Luna separadamente.
Se seu serviço de sessões longas ainda usa o ID antigo, essa é uma otimização que praticamente não tem custo. Recomendamos conferir a lista de modelos e os multiplicadores na APIYI, em apiyi.com, e seguir as três etapas deste artigo para fazer a troca. Consulte a lista de modelos da plataforma para confirmar os modelos e preços.
📚 Referências
- Tabela oficial de preços da OpenAI: preços de entrada, saída e entrada em cache dos modelos no plano padrão
- Link:
developers.openai.com/api/docs/pricing -
Observação: confira os preços oficiais de
gpt-6-sol,gpt-6.1-sol,gpt-6.1-terraegpt-6-luna -
Endpoint de preços da APIYI: dados sobre os multiplicadores dos modelos na plataforma
- Link:
api.apiyi.com/api/pricing - Observação: consulte os três multiplicadores: model_ratio, completion_ratio e cache_ratio
Autor: equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial do site da APIYI. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com.