Nota do autor: um guia para classificar erros de APIs de modelos pelo código, entender quando tentar novamente, quando trocar para um modelo alternativo e quando parar para corrigir a configuração. Inclui uma tabela de triagem, uma lista de verificação para modelos alternativos e outra para o lançamento.
Quando uma API de modelo retornar um erro, primeiro identifique a categoria e só depois decida o que fazer. A maioria dos erros 4xx indica problemas na requisição ou na configuração, e tentar novamente não vai resolvê-los; 5xx, 529 e timeouts justificam um número limitado de novas tentativas. Se elas também falharem, troque para um modelo alternativo; sem garantia de idempotência, não tente a requisição novamente de forma automática. Tentar novamente não deve ser a ação padrão, e trocar de modelo também não resolve tudo. Muitos incidentes em produção não acontecem porque o modelo caiu, mas porque a lógica de tratamento de erros transforma uma falha pequena em cobranças duplicadas, gravações repetidas no banco de dados e limitação de taxa em toda a cadeia.
Este artigo não é uma tradução de um dicionário de códigos de erro. Ele é voltado a desenvolvedores que já integraram APIs de modelos a ambientes de produção ou semiprodução e se concentra em como evitar que um erro piore a situação. Ao final, você terá uma tabela de triagem por código de erro, uma estratégia de novas tentativas e fallback, uma lista para verificar as capacidades do modelo alternativo e um checklist para executar antes do lançamento. A ideia central cabe em uma frase: erros 4xx se corrigem primeiro; em erros 5xx, considere novas tentativas; em requisições não idempotentes, pare antes de agir.
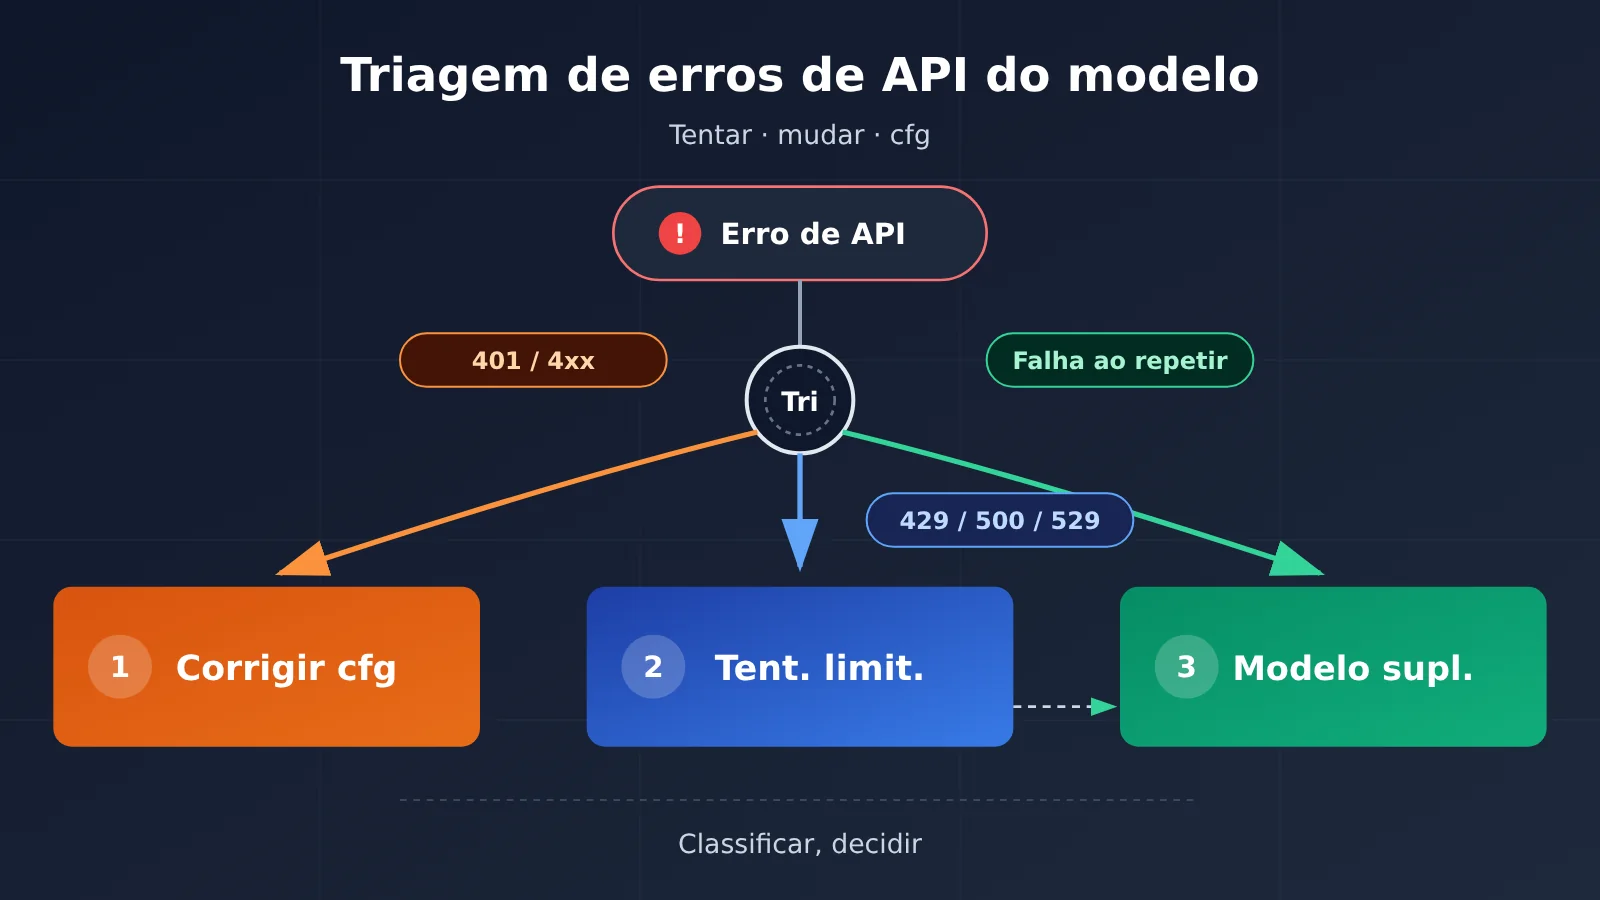
Triagem de erros de API de modelos em 5 categorias: classifique antes de repetir ou trocar
Em resumo: os erros de API de modelos se dividem em cinco categorias, cada uma com uma abordagem básica. Classifique o código de erro primeiro para manter a lógica de repetição e troca sob controle.
| Categoria de erro | Códigos de status típicos | Origem do problema | Ação padrão |
|---|---|---|---|
| Erro na requisição | 400、404、409、422 |
Corpo da requisição, parâmetros, ID do modelo ou endpoint | Não repetir; corrigir a requisição |
| Erro de autenticação ou autorização | 401、403 |
Chave, cabeçalhos, permissões, região ou políticas | Não repetir; verificar a chave e as permissões |
| Cota ou limite de requisições | 402、429 |
Saldo, concorrência, taxa de requisições ou cota do modelo | 402: parar; 429: verificar o corpo do erro e então aplicar backoff ou trocar |
| Falha no serviço upstream | 500、502、503、529 |
Gateway, serviço upstream ou sobrecarga | Repetir um número limitado de vezes e, se falhar, trocar |
| Timeout ou interrupção do stream | 408、504、timeout de rede ou desconexão do stream |
Conexão, saída longa ou resposta lenta do upstream | Primeiro confirmar se a requisição já foi executada ou cobrada; só repetir se for idempotente |
O ponto-chave da triagem: distinguir “repetir” de “trocar”
Repetir significa enviar a requisição novamente pelo mesmo modelo e pela mesma rota, o que ajuda em falhas momentâneas. Trocar significa mudar de modelo ou de rota, o que ajuda quando um serviço upstream fica indisponível por mais tempo. Os custos são diferentes: repetir aumenta a latência e pode gerar cobrança duplicada; trocar pode alterar a qualidade da saída, a compatibilidade com chamadas de ferramentas e o custo.
Por isso, siga sempre três passos: identifique a categoria do erro, verifique se a requisição é idempotente e só então decida se vai repetir, trocar ou parar. Pular o segundo passo é o mais arriscado: executar novamente uma chamada de ferramenta que já foi realizada pode causar problemas bem maiores do que apenas “gastar um pouco mais”.
Por que “tentar tudo novamente” piora os erros da API de modelos
A conclusão é simples: tentar novamente diante de qualquer erro pode parecer seguro, mas acaba ampliando custos, efeitos colaterais e problemas de limitação de requisições ao mesmo tempo. Em produção, incidentes causados por essa lógica costumam ser mais difíceis de investigar do que o erro original.
O primeiro problema é a cobrança duplicada. Uma interrupção na resposta em streaming não significa necessariamente que a requisição falhou: o provedor pode já ter gerado parte dos tokens, e esse custo pode já ter sido cobrado. Reenviar a requisição sem verificar equivale a pagar duas vezes pela mesma tarefa, especialmente em tarefas com saídas longas.
O segundo problema é a execução duplicada. Em cenários com agentes, uma requisição ao modelo pode acionar gravações no banco de dados, envio de mensagens, criação de tarefas e até pagamentos. Se ocorrer um timeout durante a chamada de uma ferramenta, você não sabe se ela já foi executada. Reenviar toda a requisição nesse momento pode gerar dois pedidos ou dois e-mails.
O terceiro problema é agravar a limitação de requisições. O código 429 é o próprio provedor dizendo “vá com calma”. Se o cliente tentar novamente de imediato e em paralelo, estará aumentando ainda mais a pressão. Outro erro comum é tentar novamente para todos os códigos 4xx: um 401 pode indicar que a chave API está errada, mas, depois de várias tentativas, o limite de requisições é atingido e os logs passam a mostrar uma série de erros 429, ocultando a verdadeira causa.
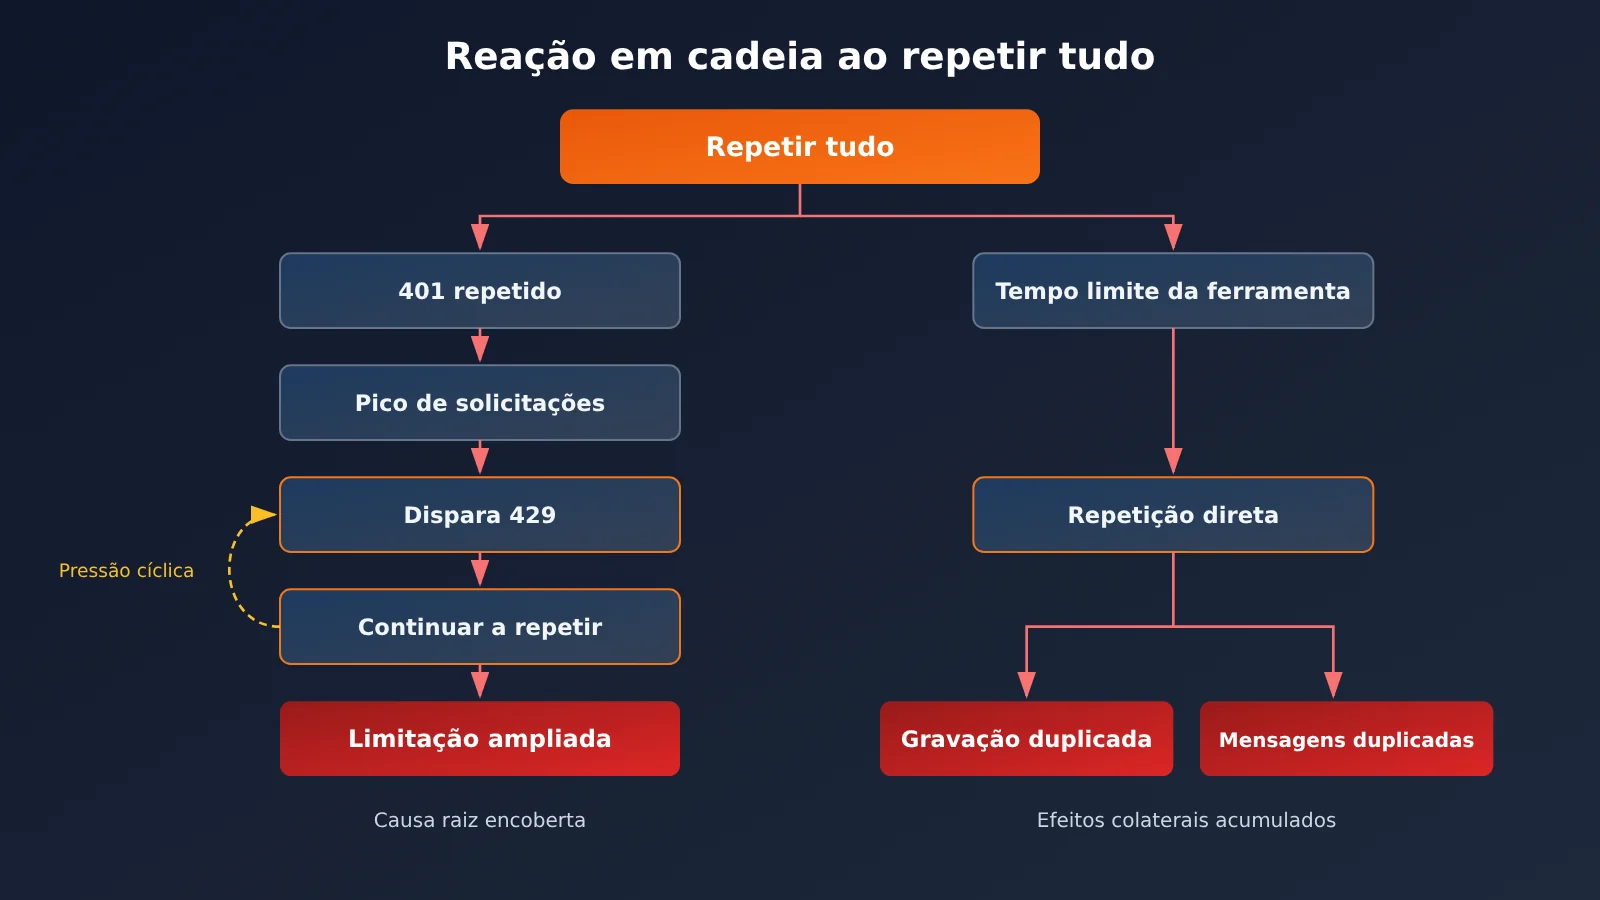
Tabela de triagem dos erros 401, 429, 500 e 529: quando tentar novamente ou trocar
Conclusão: a tabela abaixo cobre os 14 códigos de status mais comuns em produção. Apenas alguns justificam novas tentativas; a troca deve acontecer depois que elas se mostrarem ineficazes. Na coluna “Trocar?”, a troca significa usar um modelo ou uma rota alternativa. O significado exato de cada código depende do corpo do erro e da documentação de cada provedor.
| Código de status | Significado comum | Tentar novamente? | Trocar? | Ação |
|---|---|---|---|---|
400 |
Formato ou parâmetros da requisição incorretos | Não | Não | Corrija o corpo da requisição e verifique os campos e tipos |
401 |
Chave inválida ou falha de autenticação | Não | Não | Verifique a chave, o cabeçalho Authorization e a Base URL |
402 |
Saldo insuficiente ou cota esgotada | Não | Trocar de rota, conforme o caso | Adicione saldo ou mude para uma rota com cota disponível e gere um alerta |
403 |
Acesso negado por permissão, região ou política | Não | Não | Verifique as permissões da conta, a autorização para o modelo e as restrições regionais |
404 |
Modelo ou endpoint inexistente | Não | Não | Confira o ID do modelo e o caminho do endpoint |
408 |
Tempo limite da requisição esgotado | Tentativas limitadas se a operação for idempotente | Opcional | Confirme que a operação não foi executada e tente mais uma vez |
409 |
Conflito ou inconsistência de estado | Não | Não | Verifique o estado da aplicação e evite gravações simultâneas |
422 |
Falha na validação dos parâmetros | Não | Não | Corrija os parâmetros; é comum em schemas de saída estruturada |
429 |
Limite de taxa, concorrência ou cota | Sim, após uma espera progressiva | Se as tentativas falharem | Leia primeiro o corpo do erro e o cabeçalho Retry-After |
500 |
Erro interno do serviço upstream | Tentativas limitadas | Troque se as falhas persistirem | Registre o ID da requisição e o corpo do erro |
502 |
Erro de gateway | Tentativas limitadas | Pode trocar | Distinga problemas do gateway de problemas do serviço upstream |
503 |
Serviço indisponível | Tentativas limitadas | Pode trocar | Respeite o Retry-After e, se necessário, use uma alternativa com menos recursos |
504 |
Tempo limite do gateway esgotado | Só se a operação for idempotente | Pode trocar | Verifique primeiro se a tarefa já foi executada |
529 |
Sobrecarga do serviço upstream | Tentativas limitadas | Pode trocar | Use espera progressiva com variação aleatória e troque se a sobrecarga persistir |
429 nem sempre significa limite de taxa: leia o corpo do erro antes de decidir
O 429 é fácil de interpretar incorretamente. Ele pode indicar limite de taxa, excesso de concorrência ou cota do modelo esgotada e, em alguns casos, até estar relacionado ao saldo. Um limite de taxa costuma se resolver após alguns segundos de espera; se a cota estiver esgotada, porém, nenhuma quantidade de tentativas vai ajudar. Trocar diretamente para o modelo mais caro só aumenta o custo, sem resolver o problema.
Para lidar com um 429:
- Leia o cabeçalho
Retry-Afterda resposta e, se ele estiver presente, aguarde o tempo indicado. - Leia o campo de tipo de erro no corpo da resposta para distinguir entre rate limit, concurrency e quota.
- Se for um problema de taxa ou concorrência, faça de 1 a 2 novas tentativas com espera progressiva e reduza a concorrência local.
- Se for um problema de cota, pare de tentar, gere um alerta e troque para uma rota com cota disponível.
O raciocínio para o 500 é parecido. Ele não significa necessariamente que o modelo está com problema: a causa pode estar no gateway ou no serviço upstream. Primeiro, registre o ID da requisição e um resumo do corpo do erro; eles serão úteis tanto para investigar quanto para conferir a cobrança.
Estratégia de retry para erros de API de modelos: tentativas, backoff, Retry-After e idempotência
Em resumo: faça retries apenas para erros transitórios, limite-os a 1 ou 2 tentativas, use backoff exponencial com jitter aleatório e execute-os automaticamente apenas em requisições idempotentes. Se essas quatro condições não forem atendidas, não faça retry automático.
| Parâmetro | Valor recomendado | Observação |
|---|---|---|
| Erros que permitem retry | 429, 500, 502, 503, 504, 529, timeout de rede |
Entre os erros 4xx, apenas 408 e 429 são exceções |
| Número máximo de retries | 1-2 tentativas | Depois disso, alterne para outra opção ou emita um alerta, sem continuar tentando indefinidamente |
| Intervalo de backoff | 1s, 2s, 4s, com aumento exponencial | Acrescente jitter aleatório a cada tentativa para evitar que várias instâncias tentem novamente ao mesmo tempo |
| Retry-After | Respeite quando estiver presente | Tem prioridade sobre o algoritmo local de backoff |
| Requisito de idempotência | Obrigatório | Operações de escrita, chamadas de ferramentas, envio de mensagens e pagamentos não devem ter retry automático por padrão |
Como implementar a estratégia de retry
- Crie uma função de classificação de erros. Ela recebe o código de status e o corpo do erro e retorna uma das cinco categorias. Baseie o restante da lógica nessa classificação, em vez de verificar códigos numéricos por todo o código de negócio.
- Marque as requisições como idempotentes ou não. Geração de texto simples, resumos e traduções normalmente podem ser considerados idempotentes. Se a requisição acionar ferramentas ou gerar operações de escrita externas, marque-a como não idempotente.
- Verifique o status antes de repetir requisições não idempotentes. Após um timeout em uma chamada de ferramenta, consulte primeiro o status da tarefa ou do banco de dados. Confirme que a operação não foi executada antes de tentar novamente e, se necessário, use uma chave de idempotência na aplicação para evitar duplicações.
- Defina um limite de tempo total. O tempo gasto com retries de cada requisição precisa ter um limite. Caso contrário, a requisição do usuário pode ter expirado enquanto o backend ainda está tentando novamente.
- Registre cada tentativa. Registre pelo menos o request id, o ID do modelo, o código de status, a classe do erro, a latência, o uso de tokens e o número de retries.
Essa última etapa costuma ser esquecida, mas é essencial para conferir cobranças e investigar problemas. Se você usa a APIYI apiyi.com, pode consultar o uso e os logs de chamadas por Key no console. Ao cruzar o request id registrado localmente com as informações de erro da plataforma, você consegue identificar se a falha ocorreu no gateway, no provedor upstream ou no corpo da sua própria requisição.
Trate interrupções de streaming separadamente. Quando uma requisição em streaming for interrompida, verifique quantos tokens já foram recebidos e se o conteúdo já pode ser aproveitado. Só então decida se vai continuar a geração, descartar o resultado ou repetir a requisição. Antes de repetir tarefas com saídas longas, lembre-se: a geração anterior pode já ter sido cobrada.
🎯 Dica para investigar problemas: ao encontrar erros como
500e529, cuja origem pode ser difícil de identificar, salve primeiro o corpo original do erro e o request id. Depois, confira o uso e os logs do mesmo período no console da APIYI apiyi.com. Não tire conclusões com base apenas no código de status.
Estratégia de troca para um modelo alternativo: níveis de capacidade, mapeamento de modelos e verificação de compatibilidade
A conclusão é simples: para fazer a troca, você precisa ter confirmado previamente que o modelo alternativo consegue executar as mesmas tarefas. Se o caminho de fallback for usado pela primeira vez só quando ocorrer uma falha, há uma grande chance de acontecer uma segunda.
Comece dividindo os modelos em níveis: topo de linha, uso geral e leve. Para cada tipo de tarefa, defina um modelo principal e um alternativo do mesmo nível ou de um nível próximo. Não direcione todas as solicitações para o modelo mais caro: uma única instabilidade no provedor pode fazer a conta sair do controle, e muitas tarefas simples nem se beneficiam de um modelo de topo de linha.
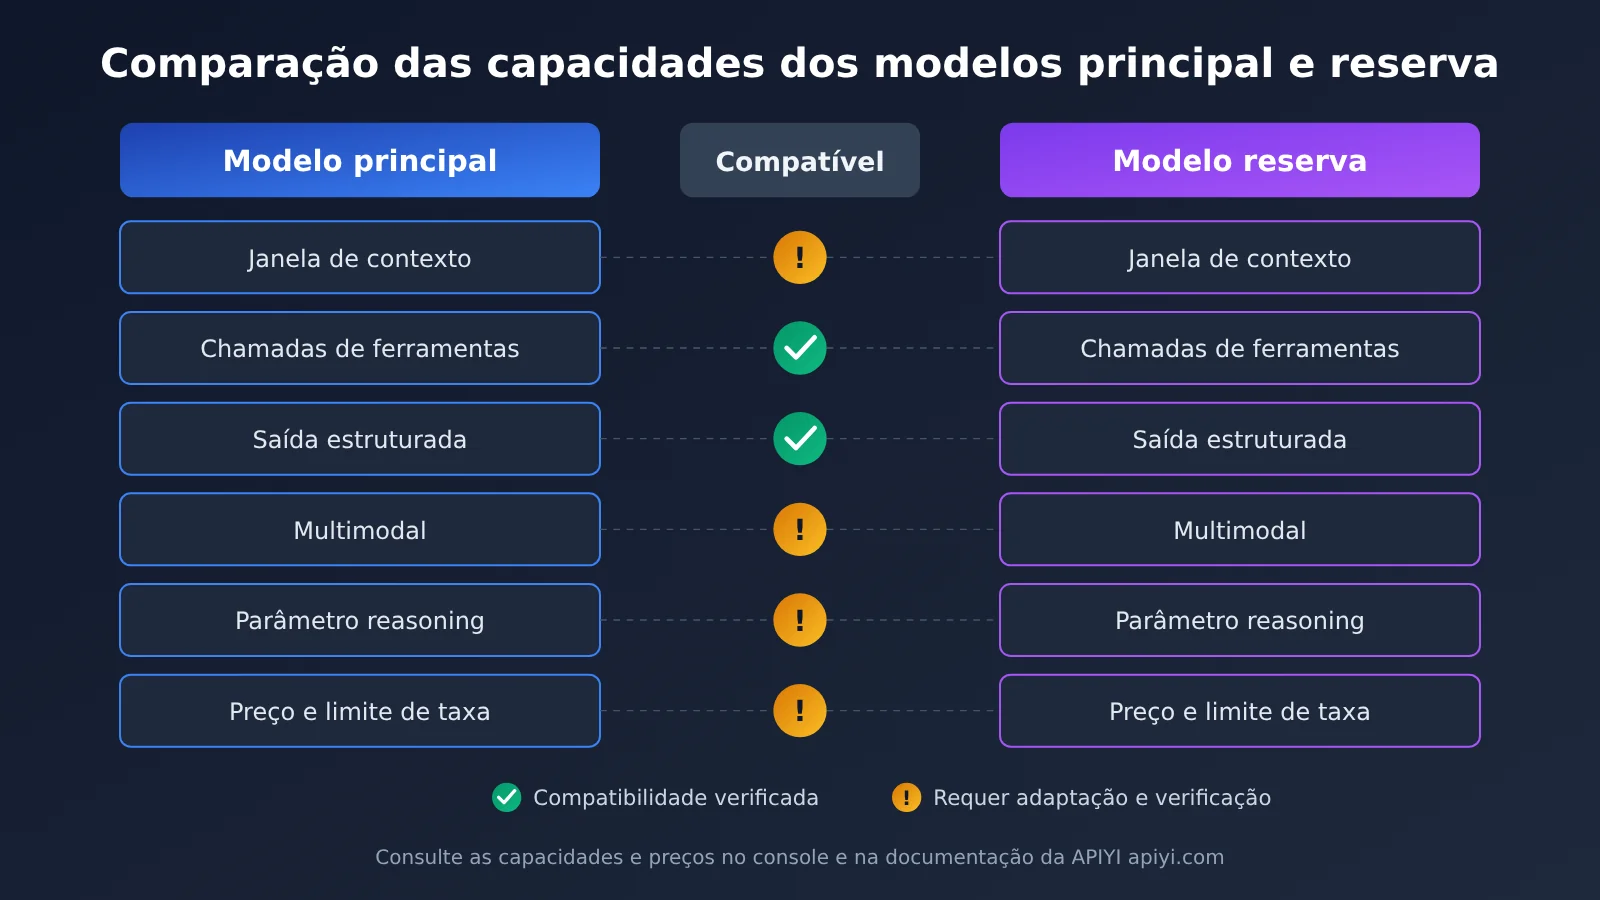
| Capacidade | Modelo principal | Modelo alternativo | É compatível? | O que fazer antes da troca |
|---|---|---|---|---|
| Janela de contexto | Preencher o limite real | Preencher o limite real | A verificar | Confirmar que a entrada real mais longa cabe na janela; caso contrário, definir uma estratégia de truncamento |
| Chamadas de ferramentas | Schema de ferramentas, chamadas paralelas | Idem | A verificar | Validar o formato de retorno dos IDs de chamada e a estrutura dos parâmetros |
| Saída estruturada | JSON schema ou JSON estrito | Idem | A verificar | Testar a taxa de sucesso com o mesmo schema para evitar 422 |
| Entrada multimodal | Imagem, áudio, vídeo | Idem | A verificar | Confirmar os formatos de entrada e os limites de tamanho |
| Parâmetros de reasoning | Nível de raciocínio ou campo de pensamento | Idem | A verificar | Remover ou mapear os parâmetros não suportados durante a troca |
| Preços e limites de requisições | Consultar o console | Consultar o console | A verificar | Estimar o custo após a troca e confirmar que os limites são suficientes |
| Região e conformidade | Escopo permitido | Escopo permitido | A verificar | Confirmar que a rota alternativa atende às restrições regionais e de conformidade do negócio |
Vale preencher uma tabela dessas para cada tipo de tarefa. Na coluna “É compatível?”, registre apenas resultados que já foram verificados, sem confiar na memória. Os parâmetros de reasoning são os que mais costumam causar problemas: um campo de nível de raciocínio aceito pelo modelo principal pode fazer o modelo alternativo retornar diretamente 400 ou 422. A lógica de troca precisa ter uma camada de adaptação de parâmetros, em vez de apenas repassá-los sem alterações.
Mapeamento de modelos: consulte o console para obter os IDs
Um dos erros básicos mais comuns na troca é informar o ID do modelo errado e receber um 404. Vale manter uma tabela que associe nomes lógicos aos IDs reais dos modelos, para que o código da aplicação use apenas os nomes lógicos. Ao usar a APIYI apiyi.com, consulte o console e a documentação para conferir os IDs exatos, a disponibilidade e os preços de cada modelo. Use https://api.apiyi.com/v1 como base_url em todas as integrações. Depois de alterar a tabela de mapeamento, execute uma requisição canário antes de publicar.
Validação de modelos de fallback e gateway multimodelo: canários, logs e fallback automático
Em resumo: antes de colocar um modelo de fallback em produção, valide-o com tarefas reais. Depois da troca, verifique a saída — não basta conferir se o código de status é 200. Um gateway multimodelo pode reduzir o custo da troca, mas não substitui a validação da qualidade.
Validação do modelo de fallback em três etapas
- Requisições canário. Escolha um conjunto de tarefas reais da aplicação e envie-as ao modelo principal e ao de fallback com o mesmo comando, as mesmas ferramentas e as mesmas entradas.
- Comparação das mesmas tarefas. Compare a taxa de aprovação, a latência, o tempo até o primeiro token, o custo dos tokens e a taxa de falhas. Em tarefas com chamadas de ferramentas, confira também se os IDs das chamadas, as estruturas dos parâmetros e as estruturas de retorno são compatíveis.
- Validação após o fallback. Quando a troca acontecer, valide automaticamente a saída: por exemplo, verifique se o JSON pode ser interpretado, se todos os campos obrigatórios estão presentes e se os parâmetros das ferramentas são válidos. Registre também o motivo da troca e o resultado da validação.
Teste o processo de fallback regularmente. Você pode direcionar manualmente uma pequena parte do tráfego para o modelo de fallback toda semana para confirmar que o fluxo continua funcionando e evitar que dependências, parâmetros ou IDs de modelos deixem de funcionar sem que ninguém perceba.
Os logs devem incluir, no mínimo:
- ID da requisição, ID do modelo, endpoint, código de status, classe de erro e resumo do corpo do erro
- Latência, tempo até o primeiro token, tempo total, número de tentativas e destino da troca
- Tokens de entrada, tokens de saída, acerto de cache e custo estimado
- Nome da ferramenta chamada, ID da chamada e se a execução foi bem-sucedida
- Motivo da troca e resultado da validação após a troca
O papel do gateway multimodelo na recuperação de desastres
Ao integrar por conta própria vários fornecedores para recuperação de desastres, você precisa manter pelo menos várias chaves API, SDKs e formatos de erro. Com um gateway agregador como o APIYI apiyi.com, uma única chave API permite chamar modelos populares como OpenAI, Claude, Gemini, DeepSeek e Qwen. A interface é compatível com o padrão da OpenAI e também aceita os formatos nativos de Claude e Gemini. Os modelos principal e de fallback podem usar o mesmo código de integração: na hora da troca, você altera o ID do modelo, e não toda a cadeia de integração.
A plataforma também oferece implantação em múltiplos nós, roteamento inteligente, fallback automático e balanceamento de carga, o que ajuda a absorver parte das instabilidades dos provedores. Mas o fallback automático no gateway não substitui as decisões da aplicação: verificações de idempotência, deduplicação de chamadas de ferramentas e validação das saídas ainda precisam estar no seu código. Uma divisão segura é deixar o gateway cuidar da disponibilidade das rotas e dos nós, enquanto a aplicação cuida da correção das tarefas.
💡 Sugestão para recuperação de desastres: ao definir os modelos principal e de fallback, use a mesma chave API no APIYI apiyi.com para executar o mesmo conjunto de tarefas canário nos dois modelos. Depois, inclua as combinações aprovadas na tabela de mapeamento de modelos. Novos usuários podem começar a validação com créditos gratuitos de teste.
Perguntas frequentes sobre erros na API de modelos
Em resumo: as cinco perguntas abaixo cobrem os cenários que mais geram dúvidas em produção. Todas seguem o mesmo princípio: primeiro avalie, depois aja.
Q1: Devo repetir uma requisição que retornou 401?
Não. `401` indica falha de autenticação. Repetir a requisição só aumenta o volume de chamadas e pode até transformar o problema em um `429`. Verifique se a chave API é válida, se o cabeçalho `Authorization` está no formato correto e se a Base URL e a chave pertencem à mesma plataforma. Se você usa a APIYI apiyi.com, pode conferir o status da chave no console.
Q2: Devo trocar de modelo imediatamente após um erro 429?
Não é recomendável trocar imediatamente. Primeiro, leia o corpo do erro e o `Retry-After`: se o limite for de taxa ou de concorrência, uma ou duas tentativas após um intervalo de espera geralmente resolvem. Troque de rota apenas quando a cota estiver esgotada. Ao trocar, escolha um modelo alternativo do mesmo nível, em vez de recorrer sempre ao mais caro.
Q3: Devo repetir a requisição se a resposta em streaming for interrompida?
Não se apresse. Uma interrupção no streaming não significa que a requisição falhou: parte do conteúdo pode ter sido gerada e cobrada. Primeiro, confira a quantidade de tokens recebidos e veja se o conteúdo pode ser aproveitado. Se puder, mantenha-o ou continue a geração; se não puder e a requisição for idempotente, repita-a uma vez. Consulte o uso no console para saber o valor efetivamente cobrado.
Q4: O que fazer quando uma chamada de ferramenta é executada mais de uma vez?
A solução fundamental é garantir a idempotência na camada de ferramentas. Use uma chave de idempotência da aplicação ou um ID de tarefa para eliminar duplicatas, executando cada ID apenas uma vez. Se uma chamada de ferramenta atingir o tempo limite, consulte primeiro o status da tarefa e só tente novamente se confirmar que ela não foi executada. Se já houver execuções duplicadas, rastreie os logs pelo ID da chamada e compense ou desfaça as operações excedentes.
Q5: O que fazer se o modelo alternativo retornar 200, mas o resultado estiver incorreto?
O código 200 indica apenas que a requisição foi bem-sucedida, não que a tarefa foi concluída corretamente. Faça uma validação automática da saída, verificando, por exemplo, a estrutura JSON, os campos obrigatórios e a validade dos parâmetros das ferramentas. Falhas na validação devem entrar na taxa de falhas e acionar um alerta ou uma revisão manual. Se uma combinação alternativa falhar com frequência nos critérios de aceitação, remova-a da tabela de mapeamento e execute novamente a validação canário.
Checklist e resumo antes de entrar em produção: quando tentar novamente, alternar ou parar
Conclusão: conferir cada item da lista antes de entrar em produção é muito mais confiável do que improvisar a lógica depois que ocorrer uma falha. Lembre-se desta regra: em erros 4xx, corrija primeiro; em erros 5xx, considere tentar novamente; em requisições não idempotentes, pare antes de agir.
| Nº | Item de verificação | Critério de aprovação |
|---|---|---|
| 1 | Identificar o tipo de erro primeiro | Todos os códigos de status se encaixam em uma das cinco categorias; erros desconhecidos não são repetidos por padrão |
| 2 | Não tentar novamente erros 4xx automaticamente | 400, 401, 402, 403, 404, 409 e 422 geram alerta ou são corrigidos diretamente |
| 3 | Decidir entre tentar novamente ou alternar | Tentar novamente apenas erros temporários, no máximo 1 a 2 vezes, com backoff e jitter |
| 4 | Respeitar o Retry-After | Quando o cabeçalho estiver presente, priorizar o tempo de espera indicado |
| 5 | Verificar a idempotência | Em chamadas de ferramentas, operações de escrita, envio de mensagens e pagamentos, parar por padrão e consultar o estado antes de decidir |
| 6 | Tratar interrupções de streaming | Verificar primeiro os tokens recebidos e o custo, sem repetir a requisição às cegas |
| 7 | Conferir o modelo de backup | A tabela de capacidades foi preenchida e validada para cada tipo de tarefa |
| 8 | Mapear os modelos | O mapeamento entre nomes lógicos e IDs dos modelos corresponde ao do console |
| 9 | Validar a saída final | Depois da troca, validar a estrutura e os campos, sem se limitar ao status 200 |
| 10 | Logs e testes | Os campos essenciais estão completos e o caminho de contingência é testado regularmente |
Principais pontos sobre o tratamento de erros em APIs de modelos
- Quando tentar novamente: em erros
429,500,502,503,529e requisições idempotentes que sofreram timeout, com um número limitado de tentativas e backoff. - Quando alternar: quando as novas tentativas ainda falham, o provedor continua indisponível ou a cota se esgota, desde que o modelo de backup já tenha sido validado.
- Quando parar: em erros de configuração 4xx, como
401, e em requisições não idempotentes cujo estado é desconhecido. - Alternar não significa ter sucesso: mesmo depois que o modelo de backup retorna 200, ainda é preciso validar a saída.
- Divisão entre gateway e aplicação: deixe a disponibilidade das rotas para o gateway e a correção das tarefas para o código de negócio.
Um bom tratamento de erros não depende de quantas tentativas você faz, mas de tomar a decisão certa a cada falha. Comece pela classificação dos erros, pelas etiquetas de idempotência e pelos campos de log; depois, introduza modelos de backup aos poucos. Para uma rota alternativa, vale considerar a APIYI apiyi.com: uma única chave dá acesso a vários modelos populares, facilitando a validação e a alternância entre o modelo principal e o de backup com o mesmo código. Consulte o console e a documentação para preços e disponibilidade.
📚 Referências
- Central de documentação da APIYI: formas de integração, lista de modelos e informações de cobrança
- Link:
docs.apiyi.com -
Observação: consulte a documentação e o console para confirmar os IDs, preços e disponibilidade dos modelos
-
Significado dos códigos de status HTTP: explicação de cabeçalhos de resposta padrão, como
Retry-After - Link:
developer.mozilla.org/docs/Web/HTTP/Status - Observação: útil para entender o significado geral dos códigos 4xx e 5xx. Para detalhes específicos, consulte o corpo de erro de cada plataforma de modelos
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato pela página inicial do site da APIYI, apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com