Nota do autor: depois que o modelo é atualizado, comandos e códigos de patch não devem ser removidos por intuição. Este artigo usa uma taxonomia de 4 categorias e um fluxo de regressão em 5 etapas para ajudar você a decidir o que excluir, o que alterar e o que manter.
Em novembro de 2026, uma reportagem do 36Kr sobre a saída de uma figura-chave do Claude Code da Anthropic fez muitos desenvolvedores voltarem a conversar sobre ferramentas de programação com IA. Além das histórias de bastidores, a questão mais prática para muitas equipes é: a cada atualização de modelo, comandos e códigos de patch só aumentam. Eles ainda são necessários? Este artigo apresenta um método de limpeza que primeiro classifica, depois compara e, por fim, faz uma liberação gradual, para ajudar você a enxugar sem sacrificar a estabilidade.
Este não é um artigo que incentiva você a “apagar tudo sem medo”. Comandos podem esconder regras de negócio, e códigos de patch também podem conter proteções de segurança. O custo de uma exclusão acidental costuma ser maior do que pagar por alguns tokens a mais. Este artigo também não traz pontuações de benchmark genéricas, porque o efeito da limpeza depende das amostras do seu negócio. Você precisa chegar às suas próprias conclusões com os seus dados.
Valor principal: ao terminar a leitura, você vai saber identificar quais comandos e códigos de patch podem ser removidos após uma atualização de modelo, além de conseguir concluir a limpeza com um processo que permite reverter.
Pontos essenciais para limpar comandos e códigos de patch após a atualização do modelo
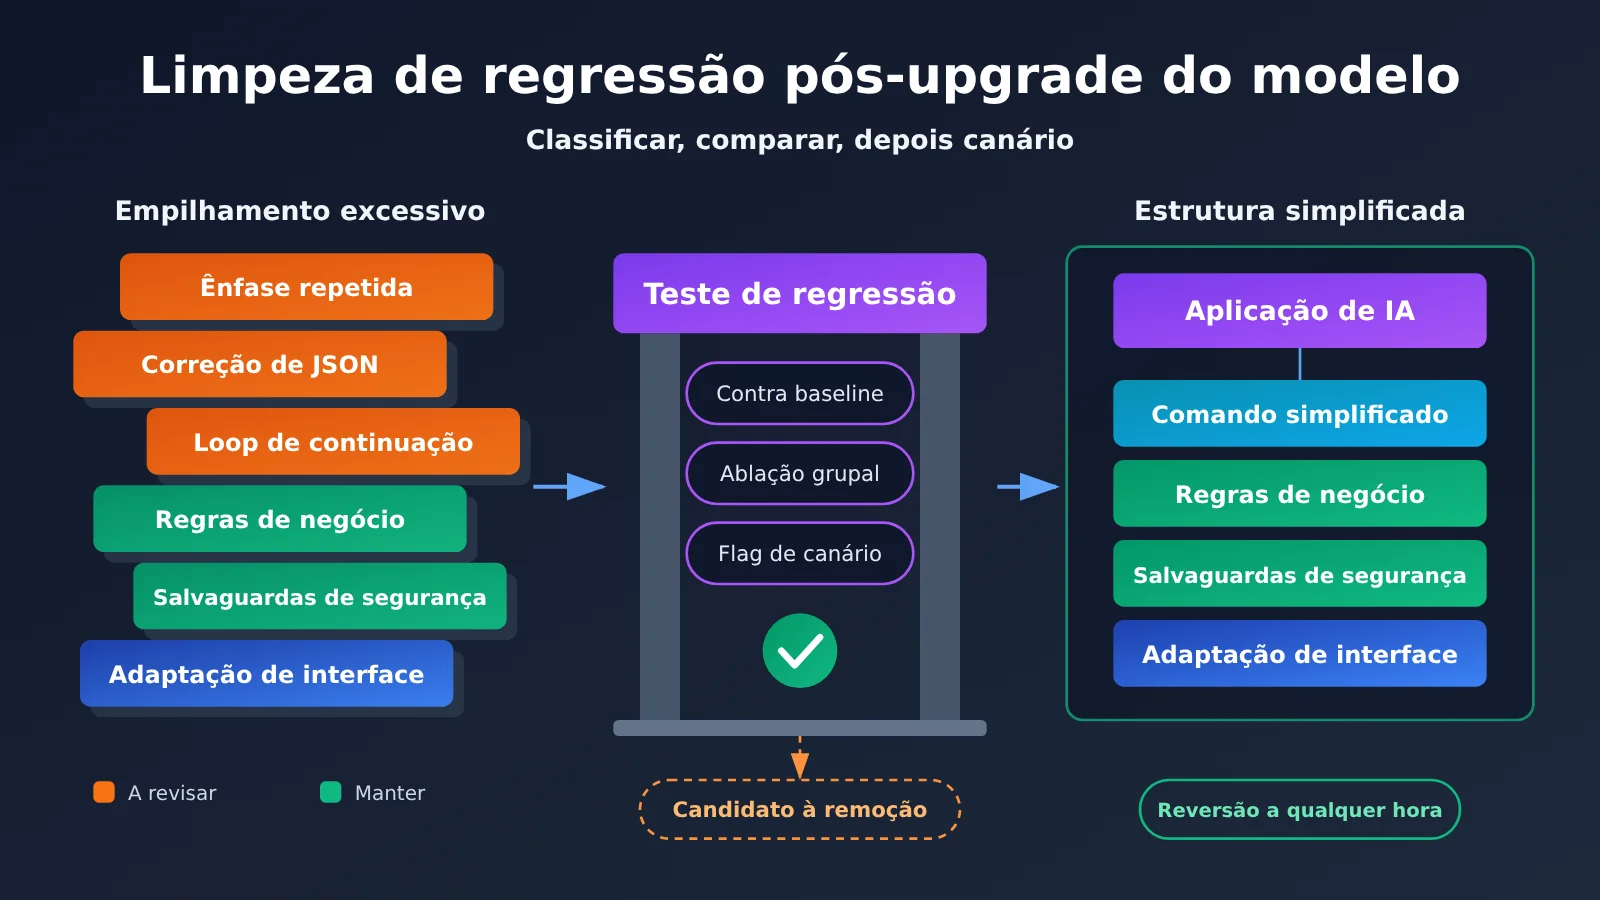
Comece com um princípio de decisão: um comando ou patch que existe para compensar deficiências do modelo antigo deve passar por revisão; já um comando ou patch que existe para expressar regras de negócio ou controlar riscos não deve ser removido só porque o modelo foi atualizado. A tabela abaixo resume o fluxo descrito ao longo do texto.
| Ponto | Descrição | Valor |
|---|---|---|
| Classifique antes de agir | Divida em 4 categorias: compensação do modelo, regras de negócio, barreiras de segurança e adaptação de interface | Evita excluir lógica crítica por engano |
| Troque apenas o modelo para criar a linha de base | Na primeira rodada, mantenha comandos e código inalterados | Distingue mudanças do modelo de mudanças da limpeza |
| Testes de ablação por grupo | Remova apenas um grupo de conteúdo por vez e compare os resultados | Identifica com precisão a função de cada item |
| Implantação gradual com feature flags | O resultado da limpeza é controlado por configuração e pode ser revertido a qualquer momento | Reduz o risco de incidentes em produção |
| Revise a cobrança separadamente | Comandos mais curtos não significam necessariamente custo total menor | Evita julgar errado olhando apenas a quantidade de tokens |
Por que comandos e códigos de patch ficam obsoletos após a atualização do modelo
Na maioria das aplicações de IA, os comandos foram crescendo à medida que problemas em produção apareciam. Se o modelo esquecia o formato, adicionava-se uma frase de ênfase; se a saída do modelo era truncada, adicionava-se um loop de continuação; se o modelo às vezes escrevia JSON errado, adicionava-se mais uma função de correção. Essas abordagens eram razoáveis na época, mas estavam atreladas ao comportamento do modelo antigo — e esse vínculo raramente era documentado.
Após a atualização do modelo, esses conteúdos podem cair em três situações: o problema desapareceu e o patch virou código inútil; o problema continua e o patch segue útil; o comportamento do modelo mudou e a abordagem antiga passa a gerar efeitos colaterais. Por exemplo, frases de ênfase repetidas no passado para chamar a atenção do modelo, quando levadas para um modelo novo que responde de forma diferente a instruções, podem fazer com que ele execute uma regra em excesso. Portanto, o objetivo da revisão após a atualização não é “quanto menor, melhor”, mas garantir que cada trecho tenha uma razão clara para existir.
Como classificar comandos e código de patch em 4 categorias
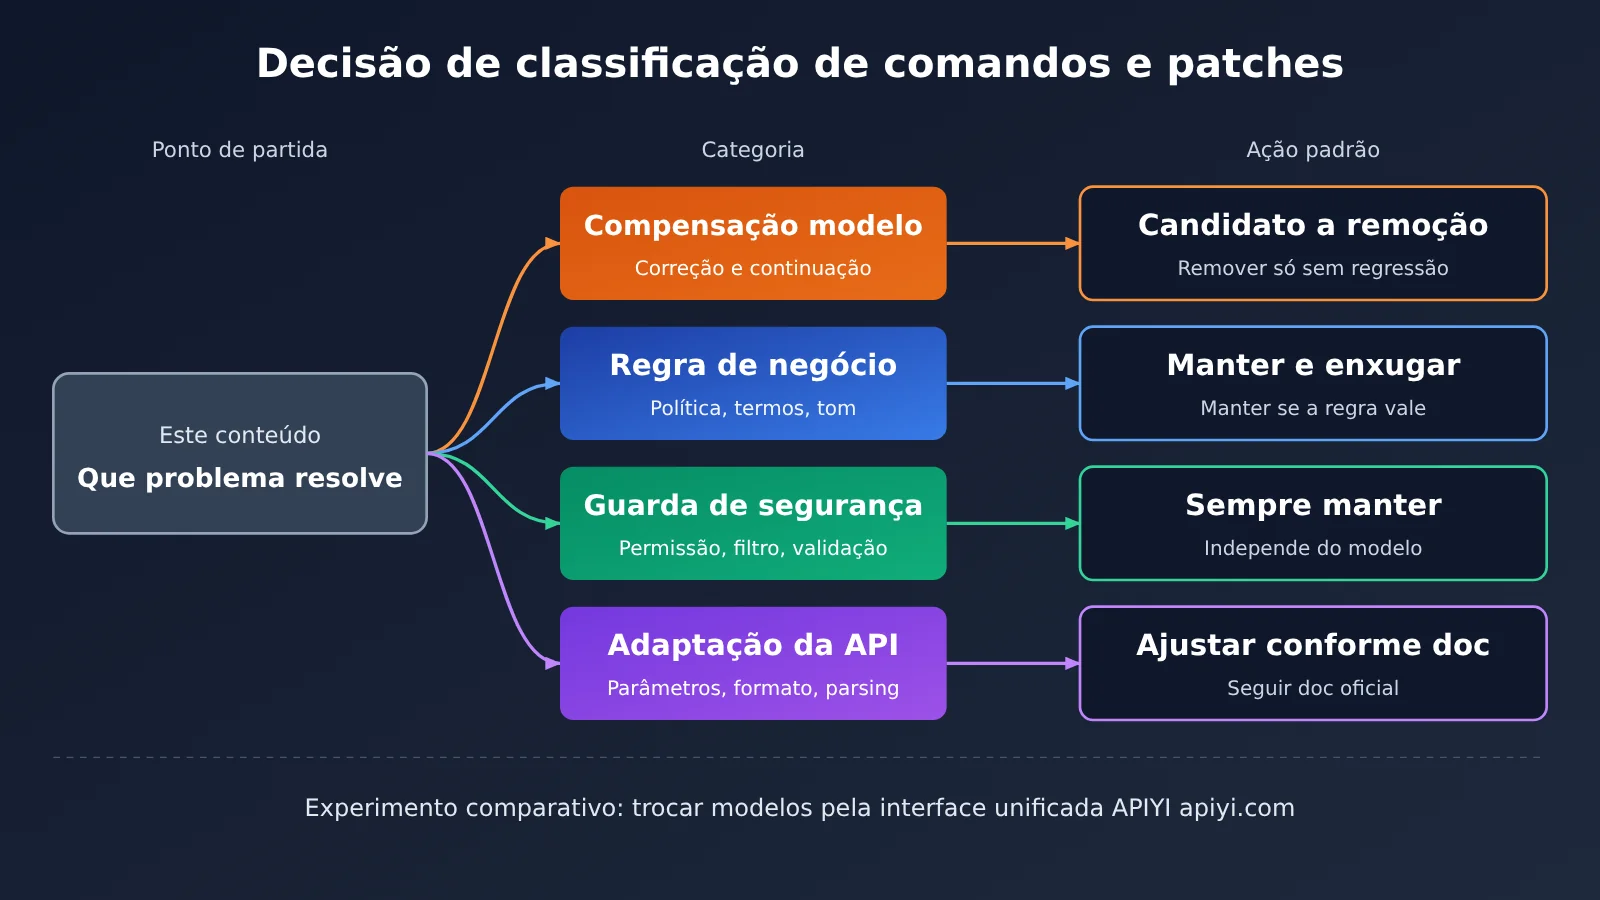
Antes da limpeza, divida o comando de sistema por parágrafos e liste, item por item, também a lógica de processamento antes e depois da invocação do modelo. Depois, classifique conforme a tabela abaixo: assim as decisões de remoção passam a ter uma base clara.
| Categoria | Exemplos comuns | Ação padrão | Critério de decisão |
|---|---|---|---|
| Compensação do modelo | Reforçar repetidamente “não omita”, funções de reparo de JSON, loops de continuação para saída truncada | Listar como candidatos à remoção | Só remover se os testes de regressão não mostrarem degradação |
| Regras de negócio | Política de reembolso, glossário, tom da marca, restrições de domínio | Manter e enxugar a expressão | Manter se a regra ainda for válida |
| Guardrails de segurança | Verificação de permissões, filtragem de informações sensíveis, validação de saída, proteção contra injeção | Manter sempre | Não depende da capacidade do modelo |
| Adaptação de interface | Mapeamento de parâmetros, conversão de formato de chamada de ferramenta, parsing de resposta | Ajustar conforme o novo modelo | Seguir a documentação oficial da interface |
Há um detalhe que merece atenção à parte: a lógica de reparo pode ser considerada para remoção, mas a lógica de validação não pode ser removida. Quando a saída estruturada do novo modelo é mais estável, o código de reparo de JSON com regex talvez possa ser desativado, mas a validação de Schema ainda deve ser mantida. Da mesma forma, o loop de continuação para truncamento de saída pode ser reavaliado; já as retentativas para erros de rede e rate limiting não têm relação com a capacidade do modelo e não devem entrar no escopo da limpeza.
Limpeza rápida de prompts e código de patch após atualização do modelo
O processo de 5 etapas abaixo não exige plataformas complexas — dá para fazer com o framework de testes e planilhas que você já tem. O ponto crucial é mudar apenas uma variável por vez e registrar cada decisão.
Etapa 1: Inventariar a origem dos prompts e do código de patch
Use git log e git blame para rastrear quando cada trecho foi introduzido e qual problema ele estava associado, e registre quatro informações na lista: localização do conteúdo, categoria a que pertence, problema que resolve e forma de validação. Se um trecho de prompt já não tem mais ninguém que consiga explicar de onde veio, marque-o como “a validar” — não o classifique direto como inútil.
Etapa 2: Criar um conjunto de amostras de regressão para o upgrade do modelo
O conjunto de regressão deve incluir três partes: requisições comuns reais da produção, amostras de falha que já causaram incidentes e cenários de fronteira de negócio. O tamanho da amostra pode ser definido conforme o risco; para equipes pequenas, começar com algumas dezenas de amostras de alto valor já faz sentido. Como a saída do modelo é incerta, amostras críticas devem ser executadas várias vezes, para evitar tratar uma aprovação acidental como aprovação estável.
Etapa 3: Trocar apenas o modelo e estabelecer uma linha de base de comparação
Na primeira rodada, altere somente o nome do modelo, mantendo o comando e o código como estavam, e fixe parâmetros controláveis como a temperatura. Assim, você obtém a diferença entre “modelo antigo + configuração antiga” e “modelo novo + configuração antiga”, e também consegue detectar antecipadamente mudanças em parâmetros de interface ou na estrutura de resposta. Se a plataforma suportar nomes de modelo com versão fixa, prefira usar a versão fixa, para evitar que mudanças no modelo durante os testes interfiram nos resultados.
A tabela abaixo lista os itens de configuração que precisam ser confirmados ao montar o experimento de comparação.
| Item de configuração | Como preencher | Observações |
|---|---|---|
base_url |
Use o endereço de interface correspondente informado na documentação do APIYI | Os endereços e caminhos dos formatos OpenAI e Anthropic seguem a documentação |
api_key |
Use a chave criada no console | Gerencie por variável de ambiente, não grave no repositório |
model |
Preencha com o nome do modelo da página de preços ou da documentação | Os grupos experimental antigo e novo devem ser idênticos exceto pelo nome do modelo |
temperature |
Use o mesmo valor em todos os grupos experimentais | A faixa de parâmetros pode variar entre modelos; consulte a documentação |
max_tokens |
Defina espaço suficiente para os modelos antigo e novo | Evite interpretar um truncamento como problema de qualidade do modelo |
🚀 Dica para começar rápido: o que costuma consumir mais tempo em experimentos comparativos é adaptar várias interfaces. O APIYI oferece chamadas de API para modelos como Claude e GPT abordados neste artigo, e é compatível com os formatos de interface OpenAI e Anthropic; normalmente basta ajustar
base_url,api_keyemodelpara começar os testes. As instruções de integração estão na documentação do APIYI: https://docs.apiyi.com
Etapa 4: ablação em grupos de comandos e código de patch
Depois que a linha de base estiver estável, comece removendo uma categoria de compensação do modelo por vez, mantendo em cada grupo apenas o conteúdo que resolve o mesmo problema. Por exemplo, primeiro remova os comandos relacionados à “ênfase de formato” e sua função de correção; depois de rodar a regressão, passe para o próximo grupo. Se você remover muita coisa de uma vez, fica difícil localizar a causa quando o resultado piorar — no fim, muitas vezes só resta reverter tudo.
| Métrica | O que observar | Referência para decisão |
|---|---|---|
| Taxa de aprovação em amostras críticas | Se incidentes históricos e cenários de alto risco passam | Se houver degradação, restaure o conteúdo desse grupo |
| Taxa de aprovação geral das tarefas | Mudança na qualidade de solicitações comuns | Decida com base no limite definido previamente pela equipe |
| Taxa de acionamento de patches | Número real de acionamentos da lógica de correção ou continuação | Se ficar perto de zero por muito tempo, pode servir de base para remoção |
| Tokens e latência | Consumo de entrada e saída e tempo de resposta | Usado para avaliar o ganho real da limpeza |
| Taxa de intervenção humana | Proporção de transferências para atendimento humano ou retrabalho do usuário | Observe continuamente após o lançamento para cobrir pontos cegos das amostras offline |
Os critérios de decisão devem ser definidos antes de rodar os testes; caso contrário, a equipe tende a ajustar os critérios na hora com base nos resultados. Para o código de patch, também é possível primeiro apenas registrar, sem intervir: deixe-o continuar rodando e, ao mesmo tempo, reporte “o que aconteceria se ele não existisse”; alguns dias depois, decida se deve removê-lo com base nos dados de acionamento. Isso é especialmente útil para negócios de alto risco.
Etapa 5: Lançamento gradual com capacidade de rollback preservada
A versão limpa deve ser publicada por meio de uma flag de configuração, cobrindo primeiro uma pequena porcentagem do tráfego e ampliando o escopo só depois de confirmar que as métricas estão estáveis. O registro da exclusão precisa deixar claro o critério usado — por exemplo, “a regressão passou em determinada versão do modelo e a taxa de acionamento de patches segue próxima de zero” — assim, na próxima atualização, você pode reaproveitar o julgamento.
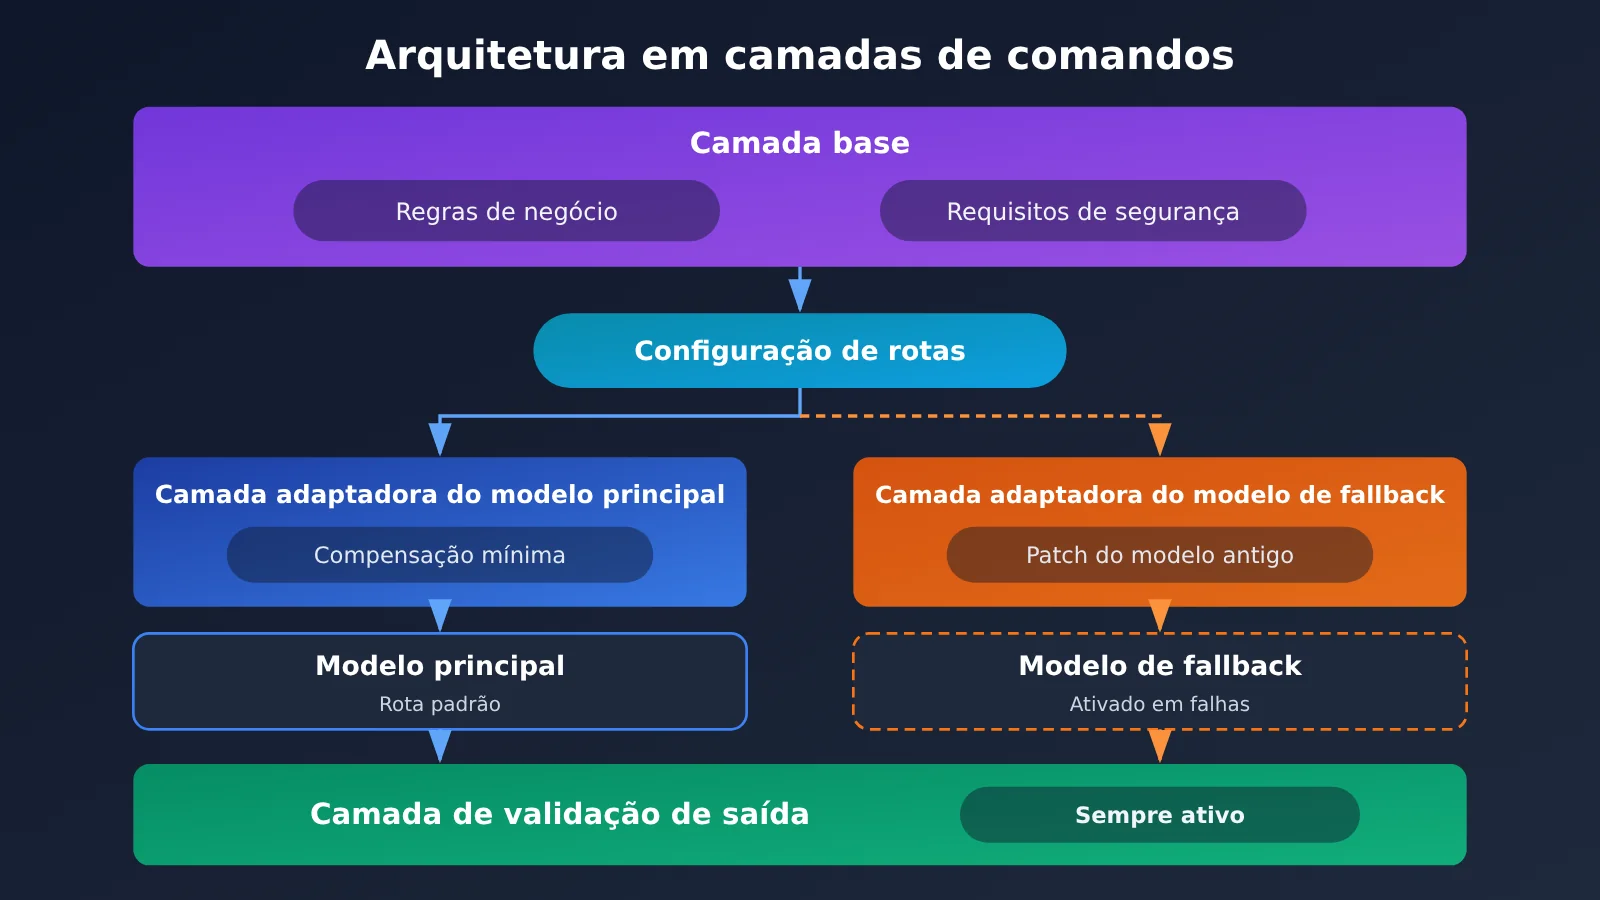
Também é preciso verificar com atenção a cadeia de fallback do modelo. Se houver retorno a um modelo antigo quando o principal não estiver disponível, os patches escritos para o modelo antigo podem continuar necessários. A abordagem mais segura é dividir o comando em duas camadas: regras de negócio e requisitos de segurança na camada base; conteúdo específico do modelo na camada de adaptação, carregada por modelo conforme a configuração de roteamento.
Comparação entre 3 abordagens para lidar com comandos e código de patch após a atualização do modelo
A limpeza não se resume a “apagar tudo” ou “não mexer em nada”. A tabela abaixo compara três estratégias comuns, para você escolher conforme o risco do negócio e o investimento do time.
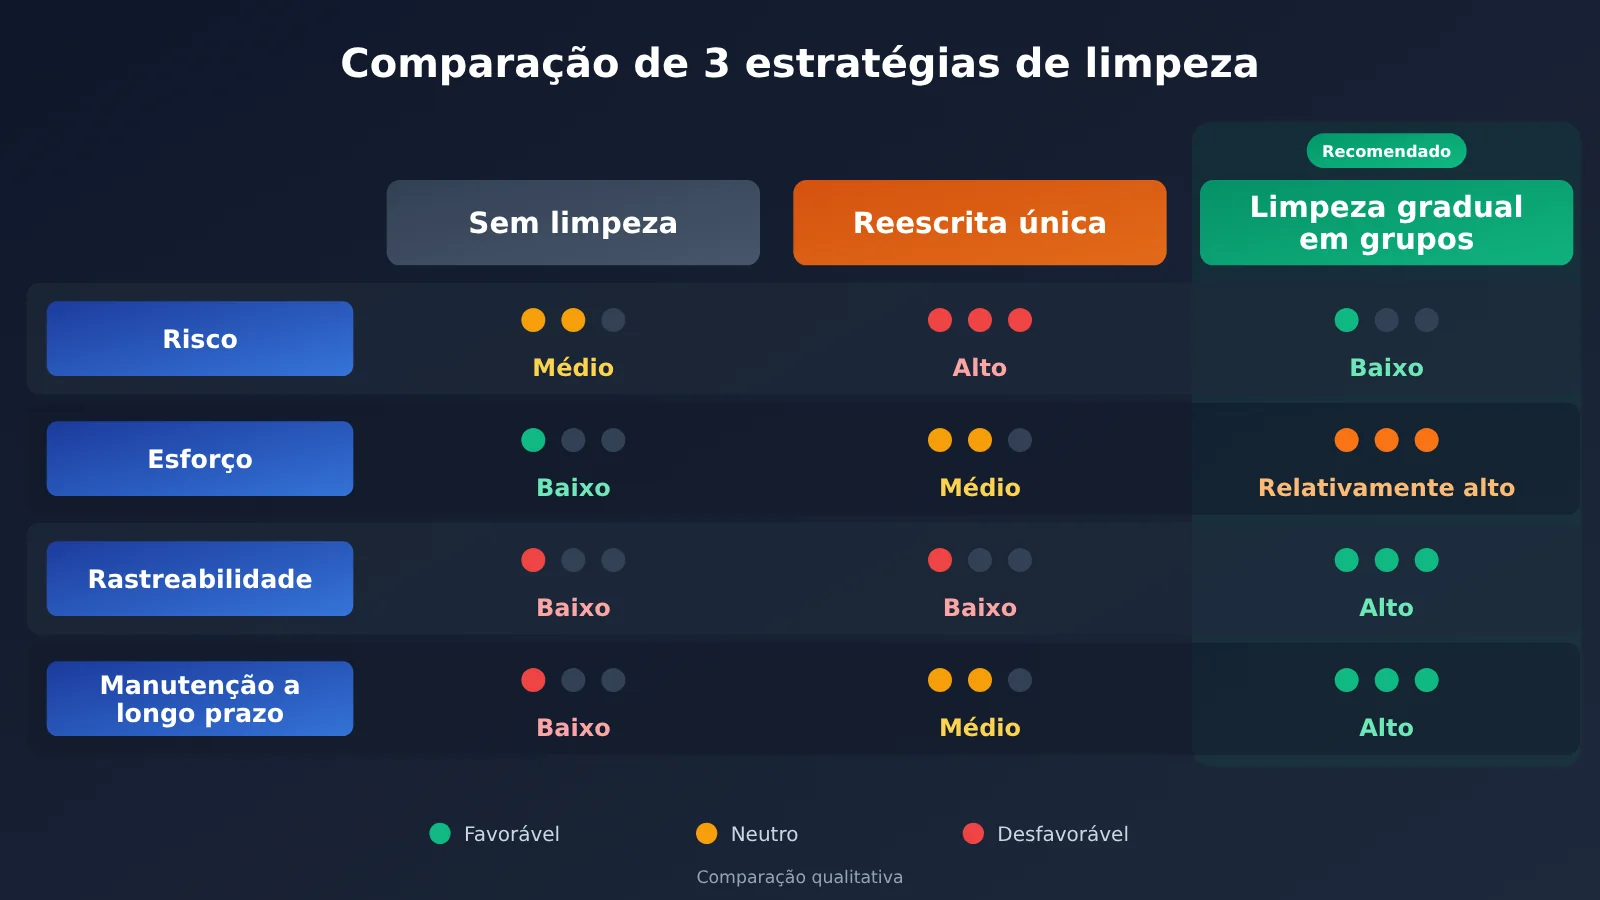
| Abordagem | Como fazer | Risco principal | Cenários indicados |
|---|---|---|---|
| Manter como está | Trocar apenas o nome do modelo, sem mexer no resto | Conteúdo ineficaz se acumula e fica difícil explorar a capacidade do novo modelo | Atualizações temporárias ou falta de recursos de teste no curto prazo |
| Reescrever de uma vez | Escrever do zero seguindo o guia de comandos do novo modelo | Regras de negócio implícitas podem se perder | Comandos de pequeno porte ou negócio em reestruturação |
| Limpeza gradual por grupos | Classificar, fazer ablação grupo a grupo e publicar em rollout gradual | Exige tempo para construir o conjunto de regressão | Ambientes de produção e a maioria das aplicações com manutenção de longo prazo |
Análise comparativa de “manter como está”: essa abordagem segue na frente em velocidade de lançamento, mas os efeitos colaterais e a carga de manutenção dos comandos antigos não desaparecem sozinhos. Em comparação, a limpeza gradual por grupos é mais adequada para sistemas de produção que precisam de iteração contínua.
Análise comparativa de “reescrever de uma vez”: essa abordagem se destaca na organização da estrutura do comando, mas o conhecimento de negócio escondido em patches históricos tende a ficar de fora. Se você realmente optar por reescrever, ainda vale validar com o mesmo conjunto de regressão e conferir item por item as regras de negócio da versão antiga.
Contabilização de custos da limpeza de comandos e código de patch após a atualização do modelo
Comando mais curto não significa custo total menor. O custo de uma chamada pode ser estimado como “tokens de entrada × preço unitário de entrada + tokens de saída × preço unitário de saída”; ao usar cache, é preciso separar a cobrança de leitura e escrita de cache e incluir as chamadas extras geradas por retries e fallbacks. A saída do novo modelo pode ser mais longa, e alterar o prefixo do comando também pode afetar o hit de cache — por isso, confirme com o uso real medido no experimento.
💰 Sobre os preços: este artigo não lista valores unitários. Para preços de modelos, critérios de cobrança, preços unitários de entrada e saída e preços de cache, consulte os dados reais da página de preços da APIYI em https://docs.apiyi.com/models, e registre a data da consulta no momento do cálculo.
Perguntas Frequentes (FAQ)
Q1: O que é “compensação de modelo” nos comandos e no código de patch?
Compensação de modelo é o conteúdo adicionado para contornar deficiências de um modelo específico, como reforçar repetidamente o formato de saída, corrigir JSON corrompido, concatenar resultados truncados. A diferença em relação às regras de negócio é que, após trocar por um modelo mais capaz, esse conteúdo pode deixar de ser necessário.
Q2: Depois da atualização do modelo, deve-se apagar tudo e reescrever os comandos e o código de patch?
Normalmente não é recomendado. Reescrever tudo pode até deixar o código mais organizado, mas é fácil perder regras de negócio implícitas e aprendizados com incidentes. Em sistemas de produção, o mais indicado é fazer a limpeza de forma gradual e por grupos; quando os comandos são muito pequenos ou o negócio está passando por uma reestruturação, pode-se considerar reescrever, mas ainda assim é preciso validar com o conjunto de regressão.
Q3: Quando é o momento adequado para limpar comandos e código de patch?
O melhor momento é o período de avaliação da troca de modelo, porque nessa fase a regressão já vai ser executada de qualquer forma. Além disso, quando a taxa de disparo do patch fica próxima de zero por muito tempo, ou quando os comandos já são tantos que ninguém ousa mexer neles, também vale agendar uma limpeza dedicada. Não concentre limpezas antes de grandes promoções ou picos de negócio.
Q4: Quais comandos e códigos de patch jamais podem ser removidos por causa de uma atualização de modelo?
Validação de permissões, filtragem de informações sensíveis, validação de Schema de saída, proteção contra injeção de comandos e logs de auditoria devem ser sempre mantidos. Esses itens controlam riscos do sistema e não devem depender de o modelo “provavelmente se sair bem”. A lógica de retry para erros de rede e rate limiting também faz parte da infraestrutura e não deve entrar no escopo da limpeza.
Q5: Como comparar rapidamente modelos novos e antigos via API?
Depois de preparar o conjunto de regressão, faça os grupos experimental novo e antigo usarem os mesmos comandos e parâmetros, alterando apenas o nome do modelo. Com a APIYI, é possível chamar vários modelos usando o formato de interface compatível com OpenAI ou Anthropic, o que facilita a troca dentro do mesmo script de teste. Para configurações específicas, consulte a documentação: https://docs.apiyi.com
Q6: Como saber se a limpeza realmente gera economia?
Contabilize separadamente os tokens de entrada, os tokens de saída, os acertos de cache e o número de retries antes e depois da limpeza, e depois multiplique pelo preço unitário atual. Para preço unitário e cobrança de cache, consulte a página de preços da APIYI: https://docs.apiyi.com/models . Ao comparar o custo por chamada, observe também o custo por tarefa bem-sucedida, que se aproxima mais do custo real do negócio.
Q7: Quais são as limitações desse processo de limpeza?
O conjunto de regressão cobre apenas problemas conhecidos; passar nos testes não significa que novas situações não vão aparecer em produção, portanto gray release e monitoramento não podem ser omitidos. O processo também exige investimento de mão de obra, e ferramentas internas de baixa frequência ou baixo risco não precisam seguir tudo à risca. Quando há poucas amostras, os indicadores podem oscilar bastante, e não é adequado tirar conclusões muito precisas com base neles.
Principais conclusões sobre a limpeza de comandos e código de patch após a atualização do modelo
- Critério de decisão: observe se o conteúdo está compensando o modelo antigo ou se expressa regras de negócio e controle de risco.
- Classificação em 4 tipos: compensação de modelo, regras de negócio, guardrails de segurança e adaptação de interface, cada um com ações distintas.
- Baseline primeiro: na primeira rodada, apenas troque o modelo, sem alterar comandos e código de patch ao mesmo tempo.
- Ablação gradual: remova apenas um grupo de conteúdo relacionado por vez, para conseguir localizar com precisão quando houver regressão.
- Manter as validações: a lógica de reparo de JSON pode ser revisada; a validação de Schema e as verificações de permissão devem ser mantidas.
- Verificação de fallback: antes de excluir um patch, confirme se o modelo antigo no caminho de fallback ainda depende dele.
- Ferramenta de comparação: use a interface compatível da APIYI para alternar modelos com o mesmo conjunto de scripts e fazer regressão.
Resumo
Após a atualização do modelo, se os comandos e o código de patch devem ou não ser removidos não depende da divulgação do novo modelo, mas sim dos seus dados de regressão. Podemos resumir o trabalho de limpeza em três pontos:
- Primeiro, descubra a origem: explique qual problema cada trecho de conteúdo resolve e depois arquive-o nas 4 categorias.
- Decida com experimentos: estabeleça uma baseline, faça ablação em grupos e use métricas definidas de antemão para julgar o que manter.
- Torne as mudanças reversíveis: faça o lançamento gradual por meio de flags e gerencie em camadas o conteúdo relacionado ao modelo e as regras de negócio.
Recomenda-se começar por um cenário com volume de chamadas moderado e risco controlável, validar todo o fluxo primeiro e depois expandir para o negócio principal. Se precisar comparar vários modelos, você pode chamar os modelos abordados neste artigo via APIYI; o modo de integração está em https://docs.apiyi.com e os custos devem ser consultados com base nos dados reais da página de preços https://docs.apiyi.com/models.
📚 Materiais de Referência
- 36氪 – A estudante de destaque em CS de Princeton que deixou a Anthropic de repente e impulsionou o Claude Code: fonte do contexto temporal citado no início deste artigo
- Link:
36kr.com/p/4055331476526214 -
Observação: publicado em 4 de novembro de 2026. O método de limpeza apresentado neste artigo é um resumo de práticas gerais de engenharia, e não uma paráfrase do conteúdo dessa reportagem.
-
Documentação da APIYI: especificação do formato de interface e configuração de acesso
- Link:
docs.apiyi.com -
Observação: usada para confirmar o
base_url, o caminho da interface e a forma de invocação. -
Página de modelos e preços da APIYI: lista de modelos e informações de cobrança
- Link:
docs.apiyi.com/models -
Observação: os preços dos modelos, os critérios de cobrança e os preços de cache mencionados neste artigo seguem os dados reais dessa página.
-
Documentação oficial da Anthropic: guia dos modelos Claude e de comandos
- Link:
docs.anthropic.com -
Observação: ao atualizar modelos Claude, consulte as mudanças de interface e as recomendações de comandos.
-
Documentação oficial da OpenAI: guia dos modelos GPT e da API
- Link:
platform.openai.com/docs - Observação: ao atualizar modelos GPT, consulte as mudanças de parâmetros e as instruções de migração.
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI; mais materiais estão disponíveis no centro de documentação em docs.apiyi.com