Nota del autor: después de una actualización del modelo, las indicaciones y el código de parche no deben eliminarse por intuición. Este artículo usa una clasificación en 4 categorías y un proceso de regresión en 5 pasos para ayudarte a decidir qué eliminar, qué modificar y qué conservar.
En noviembre de 2026, un reportaje de 36Kr sobre la marcha de una figura clave del equipo de Claude Code en Anthropic volvió a poner sobre la mesa las herramientas de programación con IA entre muchos desarrolladores. Más allá de la historia personal, la pregunta más práctica para muchos equipos es: después de cada actualización del modelo, las indicaciones y el código de parche no dejan de crecer; ¿todavía tienen sentido? Este artículo presenta un método de limpieza que consiste en clasificar primero, contrastar después y desplegar de forma gradual al final, para ayudarte a reducir sin sacrificar estabilidad.
Este no es un artículo que te anime a “eliminarlo todo sin miedo”. Las indicaciones pueden contener reglas de negocio, y el código de parche también puede incluir salvaguardas de seguridad; el coste de una eliminación accidental suele ser mayor que pagar algunos tokens de más. Tampoco ofrecemos benchmarks genéricos, porque el resultado de la limpieza depende de tus muestras de negocio; necesitas sacar tus propias conclusiones con tus datos.
Valor principal: al terminar este artículo, sabrás determinar qué indicaciones y qué código de parche se pueden eliminar después de una actualización del modelo, y podrás completar la limpieza con un proceso reversible.
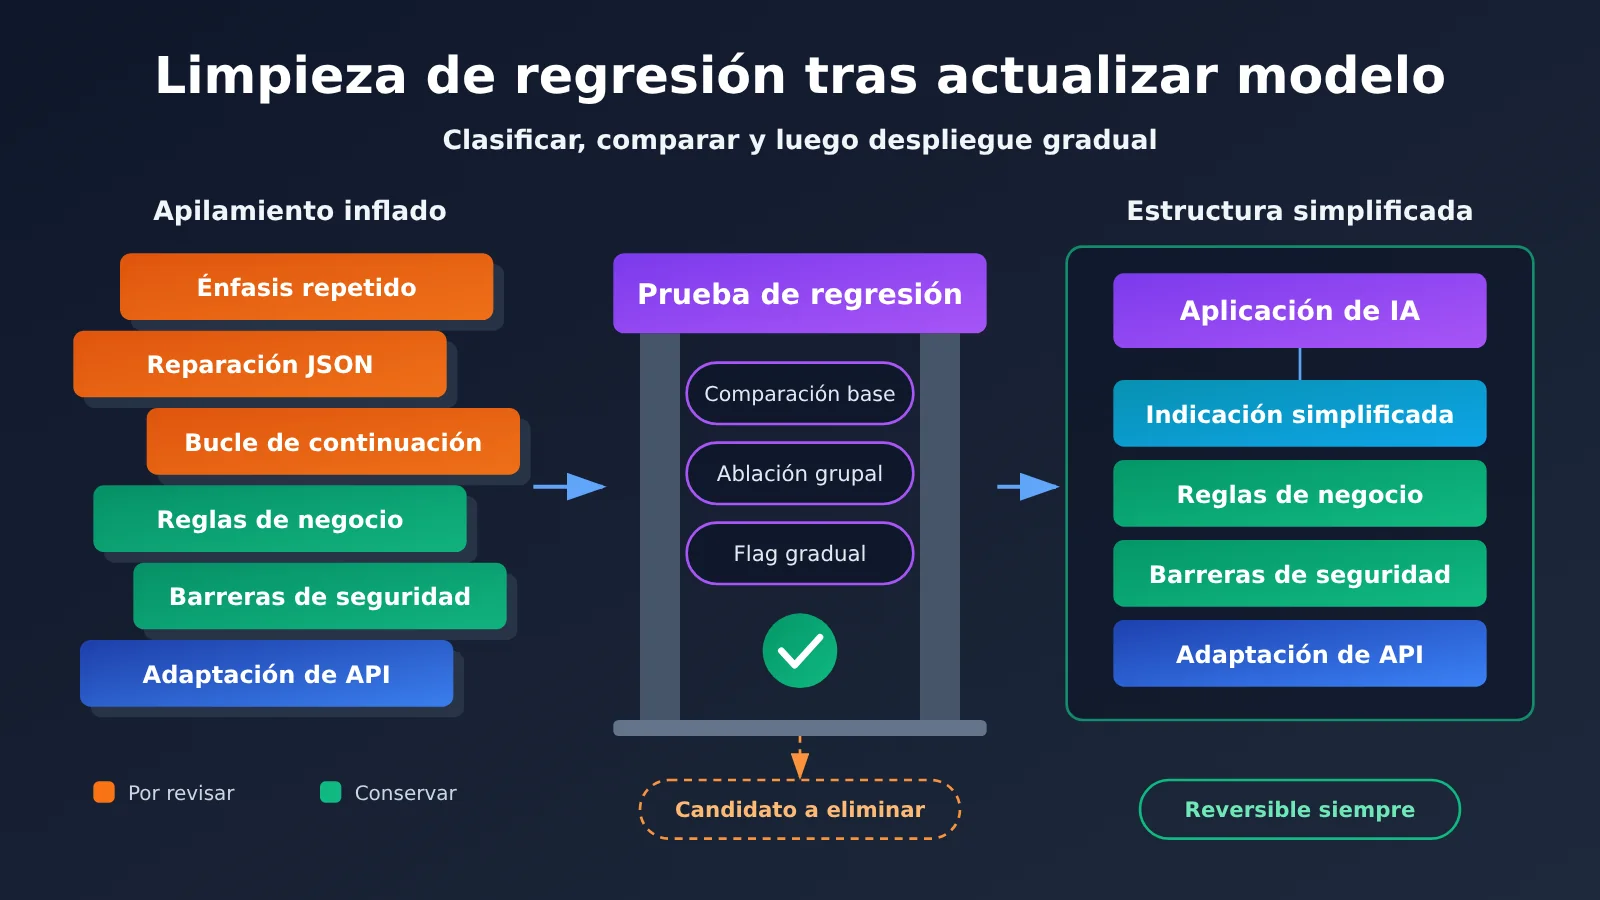
Aspectos clave de la limpieza de indicaciones y código de parche tras actualizar el modelo
Primero recuerda un principio de decisión: si una indicación o un parche existe para compensar las deficiencias de un modelo anterior, conviene someterlo a revisión; si existe para expresar reglas de negocio o controlar riesgos, no debería eliminarse solo porque el modelo se actualizó. La siguiente tabla es una versión resumida del proceso que veremos después.
| Punto clave | Descripción | Valor |
|---|---|---|
| Clasificar antes de tocar | Dividir en 4 categorías: compensación del modelo, reglas de negocio, salvaguardas de seguridad y adaptación de interfaz | Evitar borrar lógica crítica por error |
| Cambiar solo el modelo para establecer la línea base | En la primera ronda, mantener sin cambios las indicaciones y el código | Distinguir los cambios del modelo de los cambios por limpieza |
| Pruebas de ablación por grupos | Retirar solo un grupo de contenido a la vez y comparar resultados | Ubicar con precisión la función de cada elemento |
| Despliegue gradual con interruptores | Controlar el resultado de la limpieza mediante configuración, con posibilidad de revertir en cualquier momento | Reducir el riesgo de incidentes en producción |
| Revisar la factura por separado | Que una indicación sea más corta no significa necesariamente que el costo total baje | Evitar conclusiones erróneas por mirar solo la cantidad de tokens |
Por qué las indicaciones y el código de parche quedan obsoletos tras actualizar el modelo
En la mayoría de las aplicaciones de IA, las indicaciones han crecido a base de resolver problemas en producción. Si el modelo omitía el formato, se añadía una frase para insistir; si la salida se cortaba, se agregaba un bucle de continuación; si el modelo a veces escribía JSON inválido, se sumaba una función de reparación. Todas esas decisiones eran razonables en su momento, pero estaban atadas al comportamiento del modelo anterior, y esa dependencia rara vez quedaba registrada.
Después de actualizar el modelo, ese contenido puede terminar en tres situaciones: el problema desapareció y el parche se volvió código inútil; el problema sigue existiendo y el parche continúa siendo útil; o el comportamiento del modelo cambió y la vieja solución ahora genera efectos secundarios. Por ejemplo, las frases enfáticas que antes se repetían para llamar la atención del modelo pueden hacer que un modelo nuevo, con otra forma de responder a las instrucciones, ejecute una regla con exceso de celo. Por eso, el objetivo de la revisión posterior a la actualización no es “cuanto más corto, mejor”, sino lograr que cada fragmento tenga una razón clara para seguir existiendo.
Cómo clasificar las indicaciones y el código de parche en 4 categorías
Antes de limpiar, divide la indicación del sistema en párrafos y enumera, punto por punto, la lógica de procesamiento que hay antes y después de la invocación del modelo. Después, clasifícala con la tabla siguiente y tendrás una base para decidir qué eliminar más adelante.
| Categoría | Ejemplos habituales | Acción predeterminada | Criterio de decisión |
|---|---|---|---|
| Compensación del modelo | Insistir una y otra vez en «no omitas», funciones de reparación de JSON, bucles de continuación tras truncamiento | Marcar como candidato a eliminar | Eliminar solo si las pruebas de regresión no muestran degradación |
| Reglas de negocio | Política de reembolsos, glosario, tono de marca, restricciones del dominio | Conservar y simplificar la redacción | Conservar si la regla sigue vigente |
| Barreras de seguridad | Validación de permisos, filtrado de información sensible, validación de salida, protección contra inyección | Conservar siempre | No se supedita a la capacidad del modelo |
| Adaptación de interfaz | Mapeo de parámetros, conversión del formato de llamada a herramientas, análisis de respuestas | Ajustar según el nuevo modelo | Guiarse por la documentación oficial de la interfaz |
Hay un detalle que merece mención aparte: la lógica de reparación se puede considerar para eliminación, pero la lógica de validación no se debe eliminar. Cuando la salida estructurada del nuevo modelo es más estable, el código que repara JSON con expresiones regulares quizá pueda retirarse, pero la validación de Schema debería mantenerse. Por la misma razón, el bucle de continuación para truncamiento de salida se puede revisar; en cambio, los reintentos ante errores de red y limitación de velocidad no tienen relación con la capacidad del modelo y no deberían entrar en el alcance de la limpieza.
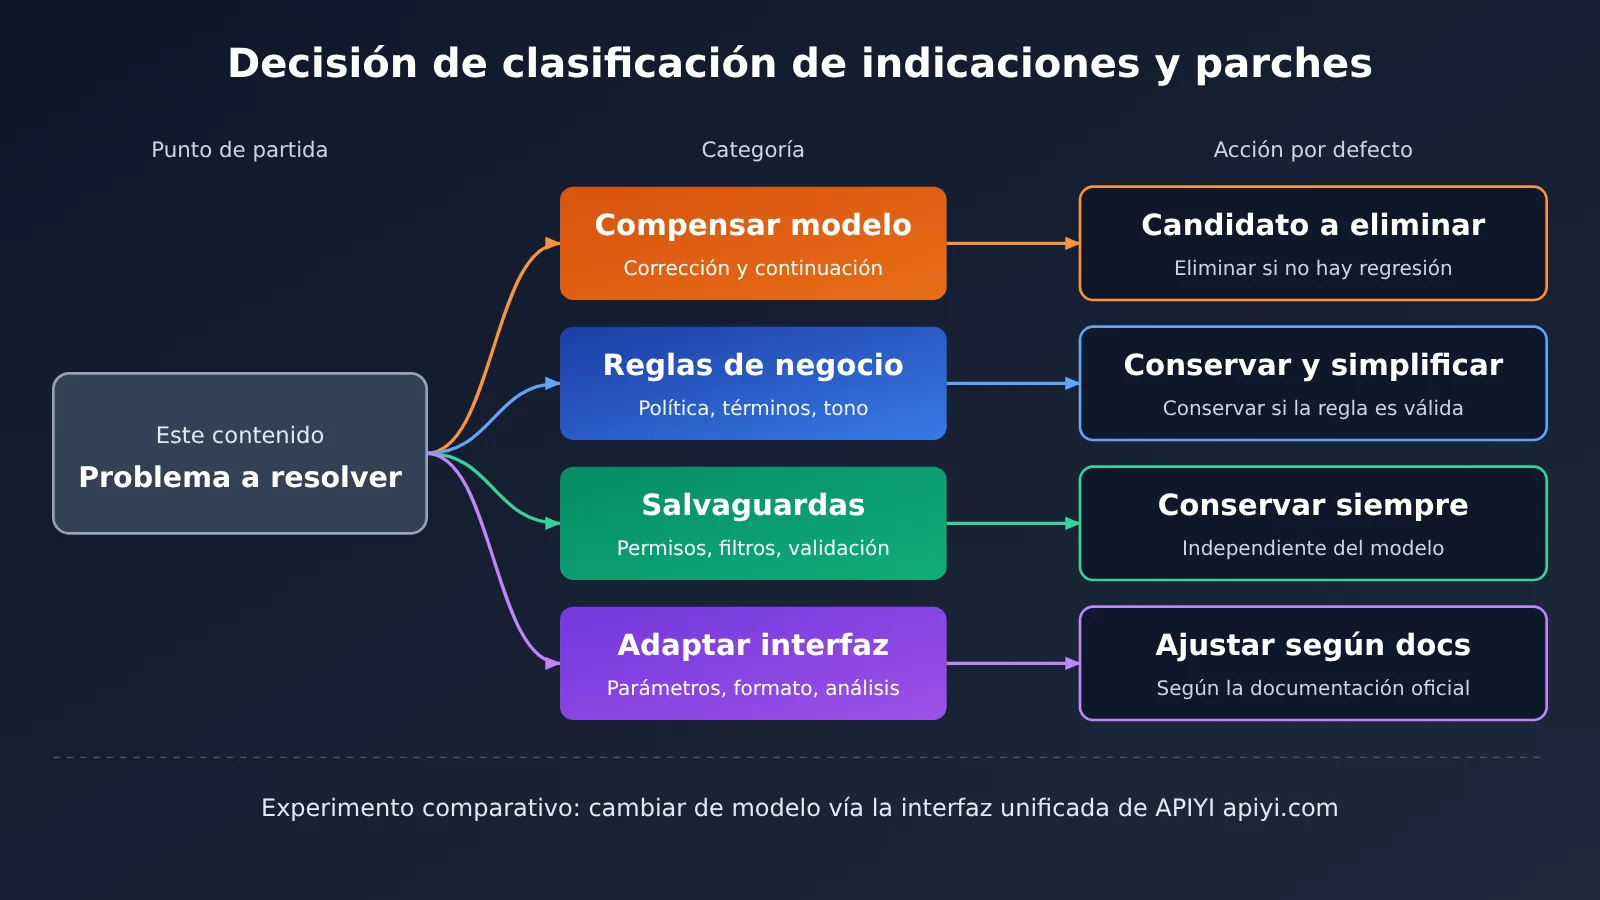
Guía rápida para limpiar indicaciones y código de parche tras actualizar el modelo
El siguiente proceso de 5 pasos no exige plataformas complejas; se puede completar con el marco de pruebas y las hojas de cálculo que ya tienes. La clave está en cambiar solo una variable a la vez y dejar constancia de cada decisión.
Paso 1: Inventariar el origen de las indicaciones y el código de parche
Usa git log y git blame para rastrear cuándo se introdujo cada fragmento de contenido y con qué problema se relacionaba. En el inventario, anota cuatro datos: ubicación del contenido, categoría a la que pertenece, problema que resuelve y método de verificación. Si ya nadie puede explicar de dónde salió una indicación, márcala como «pendiente de verificación» en lugar de darla por inútil de inmediato.
Paso 2: Crear un conjunto de muestras de regresión para la actualización del modelo
El conjunto de regresión debería incluir tres partes: peticiones normales reales en producción, muestras de fallos que ya han provocado incidentes y escenarios límite del negocio. El tamaño del conjunto puede decidirse según el riesgo; para equipos pequeños, empezar con unas decenas de muestras de alto valor también tiene sentido. Como la salida del modelo es incierta, las muestras clave deben ejecutarse varias veces para no confundir un aprobado casual con un aprobado estable.
Paso 3: Cambiar solo el modelo y establecer una línea base de control
En la primera ronda, cambia únicamente el nombre del modelo, deja la indicación y el código tal cual y fija los parámetros controlables, como la temperatura. Así obtendrás la diferencia entre «modelo antiguo + configuración antigua» y «modelo nuevo + configuración antigua», y también podrás detectar por adelantado cambios en los parámetros de la interfaz o en la estructura de la respuesta. Si la plataforma admite nombres de modelo con versión fija, prioriza usar la versión fija para evitar que el modelo cambie durante las pruebas y distorsione los resultados.
La siguiente tabla recoge los elementos de configuración que hay que confirmar al montar el experimento de control.
| Elemento de configuración | Cómo rellenarlo | Consideraciones |
|---|---|---|
base_url |
Usa la dirección de interfaz correspondiente que aparece en la documentación de APIYI | Las direcciones y rutas de los formatos OpenAI y Anthropic se rigen por la documentación |
api_key |
Usa la clave creada en la consola | Gestiónala mediante variables de entorno, no la escribas en el repositorio |
model |
Escribe el nombre del modelo que aparece en la página de precios o en la documentación | Los grupos de experimento antiguo y nuevo deben mantenerse iguales salvo en el nombre del modelo |
temperature |
Todos los grupos de experimento usan el mismo valor | El rango de parámetros de algunos modelos puede ser distinto; consulta la documentación |
max_tokens |
Ajusta suficiente margen para los modelos antiguo y nuevo | Evita interpretar un truncamiento como un problema de calidad del modelo |
🚀 Consejo para empezar rápido: lo que más tiempo suele consumir en un experimento de control es adaptarse a varios conjuntos de interfaces. APIYI ofrece la invocación de API de modelos como Claude y GPT, los que se mencionan en este artículo, y es compatible con los formatos de interfaz de OpenAI y Anthropic; normalmente basta con ajustar
base_url,api_keyymodelpara empezar a probar. Las instrucciones de integración están en la documentación de APIYI: https://docs.apiyi.com
Paso 4: ablación por grupos de indicaciones y código de parches
Una vez estabilizada la línea base, empieza a retirar grupo por grupo, comenzando por la categoría de compensación del modelo; cada grupo debe incluir solo aquello que resuelve un mismo problema. Por ejemplo, primero elimina las indicaciones relacionadas con el «énfasis en el formato» y su función de reparación, ejecuta la regresión y después pasa al siguiente grupo. Si eliminas demasiadas cosas de una vez, cuando el resultado empeore será difícil localizar la causa y, al final, lo más probable es que tengas que revertir todo.
| Métrica | Qué observar | Referencia para decidir |
|---|---|---|
| Tasa de aprobación de muestras críticas | Si pasan los incidentes históricos y los escenarios de alto riesgo | Si hay degradación, restaura el contenido de ese grupo |
| Tasa de aprobación de la tarea global | Cambios en la calidad de las solicitudes normales | Decide según el umbral definido de antemano por el equipo |
| Tasa de activación de parches | Número real de activaciones de la lógica de reparación o continuación | Si se mantiene cerca de cero durante mucho tiempo, puede servir como criterio para eliminar |
| Tokens y latencia | Uso de entrada y salida, y tiempo de respuesta | Sirve para evaluar el beneficio real de la limpieza |
| Tasa de intervención humana | Proporción de transferencias a humanos o de retrabajo por parte del usuario | Obsérvala de forma continua tras el lanzamiento para cubrir los puntos ciegos de las muestras offline |
Los criterios de decisión deben escribirse antes de ejecutar las pruebas; de lo contrario, el equipo tenderá a ajustarlos sobre la marcha según los resultados. En el caso del código de parches, también puedes empezar solo registrando, sin intervenir: déjalo seguir ejecutándose y reporta al mismo tiempo «qué pasaría si no estuviera»; unos días después, decide si eliminarlo con base en los datos de activación. Esto resulta especialmente útil en operaciones de alto riesgo.
Paso 5: Despliegue gradual y conservación de la capacidad de reversión
Se recomienda publicar la versión ya limpia mediante un interruptor de configuración: primero se cubre una pequeña proporción del tráfico y, cuando se confirma que las métricas son estables, se amplía el alcance. En el registro de eliminación hay que dejar clara la justificación; por ejemplo: «la regresión de cierta versión del modelo pasó y la tasa de activación de parches se mantuvo cerca de cero». Así, en la próxima actualización se puede reutilizar el criterio directamente.
También hay que revisar especialmente la cadena de degradación del modelo. Si cuando el modelo principal no está disponible se recurre al modelo antiguo, los parches escritos para ese modelo antiguo pueden seguir siendo necesarios. Lo más seguro es dividir las indicaciones en dos capas: las reglas de negocio y los requisitos de seguridad en la capa base, y el contenido específico del modelo en la capa de adaptación, que la configuración de enrutamiento carga según el modelo.
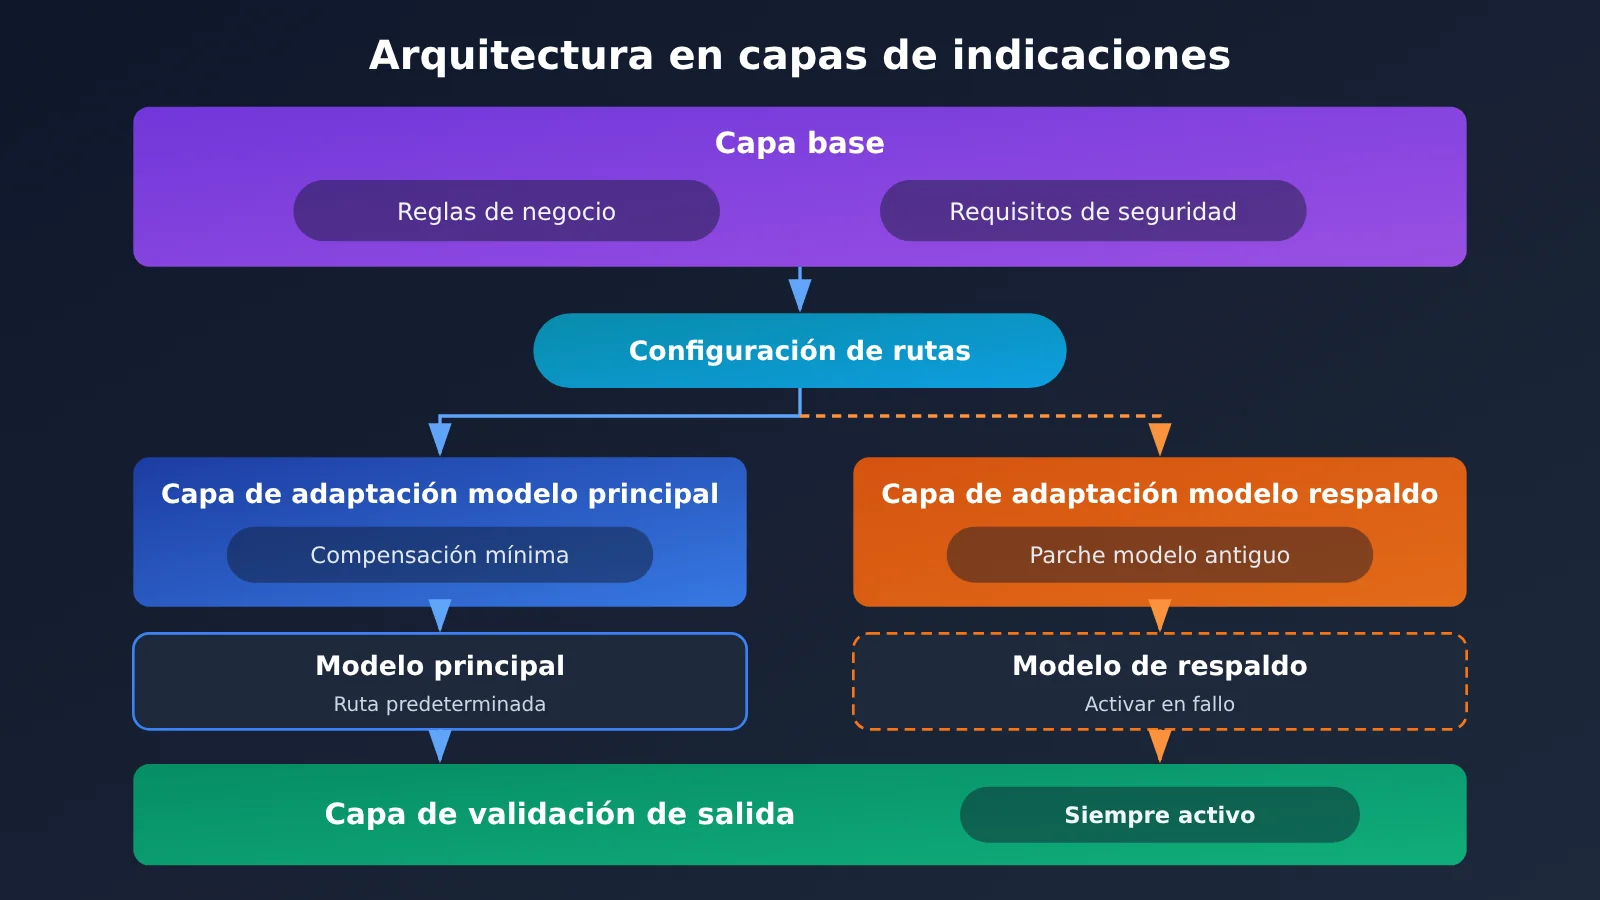
Comparación de 3 enfoques para tratar indicaciones y código de parches tras actualizar el modelo
La limpieza no se limita a dos opciones: «eliminar todo» o «no tocar nada». La siguiente tabla compara tres estrategias habituales para que elijas según el riesgo del negocio y el esfuerzo del equipo.
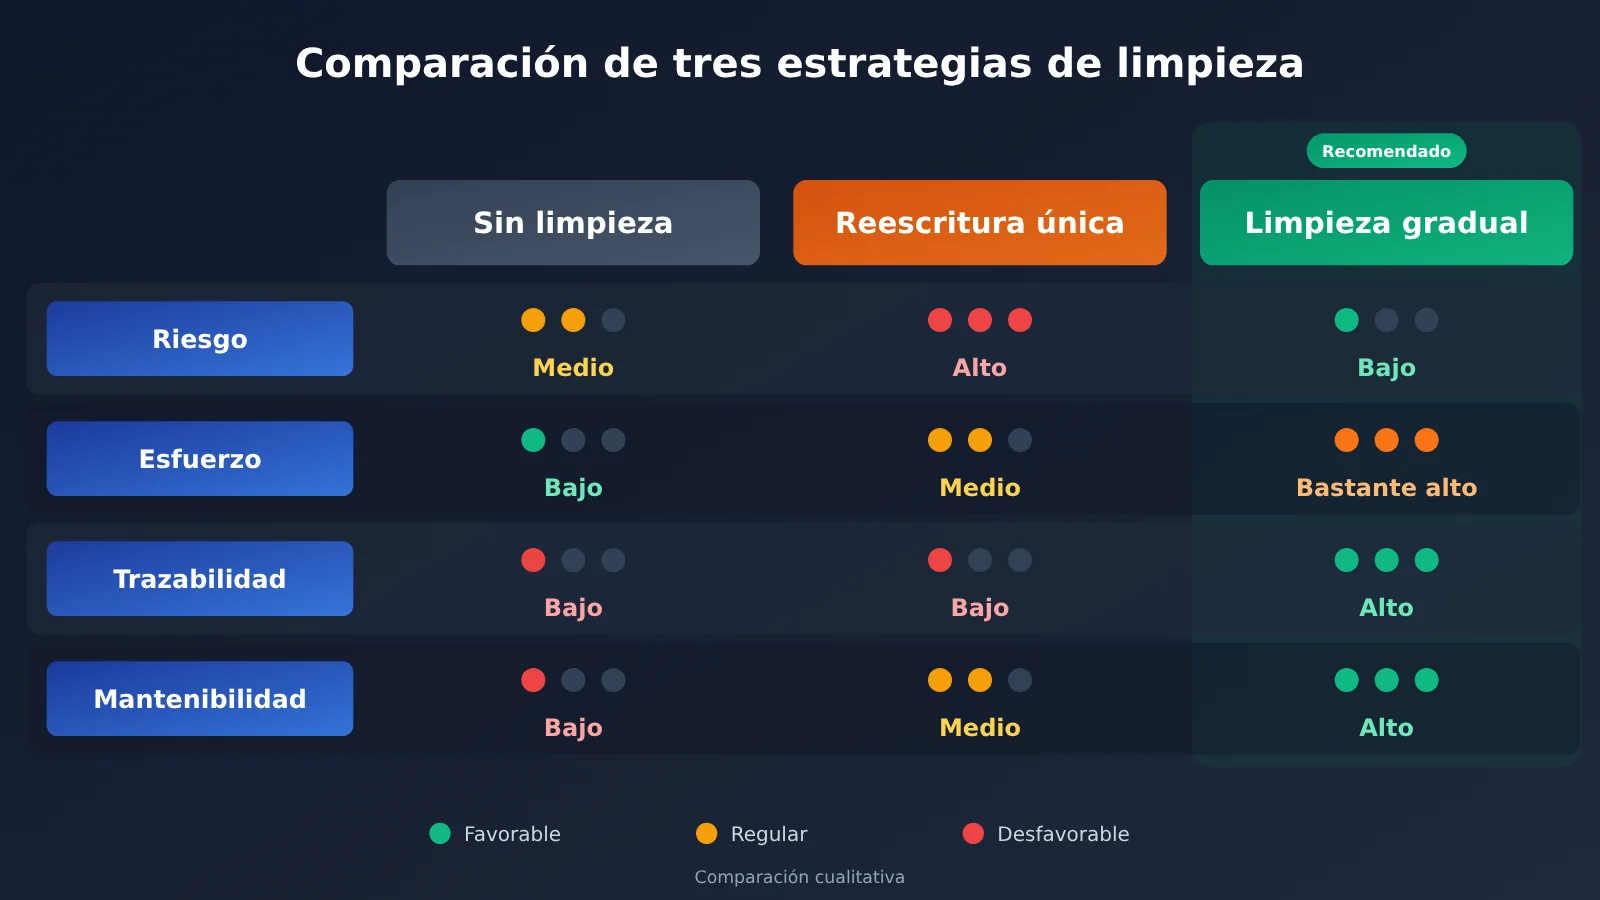
| Enfoque | Cómo se hace | Riesgo principal | Cuándo conviene |
|---|---|---|---|
| Conservar tal cual | Solo cambiar el nombre del modelo; no tocar nada más | El contenido inútil se acumula y cuesta aprovechar las capacidades del nuevo modelo | Actualizaciones temporales o falta de recursos de prueba a corto plazo |
| Reescritura de una sola vez | Escribir desde cero siguiendo la guía de indicaciones del nuevo modelo | Se pueden perder reglas de negocio implícitas | Indicaciones de pequeño tamaño o negocio en plena reestructuración |
| Limpieza progresiva por grupos | Clasificar, hacer ablación grupo por grupo y desplegar de forma gradual | Requiere tiempo para construir un conjunto de regresión | Entornos de producción y la mayoría de aplicaciones de mantenimiento a largo plazo |
Análisis comparativo de conservar tal cual: este enfoque sigue siendo el más rápido de desplegar, pero los efectos secundarios y la carga de mantenimiento de las indicaciones antiguas no desaparecen solos. En comparación, la limpieza progresiva por grupos encaja mejor en sistemas de producción que requieren iteración a largo plazo.
Análisis comparativo de la reescritura de una sola vez: este enfoque destaca por la limpieza de la estructura de las indicaciones, pero es fácil pasar por alto experiencia de negocio escondida en parches históricos. Si de verdad se opta por reescribir, conviene validar con el mismo conjunto de regresión y revisar una por una las reglas de negocio de la versión antigua.
Cálculo de costos de la limpieza de indicaciones y código de parches tras actualizar el modelo
Que las indicaciones sean más cortas no significa que baje el costo total. El costo de una llamada se puede estimar como «tokens de entrada × precio unitario de entrada + tokens de salida × precio unitario de salida»; si se usa caché, hay que distinguir la facturación de lectura y escritura de caché, y sumar las llamadas adicionales por reintentos y degradación. La salida del nuevo modelo puede ser más larga, y modificar el prefijo de las indicaciones también puede afectar los aciertos de caché; por eso conviene revisarlo con el uso real medido en el experimento.
💰 Nota sobre el criterio de precios: este artículo no incluye precios unitarios concretos. Para precios de modelos, criterios de facturación, precios unitarios de entrada/salida y precios de caché, toma como referencia los datos reales de la página de precios de APIYI https://docs.apiyi.com/models, y registra la fecha de consulta al hacer el cálculo.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la «compensación de modelo» en las indicaciones y en el código de parche?
La compensación de modelo es contenido que se añade para sortear las carencias de un modelo concreto: por ejemplo, insistir una y otra vez en el formato de salida, reparar JSON dañados o empalmar resultados truncados. La diferencia con las reglas de negocio es que, al cambiar a un modelo más capaz, puede que ya no haga falta.
Q2: Tras actualizar el modelo, ¿conviene borrarlo todo y reescribir las indicaciones y el código de parche?
Normalmente no. Reescribirlo todo queda más limpio, pero es fácil perder reglas de negocio implícitas y lecciones aprendidas de incidentes. En sistemas en producción conviene una limpieza gradual por grupos; si las indicaciones son muy pequeñas o el negocio está en plena refactorización, se puede considerar reescribir, pero aun así hay que validarlo con el conjunto de regresión.
Q3: ¿Cuándo es buen momento para limpiar las indicaciones y el código de parche?
El mejor momento es el periodo de evaluación del cambio de modelo, porque en ese momento ya hay que ejecutar la regresión de todos modos. Además, cuando la tasa de activación de los parches lleva mucho tiempo cerca de cero, o las indicaciones ya son tantas que nadie se atreve a tocarlas, también conviene programar una limpieza específica. No hagas una limpieza masiva justo antes de una gran promoción o de un pico de negocio.
Q4: ¿Qué indicaciones y código de parche no se deben eliminar nunca por una actualización del modelo?
La validación de permisos, el filtrado de información sensible, la validación del esquema de salida, la protección contra inyección de indicaciones y los registros de auditoría deben conservarse siempre. Lo que controlan es el riesgo del sistema y no deben depender de que el modelo «probablemente se comporte bien». La lógica de reintentos ante errores de red y límites de tasa también forma parte de la infraestructura y no entra en el alcance de la limpieza.
Q5: ¿Cómo comparar rápido el modelo nuevo y el antiguo mediante la API?
Una vez listo el conjunto de regresión, haz que los grupos de prueba nuevo y antiguo usen las mismas indicaciones y parámetros, cambiando solo el nombre del modelo. Con APIYI puedes invocar varios modelos con formatos de interfaz compatibles con OpenAI o Anthropic, lo que facilita cambiar entre ellos dentro del mismo script de pruebas. Para la configuración concreta, consulta la documentación: https://docs.apiyi.com
Q6: ¿Cómo saber si la limpieza realmente ahorra dinero?
Contabiliza por separado los tokens de entrada, los tokens de salida, los aciertos de caché y el número de reintentos antes y después de la limpieza, y multiplícalos por el precio unitario vigente. Para los precios unitarios y el cobro de caché, consulta la página de precios de APIYI: https://docs.apiyi.com/models. Además de comparar el coste por invocación, mira también el coste por tarea exitosa: este último se acerca más al gasto real del negocio.
Q7: ¿Qué limitaciones tiene este proceso de limpieza?
El conjunto de regresión solo cubre problemas conocidos; pasar las pruebas no significa que no vayan a surgir situaciones nuevas en producción, así que el despliegue gradual y el monitoreo no son opcionales. El proceso también requiere mano de obra, y las herramientas internas de baja frecuencia o bajo riesgo no tienen por qué seguirlo al pie de la letra. Cuando hay pocas muestras, las métricas pueden oscilar bastante y no conviene sacar conclusiones demasiado finas a partir de ellas.
Conclusiones clave sobre la limpieza de indicaciones y código de parche tras actualizar el modelo
- Criterio de decisión: fíjate en si el contenido compensa al modelo anterior o si expresa reglas de negocio y controla riesgos.
- Cuatro categorías: compensación del modelo, reglas de negocio, barreras de seguridad y adaptación de interfaz; cada una requiere una acción distinta.
- Primero la línea base: en la primera ronda solo cambia el modelo; no modifiques a la vez las indicaciones y el código de parche.
- Ablación gradual: elimina un grupo de contenido relacionado cada vez; así, si hay una degradación, puedes localizar la causa con precisión.
- Mantén las validaciones: la lógica de reparación de JSON se puede revisar; la validación de esquema y la comprobación de permisos deben mantenerse.
- Revisa la degradación: antes de borrar un parche, confirma si el modelo anterior de la ruta de reversión todavía depende de él.
- Herramienta de comparación: puedes apoyarte en la interfaz compatible de APIYI y usar el mismo conjunto de scripts para cambiar de modelo y hacer pruebas de regresión.
Resumen
Después de actualizar el modelo, si conviene borrar o no las indicaciones y el código de parche no depende de la publicidad del nuevo modelo, sino de tus datos de regresión. Podemos resumir la limpieza en tres puntos:
- Aclara primero el origen: explica qué problema resuelve cada fragmento y luego clasifícalo en las cuatro categorías.
- Decide con experimentos: establece una línea base, haz ablaciones por grupos y usa métricas definidas de antemano para decidir qué mantener y qué eliminar.
- Haz que los cambios se puedan revertir: despliega de forma gradual con interruptores y gestiona por capas el contenido relacionado con el modelo y las reglas de negocio.
Te sugiero empezar por un escenario con un volumen de llamadas moderado y riesgo controlable; primero recorre el proceso completo y luego llévalo al negocio principal. Si necesitas comparar entre varios modelos, puedes invocar los modelos de este artículo a través de APIYI. La forma de integración está en https://docs.apiyi.com y los costos deben consultarse con los datos reales de la página de precios: https://docs.apiyi.com/models.
📚 Referencias
- 36氪 – Una estudiante destacada de ciencias de la computación de Princeton se despide repentinamente de Anthropic, después de haber impulsado Claude Code: origen del contexto temporal del inicio de este artículo
- Enlace:
36kr.com/p/4055331476526214 -
Nota: publicado el 4 de noviembre de 2026. El método de limpieza de este artículo es un resumen de prácticas generales de ingeniería, no una paráfrasis del contenido de ese reportaje.
-
Documentación de APIYI: descripción del formato de la interfaz y de la configuración de acceso
- Enlace:
docs.apiyi.com -
Nota: se utiliza para confirmar
base_url, la ruta de la interfaz y la forma de invocación. -
Página de modelos y precios de APIYI: lista de modelos e información de facturación
- Enlace:
docs.apiyi.com/models -
Nota: los precios de los modelos, los criterios de facturación y los precios de caché mencionados en este artículo se basan en los datos reales de esta página.
-
Documentación oficial de Anthropic: guía de modelos Claude y de indicaciones
- Enlace:
docs.anthropic.com -
Nota: al actualizar los modelos Claude, se pueden consultar los cambios en la interfaz y las recomendaciones sobre las indicaciones.
-
Documentación oficial de OpenAI: guía de modelos GPT y de la API
- Enlace:
platform.openai.com/docs - Nota: al actualizar los modelos GPT, se pueden consultar los cambios de parámetros y las instrucciones de migración.
Autor: Equipo técnico de APIYI
Contacto técnico: Puede contactarnos a través de la página de inicio del sitio web de APIYI; para más materiales, visite el centro de documentación docs.apiyi.com.