Примечание автора: после обновления модели промпты и патчи нельзя удалять на глаз. В этой статье используется классификация из 4 категорий и 5-шаговый процесс регрессии, которые помогут решить, что удалить, что изменить, а что оставить.
В ноябре 2026 года статья 36氪 о том, как ключевой человек Claude Code покинул Anthropic, снова заставила многих разработчиков говорить об инструментах AI-программирования. Помимо историй о людях, у многих команд есть более практичный вопрос: после каждого обновления модели промптов и патчей становится всё больше — есть ли ещё смысл в их существовании? В этой статье мы расскажем о методе очистки «сначала классифицировать, затем сверить, потом выпускать постепенно», который поможет сокращать набор без ущерба для стабильности.
Это не статья с призывом «смело удалять всё». В промптах могут скрываться бизнес-правила, а в патчах — защитные ограждения; цена одного ошибочного удаления часто выше, чем переплата за токены. В статье также нет универсальных бенчмарков: эффект очистки зависит от ваших бизнес-примеров, и выводы нужно делать на своих данных.
Главная ценность: после прочтения вы научитесь определять, какие промпты и патчи можно удалить после обновления модели, и сможете выполнить очистку по процессу с возможностью отката.
Ключевые моменты очистки промптов и патчей после обновления модели
Сначала запомните простое правило: если фрагмент промпта или патч нужен, чтобы компенсировать слабые места старой модели, его стоит пересмотреть; если он выражает бизнес-правила или помогает управлять рисками, его нельзя удалять только из-за обновления модели. В таблице ниже — краткая версия процесса, о котором пойдёт речь дальше.
| Пункт | Что это значит | Зачем нужно |
|---|---|---|
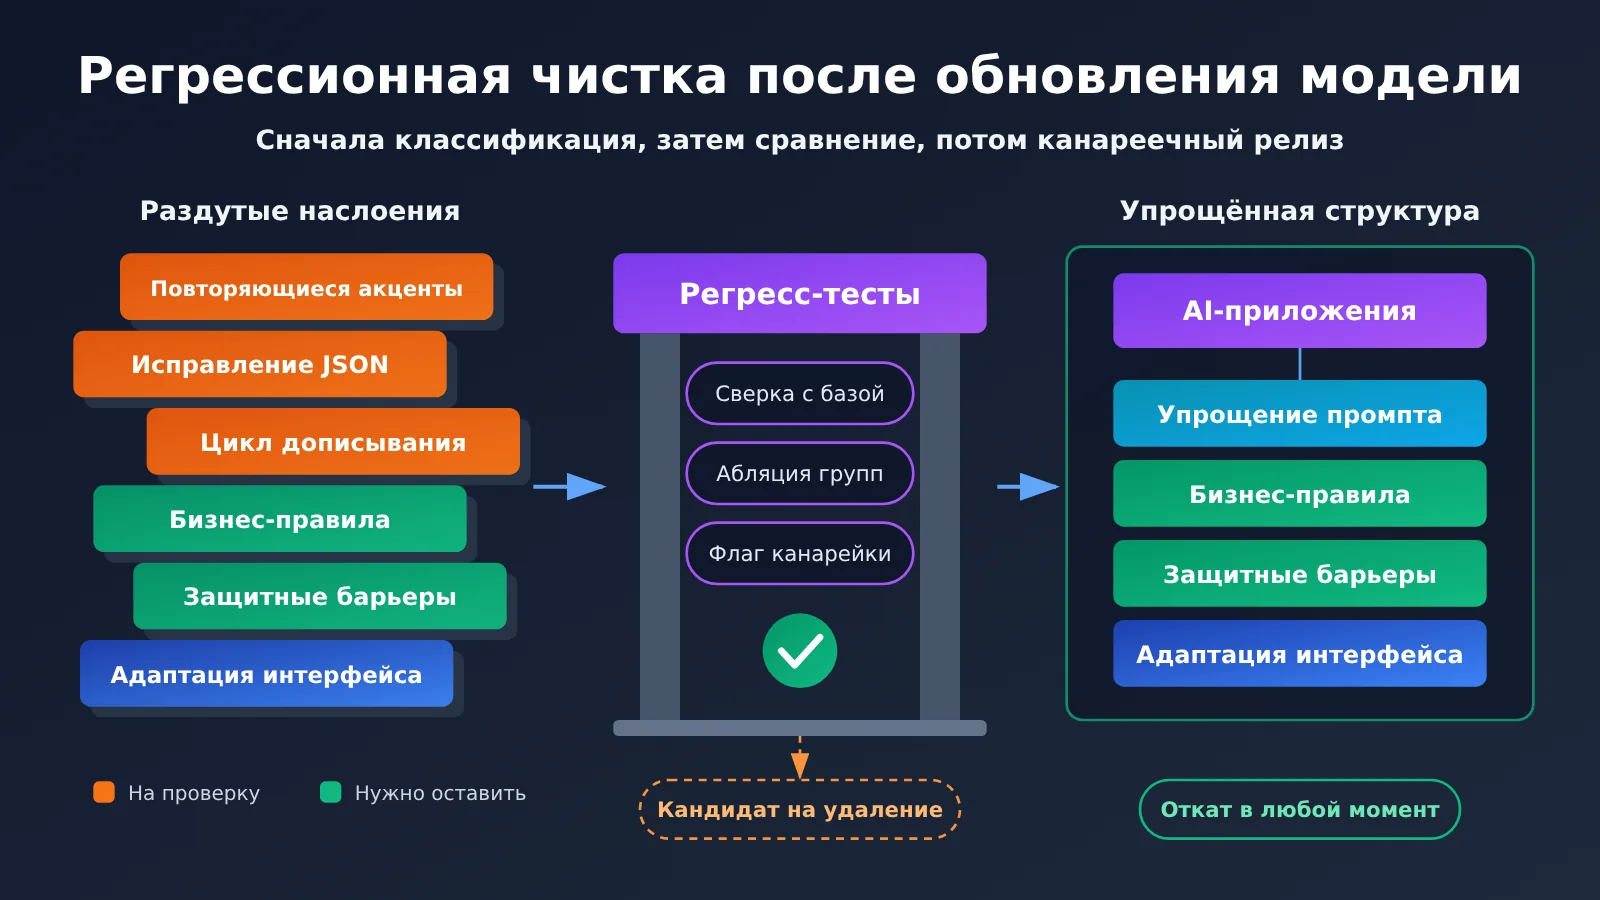
| Сначала классифицируйте, потом действуйте | Разделите всё на 4 категории: компенсация модели, бизнес-правила, защитные ограничения и адаптация интерфейса | Не удалить по ошибке важную логику |
| Меняйте только модель — это базовая линия | В первом раунде не трогайте промпты и код | Отделить эффект смены модели от эффекта очистки |
| Ablation-тесты по группам | Удаляйте по одной группе за раз и сравнивайте результаты | Точно понять роль каждого элемента |
| Постепенное развёртывание с фича-флагом | Управляйте результатами очистки через конфигурацию, чтобы всегда можно было откатиться | Снизить риск инцидентов в проде |
| Отдельно проверяйте счёт | Сокращение промпта не всегда означает снижение общих затрат | Чтобы не ошибиться, глядя только на количество токенов |
Почему после обновления модели промпты и патч-код устаревают
Большинство промптов в AI-приложениях «вырастают» из проблем на проде. Модель пропускает формат — добавляем фразу-акцент. Вывод обрезается — прикручиваем цикл дописывания. Модель изредка пишет кривой JSON — добавляем ещё одну функцию починки. Всё это было разумно в момент написания, но завязано на поведение старой модели, и эта привязка почти никогда не фиксируется документально.
После обновления модели возможны три сценария: проблема исчезла, и заплатка превратилась в мёртвый код; проблема осталась, и заплатка по-прежнему работает; поведение модели изменилось, и старый приём даёт обратный эффект. Например, настойчивые повторы, которые раньше нужны были, чтобы привлечь внимание модели, на новой модели с иной восприимчивостью к инструкциям могут заставить её переусердствовать с каким-то правилом. Поэтому цель ревизии после апгрейда — не «чем короче, тем лучше», а чтобы у каждого фрагмента была внятная причина существовать.
Как разложить промпты и патч-код на 4 категории
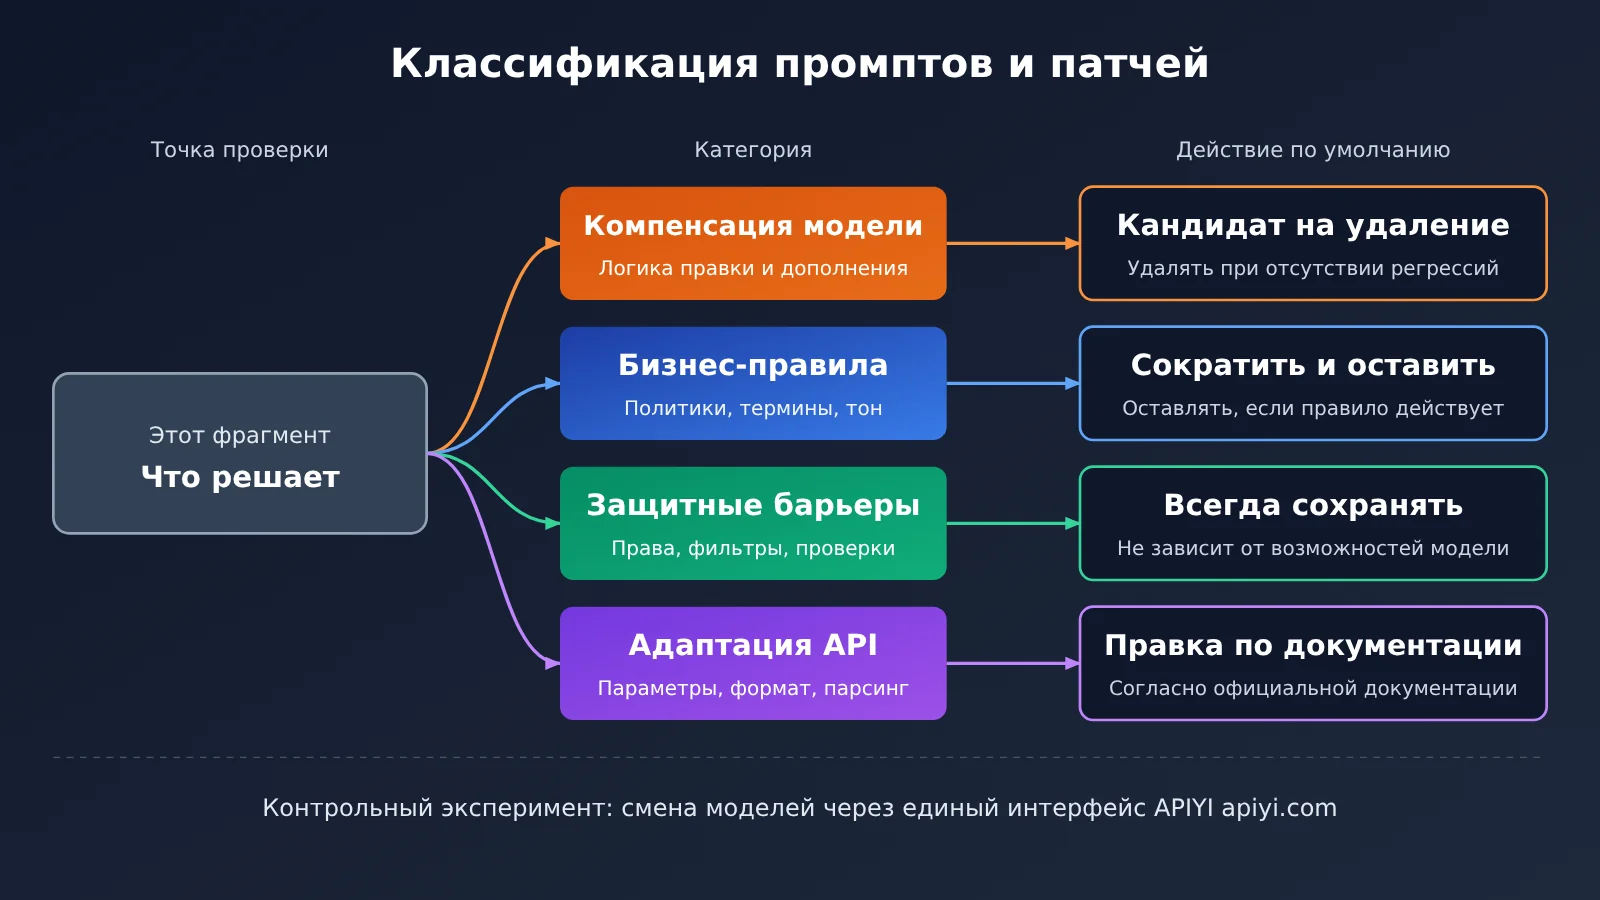
Перед чисткой разберите системный промпт по абзацам и выпишите по пунктам всю логику обработки до и после вызова модели. Дальше раскладываем по таблице — и решения об удалении уже опираются на основание.
| Категория | Типичные примеры | Действие по умолчанию | Основание для решения |
|---|---|---|---|
| Компенсация поведения модели | Многократные «не сокращай», функция починки JSON, цикл дописывания при обрыве | В список кандидатов на удаление | Удалять, только если регрессионные тесты не показали деградации |
| Бизнес-правила | Политика возвратов, глоссарий, tone of voice бренда, доменные ограничения | Оставить, но сжать формулировку | Оставлять, пока правило действует |
| Защитные ограждения | Проверка прав, фильтрация чувствительных данных, валидация вывода, защита от инъекций | Оставлять всегда | Не зависит от способностей модели |
| Адаптация интерфейса | Маппинг параметров, преобразование формата вызова инструментов, разбор ответа | Подстроить под новую модель | Ориентироваться на официальную документацию API |
Отдельно стоит проговорить одну деталь: логику починки можно рассматривать к удалению, логику валидации — нельзя. Когда структурированный вывод новой модели стал стабильнее, код, который регуляркой латает JSON, возможно, пора снять с эксплуатации, а вот проверку по Schema сохранить стоит. Точно так же цикл дописывания при обрыве вывода можно пересмотреть, а вот ретраи на сетевые ошибки и rate limit к способностям модели отношения не имеют — их в периметр чистки включать не нужно.
Быстрый старт по очистке промптов и патч-кода после обновления модели
Описанный ниже процесс из 5 шагов не требует сложной платформы — достаточно имеющегося тестового фреймворка и обычной таблицы. Главное — менять только одну переменную за раз и фиксировать каждое решение.
Шаг 1: инвентаризация источников промптов и патч-кода
С помощью git log и git blame проследите, когда был добавлен каждый фрагмент и с какой проблемой он связан, а в список занесите четыре пункта: где находится содержимое, к какой категории относится, какую проблему решает и как проверяется. Если происхождение какого-то промпта уже никто не может объяснить, помечайте его как «требует проверки», а не сразу считайте бесполезным.
Шаг 2: Соберите регрессионный набор для обновления модели
Регрессионный набор стоит составить из трёх частей: реальных обычных запросов из продакшена, неудачных примеров, которые раньше приводили к инцидентам, и сценариев на границах бизнес-логики. Размер выборки можно определить по уровню риска — даже небольшой команде имеет смысл начать с нескольких десятков ценных примеров. Поскольку вывод модели недетерминирован, ключевые примеры стоит прогонять несколько раз, чтобы случайное прохождение не принять за стабильное.
Шаг 3: Меняем только модель и строим контрольную базовую линию
На первом проходе меняйте только название модели, а промпт и код оставьте как есть; управляемые параметры вроде temperature зафиксируйте. Так вы увидите разницу между «старая модель + старая конфигурация» и «новая модель + старая конфигурация», а также заранее заметите изменения в параметрах API или структуре ответа. Если платформа поддерживает фиксированные версии модели, используйте именно их: так модель не изменится во время теста и не исказит результаты.
В таблице ниже перечислены параметры конфигурации, которые нужно проверить при подключении к контрольному эксперименту.
| Параметр | Как заполнять | На что обратить внимание |
|---|---|---|
base_url |
Используйте адрес соответствующего эндпоинта из документации APIYI | Адреса и пути для форматов OpenAI и Anthropic — по документации |
api_key |
Используйте ключ, созданный в консоли | Храните в переменных окружения, не коммитьте в репозиторий |
model |
Укажите название модели со страницы цен или из документации | В новой и старой экспериментальных группах всё, кроме названия модели, должно совпадать |
temperature |
Во всех группах используйте одно и то же значение | Диапазоны параметров у некоторых моделей могут отличаться — сверьтесь с документацией |
max_tokens |
Задайте достаточно места и для новой, и для старой модели | Чтобы обрезка ответа не была ошибочно принята за проблему качества модели |
🚀 Совет для быстрого старта: в контрольных экспериментах больше всего времени обычно уходит на адаптацию под несколько наборов API. APIYI предоставляет API-доступ к моделям Claude, GPT и другим моделям из этой статьи и совместим с форматами API OpenAI и Anthropic. Обычно достаточно поменять
base_url,api_keyиmodel, чтобы начать тестирование. Инструкция по подключению — в документации APIYI: https://docs.apiyi.com
Шаг 4: Групповая абляция промптов и патчей кода
Когда базовый вариант стабилен, начинайте убирать группы по одной — начиная с категории компенсации модели. В каждой группе должно быть только то, что решает одну и ту же задачу. Например, сначала уберите промпты, связанные с «акцентом на формат», и соответствующие функции исправления, прогоните регрессию и только потом переходите к следующей группе. Если удалить слишком много за раз, при деградации будет трудно найти причину, и в итоге часто придётся откатывать всё целиком.
| Метрика | Что отслеживаем | На что опираться при решении |
|---|---|---|
| Проходимость ключевых кейсов | Проходят ли исторические инциденты и сценарии высокого риска | При деградации вернуть содержимое этой группы |
| Общая проходимость задач | Изменение качества на обычных запросах | Судить по порогу, заранее заданному командой |
| Частота срабатывания патчей | Сколько раз реально срабатывает логика исправления или продолжения генерации | Если долго близко к нулю, это можно считать основанием для удаления |
| Токены и задержка | Расход входных и выходных токенов и время ответа | Для оценки реальной выгоды от чистки |
| Доля ручного вмешательства | Доля передач человеку или доработок пользователем | Наблюдать после запуска, чтобы закрыть слепые зоны офлайн-выборки |
Критерии оценки стоит записать до запуска тестов, иначе команда легко начнёт подгонять их под результаты. С патчами кода можно сначала просто собирать наблюдения, не вмешиваясь: оставить их работать и параллельно логировать, «что было бы, если бы их не было». Через несколько дней по данным о срабатываниях решить, удалять ли их. Для высокорисковых бизнесов это особенно полезно.
Шаг 5: Поэтапный запуск с сохранением возможности отката
Очищенную версию лучше выпускать через конфигурационный переключатель: сначала на небольшую долю трафика, убедиться, что метрики стабильны, и только потом расширять охват. В записи об удалении нужно чётко указать основание — например, «регрессия такой-то версии модели пройдена, частота срабатывания патча стабильно близка к нулю», — чтобы при следующем обновлении можно было сразу воспользоваться этим решением.
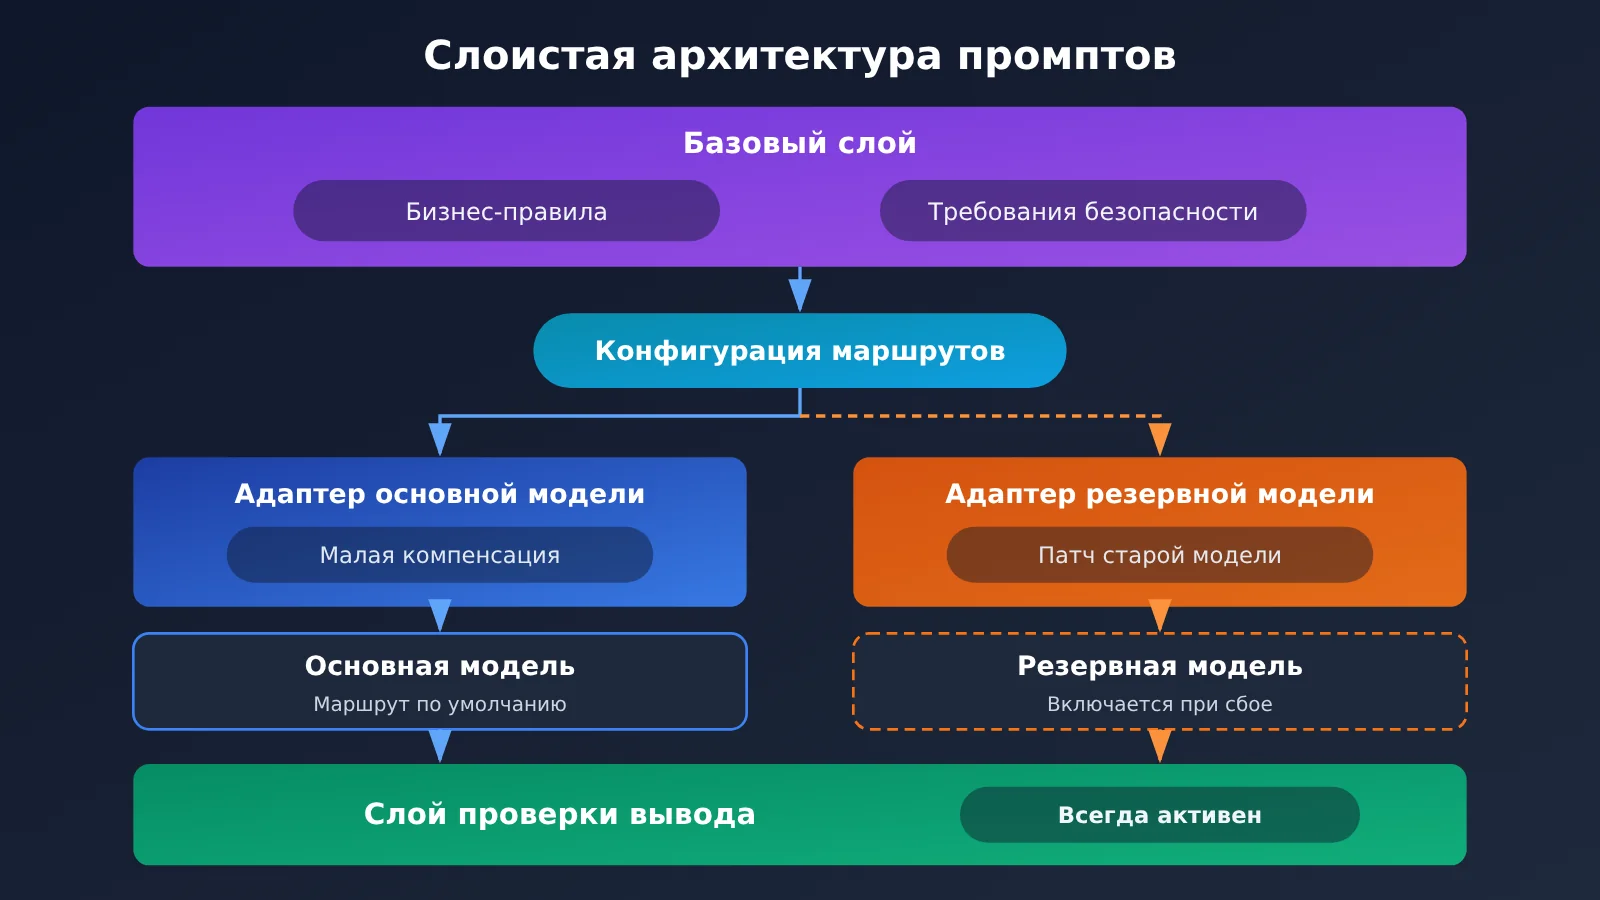
Отдельно стоит проверить цепочку деградации модели. Если при недоступности основной модели происходит откат на старую, патчи, написанные под старую модель, могут по-прежнему оставаться нужными. Надёжнее разделить промпт на два слоя: бизнес-правила и требования безопасности — в базовом слое, всё, что связано с моделью, — в слое адаптации, который загружается конфигурацией маршрутизации в зависимости от модели.
Сравнение трёх подходов к работе с промптами и патч-кодом после обновления модели
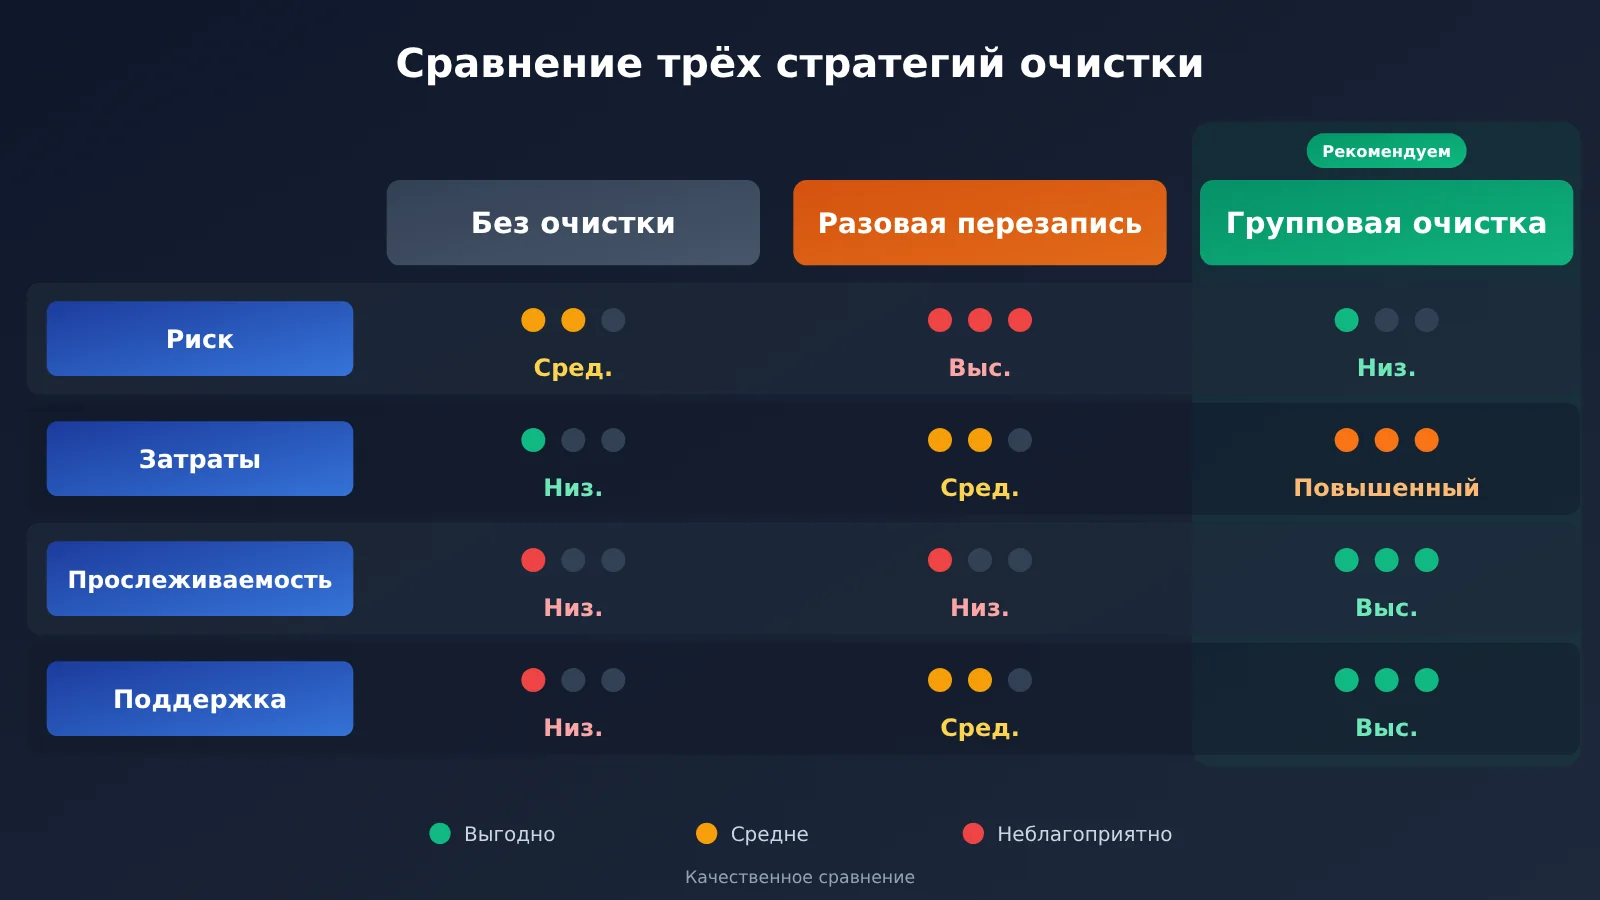
Убрать всё подчистую или не трогать ничего — это не единственные варианты. В таблице ниже сравниваются три распространённые стратегии; выбор зависит от бизнес-рисков и ресурсов команды.
| Подход | Что делаем | Основной риск | Когда подходит |
|---|---|---|---|
| Оставить как есть | Меняем только название модели, остальное не трогаем | Неэффективный контент накапливается, новую модель сложно раскрыть | Временное обновление или нет ресурсов на тесты в ближайшее время |
| Переписать за один раз | Пишем с нуля по руководству по промптам для новой модели | Можно потерять неявные бизнес-правила | Промпт небольшой или бизнес как раз перестраивается |
| Поэтапная очистка по группам | Классифицируем, затем по группам проводим абляции и выпускаем постепенно | Нужно время на создание регрессионного набора | Продакшен и большинство приложений с долгой поддержкой |
Разбор подхода «оставить как есть»: он по-прежнему выигрывает по скорости выхода в продакшен, но побочные эффекты старых промптов и нагрузка на поддержку никуда не денутся сами. При этом поэтапная очистка по группам лучше подходит для продакшен-систем, которые долго развиваются.
Разбор подхода «переписать за один раз»: он выигрывает в аккуратности структуры промпта, но бизнес-знания, спрятанные в исторических патчах, легко потерять. Если всё же выбираете переписывание, всё равно проверяйте той же регрессионной выборкой и построчно сверяйте бизнес-правила из старой версии.
Расчёт затрат на очистку промптов и патч-кода после обновления модели
Более короткий промпт не означает, что общая стоимость снизилась. Стоимость одного вызова можно оценить по формуле «входные токены × цена за входной токен + выходные токены × цена за выходной токен». Если используется кеш, нужно отдельно учитывать тарификацию чтения и записи кеша, а также дополнительные вызовы из-за повторов и деградации. Вывод новой модели может быть длиннее, а изменение префикса промпта может повлиять на попадание в кеш, поэтому проверяйте расчёт по фактическому потреблению в эксперименте.
💰 О ценах: в этой статье мы не приводим конкретные цены за единицу. Когда речь идёт о ценах на модели, принципах тарификации, стоимости входных и выходных токенов и кеша, ориентируйтесь на актуальные данные со страницы цен APIYI https://docs.apiyi.com/models и при расчётах записывайте дату запроса.
Частые вопросы (FAQ)
Вопрос 1: Что такое «компенсация под модель» в промптах и патч-коде?
Компенсация под модель — это всё, что добавлено, чтобы обойти слабые места конкретной модели: многократные напоминания о формате вывода, починка битого JSON, склейка обрезанных результатов. От бизнес-правил это отличается тем, что после перехода на более сильную модель такая компенсация может вообще перестать быть нужной.
Вопрос 2: После обновления модели нужно удалить все промпты и патч-код и переписать их с нуля?
Обычно не стоит. Полная переписка выглядит аккуратно, но легко теряет неявные бизнес-правила и опыт, полученный после инцидентов. Для продакшена лучше подходит постепенная чистка по группам; если промпты совсем небольшие или бизнес как раз перестраивается, переписать можно, но всё равно нужно прогонять регрессионный набор.
Вопрос 3: Когда уместно чистить промпты и патч-код?
Лучший момент — период оценки при смене модели: регрессию всё равно придётся гонять. Кроме того, стоит запланировать отдельную чистку, если срабатывания патчей долгое время близки к нулю или промптов стало столько, что никто уже не решается их трогать. Не устраивайте массовую чистку перед крупной распродажей или пиком нагрузки.
Вопрос 4: Что из промптов и патч-кода нельзя удалять при обновлении модели ни в коем случае?
Проверка прав доступа, фильтрация чувствительных данных, валидация выходной схемы (Schema), защита от промпт-инъекций, журналы аудита — всё это остаётся всегда. Они управляют рисками системы, и полагаться на то, что модель «скорее всего отработает хорошо», здесь нельзя. Логика ретраев при сетевых ошибках и лимитах тоже относится к инфраструктуре и в чистку не входит.
Вопрос 5: Как быстро сравнить старую и новую модель через API?
Подготовьте регрессионный набор и дайте старой и новой экспериментальным группам одинаковые промпты и параметры, меняя только имя модели. Через APIYI можно вызывать разные модели в формате, совместимом с OpenAI или Anthropic, — удобно переключаться внутри одного и того же тестового скрипта. Подробности по настройке — в документации: https://docs.apiyi.com
Вопрос 6: Как понять, что после чистки действительно стало дешевле?
Отдельно посчитайте входные и выходные токены, попадания в кэш и число ретраев до и после чистки, затем умножьте на текущую цену. Цены и биллинг кэша смотрите на странице тарифов APIYI: https://docs.apiyi.com/models . Сравнивайте не только стоимость одного вызова, но и стоимость одной успешно выполненной задачи — второе ближе к реальным расходам бизнеса.
Вопрос 7: Какие ограничения есть у этого процесса чистки?
Регрессионный набор покрывает только известные проблемы, и успешное прохождение тестов не гарантирует, что в проде не случится чего-то нового, — поэтому канареечный релиз и мониторинг пропускать нельзя. Процесс требует людей, и для низкочастотных или малозначимых внутренних инструментов копировать его целиком не обязательно. При небольшой выборке метрики могут сильно колебаться, и делать по ним слишком тонкие выводы не стоит.
Ключевые выводы: очистка промптов и патч-кода после обновления модели
- Критерий оценки: смотрите, компенсирует ли содержимое недостатки старой модели или же выражает бизнес-правила и контроль рисков.
- Четыре категории: компенсация модели, бизнес-правила, защитные барьеры и адаптация интерфейса — для каждой свои действия.
- Сначала базовый прогон: в первом раунде меняем только модель и не трогаем одновременно промпты и патч-код.
- Постепенное исключение: за один раз убираем лишь одну группу связанных фрагментов — тогда при деградации можно точно локализовать причину.
- Проверки сохраняем: логику исправления JSON можно пересмотреть, а валидацию схемы (Schema) и проверки прав доступа стоит оставить.
- Проверка при откате: прежде чем удалять патч, убедитесь, не зависит ли от него по-прежнему старая модель в цепочке отката.
- Инструмент сравнения: можно задействовать совместимый интерфейс APIYI и одним и тем же скриптом переключать модели для регрессии.
Итог
Удалять ли промпты и патч-код после обновления модели — ответ зависит не от рекламы новой модели, а от ваших данных регрессии. Всю работу по очистке можно свести к трём пунктам:
- Сначала выясните происхождение: объясните, какую задачу решает каждый фрагмент, и разложите их по четырём категориям.
- Решайте экспериментом: постройте базовую линию, проведите групповое исключение (ablation) и судите, что оставить, а что убрать, по заранее заданным метрикам.
- Сделайте изменения откатываемыми: выпускайте через фича-флаги с постепенным раскатыванием и разделяйте по слоям содержимое, связанное с моделью, и бизнес-правила.
Советуем начать со сценария с умеренным объёмом вызовов и управляемым риском: сначала прогоните весь процесс целиком, а потом распространяйте на основной бизнес. Если нужно сравнить несколько моделей, можно вызывать упомянутые в статье модели через APIYI — как подключиться, см. https://docs.apiyi.com, а стоимость смотрите по фактическим данным на странице цен https://docs.apiyi.com/models.
📚 Справочные материалы
- 36Kr — принстонская отличница по CS внезапно ушла из Anthropic и «зажгла» Claude Code: источник актуального контекста для начала этой статьи
- Ссылка:
36kr.com/p/4055331476526214 -
Примечание: опубликовано 4 ноября 2026 года. Описанные здесь методы «чистки» — это обобщение универсальных инженерных практик, а не пересказ содержания той публикации.
-
Документация APIYI: описание форматов интерфейсов и настроек подключения
- Ссылка:
docs.apiyi.com -
Примечание: использовалось для проверки
base_url, путей эндпоинтов и способа вызова. -
Страница моделей и цен APIYI: список моделей и информация о тарификации
- Ссылка:
docs.apiyi.com/models -
Примечание: цены на модели, правила тарификации и стоимость кэширования, упомянутые в статье, соответствуют фактическим данным на этой странице.
-
Официальная документация Anthropic: руководство по моделям Claude и промптам
- Ссылка:
docs.anthropic.com -
Примечание: при обновлении моделей Claude здесь можно посмотреть изменения в API и рекомендации по промптам.
-
Официальная документация OpenAI: руководство по моделям GPT и API
- Ссылка:
platform.openai.com/docs - Примечание: при обновлении моделей GPT здесь можно посмотреть изменения параметров и инструкции по миграции.
Автор: техническая команда APIYI
Обратная связь по техническим вопросам: свяжитесь с нами на главной странице сайта APIYI, больше материалов — в центре документации docs.apiyi.com