Nota do autor: este artigo usa três dimensões — dificuldade da tarefa, custo do erro e escala de contexto — para explicar como rotear Modelos de Linguagem Grande por camadas de tarefa e reservar o modelo de ponta para as solicitações que realmente precisam dele.
Muitas equipes, ao integrar um Modelo de Linguagem Grande, começam enviando todas as solicitações para o modelo de ponta mais forte disponível. Na fase de protótipo isso não é problema, mas quando o volume de solicitações cresce a fatura sobe rápido — e a maior parte dessas solicitações poderia ser atendida por modelos pequenos e médios. Este artigo apresenta um método prático para rotear Modelos de Linguagem Grande por camadas de tarefa, ajudando você a identificar quais solicitações realmente merecem o modelo de ponta.
Não se trata de um artigo panfletário defendendo que “modelo barato é igualmente bom”. O modelo de ponta ainda tem vantagens claras em raciocínio complexo, alterações de código com cadeias longas e saídas de alto risco. O roteamento por camadas precisa resolver “entregar a solicitação certa ao modelo certo”, e não simplesmente espremer custos.
Valor central: depois de ler este artigo, você terá uma padronização de classificação de tarefas em 3 camadas, uma lista de verificação para configurar regras de roteamento e um método para calibrar a estratégia de roteamento com dados depois que o sistema entrar em produção.
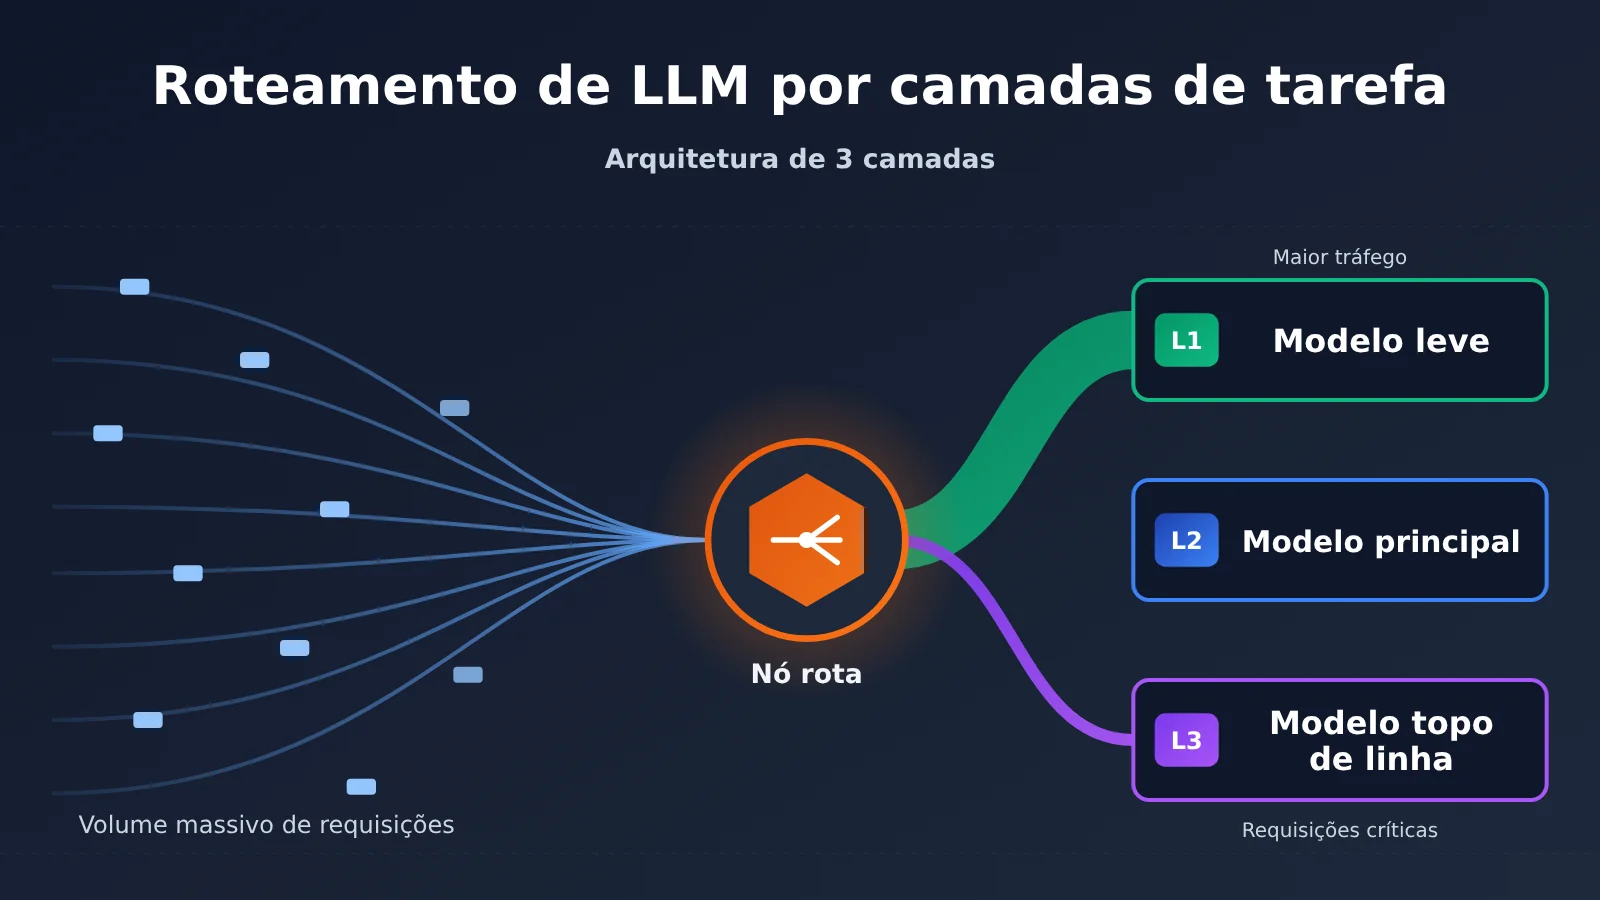
Pontos centrais do roteamento em camadas de grandes modelos por tarefa
Antes de discutir configurações específicas, vale apresentar alguns critérios centrais do roteamento em camadas. Eles determinam em qual camada uma requisição deve cair e se a estratégia de roteamento é sustentável de manter.
| Ponto | Descrição | Valor |
|---|---|---|
| Camadas por tarefa, não por usuário | Requisições diferentes do mesmo usuário variam muito em dificuldade; use as características de cada tarefa como base de roteamento | Evita o desperdício de “todo usuário VIP vai para o modelo de ponta” |
| O custo do erro tem prioridade sobre a dificuldade da tarefa | Tarefas simples, mas com consequências graves em caso de erro, também podem exigir o modelo de ponta ou uma validação secundária | Controlar o risco de incidentes em produção |
| Padrão na camada intermediária, promoção ou rebaixamento conforme sinais | O modelo principal cobre a maior parte do tráfego; sobe ou desce de camada quando certas condições são atendidas | Menos regras, mais fácil de manter e de reverter |
| Falhas podem ser promovidas | Quando a saída de uma camada inferior não passa na validação, tenta novamente automaticamente em uma camada superior | Troca um pouco de custo de retentativa por qualidade geral |
| Calibração com dados | Registrar taxa de sucesso, taxa de retentativa e custo por tarefa de cada camada, ajustando limites periodicamente | A estratégia de roteamento continua eficaz conforme os modelos evoluem |
Detalhamento do roteamento em camadas: por que não usar o modelo de ponta em tudo
O cenário dos modelos em 2026 torna o roteamento em camadas ainda mais necessário. Tomando como exemplo informações públicas de materiais de referência, a OpenAI lançou o GPT-5.5 em 24 de abril de 2026, oferecendo contexto de milhões de tokens; no mesmo dia, a DeepSeek lançou a série V4, dividida nas especificações Pro e Flash, também com suporte a contexto de 1M e pesos abertos sob a licença Apache 2.0. Ao mesmo tempo, modelos como a série Claude Opus, Gemini 3.1 Pro e Kimi K2.6 também vêm reduzindo continuamente a diferença em tarefas de codificação e raciocínio.
Quando as pontuações dos principais modelos em benchmarks comuns se aproximam cada vez mais, o “custo por tarefa” se torna o indicador-chave para diferenciar os modelos. Há artigos de avaliação de terceiros que mencionam que vários modelos já têm pontuações muito próximas em benchmarks de codificação, e o que realmente separa os modelos é o custo para concluir cada tarefa. Também há análises indicando que, em cenários de agentes de codificação como o Claude Code, a maior parte do consumo de tokens não precisa ser processada pelo modelo mais avançado. Esses são pontos de vista de terceiros; as proporções específicas variam conforme o negócio, mas a direção é clara: usar o modelo de ponta onde ele realmente importa é mais vantajoso do que usá-lo em tudo.
Outro ponto que costuma passar despercebido é a latência. Modelos de ponta geralmente raciocinam mais profundamente e geram saídas mais longas; para tarefas instantâneas como classificação, extração e reescrita, o tempo de espera do usuário acaba aumentando. Os materiais de referência mencionam que, depois que o GPT-5.5 Instant se tornou o modelo padrão do ChatGPT, o comprimento das respostas diminuiu visivelmente e a taxa de alucinação caiu, o que mostra que versões mais leves voltadas para “perguntas e respostas rápidas” são, por si só, uma direção de produto reconhecida pelos fornecedores.
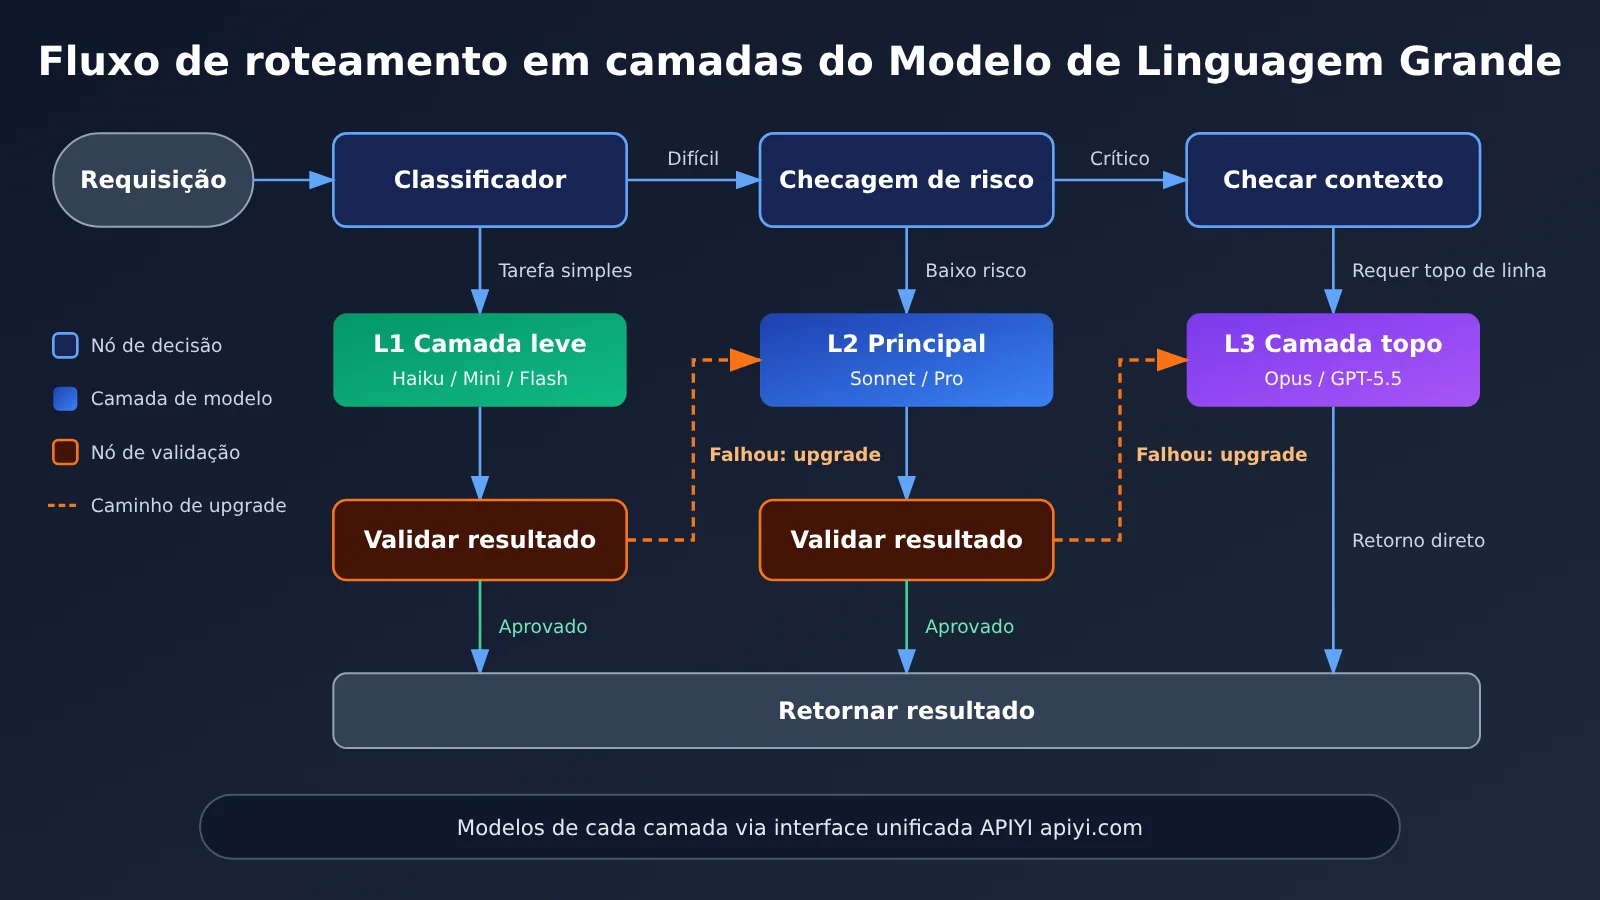
Como dividir o roteamento em camadas de Modelos de Linguagem Grandes em 3 níveis de tarefa
A essência do roteamento em camadas é encontrar, para cada tipo de tarefa, o modelo que seja “suficiente, e não mais que isso”. A tabela abaixo é o modelo genérico de divisão que consolidamos em vários projetos — você pode adaptar, adicionando ou removendo linhas conforme o seu negócio.
| Camada | Tarefas típicas | Sinais de decisão | Tipo de modelo recomendado |
|---|---|---|---|
| L1 Camada leve | Classificação de intenção, extração de palavras-chave, conversão de formato, reescrita de textos curtos, perguntas e respostas simples | Entrada curta, saída com estrutura fixa, regras de validação claras | Modelos nível Haiku, nível Mini, nível Flash |
| L2 Camada principal | Conversas rotineiras, resumo de documentos, geração de código de complexidade média, perguntas e respostas com RAG | Exige certa capacidade de compreensão e organização, mas os erros podem ser detectados e corrigidos | Modelos nível Sonnet, modelos de código aberto com muitos parâmetros, modelos generalistas nível Pro |
| L3 Camada de ponta (flagship) | Raciocínio em múltiplas etapas, refatoração de código entre arquivos, design de arquitetura, saídas de alto risco como jurídico ou financeiro | Dependência de múltiplas etapas, erros difíceis de detectar e com custo alto, análise abrangente de contextos muito longos | Modelos flagship como nível Opus, GPT-5.5, entre outros |
Como identificar tarefas da camada leve L1
A principal característica da camada L1 é que “a saída pode ser validada por programa”. Por exemplo, a classificação de intenção só pode escolher um entre rótulos fixos; a extração de JSON pode ser validada por schema; a conversão de formato pode comparar a integridade dos campos. Desde que as regras de validação sejam suficientemente rígidas, as partes em que o modelo leve erra podem ser interceptadas automaticamente e encaminhadas para uma camada superior.
Há artigos comparativos nos materiais de referência que apontam que modelos pequenos como Claude Haiku 4.5 e GPT-5.4 Mini têm focos diferentes: o primeiro se sai melhor em qualidade de código, enquanto o segundo leva vantagem em velocidade. Esse tipo de modelo é adequado para tráfego de alta frequência e baixa complexidade, sendo a principal fonte de economia de custos no roteamento em camadas.
Como identificar tarefas da camada principal L2
A camada L2 assume a maior parte das requisições que “exigem raciocínio, mas não são difíceis”, e também é o destino padrão recomendado de roteamento. Definir o padrão na camada intermediária traz duas vantagens: evita que erros do classificador façam muitas requisições complexas serem rebaixadas para a camada leve; e mantém as regras de promoção e rebaixamento simples.
O desempenho de modelos de código aberto nessa camada merece atenção. Há avaliações de terceiros nos materiais de referência que consideram que o DeepSeek V4 Flash não fica muito atrás do V4 Pro em tarefas de programação com limites bem definidos, e que o Kimi K2.6 também fica apenas alguns pontos atrás do Claude Opus 4.6 nos principais benchmarks de programação. Isso significa que muitas tarefas de programação que antes eram entregues por padrão ao modelo de ponta podem ser testadas primeiro na camada principal.
Método para identificar tarefas da camada L3 (flagship)
As requisições que realmente merecem um modelo flagship normalmente atendem a pelo menos dois dos seguintes critérios ao mesmo tempo:
- Cadeia de raciocínio longa: exige planejamento em várias etapas e validação repetida das conclusões intermediárias, por exemplo, localização de bugs complexos, provas matemáticas e agendamento com múltiplas restrições.
- Erros sutis e de alto custo: a saída parece razoável, mas erros de detalhe são difíceis de perceber, por exemplo, análise de cláusulas contratuais, cálculos financeiros e código relacionado à segurança.
- Alta dificuldade de síntese de contexto: é preciso correlacionar informações entre parágrafos em materiais com centenas de milhares de tokens, e não apenas recuperar um trecho específico.
- A camada inferior já falhou: a saída da camada L2 não passou na validação, ou o usuário relatou explicitamente que o resultado não é utilizável.
🎯 Recomendação técnica: o roteamento em camadas exige integração com vários modelos ao mesmo tempo. Se cada um for contratado separadamente e adaptado individualmente ao SDK, o custo de manutenção acaba anulando os ganhos do roteamento. A APIYI apiyi.com oferece chamadas de API para as séries de modelos GPT, Claude, Gemini, DeepSeek e outras abordadas neste artigo, com compatibilidade com os dois formatos de interface da OpenAI e da Anthropic; ao trocar de modelo, normalmente basta alterar o parâmetro do nome do modelo.
Início rápido ao roteamento em camadas de Modelos de Linguagem Grande
A seguir, apresento um esquema mínimo viável de roteamento em camadas usando o formato de lista de configuração. Este artigo não traz trechos de código: todos os itens de configuração essenciais são descritos em tabelas, e você pode implementá-los no framework que estiver usando.
Primeiro passo: camada de acesso unificada
O pré-requisito do roteamento em camadas é “trocar o modelo sem trocar o código”. A recomendação é que todas as requisições aos modelos passem por uma função de invocação unificada, que recebe apenas o tipo de tarefa, o conteúdo das mensagens e um parâmetro opcional de substituição de nível; internamente, a própria função decide, com base nas regras de roteamento, qual modelo será realmente invocado.
Quanto à forma de integração: se o seu projeto já usa o OpenAI SDK, você pode continuar com a interface no estilo chat completions; se usa o Anthropic SDK, pode continuar com a interface no estilo messages. A APIYI é compatível com os dois formatos. Para o endereço de acesso, o método de autenticação e a lista de nomes de modelos, consulte sempre as instruções do centro de documentação da APIYI em docs.apiyi.com.
Segundo passo: definir a configuração das regras de roteamento
A tabela abaixo lista os itens de configuração mais usados em um conjunto de regras de roteamento. Recomenda-se escrevê-los em um arquivo de configuração separado, para que seja possível ajustá-los sem reiniciar o serviço.
| Item de configuração | Significado | Sugestão de valor |
|---|---|---|
task_type |
Rótulo do tipo de tarefa, como classify, extract, summarize, code, reason | Marcado diretamente pela entrada do negócio, o que é mais estável do que a classificação feita pelo modelo |
default_tier |
Nível usado quando nenhuma regra é atendida | Sugere-se definir como L2, o nível principal |
risk_level |
Rótulo de risco do negócio, dividido em low, medium, high | Para high, rotear direto para L3 ou adicionar etapas de validação |
context_threshold |
Limite de tokens de entrada que dispara a escalada | Definir considerando a janela de contexto de cada modelo e o desempenho em textos longos |
validator |
Método de validação da saída, como JSON schema, regex, testes unitários ou revisão por um segundo modelo | Obrigatório no nível L1, recomendado no nível L2 |
max_escalation |
Número máximo de escaladas após falha na validação | Geralmente de 1 a 2 vezes, para evitar tentativas infinitas |
tier_model_map |
Nome do modelo e nome do modelo de reserva correspondentes a cada nível | Os nomes de modelos devem seguir a lista de modelos da documentação da APIYI |
Terceiro passo: configurar a lógica de escalada e degradação
Recomenda-se avaliar as regras de roteamento na seguinte ordem, sendo que as regras mais acima têm prioridade maior:
- Se o chamador especificou explicitamente um parâmetro de substituição de nível, use diretamente o nível indicado, o que facilita depuração e intervenção manual.
- Se
risk_levelfor high, rotear para L3, o nível de ponta. - Se o comprimento da entrada ultrapassar
context_threshold, rotear no mínimo para L2 e decidir, conforme o tipo de tarefa, se escala para L3. - Consultar a tabela por
task_type: tarefas de classificação, extração e conversão de formato vão para L1. - Se nenhuma das regras acima for atendida, usar
default_tier. - Se a saída não passar na validação do
validator, escalar um nível e tentar novamente, até atingir o limite demax_escalation.
Quarto passo: registrar as métricas principais de cada nível
Depois que o roteamento entrar em produção, registre no mínimo, para cada requisição: o nível, o nome do modelo, o número de tokens de entrada e saída, se houve acerto no cache, se houve escalada com nova tentativa e se a validação foi aprovada. Esses dados são a única base para ajustar os limites depois; uma estratégia de roteamento sem logs só pode ser ajustada por intuição.
🚀 Início rápido: sugere-se primeiro rodar os três níveis, L1, L2 e L3, no ambiente de testes com o mesmo lote de requisições reais, comparando taxa de aprovação e custo por tarefa. Com a APIYI (apiyi.com), você pode alternar entre vários modelos usando o mesmo conjunto de interfaces, o que facilita concluir rapidamente esse tipo de experimento comparativo.
Comparação entre modelos flagship e modelos principais no roteamento em camadas
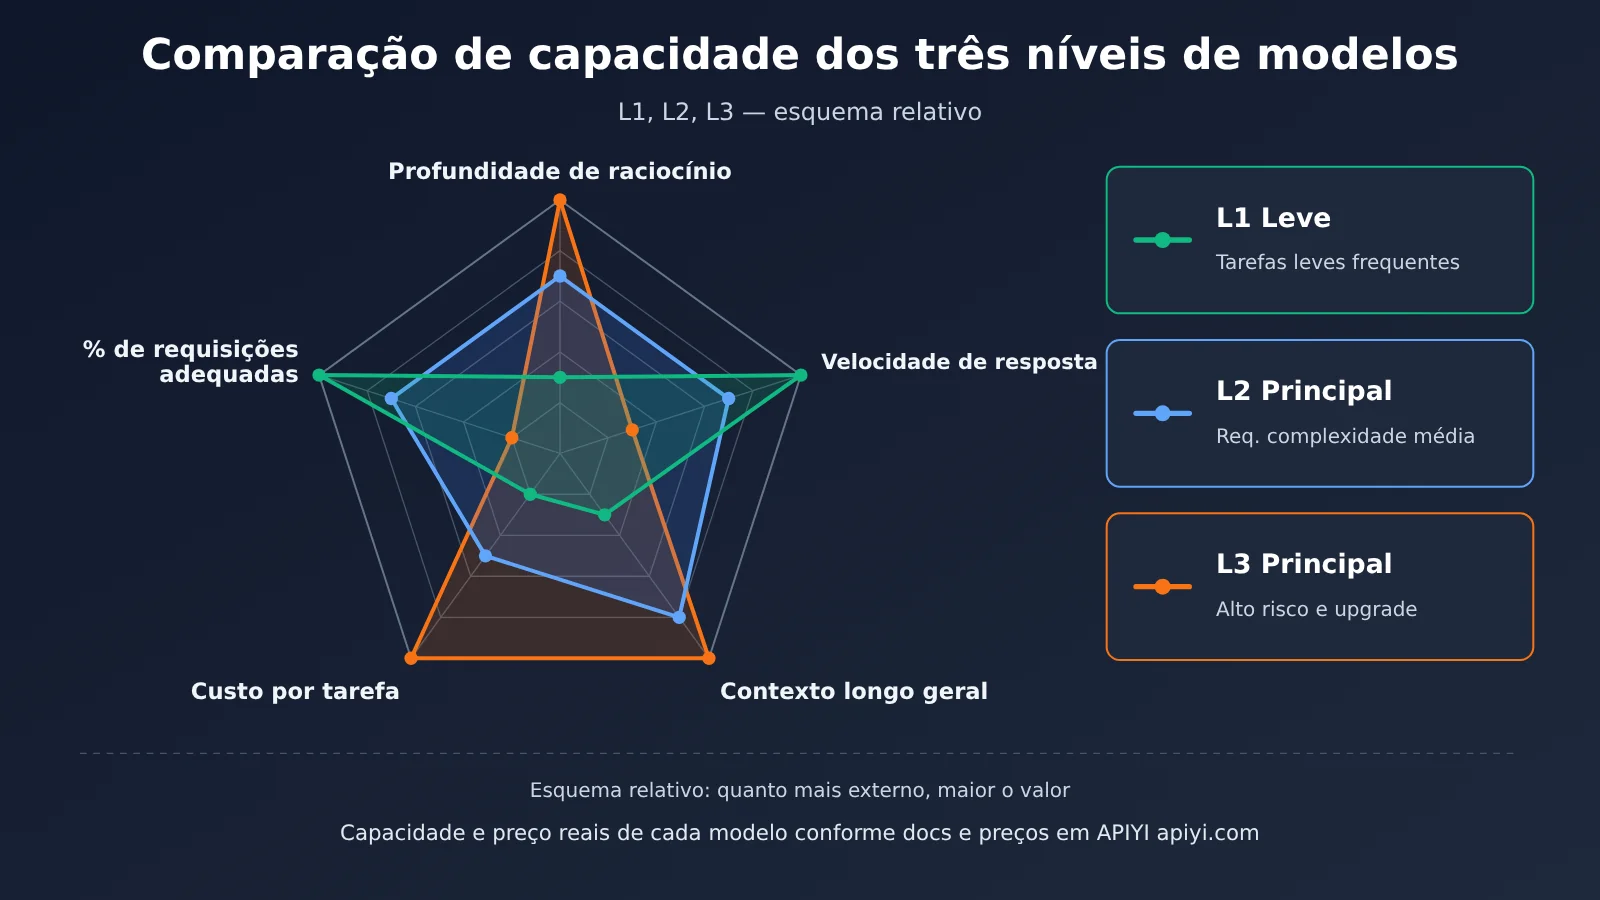
A tabela abaixo classifica por camada os principais modelos mencionados nas referências, para facilitar a escolha dos candidatos de cada nível. O posicionamento indicado vem de materiais públicos e avaliações de terceiros; o desempenho concreto varia conforme as atualizações de versão, então vale a pena retestar com os dados do seu próprio negócio.
| Modelo | Posicionamento comum | Camada adequada | Plataformas disponíveis |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | Codificação complexa e raciocínio em múltiplas etapas | Camada flagship L3 | APIYI apiyi.com, API oficial |
| GPT-5.5 | Flagship versátil, contexto de 1M | Camada flagship L3 | APIYI apiyi.com, API oficial |
| Gemini 3.1 Pro | Raciocínio e contexto longo, custo-benefício destacado | L2 a L3 | APIYI apiyi.com, API oficial |
| DeepSeek V4 Pro | Open-source de grande porte, contexto de 1M | Camada principal L2 | APIYI apiyi.com, API oficial |
| Kimi K2.6 | Capacidade de codificação próxima à dos flaghips | Camada principal L2 | APIYI apiyi.com, API oficial |
| DeepSeek V4 Flash | Baixo custo, ideal para tarefas bem delimitadas | L1 a L2 | APIYI apiyi.com, API oficial |
| Claude Haiku 4.5 / GPT-5.4 Mini | Tarefas leves de alta frequência | Camada leve L1 | APIYI apiyi.com, API oficial |
Análise comparativa entre modelos flagship e modelos principais
Análise comparativa dos modelos flagship: modelos flagship como Claude Opus e GPT-5.5 mantêm a liderança em raciocínio de múltiplas etapas, modificação de código entre arquivos e identificação de erros sutis. Porém, seu preço unitário e latência de resposta são visivelmente maiores; usá-los para tarefas simples como classificação e reescrita é um claro desperdício de recursos. Em contrapartida, os modelos flagship são mais adequados para a camada L3, lidando apenas com requisições de alto risco e com escalonamento após falhas das camadas inferiores.
Análise comparativa dos modelos principais open-source: DeepSeek V4 e Kimi K2.6 têm bom desempenho em codificação rotineira e processamento de documentos, e avaliações de terceiros mostram que a diferença em relação aos modelos flagship já é pequena em muitas tarefas. No entanto, em tarefas que exigem cadeias longas de raciocínio e com muitas restrições implícitas, a diferença ainda existe. Para a maioria das requisições de complexidade média, os modelos da camada principal continuam sendo a escolha padrão mais segura e econômica.
💡 Sugestão de escolha: qual modelo escolher em cada camada depende principalmente da distribuição das suas tarefas e dos requisitos de qualidade. Recomenda-se usar o APIYI apiyi.com para fazer testes comparativos dos modelos candidatos com o mesmo conjunto de amostras antes de definir o modelo principal e o modelo de reserva de cada camada.
Método de contabilização de custos do roteamento em camadas
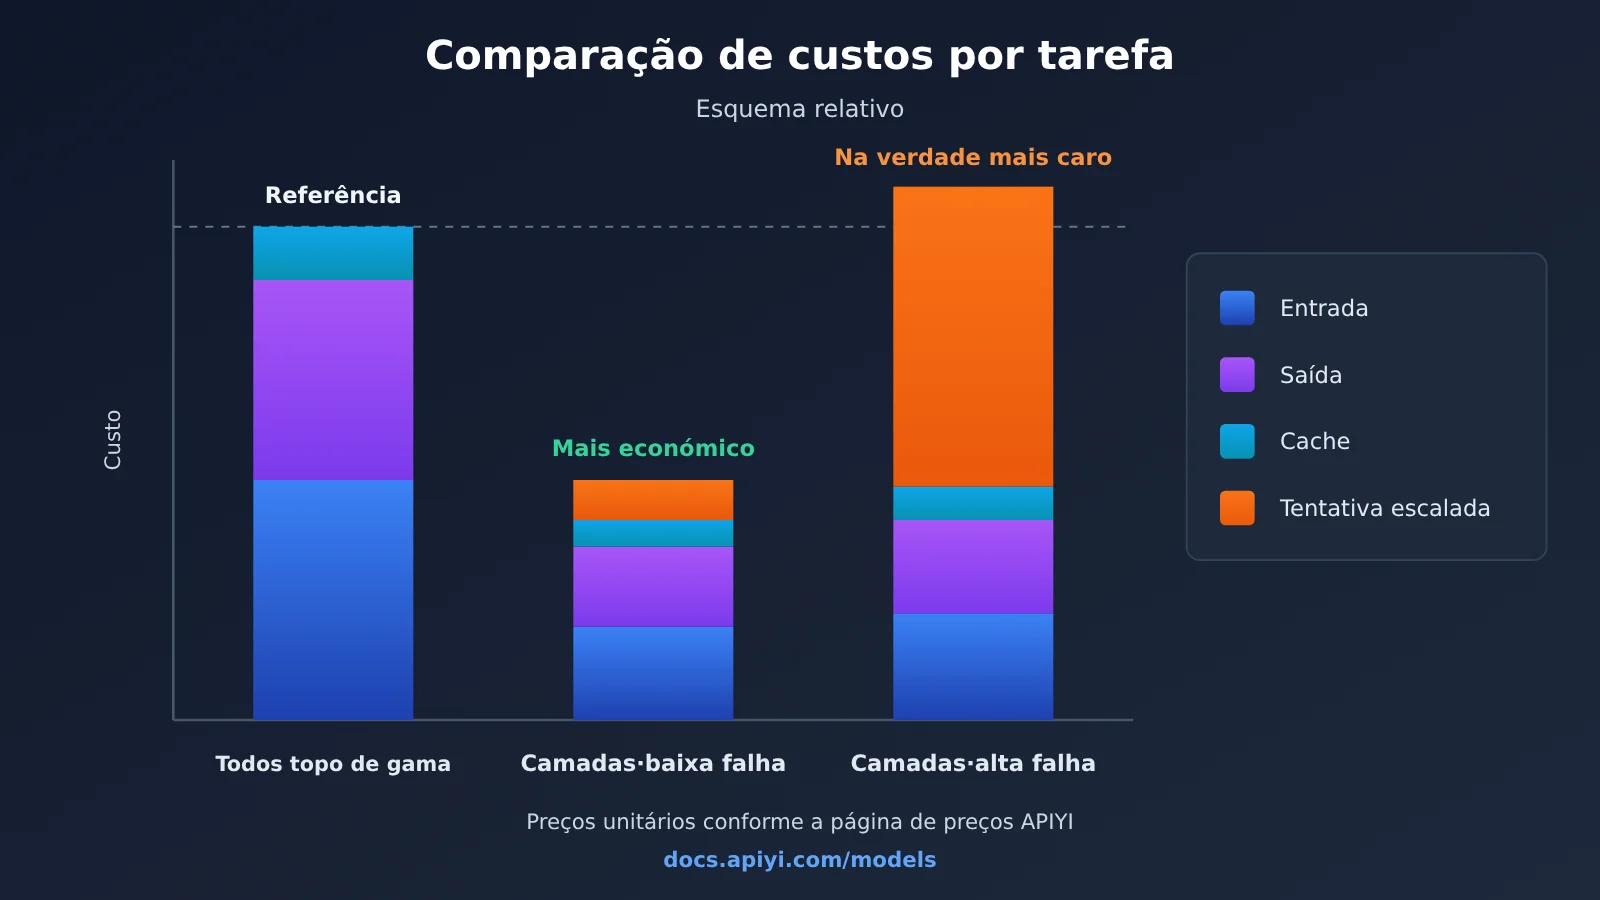
Saber se o roteamento em camadas economiza dinheiro não depende apenas do preço unitário — o que importa é o “custo total por tarefa”. O custo total de uma tarefa costuma ser composto por vários itens de cobrança, e qualquer erro em um deles distorce a conclusão.
| Item de cobrança | Descrição | Base de preço |
|---|---|---|
| Token de entrada | Total de comandos, contexto e histórico de mensagens | Com base nos dados reais da página de preços da APIYI docs.apiyi.com/models |
| Token de saída | Conteúdo gerado pelo modelo; modelos de raciocínio podem incluir tokens de pensamento | Com base nos dados reais da página de preços da APIYI docs.apiyi.com/models |
| Leitura de cache | Parte da entrada que acerta o cache de comandos | Com base nos dados reais da página de preços da APIYI docs.apiyi.com/models |
| Gravação de cache | Parte da entrada gravada no cache pela primeira vez; alguns modelos cobram separadamente | Com base nos dados reais da página de preços da APIYI docs.apiyi.com/models |
| Nova tentativa com escalonamento | Todos os custos gerados pela reexecução no nível superior após falha no nível inferior | Calculado de forma cumulativa conforme os níveis reais de invocação |
Equívocos comuns ao calcular o custo por tarefa do roteamento em camadas
O primeiro equívoco é contar os tokens de cache em dobro. Há artigos nos materiais de referência que alertam especificamente: ao calcular o custo de cache, é preciso separar leitura, gravação, entrada normal, saída e nova tentativa; caso contrário, é fácil contar o mesmo lote de tokens duas vezes. O segundo equívoco é ignorar o custo da nova tentativa com escalonamento — se a taxa de falha de validação da camada L1 for alta, “tentar primeiro o modelo barato” pode sair mais caro do que usar diretamente o modelo principal.
Por isso, recomenda-se uma fórmula simples para avaliar se um determinado tipo de tarefa é adequado para a camada inferior: custo único da camada inferior mais “taxa de falha multiplicada pelo custo único da camada superior”. Se esse valor for claramente inferior ao custo de usar diretamente a camada superior e, ao mesmo tempo, a qualidade final for aceitável, então esse tipo de tarefa é adequado para descer de camada. Os preços unitários específicos de cada modelo, os preços de cache e os critérios de cobrança devem ser consultados de forma unificada nos dados em tempo real da página de preços da APIYI docs.apiyi.com/models; este artigo não fornece números de preço específicos.
💰 Otimização de custos: Ao fazer cálculos de custo, recomenda-se ler diretamente na página de preços da APIYI os preços unitários de entrada, saída e cache de cada modelo e, em seguida, combinar com os dados dos seus logs para calcular o custo por tarefa. Na mesma plataforma, os critérios de cobrança são consistentes, o que reduz a chance de erro na comparação entre modelos.
Perguntas frequentes (FAQ)
Q1: O que é roteamento em camadas de Modelos de Linguagem Grande por tarefa?
É distribuir cada requisição para modelos de diferentes níveis de capacidade e custo, de acordo com o tipo de tarefa, o nível de risco e o tamanho do contexto. Tarefas simples vão para modelos leves, tarefas comuns ficam com o modelo principal e apenas tarefas complexas ou de alto risco são enviadas ao modelo de ponta.
Q2: Qual é a diferença entre roteamento em camadas e simplesmente “rebaixar para um modelo mais barato”?
O rebaixamento simples costuma ser uma substituição global, e a qualidade cai como um todo. O roteamento em camadas trata cada tipo de tarefa de forma diferente e conta com mecanismos de validação e escalonamento automático. Requisições que falham na camada inferior são refeitas por um modelo mais forte, o que permite controlar custos sem abrir mão do padrão mínimo de qualidade.
Q3: Depois dos lançamentos de novos modelos em 2026, a estratégia de roteamento precisa ser ajustada novamente?
Precisa. No primeiro semestre de 2026, há lançamentos frequentes de modelos como GPT-5.5, DeepSeek V4 e novas versões do Claude Opus, e as fronteiras de capacidade entre as camadas mudam rápido. Recomenda-se, após cada atualização relevante de modelo, rodar novamente um conjunto fixo de testes para medir a taxa de aprovação de cada camada e só então decidir se o mapeamento de camadas deve ser ajustado.
Q4: Quais requisições mais merecem usar o modelo de ponta?
Principalmente estas categorias:
– **Refatoração de código entre arquivos e localização de bugs complexos**: exige entender dependências entre muito contexto.
– **Saídas em áreas de alto risco**: como revisão de contratos, conferência de critérios financeiros e geração de políticas de segurança.
– **Tarefas de raciocínio com múltiplas restrições**: como agendamento complexo, avaliação de trade-offs entre soluções e deduções matemáticas.
– **Requisições que já falharam em modelos de camada inferior**: como fallback de escalonamento.
Q5: Como montar rapidamente um ambiente de teste de roteamento em camadas via API?
Recomenda-se usar uma plataforma de agregação de APIs com suporte a múltiplos modelos:
1. Acesse APIYI apiyi.com, cadastre-se e obtenha uma chave API.
2. No central de documentação da APIYI docs.apiyi.com, confira o endereço de acesso e os nomes de modelos disponíveis.
3. Seguindo a lista de configuração deste artigo, escolha um modelo para L1, L2 e L3 e compare as taxas de aprovação com o mesmo lote de amostras.
A APIYI é compatível com os formatos de interface da OpenAI e da Anthropic; projetos existentes normalmente podem ser integrados sem grandes alterações.
Q6: Se a própria classificação de tarefas for feita por um modelo, isso não aumenta o custo?
Há um pequeno custo extra, então recomendamos priorizar a marcação direta na entrada de negócio — por exemplo, a “entrada de perguntas e respostas do atendimento” já é, por padrão, um determinado tipo de tarefa. Só quando a entrada não permitir distinguir, use um modelo leve L1 para classificar; esse custo costuma ser bem menor do que o desperdício de usar um modelo de ponta por engano.
Q7: Quais são as limitações conhecidas do roteamento em camadas?
Basicamente três: primeiro, as regras exigem manutenção contínua e os limiares podem perder validade após atualizações de modelos; segundo, as tentativas de escalonamento aumentam a latência de parte das requisições, o que exige ponderação em cenários com requisitos altíssimos de tempo real; terceiro, o estilo de saída dos diferentes modelos não é consistente, e produtos voltados ao usuário podem precisar de pós-processamento unificado. Quando esses problemas aparecerem, dá para aumentar um pouco a camada padrão ou reduzir o número de camadas.
Q8: Que referência devo usar para os preços do roteamento em camadas?
Os preços unitários de entrada, saída e cache de todos os modelos, assim como os critérios de cobrança, devem seguir os dados reais da página de preços do APIYI: docs.apiyi.com/models. Os preços em artigos de terceiros podem ser diferentes do canal que você realmente utiliza, então não é recomendável usá-los diretamente para montar um orçamento.
Principais conclusões: roteamento de Modelos de Linguagem Grande por camadas de tarefas
- A divisão em camadas é baseada na tarefa, não no usuário: as requisições de um mesmo usuário variam muito em dificuldade e devem ser avaliadas uma a uma.
- O custo do erro importa mais do que a dificuldade: tarefas simples, mas de alto risco, também merecem o modelo de ponta.
- Usar a camada principal por padrão é o mais seguro: a camada intermediária serve de rede de segurança, com promoção e rebaixamento conforme os sinais; regras simples e fáceis de manter.
- As camadas inferiores precisam de validação: apenas saídas que podem ser verificadas por programa são adequadas para modelos leves.
- O custo deve considerar o total por tarefa: entrada, saída, cache e novas tentativas precisam ser calculados separadamente.
- Atualizações de modelo exigem novos testes: em 2026 a evolução dos modelos é rápida, e o mapeamento de camadas precisa de calibração periódica.
- Uma interface unificada reduz o custo de troca: com o APIYI apiyi.com, é possível usar o mesmo conjunto de interfaces para chamar vários modelos.
Resumo
Os pontos centrais do roteamento de modelos de linguagem grandes por camadas de tarefas:
- Divisão em três camadas: a L1 processa tarefas leves e verificáveis, a L2 assume o tráfego padrão, e a L3 recebe apenas requisições complexas, de alto risco e escalonamentos.
- Prioridade das regras: substituição manual, rótulos de risco, comprimento do contexto, tipo de tarefa e camada padrão, nessa ordem; em caso de falha, há escalonamento automático.
- Orientado a dados: registre a taxa de aprovação, a taxa de retentativa e o custo por tarefa de cada camada, e ajuste os limites com dados reais em vez de intuição.
O roteamento em camadas não busca “usar sempre o modelo mais barato”, mas sim direcionar a capacidade dos modelos de ponta para onde ela é realmente necessária. A sugestão é começar por uma ou duas tarefas de alta frequência, validar o fluxo completo de “classificação, invocação, verificação, escalonamento e registro” e só depois expandir gradualmente para mais áreas de negócio.
Recomenda-se validar rapidamente a solução em camadas por meio do APIYI apiyi.com. A plataforma oferece uma interface unificada para múltiplos modelos; as instruções de integração estão em docs.apiyi.com, e os preços devem ser consultados em docs.apiyi.com/models.
📚 Referências
- Lista de artigos do blog Ofox.ai (abril a maio de 2026): cobre lançamentos e comparações de modelos como GPT-5.5, DeepSeek V4 e Claude Opus
- Link:
ofox.ai/blog/page/35 -
Descrição: inclui análises de terceiros sobre roteamento de modelos híbridos e cálculo de custo de cache; este artigo cita apenas as informações factuais contidas nele
-
Lista de artigos do blog Ofox.ai (lançamentos e avaliações de modelos): cobre GPT-5.5 Instant, benchmarks dos principais modelos e comparação de custo por tarefa
- Link:
ofox.ai/blog/page/36 -
Descrição: útil para conhecer o posicionamento público dos principais modelos de 2026
-
Lista de artigos do blog Ofox.ai (modelos pequenos e de código aberto): cobre modelos leves e de código aberto como Claude Haiku, GPT-5.4 Mini e Llama 4
- Link:
ofox.ai/blog/page/37 -
Descrição: útil como referência ao selecionar modelos candidatos para as camadas L1 e L2
-
Central de documentação do APIYI: endereço de integração, formato da interface e descrição dos nomes dos modelos
- Link:
docs.apiyi.com -
Descrição: consulte antes de integrar as interfaces compatíveis com OpenAI ou Anthropic
-
Página de preços dos modelos do APIYI: dados de cobrança de entrada, saída e cache de cada modelo
- Link:
docs.apiyi.com/models - Descrição: todos os cálculos de custo deste artigo se baseiam nos dados reais desta página
Autor: Equipe técnica do APIYI
Contato técnico: sinta-se à vontade para falar conosco pela página inicial do APIYI apiyi.com; mais materiais de integração estão disponíveis na central de documentação docs.apiyi.com