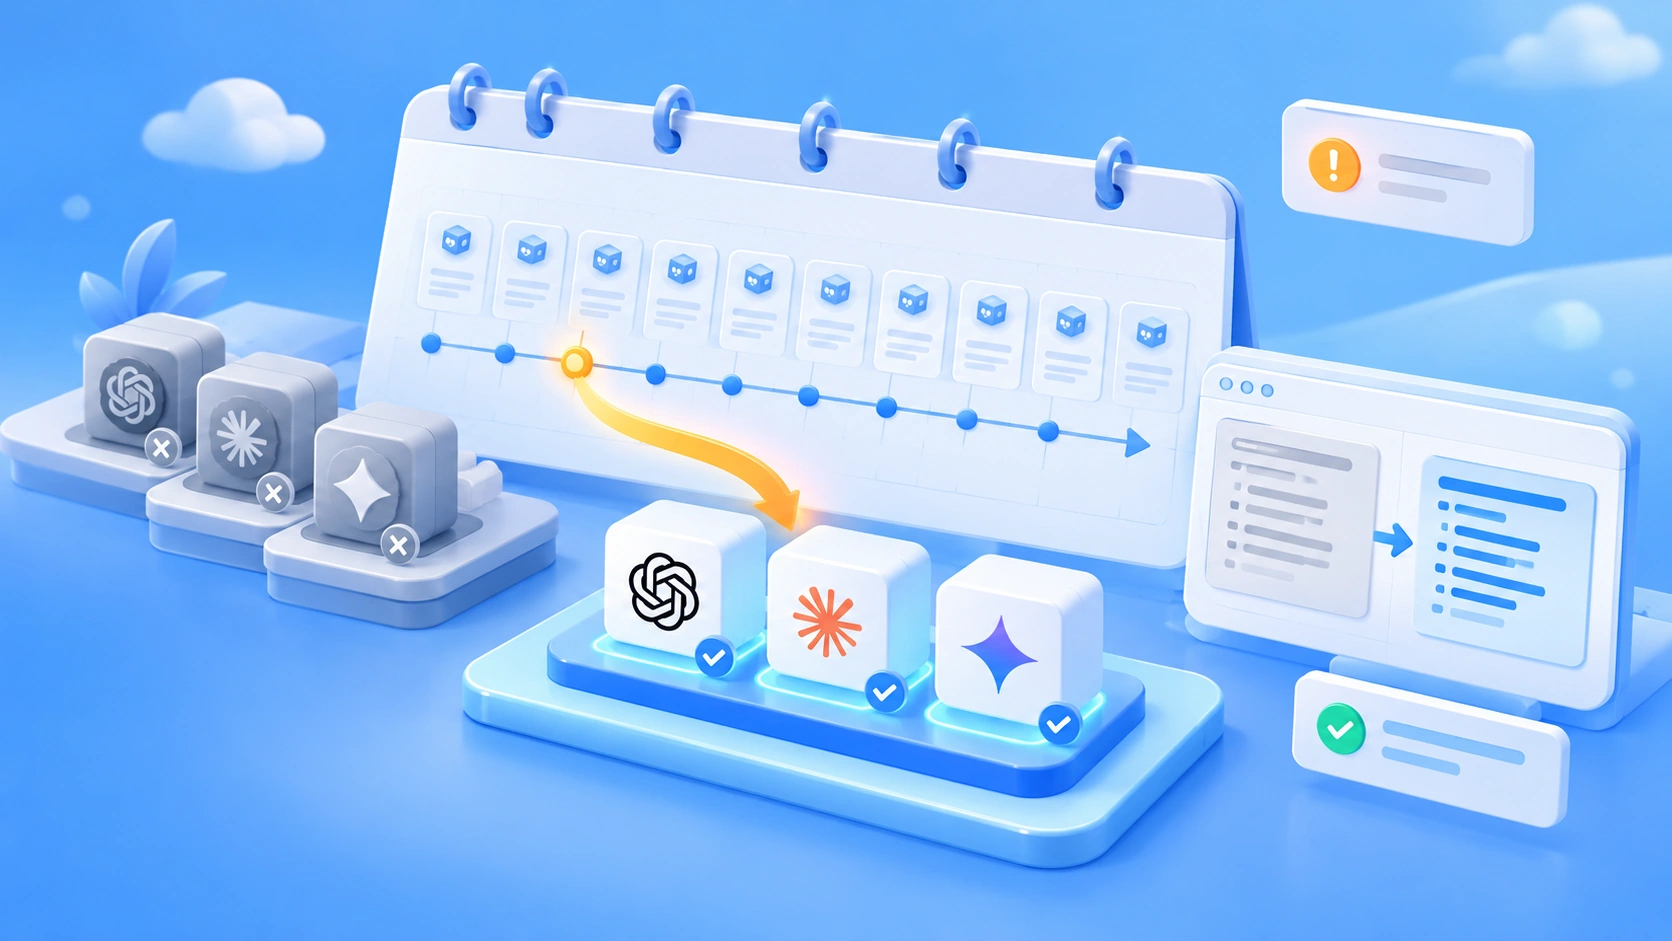
Nota do autor: O Google AI Studio anunciou a descontinuação do Gemini 2.5 Pro e do Gemini 2.5 Flash. A partir de 1º de dezembro, as requisições de API relacionadas serão roteadas automaticamente para outros modelos. Este artigo apresenta um plano prático de 6 etapas para que aplicações em produção concluam a migração antes do prazo.
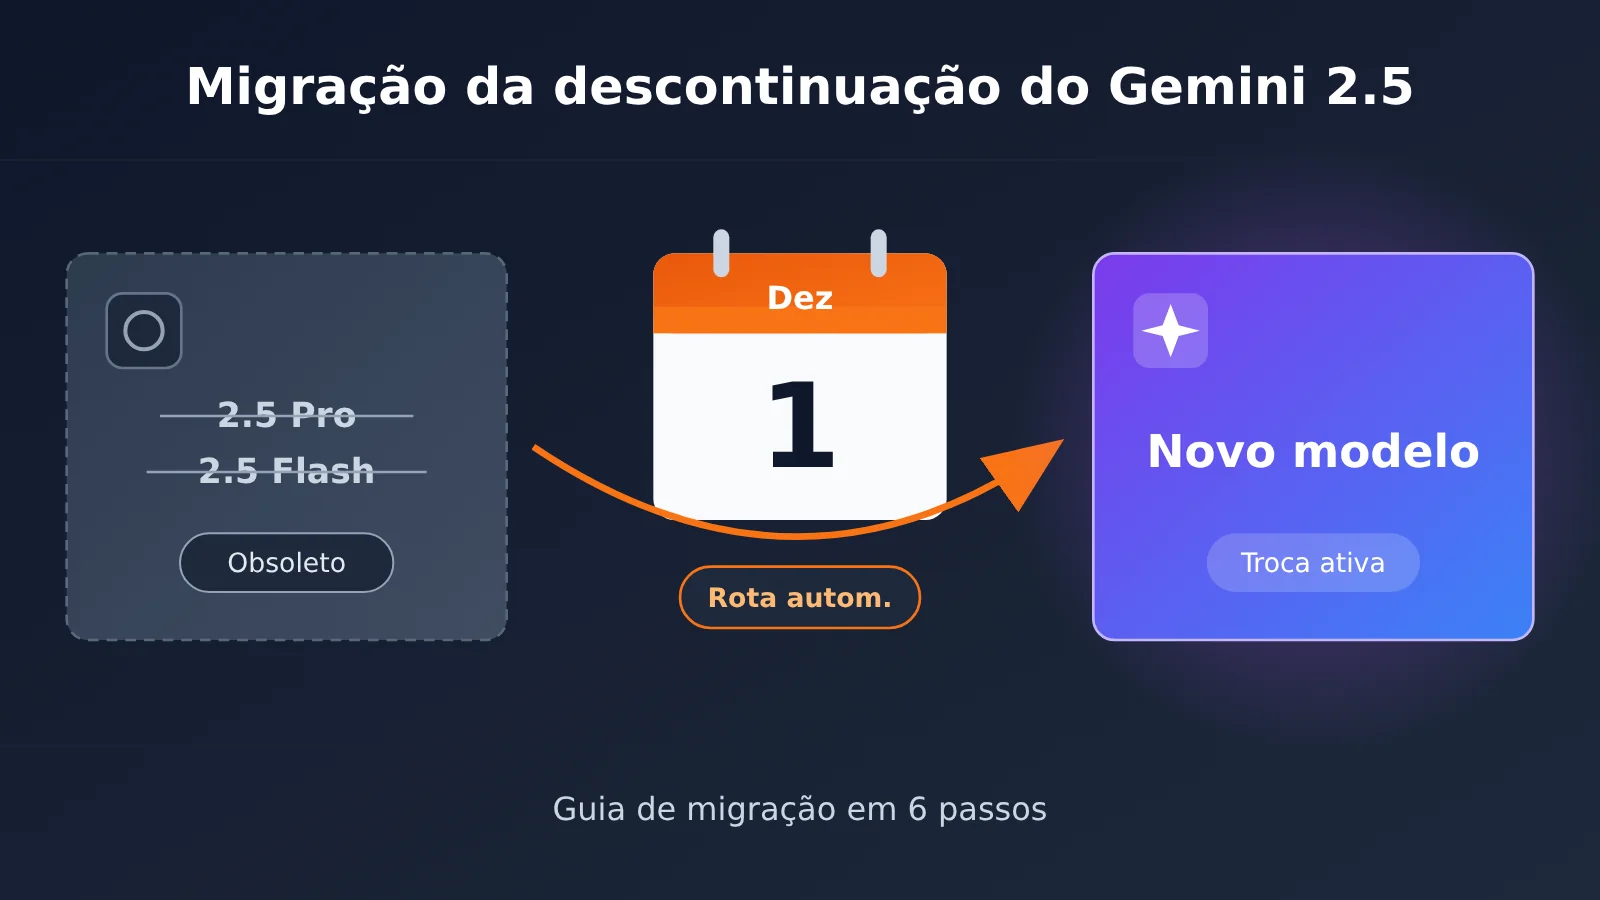
Se o seu serviço em produção ainda chama o Gemini 2.5 Pro ou o Gemini 2.5 Flash, falta menos de um mês para o roteamento automático de 1º de dezembro. De acordo com o aviso de descontinuação publicado pelo Google AI Studio, esses dois modelos entraram no processo de descontinuação; a partir dessa data, as requisições de API enviadas aos IDs dos modelos antigos serão encaminhadas automaticamente para os modelos sucessores definidos oficialmente.
Isso não é uma boa notícia do tipo “não precisa fazer nada”. O roteamento automático garante que as requisições não falhem de imediato, mas o comportamento do modelo, o estilo das respostas, a latência e os critérios de cobrança podem mudar. Para aplicações em produção que dependem de um formato de saída fixo, isso equivale a uma “atualização silenciosa” sem testes.
Valor principal: depois de ler este artigo, você terá em mãos um processo de migração em 6 etapas e conseguirá, antes de 1º de dezembro, substituir de forma proativa o Gemini 2.5 Pro/Flash, executar testes de regressão e fazer uma implantação canário, reduzindo ao mínimo a incerteza causada pelo roteamento automático.
Descontinuação do Gemini 2.5 Pro/Flash e pontos-chave do roteamento automático
Antes de começar a migração, vale organizar os fatos principais desta descontinuação do Gemini 2.5 Pro/Flash. A tabela abaixo traz apenas as informações que as referências conseguem confirmar e os impactos de engenharia derivados delas.
| Ponto | Descrição | Impacto em aplicações em produção |
|---|---|---|
| Objeto da descontinuação | Gemini 2.5 Pro e Gemini 2.5 Flash no Google AI Studio | Todos os serviços que codificam diretamente esses dois IDs de modelo estão no escopo de impacto |
| Data crítica | Em vigor a partir de 1º de dezembro | A janela para testes e implantação gradual é limitada, então é preciso planejar o cronograma de trás para frente a partir do prazo |
| Tratamento | As requisições de API são roteadas automaticamente para o modelo sucessor definido oficialmente | A interface não retorna erro de imediato, mas o modelo realmente executado muda |
| Maior risco | “Mudanças silenciosas” no estilo de saída, formato, latência e custo | Parsers downstream, métricas de avaliação e orçamento de custos podem apresentar desvios |
| Estratégia recomendada | Migrar explicitamente de forma proativa antes do prazo e concluir os testes de regressão | Transformar a “troca passiva de modelo” em um “upgrade controlado” |
Por que não dá para ficar de braços cruzados com o roteamento automático do Gemini 2.5
Muitos times, ao ver “roteamento automático”, respiram aliviados: se as requisições não vão falhar, é só esperar a transição natural em 1º de dezembro. O problema é que a estabilidade de aplicações com Modelos de Linguagem Grande nunca depende só de a interface retornar 200. Seus comandos foram ajustados para o comportamento do Gemini 2.5 Pro ou Flash; com outro modelo, o mesmo comando pode produzir conteúdo mais longo ou mais curto, e a ordem e o formato dos campos JSON também podem mudar de forma sutil.
O risco mais difícil de perceber está na observabilidade. Depois que o roteamento automático ocorre, seus logs continuam registrando o ID do modelo antigo, mas quem já processa a requisição é outro modelo. Assim que surgir uma reclamação de qualidade, a investigação pode ser facilmente enganada pelos logs, desperdiçando muito tempo para localizar a causa. O propósito da migração proativa é justamente manter alinhados “o modelo que aparece no log” e “o modelo que realmente está em execução”.
Como confirmar o modelo de destino específico do roteamento automático
As referências confirmam o mecanismo de “roteamento automático”, mas para qual modelo específico as requisições serão roteadas, se o canal Vertex AI também será afetado e se os IDs antigos ainda terão um período de retenção de alias — nesses pontos, é melhor consultar o anúncio oficial de descontinuação do Google e o changelog da Gemini API. Este artigo não faz suposições sobre esses detalhes; em vez disso, oferece um método de migração que se aplica independentemente do modelo de destino.
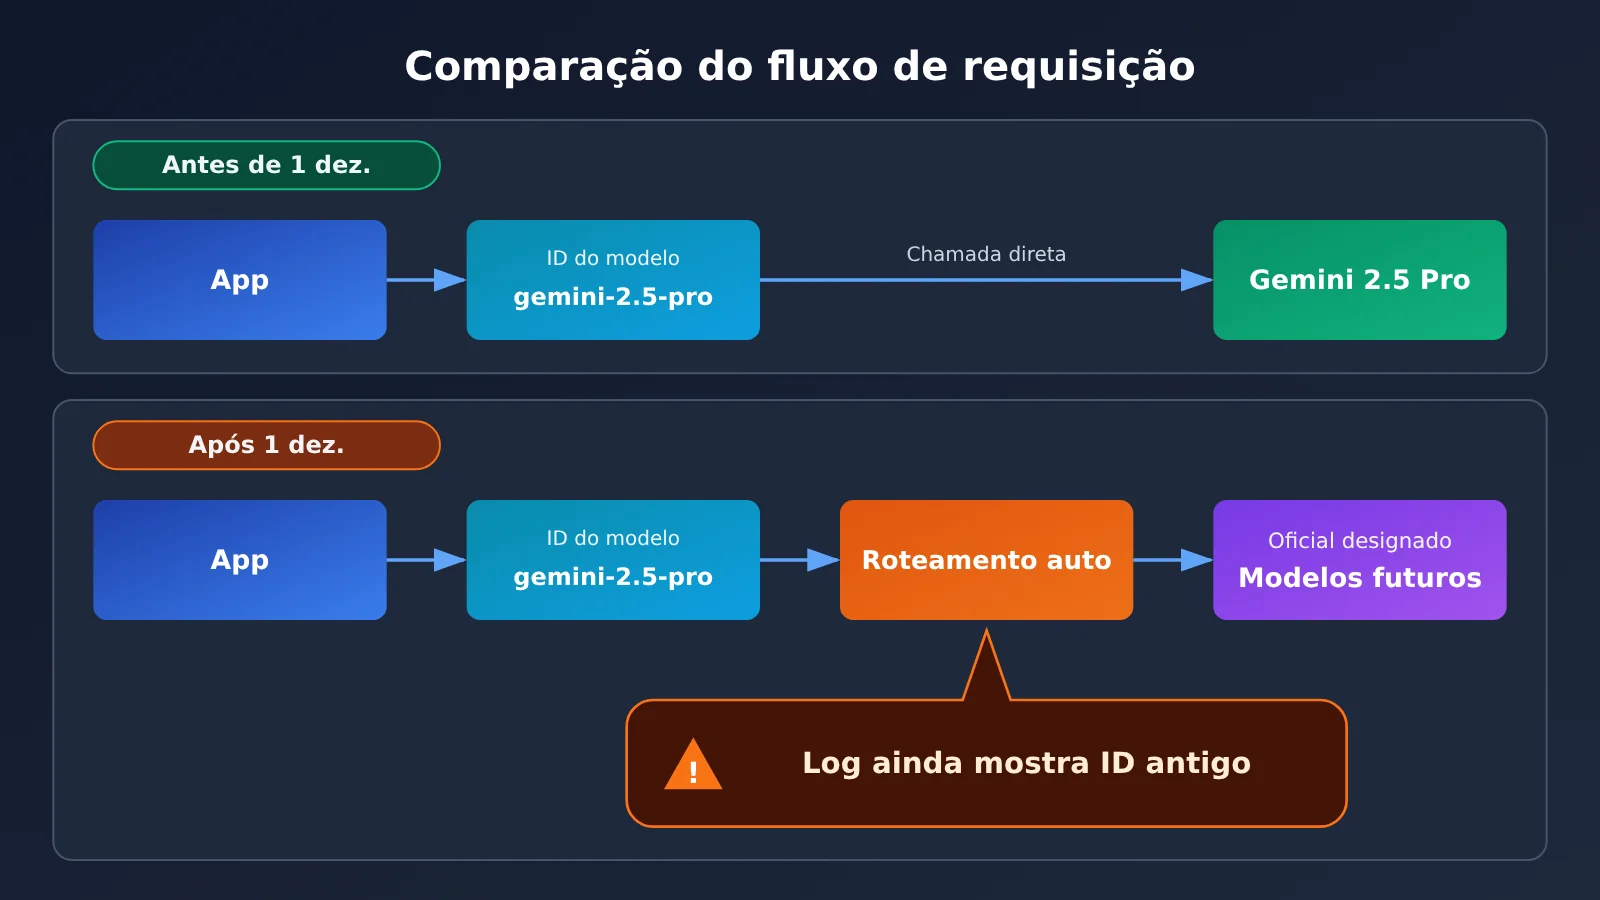
Avaliação de impacto da descontinuação do Gemini 2.5 Pro/Flash
Em aplicações de tipos diferentes, o impacto do roteamento automático do Gemini 2.5 varia bastante. Antes de mais nada, vale fazer uma classificação de impacto — só assim dá para definir a prioridade da migração e a profundidade dos testes.
| Tipo de aplicação | Uso típico | Grau de impacto do roteamento automático | Prioridade de migração |
|---|---|---|---|
| Saída estruturada / extração de informação | Exigir que o modelo retorne campos JSON fixos | Alto: campos ausentes ou mudança de formato causam falha direta no parsing | Máxima |
| Agent / chamada de ferramentas | Depende do formato dos parâmetros e do momento da chamada de função | Alto: a ordem das chamadas e os hábitos de geração de parâmetros podem mudar | Máxima |
| Análise de documentos longos | Usar janela de contexto longa para resumos e perguntas e respostas | Médio: a qualidade pode mudar; latência e custo precisam ser reavaliados | Alta |
| Atendimento ao cliente / geração de conteúdo | Saída em texto livre | Médio-baixo: mudanças de estilo são perceptíveis, mas geralmente não fatais | Média |
| Ferramentas internas / processamento em lote offline | Não em tempo real, pode ser reprocessado | Baixo: dá para observar e ajustar depois do roteamento | Baixa |
As três dependências mais fáceis de esquecer na migração do Gemini 2.5
A primeira é a dependência implícita do modelo. Algumas equipes não escrevem o ID do modelo diretamente no código de negócio, mas sim no centro de configuração, em variáveis de ambiente, na configuração de nós de plataformas low-code — ou até nos parâmetros padrão de SDKs de terceiros. Esses lugares passam facilmente batido numa busca global, então é preciso montar uma lista específica para checá-los.
A segunda é a dependência semântica de parâmetros. A linha Gemini 2.5 oferece configurações relacionadas a raciocínio (thinking), como o orçamento de raciocínio. Os modelos posteriores podem tratar esses parâmetros de forma diferente — suporte, valores padrão e faixa de valores válidos podem mudar. Reaproveitar os parâmetros antigos pode resultar em parâmetros ignorados, erros ou custos anormais.
A terceira é a dependência da linha de base de avaliação. Se o seu conjunto de avaliação offline ou as métricas dos experimentos A/B foram gerados como linha de base usando Gemini 2.5 Pro ou Flash, é obrigatório reestabelecer a linha de base depois da troca de modelo — caso contrário, todas as comparações de métricas seguintes ficam distorcidas.
🎯 Sugestão técnica: antes da migração oficial, você pode usar a APIYI apiyi.com para chamar em paralelo o modelo antigo e os candidatos a novo modelo com o mesmo lote de amostras de teste, comparando rapidamente as diferenças de saída. A APIYI é compatível com os dois formatos de interface, OpenAI e Anthropic; para trocar o modelo candidato normalmente basta alterar o nome do modelo. As instruções de integração estão no centro de documentação docs.apiyi.com.
Início rápido da migração do Gemini 2.5 Pro/Flash: fluxo em 6 etapas
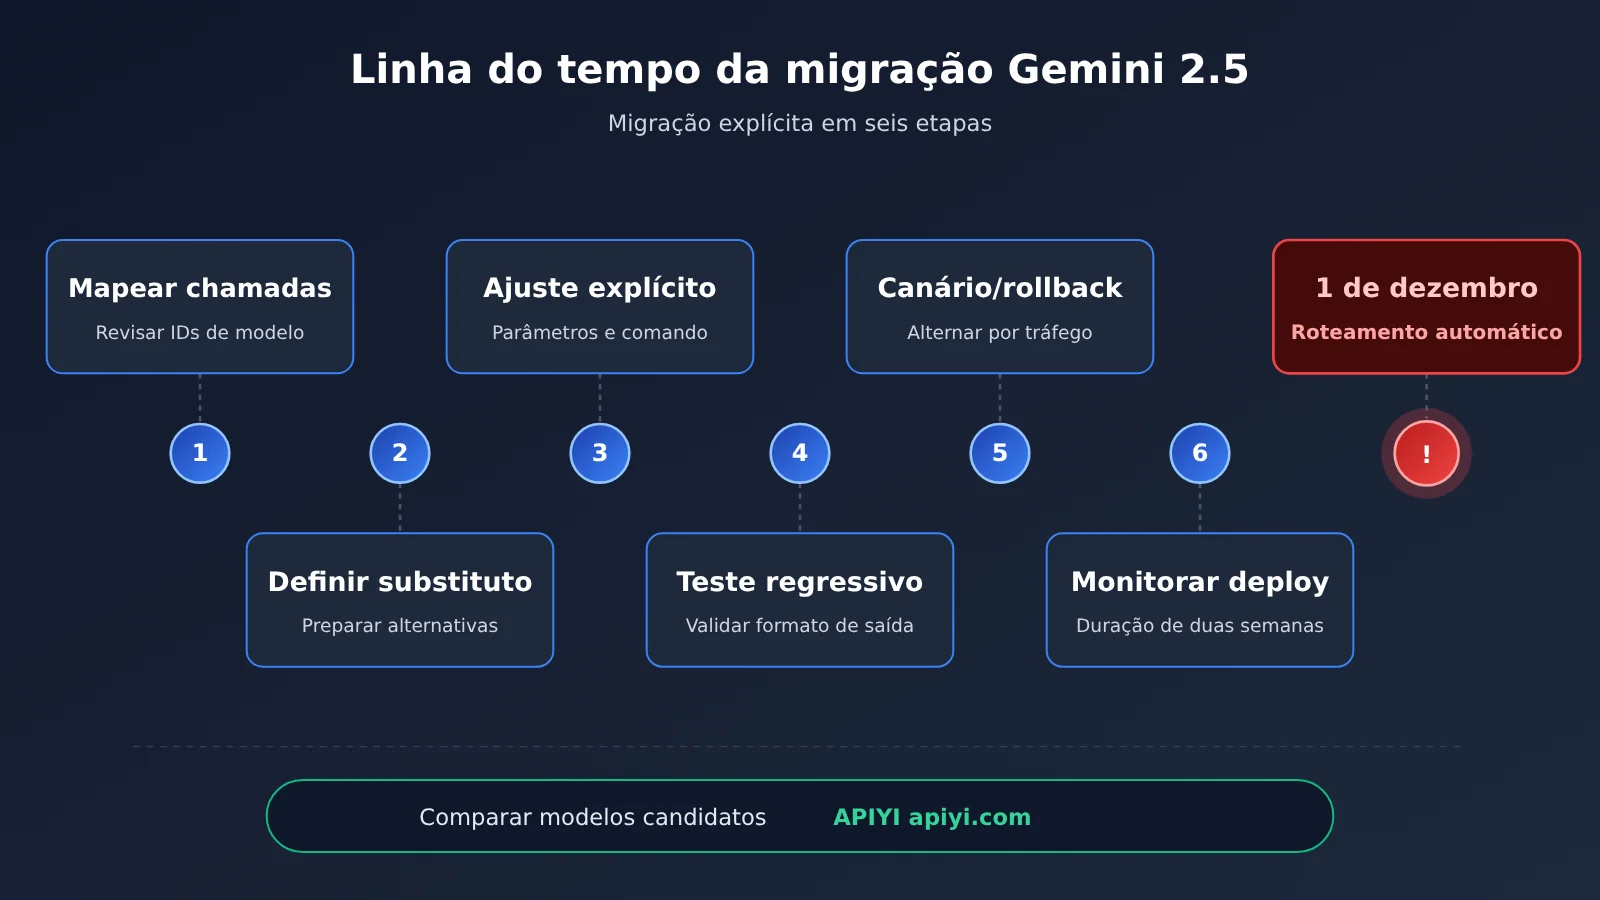
As 6 etapas abaixo são o fluxo padrão de migração que recomendamos, cobrindo toda a jornada, do inventário ao monitoramento após a entrada em produção. O processo não depende de qual será o próximo modelo e pode ser aplicado diretamente.
Etapa 1: mapear todos os pontos de invocação dos modelos Gemini 2.5
Busque globalmente por gemini-2.5-pro e gemini-2.5-flash no repositório de código, na central de configuração, nos scripts de implantação e nos fluxos de trabalho low-code. Fique atento também às variantes de ID com sufixos de versão ou marcadores de pré-visualização. Registre cada ponto de invocação em um inventário, anotando o serviço responsável, a pessoa responsável, o volume de chamadas e o nível de impacto da seção anterior.
Se o seu serviço invoca o Gemini por meio de um gateway ou plataforma de agregação, verifique também se a camada de gateway faz mapeamento de alias de modelo. Às vezes, o código de negócio usa um alias interno, e o ID real do modelo Gemini 2.5 fica escondido na configuração do gateway.
Etapa 2: Definir os modelos substitutos do Gemini 2.5
Use como referência os alvos de roteamento automático indicados no anúncio oficial do Google e, ao mesmo tempo, combine com as necessidades do seu negócio para escolher um modelo substituto para cada ponto de chamada. A regra geral é: para cenários que antes usavam o Gemini 2.5 Pro em raciocínio complexo, documentos longos e tarefas de código, priorize avaliar modelos de nível Pro da nova geração na mesma categoria; para cenários que antes usavam o Gemini 2.5 Flash em busca de velocidade e custo, priorize avaliar modelos de nível Flash da nova geração.
Vale notar que os alvos de roteamento automático oficiais nem sempre são a melhor solução para o seu negócio. Algumas equipes aproveitam a oportunidade para reavaliar e rebaixar parte do tráfego com menor exigência de qualidade para modelos mais leves, otimizando custos.
💡 Sugestão de escolha: A escolha do modelo substituto depende principalmente do cenário específico e dos requisitos de qualidade. Recomenda-se fazer testes práticos em pequena escala com os modelos candidatos pela APIYI apiyi.com. A plataforma oferece chamadas via interface unificada para diversos modelos populares, o que facilita a comparação lado a lado antes de tomar uma decisão.
Etapa 3: Alterar explicitamente o ID do modelo e calibrar os parâmetros
Não espere pelo roteamento automático. Em vez disso, substitua explicitamente o ID do modelo antigo pelo novo ID no código e nas configurações. A vantagem é que o modelo exibido nos logs, no monitoramento e na cobrança corresponde ao modelo realmente em execução, evitando induzir a erro na hora de investigar problemas.
Ao alterar o ID do modelo, verifique também cada parâmetro de chamada. A tabela abaixo lista os itens de configuração que mais precisam de atenção durante a migração:
| Item de configuração | Pontos de verificação na migração | Prática recomendada |
|---|---|---|
| ID do modelo (model) | Ainda existem IDs ou aliases antigos esquecidos? | Centralizar tudo em um centro de configuração, evitando hardcodes espalhados pelo código |
| Configurações relacionadas a raciocínio | Como o novo modelo oferece suporte a parâmetros como orçamento de raciocínio e quais são os valores padrão | Consultar a documentação do novo modelo e reconfigurar; não copiar os valores como estão |
| Comprimento máximo de saída | O limite de saída e o valor padrão do novo modelo podem ser diferentes | Definir explicitamente, evitando truncamento ou saídas longas demais |
| Saída estruturada / JSON Schema | O grau de aderência às restrições de campos pode mudar | Testar junto com a tolerância a falhas e a validação da camada de parsing |
| Definições de ferramentas / chamadas de função | O estilo de geração de parâmetros e a frequência de chamadas podem mudar | Validar com replay de amostras reais de conversa |
| Parâmetros de amostragem, como temperatura | Os mesmos valores produzem efeitos diferentes em modelos diferentes | Ajustar novamente com base nos resultados da avaliação |
Etapa 4: fazer testes de regressão com amostras reais
Extraia requisições reais representativas dos logs de produção e monte um conjunto de testes de regressão. As amostras devem cobrir cenários de alta frequência, cenários de cauda longa e casos limite que já deram problema no passado. Para aplicações com saída estruturada, inclua também as amostras com o formato mais complexo.
Rode esse lote de amostras com o modelo antigo e com o novo, comparando pelos seguintes aspectos: taxa de aprovação de formato (se o JSON pode ser analisado com sucesso), precisão dos campos principais, comprimento médio da saída, latência do primeiro token e latência total, e quantidade de tokens consumida por requisição. Se a taxa de aprovação de formato e os principais indicadores não caírem de forma significativa, pode avançar para a fase de lançamento gradual; se houver queda relevante, priorize ajustar o comando para adaptar ao novo modelo.
Etapa 5: lançamento gradual e plano de rollback
Não faça a troca total de uma vez. A recomendação é aumentar a exposição aos poucos, na proporção de 5%, 20%, 50% e 100%, observando pelo menos um ciclo completo de negócio em cada etapa. O ideal é colocar a chave de liberação gradual na central de configuração, permitindo que o ID do modelo seja trocado dinamicamente por proporção de tráfego ou por grupo de usuários.
O plano de rollback merece uma observação especial: depois de 1º de dezembro, os IDs dos modelos antigos serão roteados automaticamente, o que significa que o caminho de “rollback para o Gemini 2.5” não estará mais disponível na prática. Portanto, seu alvo de rollback deve ser outro modelo alternativo já validado, e não o modelo antigo. É por isso que recomendamos preparar com antecedência pelo menos uma opção alternativa de outro fornecedor.
🚀 Início rápido: se você precisa montar rapidamente uma cadeia de contingência entre modelos, pode usar o APIYI apiyi.com para acessar vários modelos de forma unificada. Como ele é compatível ao mesmo tempo com os formatos de interface da OpenAI e da Anthropic, o modelo alternativo e o principal podem reutilizar a mesma lógica de chamada; no rollback, basta trocar o nome do modelo.
Etapa 6: Monitoramento contínuo após o lançamento
Depois de concluir a migração, monitore com atenção por pelo menos duas semanas os seguintes indicadores: taxa de erro e taxa de timeout, taxa de falha na análise de saídas estruturadas, feedback de qualidade dos usuários (taxa de avaliações negativas, taxa de reclamações), consumo de tokens e curva de custos. Recomendo que, no painel de monitoramento, o ID do modelo seja separado como uma dimensão própria, para facilitar a comparação das mudanças antes e depois da troca.
Também vale ficar de olho extra no dia 1º de dezembro: se nesse momento ainda aparecerem requisições com o ID do modelo antigo no monitoramento, isso indica que algo passou batido na etapa de inventário. Essas requisições estão passando pelo roteamento automático e precisam ser localizadas e migradas explicitamente o quanto antes.
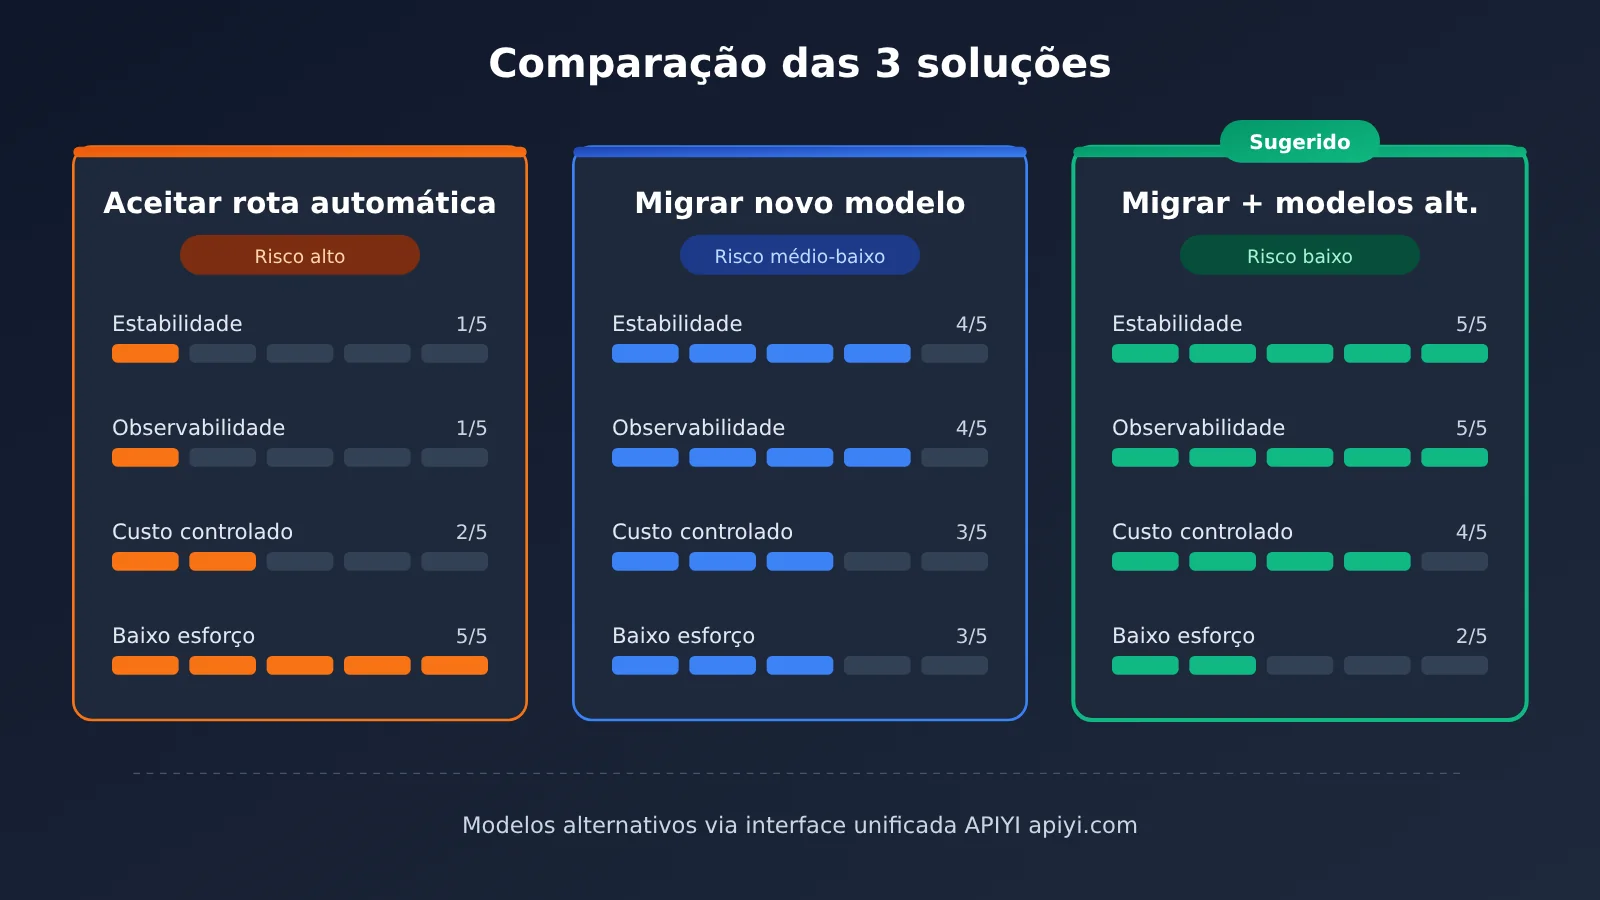
Comparativo de soluções para o Gemini 2.5: roteamento passivo vs migração ativa
Diante do roteamento automático do Gemini 2.5 Pro/Flash a partir de 1º de dezembro, as equipes normalmente têm três caminhos. A tabela abaixo compara essas opções em dimensões como estabilidade, observabilidade e esforço de implementação.
| Solução | Característica principal | Cenário indicado | Nível de risco |
|---|---|---|---|
| Aceitar o roteamento automático | Sem alterar o código, o roteamento é feito oficialmente após 1º de dezembro | Ferramentas internas de baixa prioridade, tarefas offline | Alto: mudança silenciosa de comportamento, logs em desacordo com a realidade |
| Migrar explicitamente para os novos modelos Gemini | Alterar ativamente o ID do modelo e concluir os testes de regressão | A maioria das aplicações em produção | Médio-baixo: mudança controlável e observável |
| Migração explícita + modelos alternativos | Migrar o principal para o novo modelo e, ao mesmo tempo, preparar alternativas de outros fornecedores | Negócios críticos, serviços com alta exigência de disponibilidade | Baixo: existe um caminho de rollback realmente utilizável |
| Aproveitar para reescolher o modelo | Reavaliar por cenário e distribuir entre modelos de diferentes faixas | Negócios sensíveis a custo e com grande volume de chamadas | Médio: esforço maior, mas com ganhos claros no longo prazo |
Leitura comparativa das soluções para o Gemini 2.5
Aceitar o roteamento automático é a opção que dá menos trabalho, mas entrega a decisão sobre quando e para onde o modelo será trocado a um agente externo. Para serviços em produção que dependem de um formato de saída fixo, isso equivale a publicar uma atualização de dependência crítica sem testes — e, quando surge um problema, fica difícil identificar a causa rapidamente.
Migrar explicitamente para os novos modelos Gemini é a escolha com melhor custo-benefício. Você continua dentro do ecossistema Gemini, com alterações mínimas nos comandos e na forma de integração, e ao mesmo tempo ganha observabilidade completa e garantia de testes — o que atende à grande maioria das equipes.
Migração explícita com modelos alternativos é indicada para negócios críticos. Considerando que, após 1º de dezembro, não será possível fazer rollback para o Gemini 2.5, ter um modelo alternativo de outro fornecedor já validado é o que constitui, de fato, um plano de contingência real.
💰 Sobre custos: quando o assunto envolver preços de modelos, valor unitário de entrada e saída, preço de cache e critérios de cobrança, use como referência os dados reais da página de preços da APIYI https://docs.apiyi.com/models. Este artigo não lista números de preço específicos; na avaliação da migração, recomenda-se combinar os dados dessa página com o seu próprio consumo de tokens para calcular a diferença de custo.
Perguntas frequentes (FAQ)
Q1: O que é o roteamento automático do Gemini 2.5 Pro/Flash?
Roteamento automático é o mecanismo pelo qual, após o Google AI Studio descontinuar o Gemini 2.5 Pro e o 2.5 Flash, a partir de 1º de dezembro as requisições de API enviadas para esses dois IDs de modelo antigos não vão falhar de imediato: elas serão encaminhadas para o modelo sucessor indicado oficialmente. Na camada da interface parece tudo igual, mas o modelo que realmente executa já mudou.
Q2: Qual é a diferença entre roteamento automático e migração proativa?
O roteamento automático poupa trabalho de compatibilidade, mas o momento da troca e o modelo de destino são decididos fora do seu controle, e os logs continuam mostrando o ID antigo, o que dificulta o diagnóstico. A migração proativa exige esforço de teste, porém a mudança de modelo fica controlável e observável, e de quebra você aproveita para calibrar parâmetros e comandos — algo bem mais adequado para serviços em produção.
Q3: Quando o roteamento automático do Gemini 2.5 entra em vigor? Afeta todos os canais?
Segundo o anúncio do Google AI Studio, o roteamento automático vale a partir de 1º de dezembro. Quanto a saber se ele afeta também outros canais, como o Vertex AI, e se existe um período de retenção de aliases, consulte o anúncio oficial de descontinuação do Google e o changelog da API Gemini — antes de migrar, confirme qual canal você está usando.
Q4: Quais aplicações precisam tratar a descontinuação do Gemini 2.5 com prioridade?
As de prioridade máxima são estas:
– **Saídas estruturadas**: serviços de extração de informações e de parsing de formulários que dependem de campos JSON fixos
– **Agentes e chamadas de ferramentas**: fluxos automatizados que dependem do formato dos parâmetros de function calling
– **Análise de documentos longos**: tarefas de contexto longo cuja qualidade, latência e custo precisam ser reavaliados
Q5: Como comparar rapidamente o Gemini 2.5 com modelos candidatos a substituto?
A recomendação é usar uma plataforma com acesso unificado a vários modelos para fazer testes em paralelo:
1. Acesse APIYI apiyi.com, cadastre-se e obtenha uma chave API
2. Consulte as instruções de integração na central de documentação docs.apiyi.com e configure a chamada no formato compatível com OpenAI ou Anthropic
3. Com o mesmo lote de amostras de regressão, chame o modelo antigo e o candidato separadamente e compare taxa de aprovação de formato, latência e consumo de tokens
A APIYI oferece chamadas de API para modelos populares, incluindo a série Gemini citada neste artigo; para trocar de modelo, normalmente basta alterar o nome dele.
Q6: Quais são as limitações ou riscos conhecidos na migração do Gemini 2.5?
Vale encarar algumas limitações com objetividade. Primeiro, depois de 1º de dezembro não há como reverter para o Gemini 2.5 — qualquer rollback precisa apontar para outro modelo já validado. Segundo, os modelos novos podem ter formas diferentes de suportar parâmetros como o orçamento de raciocínio, então não dá para reaproveitar tudo como está. Por fim, o custo pode mudar: consulte os dados reais da página de preços da APIYI em docs.apiyi.com/models para conferir preço unitário e critérios de cobrança e evitar desvios de orçamento.
Principais pontos sobre como lidar com a descontinuação do Gemini 2.5 Pro/Flash
- Fato central: Gemini 2.5 Pro e 2.5 Flash foram descontinuados e, a partir de 1º de dezembro, as requisições passam a ser roteadas automaticamente
- Maior risco: o modelo muda silenciosamente, os logs continuam mostrando o ID antigo, e formato e custo podem sofrer desvios
- Primeira ação: fazer um inventário global dos IDs de modelo, incluindo central de configuração, gateway e plataformas low-code
- Como migrar: substituir explicitamente o ID do modelo e recalibrar parâmetros como raciocínio e comprimento de saída
- Garantia de qualidade: rodar testes de regressão com amostras reais de produção e só depois liberar o tráfego de forma gradual
- Plano de rollback: após o prazo final não há como voltar ao Gemini 2.5, então é preciso preparar com antecedência modelos alternativos de outros fornecedores
- Como começar: é possível acessar vários modelos de forma unificada via APIYI e comparar rapidamente os candidatos
Resumo
Depois da descontinuação do Gemini 2.5 Pro/Flash, os pontos essenciais para lidar com o roteamento automático de 1º de dezembro:
- Não dependa do roteamento automático: ele só garante que a interface não retorne erro, não garante que a qualidade da saída e o formato permaneçam iguais
- Migre de forma ativa em 6 passos: inventário, escolha do modelo, alteração explícita, testes de regressão, liberação gradual e rollback, monitoramento contínuo
- Prepare com antecedência um caminho alternativo: após o prazo final não é possível fazer rollback para o modelo antigo; ter alternativas de outros fornecedores é a proteção real
Falta menos de um mês para 1º de dezembro. A recomendação é concluir nesta semana o inventário dos pontos de chamada e a classificação de impacto, entrar nos testes de regressão na próxima semana e finalizar a liberação gradual até o fim do mês, deixando uma margem até a data limite.
Recomendamos validar rapidamente os modelos candidatos pelo APIYI em apiyi.com. A plataforma é compatível com os formatos de interface da OpenAI e da Anthropic; as instruções de integração estão em docs.apiyi.com, e os preços e critérios de cobrança dos modelos seguem o disposto em https://docs.apiyi.com/models.
📚 Referências
- Google AI Studio descontinua o Gemini 2.5 Pro e o 2.5 Flash: notícia sobre esta descontinuação e o evento de roteamento automático
- Link:
aihot.news/items/ewvepczpb5fewcbzo2tkqdldm -
Descrição: confirma quais modelos foram descontinuados e o momento do roteamento automático, em 1º de dezembro
-
Changelog da API Gemini: registro oficial de atualizações e descontinuações de modelos do Google
- Link:
ai.google.dev/gemini-api/docs/changelog -
Descrição: usado para verificar o modelo de destino do roteamento automático e os canais afetados
-
Central de documentação do APIYI: instruções para integração de múltiplos modelos
- Link:
docs.apiyi.com -
Descrição: configuração de chamadas nos formatos compatíveis com OpenAI e Anthropic
-
Página de preços de modelos do APIYI: preços e critérios de cobrança dos modelos
- Link:
docs.apiyi.com/models - Descrição: base de preços usada para avaliar o custo da migração
Autor: Equipe técnica do APIYI
Contato técnico: fale com a gente pela página inicial do site do APIYI; há mais materiais disponíveis na central de documentação docs.apiyi.com