Nota do autor: uma pesquisa de Stanford descobriu que 44% das conclusões amplamente citadas sobre LLMs já estão desatualizadas. Entre aquelas com prazo de validade estimado, a duração média foi de apenas 15,7 meses. Este artigo transforma o estudo em um checklist de retestes que equipes de desenvolvimento podem usar na escolha de modelos.
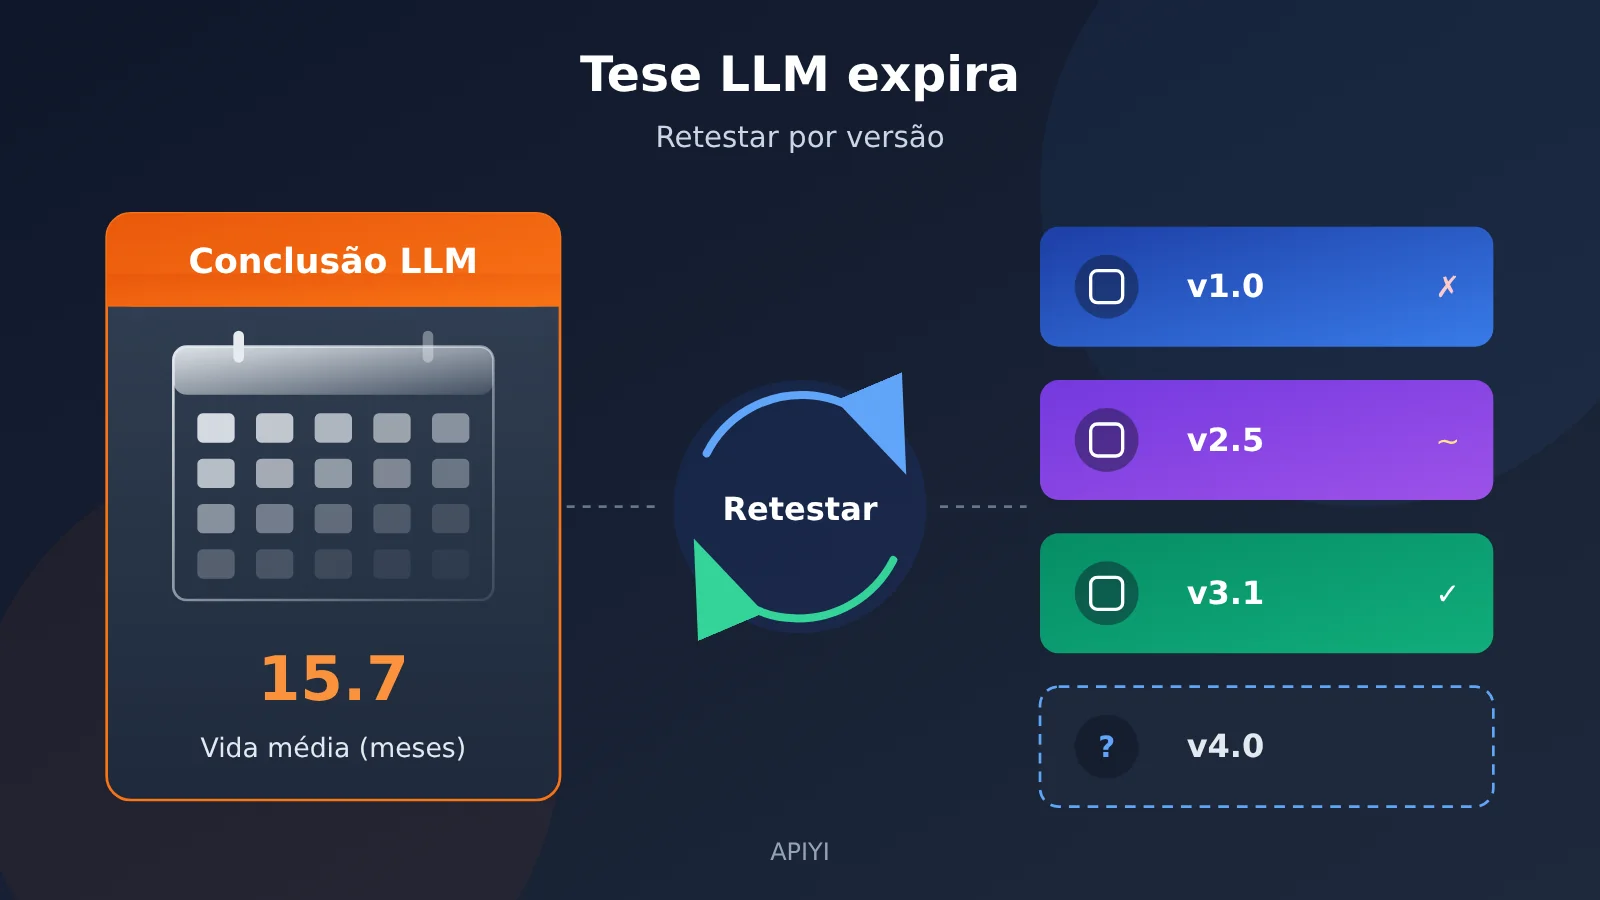
“Um modelo não consegue contar quantas letras r há em strawberry”, “as informações no meio de um contexto longo se perdem”, “modelos adoram inventar referências bibliográficas”. Talvez você já tenha ouvido essas afirmações repetidas vezes em artigos, grupos de tecnologia e reuniões para escolher modelos. Os pesquisadores de Stanford Owen Queen e James Zou usaram 20 modelos para reavaliar 50 conclusões amplamente citadas sobre LLMs e descobriram que 44% já estavam desatualizadas. Entre as conclusões cujo prazo de validade foi estimado, a duração média foi de apenas 15,7 meses.
Este não é mais um comentário genérico sobre como “os modelos estão cada vez melhores”. O estudo apresenta dados concretos sobre quais tipos de conclusão ficam desatualizados mais rápido, quais duram mais e qual é a diferença entre modelos da mesma geração. Neste artigo, vamos transformar as recomendações dos pesquisadores para a comunidade acadêmica em um processo que equipes de desenvolvimento podem seguir ao escolher modelos.
O que você vai levar daqui: ao terminar a leitura, você saberá quais afirmações do tipo “o modelo não é bom em X” são menos confiáveis e poderá criar o hábito de registrar o nome, a versão e a data do modelo, guardar os comandos e repetir os testes no modelo escolhido.
Principais conclusões da pesquisa sobre a validade de estudos sobre LLMs
A tabela abaixo resume os números mais importantes da pesquisa. Os modelos analisados foram lançados entre julho de 2024 e setembro de 2026, por 8 desenvolvedores diferentes. A reportagem sobre o estudo foi publicada em 3 de novembro de 2026.
| Ponto principal | Dados da pesquisa | O que isso significa para a escolha de modelos |
|---|---|---|
| Proporção de conclusões que deixaram de valer | Das 50 conclusões, 44% deixaram de valer e 34% perderam força consideravelmente | A maioria das limitações de modelos citadas na internet já não pode ser aplicada diretamente |
| Proporção que continua válida | Apenas 16% se mantiveram, e 6% ficaram ainda mais fortes | Algumas tendências persistentes merecem atenção a longo prazo |
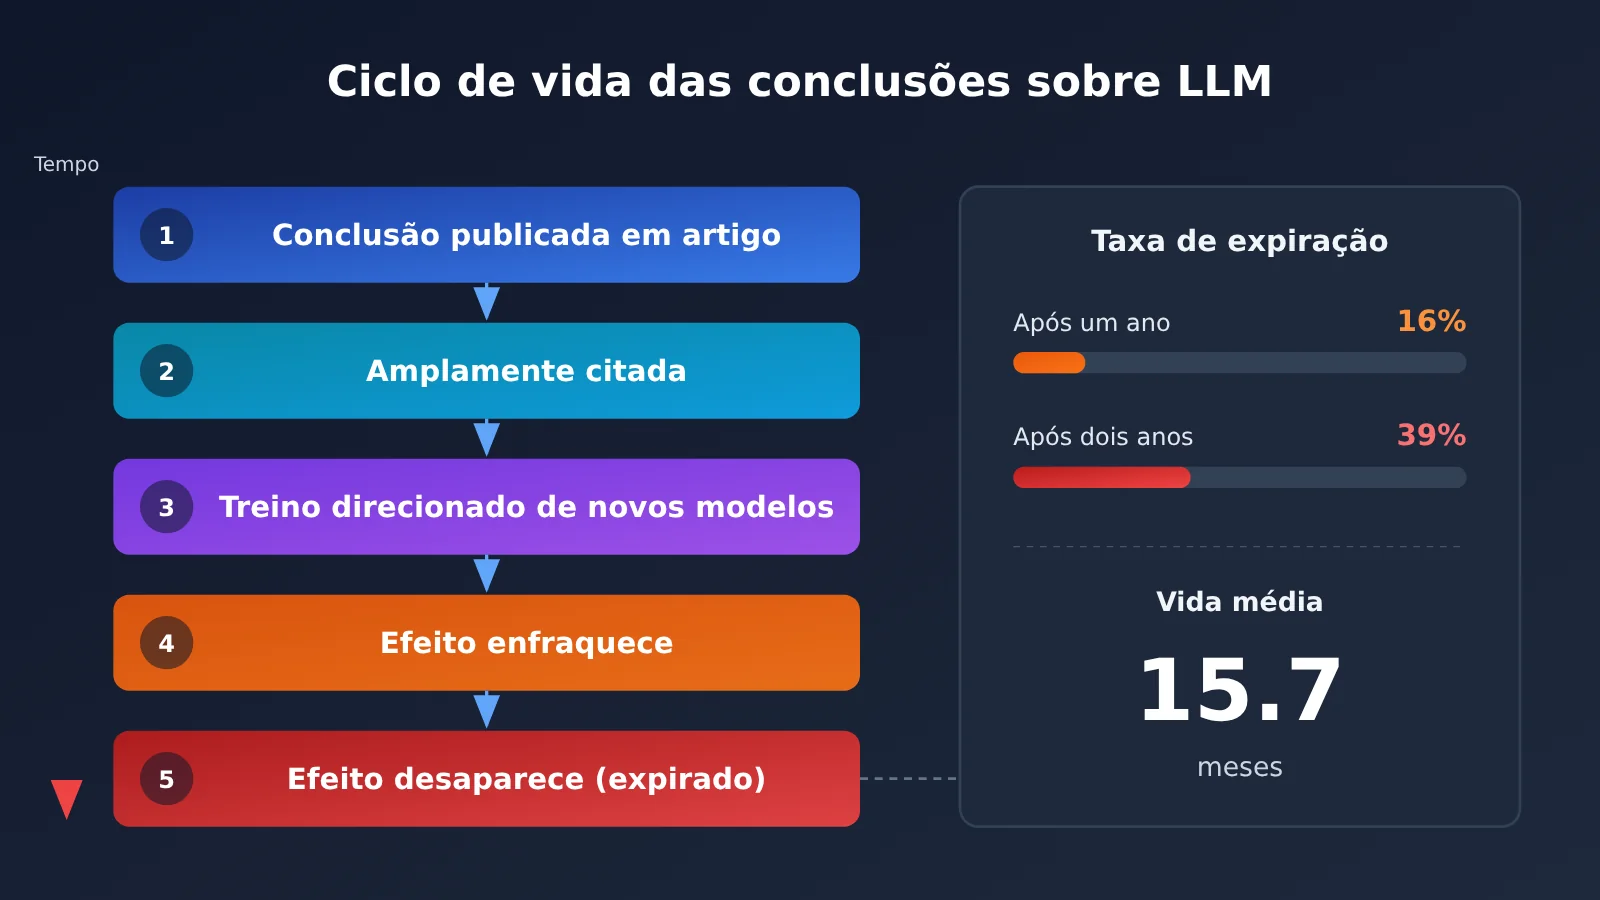
| Vida útil média | Entre as 22 conclusões cuja validade pôde ser estimada, a média foi de 15,7 meses | É preciso olhar com cautela para avaliações de mais de um ano atrás |
| Acúmulo ao longo do tempo | Após um ano, 16% deixaram de valer; após dois anos, o número subiu para 39% | Quanto mais antiga a conclusão, maior a necessidade de testá-la novamente |
| Diferenças entre modelos da mesma geração | Nos modelos lançados entre julho e setembro de 2026, o número de conclusões que deixaram de valer variou de 11 a 30 | Não dá para deduzir a capacidade de um modelo apenas pela data de lançamento |
Duas descobertas importantes sobre a validade das conclusões sobre LLMs
A primeira descoberta importante diz respeito ao significado de “deixar de valer”. No estudo, isso quer dizer que o efeito por trás da conclusão original praticamente desapareceu nos modelos mais recentes, e não apenas que diminuiu. Outros 34% das conclusões perderam força consideravelmente: o problema ainda existe, mas é bem menos grave do que o descrito no artigo original. Somadas, as duas categorias mostram que quase 80% das conclusões amplamente citadas já não podem ser aplicadas aos modelos atuais sem ressalvas.
A segunda descoberta é que a “vida útil” de uma conclusão está fortemente ligada ao seu tipo. As conclusões sobre limitações de capacidade — o que um modelo “não consegue fazer” — deixam de valer mais rapidamente. Já as conclusões sobre preferências — como um modelo “tende a agir” — duram mais. Segundo os pesquisadores, erros de capacidade costumam ter uma “resposta correta”, o que dá aos desenvolvedores um objetivo claro para otimizar o treinamento. Preferências e tendências, por outro lado, não têm uma resposta padrão e, por isso, são naturalmente mais difíceis de “corrigir”.
Quais conclusões sobre LLMs perdem a validade mais rápido
Entender o tipo de conclusão é o primeiro passo para decidir o que retestar. Com base no que foi relatado sobre a pesquisa, a tabela abaixo divide as conclusões típicas entre as que “perdem a validade rapidamente” e as “relativamente duradouras”.
| Tipo de conclusão | Exemplos típicos | Situação na pesquisa | Prioridade de reteste |
|---|---|---|---|
| Falhas de raciocínio e capacidade | Contar as letras em strawberry, fazer cálculos em bases numéricas pouco familiares, perder informações no meio de contextos longos, abandonar uma resposta correta após contestação do usuário | Das 9 conclusões sobre raciocínio, 5 perderam a validade; nenhuma permaneceu igual ou se intensificou | Máxima: retestar antes de citar |
| Precisão factual e alucinações | Inventar referências científicas | Em alguns modelos, o problema caiu para quase 0; em outros, continua elevado | Alta: as diferenças são enormes; é preciso testar cada modelo |
| Raciocínio combinatório | Perguntas de duas etapas, “maldição da inversão”, respostas contraditórias a pares de perguntas temporais | Enfraqueceu, mas ainda pode ser detectado | Média-alta: o problema persiste, mas sua magnitude varia bastante |
| Preferências como avaliador | Favorecer as próprias respostas, atribuir notas semelhantes a artigos aceitos e rejeitados, ser influenciado pela forma como resumos médicos são apresentados | Permaneceu igual ou se intensificou | Média: risco de longo prazo, mas exige verificação periódica |
| Bajulação e concordância com o usuário | Concordar com a opinião do usuário | Representa uma parcela considerável das conclusões que permaneceram iguais ou se intensificaram | Média: priorizar em aplicações de atendimento e consultoria |
| Tendências na distribuição das saídas | Viés político à esquerda, respostas muito semelhantes a perguntas abertas, distribuição desigual de números aleatórios gerados | Permaneceu igual ou se intensificou | Média: exige atenção na geração de conteúdo e na amostragem |
Vale esclarecer que, sobre as conclusões relacionadas a raciocínio, o corpo da reportagem afirma que “5 das 9 perderam a validade e nenhuma permaneceu igual ou se intensificou”, enquanto a legenda do gráfico diz que “todas as 9 diminuíram”. Combinando as duas informações, a interpretação é que 5 perderam a validade e as demais também enfraqueceram, sem que nenhuma permanecesse igual. Como não tivemos acesso à lista completa das 50 conclusões nem aos métodos de reteste do artigo original, a classificação exata deve ser confirmada nele.
Por que conclusões sobre preferências de LLMs são mais duradouras
Das 11 conclusões que permaneceram iguais ou se intensificaram, 3 estão relacionadas ao “LLM como avaliador”, 3 à bajulação e à concordância com o usuário, e as demais envolvem tendências políticas, semelhança entre respostas a perguntas abertas e distribuição desigual de números aleatórios. Esses problemas têm algo em comum: é difícil definir o que seria uma saída “correta” e, por isso, também é difícil eliminá-los com treinamento direcionado.
Para as equipes de desenvolvimento, isso aponta para uma ordem de prioridades de risco pouco intuitiva. O tão comentado problema de “o modelo não conseguir contar letras” muitas vezes já foi resolvido. Por outro lado, as tendências sistemáticas menos evidentes são as que realmente merecem atenção. Se você usa LLMs para avaliação automática, pontuação ou recomendações, os problemas de preferência devem fazer parte dos testes de regressão regulares.
Conclusões sobre vieses sociais em LLMs apresentam resultados mistos
Os pesquisadores destacam que as conclusões sobre vieses sociais não seguiram todas a mesma direção. O viés político à esquerda ainda existe, os estereótipos de gênero e os vieses de associação implícita enfraqueceram, enquanto o viés contra falantes do inglês afro-americano chegou a inverter de direção nos dados de tendências. Isso reforça que qualquer afirmação genérica de que “modelos apresentam determinado viés de forma generalizada” só faz sentido quando associada a um modelo e a um momento específicos.
Por que não dá para prever o desempenho de um LLM pelo fabricante ou pela data de lançamento
Na hora de escolher um modelo, muitas equipes partem de uma intuição simples: modelos novos são sempre melhores que os antigos, modelos do mesmo fabricante têm desempenho parecido e modelos grandes são sempre mais confiáveis que os pequenos. Os dados da pesquisa contradizem diretamente essas suposições.
O exemplo mais marcante é o teste de referências bibliográficas inventadas. Na pesquisa original de Walters e Wilder, publicada em 2023, o GPT-3.5 inventou 55% das referências. Pesquisadores de Stanford testaram modelos atuais com os mesmos comandos: o GPT-6.1 Sol ficou em 0%, o Claude Sonnet 5.5 em 1% e o Qwen3.7-Flash, também lançado em 2026, ainda inventou 69% das referências — uma taxa maior que a do GPT-3.5, lançado três anos antes.
A diferença entre modelos lançados no mesmo período também é surpreendente. Entre os lançados de julho a setembro de 2026, o número de conclusões “refutadas” variou de 11 no DeepSeek V4 Pro a 30 no GPT-6.1 Sol. A pesquisa deixa claro que data de lançamento, fabricante e tamanho do modelo não permitem prever esse padrão de forma confiável.
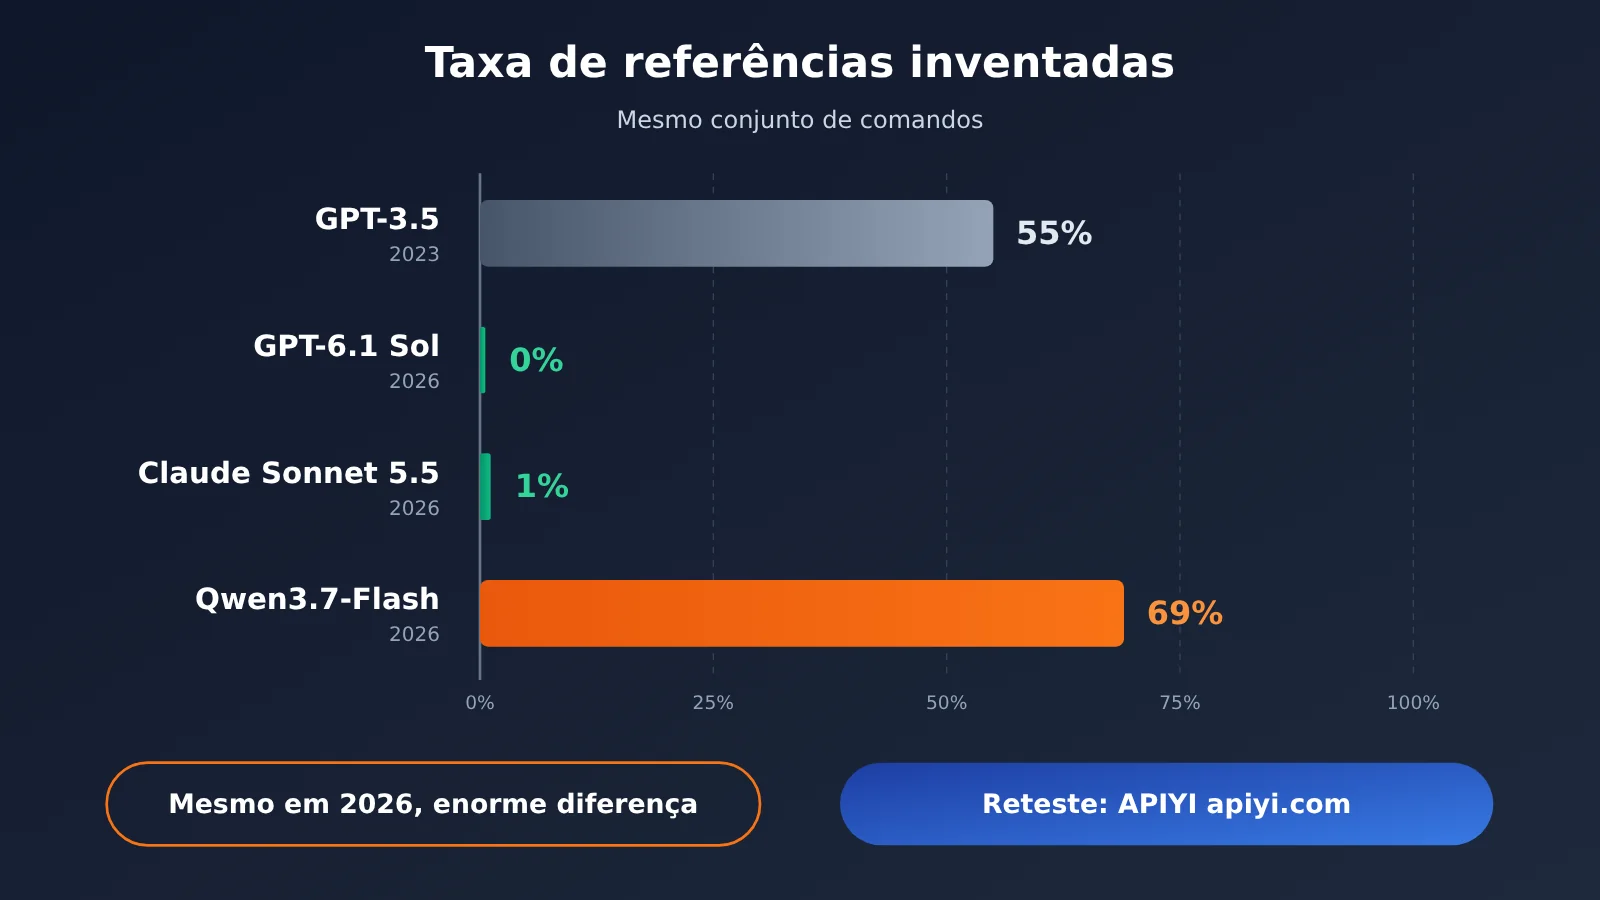
A mensagem central desse gráfico é: modelos da mesma época podem estar em extremos opostos no mesmo teste. Se você quiser reproduzir esse tipo de comparação na sua equipe, pode usar uma plataforma de interface unificada como a APIYI apiyi.com para testar o mesmo conjunto de comandos em vários modelos candidatos. Consulte a lista oficial da plataforma para verificar quais modelos estão disponíveis.
Os pesquisadores também alertam para não interpretar a melhora como sinal de que “o problema foi completamente resolvido”. Em perguntas de dois passos, que exigem combinar dois fatos conhecidos, o Claude Sonnet 5.5 ainda errou cerca de 10% das perguntas combinadas, mesmo quando conseguia responder corretamente às duas perguntas individuais. No artigo original, a taxa relatada para o ChatGPT era de 43%. A queda é significativa, mas, se sua aplicação depende da combinação de fatos em várias etapas, esses 10% ainda podem causar incidentes em produção.
Reavaliação para escolher um LLM: checklist rápido em 5 passos
A recomendação dos pesquisadores para a comunidade acadêmica é tratar conclusões empíricas sobre LLMs como “observações sobre um modelo específico em um momento específico”, e não como verdades universais. Os artigos devem registrar o modelo, a versão e a data, além de disponibilizar os comandos e o código de análise para facilitar novos testes com modelos futuros. Essa recomendação pode ser aplicada quase sem alterações ao processo de seleção de modelos das equipes de desenvolvimento.
Passo 1: registre os metadados de cada conclusão sobre LLMs
Independentemente de a conclusão vir de um artigo, blog, experiência de um colega ou teste próprio, primeiro preencha os campos da tabela abaixo. Conclusões sem dados essenciais devem ser tratadas apenas como “pistas a verificar”, não como base para decisões.
| Campo de metadados | O que registrar | Por que é necessário |
|---|---|---|
| Nome do modelo | Nome completo, em vez de “modelo de uma empresa” | Modelos do mesmo fornecedor podem apresentar grandes diferenças |
| Versão específica | Número da versão ou identificador do snapshot | O desempenho de um modelo pode mudar após atualizações, mesmo que o nome continue igual |
| Data do teste | Data exata, incluindo o dia | Ajuda a avaliar a “idade” da conclusão, tomando como referência a vida útil média de 15,7 meses |
| Comando completo | Comando de sistema, entrada do usuário e exemplos | Não é possível reproduzir o teste usando outro comando |
| Parâmetros de invocação | Temperatura, comprimento máximo da saída etc. | Os parâmetros de amostragem podem afetar conclusões sobre estabilidade |
| Critérios de avaliação | O que conta como aprovação ou falha | Sem isso, os resultados obtidos por pessoas diferentes não são comparáveis |
| Tamanho da amostra | Quantos casos foram testados | Uma captura de tela de uma única conversa não representa uma proporção |
Passo 2: defina a prioridade dos retestes de LLM por tipo de conclusão
Ao encontrar uma conclusão, primeiro identifique a qual categoria ela pertence. Conclusões sobre falhas de capacidade (não conseguir contar ou calcular corretamente, não se lembrar de informações ou mudar de resposta ao ser contrariado) devem ser tratadas como “muito provavelmente desatualizadas” e retestadas antes de serem citadas. Já conclusões sobre preferências e tendências (favorecer a si mesmo, bajular ou gerar respostas parecidas) devem ser tratadas como “muito provavelmente ainda presentes” e incluídas em testes de regressão de longo prazo.
Considere também a idade da conclusão: segundo os dados da pesquisa, conclusões com mais de um ano têm cerca de 16% de probabilidade de estarem desatualizadas; após dois anos, essa proporção sobe para 39%. Se o modelo ao qual a conclusão se refere já foi substituído pelo modelo que você está avaliando, refaça o teste, por mais conhecida que seja a conclusão.
Passo 3: transforme as conclusões em casos de teste executáveis para LLMs
Uma afirmação como “o modelo não compreende bem documentos longos” não pode ser testada diretamente: ela precisa ser transformada em um caso concreto. Por exemplo, coloque uma informação essencial no início, no meio e no fim de um documento longo, faça perguntas sobre cada ocorrência e calcule a taxa de acerto. Outra opção é pedir que o modelo dê a resposta correta, simular uma contestação do usuário e medir a proporção de vezes em que ele muda de resposta.
Ao criar os testes, use dados o mais próximos possível dos seus dados reais de negócio, em vez de apenas reutilizar exemplos simplificados de artigos acadêmicos. Os problemas clássicos que a pesquisa identificou como “desatualizados” podem já ter sido alvo de treinamento específico por diferentes empresas. Passar nesses testes não significa que o modelo também terá sucesso com seus dados de negócio.
Etapa 4: testar novamente todos os LLMs candidatos com o mesmo conjunto de comandos
A chave para repetir os testes é controlar as variáveis: use os mesmos comandos, parâmetros e critérios de avaliação, mudando apenas o modelo. Se cada modelo exigir uma integração própria com SDK e um tratamento separado de autenticação, o custo dos testes pode ficar alto demais para a equipe.
🚀 Dica prática: a APIYI apiyi.com usa o padrão unificado da API da OpenAI e permite acessar mais de 200 modelos com um único token. Para trocar de modelo candidato, basta alterar o parâmetro model, mantendo os comandos e os demais parâmetros. Isso facilita comparações como essa. Consulte a lista oficial da plataforma para saber quais modelos e versões estão disponíveis.
Etapa 5: criar um registro de conclusões sobre os LLMs e revisá-lo periodicamente
Salve os resultados de cada rodada em um “registro de conclusões”, contendo pelo menos a conclusão original, os metadados, os resultados dos novos testes e a data da próxima revisão. Considerando a vida útil média de 15,7 meses, recomenda-se revisar trimestral ou semestralmente as conclusões das quais o negócio depende. Ao planejar uma atualização de versão do modelo, faça uma nova rodada completa de testes, sem exceção.
| Cenário | Escopo recomendado para os novos testes | Quando testar |
|---|---|---|
| Seleção inicial | Todas as conclusões que afetam a decisão + casos de uso essenciais para o negócio | Antes da avaliação para seleção |
| Atualização da versão do modelo | Todos os casos de teste de regressão | Antes de colocar a nova versão em produção |
| Uso de conclusões externas | Apenas as conclusões relevantes | Antes de incluí-las no documento da solução |
| Operação rotineira | Tendências de preferência + casos de alto risco | A cada trimestre ou semestre |
| Anomalia em produção | Capacidades relacionadas à anomalia | Imediatamente |
💡 Dica para a escolha: em vez de começar perguntando “qual é o modelo mais poderoso?”, determine primeiro quais tipos de erro representam o maior risco para o negócio. Depois, teste os modelos candidatos com foco nesses erros. Com a interface unificada da APIYI apiyi.com, você pode comparar vários modelos no mesmo fluxo de testes, reduzindo as variáveis extras na integração.
Perguntas frequentes (FAQ)
P1: O que significa uma conclusão sobre LLMs estar “desatualizada”?
Neste estudo de Stanford, “desatualizada” significa que o efeito por trás de uma conclusão empírica sobre LLMs praticamente desapareceu nos modelos mais recentes. É diferente de “enfraquecida”, quando o problema ainda existe, mas em grau bem menor. Das 50 conclusões, 44% ficaram desatualizadas e 34% enfraqueceram.
P2: Qual é a diferença entre conclusões sobre limitações de capacidade e conclusões sobre tendências de preferência dos LLMs?
As conclusões sobre limitações de capacidade descrevem o que os modelos “não conseguem fazer”, como contar letras, resolver operações aritméticas ou recuperar informações em contextos longos. Como essas tarefas têm respostas corretas claras, é mais fácil corrigi-las com treinamento direcionado, e essas conclusões ficam desatualizadas mais rápido. Já as conclusões sobre tendências de preferência descrevem “como os modelos tendem a agir”, por exemplo, favorecendo as próprias respostas ou bajulando usuários. Como não há uma resposta padrão, essas tendências persistem por mais tempo.
P3: Quando esse estudo sobre a desatualização de conclusões sobre LLMs foi publicado?
A reportagem sobre o estudo foi publicada em 3 de novembro de 2026. Os modelos testados foram lançados entre julho de 2024 e setembro de 2026: ao todo, foram 20 modelos de 8 desenvolvedores. Como os modelos evoluem rapidamente, os dados específicos citados neste artigo também podem ficar desatualizados. Vale consultar o artigo original antes de usá-los.
P4: Quais equipes mais precisam testar novamente os LLMs a cada versão?
Os principais casos incluem:
– **Equipes escolhendo ou trocando de modelo**: para não descartar candidatos com base em defeitos observados dois anos atrás
– **Equipes que usam LLMs para avaliação e pontuação**: tendências como favorecer as próprias respostas e ser influenciado pela formulação ainda existem
– **Aplicações sensíveis à precisão factual**: a taxa de referências bibliográficas inventadas varia de 0% a 69% entre modelos da mesma geração
– **Produtos de atendimento ao cliente e consultoria por conversação**: tendências a bajular e concordar com o usuário precisam de monitoramento contínuo
P5: Como testar novamente vários LLMs com baixo custo?
O essencial é usar uma camada de acesso unificada, para facilitar a troca apenas do modelo, sem mudar as outras variáveis:
1. Acesse APIYI apiyi.com, crie uma conta e obtenha uma chave API
2. Confira na lista oficial se os modelos e versões candidatos estão disponíveis
3. Use o mesmo conjunto de comandos e parâmetros, alterando apenas o parâmetro model para invocar cada modelo e registrar os resultados e metadados
Assim, você pode concentrar seus esforços no planejamento dos casos de teste, em vez de integrar repetidamente interfaces de diferentes fornecedores.
P6: Posso usar as pontuações dos novos modelos em rankings no lugar de novos testes?
Não é recomendável depender totalmente delas. O estudo mostra que data de lançamento, fornecedor e tamanho não permitem prever com segurança o desempenho de um modelo em relação a uma conclusão específica. Modelos lançados no mesmo período podem apresentar diferenças enormes. Rankings servem para uma triagem inicial, mas a decisão final ainda deve se basear nos resultados de novos testes com os dados do seu negócio.
P7: Quais são as limitações desse estudo sobre LLMs?
Primeiro, consulte o artigo original para ver a lista completa das 50 conclusões e os métodos de reavaliação: relatos de terceiros não cobrem todos os detalhes. Além disso, há diferenças entre o texto e as legendas dos gráficos na reportagem sobre conclusões ligadas ao raciocínio, então o artigo original deve prevalecer. Por fim, os resultados também são observações sobre “modelos específicos, em um momento específico” e, pela lógica dos próprios pesquisadores, também ficarão desatualizados com o tempo.
Conclusões sobre LLMs que ficam desatualizadas: pontos principais
- Alta taxa de desatualização: das 50 conclusões populares sobre LLMs, 44% já ficaram desatualizadas e 34% perderam força significativamente
- Vida útil curta: as conclusões cuja duração pôde ser estimada duraram, em média, apenas 15,7 meses; quase 40% ficaram desatualizadas após dois anos
- Limitações de capacidade ficam desatualizadas mais rápido: alegações sobre contagem de letras, aritmética e perda de informações em contextos longos devem ser reavaliadas primeiro
- Tendências de preferência persistem por mais tempo: preferência por si mesmo, bajulação e respostas semelhantes devem fazer parte de testes de regressão contínuos
- Não dá para tirar conclusões pelo fornecedor ou pela data: entre modelos de 2026, a taxa de referências fabricadas variou de 0% a 69%
- Metadados são indispensáveis: sem nome do modelo, versão, data e comando, fica difícil reproduzir uma conclusão
- Uma interface unificada reduz o custo da reavaliação: com APIYI apiyi.com, é possível comparar modelos alterando apenas o parâmetro
model
Resumo
As conclusões sobre LLMs ficam desatualizadas, em média, após 15,7 meses. Esse dado nos lembra de que:
- Conclusões têm prazo de validade: qualquer afirmação sobre um LLM deve ser vista como “uma observação sobre determinado modelo em determinado momento”
- O tipo de conclusão define a prioridade: falhas de capacidade devem ser retestadas primeiro; tendências de preferência exigem monitoramento contínuo
- A versão faz toda a diferença: fabricante, data de lançamento e tamanho do modelo não substituem testes da versão específica
Na próxima reunião de seleção de modelos, ao ouvir que “um modelo não é bom em X”, vale fazer três perguntas: qual versão? Quando foi testada? O comando ainda está disponível? Se ninguém souber responder, inclua o caso na lista de novos testes.
Uma opção é usar a APIYI em apiyi.com para integrar os modelos candidatos ao mesmo processo de testes e retestá-los rapidamente com o mesmo conjunto de comandos. Consulte a lista oficial para verificar os modelos disponíveis.
📚 Referências
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds: reportagem sobre o estudo de Stanford a respeito da desatualização de conclusões sobre LLMs
- Link:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
Descrição: apresenta dados centrais, como os 44% de conclusões desatualizadas, a validade média de 15,7 meses, casos de referências inventadas e diferenças entre modelos da mesma geração
-
Artigo original de Owen Queen e James Zou: estudo de pesquisadores de Stanford que retestou 50 conclusões sobre LLMs
- Link: pesquise pelos nomes dos autores e pelo título do artigo em plataformas de busca acadêmica
- Descrição: não foi possível acessar o texto completo do artigo original; consulte-o para conferir a lista das 50 conclusões e os métodos usados nos testes
Autor: equipe técnica da APIYI
Troca de ideias sobre tecnologia: entre em contato pela página inicial da APIYI em apiyi.com. Para mais informações sobre integração de modelos, acesse a central de documentação em docs.apiyi.com