Nota do autor: guia para desenvolvedores identificarem erros em chamadas de APIs de modelos em produção, usando códigos de erro, logs e uma reprodução mínima com curl.
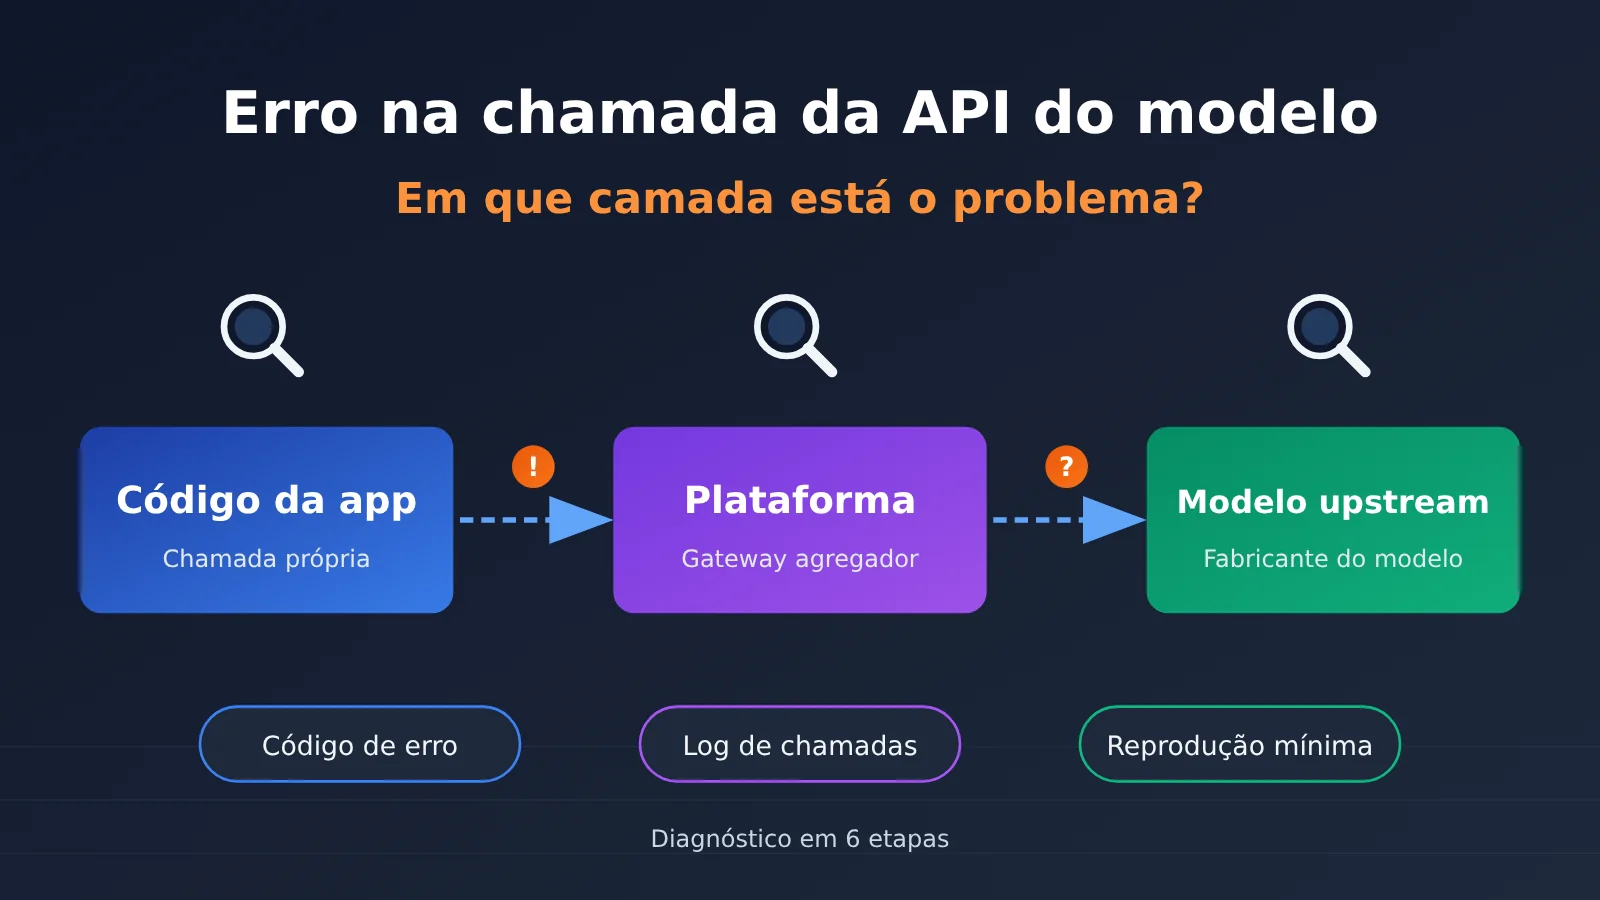
Um alerta de madrugada avisa que a taxa de erros da API de modelos aumentou. Nesses casos, o que mais costuma consumir tempo não é a correção, mas descobrir a quem recorrer: uma alteração no seu código causou o problema, a plataforma de gateway falhou ou o serviço do modelo upstream está instável? Neste artigo, você vai conhecer um método de diagnóstico em três camadas: “sua chamada → plataforma de gateway → modelo upstream”, para reduzir rapidamente o escopo da investigação quando uma chamada à API de um modelo falhar.
Isto não é apenas uma tabela de códigos de erro. Essa divisão em três camadas também é uma abordagem comum entre equipes que operam plataformas de agregação de modelos: elas reproduzem o problema com base nos parâmetros da requisição, nos logs, nos códigos de erro e na cadeia de chamadas para determinar se a origem está na chamada do usuário, na plataforma ou no serviço do modelo upstream. Aqui, essa abordagem vira uma sequência de investigação que você pode aplicar diretamente. Seja para se conectar diretamente ao fornecedor ou por meio de um gateway agregador como o APIYI, a sequência é a mesma.
O que você vai aprender: uma sequência de 6 etapas de investigação, sinais para identificar categorias comuns de erro, como fazer uma reprodução mínima com curl e um checklist pronto para preencher ao reportar o problema.
Pontos essenciais para identificar a origem de erros em chamadas de API de modelos
Uma chamada de API de modelo passa por pelo menos três camadas: sua aplicação e seu ambiente de rede, o gateway ou plataforma agregadora intermediária e o serviço do modelo que fornece a inferência. Na conexão direta com o fornecedor, a camada intermediária é menor, mas ainda há balanceamento de carga e uma camada de acesso. O objetivo da investigação é identificar em qual dessas camadas está a falha.
| Camada de origem | Problemas típicos | Sinais comuns | Responsável |
|---|---|---|---|
| Sua própria chamada | Chave incorreta, parâmetros inválidos, limite de contexto excedido, timeout local muito curto, problemas de proxy ou DNS | Erro 4xx reproduzido de forma consistente; funciona em outro ambiente; afeta apenas alguns fluxos de código | Você |
| Plataforma de gateway | Problemas de autenticação ou cobrança, mapeamento incorreto de parâmetros, roteamento ou fallback, limite de taxa da plataforma, conexão interrompida no meio do caminho | Conexão direta funciona, mas a chamada pelo gateway falha; formato do erro difere do fornecedor; vários modelos apresentam problemas ao mesmo tempo | Plataforma |
| Modelo do fornecedor | Sobrecarga do serviço, mudança de versão do modelo, alteração de capacidades, limite de taxa do fornecedor | Falhas simultâneas em vários canais de acesso; aviso na página de status do fornecedor; apenas um modelo é afetado | Fornecedor do modelo (geralmente comunicado pela plataforma) |
Por que identificar primeiro a camada responsável pelo erro
Quando uma chamada de API de modelo falha, a primeira reação de muitas equipes é adicionar novas tentativas ou trocar de modelo. Às vezes isso resolve o problema temporariamente, mas, sem encontrar a causa raiz, ele pode voltar alguns dias depois. Essa abordagem também pode esconder um erro de configuração. Identificar a origem antes de agir evita perder tempo na direção errada.
Essa análise também ajuda a decidir quem deve ser acionado. Se o problema estiver na sua chamada, basta corrigir o código; se estiver na plataforma de gateway, é preciso entrar em contato com ela levando o ID da requisição; se estiver no modelo do fornecedor, geralmente resta esperar a recuperação, trocar de modelo ou ativar um fallback. As soluções são bem diferentes e, se o diagnóstico estiver errado, o tempo de resolução aumenta.
6 passos para diagnosticar erros na invocação de modelos via API
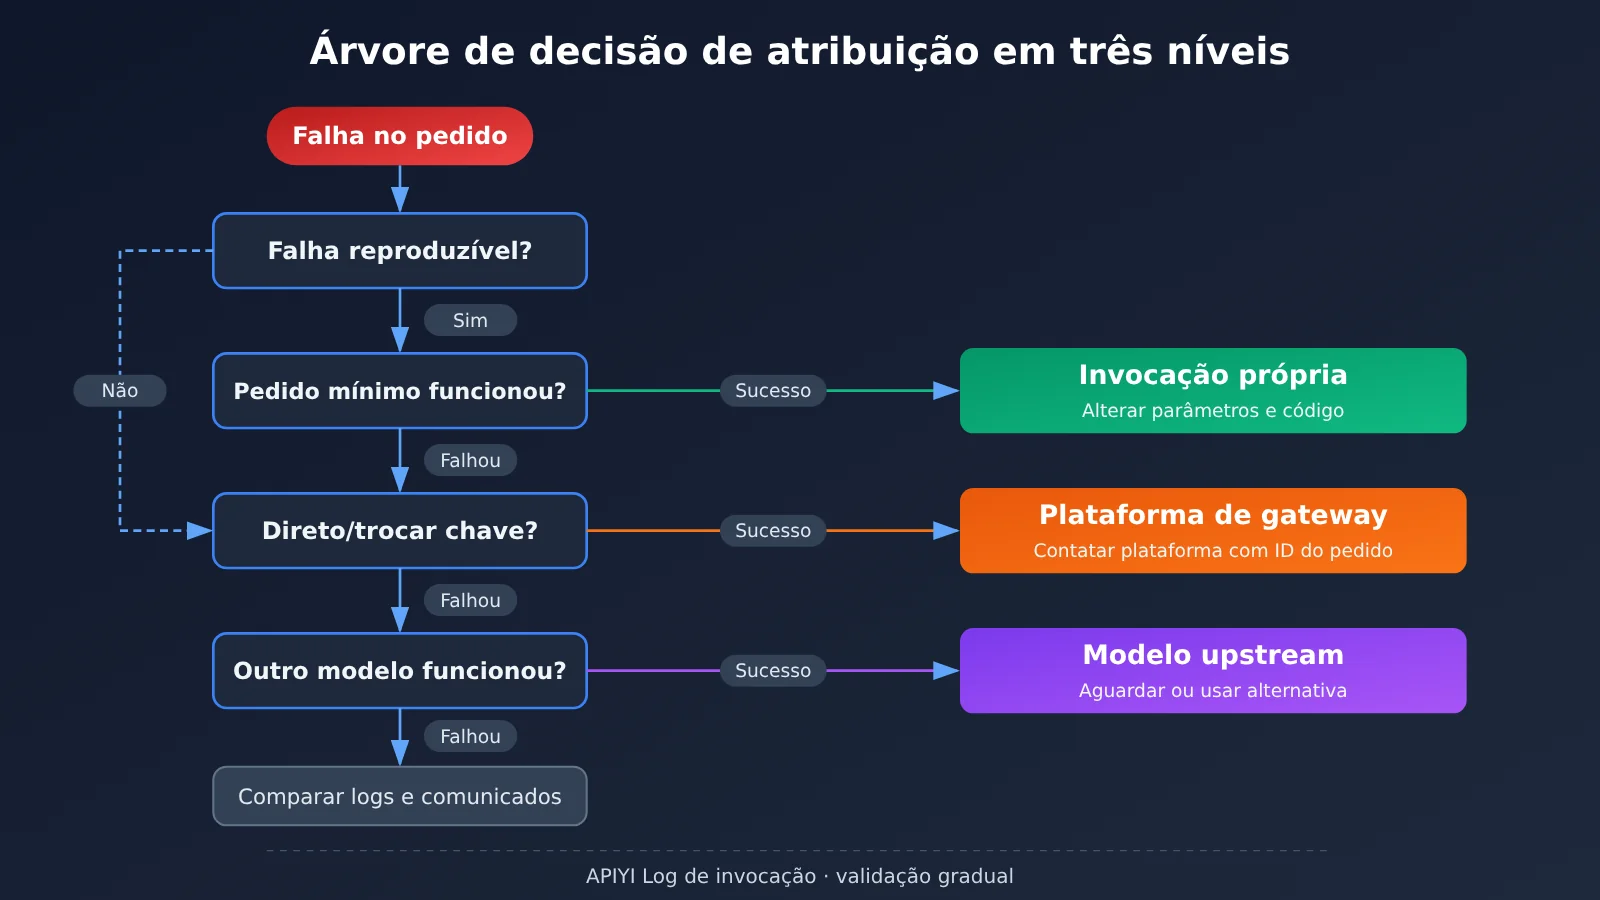
A sequência segue o princípio de começar pelo mais simples e barato, isolar o problema e só depois investigar a fundo. Cada passo procura descartar uma possibilidade, em vez de suspeitar de tudo ao mesmo tempo.
- Identifique o alcance do problema: todas as requisições falham ou apenas algumas? O erro afeta um único modelo ou vários? Quando começou? Quanto maior o alcance, maior a chance de o problema estar na plataforma ou no provedor upstream. Se afetar apenas uma funcionalidade, é mais provável que esteja no seu código.
- Registre o erro original: salve o código de status HTTP, o corpo original da resposta, o ID da requisição nos cabeçalhos de resposta (se houver), o horário e o tempo decorrido. Não se limite à exceção processada pelo SDK: muitos detalhes importantes podem se perder nesse processo.
- Crie uma reprodução mínima: fora do código da aplicação, use curl para enviar a requisição mais simples possível, por exemplo, um texto curto, sem streaming e sem chamadas de ferramentas. Se ela funcionar, o problema provavelmente está na combinação de parâmetros ou na lógica da aplicação.
- Adicione os parâmetros aos poucos: partindo da requisição mínima, acrescente um de cada vez o comando de system, o contexto longo,
stream,tools,response_formate outros parâmetros, até encontrar o que provoca a falha. - Faça testes comparativos: use outro modelo no mesmo gateway ou, se a rede permitir, conecte-se diretamente ao provedor para comparar. Se trocar o modelo resolver, o problema geralmente aponta para o provedor upstream; se a conexão direta funcionar, geralmente aponta para o gateway.
- Consulte logs e comunicados: verifique os logs de chamadas da plataforma e a página de status do provedor. Confirme se a requisição chegou à plataforma, se ela a encaminhou e qual foi a resposta do provedor upstream.
Erros comuns em APIs de modelos e sinais para identificá-los
O código de erro é a pista mais direta para investigar um problema, mas o mapeamento desses códigos varia entre plataformas. A tabela abaixo segue a semântica geral do HTTP; para saber o significado exato, consulte a documentação da plataforma que você usa.
| Categoria do erro | Manifestação típica | Sinais para identificação | Origem mais provável |
|---|---|---|---|
| Falha de autenticação | 401 / 403 | O problema desaparece ao trocar a chave API; a chave contém espaços extras ou foi usada no ambiente errado | Principalmente na própria chamada; às vezes, no status da conta na plataforma |
| Erro de parâmetro | 400 / 422 | Uma requisição mínima funciona, mas falha ao adicionar um parâmetro; a mensagem de erro aponta o nome do campo | Na própria chamada ou no mapeamento de parâmetros da plataforma |
| Modelo inexistente | 404 ou aviso de modelo inválido | O nome do modelo foi digitado incorretamente ou o modelo foi desativado ou renomeado | Na própria chamada ou em uma mudança de versão do modelo |
| Limite de taxa / cota | 429 | O problema desaparece ao reduzir a concorrência; o cabeçalho da resposta informa o tempo de espera antes de tentar novamente | Depende da origem do limite: pode estar na plataforma ou no provedor upstream |
| Erro de servidor | 500 / 502 / 503 | A mesma requisição funciona de forma intermitente; vários usuários relatam o problema ao mesmo tempo | Na plataforma de gateway ou no modelo upstream |
| Timeout | 504 ou timeout acionado pelo cliente | Mais comum em requisições com respostas longas; desaparece ao usar streaming | Na configuração local de timeout, no timeout do gateway ou na lentidão da inferência upstream |
| Interrupção de streaming | A conexão SSE é interrompida antes do fim, sem marcador de encerramento | Requisições sem streaming funcionam normalmente; ocorre apenas em respostas longas | No proxy intermediário, na política de manutenção de conexão do gateway ou no upstream |
Casos especiais: interrupções de streaming, mudanças de versão e fallback automático
Interrupções de streaming estão entre os problemas mais difíceis de diagnosticar. O cliente vê apenas a conexão ser encerrada, e o código de status HTTP pode continuar sendo 200. Para investigar, primeiro verifique se o seu proxy, balanceador de carga ou Nginx define um tempo limite de inatividade curto para conexões longas. Depois, use o curl com o parâmetro -N para observar a saída SSE bruta e conferir se o marcador de encerramento foi recebido.
Mudanças de versão nem sempre geram erros, mas podem alterar a saída: por exemplo, o formato JSON pode deixar de ser consistente ou faltar parâmetros nas chamadas de ferramentas. Se o nome do modelo apontar para um alias atualizado continuamente, seu comportamento pode mudar sem aviso após uma atualização do provedor. Em produção, procure usar nomes de modelo com data ou número de versão fixos e faça testes de regressão periodicamente.
Fallback automático e roteamento dinâmico podem gerar resultados inconsistentes durante a investigação. Alguns gateways mudam automaticamente para um canal ou modelo alternativo quando o provedor falha. Isso melhora a disponibilidade, mas também pode fazer com que “a mesma solicitação funcione desta vez e falhe na próxima” ou que “o estilo da resposta mude de repente”. Ao investigar, confira se o campo model na resposta corresponde ao solicitado. Se os logs da plataforma registrarem o canal ou modelo realmente utilizado, verifique esses dados também. A possibilidade de quem faz a chamada perceber o fallback depende de como a plataforma o implementa, então é melhor confirmar isso com antecedência.
Erros na invocação de modelos via API: reprodução mínima com curl
O objetivo de uma reprodução mínima é eliminar a interferência do código da aplicação. O curl não depende de nenhum SDK e mostra a interação HTTP bruta, sendo ideal para coletar evidências. Os exemplos abaixo usam uma interface compatível com OpenAI. Substitua o endereço pelo base_url informado na documentação da plataforma que você usa.
5 dicas de curl para uma reprodução mínima
- Veja apenas o código de status e o tempo de resposta: use
-sS -o /dev/null -w "%{http_code} %{time_total}"para verificar em poucos segundos se a requisição chegou ao destino e quanto tempo levou. - Confira os cabeçalhos completos da requisição e da resposta: use o parâmetro
-vpara visualizar o handshake TLS e os cabeçalhos. Muitas plataformas incluem o ID da requisição e informações de limite de taxa nos cabeçalhos da resposta. - Separe o tempo gasto em cada etapa da conexão: adicione
%{time_namelookup},%{time_connect}e%{time_starttransfer}ao-w. Lentidão no DNS ou no estabelecimento da conexão geralmente indica um problema na rede local; um tempo longo até o primeiro byte costuma apontar para lentidão no gateway ou na inferência do provedor. - Observe a saída em streaming: adicione
-Npara desativar o buffer e defina"stream": trueno corpo da requisição. Assim, você pode acompanhar os dados SSE linha por linha e identificar onde ocorre a interrupção. - Use um corpo de requisição mínimo: mantenha apenas
modele uma entrada emmessages, com um texto curto, sem parâmetros opcionais comotools,response_formatoumax_tokens.
🚀 Dica de diagnóstico: em plataformas agregadoras como a APIYI, uma mesma chave permite invocar modelos de vários provedores. Na reprodução mínima, basta alterar o campo
modelpara trocar de modelo. Assim, você faz rapidamente o teste comparativo sem precisar criar contas e obter chaves para cada fornecedor.
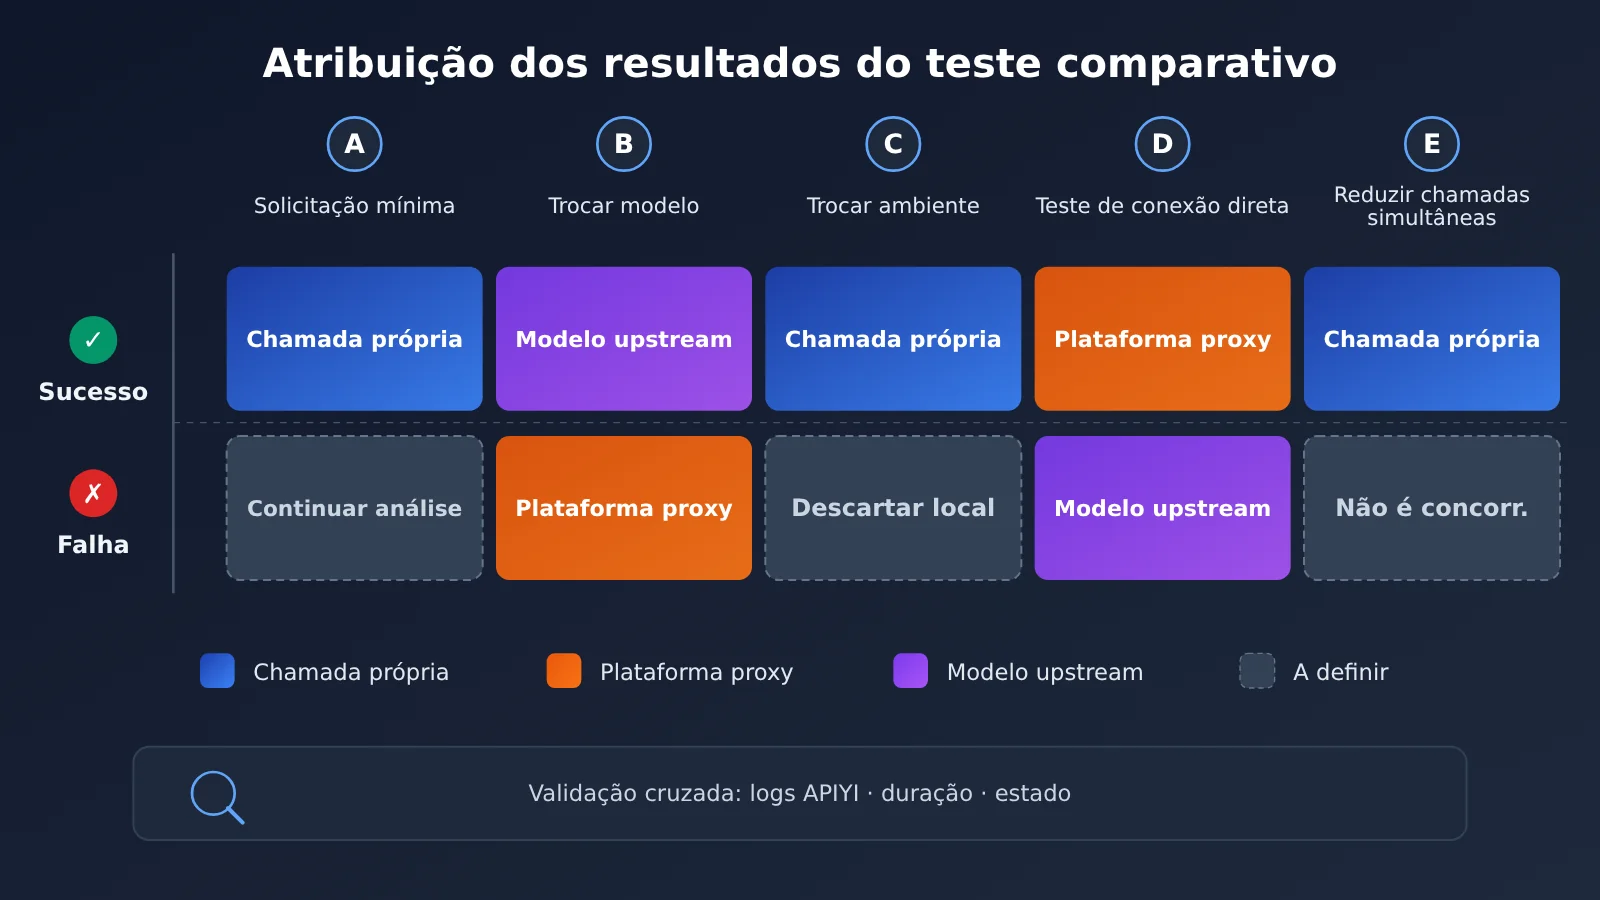
Matriz de testes comparativos: identifique a camada com falha
Ao combinar a reprodução mínima com testes comparativos, você consegue identificar a causa com mais confiança. Recomendamos executar pelo menos os três primeiros grupos da tabela.
| Grupo de teste | Ação | O que o sucesso indica | O que a falha indica |
|---|---|---|---|
| A: requisição mínima | Mesma chave e mesmo modelo, com o corpo de requisição mais simples possível | O problema está nos parâmetros ou na lógica do código da aplicação | Prossiga com os grupos B e C |
| B: trocar de modelo | Mesmo gateway e mesma chave, usando um modelo de outro fornecedor | O provedor do modelo original pode estar com problemas | O gateway, a chave ou a rede local passam a ser mais suspeitos |
| C: trocar de ambiente | Enviar a mesma requisição de outra máquina ou rede | Há um problema na rede local, no proxy ou no DNS | Descarta fatores da rede local |
| D: comparação com conexão direta | Quando possível, conectar diretamente à interface oficial do fornecedor | A camada do gateway passa a ser mais suspeita; você pode relatar o problema à plataforma | O próprio modelo do provedor apresenta uma falha |
| E: reduzir a concorrência | Reduzir a concorrência para 1 e tentar novamente | Há um problema de limite de taxa ou cota | O problema não está relacionado à concorrência |
Use logs de chamadas para identificar a origem de erros na API de modelos
O curl mostra se uma chamada falha agora; os logs mostram o que aconteceu naquele momento. Problemas em produção costumam ser difíceis de reproduzir de forma consistente, e os logs podem ser a única fonte de evidências. Na investigação, alinhe os logs da aplicação e da plataforma por horário e ID da requisição e analise-os em conjunto.
Na aplicação, registre pelo menos: horário da requisição, nome do modelo, resumo dos parâmetros (sem conteúdo sensível), código de status HTTP, resposta de erro original, tempo total, tempo até o primeiro byte e ID da requisição retornado pela plataforma. Os logs da plataforma podem complementar o que você não consegue ver, como se a requisição chegou à plataforma, quantos tokens foram cobrados e qual modelo foi realmente chamado.
💡 Dica para usar os logs: se você usa a APIYI, pode consultar os registros de chamadas por período no console e compará-los, um a um, com os logs da aplicação. Para saber quais campos estão disponíveis e se os erros originais do provedor são repassados, consulte as informações no console e na documentação. Na dúvida, perguntar ao suporte técnico é mais rápido do que tentar adivinhar.
Checklist de informações para abrir um chamado
Quanto mais completo for o chamado, mais rápido o problema poderá ser resolvido. Uma descrição como “a API parou de funcionar” quase sempre leva a várias rodadas de perguntas. Prepare as informações da tabela abaixo e envie tudo de uma vez.
| Informação | Exemplo | Para que serve |
|---|---|---|
| Período | Horário preciso até os segundos, com fuso horário | Facilitar a busca nos logs da plataforma |
| ID da requisição | Identificador único no cabeçalho ou no corpo da resposta | Localizar diretamente uma requisição específica |
| Nome do modelo e endpoint | Nome completo do modelo e caminho da API | Verificar se o problema envolve um provedor específico |
| Erro original | Código de status e corpo completo da resposta | Distinguir erros da plataforma de erros repassados pelo provedor |
| Reprodução mínima | Descrição dos parâmetros do curl, sem dados sensíveis | Permitir que o problema seja reproduzido de forma consistente |
| Impacto | Proporção de falhas e modelos ou funcionalidades afetados | Avaliar a gravidade do problema |
| Comparações realizadas | Resultados dos experimentos dos grupos A a E | Evitar repetir a investigação |
Antes de abrir o chamado, remova a chave API e os dados privados dos usuários. Mantenha apenas os primeiros e os últimos caracteres da chave para identificá-la. Se a plataforma oferecer suporte técnico 24 horas por dia, 7 dias por semana, em caso de falha urgente você pode informar primeiro o impacto de forma resumida e complementar os detalhes depois.
Perguntas frequentes (FAQ)
Q1: Qual é o primeiro passo quando ocorre um erro na invocação do modelo pela API?
Primeiro, registre o erro original, incluindo o código de status, o corpo completo da resposta, o ID da requisição e o horário. Depois, confirme o alcance do problema. Não reinicie o serviço nem altere o código às pressas: se as informações originais forem perdidas, será muito mais difícil identificar a causa.
Q2: Como saber se o problema está no gateway ou no provedor do modelo?
O jeito mais eficaz é fazer um teste comparativo: troque o modelo no mesmo gateway. Se tudo voltar ao normal, o provedor do modelo original passa a ser o principal suspeito. Se for possível acessar o provedor diretamente e a conexão funcionar, a suspeita recai sobre o gateway. Também vale conferir o formato da resposta de erro: erros repassados pelo provedor costumam ter uma estrutura específica dele.
Q3: Um erro 429 de limite de requisições é necessariamente um problema da minha conta?
Não necessariamente. O erro 429 pode vir da cota da sua conta, de um limite de requisições simultâneas por chave imposto pela plataforma ou de uma sobrecarga geral no provedor. Primeiro, reduza a concorrência para 1 e tente novamente. Depois, confira os avisos de limite nos cabeçalhos da resposta e confirme com a plataforma em qual camada o limite foi atingido.
Q4: Como investigar quando a mesma requisição às vezes funciona e às vezes falha?
Comece verificando se há fallback automático ou roteamento dinâmico: confira se o campo `model` da resposta corresponde ao canal realmente usado, registrado nos logs da plataforma. Depois, analise a distribuição do tempo de duração das requisições que falharam. Se os tempos estiverem concentrados em torno de um valor, é possível que o limite de timeout de alguma camada esteja sendo atingido.
Q5: Como fazer testes comparativos entre modelos sem gastar muito?
Uma plataforma agregadora com interface unificada para vários modelos facilita bastante. Na APIYI, basta alterar o campo `model` para trocar de provedor usando a mesma chave. Assim, dá para reproduzir o problema com uma requisição mínima e fazer comparações em poucos minutos, sem criar uma conta em cada provedor.
Q6: Uma queda repentina na qualidade das respostas do modelo conta como erro de invocação?
Esse tipo de problema não gera uma mensagem de erro, mas também precisa ser investigado. Primeiro, confirme se o nome do modelo aponta para um alias que recebe atualizações contínuas. Depois, compare os resultados com casos de teste fixos e resultados anteriores. Se confirmar que o comportamento do modelo mudou, envie exemplos comparativos à plataforma.
Q7: Ao reportar um problema por meio de um gateway agregador, preciso fornecer informações sobre o provedor?
Você não precisa entrar em contato com o provedor diretamente, mas deve informar o ID da requisição, o nome do modelo e a mensagem de erro original. Com esses dados, a plataforma pode consultar os registros de encaminhamento e verificar se o erro veio do provedor. Na APIYI, por exemplo, informar o ID da requisição e o intervalo de tempo ao suporte técnico pode reduzir bastante as trocas de mensagens.
Principais pontos para investigar erros na invocação de APIs de modelos
- Identifique primeiro a camada responsável: determine se o problema está na sua chamada, na plataforma de gateway ou no provedor do modelo antes de decidir como corrigi-lo.
- Preserve os dados originais: código de status, resposta original e ID da requisição são as principais evidências para identificar a origem do problema.
- Isole o problema com uma reprodução mínima: use curl para eliminar o código da aplicação e adicione os parâmetros de volta um a um até encontrar o que causa a falha.
- Compare cenários para identificar a camada: troque de modelo, mude o ambiente e teste a conexão direta. Esses três testes geralmente permitem localizar a falha.
- Fique atento ao fallback automático: se os resultados forem inconsistentes, confira o modelo realmente usado na resposta e os registros de roteamento.
- Cruze os logs dos dois lados: compare os logs da aplicação com os de plataformas como a APIYI, usando o horário e o ID da requisição.
- Reporte o problema de forma estruturada: envie de uma vez o horário, o ID da requisição, o erro original e os resultados dos testes comparativos, seguindo o checklist.
Resumo
Quando ocorre um erro na invocação da API de um modelo, o mais importante não é encontrar imediatamente uma solução, mas identificar primeiro em qual camada está o problema:
- Camada da sua chamada: confirme com uma reprodução mínima e adicionando os parâmetros de volta aos poucos. Geralmente, basta corrigir o código ou a configuração.
- Camada da plataforma de gateway: confirme com um teste de conexão direta e os logs da plataforma. Entre em contato com a plataforma e informe o ID da requisição.
- Camada do provedor do modelo: confirme testando outro modelo e consultando os comunicados do fornecedor. Para reduzir o impacto, troque de modelo ou use uma estratégia de fallback.
Vale incluir a sequência de 6 etapas de investigação e o checklist de reporte deste artigo no manual de plantão da equipe. Assim, no próximo alerta, todos poderão seguir o processo diretamente. Se você está criando uma solução de integração com vários modelos, pode usar a APIYI, em apiyi.com, para fazer testes comparativos entre modelos com a mesma interface e combinar os resultados com os logs da plataforma para criar seu próprio processo de investigação.
📚 Referências
- Códigos de status de resposta HTTP da MDN: explicação do significado geral dos códigos de status HTTP
- Link:
developer.mozilla.org/zh-CN/docs/Web/HTTP/Status -
Descrição: ajuda a entender o significado padrão dos erros 4xx e 5xx
-
Manual oficial do curl: documentação completa dos parâmetros do curl
- Link:
curl.se/docs/manpage.html -
Descrição: explica variáveis de tempo usadas com
-we parâmetros comuns para diagnóstico, como-Ne-v -
Server-Sent Events da MDN: explicação do protocolo de streaming SSE
- Link:
developer.mozilla.org/zh-CN/docs/Web/API/Server-sent_events - Descrição: ajuda a entender o formato das respostas em streaming e como as interrupções se manifestam
Autor: equipe técnica da APIYI
Troca de informações técnicas: entre em contato conosco pela página inicial da APIYI. Para mais materiais sobre integração e diagnóstico de problemas, acesse a central de documentação em docs.apiyi.com