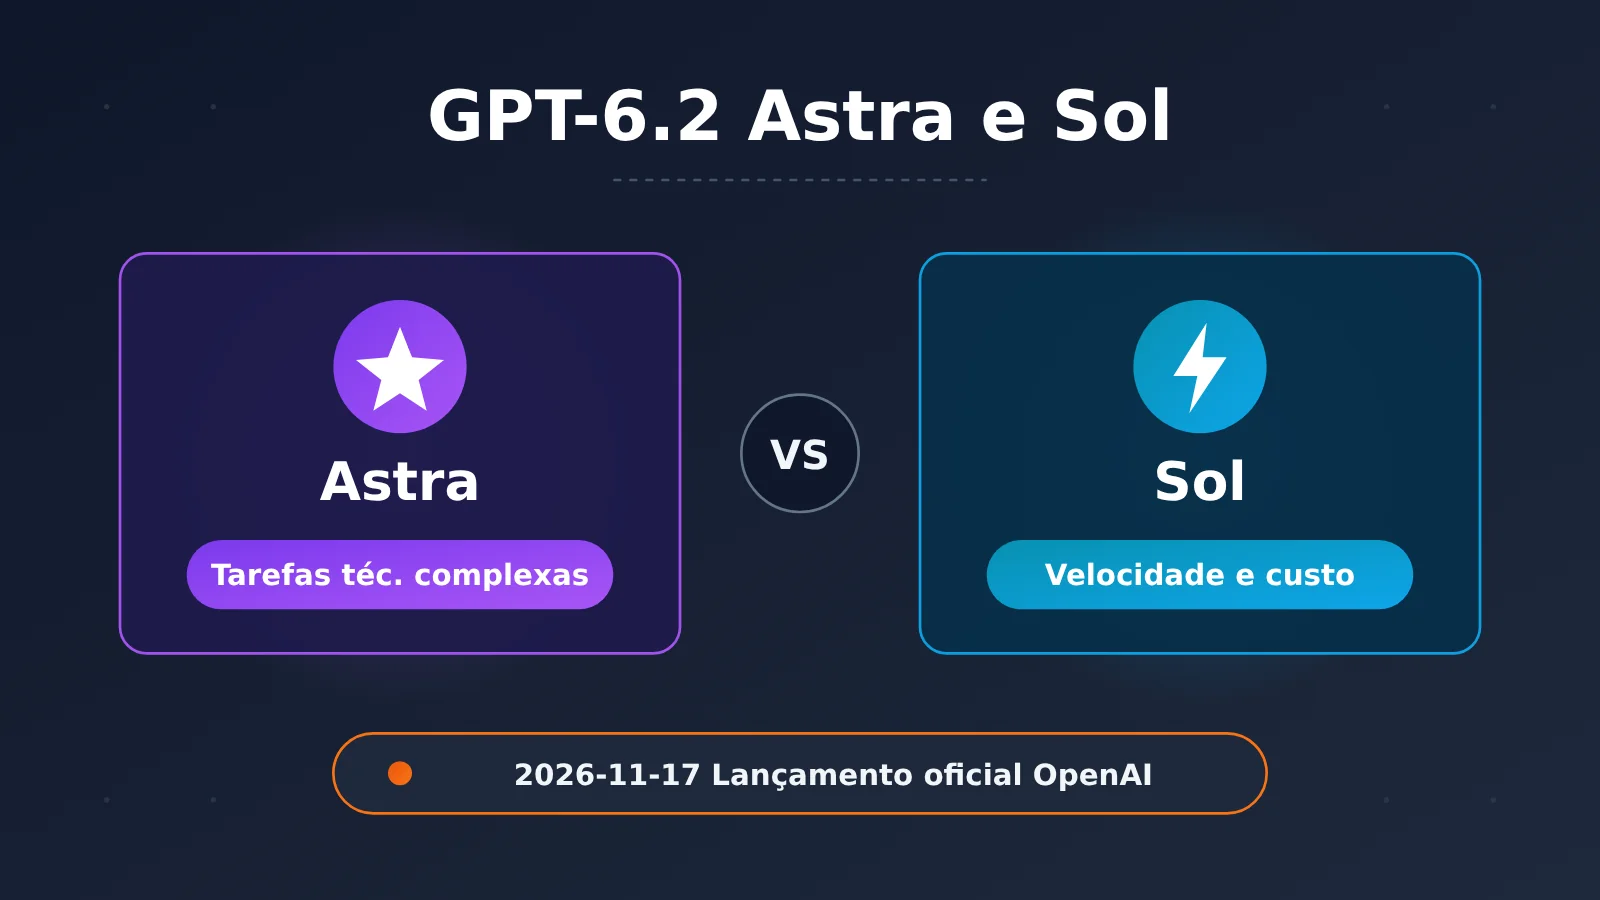
Resposta direta: A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. Segundo o relatório oficial, os dois modelos melhoraram em relação às suas respectivas gerações anteriores no GDPval v2, e o Astra ainda reduziu em 22% os tokens de saída. Na escolha entre os modelos, tarefas profissionais complexas, de alto valor e com alto custo de erro devem priorizar o Astra; tarefas de alta frequência, sensíveis a velocidade e custo, devem priorizar o Sol. Vale observar que, nesta rodada, a liberação gradual é apenas para ChatGPT Work, Codex e API. As conversas comuns do ChatGPT não entram no escopo de lançamento desta rodada. Por isso, se você usa apenas o Chat comum, por enquanto não precisa ajustar sua forma de trabalhar por causa deste lançamento.
O que você vai descobrir ao ler este artigo?
- Data de lançamento, fontes oficiais e onde o GPT-6.2 Astra e o Sol estão disponíveis.
- O que os dados oficiais de GDPval v2, ALE e FrontierCode 2.0 mostram — e o que não mostram.
- Os limites de capacidade de entrada e saída dos dois modelos e a estrutura oficial de preços padrão da API.
- Como usuários comuns e desenvolvedores devem escolher entre Astra e Sol.
Índice: Mais adiante, uma tabela de conceitos explica termos como nomes de avaliações e cobrança de cache, e depois uma visão rápida de impactos mostra a relação deste lançamento com diferentes públicos. A primeira parte do texto reúne os fatos oficiais, incluindo 1.1 escopo de lançamento, 1.2 avaliações oficiais, 1.3 limites de capacidade e 1.4 preços. A segunda parte é a análise editorial, que discute o significado prático da atualização, a divisão de tarefas entre os dois modelos, recomendações de escolha e métodos de validação da integração.
Para saber: entenda estes conceitos primeiro
Estes termos aparecem nos materiais oficiais e neste artigo. Entender o significado deles primeiro ajuda a evitar interpretar errado os dados de avaliação e os preços.
| Conceito | Explicação breve |
|---|---|
| GPT-6.2 Astra | Modelo desta versão voltado para tarefas profissionais complexas; o preço oficial da API é mais alto |
| GPT-6.2 Sol | Modelo desta versão voltado para velocidade e custo; o preço oficial da API é cerca de um quarto do preço do Astra |
| GDPval v2 | Uma das avaliações oficiais da OpenAI; os principais dados comparativos entre Astra e Sol nesta versão vêm dela |
| ALE | Outra avaliação do relatório oficial; desta vez, foi divulgado apenas o ganho de pontuação do Astra |
| FrontierCode 2.0 | Avaliação de programação do relatório oficial; desta vez, usada para comparar a diferença entre Sol e Astra no nível de raciocínio max |
| Ponto percentual | Diferença entre duas porcentagens; por exemplo, de 50% para 56,2% é um aumento de 6,2 pontos percentuais |
| Nível de raciocínio (max) | Nível de intensidade de raciocínio configurável do modelo; max indica a configuração que investe mais cálculo de raciocínio |
| Token de saída | Unidade de cobrança consumida pelo conteúdo gerado pelo modelo; quanto mais concisa a saída, geralmente menor o custo |
| Leitura de cache | Parte do conteúdo de comando reutilizado que, ao acertar o cache, é cobrada a um preço menor |
| Gravação de cache | Os tokens gravados são cobrados pela taxa de gravação correspondente ao período de retenção; o mesmo lote de tokens não é cobrado novamente pela taxa normal de entrada |
| Limite de contexto longo de 272K | Quando a entrada de uma única solicitação ultrapassa cerca de 272 mil tokens, a solicitação inteira é cobrada a uma taxa mais alta |
| ChatGPT Work | Produto ChatGPT da OpenAI voltado para cenários de trabalho; é uma das portas de entrada deste lançamento |
| Codex | Produto da OpenAI voltado para cenários de programação; é uma das portas de entrada deste lançamento |
Resumo rápido do impacto do GPT-6.2 Astra e Sol em diferentes públicos
- Usuários comuns do ChatGPT: Nesta rodada, o ChatGPT comum não faz parte do escopo de lançamento; no curto prazo, a experiência de uso diário não mudará diretamente por causa disso.
- Usuários do ChatGPT Work: Terão acesso ao novo modelo à medida que ele for liberado gradualmente; a principal decisão será quais tarefas entregar ao Astra e quais ao Sol.
- Usuários do Codex e programadores: Os dados oficiais do FrontierCode 2.0 mostram que o Sol fica próximo do Astra nesse teste, então vale a pena fazer uma comparação na sua própria base de código.
- Desenvolvedores de API: Há uma diferença clara de preço entre os dois modelos, além de regras de cobrança para cache e para contexto longo de 272K; o roteamento de modelos e o design de comandos afetam diretamente a fatura.
- Criadores que precisam de geração de vídeo: Os novos modelos recebem texto e imagens como entrada e produzem texto como saída; não são modelos nativos de geração de vídeo, portanto esse tipo de necessidade não é afetado diretamente.
1. Fatos objetivos sobre o lançamento do GPT-6.2 Astra e Sol
Esta seção apresenta apenas informações oficiais divulgadas publicamente. Todos os dados de avaliação citados no texto vêm do relatório oficial da OpenAI, não são testes práticos da equipe da APIYI, e nós também não realizamos nenhum benchmark nem entrevistas.
1.1 Datas de lançamento e escopo de disponibilização do GPT-6.2 Astra e Sol
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026 por meio de sua página oficial. A data de verificação das informações deste artigo é 18 de novembro de 2026. A página oficial de lançamento, os documentos da central de ajuda e a página de modelos para desenvolvedores são, atualmente, as fontes de informação mais diretas; os endereços específicos estão nas referências ao final do texto.
| Item | Detalhes |
|---|---|
| Data de lançamento | 17 de novembro de 2026 |
| Responsável pelo lançamento | OpenAI |
| Modelos lançados | GPT-6.2 Astra, GPT-6.2 Sol |
| Pontos de acesso | ChatGPT Work, Codex, API, com liberação gradual |
| Fora do escopo desta rodada | ChatGPT comum (Chat) |
| Modalidade de entrada | Texto, imagens |
| Modalidade de saída | Texto |
| Fontes oficiais | página de lançamento em openai.com, documentos de ajuda em help.openai.com, página de modelos em developers.openai.com |
“Liberação gradual” significa que nem todas as contas verão os novos modelos no dia do lançamento. Se você não encontrar o acesso por enquanto no ChatGPT Work ou no Codex, isso é normal: trata-se de uma liberação em lotes. Consulte as explicações nos documentos oficiais de ajuda.
1.2 Dados oficiais de avaliação do GPT-6.2 Astra e Sol
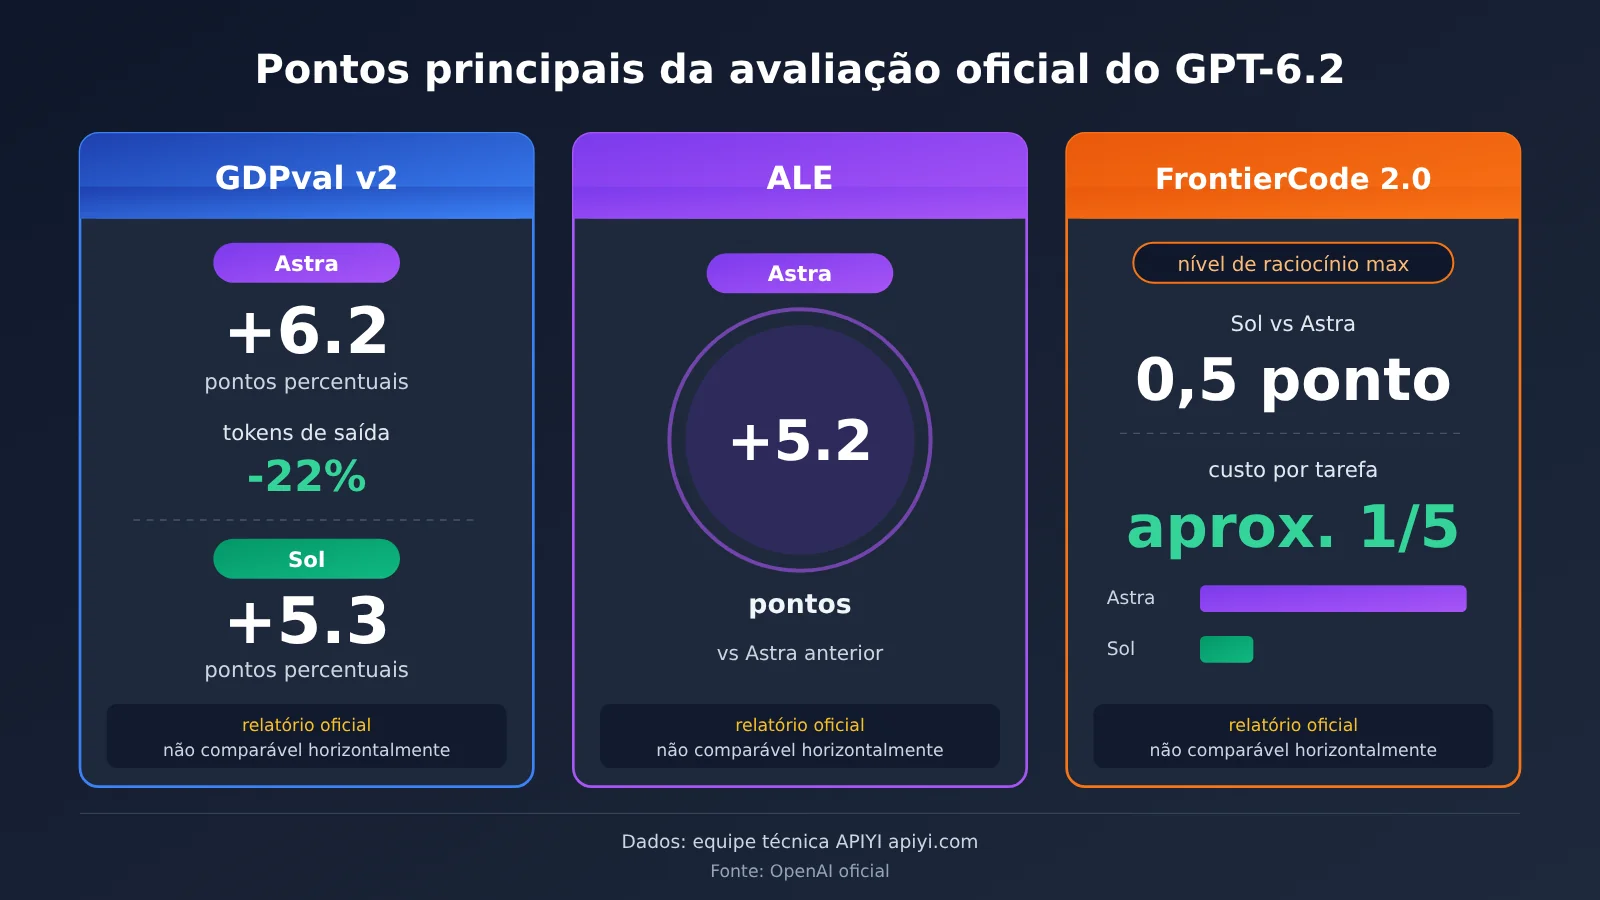
O relatório oficial traz três conjuntos de dados. Eles vêm de avaliações diferentes e têm objetos de comparação distintos; por isso, não podem ser comparados em conjunto. A tabela abaixo segue os critérios originais.
| Avaliação | Modelo | Resultado do relatório oficial | Comparado com |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | aumento de 6,2 pontos percentuais, 22% menos tokens de saída | GPT-6 Astra |
| GDPval v2 | GPT-6.2 Sol | aumento de 5,3 pontos percentuais | GPT-6.1 Sol |
| ALE | GPT-6.2 Astra | aumento de 5,2 pontos | Astra da geração anterior |
| FrontierCode 2.0 (faixa de raciocínio max) | GPT-6.2 Sol | diferença para o Astra dentro de 0,5 ponto; custo da tarefa cerca de 1/5 do Astra | GPT-6.2 Astra |
Há três pontos que merecem atenção. Primeiro, no GDPval v2, os objetos de comparação de Astra e Sol com as gerações anteriores são diferentes: Astra é comparado ao GPT-6 Astra, e Sol ao GPT-6.1 Sol. Portanto, os números 6,2 e 5,3 não permitem comparar diretamente qual dos dois avançou mais. Segundo, o ALE usa “pontos”, enquanto o GDPval v2 usa “pontos percentuais”; as unidades e os métodos de avaliação são diferentes. Terceiro, a conclusão do FrontierCode 2.0 vale apenas para a faixa de raciocínio max desse teste. O material oficial não afirma que o Sol fica a menos de 0,5 ponto do Astra em todas as tarefas, nem que o Sol custa apenas 1/5 em todos os cenários.
1.3 Os limites de capacidade do GPT-6.2 Astra e do Sol
De acordo com os materiais oficiais dos modelos, ambos aceitam texto e imagens como entrada e produzem texto como saída. Isso significa que eles conseguem ler imagens, analisar capturas de tela, entender gráficos e, em seguida, entregar respostas ou código em texto — mas eles próprios não são modelos nativos de geração de vídeo.
Se a sua necessidade é gerar vídeos, este lançamento não traz essa capacidade de forma direta. Já se a sua necessidade é ler materiais, escrever relatórios, escrever código ou fazer análises de várias etapas, então esta atualização está bem mais próxima do seu dia a dia de trabalho.
1.4 Preço padrão da API oficial do GPT-6.2 Astra e do Sol
A página oficial do modelo para desenvolvedores divulgou o preço padrão, na unidade de dólares por milhão de tokens. Os valores abaixo são os preços oficiais e não representam a oferta de nenhuma plataforma de terceiros.
| Item de cobrança | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Entrada não armazenada em cache | $8 | $2 |
| Leitura de cache | $0.4 | $0.1 |
| Saída | $40 | $10 |
| Gravação de cache | Cobrada pela taxa de gravação do respectivo período de retenção, sem acúmulo com a taxa normal de entrada | Cobrada pela taxa de gravação do respectivo período de retenção, sem acúmulo com a taxa normal de entrada |
| Quando a entrada passa de 272K | Taxas de entrada e de cache de toda a requisição ×2, saída ×1.5 | Taxas de entrada e de cache de toda a requisição ×2, saída ×1.5 |
Não some repetidamente a cobrança de cache. O volume de entrada deve ser dividido em quatro partes mutuamente exclusivas: entrada normal, leitura de cache, gravação de cache de 30 minutos e gravação de cache de 12 horas; volume de entrada normal = volume total de entrada − volume de leitura de cache − todo o volume de gravação de cache. Cada parte é multiplicada pela sua taxa correspondente, e os mesmos tokens gravados não voltam a ser cobrados pelo preço normal de entrada. Por exemplo, no Astra em contexto curto Standard, o preço de gravação de 30 minutos é $10/milhão de tokens — essa é a taxa completa de gravação dessa parte, e não $8 do preço normal de entrada mais $10 por cima. Explicação oficial sobre cobrança de cache
A regra dos 272K merece atenção especial. Ela não acrescenta preço apenas à parte que excede o limite: quando a entrada de uma única requisição ultrapassa 272K tokens, as taxas de entrada e de cache de toda a requisição dobram, e a taxa de saída passa a 1,5 vez. Quem tem o hábito de enfiar o acervo inteiro de uma vez na janela de contexto pode acabar com uma conta bem mais alta do que esperava.
2. Análise e avaliação do GPT-6.2 Astra e Sol
O conteúdo a seguir é uma interpretação da equipe editorial da APIYI com base nos fatos oficiais apresentados acima. Não é uma conclusão oficial nem o resultado dos nossos testes práticos. As partes que envolvem tendências são julgamentos — vale validá-las com as suas próprias tarefas.
2.1 O que GPT-6.2 Astra e Sol melhoraram nesta atualização
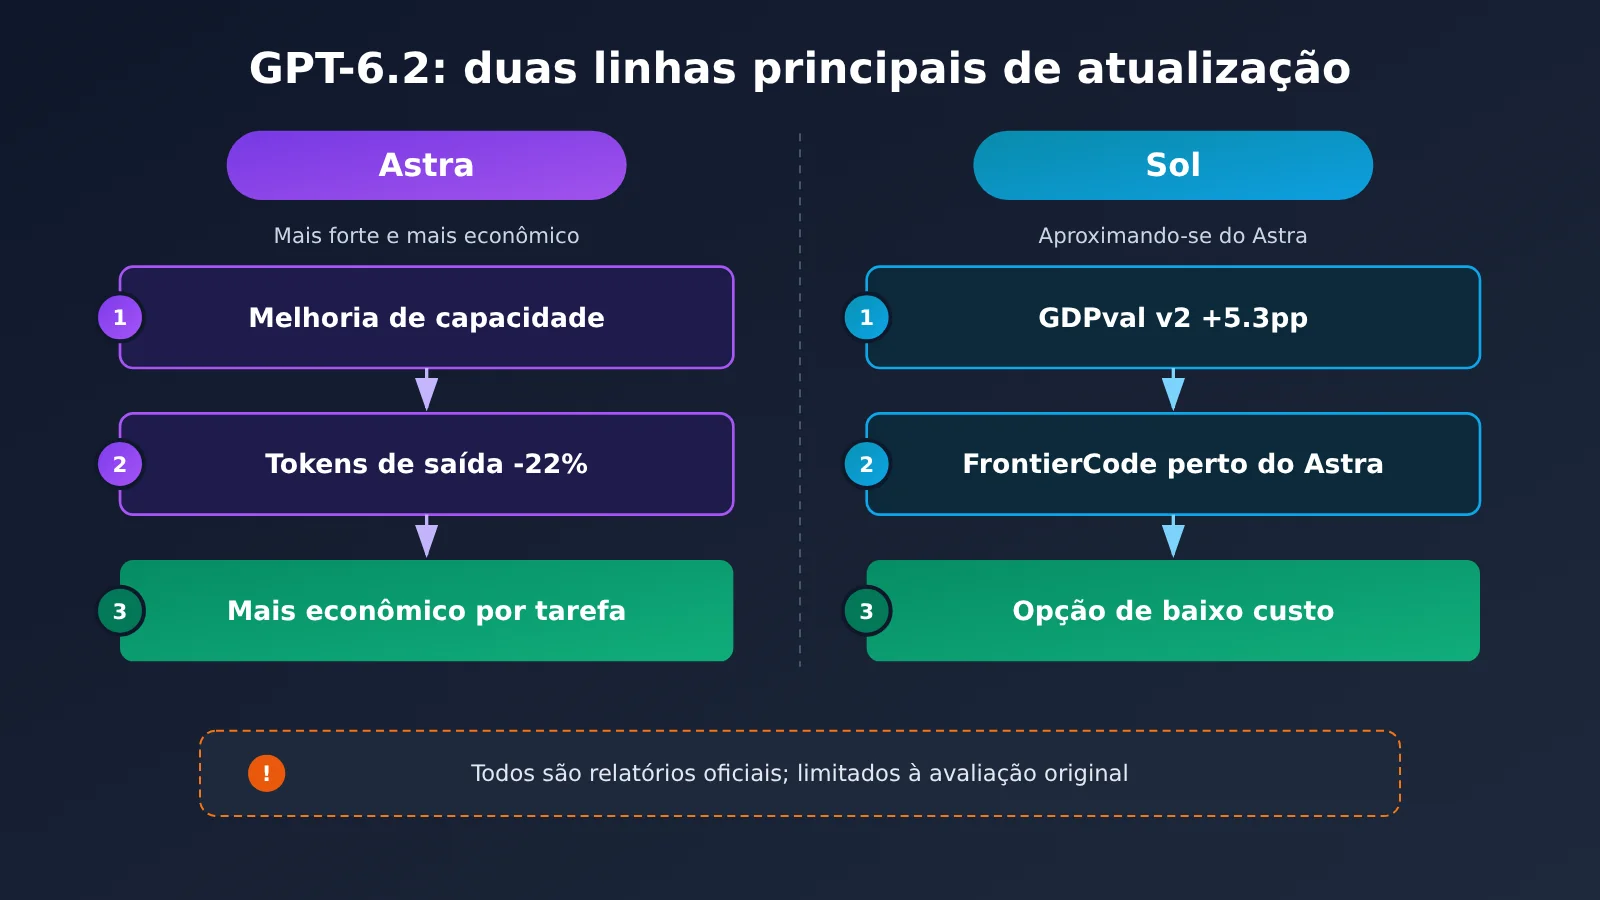
Pelos dados oficiais, esta atualização pode ser resumida em duas linhas principais. Uma é a de Astra: “mais forte e mais econômico” — um ganho de 6.2 pontos percentuais no GDPval v2 e, ao mesmo tempo, uma redução de 22% nos tokens de saída. Esses 22% se referem à variação no consumo de tokens de saída nesse benchmark; não dá para usar esse número para estimar diretamente o tamanho visível de cada resposta nem a proporção de economia.
A outra é a de Sol: “aproximar-se”. O ganho de 5.3 pontos percentuais no GDPval v2 e, no FrontierCode 2.0, uma diferença de menos de 0.5 ponto em relação ao Astra no nível de raciocínio max indicam que a empresa está tentando posicionar o Sol como uma opção com capacidade nada desprezível e preço muito menor. Porém, esse julgamento de “aproximação” hoje se apoia em um único teste de programação; para saber se vale para escrita, análise, documentos longos e outras tarefas, ainda são necessários mais dados.
2.2 Divisão de posicionamento entre GPT-6.2 Astra e Sol
A tabela abaixo coloca os dois modelos lado a lado nas mesmas dimensões. A coluna “cenários adequados” é um julgamento editorial, derivado do preço e da direção das avaliações oficiais, e não significa que o outro modelo seja completamente inutilizável naquele cenário.
| Dimensão | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Tendência de posicionamento | Tarefas complexas, profissionais e de alto valor | Tarefas sensíveis a velocidade e custo |
| Preço oficial (entrada/saída) | $8 / $40 | $2 / $10 |
| Destaques das avaliações oficiais | GDPval v2 +6,2 pontos percentuais, tokens de saída -22%, ALE +5,2 pontos | GDPval v2 +5,3 pontos percentuais, FrontierCode 2.0 faixa max com diferença de até 0,5 ponto em relação ao Astra |
| Cenários adequados (julgamento editorial) | Relatórios críticos, refatoração de código complexo, raciocínio em múltiplas etapas, apoio a decisões com alto custo de erro | Processamento em lote, perguntas e respostas do dia a dia, programação convencional, chamadas de alta frequência, validação de protótipos |
| Pontos de atenção | Preço unitário elevado; com contexto longo, o custo se amplifica de forma mais evidente | Os testes de programação ficam próximos do Astra, mas isso não pode ser extrapolado para todas as tarefas |
| Vias de acesso | ChatGPT Work, Codex, API oficial; para plataformas agregadoras de terceiros como APIYI apiyi.com, consulte a lista de modelos da própria plataforma | O mesmo à esquerda |
Um detalhe fácil de passar despercebido: pelo preço oficial, o preço unitário do Sol é cerca de 1/4 do Astra, enquanto o custo por tarefa no FrontierCode 2.0 é cerca de 1/5. Essa inconsistência é normal, porque o custo por tarefa também depende da quantidade real de tokens consumidos. Isso também nos lembra de que, ao comparar custos, devemos olhar para o “gasto total para concluir a mesma tarefa”, e não apenas para o preço unitário.
Um exemplo ilustrativo com base no preço oficial: em uma requisição com 100 mil tokens de entrada e 10 mil tokens de saída, sem considerar cache, o Astra fica em cerca de $0,8 + $0,4 = $1,2, e o Sol em cerca de $0,2 + $0,1 = $0,3. Os custos reais variam conforme o nível de raciocínio, o comprimento da saída e o acerto de cache; o cálculo detalhado de custos não será abordado neste artigo.
2.3 Usuário comum: escolher GPT-6.2 Astra ou Sol?
Para quem usa o ChatGPT Work no dia a dia, dá para decidir pelo critério de “quanto custa errar”. Se uma tarefa, quando sai errada, exige muito retrabalho ou impacta decisões importantes — como resumir pontos-chave de um contrato, analisar dados complexos ou rascunhar um relatório formal —, vale a pena priorizar o Astra. Já se a tarefa é simples, em grande volume e o resultado pode ser conferido rapidamente — como reescrever um e-mail, organizar atas de reunião ou fazer consultas do cotidiano —, o Sol normalmente dá conta.
Para usuários do Codex, os dados do FrontierCode 2.0 apontam uma direção que vale a pena testar: comece usando o Sol para tarefas de desenvolvimento rotineiras e mude para o Astra quando aparecer uma refatoração que atravessa módulos, um bug difícil de localizar ou um desenho de arquitetura. Mas isso é só uma recomendação baseada em um teste isolado — no fim, o que vale é o desempenho no seu próprio repositório de código.
Se você usa apenas o ChatGPT no modo de conversa comum, essa entrada não está incluída no lançamento desta rodada. Antes de a empresa anunciar oficialmente a ampliação do escopo, você não precisa fazer nenhuma preparação para este lançamento.
2.4 Como desenvolvedores podem validar o GPT-6.2 Astra e o Sol através da API
A abordagem mais segura para o desenvolvedor é chamar os dois modelos com o mesmo lote de tarefas reais e comparar qualidade, latência e consumo efetivo de tokens. O exemplo abaixo foi adaptado da documentação oficial do SDK e ainda não foi executado nem validado; ele usa a interface oficial da OpenAI, e os IDs dos modelos devem ser confirmados na página oficial de modelos. Se você usar uma plataforma de terceiros, confirme primeiro na lista de modelos da plataforma que o modelo já está disponível — este artigo não verificou a disponibilidade de nenhuma plataforma de terceiros.
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # API oficial, chave fornecida via variável de ambiente
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # ID do modelo conforme a lista oficial ou da plataforma
    messages=[{"role": "user", "content": "Resuma em três frases os pontos de risco deste documento de requisitos"}]
)
print(response.choices[0].message.content)
Ver o código completo de comparação entre Astra e Sol
import time
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # API oficial, chave fornecida via variável de ambiente
)

# IDs dos modelos conforme a página oficial de modelos ou a lista da plataforma
MODELS = ["gpt-6.2-astra", "gpt-6.2-sol"]

# Substitua pelas suas tarefas reais, para não avaliar apenas benchmarks públicos isolados
TASKS = [
    "Leia a função a seguir e aponte possíveis problemas de concorrência: ...",
    "Transforme esta ata de reunião em 5 itens de ação: ...",
]

def run(model: str, prompt: str) -> dict:
    start = time.time()
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        usage = resp.usage
        return {
            "model": model,
            "seconds": round(time.time() - start, 2),
            "input_tokens": usage.prompt_tokens,
            "output_tokens": usage.completion_tokens,
            "answer": resp.choices[0].message.content,
        }
    except Exception as e:
        return {"model": model, "error": str(e)}

for task in TASKS:
    for model in MODELS:
        result = run(model, task)
        print(result)
Registre também o total de entrada, as leituras de cache, as gravações de cache discriminadas por período de retenção, a saída cobrada (incluindo raciocínio) e o uso de ferramentas, calculando com as tarifas reais do provedor e do nível de serviço utilizado; os preços oficiais servem apenas para estimativas na API oficial. Recomenda-se ainda manter a entrada de cada requisição abaixo de 272K tokens, para evitar que a requisição inteira acione uma tarifa mais alta.
🎯 Dica técnica: se você precisa comparar vários modelos no mesmo código, pode usar a interface compatível com OpenAI do APIYI apiyi.com: com uma única chave API você alterna entre modelos populares como OpenAI, Claude e Gemini. Se a linha GPT-6.2 já está disponível na plataforma, confirme na lista de modelos da plataforma.
2.5 Variáveis que vale acompanhar no GPT-6.2 Astra e no Sol
A primeira variável é o escopo de lançamento. O Chat comum ainda não entra nesta rodada, e não há informação pública sobre se — e quando — a OpenAI vai ampliar a disponibilização. Isso vai definir quando a maioria dos usuários comuns poderá usar os novos modelos. A segunda variável são os dados de mais tipos de tarefa. Se o Sol também consegue se aproximar do Astra fora da programação é algo que só avaliações de terceiros e mais testes oficiais podem responder.
A terceira variável é o desempenho real de custo. A redução de 22% nos tokens de saída do Astra é um resultado obtido no GDPval v2, e na sua própria tarefa a proporção pode não ser a mesma. A recomendação é registrar continuamente os dados reais de invocação, em vez de fechar um plano de longo prazo de uma vez com base nos números da apresentação de lançamento.
Como dizem os Analectos (Lunyu · Duque Ling de Wei): “Para fazer bem um trabalho, é preciso primeiro afiar as ferramentas.”
📚 Referências
Changelog da API da OpenAI (conferência das datas de publicação)
-
Página oficial de lançamento da OpenAI: anúncio e avaliações oficiais do GPT-6.2 Astra e do Sol
- Link: texto oficial
- Descrição: fonte dos dados de data de lançamento, GDPval v2, ALE e FrontierCode 2.0
-
Central de Ajuda da OpenAI: documentação do ChatGPT Work e do Codex
- Link: texto oficial
- Descrição: pontos de entrada e escopo de liberação gradual
-
Documentação para desenvolvedores da OpenAI – GPT-6.2 Astra: informações do modelo e preços da API
- Link: texto oficial
- Descrição: modalidades de entrada e saída, preço padrão, regras de cobrança para contexto longo
-
Documentação para desenvolvedores da OpenAI – GPT-6.2 Sol: informações do modelo e preços da API
- Link: texto oficial
- Descrição: modalidades de entrada e saída, preço padrão, regras de cobrança para contexto longo
Autor: equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial do site da APIYI, em apiyi.com; há mais materiais de integração no centro de documentação em docs.apiyi.com