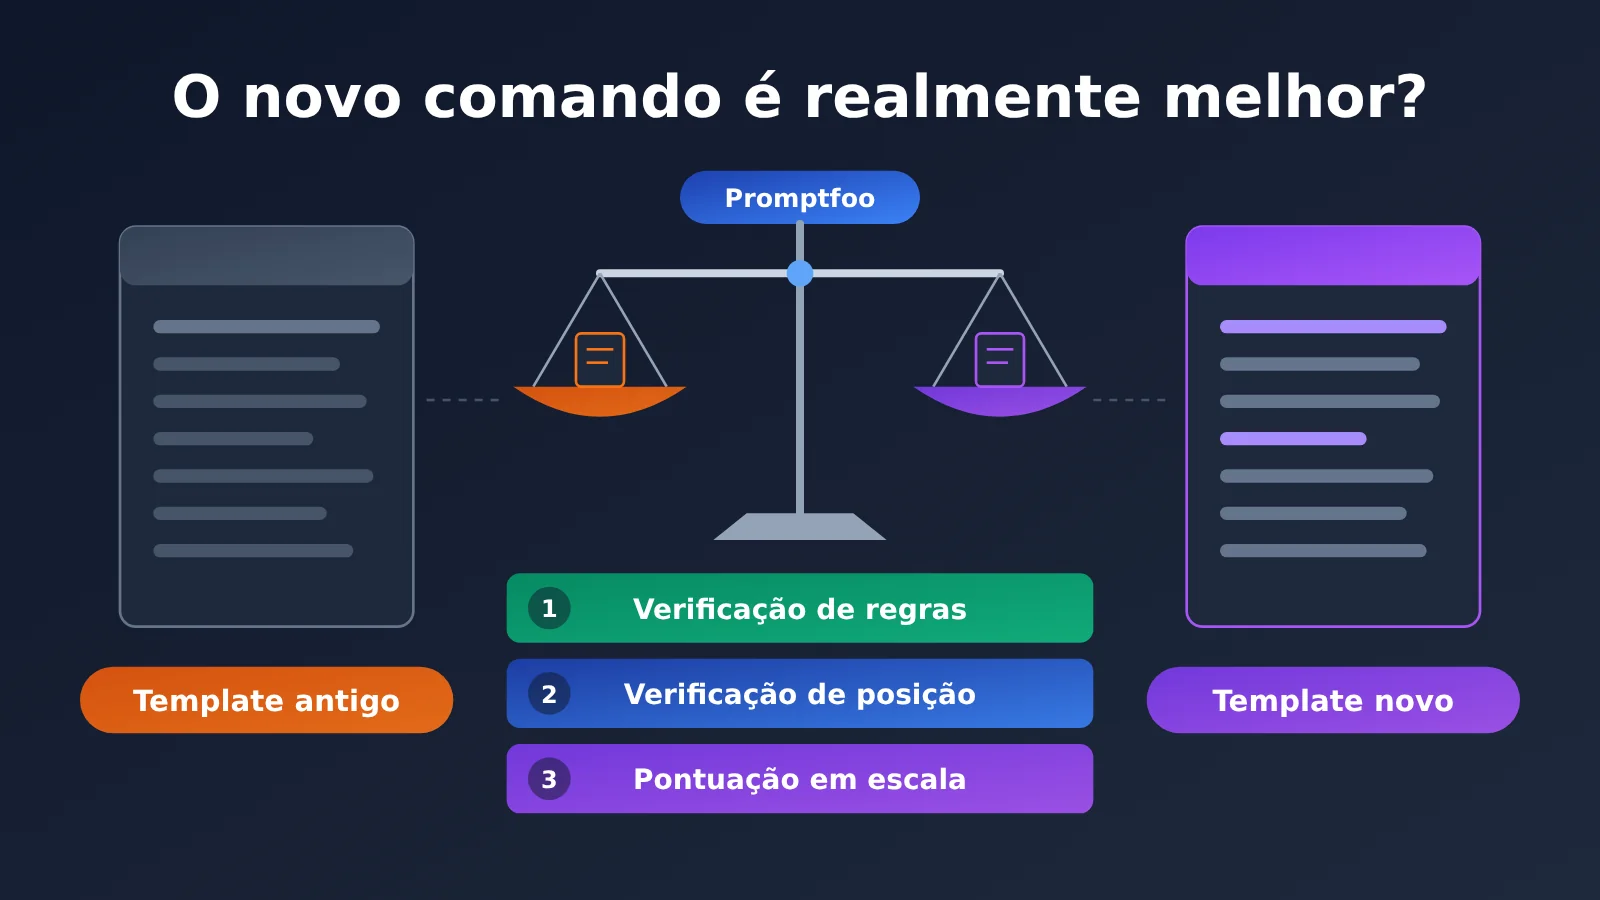
Resposta direta: um novo comando não é necessariamente melhor, e “parecer melhor” também não é evidência. Para julgar qual template de artigo é melhor, o antigo ou o novo, deve-se fixar as fontes, o modelo e as configurações de geração, alterar apenas o template e, então, usar as asserções do Promptfoo para verificar em camadas a estrutura, a ordem e a qualidade do conteúdo. Também é preciso apresentar os resultados por dimensão, sem permitir que a nota de estilo anule erros factuais. Este artigo propõe um desenho experimental; não executamos um experimento A/B real e, portanto, não apresentamos qualquer taxa de vitória, pontuação ou economia de créditos.
Depois de ler este artigo, você vai entender:
- O que as asserções
contains, JavaScript ellm-rubricdo Promptfoo conseguem verificar — e o que elas não conseguem provar. - Como executar um arquivo de asserções separadamente sobre saídas de modelo já existentes, evitando regenerar quando apenas as regras de avaliação mudam.
- Um desenho experimental para comparar os templates de artigo antigo e novo, incluindo controle de variáveis, verificação em três camadas e apresentação por dimensão.
- Os limites entre modelo-juiz e asserções baseadas em regras, além do problema de custo trazido pelos modelos de avaliação pagos.
Índice: primeiro, uma tabela de conceitos explica alguns termos-chave da avaliação com Promptfoo; em seguida, mostramos o impacto disso para equipes de conteúdo, desenvolvedores e responsáveis pela avaliação. A seção “Fatos objetivos” do corpo do texto apenas reúne as capacidades de asserção e o status de verificação descritos na documentação. Já a seção “Análise e julgamento” apresenta recomendações de desenho experimental, exemplos de configuração e discussão de limitações, indicando item por item o que é recomendação e não conclusão de teste real.
Conceitos que você precisa conhecer antes de comparar modelos de comando no Promptfoo
Os termos abaixo vão aparecer várias vezes ao longo do texto. A maioria vem da documentação de configuração do Promptfoo, e alguns são apenas jargão comum em experimentos de avaliação.
| Conceito | Explicação rápida |
|---|---|
| Promptfoo | Ferramenta open source para avaliar comandos e saídas de Modelos de Linguagem Grande; permite definir casos de teste e asserções em um arquivo de configuração |
| Asserção (Assertion) | Regra de verificação automática da saída do modelo, que determina se ela atende a uma determinada condição |
| contains | Verifica se o texto especificado aparece na saída; é uma correspondência de string determinística |
| Asserção JavaScript | Usa uma expressão ou função JavaScript para implementar condições de julgamento mais complexas |
| llm-rubric | Faz um modelo dar uma nota à saída de acordo com uma escala personalizada; pertence à categoria de asserções de “pontuação por modelo” |
| Provedor de avaliação (Grading Provider) | O modelo que executa a pontuação do llm-rubric, que pode ser configurado separadamente |
| Escala (Rubric) | Critérios de julgamento escritos para o modelo de avaliação, explicando em que situação conta como aprovado e em que situação há desconto de pontos |
| Modelo juiz (LLM-as-a-Judge) | A prática de usar um Modelo de Linguagem Grande no lugar de avaliação humana para julgar a qualidade das saídas |
| Controle de variáveis | Mudar apenas um fator no experimento (aqui, o modelo de comando) e manter todos os demais constantes |
Visão rápida do impacto da avaliação de templates de comando novos e antigos
O valor desse tipo de método de avaliação não está em quão nova é a ferramenta, mas em transformar o “acho que o novo template é melhor” em registros de verificação auditáveis. Cada função tira algo diferente disso.
| Público | Impacto real |
|---|---|
| Equipes de conteúdo e editores | A reformulação do template passa a ter critérios de aceitação auditáveis, permitindo detectar problemas como “a estrutura está certa, mas o bloco de fatos incluiu suposições” |
| Engenheiros de comando e desenvolvedores | É possível dividir os requisitos do template em asserções baseadas em regras e asserções baseadas em rubrica; ao alterar as regras de pontuação, não é preciso regenerar todas as saídas |
| Responsáveis pela avaliação | Precisam relatar os resultados por dimensão e distinguir claramente o peso probatório da pontuação do modelo, da correspondência de regras e da revisão humana |
| Responsáveis pelo orçamento | As asserções baseadas em regras quase não geram custo extra de chamadas; se o llm-rubric usar um modelo pago, haverá custos de avaliação |
Fatos objetivos sobre os recursos de asserção do Promptfoo
Esta seção apresenta apenas os recursos descritos na documentação do Promptfoo. Verificamos as páginas relevantes da documentação em 2026-11-17, mas as datas de lançamento inicial desses recursos não foram verificadas. Por isso, este artigo não informa datas específicas de lançamento.
Asserção contains do Promptfoo: verificar se um texto aparece
contains é o tipo de asserção mais básico e serve para verificar se um determinado texto aparece na saída do modelo. Trata-se de uma correspondência de string determinística: a mesma saída produz o mesmo resultado em todas as execuções.
É importante destacar que passar no contains indica apenas que “aquele trecho de texto foi encontrado”. Ele não diz se o parágrafo em que esse texto aparece está bem escrito, nem se o conteúdo está correto.
Asserção JavaScript do Promptfoo: implementar condições complexas
Quando o critério de julgamento vai além de “contém ou não”, é possível escrever lógica personalizada com uma asserção JavaScript. Por exemplo, comparar a ordem em que dois títulos aparecem, contar quantas seções existem ou verificar se determinado trecho está dentro de uma seção específica. Esse tipo de asserção também é determinístico e o resultado é reproduzível.
Avaliar saídas existentes do Promptfoo com um arquivo de asserções independente
O Promptfoo permite executar um arquivo de asserções independente sobre saídas de modelo já geradas, sem precisar regerar todas as saídas. Isso é importante para a iteração de avaliação: as regras de pontuação costumam precisar de ajustes repetidos, enquanto a geração em si consome tempo e tem custo de chamada.
llm-rubric do Promptfoo: pontuar com um modelo segundo uma rubrica
llm-rubric é uma asserção de avaliação por modelo. Ela entrega a saída e uma rubrica personalizada ao modelo de avaliação, que decide se a saída passa e fornece uma justificativa. A documentação explica que o provedor de avaliação responsável pela pontuação pode ser configurado separadamente, e o comando usado na avaliação também pode ser personalizado.
| Tipo de asserção | Forma de julgamento | Resultado determinístico? | O que pode provar | O que não pode provar |
|---|---|---|---|---|
| contains | Correspondência de string | Sim | Que o texto especificado apareceu | Qualidade do parágrafo, correção do conteúdo |
| JavaScript | Lógica de código personalizada | Sim | Condições codificáveis, como estrutura, ordem e contagem | Se algo é bom ou ruim no nível semântico |
| llm-rubric | Modelo pontua segundo uma rubrica | Influenciado pelo modelo de avaliação | Que a saída, na visão do modelo de avaliação, atende à rubrica | Correção factual; também não substitui a verificação humana |
Fontes e status de verificação
A parte factual deste artigo se baseia nas seguintes páginas da documentação do Promptfoo, verificadas em 2026-11-17:
- Documentação de asserções e métricas do Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/
- Documentação de asserções de avaliação por modelo do Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Documentação do
llm-rubricdo Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
Este artigo não executou um experimento A/B real entre templates antigos e novos. As configurações e os fluxos apresentados adiante são sugestões de design e não representam resultados de testes reais.
Usando o Promptfoo para comparar a análise e o julgamento de templates de artigo antigos e novos
O conteúdo a seguir é a nossa interpretação e recomendações com base nos fatos acima. Tomando o “template de artigo de notícias” como exemplo, suponha que o novo template exija que o artigo contenha duas seções: “fatos objetivos” e “análise e julgamento”, com os fatos primeiro e a análise depois, e que especulações não possam ser misturadas ao parágrafo de fatos.
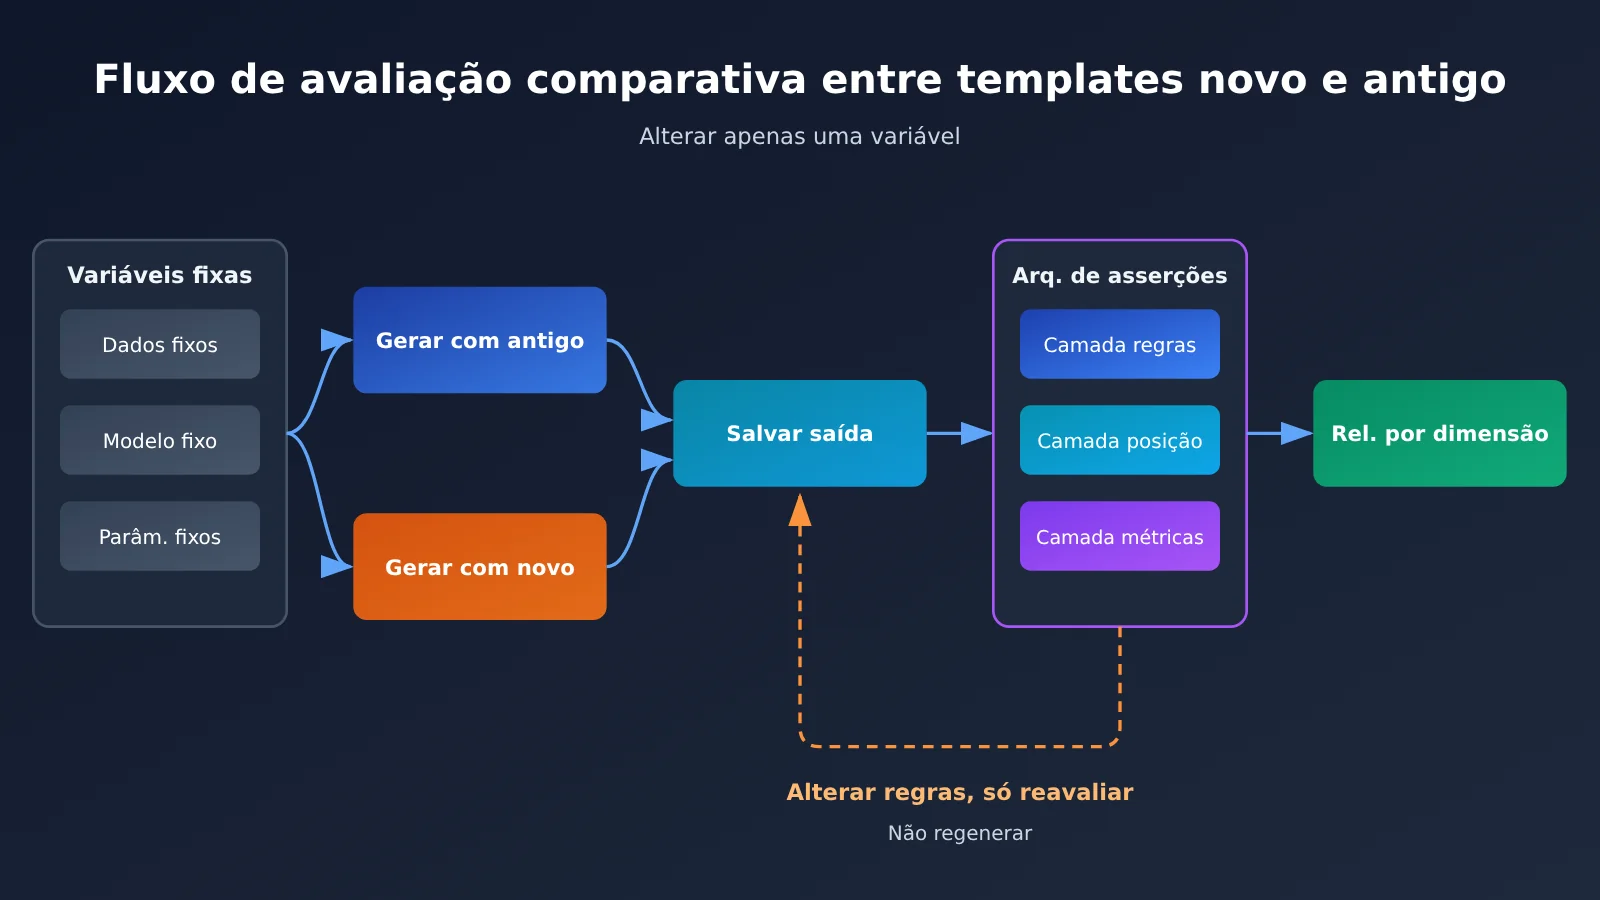
Desenho do experimento: ao comparar templates com o Promptfoo, mude apenas uma variável
O erro mais comum ao comparar templates é trocar o template e, ao mesmo tempo, também trocar os dados, o modelo ou os parâmetros de temperatura. Assim, mesmo que o resultado melhore, não dá para dizer se foi mérito do template ou influência de outros fatores. Por isso, o primeiro passo é travar todas as variáveis, exceto o template.
| Variável | Tratamento | Motivo |
|---|---|---|
| Dados de entrada | Fixar o mesmo lote, compartilhado pelos templates novo e antigo | Dados diferentes alteram diretamente o conteúdo factual |
| Modelo de geração | Fixar o mesmo modelo e versão | Diferenças de estilo de escrita entre modelos podem ser maiores que as diferenças entre templates |
| Parâmetros de geração | Fixar configurações como temperatura e comprimento máximo | Parâmetros afetam a estabilidade e a extensão da saída |
| Template de comando | A única variável alterada | É o objeto a ser validado |
| Regras de pontuação | Os dois grupos, novo e antigo, usam o mesmo conjunto de asserções | Garantir que os dois grupos passem pelas mesmas verificações |
Camadas de regra e de posição do Promptfoo: primeiro verifique a estrutura, depois a ordem
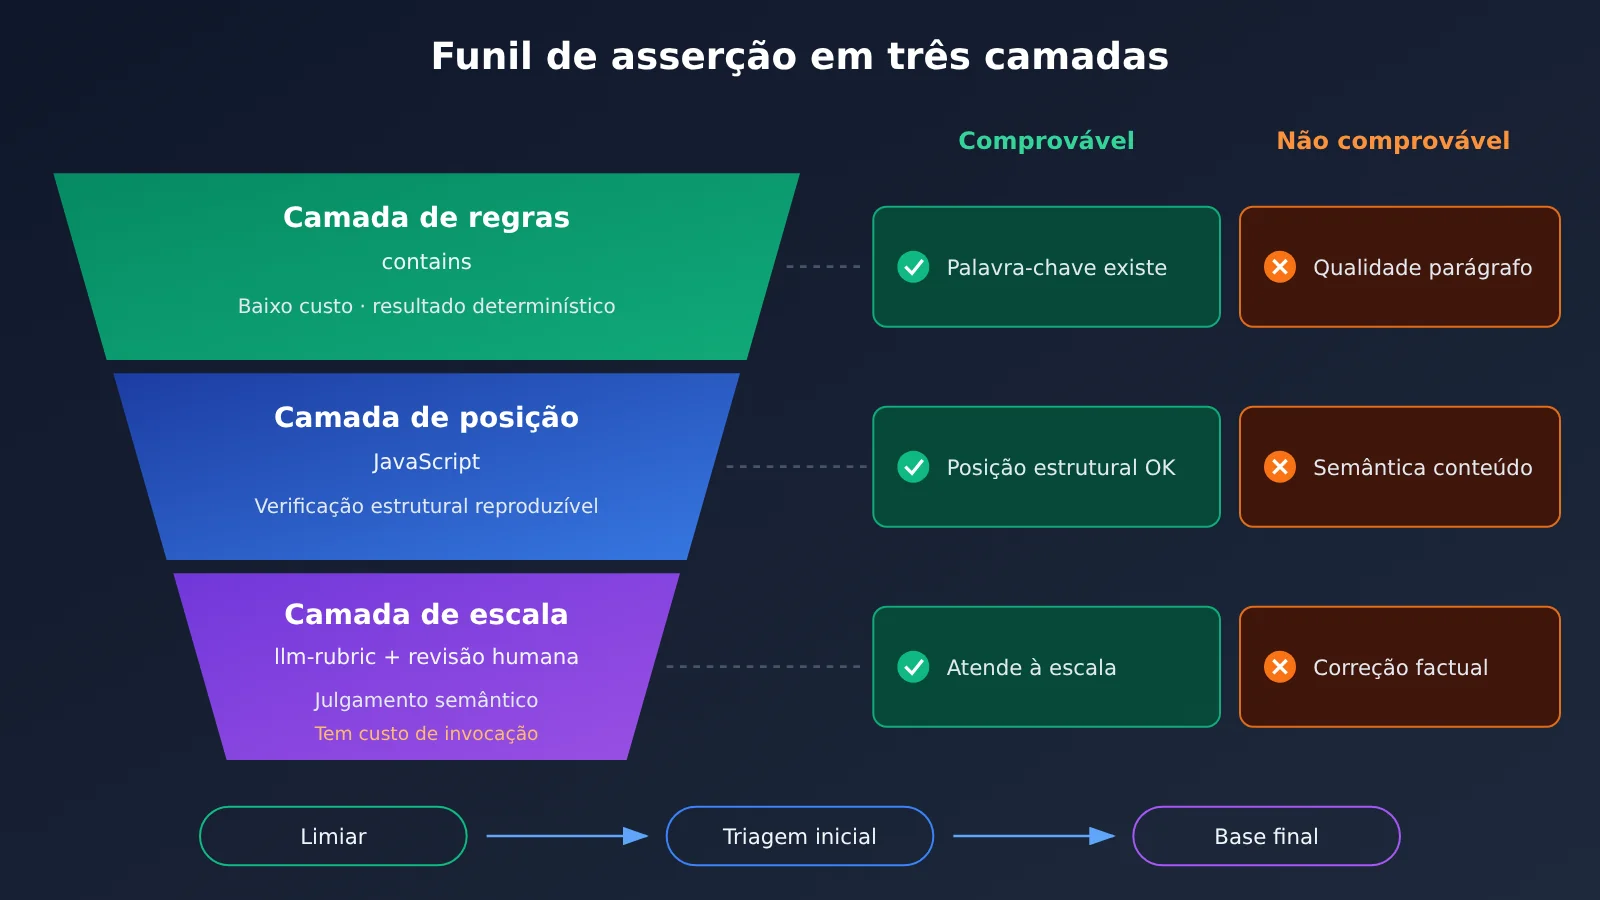
A primeira camada é a checagem de regras, usando contains para confirmar se os títulos exigidos pelo template aparecem. A segunda é a comparação de posição, usando uma asserção JavaScript para confirmar que o título “客观事实” aparece antes do título “分析判断”. As duas camadas são checagens determinísticas: custo baixo e resultado estável, então é melhor colocá-las no início para filtrar rapidamente as saídas claramente fora do padrão.
Abaixo está uma forma ilustrativa de escrever as asserções — os nomes exatos dos campos devem ser conferidos na documentação oficial do Promptfoo:
# Configuração ilustrativa: serve para explicar a ideia; confira os detalhes dos campos na documentação oficial
assert:
  # Camada de regra: o título aparece?
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # Camada de posição: a seção de fatos deve vir antes da seção de análise
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
Repare que, na camada de posição, primeiro verificamos se os dois títulos existem. Se escrevêssemos apenas a < b, quando o título “客观事实” estiver faltando o indexOf retorna -1, e a condição de “menor que” ainda seria satisfeita, causando um falso positivo. É justamente por isso que até as asserções determinísticas precisam ser escritas com cuidado.
Camada de rubrica do Promptfoo: usar uma rubrica clara para verificar se o parágrafo de fatos mistura especulação
Ter todos os títulos e a ordem correta não significa que o parágrafo de fatos esteja limpo. “Se o parágrafo de fatos mistura especulação” é um julgamento semântico, algo que asserções baseadas em regras dificilmente conseguem cobrir — e é aí que o llm-rubric se encaixa bem. A rubrica precisa ser escrita de forma específica: diga ao modelo de avaliação o que conta como violação, em vez de perguntar de modo vago se “ficou bom ou não”.
# Configuração ilustrativa: o provedor de avaliação e o conteúdo da rubrica são apenas exemplos
assert:
  - type: llm-rubric
    value: |
      Avalie apenas a seção "fatos objetivos".
      Se essa seção contiver previsões, avaliações subjetivas ou inferências sem fonte indicada, considere como reprovado e cite a frase original problemática.
      Não avalie a qualidade da escrita nem as demais seções.
    provider: your-grading-model   # O provedor de avaliação pode ser configurado separadamente
As conclusões da camada de rubrica ainda exigem verificação manual por amostragem. O modelo de avaliação pode deixar passar casos, ou pode classificar erroneamente uma declaração factual razoável como especulação. O procedimento mais seguro é revisar item por item as amostras reprovadas e, em seguida, selecionar aleatoriamente uma parte das amostras aprovadas para revisão manual.
Apresentação por dimensão: não deixar a pontuação de estilo do Promptfoo compensar erros factuais
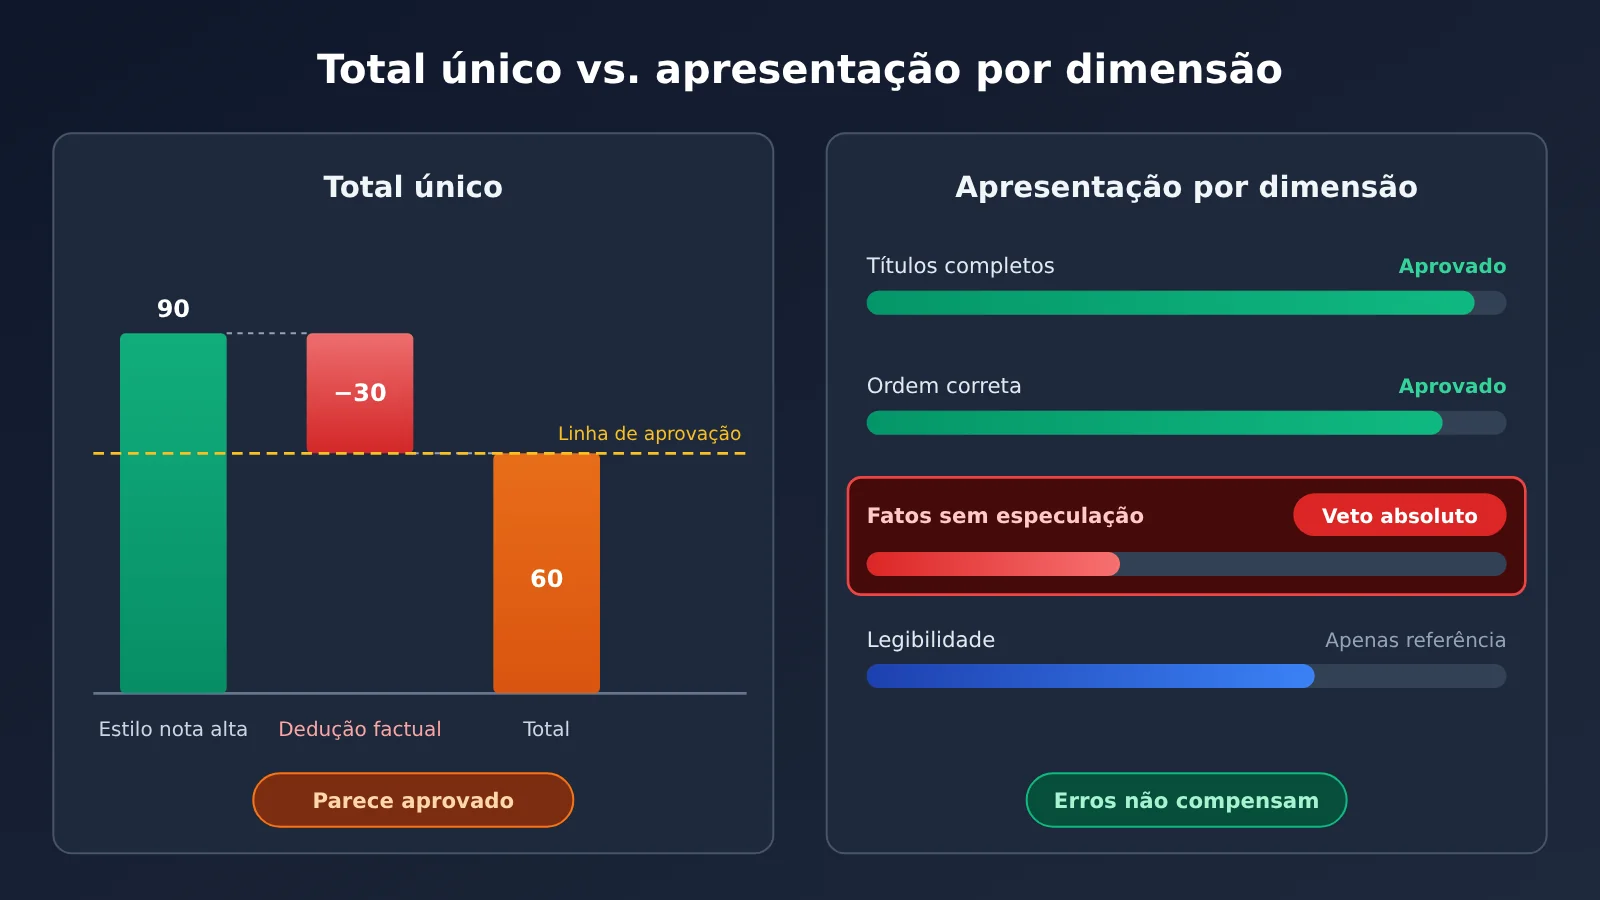
Se você juntar todas as asserções em uma pontuação total, um artigo com escrita fluente mas cujo parágrafo de fatos mistura especulação pode acabar com pontuação parecida à de um artigo bem estruturado, porém um pouco sem graça. Para conteúdo jornalístico, esse tipo de “compensação mútua” é perigoso. Por isso, recomenda-se relatar cada dimensão separadamente e definir a dimensão factual como veto — uma reprovação ali derruba tudo.
| Dimensão de avaliação | Método de verificação | Forma de apresentação | Pode ser compensada por outras dimensões? |
|---|---|---|---|
| Títulos obrigatórios completos | contains | Taxa de aprovação | Não, é requisito rígido |
| Ordem das seções correta | JavaScript | Taxa de aprovação | Não, é requisito rígido |
| Parágrafo de fatos sem especulação | llm-rubric + revisão manual | Taxa de aprovação + lista das frases originais problemáticas | Não, veto |
| Expressão e legibilidade | llm-rubric | Listada separadamente | Apenas como referência, não participa da compensação |
Ao alterar apenas as regras de pontuação do Promptfoo, reavalie diretamente as saídas antigas
Durante as iterações de avaliação, o que mais costuma mudar são as regras de pontuação, não o template em si. Por exemplo, quando percebemos que a descrição da escala não está clara o suficiente ou que uma asserção de posição deixou de fora algum caso de borda. Nesse momento, nem o template nem as saídas mudaram, então não faz sentido gerar tudo de novo.
Usando a capacidade do Promptfoo de executar arquivos de asserção independentes sobre saídas já existentes, é possível separar completamente geração e pontuação: gere uma vez, salve as saídas e, a cada ajuste nas regras, execute novamente apenas as asserções. Isso economiza tempo e ainda garante que as duas rodadas de pontuação estejam diante exatamente do mesmo texto — só assim a comparação faz sentido.
Limites e custos do modelo-juiz no Promptfoo
Há três pontos que precisam ficar claros para evitar leituras exageradas dos resultados da avaliação:
- A pontuação do modelo-juiz não prova que os fatos estão corretos. O
llm-rubricapenas indica que, aos olhos do modelo que pontua, a saída está de acordo com a escala; a verificação factual ainda precisa voltar às fontes originais. - Passar em
containssignifica apenas que o texto apareceu. Isso mostra que o título apareceu, mas não que a qualidade dos parágrafos abaixo dele esteja aceitável. - A revisão por modelo pago tem custo. Asserções baseadas em regras praticamente não geram invocações adicionais do modelo, mas o
llm-rubricchama o modelo de pontuação uma vez para cada saída avaliada; portanto, não dá para chamar todo o conjunto de avaliações de “totalmente gratuito”.
Com base nesses limites, nossa conclusão é: asserções determinísticas funcionam bem como um “portão”, a pontuação por modelo como uma “triagem inicial” e a revisão humana como a base final para conclusões factuais. As três têm responsabilidades diferentes e não podem substituir umas às outras.
Direções que mereem atenção daqui para frente
A seguir estão direções de observação ainda não verificadas, que servem apenas como sugestões para experimentos futuros:
- Consistência do modelo de avaliação. Se a mesma saída, avaliada várias vezes, mantém conclusões estáveis, e se trocar o modelo de avaliação pode inverter as conclusões. Se não houver estabilidade, a escala de avaliação precisa ser escrita de forma mais específica.
- Grau de concordância entre a checagem manual por amostragem e a nota do modelo. Isso determina até que ponto é possível confiar no llm-rubric para fazer uma triagem inicial.
- Se o tamanho da amostra é suficiente. Ao comparar apenas poucos artigos, fatores ocasionais podem mascarar diferenças entre templates; é preciso uma quantidade suficiente de material de entrada para chegar a conclusões significativas.
Antes de haver dados medidos empiricamente sobre essas questões, qualquer afirmação do tipo “qual é a taxa de acerto do novo template” ou “quanto a nota subiu” deve ser tratada com cautela. Este artigo deliberadamente não apresenta esse tipo de número, e a razão é justamente essa.
O que se aprende no papel é sempre superficial; para conhecer a fundo, é preciso praticar. — Lu You, “Lendo para meu filho Yu numa noite de inverno”