A equipe Tongyi da Alibaba lançou o Qwen4-Max na manhã de 2026-11-16. Parâmetros do modelo principal: 2.4T, janela de contexto de 1M. Junto com o anúncio, foi divulgada uma imagem comparativa com 16 resultados de benchmark.
Primeiro, a conclusão: onde o Qwen4-Max realmente lidera é na eficiência de tokens e na entrega em tarefas de longo prazo — ele não fica em primeiro lugar em todos os itens. Nos 16 resultados de benchmark autodeclarados oficialmente, ele conquistou 4 primeiros lugares e 4 segundos lugares; em operação de terminal, construção de programas, compreensão de gráficos e compreensão de vídeo, ainda fica claramente atrás dos concorrentes líderes no mesmo gráfico.
As fontes de informação deste artigo são apenas três: os materiais oficiais de lançamento de 2026-11-16, o snapshot final do ranking público Code Arena WebDev do arena.ai (2026-11-14) e os dois preços de tabela do QwenCloud e da plataforma Qwen AI. Detalhes de parâmetros não divulgados e resultados de reprodução por terceiros não fazem parte do escopo deste artigo. Se você está rodando Qwen3.8-Max ou outro modelo de ponta, depois da leitura pode avaliar, para os três tipos de tarefa, se vale trocar, e fazer as contas por conta própria usando o preço de entrada, o preço de saída e o preço de cache.
Resumo das informações de lançamento do Qwen4-Max
| Item | Detalhes |
|---|---|
| Data de lançamento | 2026-11-16 10:01 (UTC+8) |
| Lançado por | Equipe Qwen (通义千问) da Alibaba |
| Escala de parâmetros | 2.4T de parâmetros no backbone, 71B ativados por token, além de 328B em parâmetros de N-gram Embedding |
| Contexto | 1M, visão nativa |
| Canais oficiais | QwenCloud API, Qwen Studio, QwenWork, Qoder, 千问 App |
| Plano de código aberto | A equipe oficial informou que versões menores do Qwen4 terão os pesos abertos; o próprio Max não foi mencionado como código aberto |
Pelo ritmo de lançamentos, desta vez não se trata apenas da atualização de um modelo de API. O Qwen4-Max também entrou em dois produtos próprios, QwenWork (escritório) e Qoder (programação), e os materiais oficiais colocam o foco em tarefas longas de agentes e entregas para setores específicos, sem tratar a capacidade de perguntas e respostas puras como principal destaque.
Três mudanças na arquitetura do Qwen4-Max
O blog oficial lista três mudanças estruturais. Veja abaixo o problema que cada uma resolve:
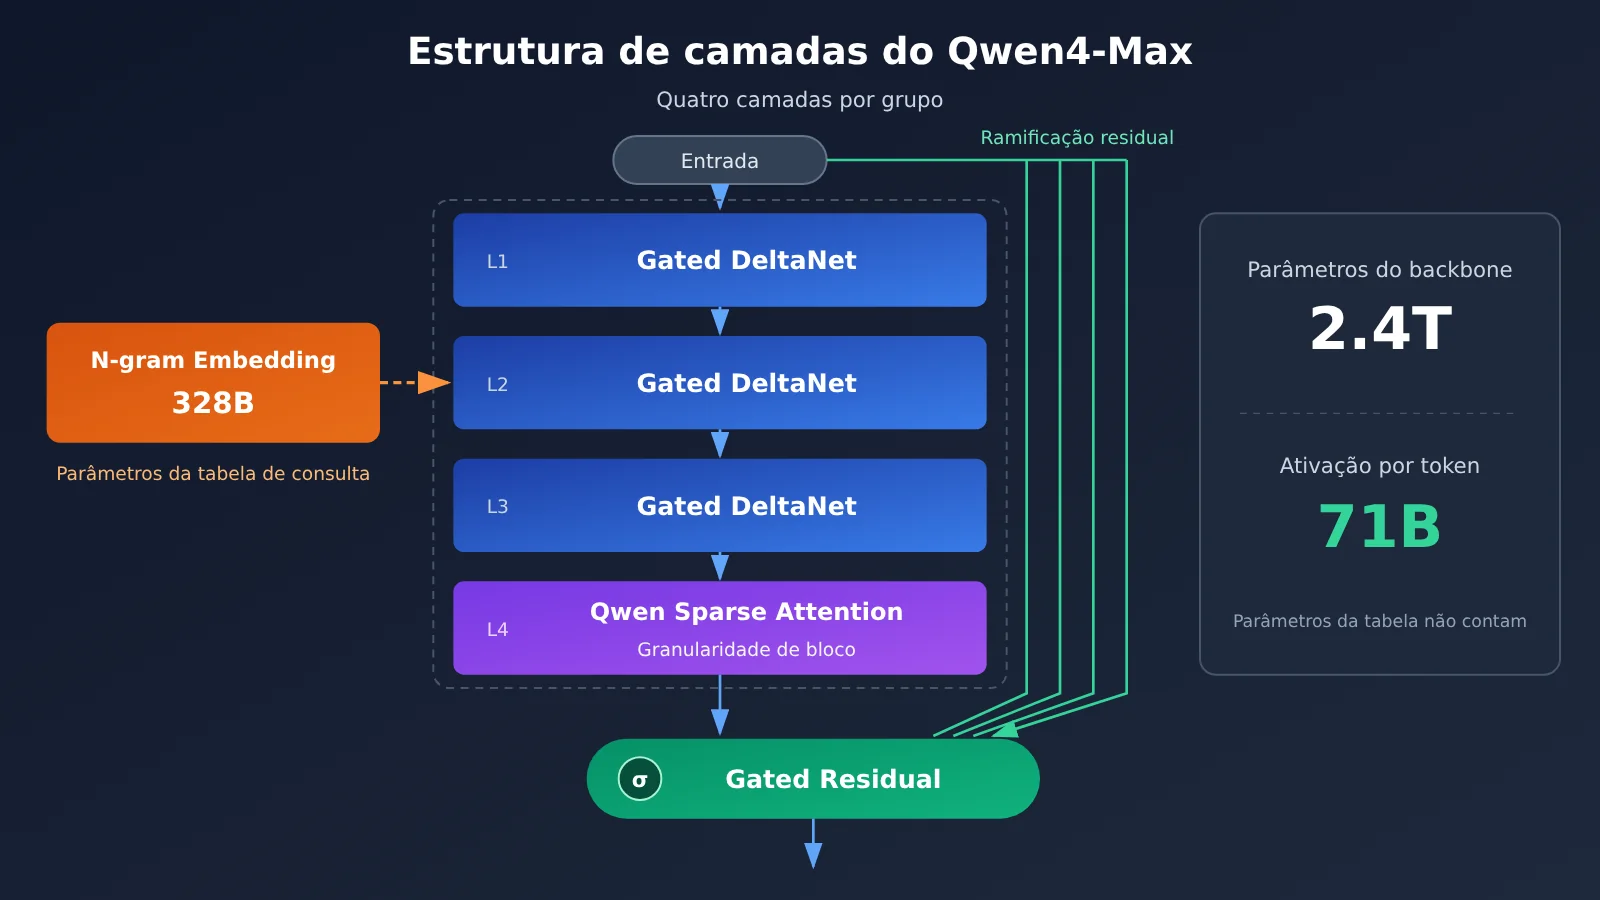
- Atenção híbrida GDN + QSA: a cada quatro camadas, três usam Gated DeltaNet e uma usa Qwen Sparse Attention, selecionando o contexto com granularidade de bloco. O objetivo principal dessa disposição é reduzir o custo computacional em contextos longos de 1M.
- Gated Residual: o caminho residual é dividido em quatro ramos paralelos e depois combinado por gating, para melhorar a capacidade de expressão das camadas profundas da rede.
- N-gram Embedding: faz uma consulta em tabela na segunda camada para complementar padrões locais de tokens. É daí que vêm os 328B de parâmetros extras; são parâmetros de consulta em tabela e não participam do cálculo de ativação por token.
Atenção: 2.4T é o total de parâmetros do backbone, e o que é efetivamente ativado por token são 71B. Ao comparar o “tamanho de parâmetros” com outros modelos, primeiro é preciso confirmar se ambos usam o mesmo critério.
Especificações e protocolos do Qwen4-Max
| Item de especificação | Qwen4-Max |
|---|---|
| Janela de contexto | 1M |
| Entrada máxima | 991K (983K no modo de raciocínio) |
| Saída máxima | 393K |
| Cadeia de pensamento máxima | 262K |
| TPM | 5 milhões |
| Protocolos compatíveis | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
reasoning_effort padrão |
high (o padrão do Qwen3.8-Max é xhigh) |
A última linha passa fácil despercebida. O nível de raciocínio padrão do Qwen4-Max é high, um nível abaixo do xhigh padrão da geração anterior. Se você comparar as duas gerações usando diretamente os parâmetros padrão, parte da economia de tokens que você vê vem da diferença de nível, e não inteiramente do modelo em si. Ao fazer testes A/B, recomendo definir reasoning_effort explicitamente com o mesmo valor nos dois lados.
Qwen4-Max: 16 benchmarks oficiais — onde lidera e onde fica atrás
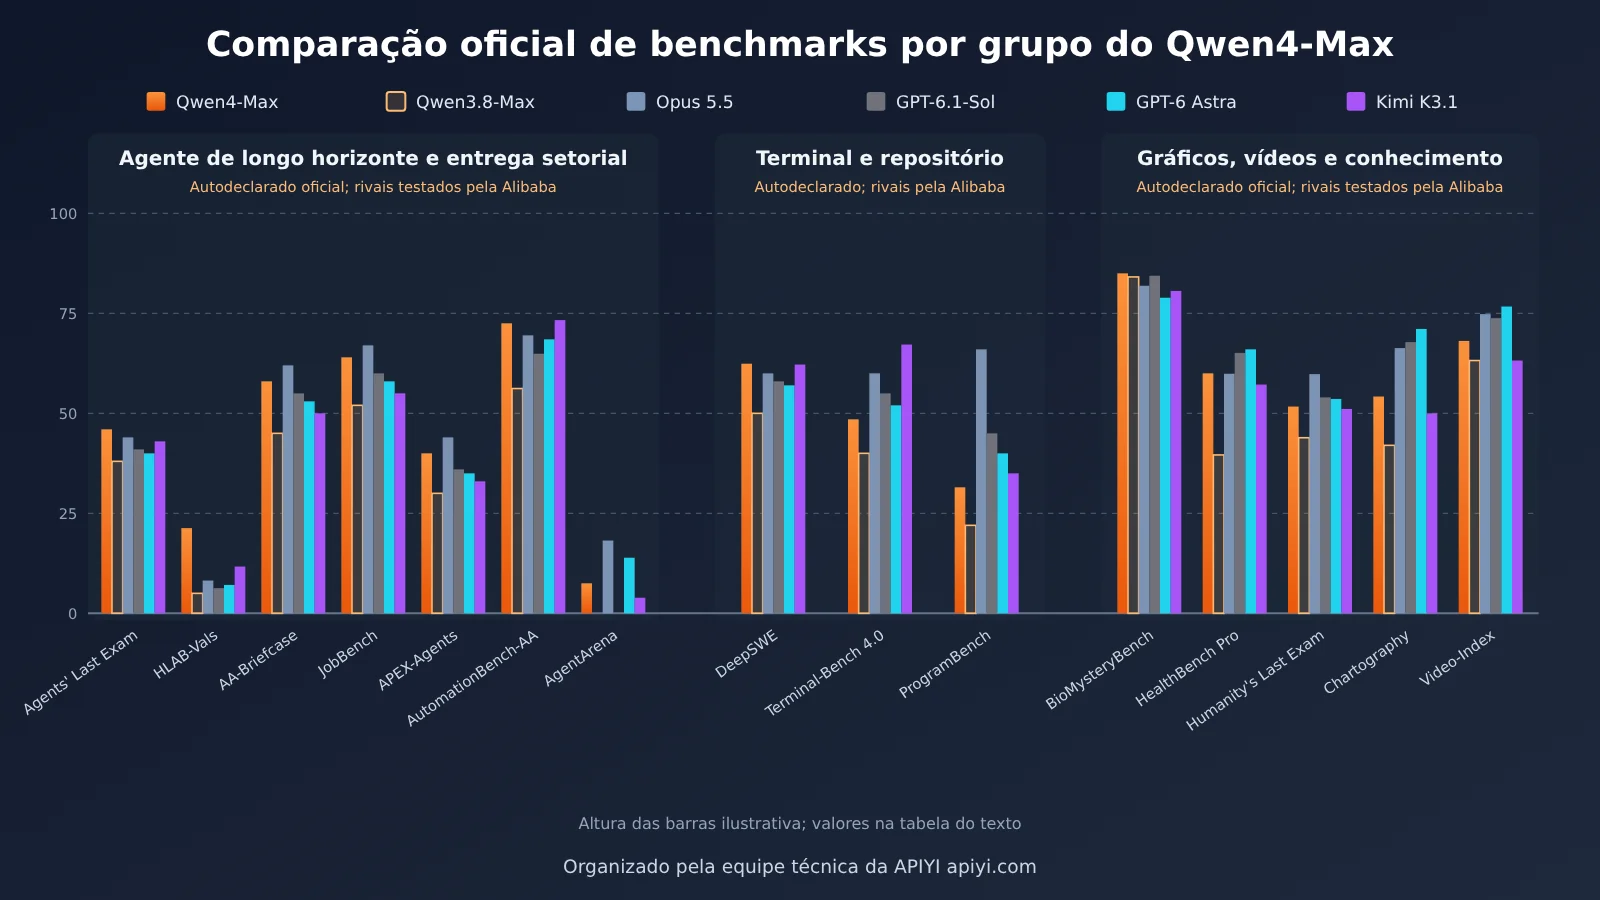
Todos os números da tabela abaixo vêm da mesma imagem divulgada oficialmente, ou seja, são auto-relatados pela própria Alibaba. As pontuações dos concorrentes nessa imagem também foram medidas pela Alibaba, então não devem ser tratadas como resultados oficiais publicados pela Anthropic, pela OpenAI ou pela Moonshot. CodeArena e AgentArena vêm do LM Arena; AA-Briefcase e AutomationBench-AA vêm do Artificial Analysis; APEX-Agents vem do ranking da Mercor; JobBench foi testado pela própria Alibaba com um dataset e um código de avaliação atualizados.
| Benchmark | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | não informado |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Projetos em que o Qwen4-Max lidera
O Qwen4-Max fica em primeiro em quatro benchmarks: DeepSWE, Agents’ Last Exam, HLAB-Vals e BioMysteryBench. Desses, a maior diferença está no HLAB-Vals: os 21.3 pontos são aproximadamente o dobro do segundo colocado, o Kimi K3.1. Já no DeepSWE a vantagem sobre o Kimi é de apenas 0.2 ponto, diferença que dá para considerar praticamente empate.
Em outros quatro ele aparece em segundo: AA-Briefcase, JobBench, APEX-Agents e AutomationBench-AA. Nos três primeiros o líder é o Opus 5.5; no último, o Kimi K3.1. Todos esses benchmarks pendem para agentes de longo prazo e para entregas típicas de trabalho de colarinho branco — que é justamente a direção que o material oficial destaca desta vez.
Projetos em que o Qwen4-Max fica atrás
Terminal e construção de programas é o ponto fraco mais evidente aqui. Os 48.5 pontos no Terminal-Bench 4.0 colocam o modelo em quinto lugar entre seis, 18.7 pontos atrás do primeiro colocado, o Kimi. No ProgramBench, os 31.5 pontos ficam abaixo da metade do Opus 5.5. Se o seu agente basicamente roda build, debug e deploy dentro do shell, esses dois benchmarks têm mais valor de referência do que o DeepSWE.
Compreensão de gráficos e de vídeo também fica para trás. Chartography e Video-Index aparecem ambos em quarto lugar, com 16.9 e 8.6 pontos de distância do líder GPT-6 Astra, respectivamente. Humanity’s Last Exam também é quarto lugar. Ou seja: “visão nativa” significa que o recurso existe, não que o modelo seja líder nessa área.
A posição do Qwen4-Max no ranking público do Code Arena
O snapshot final do ranking público (2026-11-14) do arena.ai Code Arena WebDev reúne 1,007,405 votos e 159 modelos. O Qwen4-Max (xHigh) aparece em 6º lugar com 1750 pontos, marcado como Preliminary, com apenas 1,814 votos — a página exibe um custo por tarefa P50 de $4.18. À sua frente estão, nesta ordem, Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Carbon (Preliminary) e GPT-6 Astra.
A geração anterior, Qwen3.8-Max (0902), ocupava a 16ª posição no mesmo ranking, com 1676 pontos. Ou seja, esta geração subiu 74 pontos e 10 posições. Só que o Qwen4-Max ainda tem poucos votos, então o ranking pode mudar mais para frente.
De onde vêm a eficiência de tokens do Qwen4-Max e a “queda de 60% no custo”
Os números oficiais de eficiência saem do benchmark interno de cenários Work360. Esse benchmark tem 26 domínios de primeiro nível, 182 de segundo nível e 721 de terceiro nível; o Qwen4-Max marca 52.69 e o Qwen3.8-Max, 47.74. No consumo de tokens, o nível Xhigh do Work360 fica cerca de 24% menor e o nível High, cerca de 35% menor; já no Terminal-Bench 4.0, os dois níveis ficam cerca de 48% e 49% menores, respectivamente.
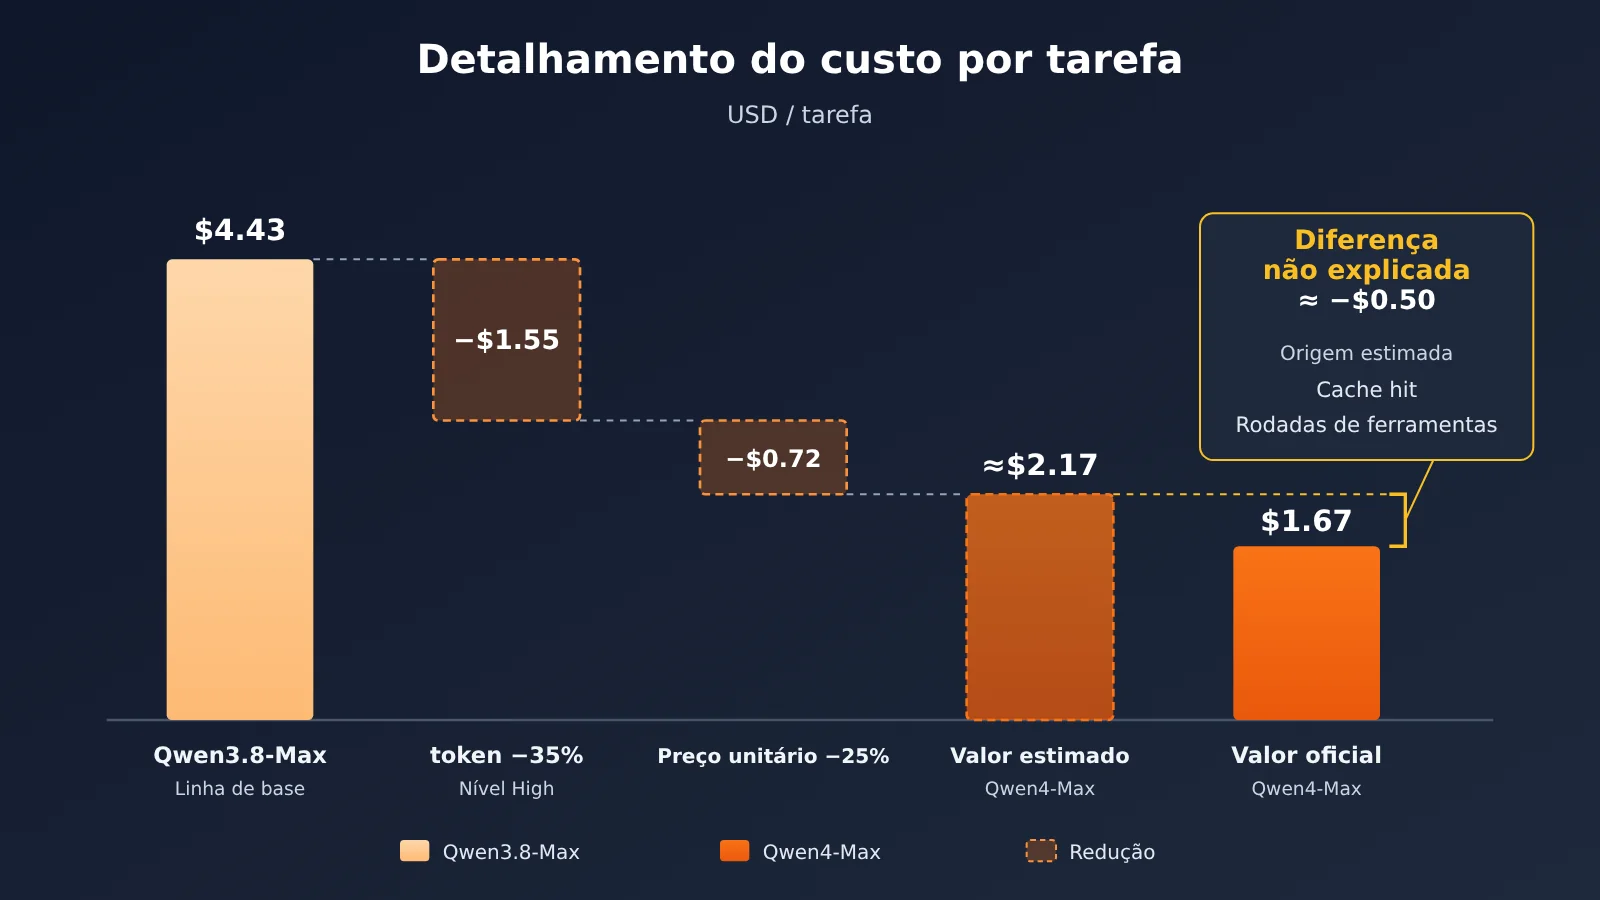
No custo médio por tarefa, os números oficiais vão de $4.43 para $1.67 — na versão do blog em chinês, de ¥26.58 para ¥11.16, uma redução de 58%. Já calculando com os valores em dólar, a queda fica em torno de 62%. Mas se a gente usar apenas “35% menos tokens × 25% menos preço unitário”, o resultado é mais ou menos 0.65 × 0.75 ≈ 0.49, ou seja, uma redução de cerca de 51%. Essa diferença no meio não é explicada oficialmente; as fontes mais prováveis seriam maior taxa de acerto de cache e menos rodadas de chamada de ferramentas, mas isso é só especulação e não pode ser tratado como causa confirmada.
Na parte de segurança, a “taxa de dupla aprovação em funcionalidade e vulnerabilidades”, no nível de função do Last Secure Code Bench, sobe de 22.0% para 31.8%. A proporção de código seguro gerado nas três granularidades — função, arquivo e repositório — vai de 8% para 14.7%. Em termos absolutos ainda é baixo, e o código gerado continua precisando de revisão humana.
Como calcular o preço do Qwen4-Max
Abaixo estão os preços oficiais do Qwen4-Max, além do preço oficial da geração anterior e do preço atual na APIYI. Todas as unidades estão em dólares / 1M tokens, com data de referência em 2026-11-16.
| Item de cobrança | Qwen4-Max (oficial QwenCloud) | Qwen3.8-Max (oficial) | qwen3.8-max (preço atual na APIYI apiyi.com) |
|---|---|---|---|
| Entrada | $1.5 | $2 | $1.65 |
| Saída | $4.5 | $6 | $4.95 |
| Leitura de cache / acerto | $0.075 | $0.25 | $0.20625 |
| Criação de cache explícito de 5 minutos | $1.875 | — | — |
| Criação de cache explícito de 1 hora | $3 | — | — |
Os preços em RMB têm como referência a plataforma Qwen AI, com unidade em RMB / 1M tokens e data de referência em 2026-11-16:
- Entrada ¥10, saída ¥30, acerto de cache ¥0.5
- Criação de cache explícito de 5 minutos ¥12.5, criação de cache explícito de 1 hora ¥20
Em comparação com o preço oficial da geração anterior, os preços de entrada e saída do Qwen4-Max são 25% menores, e o preço de leitura de cache é 70% menor. A maior queda é justamente no preço de leitura de cache, o que tem impacto evidente em agentes de horizonte longo, porque, em tarefas com múltiplos turnos, muitos comandos de sistema e contextos históricos repetidos são cobrados pelo preço de cache.
Ao estimar o custo por conta própria, você pode detalhar o cálculo com esta fórmula: entrada sem acerto de cache × preço de entrada + acerto de cache × preço de cache + volume de criação de cache explícito × preço de criação + saída (incluindo cadeia de pensamento) × preço de saída. Um exemplo hipotético: uma tarefa tem 1M de entrada, dos quais 600 mil acertam o cache, e 100 mil de saída. Com o preço oficial do Qwen4-Max, o cálculo fica em cerca de $0.6 + $0.045 + $0.45 ≈ $1.10; com o mesmo volume de tokens e o preço oficial do Qwen3.8-Max, o cálculo fica em cerca de $1.55. A diferença real ainda inclui variações no consumo de tokens, então o método mais confiável é rodar novamente com seus próprios logs reais.
💰 Dica para calcular os custos: a APIYI ainda não disponibilizou o qwen4-max; vamos adicioná-lo o quanto antes. O nome exato do modelo e os preços devem ser consultados na lista de modelos da plataforma apiyi.com. Antes do lançamento, você pode usar o
qwen3.8-maxda plataforma para estabelecer uma linha de base de custos e, quando o novo modelo estiver disponível, comparar diretamente as duas faturas.
Como decidir por cenário se vale trocar para o Qwen4-Max
| Cenário | Desempenho do Qwen4-Max (segundo a própria empresa) | Recomendação |
|---|---|---|
| Agentes de horizonte longo e entregas setoriais (automação de escritório, pesquisa, documentos finais) | 1º em HLAB-Vals e Agents’ Last Exam; 2º em APEX, JobBench e AA-Briefcase; economia de tokens claramente maior | Priorizar a avaliação; o ganho de atualizar do Qwen3.8-Max é o mais evidente |
| Terminal e repositórios de código (agente de shell, build, alterações entre repositórios) | 1º no DeepSWE, mas com vantagem pequena; 5º no Terminal-Bench e 4º no ProgramBench | Para tarefas com foco em operações de terminal, compare com Kimi K3.1 e Opus 5.5 antes de decidir |
| Desenvolvimento web front-end | 6º no ranking público do Code Arena, com 1.750 pontos (Preliminary) | Pode ser uma opção de bom custo-benefício, mas não lidera o ranking |
| Compreensão de gráficos e vídeos, documentos longos multimodais | 4º no Chartography e no Video-Index | Em fluxos com muita leitura de imagens e vídeos, por enquanto não é recomendável usá-lo sozinho |
| Perguntas e respostas em biologia e saúde | 1º no BioMysteryBench; 3º no HealthBench Professional | Pode entrar nos testes, mas precisa de revisão de especialistas da área |
Uma abordagem mais segura é dividir o tráfego: tarefas como agentes de horizonte longo e entrega de documentos ficam com o Qwen4-Max, enquanto tarefas pesadas de terminal e de gráficos/vídeos continuam com os modelos que hoje se saem melhor nessas áreas. Assim, você não precisa migrar todo o tráfego de uma vez e já captura o ganho com economia de tokens.
🎯 Recomendação de seleção: A premissa para dividir o tráfego é conseguir trocar de modelo com o mesmo código. A APIYI apiyi.com oferece uma interface compatível com OpenAI; com uma única chave API, você pode chamar vários modelos de ponta e fazer testes A/B apenas alterando o campo
model.
Primeiros passos com Qwen4-Max
O canal oficial é o QwenCloud API, que oferece suporte a quatro protocolos: OpenAI Chat Completions, Responses, Anthropic Messages e DashScope. Os SDKs existentes da OpenAI ou da Anthropic podem ser integrados diretamente. Ao fazer a integração, observe os pontos abaixo:
- Confirme o modelo: o ID oficial do modelo é
qwen4-max; consulte a página do modelo para confirmar. Oreasoning_effortpadrão éhigh; em testes comparativos, especifique explicitamente o mesmo nível, por exemplo,xhigh. - Reserve espaço para a saída: a saída máxima é de 393K e a cadeia de pensamento máxima é de 262K. Para tarefas longas, defina
max_tokensou o parâmetro correspondente com um valor suficientemente grande; caso contrário, a cadeia de pensamento ocupará toda a cota de saída. - Ative o cache: o preço de acerto do cache implícito é $0.075. Se o comando do sistema for longo e reutilizado com frequência, vale avaliar se compensa usar cache explícito de 5 minutos ou 1 hora; a criação do cache é cobrada separadamente e, se a reutilização for muito baixa, pode não valer a pena.
- Prepare o grupo de controle: após se registrar na APIYI e obter uma chave API, defina
base_urlcomohttps://api.apiyi.com/v1, preenchamodelcomqwen3.8-maxe execute o mesmo lote de tarefas para obter o consumo de tokens e a pontuação do modelo antigo como linha de base. - Troque de modelo depois que o novo modelo for lançado: depois que o qwen4-max estiver disponível na APIYI, basta alterar o campo
modele manter o restante do código inalterado para obter diretamente os dados comparativos entre as gerações nova e antiga.
🚀 Início rápido: novos usuários podem se registrar na APIYI apiyi.com para receber uma cota de teste gratuita, suficiente para executar primeiro a linha de base do
qwen3.8-max; depois, a troca de modelo não exige uma nova integração.
Perguntas frequentes sobre o Qwen4-Max
P1: O que é o Qwen4-Max?
O Qwen4-Max é o modelo principal (flagship) lançado pelo Tongyi Qianwen em 2026-11-16. Ele usa parâmetros de backbone de 2.4T, ativa 71B por token, oferece suporte nativo a entrada visual e tem janela de contexto de 1M. É voltado principalmente para agentes de longa duração e tarefas de entrega setorial.
P2: Qual é a diferença entre o Qwen4-Max e o Qwen3.8-Max?
Nos 16 benchmarks auto-relatados oficialmente, o Qwen4-Max supera o Qwen3.8-Max-0902 em todos eles. No ranking público do Code Arena, fica 74 pontos à frente. Nos preços oficiais, entrada e saída são 25% mais baratas cada, e a leitura de cache é 70% mais barata. Além disso, os dois têm níveis de raciocínio padrão diferentes: `high` e `xhigh`, respectivamente.
P3: Os 16 benchmarks são confiáveis?
Esses números são todos auto-relatados oficialmente, e as pontuações dos concorrentes também foram medidas pela própria Alibaba; no momento, não há reprodução por terceiros. Um sinal externo de referência é o ranking público Code Arena WebDev: no snapshot do ranking final de 2026-11-14, o Qwen4-Max ficou em 6º lugar, mas ainda em status Preliminary, com poucos votos.
P4: Dá para aplicar a “redução de custo de 60%” diretamente ao meu negócio?
Não dá para aplicar diretamente. Esse número vem do cenário oficial Work360, e a redução é maior do que a estimativa baseada apenas em tokens e no preço unitário; a diferença intermediária não foi explicada oficialmente. Sua redução real depende da taxa de acerto de cache, do número de rodadas de chamadas de ferramentas e do nível de raciocínio, então é preciso calcular usando seus próprios logs de tarefas.
P5: É possível chamar o Qwen4-Max via APIYI?
Até 2026-11-16 11:00, o catálogo de modelos da APIYI ainda não inclui o qwen4-max, e vamos disponibilizar o quanto antes. O modelo Qwen flagship atualmente à venda é o `qwen3.8-max`, com preços de $1.65 para entrada, $4.95 para saída e $0.20625 para leitura de cache (unidade: 1M tokens). A disponibilidade e os preços estão sujeitos ao catálogo de modelos em apiyi.com.
P6: Quais são os pontos fracos do Qwen4-Max?
Operação em terminal (5º no Terminal-Bench), construção de programas (4º no ProgramBench), compreensão de gráficos e vídeos (ambos em 4º) e HLE (4º) ficam atrás dos concorrentes de ponta mostrados no mesmo gráfico. Mesmo com melhora na taxa de dupla aprovação de código seguro, ela é de apenas 31.8%. Além disso, o tamanho Max atualmente não tem planos de liberar pesos open source.
Resumo: vale a pena migrar para o Qwen4-Max?
- Posicionamento: modelo flagship com backbone de 2.4T, 71B ativados por token e janela de contexto de 1M, com foco em agentes de longo prazo e entregas para empresas.
- Onde lidera: em 16 benchmarks autodeclarados oficialmente, conquistou 4 primeiros lugares e 4 segundos lugares, concentrados principalmente em benchmarks de agentes e de entregas típicas de trabalho de escritório.
- Onde fica atrás: operações de terminal, build de programas, gráficos, vídeo e HLE ficaram em quarto ou quinto lugar; não dá para um único modelo cobrir todas as tarefas.
- Posição no ranking público: snapshot do ranking final do Code Arena WebDev (2026-11-14), 6º lugar, 1750 pontos, ainda como Preliminary.
- Custo: o preço unitário oficial caiu 25%, a leitura de cache caiu 70% e o consumo de tokens também diminuiu bastante; a queda de 60% precisa ser validada com seus próprios dados.
Se sua carga principal for agentes de longo prazo e entrega de documentos, vale a pena avaliar o Qwen4-Max com prioridade; se for tarefa pesada de terminal ou compreensão de gráficos e vídeo, é melhor continuar distribuindo para os modelos atualmente mais fortes. Antes do lançamento do qwen4-max, você pode usar a interface compatível com OpenAI do APIYI apiyi.com para estabelecer uma linha de base de custo e desempenho com qwen3.8-max; depois que o novo modelo entrar no ar, basta alterar um campo para concluir a comparação.
📚 Materiais de referência
- Post oficial da Qwen no X: anúncio de lançamento do Qwen4-Max
- Link:
x.com/Alibaba_Qwen/status/2122148127520289151 -
Descrição: data de lançamento e canais oficiais disponíveis
-
Blog oficial da Qwen (em chinês): arquitetura, especificações, 16 benchmarks e números de eficiência
- Link:
qwen.ai/blog?id=qwen4-max -
Descrição: a arquitetura, as especificações e os dados de benchmark deste artigo vêm todos deste post
-
Página do modelo no QwenCloud: preço de tabela em dólares
- Link:
qwencloud.com/models/qwen4-max -
Descrição: preços de entrada, saída e cache em dólares / 1M tokens
-
Página do modelo na plataforma 千问AI: preço de tabela em RMB
- Link:
qianwenai.com/models/qwen4-max -
Descrição: preço em RMB / 1M tokens
-
Code Arena WebDev do arena.ai: ranking público
- Link:
arena.ai - Descrição: a referência citada neste artigo é o snapshot do ranking final de 2026-11-14
Autor: equipe técnica da APIYI
Contato técnico: se você quiser saber o andamento da listagem do modelo e as formas de integração, é só falar com a gente pela página inicial do site da APIYI. A documentação está em docs.apiyi.com