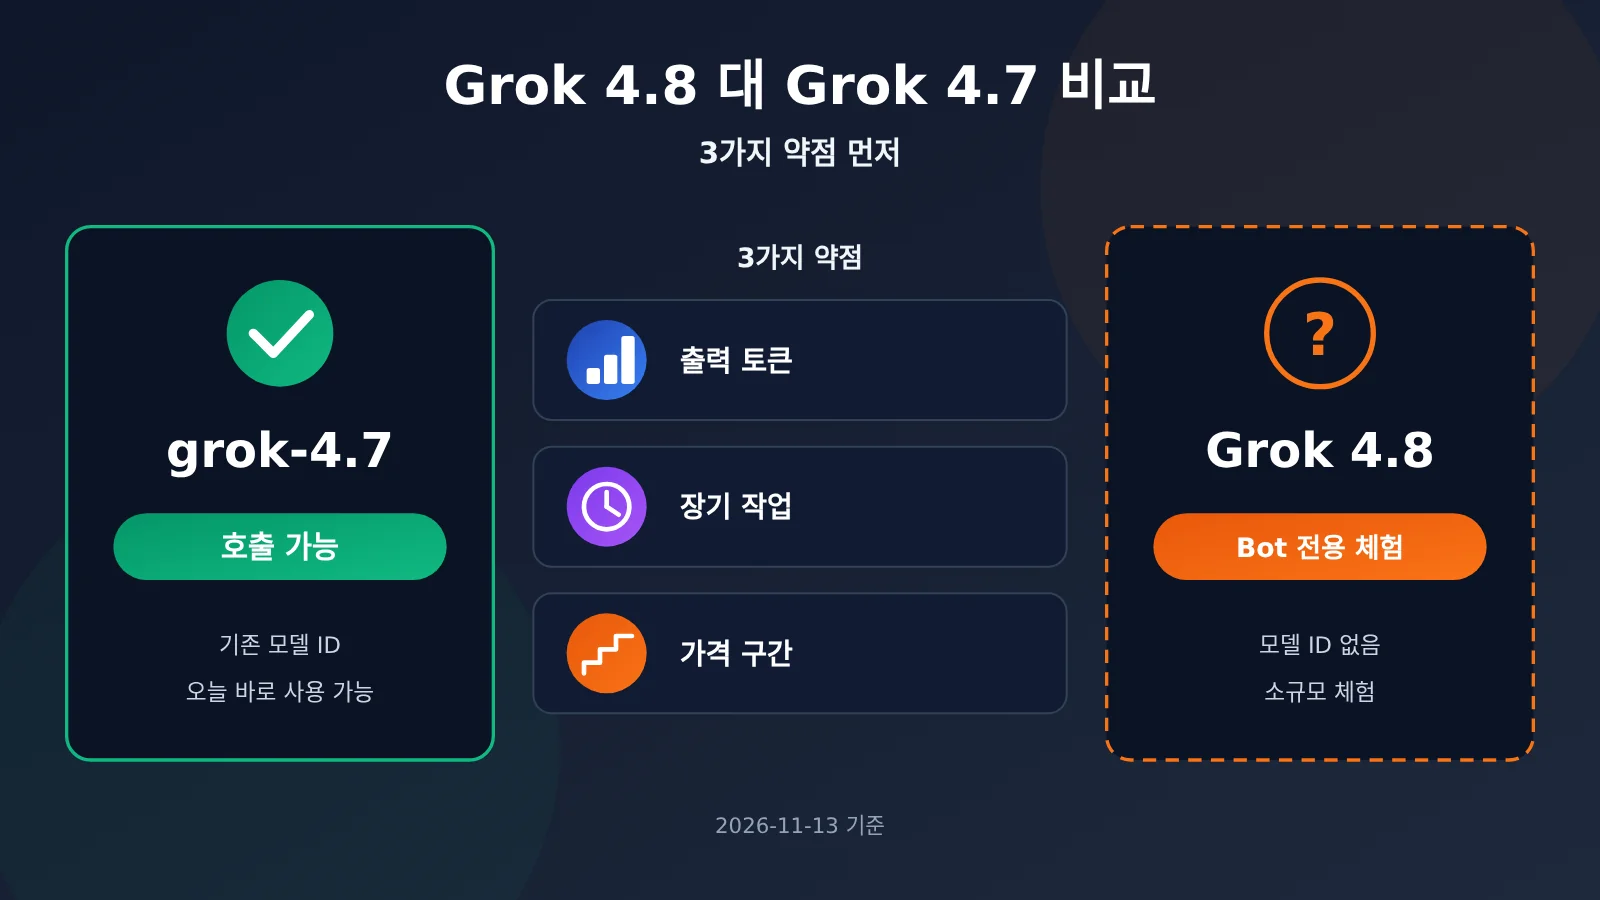
작성자 주: 오늘 API를 호출해야 한다면 계속 grok-4.7을 쓰세요. Grok 4.8은 2026-11-13 기준 아직 모델 ID가 없어요. 이 글에서는 출처별로 Grok 4.7의 3가지 약점을 짚어 보고, 4.8에 이를 보완했다는 증거가 있는지 살펴봐요.
이미 프로덕션에서 grok-4.7을 호출하고 있다면, 요즘 한 가지 고민이 생겼을 거예요. 멈추고 Grok 4.8을 기다려야 하나? 결론부터 말하면, 오늘 API를 호출해야 한다면 grok-4.7을 쓰세요. 2026-11-13 기준 Grok 4.8에는 모델 ID도, 모델 카드도, 리더보드 점수도, 가격도 없어요. 머스크가 말한 “이번 주”는 Grok Bot 사용자 대상의 소규모 체험(soft rollout)일 뿐, API 공개가 아니에요.
이 글은 “새 버전이 무조건 더 강하다”는 예고문이 아니에요. Grok 4.7 공개 데이터에서 실제로 대조할 수 있는 세 가지 약점만 살펴봐요. 각 항목마다 출처를 밝혀요. 공식 자체 발표인지, 제3자 리더보드인지, 아니면 머스크의 발언인지. 그다음 Grok 4.8에 이를 보완했다는 증거가 현재 있는지 확인해요.
핵심 가치: 이 글을 다 읽고 나면 Grok 4.7의 약점이 구체적으로 어디인지, 누구의 데이터에서 나온 것인지, 그리고 Grok 4.8이 출시되기 전에 20만 token 구간별로 비용을 어떻게 통제할지 알게 될 거예요.
Grok 4.8 vs Grok 4.7: 오늘은 어떻게 선택할까
이번 비교는 흔히 보는 신·구 버전 비교와는 달라요. Grok 4.8은 현재 X에 올라온 머스크의 몇 마디 말뿐이고, 검증 가능한 점수는 전혀 없어요. 그래서 “비교”의 실제 의미는 이거예요: Grok 4.7에는 공개 데이터로 기록된 약점이 무엇이며, Grok 4.8의 알려진 변경 사항이 그 약점을 실제로 보완할 수 있는가.
| 상황 | 권장 | 이유 |
|---|---|---|
| 이번 주에 출시하거나 인터페이스를 수정해야 함 | grok-4.7 사용 | 플랫폼 모델 목록에는 grok-4.7만 있음 |
| 장기적인 모델 선택을 평가 중 | 우선 grok-4.7로 베이스라인 실행 | 4.8은 벤치마크가 없어 횡적 비교가 불가능 |
| 4.8을 가장 먼저 시험해 보고 싶음 | 플랫폼 모델 목록 확인 | Bot 소프트 롤아웃은 API 사용 가능을 의미하지 않음 |
| 긴 작업 요구 수준이 매우 높음 | 4.8에 기대를 걸지 말 것 | 긴 작업 격차가 좁혀졌다는 증거가 없음 |
한 가지 짚고 넘어갈게요. “Bot users”는 하드웨어 로봇이 아니라 Grok Bot 사용자를 뜻해요. “soft rollout”은 소규모로 점진 배포하는 것이지, 개발자에게 개방된 인터페이스가 아니에요. 이걸 “이미 교체 가능한 모델 ID”로 받아들이면 호출 오류가 바로 발생해요.
Grok 4.8과 Grok 4.7의 핵심 차이: 3가지 약점의 출처
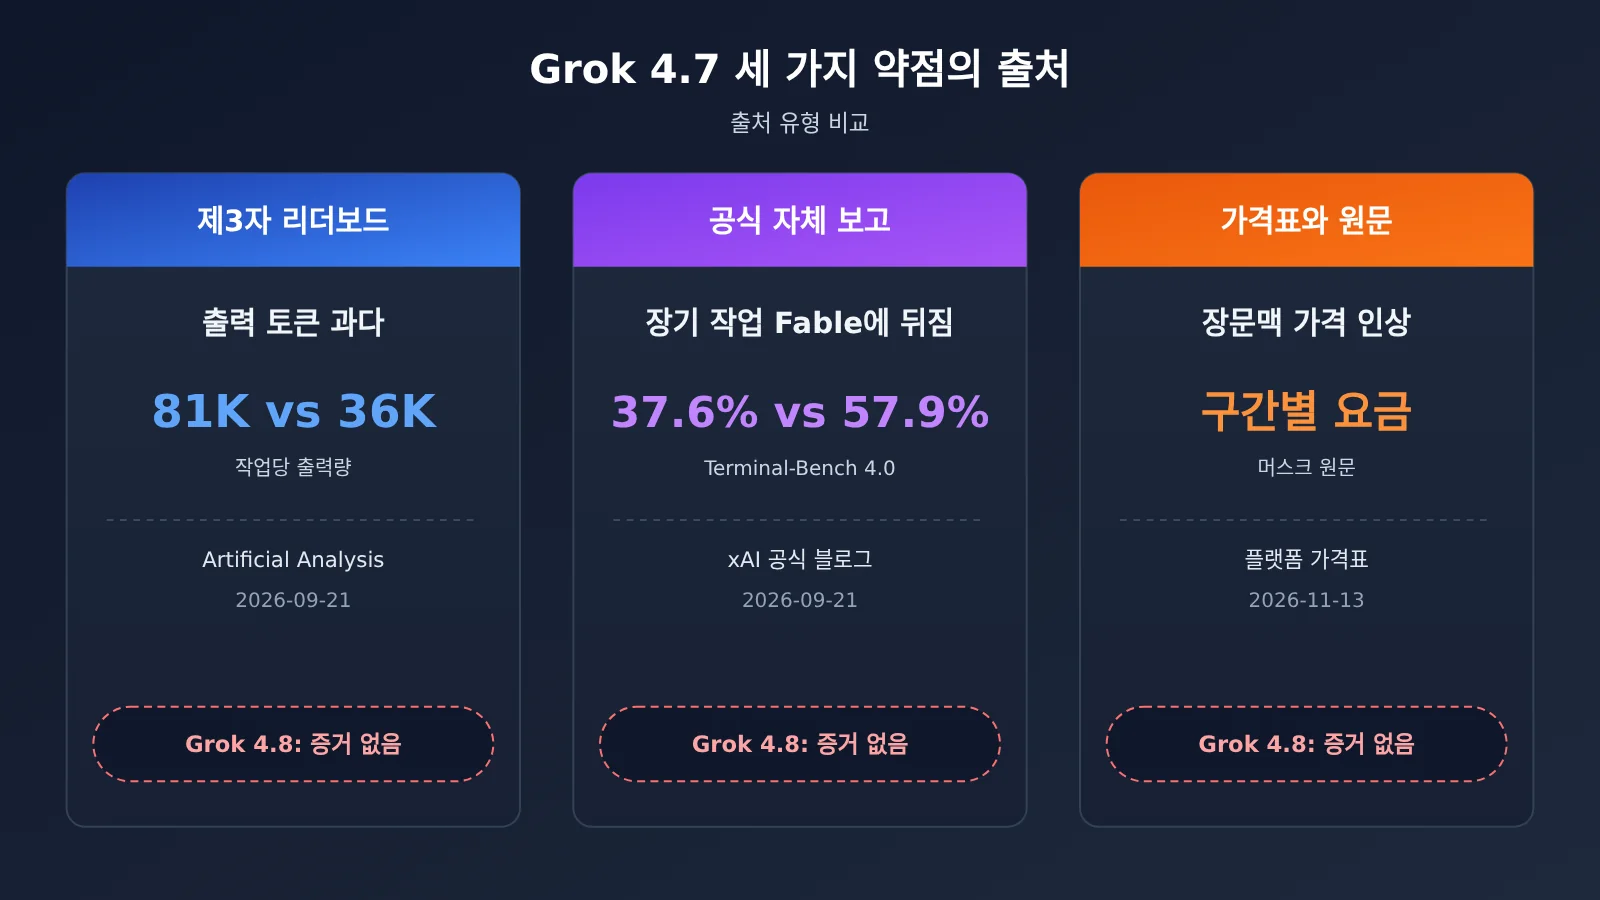
아래 표는 세 가지 약점의 출처 유형을 먼저 정리한 것이에요. 이후 내용은 이 순서를 그대로 따라갑니다.
| 약점 | 출처 유형 | 출처 날짜 | Grok 4.8에 보완 증거가 있는가 |
|---|---|---|---|
| 출력 토큰이 많음 | 제3자 리더보드(Artificial Analysis) | 2026-09-21 | 없음 |
| 수 시간짜리 장기 작업에서 Fable에 뒤짐 | 공식 자체 발표(xAI 블로그 표) | 2026-09-21 | 없음 |
| 긴 컨텍스트 구간별 가격 인상 + 머스크가 기본 성능을 인정하지 않음 | 플랫폼 가격표 + 머스크 발언 원문 | 2026-11-13 / 2026-11-10 | 없음 |
약점 1: Grok 4.7의 출력 토큰이 많음(제3자 리더보드)
이 부분의 출처는 Artificial Analysis가 2026-09-21에 공개한 Grok 4.7 평가예요. 제3자 리더보드이며, 공식 데이터도, 이 글 작성자의 테스트도 아니에요. 이들은 xhigh 설정으로 테스트했고, Grok 4.7의 지능 지수는 46으로 Grok 4.6보다 2점 높았어요. 점수는 올랐지만, 그 대가로 출력 토큰이 눈에 띄게 늘었어요.
같은 평가에 나온 출력량 비교는 다음과 같아요. 두 Grok 4.6 수치는 서로 다른 설정에 해당하므로 하나로 합치면 안 돼요.
- Grok 4.7(xhigh): 지능 지수 과제당 약
81,000출력 토큰 - Grok 4.6(high): 약
36,000출력 토큰 - Grok 4.6(xhigh): 약
38,000출력 토큰. 평가에서는 4.7이 이보다 두 배 이상이라고 해요 - GPT-6 Astra(max): 약
27,000출력 토큰
규모를 체감해 보려면 공식 출력 가격 $6 / 1M tokens로 대략 계산할 수 있어요. 8만 1천 출력은 약 $0.49, 3만 6천은 약 $0.22예요. 이건 어디까지나 리더보드 과제 기준의 환산 방식으로, “같은 문제에 비용이 어디에 쓰이는지”를 보여 주기 위한 것이지, 어떤 플랫폼의 실제 청구서도 아니에요.
Artificial Analysis는 동시에 Grok 4.7의 컨텍스트 윈도우가 500K이고, 가격 표시가 $2 / $6, 캐시 적중 시 $0.50으로 모두 4.6과 같다고 적었어요. 즉, 단가는 오르지 않았지만 과제마다 내놓는 토큰이 늘어서 과제당 비용은 실제로 상승한 셈이에요.
약점 2: Grok 4.7은 수 시간 규모 장기 작업에서 여전히 Fable에 뒤처져요(공식 자체 발표)
이 부분의 출처는 xAI 공식 블로그(2026-09-21)의 비교표이고, 공식 자체 발표예요. 표 머리글의 네 열은 차례로 Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max, Fable 5.1 Max예요. 장기 작업 격차를 가장 잘 드러내는 항목은 아래 두 가지예요.
- Terminal-Bench 4.0: Grok 4.7
37.6%, Fable 5.1 Max57.9%(Grok 4.6은20.3%, GPT-5.6 Sol은37.3%) - CursorBench 4.0: Grok 4.7
46.3%, Fable 5.1 Max51.8%(Grok 4.6은40.4%, GPT-5.6 Sol은41.7%)
하지만 공식 표가 ‘전면 열세’인 건 아니에요. Grok 4.7의 4.6 대비 향상은 실질적이고, 두 가지 전문 벤치마크에서는 1위예요.
- EEBench: Grok 4.7
64.0%로, 4.6의53.0%, GPT-5.6 Sol의39.4%, Fable 5.1의56.4%보다 높아요 - Harvey Legal Agent Benchmark: Grok 4.7
19.6%로,15.8%/2.5%/6.7%보다 높아요 - DeepSWE v1.1: Grok 4.7
71.0%. 공식 표에는 xhigh가 아니라 high effort로 표기돼 있으며, GPT-5.6 Sol의72.7%보다는 약간 낮아요 - AA Briefcase v1.1: Grok 4.7
1657로, Fable의1678보다 약간 낮아요 - HealthBench Professional: Grok 4.7
56.7%로, GPT-5.6 Sol의60.5%와 Fable의62.1%보다 낮아요
| 공식 표 벤치마크 | Grok 4.6 대비 | GPT-5.6 Sol 대비 | Fable 5.1 대비 |
|---|---|---|---|
| Terminal-Bench 4.0 | 뚜렷이 높음 | 거의 비슷하거나 약간 높음 | 격차 뚜렷 |
| CursorBench 4.0 | 높음 | 높음 | 낮음 |
| DeepSWE v1.1 | 높음 | 약간 낮음 | 약간 높음 |
| EEBench | 높음 | 높음 | 높음 |
| Harvey Legal Agent | 높음 | 높음 | 높음 |
| HealthBench Professional | 높음 | 낮음 | 낮음 |
서드파티 리더보드에는 별도 데이터가 또 있는데, 따로 표시해야 해요. Artificial Analysis의 평가에 따르면 Grok 4.6 대비 Grok 4.7은 Terminal-Bench 4.0에서 4.5포인트 높고, GDP.pdf에서 3.0포인트 높아요. 반면 AA-LCR에서는 3.7포인트 낮고, AutomationBench-AA에서는 1.1포인트 낮아요. 여기서 말하는 ‘+4.5포인트’는 공식 표의 37.6% 대 20.3%와 같은 절대 점수 체계가 아니니, 혼용하면 안 돼요.
약점 3: Grok 4.7의 가격 구간과 머스크의 실제 발언(가격 + 발언)
세 번째 약점은 두 부분이에요. 하나는 긴 컨텍스트의 가격이고, 다른 하나는 머스크 본인의 4.7에 대한 태도예요. 먼저 가격부터 볼게요. 플랫폼 모델 총표와 가격 API는 20만 토큰 초과 구간의 기재가 완전히 같지는 않아요:
| 가격 항목 | 플랫폼 모델 총표 | 가격 API billing_expr |
|---|---|---|
| ≤ 20만 토큰 입력 / 출력 / 캐시 읽기 | 명시됨 | 명시됨, 총표와 일치 |
| 20만 초과 입력 | 명시됨 | 명시됨, 총표와 일치 |
| 20만 초과 출력 | 별도 명시 없음 | 명시됨 |
| 20만 초과 캐시 읽기 | 별도 명시 없음 | 명시됨 |
구체적인 숫자는 아래와 같고, 가격 데이터 기준일은 2026-11-13이며, 단위는 모두 1M tokens당이에요:
- 저가 구간(0–200,000 tokens): 입력
$2, 출력$6, 캐시 읽기$0.5이며, 총표와 가격 API가 일치해요 - 고가 구간(200,001–500,000 tokens) 입력:
$4이며, 총표와 가격 API가 일치해요 - 고가 구간 출력: 가격 API에는
$12로 되어 있지만, 총표의 구간표에는 적혀 있지 않아요 - 고가 구간 캐시 읽기: 가격 API에는
$1로 되어 있지만, 총표의 구간표에는 적혀 있지 않아요
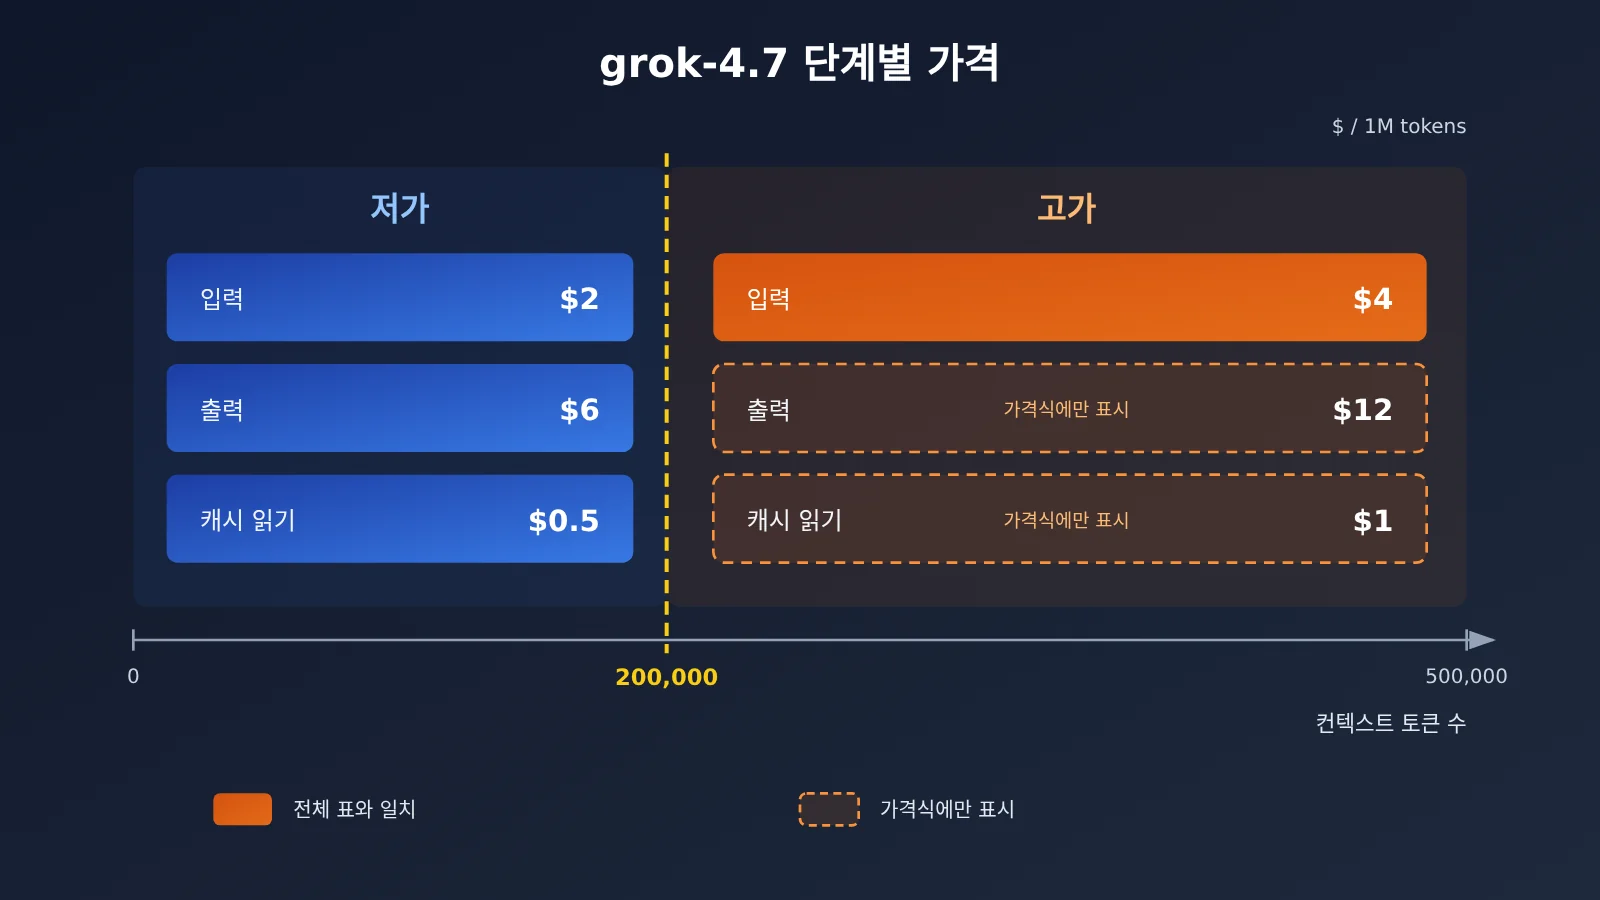
위 그림의 가격 정보는 APIYI(apiyi.com)의 가격 API와 모델 총표에서 가져왔고, 확인 날짜는 2026-11-13이며, 플랫폼 모델 목록을 기준으로 해요.
이제 머스크의 실제 발언을 볼게요. 2026-11-10 17:35, 머스크는 X에서 Grok 4.8이 “4.7과 전혀 닮지 않을 것이다(다행히도). 아직 놀랍지도 않다”라고 말했어요. 같은 날 18:22에는 답글에서 “그렇게 좋지는 않다. Opus 5.5는 걸작이다”라고 덧붙였는데, 이는 4.8이 아직 Opus 5.5만 못하다는 뜻이에요. 그는 동시에 Grok 5가 두세 달 안에 Opus 5.5를 넘어설 수 있다고 내다봤어요.
이건 태도이지 Grok 4.8의 점수는 아니에요. 한 창업자가 새 버전이 “4.7과 닮지 않아서 다행”이라고 말한 것은, 그가 4.7의 기반을 인정하지 않는다는 뜻일 뿐이에요. 4.8이 위의 세 가지 약점에서 이미 개선됐다고 결론 내릴 수는 없어요.
Grok 4.8, 이 3가지 약점을 메울 수 있을까
확실히 말할 수 있는 건 머스크가 올린 원문 게시물에 담긴 내용뿐이에요. 그는 JAX/SGLang을 버리고 C/C++로 강화학습(RL)과 추론 스택을 처음부터 다시 작성했다고 언급했어요. 사전학습은 완료됐고, SFT 데이터는 대대적으로 정리했으며, 4.8은 현재 RL 단계로 “평가가 오르기 시작하고 있다(evals are starting to climb)”고 했어요. 게시물에는 어떤 벤치마크 이름이나 점수도 없고, 파라미터 수도 없어요.
이 정보를 세 가지 약점과 대조해 보면, 결론은 상당히 보수적이에요:
- 출력 토큰이 많은 편: RL 단계가 실제로 출력 길이에 영향을 줄 수는 있지만, 그는 토큰 효율성에 대해서는 언급하지 않았어요.
- 긴 작업에서 Fable에 뒤처짐: Terminal-Bench나 CursorBench는 언급되지 않았고, 긴 작업 관련 데이터도 전혀 없어요.
- 20만 토큰 이상의 가격: 가격 정보가 전혀 없고, 4.8은 어떤 가격표에도 등재되지 않았어요.
그래서 추측은 “RL과 추론 스택을 다시 작성하고 SFT 데이터를 정리했다”는 수준에 머물러야 해요. 현재로서는 위 세 가지가 이미 메워졌다는 증거가 없어요. 4.8에 모델 카드와 제3자 벤치마크가 나온 뒤에 항목별로 대조해야 의미가 있어요.
지금 grok-4.7을 호출할 때, 20만 토큰 가격 구간은 어떻게 나뉠까
4.8이 출시되기 전에는 grok-4.7의 비용을 잘 통제하는 게 더 현실적인 방법이에요. 핵심은 20만 토큰이라는 기준선이에요: 입력이 이 선을 넘는 순간 입력 단가가 곧바로 두 배가 되고, 가격 계산식에 따라 출력과 캐시 읽기 단가도 두 배가 돼요. 아래는 바로 적용할 수 있는 연동 정보와 가격 구간별 제안이에요:
- 모델 ID:
grok-4.7, 엔드포인트는 chat이고, 그룹에는CodexResponses,Default,SVIP가 포함돼요 - API 주소: OpenAI 호환 형식이며, base_url에
https://api.apiyi.com/v1을 넣고 model을grok-4.7로 설정하면 돼요 - 저가 구간 제어: 단일 요청의 컨텍스트를 가능한 한
200,000tokens 이내로 유지하고, 문서 전체를 밀어 넣는 대신 요약이나 검색 청크로 대체할 수 있어요 - 고가 구간 예산: 정말 긴 컨텍스트가 필요할 때는 입력
$4, 출력$12, 캐시 읽기$1로 예상하고, 전체 요금표에 고가 구간 출력 단가가 빠져 있다는 불일치도 주의하세요 - 출력 길이: 첫 번째 약점을 고려해 필요한 작업에 max_tokens를 설정하고, 높은 추론 단계에서 출력이 통제 불능이 되는 걸 피하세요
모델과 가격은 플랫폼의 모델 목록을 기준으로 하며, 최신 정보는 docs.apiyi.com/models에서 확인할 수 있어요. 공식 블로그에서는 Grok 4.7에 fast 변형이 있다고도 언급했는데, 출력 속도는 약 두 배, 가격도 약 두 배예요. 다만 플랫폼 전체 요금표에는 별도의 fast 모델 ID가 없으니, 호출할 때 임의로 만들어 쓰면 안 돼요.
🚀 빠른 시작: grok-4.8이 출시되면 APIYI(apiyi.com)가 이 모델을 최대한 빨리 등록할 거예요. 그전까지는 같은 API 키로 grok-4.7의 기준선을 먼저 확보해 두고, 4.8을 사용할 수 있게 되면 model 파라미터 하나만 바꿔 비교하면 돼요.
Grok 4.8 vs Grok 4.7 시나리오별 추천
Grok 4.7을 계속 쓰는 게 좋은 시나리오
- 법률·엔지니어링 같은 전문 작업: 공식 표에서 EEBench와 Harvey Legal Agent 두 항목 모두 Grok 4.7이 1위예요. 이런 작업이라면 굳이 기다릴 이유가 없어요.
- 컨텍스트를 20만 이내로 통제할 수 있는 업무: 안정적으로 낮은 구간 요금을 유지할 수 있고, 단가도 4.6과 같아요.
- 당장 출시해야 하는 프로젝트: grok-4.7이 현재 유일하게 호출 가능한 버전이에요.
Grok 4.8을 계속 지켜볼 만한 시나리오
- 여러 시간짜리 Agent / 터미널 장시간 작업: Terminal-Bench 4.0과 Fable 5.1의 격차가 뚜렷하니, 다른 모델도 대안으로 함께 평가해 보세요.
- 출력 토큰 비용에 민감한 배치 작업: 서드파티 리더보드에 따르면 4.7은 출력이 다소 긴 편이에요. 4.8이 이 부분을 개선한다면 비용이 바로 줄겠지만, 아직 근거는 없어요.
- 20만 이상 컨텍스트에 크게 의존하는 애플리케이션: 상위 구간 요금이 두 배로 뛰니, 4.8이 출시된 뒤 과금 방식을 주목해 볼 만해요.
Grok 4.8 vs Grok 4.7 의사결정 가이드
| 관심 포인트 | 지금 할 일 | 언제 재평가할까 |
|---|---|---|
| 출시 안정성 | grok-4.7 사용 | 4.8이 플랫폼 모델 목록에 나타날 때 |
| 작업당 비용 | 컨텍스트와 출력 길이 관리 | 4.8의 서드파티 토큰 사용량 데이터가 나올 때 |
| 장시간 작업 성능 | 대안 모델을 병행 평가 | 4.8의 Terminal-Bench 등 점수가 공개될 때 |
| 가격 투명성 | 가격표 API를 기준으로 예산 수립 | 플랫폼 종합표에 상위 구간 출력 가격이 채워질 때 |
💡 선택 제안: 어떤 버전을 고를지는 여러분의 작업이 장시간 작업인지, 20만 토큰을 자주 넘는지에 달려 있어요. APIYI apiyi.com에서 동일한 인터페이스로 직접 샘플을 돌려 본 뒤, 장시간 작업을 다른 모델로 옮길지 결정하시길 권해요.
자주 묻는 질문 FAQ
Q1: Grok 4.8은 지금 API로 호출할 수 있나요?
아니요. 2026-11-13 기준으로 Grok 4.8에는 모델 ID가 없어요. 플랫폼 모델 총표와 가격 인터페이스 어디를 봐도 grok-4.7만 있죠. 머스크가 말한 이번 주 소프트 런칭은 Grok Bot 사용자만 대상으로 한 거예요.
Q2: Grok 4.8과 Grok 4.7, 대체 누가 더 강한가요?
지금은 판단할 수 없어요. Grok 4.8은 공개된 리더보드나 점수가 전혀 없고, 머스크는 “평가 점수가 올라가는 중”, “아직 놀랍지는 않다”, “Opus 5.5보다는 못하다” 정도만 말했어요. 이건 태도일 뿐, 비교 가능한 데이터가 아니에요.
Q3: Grok 4.7의 출력 토큰이 많다는 이야기는 어디서 나온 건가요?
Artificial Analysis가 2026-09-21에 진행한 제3자 평가에서 나왔어요. 테스트 등급은 xhigh였고, 작업당 약 8.1만 출력 토큰이었습니다. 4.6 high의 3.6만, 4.6 xhigh의 3.8만과 비교되는 수치죠. 공식 데이터는 아니에요.
Q4: Grok 4.7이 Grok 4.6보다 전반적으로 나빠진 건가요?
아니요. 공식 표에서 Grok 4.7은 Terminal-Bench, CursorBench, EEEBench 등 여러 항목에서 4.6보다 높아요. 제3자 리더보드에서는 AA-LCR이 3.7포인트, AutomationBench-AA가 1.1포인트 낮게 나오는데, 이는 일부 항목의 하락일 뿐이에요.
Q5: 지금 당장 grok-4.7을 호출하려면 어떻게 하나요?
APIYI(apiyi.com)에서 가입하고 API 키를 발급받으면 돼요. 신규 사용자에게는 무료 테스트 크레딧이 있어요. OpenAI 호환 SDK를 사용하고, base_url에는 플랫폼 인터페이스 주소를, model에는 grok-4.7을 넣으면 됩니다.
Q6: 20만 토큰 초과 출력은 도대체 어떤 기준으로 과금되나요?
가격 표현식에는 출력 $12, 캐시 읽기 $1로 적혀 있어요. 그런데 총표 계단에는 고급 입력 $4만 적혀 있고 고급 출력은 따로 명시되어 있지 않죠. 두 곳의 기록이 완전히 일치하지는 않으니, 예산을 잡을 때는 가격 표현식을 기준으로 보수적으로 추정하고, 최종적으로는 플랫폼 모델 목록을 기준으로 삼는 걸 권장해요.
Q7: Grok 4.8이 상장되면 어떻게 마이그레이션해야 하나요?
플랫폼 실시간 동향에는 아직 Grok 4.8 상장 기록이 없어요. 상장된 뒤에는 보통 model 파라미터만 교체하면 되는데, 먼저 동일한 샘플 배치로 출력 토큰, 장기 작업 성공률, 구간별 비용을 비교한 다음 트래픽을 전환하는 걸 권장해요.
Grok 4.8과 Grok 4.7 비교 핵심 요점 Key Takeaways
- 오늘의 선택: API를 호출하려면 grok-4.7을 사용하세요. Grok 4.8은 아직 모델 ID가 없습니다.
- 약점 1(제3자 리더보드): xhigh에서 작업당 약 8.1만 개의 출력 토큰으로, 다소 깁니다.
- 약점 2(공식 자체 보고): Terminal-Bench와 CursorBench에서는 여전히 Fable 5.1에 뒤처집니다.
- 전면적 열세는 아님: EEBench, Harvey 두 항목에서 Grok 4.7이 1위입니다.
- 약점 3(가격표 + 발언 원문): 20만 토큰 초과 입력은 두 배로 오르고, 머스크는 4.7의 기반을 인정하지 않습니다.
- 4.8의 알려진 변경 사항: RL과 추론 스택 재작성, SFT 정리. 세 가지 약점을 보완했다는 증거는 없습니다.
- 시작 방법: APIYI apiyi.com을 통해 먼저 grok-4.7 기준선을 실행하고, 4.8이 출시되면 바로 비교하세요.
요약
Grok 4.8과 Grok 4.7 비교의 핵심 포인트:
- 가용성: 2026-11-13 기준으로 grok-4.7만 호출할 수 있습니다. Bot의 소프트 출시가 API 개방을 의미하지는 않습니다.
- 세 가지 약점: 출력 토큰이 많음(제3자 리더보드), 긴 작업에서 Fable에 뒤처짐(공식 자체 보고), 긴 컨텍스트 가격 인상과 창업자 발언(가격표와 발언 원문). 각기 출처가 다릅니다.
- 4.8의 증거: 현재는 RL과 추론 스택 재작성, SFT 정리라는 설명뿐이며, 점수나 가격, 모델 카드는 없습니다.
멈춰서 기다리기보다는 먼저 grok-4.7의 컨텍스트 구간과 출력 길이를 잘 관리하고, 4.8에 검증 가능한 데이터가 생기면 항목별로 비교하는 편이 좋습니다. APIYI apiyi.com을 통해 통합 인터페이스로 grok-4.7이 여러분의 비즈니스에서 어떤 성능을 내는지 먼저 검증해, 이후 전환을 위한 기준선을 마련하길 권합니다.
📚 참고 자료
- xAI 공식 블로그 – Grok 4.7 출시: 공식에서 자체 보고한 벤치마크 비교표와 가격 정책
- 링크:
x.ai/news/grok-4-7 -
설명: Terminal-Bench 4.0, CursorBench 4.0, EEBench 등의 데이터 출처
-
Artificial Analysis – Grok 4.7 벤치마크: 서드파티 리더보드, 출력 토큰 사용량 포함
- 링크:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
설명: 지능 지수, 출력 토큰 대조, AA-LCR 등 항목의 변화
-
머스크 X 게시물(2026-11-10): Grok 4.8 진행 상황에 관한 원문 발언
- 링크:
x.com/elonmusk/status/2120088070443655190 -
설명: RL 및 추론 스택 재작성, SFT 정리, Bot 소프트 런칭
-
머스크 X 답글(2026-11-10): 4.8과 Opus 5.5 비교에 대한 입장 표명
- 링크:
x.com/elonmusk/status/2120099798078656909 -
설명: “Not as good”의 출처
-
APIYI 모델 전체 목록: grok-4.7 모델, 그룹 및 계층별 가격
- 링크:
docs.apiyi.com/models - 설명: 모델과 가격은 이를 기준으로 하며, 확인 날짜 2026-11-13
저자: APIYI 기술 팀
기술 교류: APIYI 웹사이트 첫 페이지에서 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.