
요약: Google Decisions API는 고정 옵션에 대해 직접 점수를 매기고 텍스트를 생성하지 않아요. 이 글에서는 공개 가격을 기준으로 분류, 검토, 라우팅 작업에서의 비용을 계산하고, 공식 및 제3자 데이터를 함께 살펴 적용 범위를 설명해요.
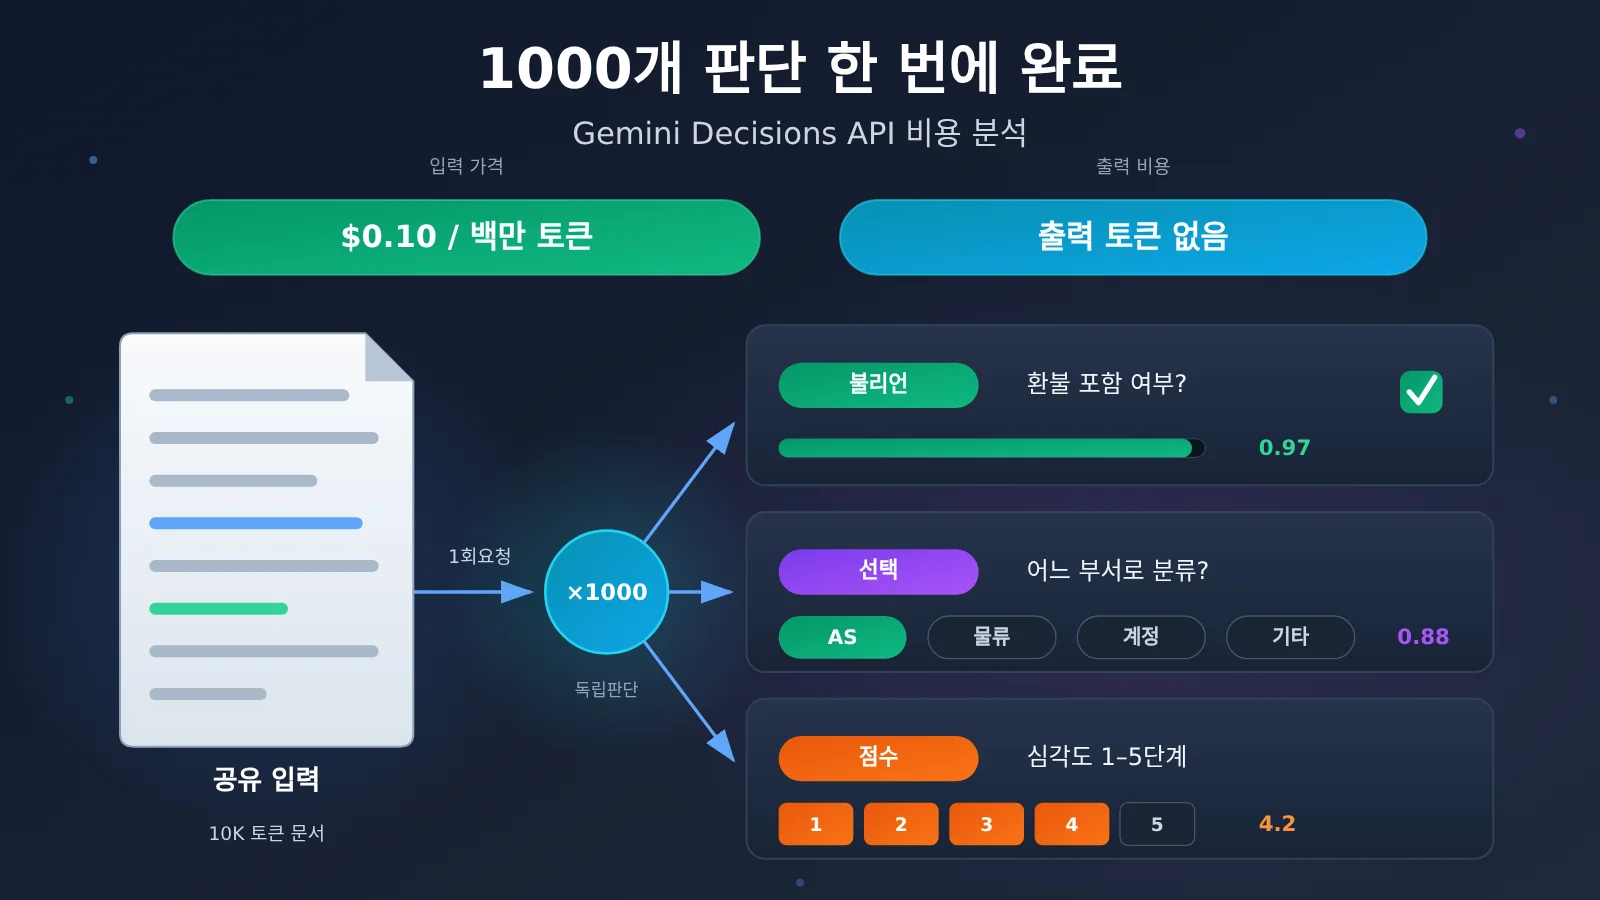
결론부터 말하면: Google은 2026년 11월 11일 Gemini Decisions API(모델 ID gemini-decision-1)를 발표했어요. 이 API는 한 번의 요청으로 동일한 입력에 대해 1~1,000개의 독립 판단을 수행할 수 있고, 입력 가격은 백만 토큰당 0.10달러이며 생성형 출력 토큰 비용은 없어요. 공개 가격을 기준으로 계산하면, 동일한 10K 토큰 문서에서 1,000개 규칙을 검사할 때 비용은 Gemini 3.5 Flash-Lite의 약 1/20로, 이론상 94.9% 절감돼요. 1,000개 메시지를 각각 한 번씩 분류할 때는 이론상 73.1% 절감돼요. Google 공식 테스트에서 제시한 비용 우위는 약 4.7배예요. 제3자 단일 문제 실측에서는 이 우위가 약 1.5배였어요. 분류, 검토, 라우팅만 수행하고 답을 미리 고정 옵션으로 한정할 수 있는 작업에 비용 절감 목적으로 가장 적합해요.
이어서 이 인터페이스의 작동 방식과 세 가지 판단 유형을 먼저 설명하고, 재계산 가능한 공식으로 세 가지 대표 업무의 비용을 산출한 뒤, 공식 “약 5배”와 제3자 실측 사이의 차이를 설명할게요. 그다음 Google이 공개한 속도 데이터와 Artificial Analysis의 독립 평가를 비교해 정확도가 프로덕션 요구 사항을 충족하는지 논의하고, 마지막으로 최소 호출 예시, 모델 선택 표, 출시 전 비용 점검 체크리스트를 제시할게요.
To Know: 용어 사전
| 용어 | 설명 |
|---|---|
| Decisions API | Google이 내놓은 판단 인터페이스로, 고정된 옵션에 대한 결과와 확률을 바로 내놓아요. |
| Gemini Decision 1 | 이 인터페이스를 지원하는 전용 모델이며, 모델 ID는 gemini-decision-1이에요. |
| 토큰 | 모델 처리와 과금의 기본 단위로, 텍스트와 이미지 등이 모두 토큰으로 환산돼요. |
| 공유 입력(Shared Input) | 한 번의 요청에서 모든 판단이 함께 쓰는 입력 내용이에요. |
| 폐쇄형 판단(Closed-set Decision) | 답변 범위가 미리 한정된 판단으로, “예/아니요”나 “A/B/C 중 하나”처럼요. |
noul |
이진 판단으로, “Yes”일 확률을 반환해요. |
choice |
미리 정해진 2–255개 옵션 중 하나를 선택해요. |
score |
미리 정의된 순서형 등급에 따라 점수를 매기고, 결과는 가중 기대값이에요. |
| 신뢰도(Confidence) | 모델이 선택한 결과가 맞을 것이라는 확률 추정치예요. |
| 단일 순방향 패스(Single Forward Pass) | 모델이 한 번의 계산으로 각 옵션 점수를 내놓고, 텍스트를 한 글자씩 생성하지 않아요. |
| 컨텍스트 윈도우(Context Window) | 한 번의 요청에 담을 수 있는 전체 내용량이며, 이 모델은 262,144 토큰이에요. |
| TPM / RPM | 분당 처리 가능한 토큰 수 / 요청 수로, 처리량 상한이에요. |
1. Google이 공개한 것: Gemini Decisions API는 판단 질문 전용
1.1 Gemini Decision 1과 기존 생성형 모델의 차이
Gemini Decisions API는 2026년 11월 11일 Gemini Developer API v1beta를 통해 공개됐어요. REST 엔드포인트는 POST https://generativelanguage.googleapis.com/v1beta/decisions예요. 핵심 기능은 미리 정의된 옵션에 대해 확률 판단을 하고, 판단 결과, 각 옵션의 확률, 신뢰도, 토큰 사용량을 반환하는 거예요. 입력은 텍스트, 이미지, 오디오, 비디오, PDF를 지원해요.
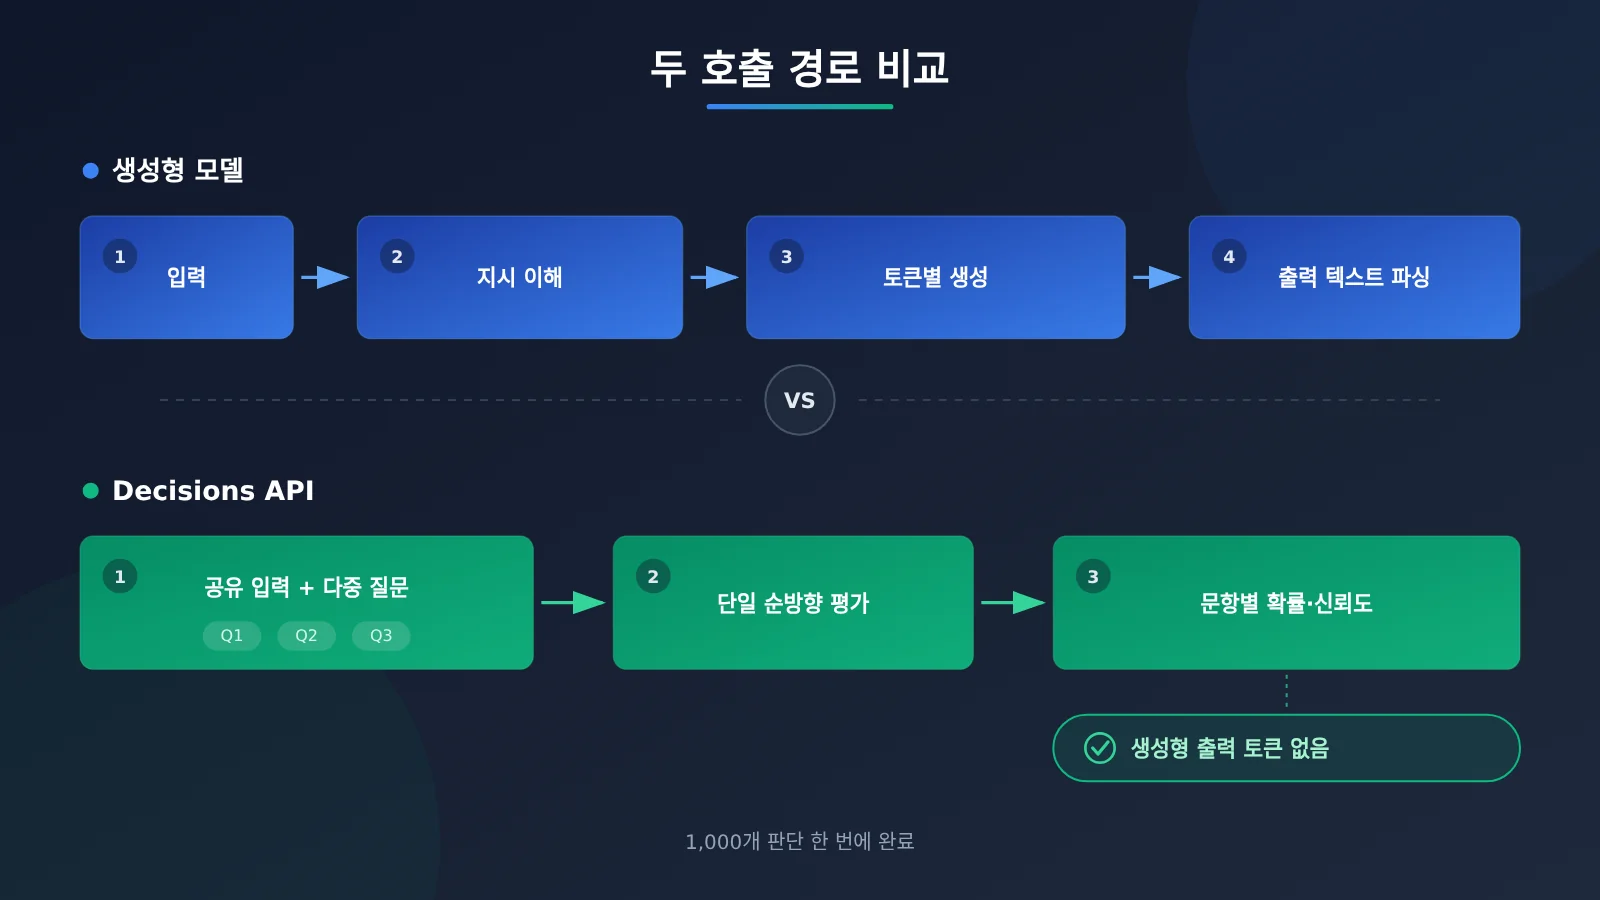
기존 생성형 모델이 분류 작업을 처리하는 흐름은 이래요. 내용을 읽고, 지시를 이해한 다음, 토큰을 하나씩 생성해 답변을 만들고, 개발자가 그 답변을 다시 파싱해야 하죠. Decisions API는 이 흐름을 바꿔서 공유 내용을 읽은 뒤, 각 질문의 사전 정의된 옵션에 바로 점수를 매겨요. 분류, 검토, 라우팅 같은 작업에는 라벨 하나나 “예/아니요” 하나만 있으면 충분해요. 긴 답변을 생성하면 출력 비용을 차지할 뿐 아니라 응답도 느려지죠. 이 단계를 없애는 것만으로 비용과 지연을 줄일 수 있다는 점이 이 API의 핵심이에요.
1.2 Decisions API의 세 가지 판단 방식이 다루는 작업
고객센터 메시지 하나를 예로 들어볼게요. “지난주에 산 이어폰 왼쪽에서 소리가 안 나는데, 환불 신청한 지 사흘째 아무도 응대를 안 해줘요. 지금 처리 안 하면 플랫폼에 민원 넣을 거예요.” 이 메시지 하나에 대해 같은 요청 안에서 서로 독립적인 질문 세 개를 동시에 던질 수 있어요.
| 판단 유형 | 예시 질문 | 반환 내용 | 대표 작업 |
|---|---|---|---|
noul |
이 메시지가 환불과 관련 있나요? | “Yes”일 확률, 예: 0.97 | 위반 여부, 가격 언급 여부, 상위 검토 필요 여부 |
choice |
어느 부서로 보내야 하나요: 애프터서비스 / 물류 / 계정 / 기타? | “애프터서비스” 선택 및 각 옵션 확률 | 티켓 라우팅, 문서 분류, 에이전트 도구 선택 |
score |
불만 심각도 1–5등급 중 몇 점인가요? | 각 등급 확률로 계산한 가중 기대값, 예: 4.2 | 관련성, 심각도, 리드 우선순위 점수화 |
choice는 2–255개 옵션을, score는 2–255개 등급을 지원해요. score는 각 등급 확률로 계산한 기대값을 반환하기 때문에, 평가 문장에서 점수를 추출할 필요 없이 바로 정렬하거나 임계값을 설정할 수 있어요.
2 Google Decisions API 비용은 얼마나 절감할 수 있을까: 세 가지 비즈니스 시나리오별 계산
2.1 공유 입력이 토큰 소비를 줄이는 이유
Decisions API의 과금 구조에는 세 가지 특징이 있습니다. 공유 입력은 한 번의 요청에서 한 번만 과금되고, 각 질문 자체의 지시문은 여전히 입력 토큰으로 과금되며, 판단 결과에는 생성형 출력 비용이 발생하지 않습니다. 비교 대상인 Gemini 3.5 Flash-Lite의 공식 표준 가격은 입력 100만 토큰당 0.30달러, 출력 100만 토큰당 2.50달러입니다(2026년 11월 13일 공식 가격).
S를 하나의 공유 입력 토큰 수, Q를 해당 입력에 대해 던지는 독립 질문 수, Tq를 질문당 평균 토큰 수, To를 생성형 모델의 질문당 평균 출력 토큰 수, N을 입력 건수라고 합시다. “두 인터페이스의 과금 대상 입력 토큰이 동일하다”는 단순화 가정 아래에서는 다음과 같습니다.
Decisions API 비용   C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Flash-Lite 비용      C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
절감률               = (1 − C_D / C_F) × 100%
이 계산 모델은 메커니즘을 이해하기 위한 것이며, Google이 고정된 절감률을 제시한 것은 아닙니다. 두 인터페이스는 각기 다른 지시문 인코딩과 포맷 오버헤드를 가지므로, 실제 비용은 각자가 반환하는 과금 토큰을 기준으로 삼아야 합니다.
2.2 1회 판단에서 1,000회 판단으로: 비용은 어떻게 달라질까
아래 표는 공개 단가를 기준으로 도출한 이론 예시이며, 실제 부하 테스트를 거친 결과는 아니에요. 시나리오 ①의 1,000개 판단은 모두 같은 문서 하나를 대상으로 하므로, 하나의 입력에 대해 1,000개의 독립적인 질문을 던지는 것이에요. 이는 “문서 1,000건을 각각 한 번씩 분석하는 것”과 완전히 다른 부하예요.
| 업무 시나리오 | 주요 가정 | Decisions API | Flash-Lite | 이론상 절감 |
|---|---|---|---|---|
| ① 문서 1건에서 1,000개 규칙 검사 | 문서 10K Token, 규칙당 20 Token, Flash-Lite 규칙당 출력 20 Token, 두 방식 모두 하나의 요청으로 묶음 | $0.003 | $0.059 | 94.9% |
| ② 메시지 1,000건 각각 1회 분류 | 메시지당 300 Token, 판단 지시 50 Token, Flash-Lite 출력 10 Token | $0.035 | $0.130 | 73.1% |
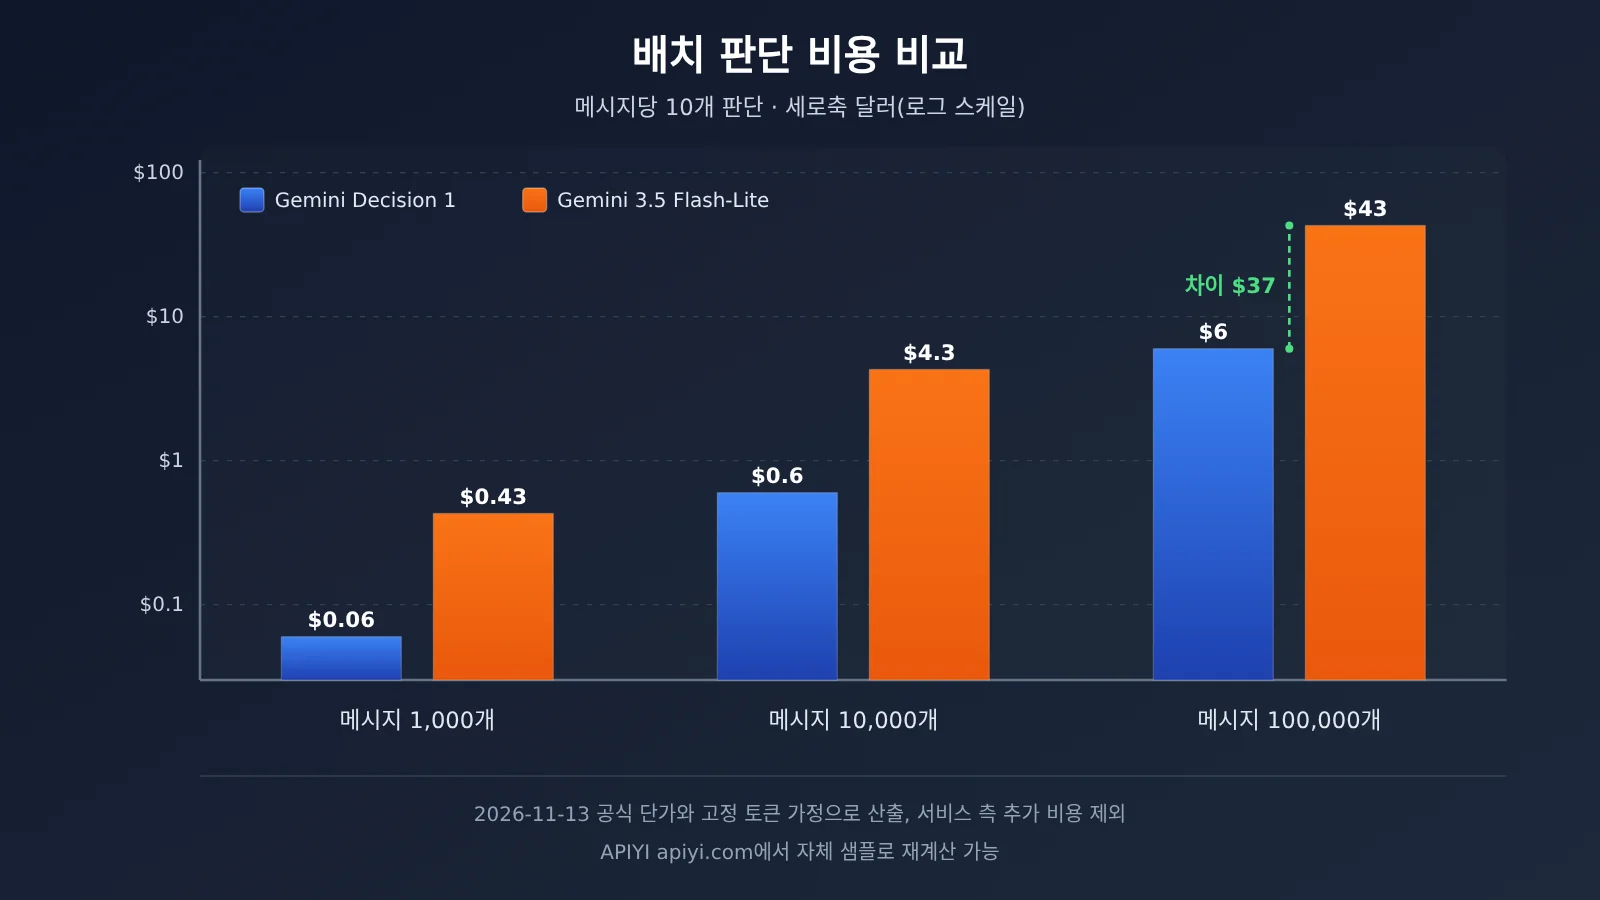
| ③ 메시지 1,000건 각각 10개 항목 판단 | 메시지당 300 Token, 항목당 판단 30 Token, Flash-Lite 항목당 출력 10 Token, 메시지당 한 번 요청 | $0.060 | $0.430 | 86.0% |
세 가지 시나리오는 두 가지 사실을 보여줘요. 시나리오 ②에서는 요청마다 질문이 하나뿐인데도 이론상 73.1%의 절감이 남아요. 그 이유는 입력 단가가 3분의 1로 낮아지고 출력 비용이 0이 되기 때문이에요. 시나리오 ①과 ③의 절감 폭이 더 큰 이유는 공유 입력이 여러 질문에 나뉘어 부담이 줄어들고, 동시에 Flash-Lite는 질문마다 출력을 생성해야 하기 때문이에요.
시나리오 ③의 파라미터를 그대로 적용해 규모를 키워 볼게요. 메시지 10만 건, 총 100만 회 판단을 처리할 때 Decisions API의 모델 호출 비용은 6달러, Flash-Lite는 43달러로 차이는 37달러예요. 이 수치는 모델 호출 비용만 포함하며, 재시도, 오판 후 사람의 검토, 더 강력한 모델로의 업그레이드, 전송·저장, 엔지니어링 변경 비용은 포함하지 않아요.
자체 업무 샘플로 다시 계산해 보고 싶다면, 먼저 같은 데이터를 생성형 모델에 한 번 돌려 실제 입력·출력 Token을 기록한 뒤 위 공식에 대입해 보세요. APIYI apiyi.com에서는 키 하나로 Gemini, GPT, Claude 등 여러 생성형 모델을 호출할 수 있어서 이런 비용 기준선을 빠르게 세우기 좋아요.
2.3 왜 Google의 “약 5배”가 범용적인 답이 아닌가
Google은 발표 당시 공식 테스트에서 Decision 1의 비용이 Gemini 3.5 Flash-Lite의 약 1/4.7 수준이라고 밝혔어요. 독립 테스터 RanThis는 2026년 11월 12일 실제 API 호출로 다른 숫자를 내놓았어요. 영어 메시지 100건, 베트남어 메시지 20건을 사용했고, 각 요청은 이진 판단 하나만 수행했어요.
- 정확도: 영어 판단 100건 중 Decision 1은 99건, Flash-Lite는 98건을 맞혔어요.
- 비용: 영어 판단 1,000회당 추산 비용은 각각 $0.0113과 $0.0166으로, Decision 1이 약 32% 낮았고 격차는 약 1.5배 수준이었어요.
- 지연: 단일 요청 지연 중앙값은 각각 0.18초와 0.58초였어요.
- 토큰 오버헤드: Decision 1은 요청당 평균 약 113개의 입력 토큰이 청구됐고, Flash-Lite는 약 47개의 입력 토큰에 출력 토큰 1개가 더해졌어요.
격차의 원인은 분명해요. Decisions 인터페이스 자체의 지시문과 형식 오버헤드 때문에 청구되는 입력 토큰이 두 배 이상으로 늘어나면서, 단가 우위의 일부가 상쇄된 거예요. 입력이 아주 짧고 매번 질문 하나만 던지며 생성형 모델이 토큰 하나만 출력하면 절감 폭이 가장 작아요. RanThis가 같은 이메일의 질문 10개를 Decision 1 요청 하나로 묶어서 Flash-Lite 개별 요청 10회와 비교했을 때는 격차가 약 5.4배로 벌어졌는데, 이 비교에서는 Flash-Lite 쪽이 같은 방식으로 요청을 묶지 않았기 때문에 서로 다른 요청 방식 사이의 비교라는 점을 감안해야 해요.
따라서 실제 절감 폭을 좌우하는 변수는 이렇습니다. 공유 입력의 길이, 입력 한 건당 질문 수, 생성형 모델의 출력 길이, 양쪽 모두 요청을 묶었는지 여부, 그리고 인터페이스 자체의 고정 오버헤드예요. 공식 수식 도출, Google 공식 벤치마크, 제3자 실측은 각기 다른 조건에서 나온 결과이니, 모델을 고를 때는 이들을 따로따로 봐야 해요.
3. 한 번에 1,000개의 판단을 처리한다면, Decisions API는 실제로 어떤 작업에 적합할까요?
3.1 문서 검토: 하나의 자료를 여러 규칙과 매칭하기
공유 입력의 장점을 가장 잘 살리는 건 “긴 자료 + 여러 규칙” 조합이에요. 계약서, 입찰 문서, 제품 설명서 같은 자료는 준수 체크리스트와 항목별로 대조해야 하죠. 위약 조항이 있는지, 데이터 국외 이전을 약정했는지, 결제 주기가 60일을 넘는지, 서명일이 빠졌는지 등을 확인해야 해요. 자료가 길수록, 규칙이 많을수록 공유 입력 비용이 더 넓게 분산돼요. 시나리오 ①의 94.9% 이론 절감률도 바로 이런 구조에서 나온 결과예요.
이런 작업의 또 다른 장점은 결과를 곧바로 표에 담을 수 있다는 점이에요. 각 규칙은 하나의 noul 판단에 대응하고, 확률과 신뢰도를 반환하죠. 프로그램은 임계값에 따라 “통과 / 불통과 / 재검토 필요”로 표시할 수 있고, 검토 담당자는 재검토가 필요한 항목만 보면 돼요.
3.2 Agent 라우팅과 콘텐츠 분류
Agent는 매 단계마다 다음 동작을 결정해야 해요. 웹 검색이 필요한지, 코드를 실행해야 하는지, 다른 도구로 넘겨야 하는지 같은 판단이죠. 이런 판단은 선택지가 고정돼 있고 호출 빈도가 높으며 지연에 민감해서 choice로 한 번에 처리하기에 적합해요. Google이 공개한 내부 활용 사례도 바로 여기에 집중돼 있어요. Gemini Notebook은 질문의 성격에 따라 모델과 사고 수준을 선택하는 데 이 기능을 쓰고, 일반 쿼리 지연을 최대 40%까지 줄였어요. Google Search는 MCP 도구의 안전 검사에 이 기능을 사용해 적대적 콘텐츠를 식별하고, CC는 200개가 넘는 후보 Emoji 중에서 반응을 빠르게 골라요. 이 수치는 Google 자체 데이터이고, 외부 개발자의 실제 효과는 각자의 부하에 따라 달라져요.
콘텐츠 생산 워크플로도 또 하나의 확장 시나리오예요. AI 뉴스 수집이 끝나면 시스템은 이 소식이 새 이벤트인지, 개발자와 관련 있는지, API 가격을 다루는지, 공식 출처가 있는지, 튜토리얼로 쓰기 적합한지, 콘텐츠 가치 점수는 얼마인지를 판단해야 해요. 이 여섯 조건은 서로 독립적이라 하나의 Decisions 요청에 넣어 필터링할 수 있고, 필터를 통과한 주제는 다시 생성형 모델로 넘겨 리서치, 작성, 다듬기를 진행할 수 있어요. 이건 인터페이스 기능을 바탕으로 설계한 예시方案이에요. 뒷단의 생성 단계는 APIYI apiyi.com을 통해 필요에 따라 다른 모델로 전환하면서 작성 품질과 비용을 비교할 수 있어요.
3.3 1,000개 질문이 가진 세 가지 경계
- 질문은 서로 독립적이어야 해요. 같은 요청 안의 판단은 서로의 결과를 읽을 수 없어요. “먼저 민원인지 판단하고, 그다음 민원 유형별로 등급을 매긴다”처럼 선후 의존 관계가 있는 흐름은 프로그램이 결과를 조합해야 하고, 필요하면 다음 요청을 다시 보내야 해요.
- 1,000개 질문은 262,144 토큰 컨텍스트를 공유해요. 공유 입력과 모든 질문이 이 윈도우를 함께 차지하므로, 각 질문의 지시문이 길어질수록 넣을 수 있는 자료는 짧아져요.
- 공식 저지연 데이터는 소규모 요청만 다뤄요. Google 테스트에서 지연이 거의 일정하게 유지된 범위는 요청당 1~100개 질문, 컨텍스트 16K 토큰 이내예요. 1,000개 질문에 컨텍스트가 거의 가득 찬 상황이라면 지연은 직접 실측해야 해요.
4 저렴하다는 것만으로 충분할까? Gemini Decisions API의 정확도와 속도가 프로덕션 요구를 충족할 수 있을까?
4.1 Google이 공개한 속도와 내부 적용 데이터
Google이 공개한 모델 계산 소요 시간 중앙값은 50–100ms이고, 엔드투엔드 지연은 150–250ms예요. 테스트 조건은 회당 1–100개 질문, 컨텍스트 16K 토큰 이하입니다. 이 수치를 보면 실시간 파이프라인에 넣기에 적합하다는 걸 알 수 있어요. 예를 들어 에이전트가 각 단계에서 하는 라우팅이나, 사용자 메시지의 즉시 분류 같은 곳이죠. RanThis가 단일 문제로 실측한 0.18초 중앙값 지연도 이 구간 근처에 있어요.
4.2 서드파티 평가가 알려주는 것
Artificial Analysis의 Decision Index v2.1은 출시 초기 결과를 원점수와 실제 과제를 섞어 계산했어요. 아래 표의 비용은 이 벤치마크 과제의 혼합 비용이고, “백만 토큰당 단가”와는 기준이 달라요.
| 결정 모델 | 종합 점수 | 과제당 소요 시간 | 백만 과제당 추정 비용 | AA-Paperclip 15개 전부 정답률 |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
여기서 눈여겨볼 점이 두 가지 있어요. 첫째, Gemini Decision 1은 토큰 단가가 낮은데도 이 과제 분포에서는 백만 과제당 추정 비용이 Drex Max와 Jev보다 높아요. 요청 방식과 과제 구조가 최종 경제성을 바꿔놓는다는 뜻이죠. 둘째, AA-Paperclip 문서 테스트에서 Decision 1이 15개 판단을 한 번에 모두 처리하면서 전부 맞힌 문서 비율은 33%였어요. 여러 판단을 한 번에 처리하는 방식은 비용을 아껴주지만, 각 항목의 정확도는 여전히 따로 검증해야 해요.
4.3 신뢰도로 오류가 자동 실행되는 것을 막기
신뢰도는 모델이 자기 결과에 대해 내놓는 확률 추정치예요. 어떤 결과를 자동으로 실행하고 어떤 결과를 사람에게 넘길지 정하는 데 쓸 수 있죠. 실제 서비스에 올릴 때는 다음 세 가지를 함께 쓰는 걸 권해요.
- 신뢰도 임계값 설정: 예를 들어 환불 판정의 신뢰도가 0.85보다 낮으면 사람에게 넘기고, 임계값을 넘을 때만 자동으로 라벨을 붙이거나 담당자를 배정해요.
- choice에 other 옵션 추가: 어떤 옵션도 적합하지 않을 때도 모델은 그중 하나를 골라요. “기타 / 판단 불가”를 넣으면 범위를 벗어난 입력의 일부를 걸러낼 수 있고, 별도로 noul을 하나 더 두어 범위 검사를 할 수도 있어요.
- 고위험 작업에는 코드 제약 유지: 환불 금액, 계정 정지, 규정 위반 차단 같은 동작에는 모델의 판단 외에도 하드코딩된 규칙과 사람의 재검토가 함께 있어야 해요.
5. 개발자는 Gemini Decisions API를 어떻게 사용하고 선택해야 할까요?
5.1 첫 번째 요청을 보내는 방법
공식적으로는 Python google-genai SDK 3.2 이상이 필요하고, JavaScript SDK와 REST도 지원해요. 연동하려면 Google AI Studio의 API 키가 필요하죠. 아래 예제는 공식 SDK 구조를 참고해 정리한 것으로, 같은 뉴스에 대해 이진 판단과 분류 판단을 동시에 수행해요. 이 글에서 실제로 호출해 검증하지는 않았으니 필드명은 공식 개발자 가이드를 기준으로 확인하세요.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input: 모든 질문이 공유하는 입력, 과금은 한 번만
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions: 서로 독립적인 판단, 키 이름이 곧 질문 ID
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # 각 질문의 판단 결과, 선택지별 확률과 신뢰도
print(result.usage)    # 과금 Token 사용량, 비용 산정은 이를 기준으로
네 가지 핵심 필드의 역할은 이래요. input에는 공유 콘텐츠를, questions에는 독립적인 질문을 넣어요(score 타입의 등급 정의 작성법은 공식 가이드를 참고하세요). answers에서는 판단 결과와 확률을, usage에서는 과금 Token을 읽어요. 비용을 계산할 때는 반드시 usage의 실제 값을 써야 해요. 2.3절에서도 설명했듯이 인터페이스의 고정 오버헤드가 질문당 비용에 큰 영향을 주거든요.
비용을 비교하려면 생성형 모델 기준선도 하나 필요해요. 아래에서는 OpenAI 호환 인터페이스를 통해 APIYI로 Flash-Lite를 호출해 같은 분류를 수행하고 Token 사용량을 기록해요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # 플랫폼 모델 목록의 실제 이름을 기준으로
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # 입력, 출력 Token, 2.1절 공식에 대입하는 용도
배치 비교 스크립트 보기: 같은 샘플 배치로 두 인터페이스의 비용을 각각 집계
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # Flash-Lite 공식 표준가, 달러/백만 Token
DECISION_IN = 0.10                 # Decision 1 입력가, 출력은 과금 없음

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """각 샘플의 모든 질문을 하나의 생성 요청으로 합쳐 실제 과금 비용을 누적"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Decisions API가 매번 반환한 usage 입력 Token을 받아 총비용을 계산"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 빠른 시작 제안: 먼저 실제 업무 샘플 200~500건을 골라 생성형 모델로 기준 정확도와 토큰 사용량을 측정한 뒤, Decisions API의
usage와 비교해 보세요. APIYI(apiyi.com)는 OpenAI 호환 인터페이스와 신규 사용자 무료 테스트 크레딧을 제공하므로, 이 단계의 기준 테스트를 빠르게 끝내기에 딱이에요.
5.2 언제 Decisions API를 선택하고, 언제 생성형 모델을 계속 쓸까
| 작업 유형 | 추천 방안 | 이유 |
|---|---|---|
| 동일한 긴 문서를 여러 규칙에 대조해 검토 | Decisions API | 입력을 공유해 비용이 분산되고, 판단이 서로 독립적 |
| Agent 도구 라우팅, 모델 선택 | Decisions API | 옵션이 고정되어 지연이 낮음 |
| 콘텐츠 안전 및 위반 검사 | Decisions API | 여러 개의 독립적인 noul 조건이 있고, 신뢰도로 분기 가능 |
| 고객센터 티켓 분류, 이커머스 A/S 태그 | Decisions API | 고정된 태그 집합 |
| 주제 선별, 리드 우선순위 점수화 | Decisions API | 사전에 설정한 척도에 맞는 score |
| 요약, 리라이팅, 글쓰기 | 생성형 모델 | 자연어 출력이 필요 |
| 복잡한 연구, 논증, 새로운 관점 제시 | 생성형 모델 | 개방형 추론이 필요 |
| 판단 사이에 선후 의존 관계가 있는 프로세스 | 프로그램 오케스트레이션 + 다중 요청, 또는 생성형 모델 | 같은 요청 안에서는 질문끼리 서로를 참조할 수 없음 |
생성형 모델의 구조화 출력(JSON Schema)도 답변을 고정된 형식으로 제한할 수 있어요. 하지만 여전히 토큰 단위로 내용을 생성하고 출력량 기준으로 과금되며, 확률은 별도 처리를 거쳐야 얻을 수 있죠. Decisions API는 각 옵션의 확률과 신뢰도를 곧바로 반환하고 출력에는 과금이 없어요. 대신 미리 정해 둔 옵션에 대해서만 답할 수 있다는 트레이드오프가 있습니다.
5.3 출시 전에 또 어떤 비용을 계산해야 할까요
단가 외에도 다음 몇 가지 항목은 “올바른 결정 하나당 총비용”에 직접 영향을 미쳐요.
- 실제 Token 비용:
usage를 기준으로 봐야 하며, 짧은 입력으로 한 문제를 처리하는 시나리오에서는 고정 비용 비중이 가장 커요. - 요청 한도: 무료 등급은 200 RPM, 50,000 TPM, 10,000 RPD이고, 유료 Tier 1은 1,500 RPM, 100만 TPM, 50,000 RPD예요. 긴 컨텍스트 요청은 대개 TPM 상한에 먼저 부딪혀요.
- 캐시와 배치 처리 부재: Context Caching, Batch API, Flex/Priority 추론을 지원하지 않아서, 같은 긴 문서를 반복해서 쓸 때 캐시 할인을 받을 수 없어요.
- 기능 제약: 질문 지시문 안에 미디어 콘텐츠를 넣을 수 없고, 전체 대화 기록이나 사고(thinking)·도구 호출 블록을 직접 전달할 수도 없어요. 멀티턴 대화는 먼저 텍스트 입력으로 정리해야 해요.
- 오판과 수동 검토: 신뢰도가 낮아 사람에게 넘기는 비율, 오판 후 재작업 비용도 단위 비용에 포함해야 해요.
- 데이터 처리 조건: 무료 등급의 사용 데이터는 Google 제품 개선에 활용될 수 있지만, 공식 가격표에 따르면 유료 등급은 이 목적으로 사용되지 않아요. 고객 문서를 처리하기 전에 어떤 등급을 쓰는지 확인해야 해요.
- 엔지니어링 개편: 생성형 프롬프트를 noul / choice / score 질문으로 다시 쓰고, 임계값과 폴백 로직을 구축하는 데에도 개발 투입이 필요해요.
서드파티 API 플랫폼을 통해 접속할 계획이라면, 해당 플랫폼이 /v1beta/decisions라는 전용 엔드포인트를 지원하는지 먼저 확인해야 해요. Chat Completions만 지원하는 플랫폼에서는 Decisions API를 직접 호출할 수 없어요. APIYI apiyi.com을 사용하기 전에 문서 센터의 모델 및 엔드포인트 목록을 먼저 확인하거나, 플랫폼에 문의해서 지원 여부를 확인해 보세요.
6 결론: 분류, 검토, 라우팅 작업은 Gemini Decisions API에 맡길 수 있어요
제목의 질문으로 돌아가면, 결론은 세 가지예요.
- 고정 옵션 작업은 Decisions API를 우선 고려할 만해요. 공개 가격을 기준으로 추산하면 문항당 분류는 이론상 약 73% 절감되고, 같은 긴 문서의 1,000개 규칙 검토는 이론상 약 95% 절감돼요. 타사 문항당 실측 우위는 약 32% 정도예요.
- “하나의 입력, 여러 개의 독립 질문” 구조가 비용 잠재력이 가장 큰 구조예요. 공유 입력은 한 번만 과금되고, 문항이 많을수록, 입력이 길수록, 생성형 모델의 출력이 길수록 격차는 더 커져요.
- 최종 기준은 프로덕션 환경에서 올바른 결정 한 건당 총비용이에요. 토큰 단가와 1,000문항 상한은 출발점이고, 정확도, 신뢰도 기반 분기 후 사람이 처리하는 비율, 할당량, 엔지니어링 비용이 함께 실제 이익을 결정해요.
비교적 안정적인 방법은 먼저 실제 샘플로 생성형 모델의 베이스라인을 측정한 뒤, Decisions API에서 usage와 정확도를 비교하고, 판단 계층과 생성 계층을 분리해 설계하는 거예요. 생성 계층의 모델 선택과 비용 비교는 APIYI(apiyi.com)를 통해 통일된 인터페이스로 진행할 수 있어요.
📚 참고 자료
- Google Gemini Decisions API 개발자 가이드 및 가격표: 인터페이스 기능, 제한, 할당량, 공식 가격
- 링크:
ai.google.dev -
설명: 모델 ID, 질문 유형, 컨텍스트 윈도우, 속도 제한, SDK 사용법
-
Google 공식 블로그 게시글: 게시일, 지연 시간 데이터, 내부 적용 사례
- 링크:
blog.google -
설명: 50–100 ms 계산 소요 시간, 약 4.7배 비용 우위, Gemini Notebook 등의 사례
-
Gemini Decisions API REST 엔드포인트
- 링크:
generativelanguage.googleapis.com/v1beta/decisions -
설명: REST 방식 호출의 공식 엔드포인트
-
Artificial Analysis Decision Index v2.1: 타사 결정 모델 평가
- 링크:
artificialanalysis.ai -
설명: 종합 점수, 작업 소요 시간, 백만 작업당 비용, AA-Paperclip 전 문항 정답률
-
RanThis 독립 실측(2026-11-12): 실제 호출 기반 소규모 테스트
- 설명: 문항당 비용, 지연 시간, 토큰 오버헤드 비교 및 다중 문항 병합 요청 결과
작성자: APIYI 기술팀
기술 문의: APIYI(apiyi.com) 첫 페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.


