作者注:MiniMax H3와 H3-Image는 모델 가중치가 공개됐지만, 시스템 구성 요소와 클라우드 서비스, 커뮤니티 라이선스가 개발과 상업적 사용의 범위를 정해요. 이 글에서는 모듈별, 라이선스별로 하나씩 짚어 볼게요.
2026년 11월 10일, MiniMax가 H3-Image의 모델 가중치를 공개했어요. 이보다 앞선 2026년 8월 3일에는 올모달 비디오 생성 모델인 MiniMax H3가 이미 오픈소스로 공개됐고요. 두 발표는 세 달 넘게 간격이 있는데도 자주 뭉뚱그려 논의돼요. 하지만 둘은 서로 다른 모델이고, 라이선스도 각각 따로예요.
이 글은 “가짜 오픈소스”를 비판하려는 글이 아니에요. 공식 발표문, Hugging Face 모델 카드, 라이선스 원문에 모두 분명하게 적혀 있듯이, MiniMax가 공개한 것은 핵심 생성 모델을 중심으로 한 가중치와 추론 자료이지 클라우드 시스템 전체가 아니에요. 이 글에서는 “무엇이 공개됐고, 무엇이 공개되지 않았으며, 어떻게 쓸 수 있는지”를 항목별로 정리해 볼게요.
핵심 가치: 이 글을 읽고 나면 MiniMax H3의 세 모듈이 각각 어떤 공개 상태인지 구분할 수 있고, H3-Image의 어떤 구성 요소를 로컬에서 실행할 수 있는지 파악할 수 있어요. 또 두 Community License가 매출 기준과 호스팅 서비스 측면에서 구체적으로 어떻게 다른지도 알게 될 거예요.
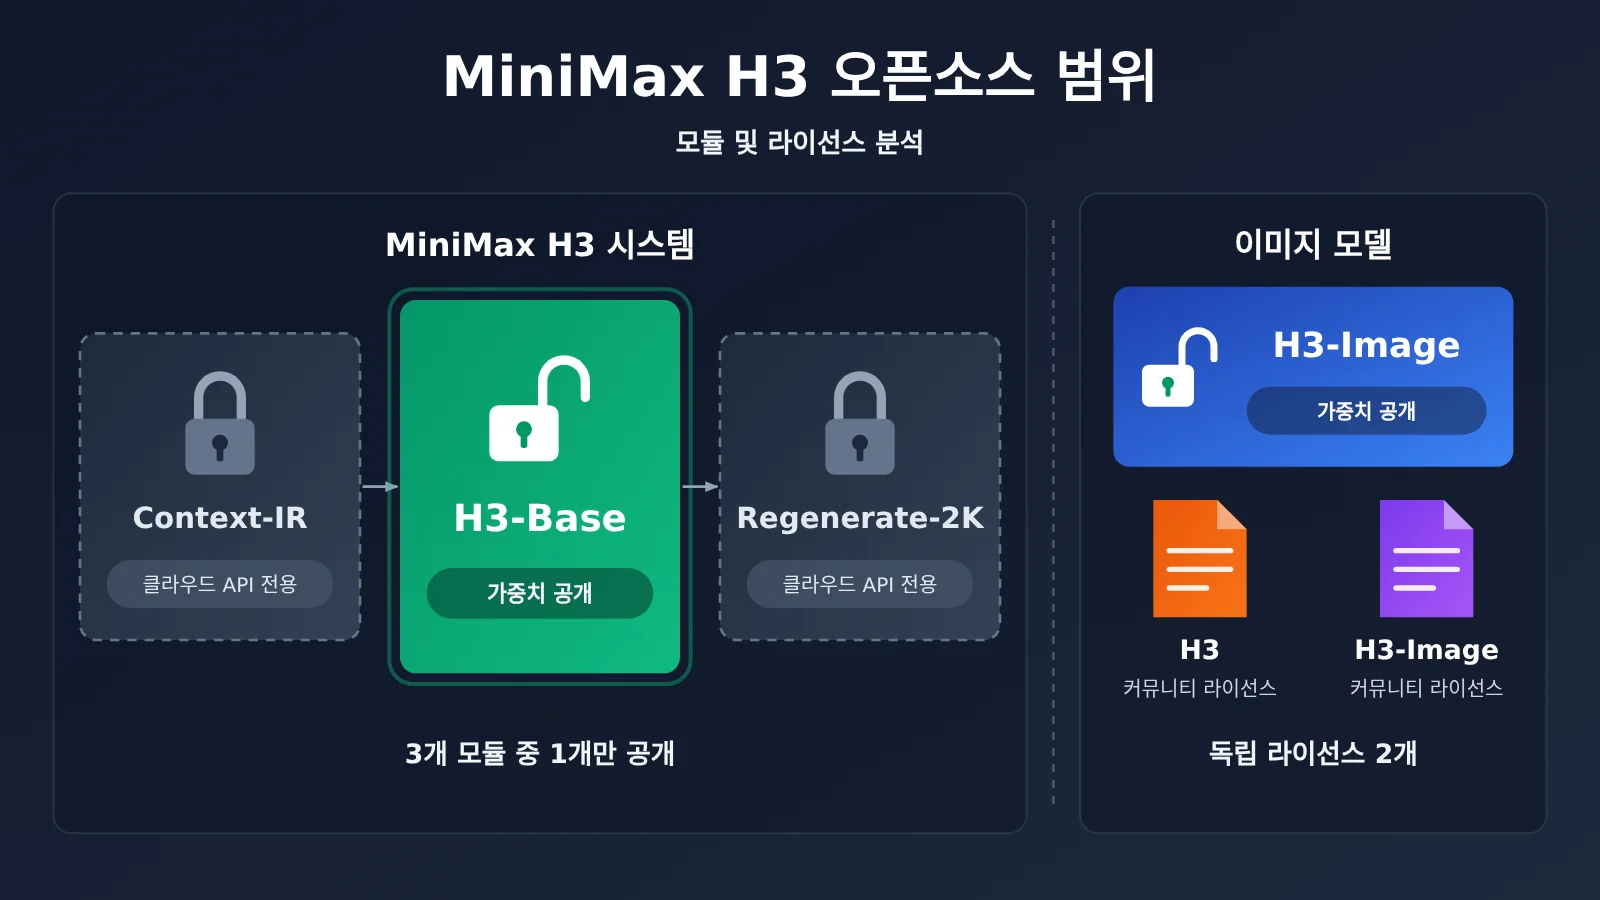
MiniMax H3 오픈소스 핵심 정보 한눈에 보기
먼저 타임라인과 기본 사실을 표 하나에 정리했어요. 아래의 모든 판단은 공식 공지, 모델 카드, 라이선스 원문을 근거로 하며, 확인 기준일은 2026년 11월 11일이에요.
| 정보 항목 | MiniMax H3 (비디오) | MiniMax H3-Image (이미지) |
|---|---|---|
| 오픈소스 공개 시점 | 2026년 8월 3일 | 2026년 11월 10일 |
| 모델 포지셔닝 | 풀 모달 비디오 생성, 네이티브 스테레오 오디오가 포함된 비디오 출력 | H3에서 파생된 고해상도 이미지 생성 및 편집 |
| 핵심 규모 | 33B 파라미터 | 33.1B 파라미터 DiT |
| 공개 범위 | H3-Base 가중치 및 추론 자료 (FL2VA, Ref2VA 두 개의 checkpoint) | DiT, Image VAE, Tokenizer/Processor, PE 모델 등 |
| 여전히 클라우드 의존 | Context-IR, Regenerate-2K | H3-Image-Context-IR |
| 라이선스 | H3 Community License | H3-Image Community License |
읽기 전에 알아둘 MiniMax H3 관련 용어 6가지
- 오픈 웨이트(개방 가중치): 학습된 모델 파라미터를 받을 수 있다는 뜻이에요. 다만 사용 범위는 라이선스가 정하며, 학습 데이터와 전체 파이프라인까지 공개된다는 의미는 아니에요.
- Community License: 모델 제공사가 자체적으로 만든 사용 라이선스 계약이에요. MIT나 Apache 2.0 같은 범용 오픈소스 라이선스와는 달라요.
- Checkpoint: 모델을 불러올 때 쓰는 파라미터 파일이에요. 하나의 모델이 작업별로 여러 개의 checkpoint를 제공할 수도 있어요.
- Context-IR: 멀티모달 입력을 이해하고, 지시문을 해석하고, 컨텍스트를 정리해 주는 공식 서비스예요. 현재는 API 형태로 제공돼요.
- 호스팅 서비스: 네트워크를 통해 제3자에게 모델 기능을 제공하는 방식이에요. 예를 들어 API를 외부에 공개하는 경우가 해당하며, 라이선스 제약이 집중되는 핵심 시나리오예요.
- 희소 어텐션(Sparse Attention): 어텐션 관계의 일부만 계산해서 긴 시퀀스의 연산 비용을 줄이는 기술이에요.
MiniMax H3 비디오 모델: 3개 모듈 중 1개만 공개됐어요
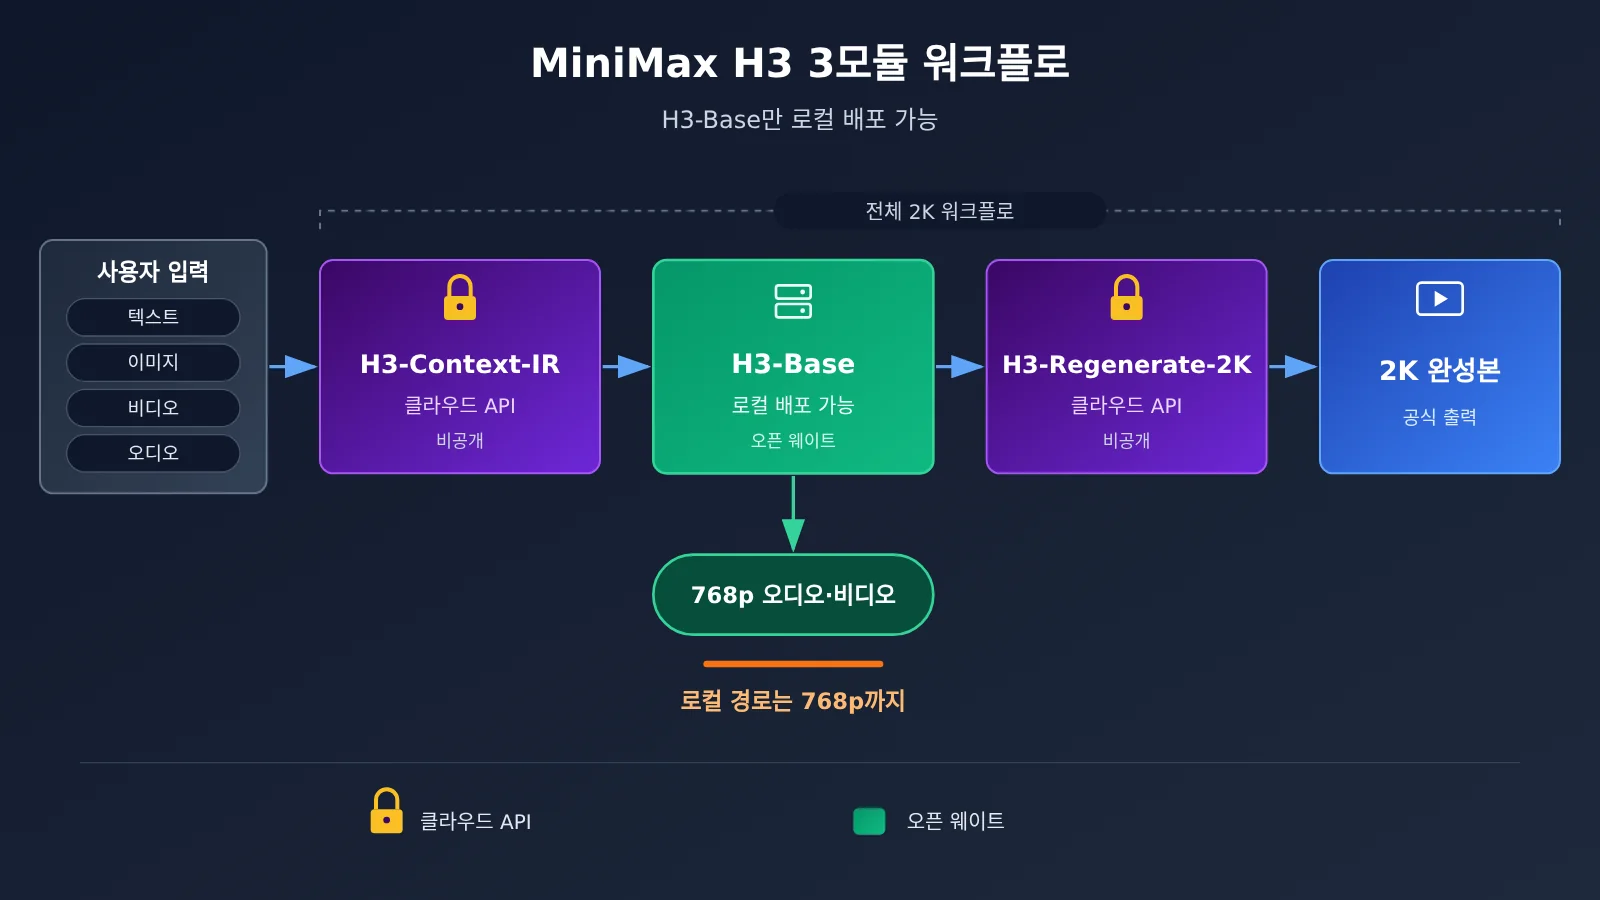
공식 원문 공지에서는 MiniMax H3 시스템 전체를 세 가지 모듈로 나눠요. 이 구분을 이해하면 “오픈소스지만 완전한 오픈소스는 아닌” 이유를 파악할 수 있어요.
| 모듈 | 역할 | 공개 현황 | 로컬 사용 가능 |
|---|---|---|---|
| H3-Context-IR | 멀티모달 입력 이해, 지시문 해석, 컨텍스트 구조화 | 비공개, 공식 API 제공 | 불가 |
| H3-Base | 비디오·오디오 생성 핵심 모델 | 가중치 및 관련 추론 자료 공개 | 가능 |
| H3-Regenerate-2K | 원본 컨텍스트를 바탕으로 저해상도 결과를 2K로 다시 생성 | 비공개, 공식 API 제공 | 불가 |
MiniMax H3-Base의 두 가지 checkpoint
H3-Base는 단일 가중치 파일이 아니라, 작업별로 특화된 checkpoint 두 개로 제공돼요. FL2VA는 텍스트-비디오 변환, 첫 프레임 기반 비디오 생성, 마지막 프레임 기반 비디오 생성, 첫·마지막 프레임 기반 비디오 생성을 지원해요. Ref2VA는 이미지, 비디오, 오디오를 동시에 참조로 사용해 더 복잡한 생성과 편집 작업을 처리할 수 있어요. 예를 들어 원본 비디오의 인물 외모와 장면은 그대로 두고, 동작과 입 모양, 대사만 바꾸는 식이에요.
두 checkpoint 모두 processor, tokenizer, text encoder, transformer, visual VAE, audio VAE 같은 구성 요소가 함께 제공돼요. 다시 말해 공개된 것은 실제로 추론을 돌릴 수 있는 모델 저장소이고, 부족한 구성 요소를 직접 채워 넣어야 하는 날것의 가중치가 아니에요. 이 점에서 “가중치만 공개”하는 많은 릴리스보다 훨씬 완성도가 높아요.
로컬 768p와 전체 2K 워크플로의 차이
공식 사양에 따르면 H3의 기본 출력은 짧은 변 기준 768px, 비디오 길이 4~15초, 프레임레이트 24 FPS, 오디오는 32kHz 스테레오예요. 오픈소스인 H3-Base만 배포하면 로컬에서 768p 오디오·비디오 생성을 구현할 수 있어요. 공식 2K 출력을 재현하려면 Context-IR과 Regenerate-2K, 이 두 API를 추가로 호출해야 해요.
따라서 더 정확하게 말하면 H3-Base는 독립적으로 실행할 수 있지만, H3 시스템 전체는 MiniMax 서비스에서 완전히 벗어날 수 없어요. 로컬 방식에서는 입력 이해와 지시문 정리 단계를 개발자가 직접 설계해야 하고, Context-IR의 로컬 버전이 이미 있다고 가정해서는 안 돼요.
놓치기 쉬운 Sparse Attention
공식은 첫 오픈소스 공개 때, H3 모델 자체는 희소 어텐션(Sparse Attention) 학습과 추론을 기본으로 지원하며 긴 시퀀스 멀티모달 연산 비용을 줄이는 데 쓰인다고 분명히 밝혔어요. 하지만 처음 공개된 추론 코드에는 Full Attention만 포함돼 있고, Sparse Attention 구현은 이후 업데이트에서 따로 공개될 예정이에요.
즉 가중치가 공개됐다고 해서 내부 추론 최적화까지 모두 공개된 것은 아니에요. 현재 공개된 코드로 긴 비디오를 추론하면 공식 클라우드의 실제 성능보다 연산 비용이 더 높을 수 있으니, 성능을 평가할 때 이 변수를 고려해야 해요.
MiniMax H3-Image에서 공개된 구성 요소는 무엇일까요?
H3-Image의 공개 방식은 H3와 비슷해요. 핵심 모델은 내려받을 수 있지만, 컨텍스트 처리는 여전히 클라우드에 의존해요. 아래 표는 Hugging Face 모델 저장소를 기준으로 정리했어요.
| 구성 요소 | 공개 여부 | 설명 |
|---|---|---|
| 33.1B DiT 이미지 생성 모델 | 공개 | 싱글 스트림 Diffusion Transformer, 약 68.65 GB |
| Image VAE | 공개 | 이미지 잠재 표현 인코딩/디코딩 |
| Tokenizer / Processor | 공개 | 입력 전처리 |
| PDD 출력 헤드 및 샘플링 설정 | 공개 | 6단계 샘플링, CFG 불필요를 지원 |
| Qwen3-VL 텍스트 인코더 | 공개, H3 저장소 가중치 재사용 | 50번째 레이어의 히든 스테이트 사용, 약 66.7 GB |
| H3-Image-PE 프롬프트 향상 모델 | 공개, 별도 다운로드 | 약 17.9 GB, 로컬 실행 가능 |
| H3-Image-Context-IR | 비공개 | 공식 API 형태로 제공 |
텍스트 인코더를 왜 H3 저장소에서 받아야 할까요?
H3-Image는 H3의 Qwen3-VL 텍스트 인코더를 그대로 가져다 써요. 이 가중치는 H3 저장소에 들어 있고, H3-Image 저장소에는 중복해서 올리지 않았어요. 그래서 H3-Image를 배포하려면 두 저장소의 내용을 모두 내려받아야 해요. 메인 모델과 텍스트 인코더를 합치면 저장 공간이 약 135.35 GB 필요한데, 이건 어디까지나 파일 용량일 뿐 필요한 VRAM 용량과는 달라요.
공식 권장 배포 프레임워크로는 SGLang, vLLM-Omni, Diffusers, ComfyUI가 있어요. 지원 하드웨어로는 NVIDIA H200, RTX PRO 6000 Blackwell, AMD Instinct MI350X 등이 나와 있고, 멀티 GPU 병렬 방식도 제공해요. 개인 개발자 대부분에게는 이 하드웨어 문턱이 꽤 높은 편이에요.
Context-IR과 PE는 서로 다른 것이에요
H3-Image-Context-IR은 공식 클라우드 서비스예요. 짧은 지시문을 완전한 생성 설명으로 확장하고, 적절한 이미지 크기까지 정해 줘요. 반면 H3-Image-PE는 독립적으로 내려받아 로컬에서 실행할 수 있는 프롬프트 향상 모델이고, 공식에서 제시한 로컬 대안이에요.
PE가 공개됐다고 해서 Context-IR의 다단계 호스팅 워크플로까지 공개된 것은 아니에요. 이미지 모델과 PE만 받으면 쓸 만한 로컬 파이프라인은 갖출 수 있지만, 공식 클라우드의 결과를 그대로 재현한다고 보기는 어려워요.
제조사의 주장과 프레임워크 테스트는 구분해서 봐야 해요
“10초 안에 4K 이미지 생성”, “참조 이미지 최대 16장”은 공식 모델 카드와 공지에서 나온 내용이라 제조사의 주장에 해당해요. 반면 vLLM 배포 레시피에는 참조 이미지 상한이 최대 9장으로 적혀 있어서, 두 수치는 기준이 달라요. 실제로 참조 이미지를 몇 장까지 쓸 수 있는지는 사용하는 추론 프레임워크와 설정에 따라 달라지니, 평가할 때는 직접 측정한 결과를 기준으로 삼는 게 좋아요.
MiniMax H3 두 라이선스는 정확히 무엇을 제한할까요?
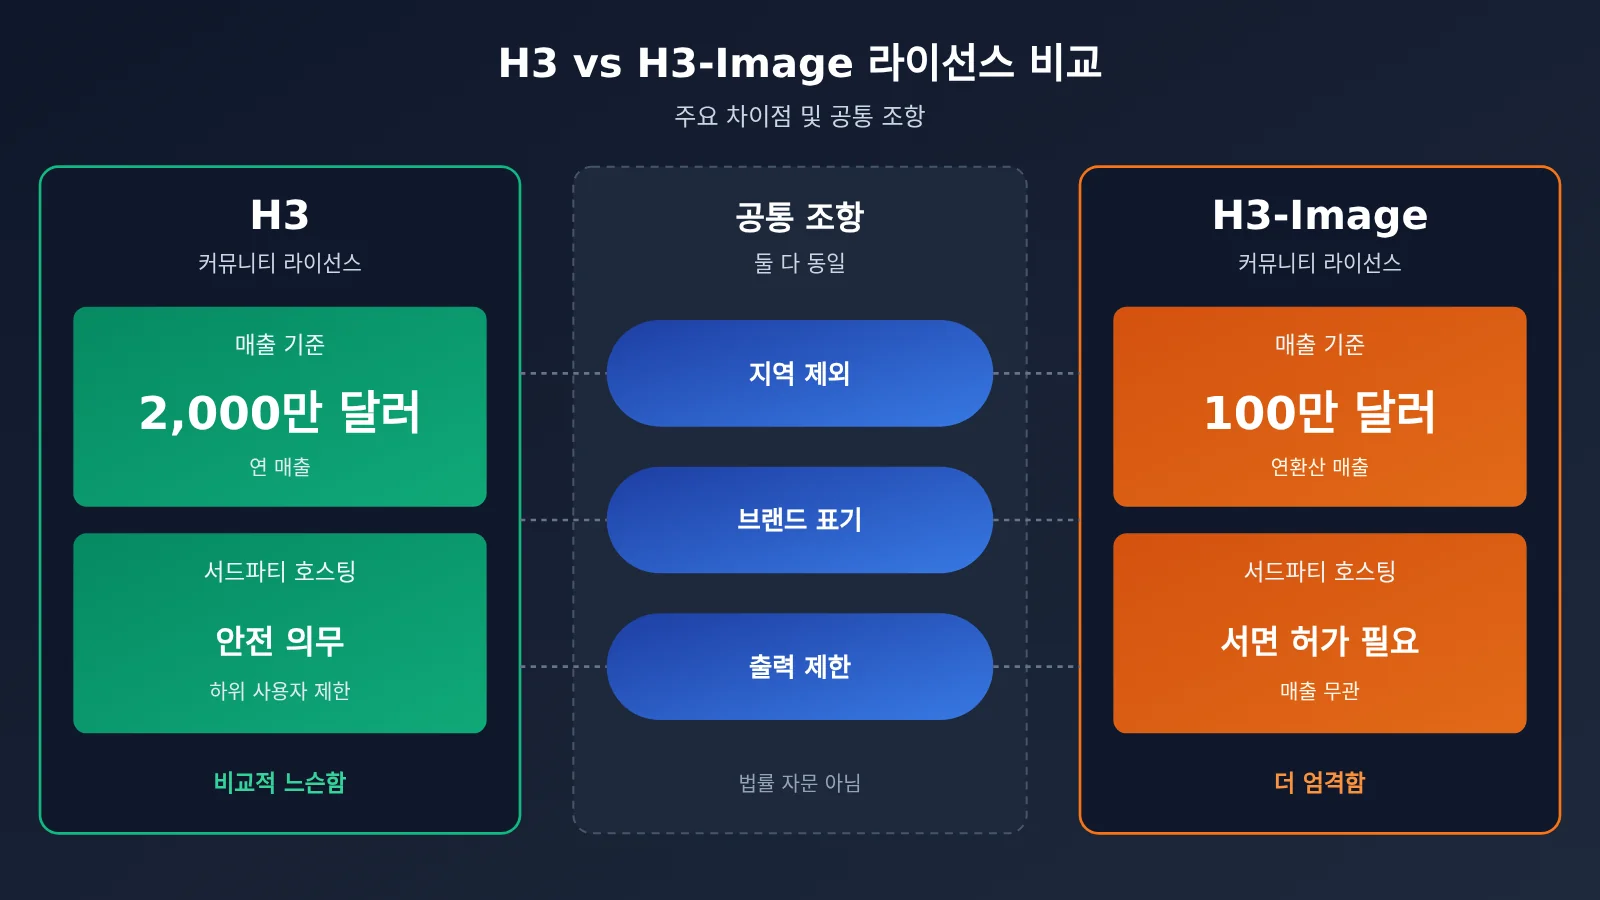
두 번의 발표 중에서 가장 오해하기 쉬운 부분이에요. H3와 H3-Image는 서로 다른 두 개의 Community License를 쓰고, 상업적 이용 조건도 꽤 달라요. 그래서 하나의 결론을 두 모델에 똑같이 적용하면 안 돼요.
| 조건 | H3 Community License | H3-Image Community License |
|---|---|---|
| 적용 지역 | 미국, EU, 영국, 한국 제외 | 동일 |
| 매출 기준 승인 요건 | 상업 제품 및 서비스의 연 매출이 2,000만 달러를 초과하면 사전 서면 승인 필요 | 본인 및/또는 계열사의 연환산 매출이 100만 달러를 초과하면 사전 서면 승인 필요 |
| 제3자 호스팅 서비스 | 합리적인 보안 조치를 마련하고, 하위 사용자도 사용 제한을 준수하도록 해야 함 | 제3자에게 호스팅 서비스를 제공하려면 사전 서면 승인 필요 |
| 상업 제품 표기 | 인터페이스에 MiniMax H3를 눈에 띄게 표시 | 인터페이스에 MiniMax-H3-Image를 눈에 띄게 표시 |
| 출력물로 다른 AI 모델 개선 | 허용 안 됨 | 허용 안 됨 |
📌 참고: 위 내용은 라이선스 원문의 조항을 요약한 것이며 법률 자문이 아니에요. 지역 제한과 그 밖의 의무에 대한 자세한 내용은 두 LICENSE 원문을 기준으로 확인해 주세요. 우선 생성형 모델과 대화형 모델의 성능만 평가해 보고 싶다면, APIYI apiyi.com의 통합 인터페이스로 주요 모델을 호출해 방안을 비교해 본 뒤 로컬 배포와 승인 신청에 투자할지 결정하셔도 좋아요.
H3의 경계: 상업 이용은 가능하지만 의무가 따라요
H3는 적용 지역 안에서 로열티 없는 제한적 라이선스를 제공하고, 상업적 이용도 허용해요. 실제로 걸림돌이 되는 조건은 두 가지예요. 연 매출이 2,000만 달러를 넘으면 서면 승인을 받아야 하고, 제3자에게 모델 서비스를 제공할 때는 보안 장치를 마련해 사용 제한을 하위 사용자에게 전달해야 해요.
H3-Image의 경계: 호스팅 서비스가 가장 높은 문턱이에요
H3-Image의 조건은 훨씬 엄격해요. 연환산 매출 기준이 100만 달러로 낮아지고, 제3자에게 호스팅 서비스를 제공한다면 매출 규모와 상관없이 반드시 사전 서면 승인을 받아야 해요. 라이선스에는 별도 라이선스를 신청할 수 있도록 MiniMax에 문의하는 경로도 마련되어 있어요.
API 플랫폼, 모델 호스팅 플랫폼, SaaS 개발자에게 이 조항은 “가중치를 내려받을 수 있다”고 해서 “배포한 뒤 외부에 API를 열어도 된다”는 뜻은 아니라는 점을 의미해요. 이 경계의 엄격함은 H3와 H3-Image에서 완전히 달라요.
MiniMax H3 오픈소스가 개발자에게 미치는 영향 분석
모델 공개 범위와 라이선스를 함께 놓고 보면, 사용 시나리오에 따라 개발자가 누리는 자유도가 꽤 다르다는 걸 알 수 있어요.
| 사용 시나리오 | 할 수 있는 것 | 주요 제약 |
|---|---|---|
| 개인 연구 및 로컬 실험 | 가중치 다운로드, 로컬 추론, 아키텍처 연구, 2차 개발 | 지역 제외 조항, 출력물을 다른 모델 개선에 사용 불가, 높은 하드웨어 요구 사양 |
| 기업 내부 상업적 사용 | 로컬에 배포해 생성한 콘텐츠를 자사 사업에 활용 | H3는 2,000만 달러 기준, H3-Image는 100만 달러 기준 적용 |
| 사용자 대상 상업 제품 | 자사 애플리케이션에 통합 | 인터페이스에 해당 모델 이름을 눈에 띄게 표시해야 함 |
| 제3자에게 API 호스팅 제공 | H3는 보안 의무를 이행하면 제공 가능 | H3-Image는 사전에 서면 허가를 받아야 함 |
| 공식 전체 성능 재현 | 로컬 768p 영상, 로컬 이미지 생성 + PE | 2K 영상과 Context-IR은 여전히 공식 API가 필요 |
공개가 가져다주는 실질적인 자유
가중치 공개로 얻는 자유는 분명히 실속이 있어요. 오프라인 배포가 가능하고, 데이터가 내부망 밖으로 나가지 않도록 통제할 수 있으며, 33B 규모 옴니모달 모델의 구조를 연구할 수도 있어요. 로컬 파이프라인에서 전처리와 후처리 단계를 교체하거나 개조하는 것도 가능하고요. 두 모델 모두 완전한 추론 구성 요소를 함께 제공해서, 커뮤니티가 재현해 볼 수 있는 진입 장벽이 낮아졌어요.
여전히 남아 있는 세 겹의 경계
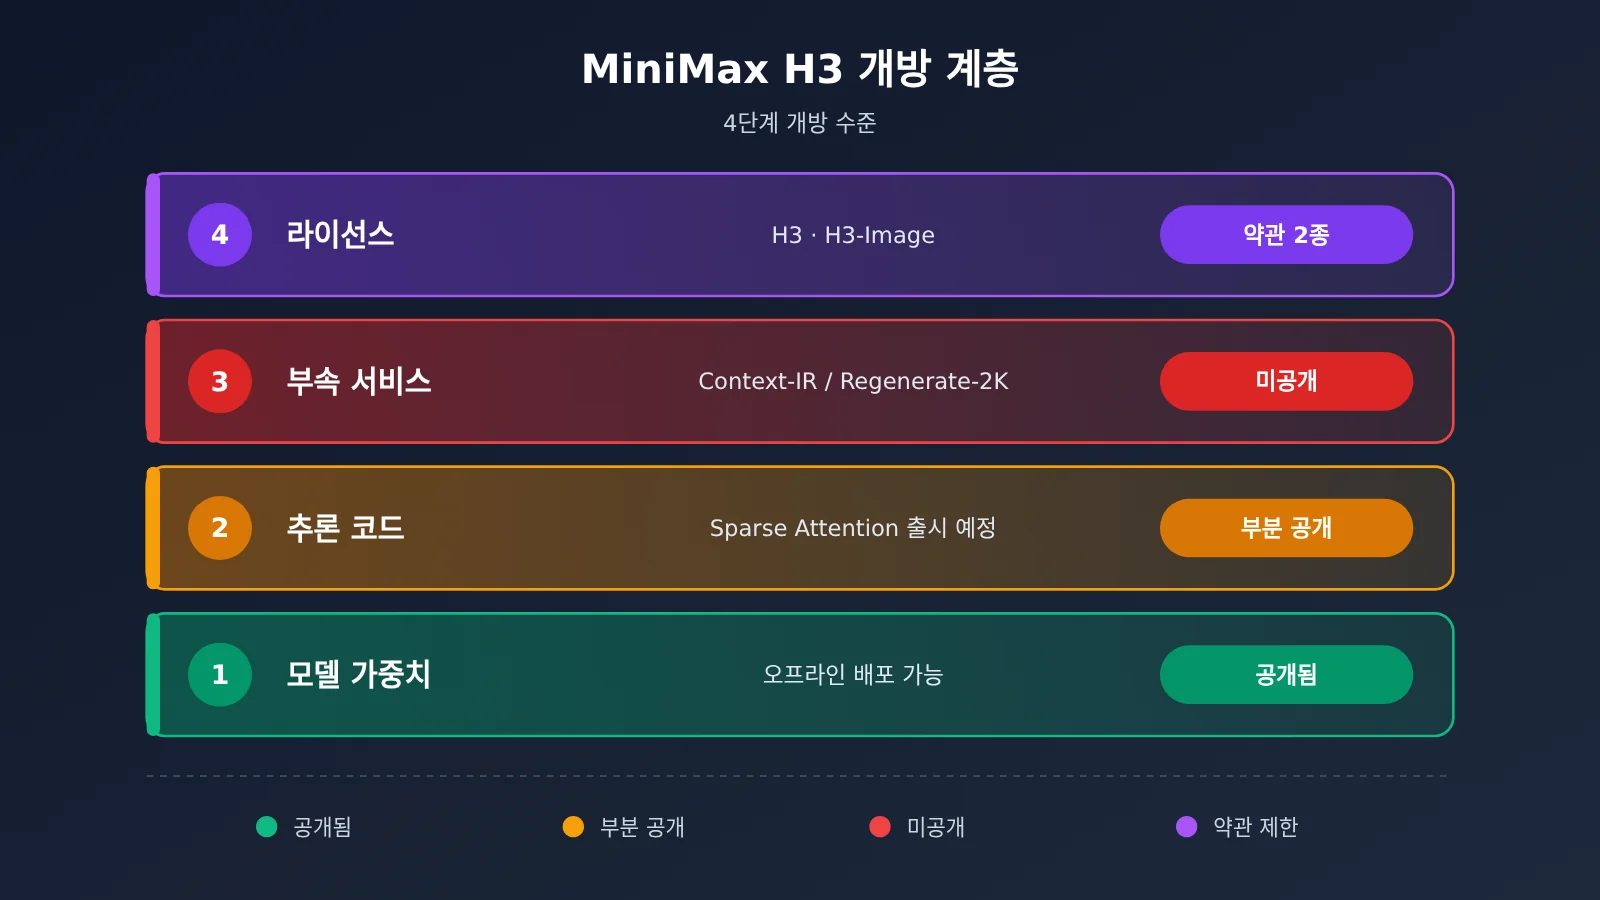
첫 번째는 시스템 경계예요. Context-IR과 Regenerate-2K는 공개 범위에 포함되지 않아요. 두 번째는 구현 경계로, H3의 Sparse Attention 코드는 최초 공개 시점에 포함되지 않았어요. 세 번째는 라이선스 경계예요. 지역, 매출, 호스팅 서비스, 브랜드 표시 조항이 함께 상업적 사용 가능 여부를 결정해요.
그래서 가중치 공개와 클라우드 API는 공존하는 관계예요. GPU 구매, 추론 최적화, 고동시성 스케줄링, 프롬프트 강화, 규정 준수 검토 같은 비용은 가중치가 공개됐다고 사라지지 않아요. 많은 팀에게는 먼저 APIYI(apiyi.com) 같은 통합 플랫폼으로 비즈니스 요구를 검증한 뒤, 자체 구축할 가치가 있는지 평가하는 방식이 더 안정적인 순서예요.
MiniMax H3 로컬 흐름의 전처리 단계 예시
Context-IR이 공개되지 않았기 때문에, H3-Base를 로컬에서 실행할 때는 입력을 정리하는 단계를 직접 만들어야 해요. 흔히 쓰는 방법은 범용 대규모 언어 모델로 짧은 아이디어를 구조화된 설명으로 먼저 확장한 뒤, 그 결과를 로컬 모델에 넘기는 거예요. 다만 이건 어디까지나 엔지니어링 차원의 대체 방안이라서, 공식 Context-IR과 같은 효과를 내지는 않는다는 점을 기억해 두세요.
간단한 예시
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "把简短视频创意扩写为详细镜头描述,包含主体、动作、镜头、光线和声音。"},
        {"role": "user", "content": "雨夜街头,一只猫跳上霓虹灯招牌"}
    ]
)
print(resp.choices[0].message.content)
전체 구현 코드 보기
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = """你是视频生成提示词工程师。
请把用户的简短创意扩写为 JSON,字段包括:
- prompt: 详细的画面与动作描述
- camera: 镜头运动
- audio: 环境声与音乐描述
- duration: 视频时长(秒,取值 4 到 15)
只输出 JSON。"""

def build_context(idea: str, model: str = "gpt-4o-mini") -> dict:
    """범용 대규모 언어 모델로 입력을 정리해 로컬 H3-Base의 전처리 단계로 사용한다"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": idea},
        ],
        response_format={"type": "json_object"},
    )
    ctx = json.loads(resp.choices[0].message.content)
    # H3 공식 사양에 맞춰 영상 길이를 4~15초로 제한
    ctx["duration"] = max(4, min(15, int(ctx.get("duration", 5))))
    return ctx

if __name__ == "__main__":
    ctx = build_context("雨夜街头,一只猫跳上霓虹灯招牌")
    print(json.dumps(ctx, ensure_ascii=False, indent=2))
    # 다음 단계: ctx를 로컬 H3-Base 추론 흐름에 넘긴다
    # (공식 GitHub 저장소의 FL2VA 추론 예시 참고)
🚀 빠른 시작: 로컬 VRAM이 부족하다면 APIYI(apiyi.com)에서 무료 테스트 크레딧을 받아 프롬프트 정리 단계부터 먼저 돌려 보세요. 이 플랫폼은 OpenAI 호환 인터페이스를 제공해서 API 키 하나로 여러 모델을 바꿔 가며 쓸 수 있어요. 그래서 어떤 모델이 전처리 확장에 더 잘 맞는지 비교하기도 편해요.
MiniMax H3 오픈소스 관련 자주 묻는 질문 FAQ
Q1: MiniMax H3는 진짜 오픈소스인가요?
정확하게는 오픈 웨이트 모델이라고 보는 편이 맞아요. H3-Base의 가중치와 추론 자료는 공개되어 있지만, Context-IR과 Regenerate-2K는 공개되지 않았어요. 라이선스도 MIT나 Apache 2.0이 아니라 제한이 있는 Community License를 사용해요.
Q2: MiniMax H3와 H3-Image의 라이선스는 같은가요?
아니요, 달라요. 두 라이선스 모두 지역 제외 범위는 같지만, 수익 기준이 서로 달라요. H3는 연 매출 2,000만 달러 초과, H3-Image는 연환산 매출 100만 달러 초과가 기준이에요. 또 H3-Image는 제3자에게 호스팅 서비스를 제공할 때 반드시 사전에 서면 승인을 받아야 해요. 반면 H3는 안전 장치 마련과 하위 사용자에 대한 제약 의무를 이행하도록 요구해요.
Q3: H3-Base만 배포해도 2K 비디오를 얻을 수 있나요?
얻을 수 없어요. 로컬에서 H3-Base를 실행하면 기본 출력은 짧은 변 기준 768px이에요. 2K 출력은 공식 Context-IR과 Regenerate-2K API에 의존해요.
Q4: H3-Image-PE로 Context-IR을 대체할 수 있나요?
PE는 공식에서 제공하는 로컬 프롬프트 강화 방식이라 따로 내려받아 실행할 수 있어요. 하지만 Context-IR의 다단계 호스팅 워크플로 전체와 같다고 할 수는 없어요. 공식 결과에 가까운 품질을 원한다면 직접 테스트하고 튜닝해야 해요.
Q5: 로컬 배포의 문턱이 너무 높은데, 대안이 있을까요?
H3-Image는 메인 모델과 텍스트 인코더만 합쳐도 저장 공간이 약 135.35 GB나 필요해요. 공식 지원 하드웨어도 H200, MI350X 같은 데이터센터급 GPU가 중심이에요. 지금 단계가 방안 검증이라면, 먼저 APIYI(apiyi.com)를 통해 이미 등록된 주요 모델을 호출해 보세요. 통합 인터페이스로 결과를 빠르게 비교한 다음, 직접 구축하는 쪽이 실익이 있는지 판단하면 돼요.
Q6: H3의 출력물로 제 모델을 학습시켜도 되나요?
두 라이선스 모두 모델이나 그 출력물을 이용해 다른 AI 모델을 개선하는 것을 허용하지 않아요. 데이터 합성이나 증류를 하기 전에 반드시 라이선스 원문을 먼저 확인하세요.
MiniMax H3 오픈소스 핵심 요약 Key Takeaways
- 세 모듈 중 하나만 공개: H3-Base만 공개되었고, Context-IR과 Regenerate-2K는 여전히 공식 API로만 쓸 수 있어요.
- checkpoint 완비: FL2VA와 Ref2VA 모두 tokenizer, VAE 등 추론 컴포넌트가 함께 제공돼요.
- 로컬은 768p까지: 완전한 2K 영상 워크플로는 공식 클라우드 서비스에 의존해요.
- 희소 어텐션은 아직 미공개: 처음 공개된 추론 코드에는 Full Attention만 들어 있어요.
- 두 라이선스는 서로 달라요: H3는 2,000만 달러, H3-Image는 100만 달러가 기준이에요.
- 호스팅 서비스는 레드라인: H3-Image를 제3자에게 호스팅 서비스로 제공하려면 사전에 서면 승인을 받아야 해요.
- 먼저 검증하고 구축하세요: APIYI(apiyi.com)의 통합 인터페이스로 비즈니스 요구 사항을 저렴하게 검증해 볼 수 있어요.
정리
MiniMax H3 오픈소스의 핵심 포인트를 정리해 볼게요.
- 공개된 것은 핵심 생성 모델: H3-Base와 H3-Image 메인 모델은 내려받아 직접 배포할 수 있고, 추론 컴포넌트도 모두 갖춰져 있어요.
- 클라우드 서비스도 여전히 시스템의 일부: Context-IR과 Regenerate-2K가 완성된 결과물 품질의 상한을 좌우해요.
- 라이선스가 상업적 활용의 경계를 정해요: 두 Community License는 조건이 서로 다르고, 특히 H3-Image는 호스팅 서비스에 대한 요건이 훨씬 엄격해요.
모델이 어디까지 공개되었는지 판단하려면 가중치를 내려받을 수 있는지만 볼 것이 아니라, 컴포넌트, 추론 코드, 부속 서비스, 라이선스라는 네 가지 측면을 함께 살펴봐야 해요. 이번 MiniMax의 공개는 꽤 성의 있는 편이지만, 직접 배포하거나 상업적으로 활용하기 전에 이 네 가지 층위의 경계를 하나씩 꼼꼼히 확인하는 게 좋아요.
생성형 솔루션을 평가하고 있다면, 먼저 APIYI(apiyi.com)의 무료 크레딧으로 비즈니스 흐름을 빠르게 검증해 보세요. 그런 다음 로컬 배포와 라이선스 신청에 투자할지 결정하시길 권해요.
📚 참고 자료
- MiniMax H3 공식 오픈소스 공지: 3개 모듈 구성과 Sparse Attention 설명
- 링크:
minimax.io/news/minimax-h3-open-source -
설명: H3 시스템 구조와 공개 범위를 가장 먼저 확인할 수 있는 원본 자료예요
-
Hugging Face – MiniMax-H3 모델 저장소: FL2VA, Ref2VA 체크포인트와 구성 요소
- 링크:
huggingface.co/MiniMaxAI/MiniMax-H3 -
설명: 공유되는 Qwen3-VL 텍스트 인코더 가중치가 포함되어 있어요
-
MiniMax H3 Community License 원문
- 링크:
huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE -
설명: 수익 기준, 적용 지역 범위, 다운스트림 의무는 이 원문을 기준으로 해요
-
Hugging Face – MiniMax-H3-Image 모델 저장소: 구성 요소 목록과 배포 안내
- 링크:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
설명: 공식 모델 카드이며, 참조 이미지 최대 개수 등 제조사 측 명세가 담겨 있어요
-
MiniMax H3-Image Community License 원문
- 링크:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
설명: 호스팅 서비스 이용 허가와 100만 달러 기준 조항이 나와 있어요
-
vLLM 배포 레시피 – MiniMax-H3-Image
- 링크:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image -
설명: 프레임워크 측 테스트 구성이며, 참조 이미지 최대 개수 기준이 모델 카드와 달라요
-
GitHub – MiniMax-H3 소스 코드 및 배포 자료
- 링크:
github.com/MiniMax-AI/MiniMax-H3 - 설명: 로컬 추론 예제와 배포 스크립트를 확인할 수 있어요
작성자: APIYI 기술팀
기술 교류: APIYI 공식 웹사이트 첫 페이지에서 언제든 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요