작성자 주: Fable 5.5와 GPT-6.2 Astra는 모두 공개 데모가 있지만, 같은 과제로 비교한 결과는 없어요. 이 글에서는 데모 6개의 증거 수준을 살펴보고, 현재 주력 모델인 Fable 5.1과 GPT-6 Astra의 공식 사양과 가격을 비교해요. 또 반복 실행할 수 있는 모델 선택 평가 방법도 소개해요.
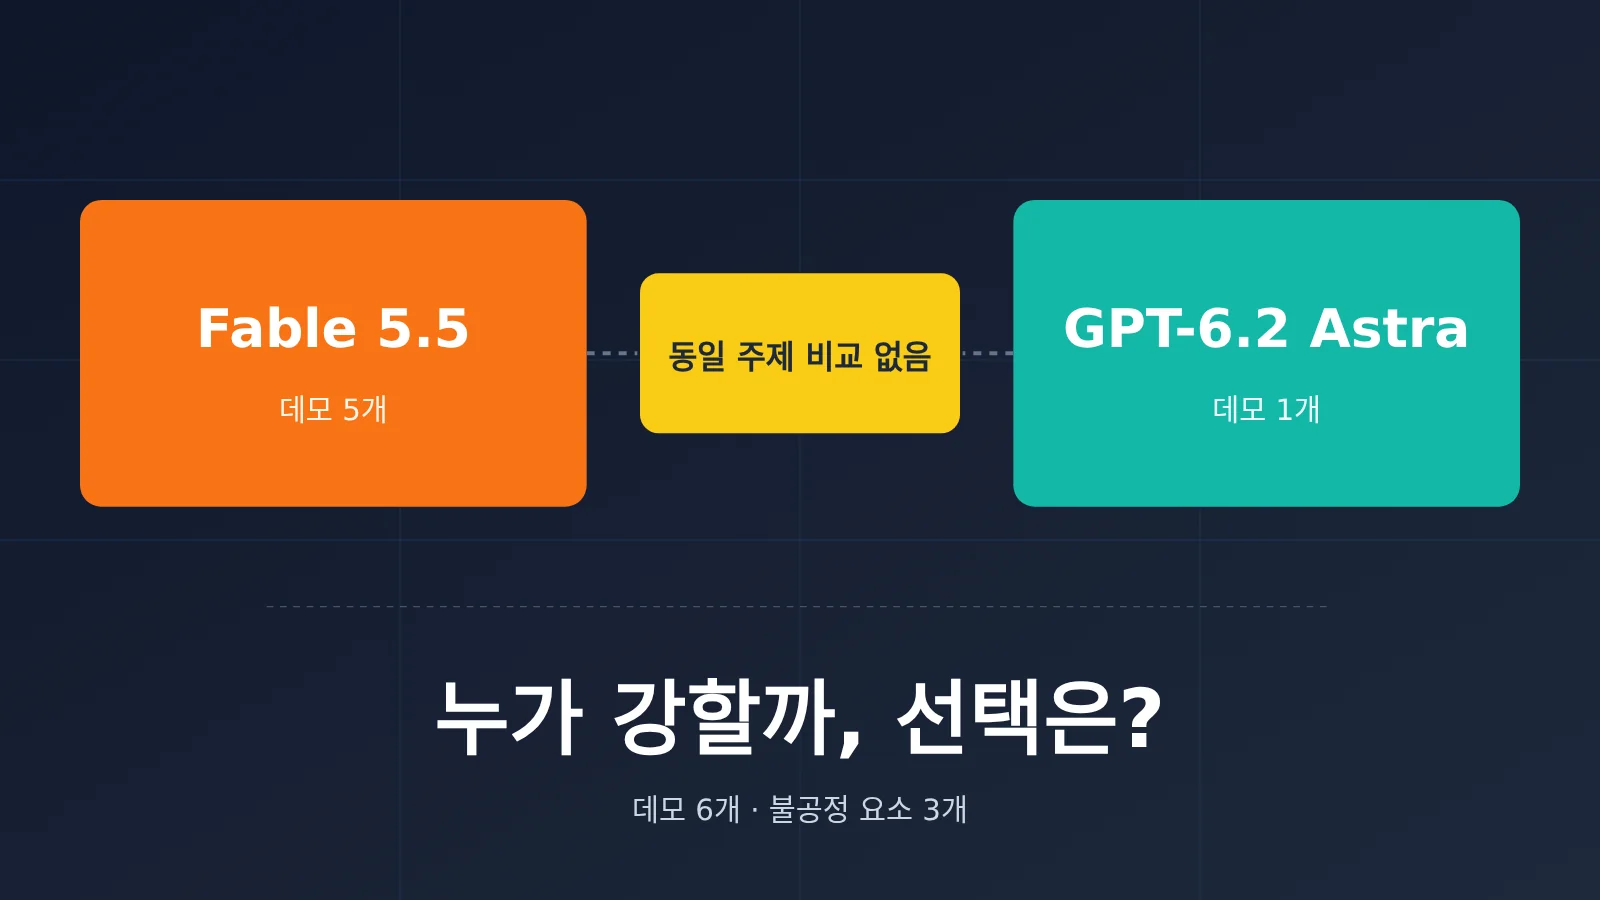
결론부터 말하면, Fable 5.5와 GPT-6.2 Astra 중 어느 쪽이 더 뛰어난지는 아직 알 수 없어요. 두 모델 모두 정식 출시되지 않았어요. 2026-11-03 기준으로 Anthropic의 모델 목록에는 여전히 Fable 5.1이, OpenAI의 모델 목록에는 GPT-6 Astra가 올라와 있어요(출처: 양사 공식 모델 페이지, 증거 수준: 공식 문서). 두 모델의 공개 데모는 모두 제3자 테스트 사이트인 Model Tests에 올라와 있고 제작자는 @notjazii예요. 하지만 같은 과제를 수행한 결과는 아니에요. Fable 5.5에는 게임, 단편 영상, SVG, WebGL 등 작품 5개가 있고, GPT-6.2 Astra에는 픽셀 애니메이션 GIF 1개만 있어요. 과제가 다르니 어느 쪽이 이겼다고 말할 수 없어요.
그래서 이 글에서는 순위를 매기지 않고 세 가지 질문에 답해요. 이 데모들이 무엇을 입증할 수 있고 무엇은 입증할 수 없는지, 지금 비교할 수 있는 Fable 5.1과 GPT-6 Astra의 공식 사양은 어떻게 다른지, 그리고 새 모델이 출시되면 모델 이름만 바꿔 다시 실행할 수 있는 20~50개 과제의 자체 평가를 어떻게 준비하는지 살펴봐요. Mythos 5.5, Gemini 4 Carbon 같은 다른 소문은 다루지 않아요.
이 글은 “둘 다 나름의 장점이 있다”는 식으로 결론을 흐리는 글이 아니에요. 증거가 부족한 부분은 부족하다고 명확히 밝히고, 판단할 수 있는 부분은 직접 권장 사항을 제시해요.
Fable 5.5 vs GPT-6.2 Astra 공개 데모 목록
판단: 데모는 모델이 실행 가능한 완성물을 만들 수 있다는 점을 보여주지만, 양쪽의 과제와 수량, 모델 등급이 달라 직접 비교할 수는 없어요.
Model Tests 사이트에는 총 11개 프로젝트와 8개 모델이 등록돼 있으며, 각 항목에 날짜, 모델, 유형이 표시돼 있어요(출처: 사이트 페이지, 증거 등급: 커뮤니티 자체 주장). 아래 표에는 Fable 5.5와 GPT-6.2 Astra 이름으로 등록된 작품 6개를 모두 정리했어요. 모델 출처는 모두 제작자가 직접 밝힌 내용이에요.
| 작품 | 제작자가 표기한 모델 | 유형 | 날짜 | 주요 내용 |
|---|---|---|---|---|
| VoxelCraft | Fable 5.5 xhigh | 플레이 가능한 HTML 게임 | 2026-11-01 | 단일 파일 《마인크래프트》 클론. 생존/크리에이티브 모드, 조합, 화로, 인챈트, 레드스톤, 주민, 다양한 생물 군계, 네더와 엔드 포함 |
| The Last Page | Fable 5.5 xhigh | 66초 음성 단편 영상 | 2026-11-02 | 여우, 달빛 도서관, 책장 폭풍, 구름 위로 날아가는 장면 |
| Open Me | Fable 5.5 xhigh | WebGL 인터랙티브 체험 | 2026-11-02 | 레이 마칭을 적용한 WebGL2와 생성형 음악, 외장 GPU 필요 |
| Acorn Bread on a Stick | Fable 5.5 xhigh | 직접 작성한 SVG | 2026-11-02 | 도토리 빵 일러스트 |
| Fruit Basket | Fable 5.5 max | 순수 벡터 정물화 | 2026-11-02 | 3000×2400, 비트맵 없이 제작한 사실적인 과일 바구니 |
| Tsukimi Moon Ferry | GPT 6.2 Astra Max | 픽셀 애니메이션 GIF | 2026-11-02 | 보름달 아래 일본풍 강변 마을: 성, 후지산, 붉은 다리, 날아오르는 잉어, 물에 띄운 등불, 나룻배 |
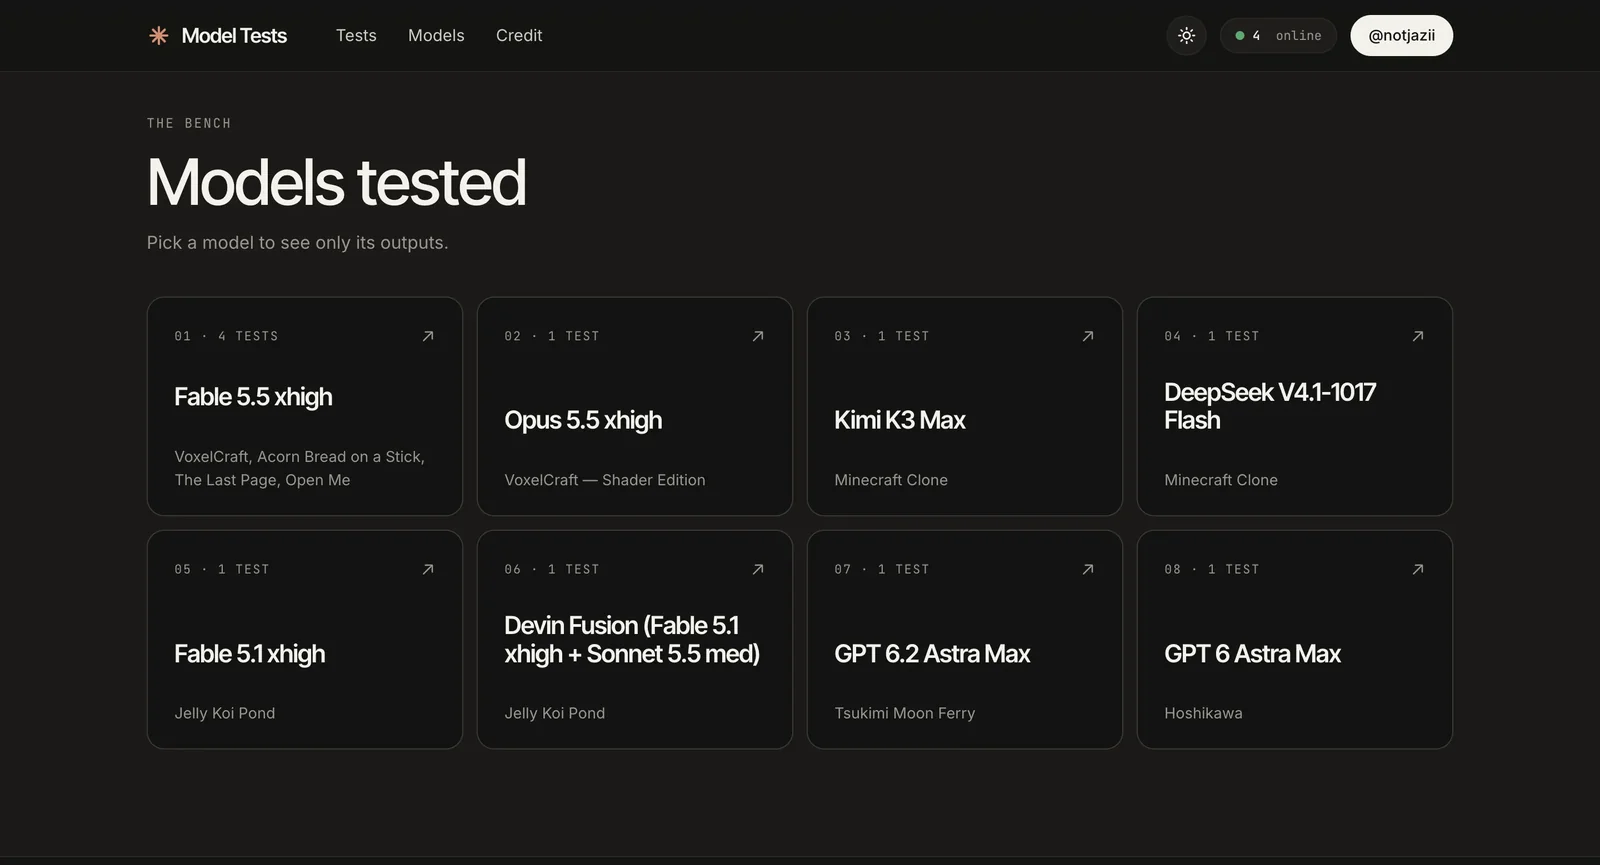
그림 설명: Model Tests의 모델 목록. Fable 5.5 xhigh로 등록된 테스트는 4개, GPT-6.2 Astra Max는 1개, GPT-6 Astra Max도 1개예요(스크린샷 2026-11-03).
사이트에는 비교 기준으로 삼을 만한 작품도 몇 개 있어요. Hoshikawa는 GPT 6 Astra Max로 표기된 작품으로, 보름달 아래 일본풍 마을을 그린 픽셀 애니메이션이에요(2026-11-02). Tsukimi Moon Ferry와 스타일이 비슷해 사이트 내에서 거의 같은 주제로 만든 OpenAI 신·구 모델의 유일한 비교 사례예요. VoxelCraft — Shader Edition은 Opus 5.5 xhigh로 표기돼 있으며(2026-11-01), Fable 5.5의 VoxelCraft와 같은 과제예요. 이 밖에도 Kimi K3 Max와 DeepSeek V4.1-1017 Flash가 각각 Minecraft 클론을 하나씩 만들었어요(2026-10-17).
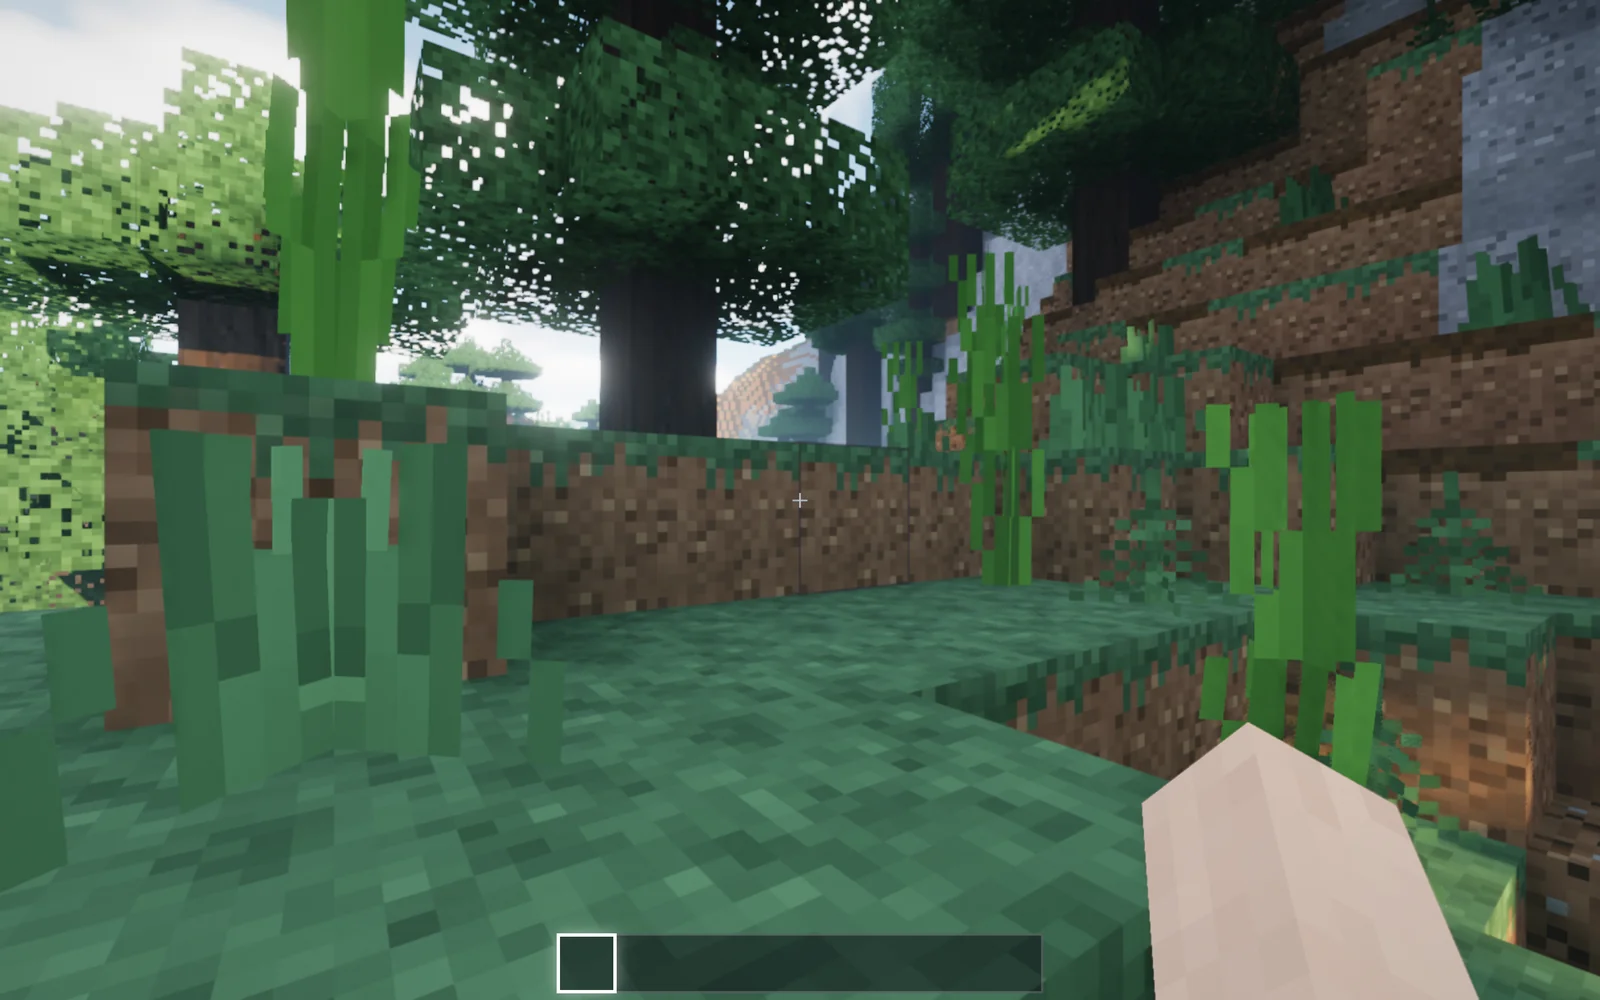
그림 설명: Fable 5.5 xhigh의 VoxelCraft. 단일 파일로 만든 《마인크래프트》 클론으로, 열면 바로 움직일 수 있어요(스크린샷 2026-11-03).
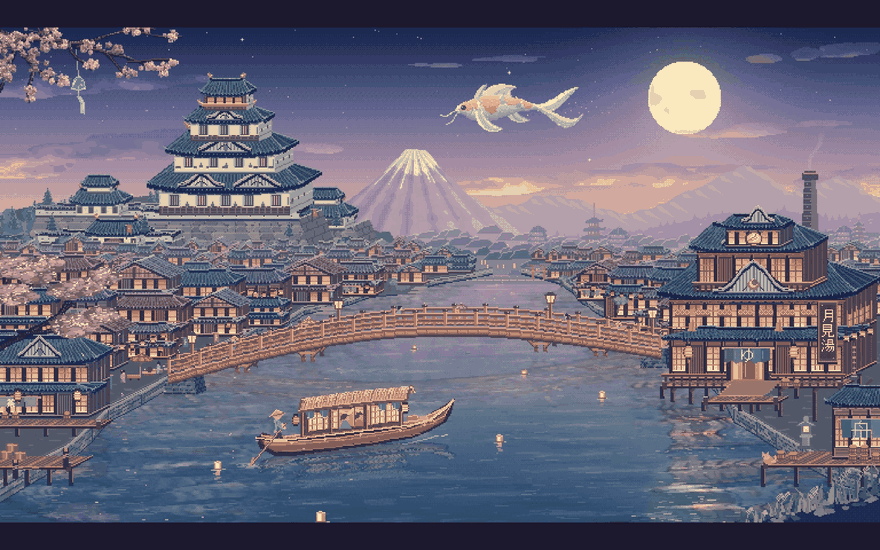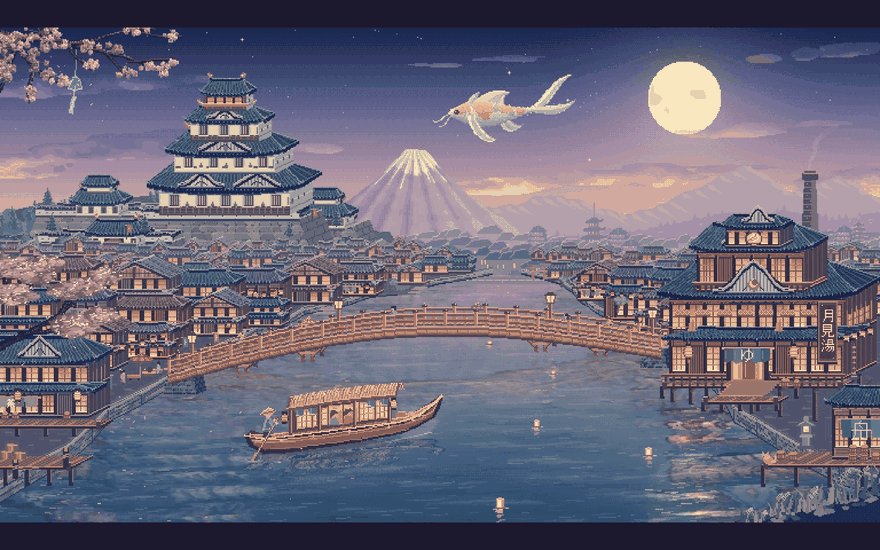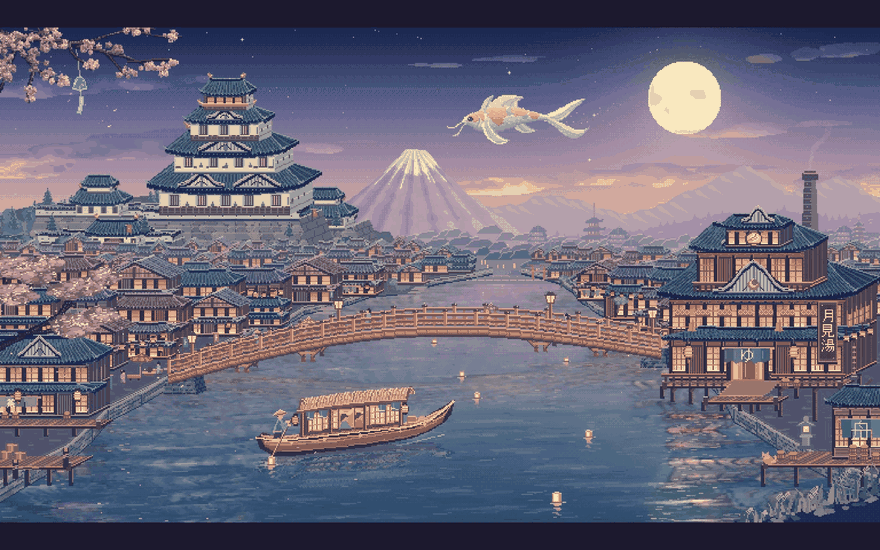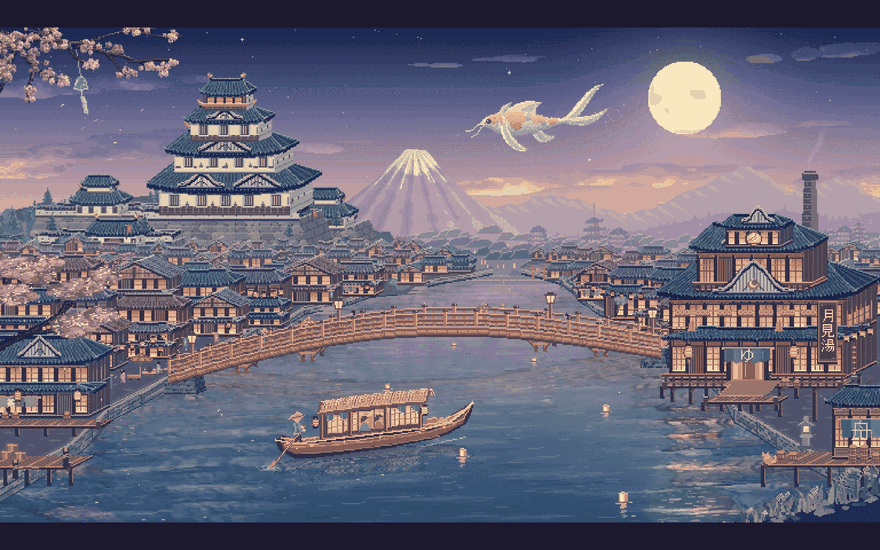
그림 설명: GPT-6.2 Astra Max의 Tsukimi Moon Ferry. 보름달 아래 일본풍 강변 마을을 그린 픽셀 애니메이션 GIF예요(화면 녹화 2026-11-03).
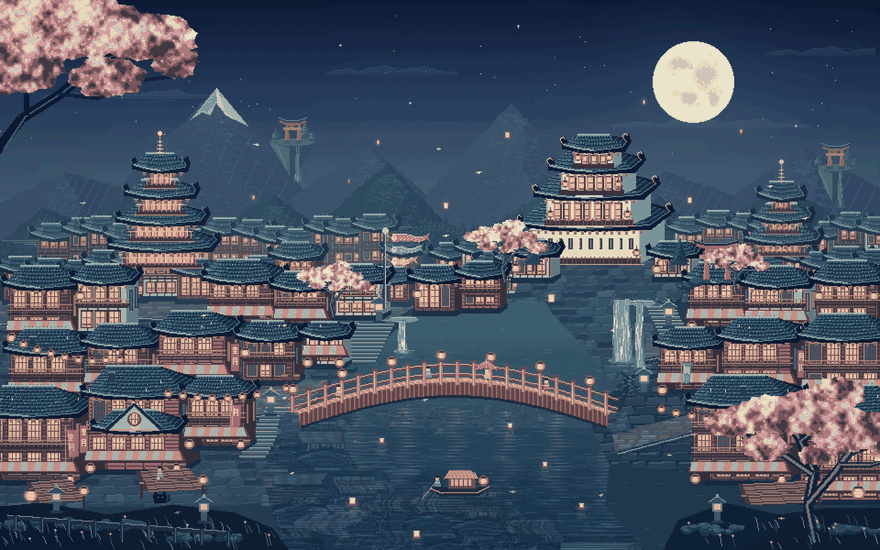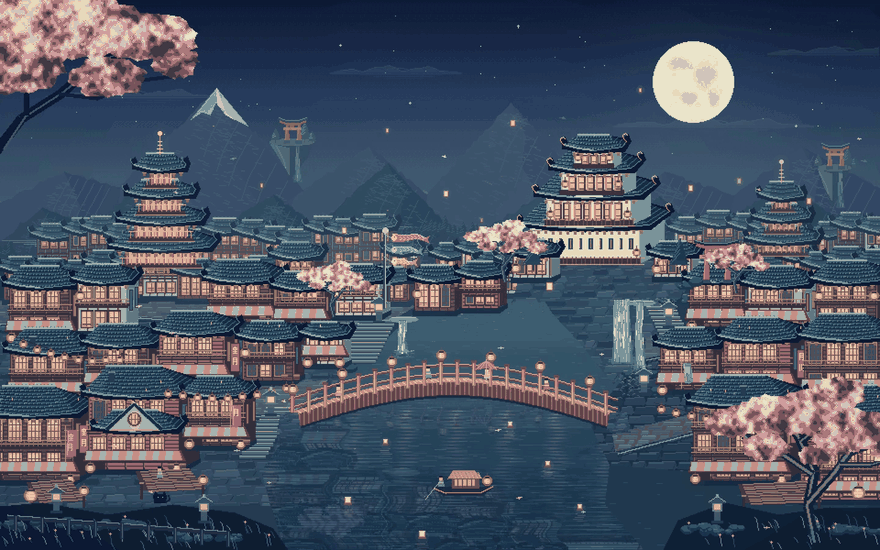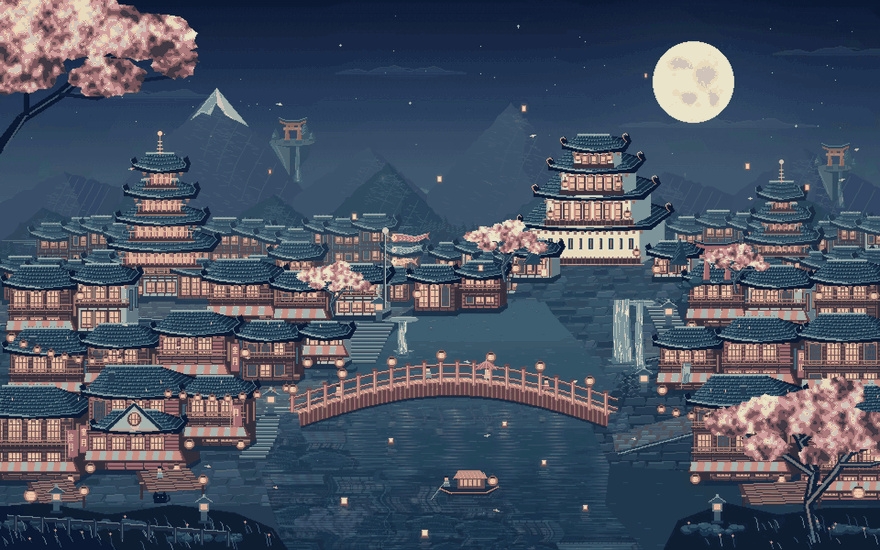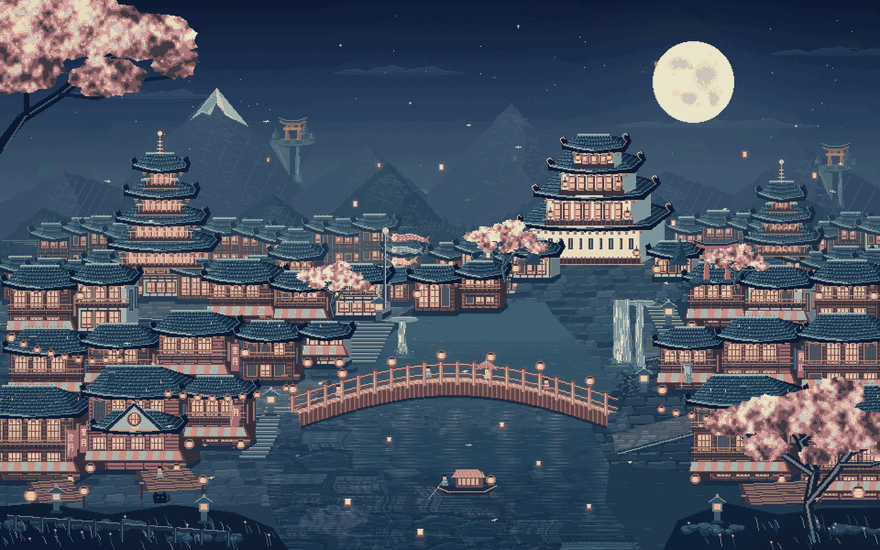
그림 설명: 비교 대상으로 사용한 GPT-6 Astra Max의 Hoshikawa. 같은 사이트의 같은 스타일 작품으로, 6.2의 픽셀 애니메이션과 비교하기 위한 영상이에요(화면 녹화: 2026-11-03).
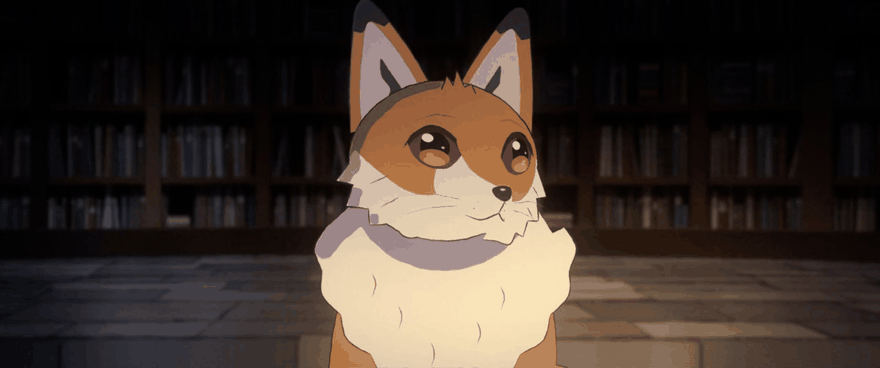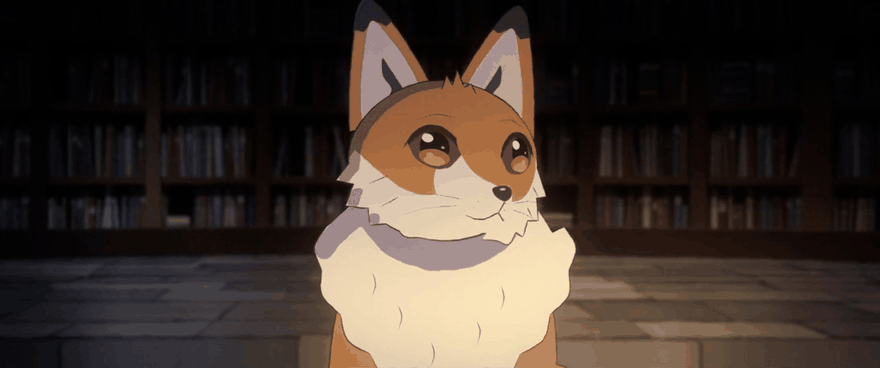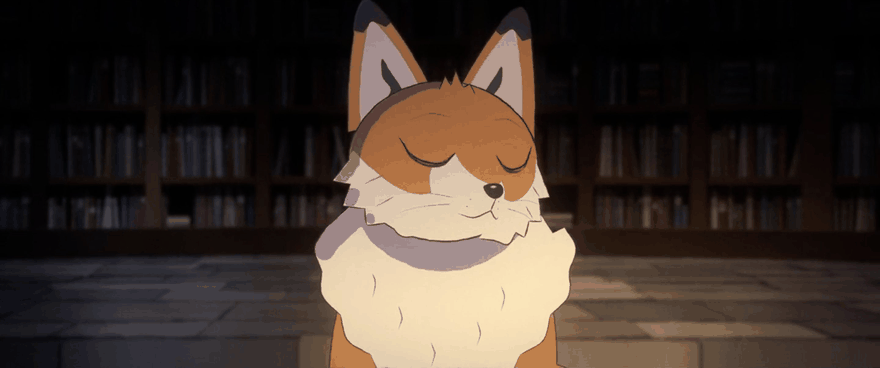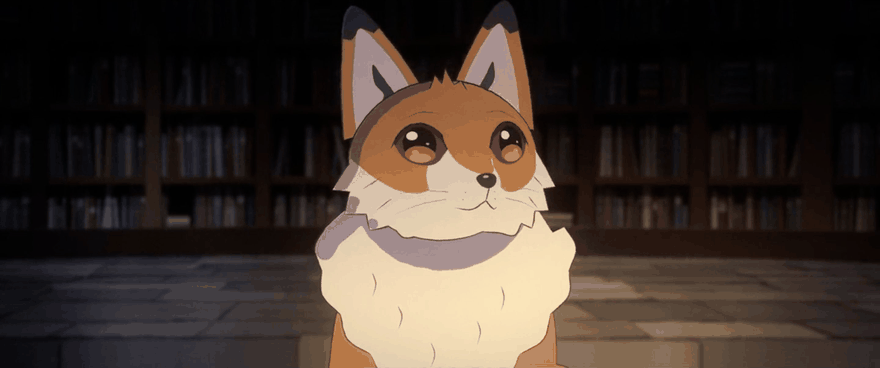
그림 설명: Fable 5.5 xhigh로 만든 66초짜리 유성 단편 The Last Page에서 여우가 달빛이 비치는 도서관에 있는 장면이에요(GIF 발췌: 2026-11-03, 소리 없음).
사이트에서 비용과 소요 시간이 공개된 작품은 Jelly Koi Pond뿐이에요. Fable 5.1 xhigh 버전은 약 1시간 40분에 $25가 들었고, Devin Fusion 조합(Fable 5.1 xhigh와 Sonnet 5.5 med)은 약 1시간에 $11가 들었어요(날짜: 2026-10-21, 근거 수준: 커뮤니티 자체 보고). 이 작품을 제외하면 사이트에 소요 시간이나 비용이 공개된 작품은 없으며, 이 글에서도 별도로 추정하지 않아요.
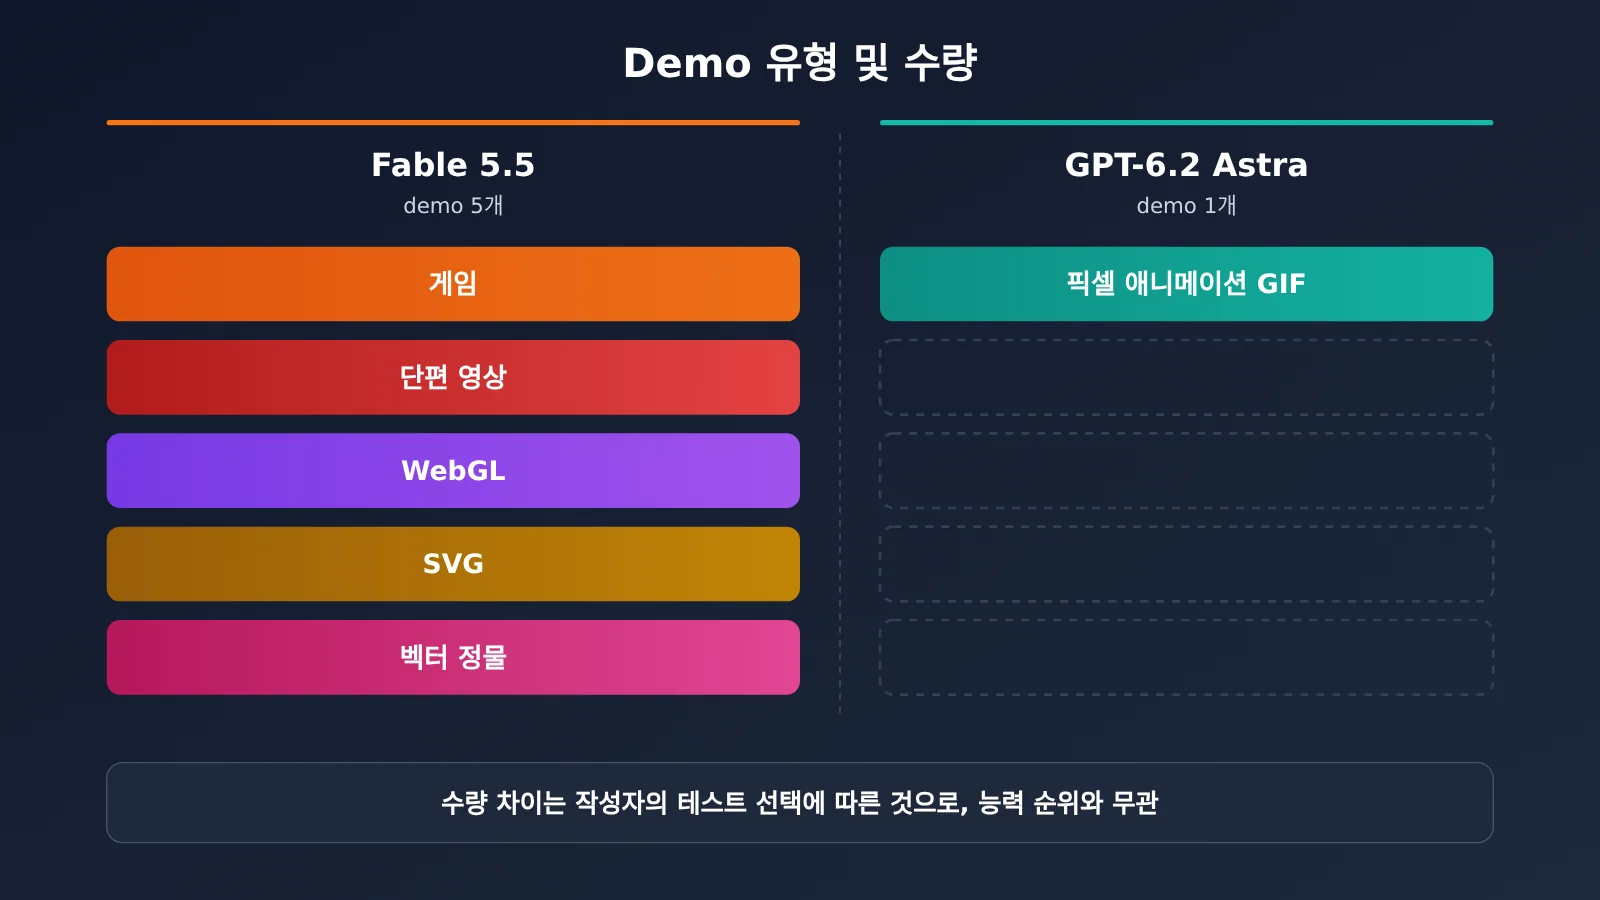
위 그래프는 데모의 유형과 수량 분포를 보여줄 뿐, 능력 순위는 아니에요. 자신의 작업에서 두 회사의 현역 플래그십 모델이 실제로 얼마나 차이 나는지 확인하고 싶다면, APIYI apiyi.com에서 동일한 API 키로 claude-fable-5-1과 gpt-6-astra를 각각 호출해 볼 수 있어요.
Fable 5.5 vs GPT-6.2 Astra: 공정해 보이지만 사실은 불공정한 세 가지 비교
판단: 같은 사이트의 같은 작성자가 올린 결과라 직접 비교처럼 보이지만, 적어도 세 가지 측면에서 조건이 달라요.
불공정한 점 1: 과제가 완전히 달라요
Fable 5.5의 작품 5개는 게임, 단편 영상, WebGL, SVG 네 가지 분야를 다루지만, GPT-6.2 Astra는 픽셀 애니메이션 한 분야뿐이에요. 두 모델이 공통으로 수행한 과제도 하나도 없어요. 픽셀 애니메이션은 구도와 프레임 간 일관성을, 단일 파일 게임은 긴 코드의 구성과 상태 관리를 평가하므로 결과를 서로 환산할 수 없어요. 같은 과제를 기준으로 참고하려면 GPT-6.2 Astra는 같은 사이트의 GPT-6 Astra(Hoshikawa)와, Fable 5.5는 Opus 5.5(VoxelCraft — Shader Edition)와만 비교할 수 있어요.
불공정한 점 2: 추론 단계, 날짜, 수량이 모두 다르다
Fable 5.5의 결과물은 대부분 xhigh로 표시되어 있고, Fruit Basket만 max예요. GPT-6.2 Astra는 Max로 표시되어 있어요. 단계가 다르면 추론 예산도 다르기 때문에 결과물의 품질을 직접 비교하기 어려워요. 수량도 5 대 1이지만, 이는 작성자가 무엇을 테스트할지 선택한 결과일 뿐 공식 평가 결과는 아니에요. 데모 수를 성능의 우열로 받아들이는 것이 이번 논의에서 가장 흔한 오해예요.
세 번째 불공정 요소: 어떤 모델이 사용됐는지 확인할 수 없어요
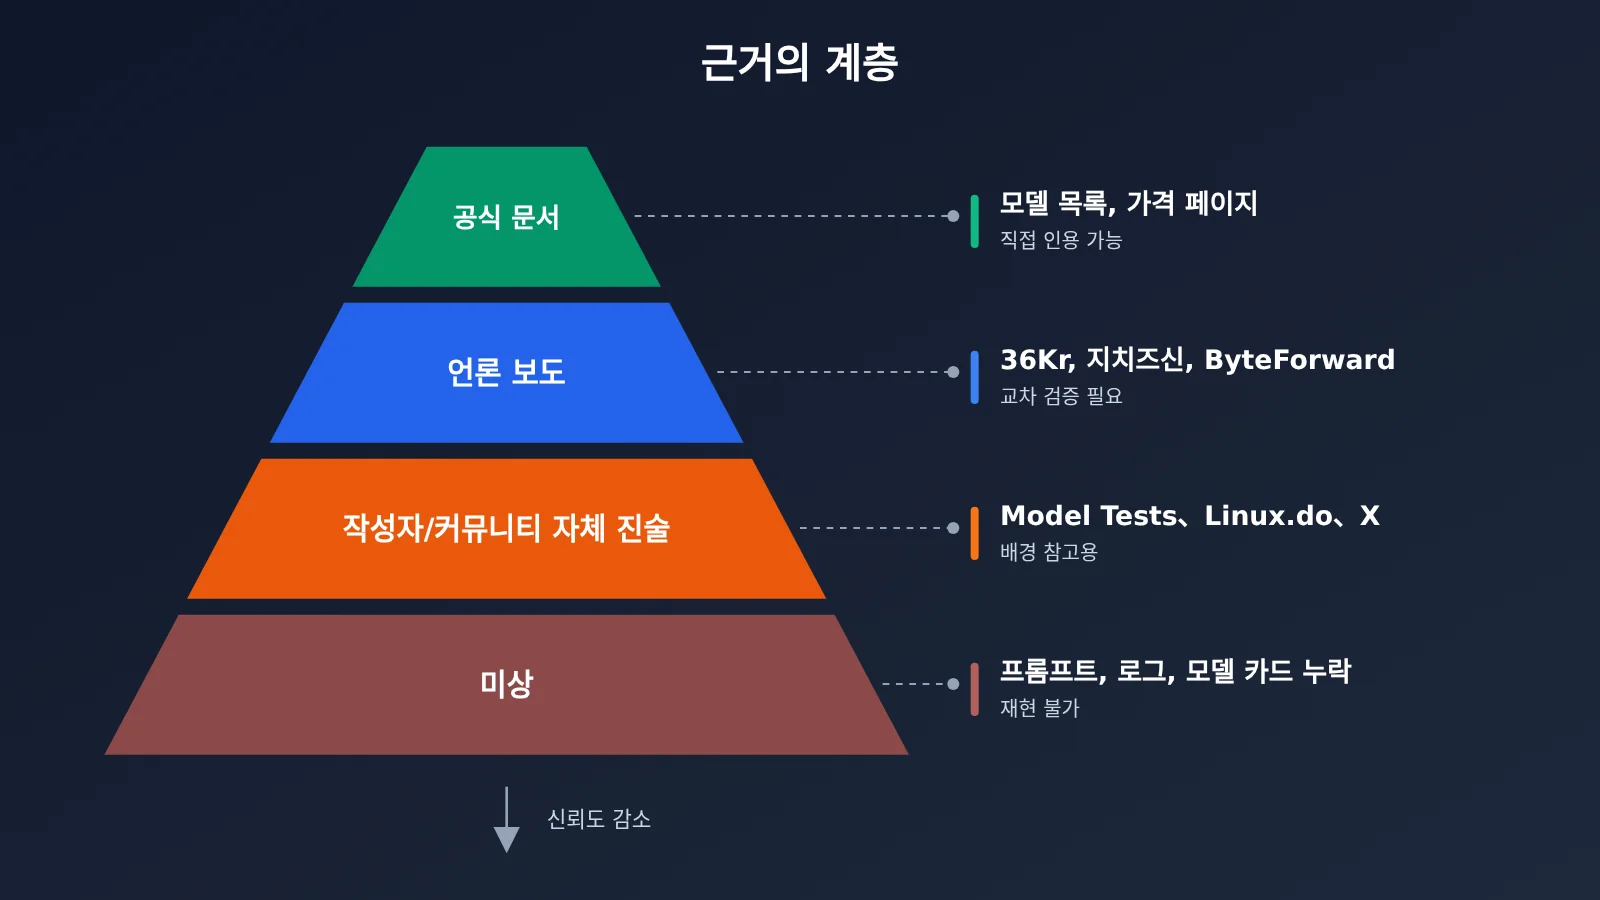
어떤 데모도 프롬프트, 호출 로그, 모델 카드를 공개하지 않았기 때문에 어떤 모델이 사용됐는지는 전적으로 작성자의 표기에 의존해요. ByteForward는 11-02 확인 과정에서 “Fable 5.5”로 표시된 일부 데모가 실제로는 Opus 5.5 요청이 새 모델로 라우팅된 것일 수 있으며, 모델 선택기에는 여전히 Opus 5.5가 표시됐다고 전했어요(증거 등급: 단일 매체 보도). 이 상황에서는 “작성자가 Fable 5.5라고 주장한다”라고만 쓸 수 있고, “Fable 5.5가 만들었다”라고 단정할 수는 없어요.
아래 표는 두 모델과 관련된 현재까지의 주장을 증거 등급별로 정리한 것이에요. 팀 내에서 내용을 전달할 때도 증거 등급을 함께 남겨두는 것이 좋아요.
| 주장 | 출처 | 날짜 | 증거 등급 |
|---|---|---|---|
| Anthropic 카탈로그에는 여전히 Fable 5.1만 있고 Fable 5.5는 없음 | Anthropic 가격 페이지 및 뉴스 페이지 | 11-03 확인 | 공식 문서 |
| OpenAI 카탈로그에는 여전히 GPT-6 Astra만 있고 GPT-6.2 Astra는 없음 | OpenAI 모델 카탈로그 | 11-03 확인 | 공식 문서 |
LiteLLM에 azure_ai/claude-fable-5-5 가격 항목 추가 |
TestingCatalog 기록 | 10-13 | 제3자 기록 |
| Fable 5.5가 1M 입력, 12.8만 출력 지원 | 36氪/新智元 | 11-02 | 단일 매체 보도 |
| GPT-6.2 Astra에 대한 종합 평가가 “눈에 띄게 도약” | 机器之心/新浪 | 11-02 | 매체 종합, 벤치마크 없음 |
| 사용량 내역에서 gpt-6.2-astra 비중 1.6% | Linux.do @fourfour | 11-01 | 커뮤니티 사용자 주장 |
| 사용량 내역에서 gpt-6.2-astra 비중 19.8% | X @TokenGremlin | 11-01 | 커뮤니티 사용자 주장 |
| Model Tests 데모에 사용된 모델 | 작성자 @notjazii | 11-01~11-02 | 작성자 주장 |
| 일부 Fable 5.5 데모는 실제로 Opus 5.5 요청이 라우팅된 결과 | ByteForward | 11-02 | 단일 매체 보도 |
GPT-6.2 Astra의 트래픽 데이터는 별도로 살펴볼 필요가 있어요. Linux.do 게시물에 공개된 10/25부터 10/31까지의 Codex 사용량 분포에서는 여전히 gpt-6-astra가 97.7%를 차지했고, gpt-6.2-astra는 1.6%에 불과했어요. 같은 게시물의 청구 내역 13개 중 12개도 gpt-6-astra였고, 속도는 44~73 tok/s였어요. X의 TokenGremlin이 공개한 자료에서는 19.8%로 나타났으며, 이 자료가 더 널리 퍼졌어요(조회수 약 15.5만 회). 두 수치 모두 개인 계정의 스크린샷일 뿐 공식 데이터는 아니에요. 机器之心도 스크린샷은 “접근 권한을 얻었다고 보고한 사용자가 있다”는 사실만 증명한다고 명시했어요. 한편 GPT-6.2 Betelgeuse / Bel은 그보다 앞서 알려진 별도의 기반 모델 코드명으로, 6.2 Astra와는 달라요.
커뮤니티의 체감 평가도 서로 엇갈려요. Fable 5.5가 더 강하다는 의견도 있고 Opus 5.5와 비슷하다는 의견도 있어요. GPT-6.2 Astra에 대해서도 Opus 5.5보다 못하다는 의견, 점진적인 개선에 그쳤다는 의견, 여러 측면에서 Opus 5.5를 앞선다는 의견이 나와요. 이런 주장에는 모두 벤치마크와 표본 규모가 없어 참고 자료로만 봐야 해요.
Fable 5.1 vs GPT-6 Astra 공식 사양과 가격 비교
결론: 신규 모델의 공식 사양은 아직 공개되지 않아 현재 서비스 중인 플래그십 모델만 비교할 수 있어요. 두 모델의 단가는 같지만, 긴 입력에 대한 과금, 지식 기준 시점, 추론 단계가 다릅니다.
Fable 5.1과 GPT-6 Astra의 공식 단가는 모두 입력 $10, 출력 $50(백만 토큰당)이에요. 최대 출력은 둘 다 128K이고, 컨텍스트 윈도우는 각각 1M과 1.05M입니다. 아래 표는 2026-11-03에 확인한 양사의 공식 모델 페이지를 바탕으로 작성했으며, 근거는 공식 문서입니다.
| 사양 | Fable 5.1 | GPT-6 Astra |
|---|---|---|
| 모델 ID | Anthropic 공식 Fable 5.1 | gpt-6-astra |
| 컨텍스트 윈도우 | 1M | 1.05M |
| 최대 출력 | 128K | 128K |
| 지식 기준 시점 | 2026-06 | 2026-04-30 |
| 추론 제어 | Adaptive thinking 상시 활성화, 기본 effort는 high | low / medium / high / xhigh / max |
| 도구 기능 | 공식 문서 참조 | 함수 호출, 웹 검색, 파일 검색, computer use |
추론 제어 방식의 차이는 평가 설계에도 직접 영향을 줘요. Fable 5.1은 Adaptive thinking이 항상 활성화되어 있고 기본 effort가 high인 반면, GPT-6 Astra는 다섯 단계 중에서 선택할 수 있어요. 두 모델의 단계 명칭은 서로 대응하지 않으므로, 같은 단계로 맞추더라도 완전히 동등하다고 볼 수는 없습니다. 평가할 때는 high와 high가 같다고 가정하기보다 각 단계를 기록 항목으로 남기는 것이 좋아요.
가격은 공식 단가가 같지만 세부 과금 방식은 크게 달라요. 아래 표에는 공식 가격과 APIYI 플랫폼의 등록 가격을 함께 정리했습니다. 가격은 백만 토큰당 미국 달러 기준이에요.
| 과금 항목 | Fable 5.1 공식 | GPT-6 Astra 공식 | APIYI apiyi.com 등록 가격 |
|---|---|---|---|
| 입력 | $10 | $10 | claude-fable-5-1 $10; gpt-6-astra 0~272,000 tokens는 $10 |
| 긴 입력 | 1M 이내에서 $10 유지 | 공식 페이지 참조 | gpt-6-astra 272,001~1,050,000 tokens는 $20 |
| 출력 | $50 | $50 | 둘 다 $50 |
| 캐시 히트/읽기 | $0.25 | 공식 페이지 참조 | claude-fable-5-1 $0.25; gpt-6-astra $1 |
| 캐시 쓰기 | 5분 $12.50, 1시간 $20 | 공식 페이지 참조 | 플랫폼 모델 목록 참조 |
| 엔드포인트 | messages | responses, chat | claude-fable-5-1: chat / messages; gpt-6-astra: responses / chat |
긴 문서 분석이나 대형 코드베이스 이해 작업을 하는 팀에는 “누가 더 강한가”보다 이 표가 유용할 수 있어요. 단일 입력이 27.2만 tokens를 넘으면 gpt-6-astra의 입력 가격은 $20로 두 배가 되지만, claude-fable-5-1은 1M 범위 내에서 $10를 유지합니다. 캐시 읽기 가격도 4배 차이($0.25 대 $1)가 나요. 동일한 긴 컨텍스트로 반복 호출한다면 이 두 가지 차이가 청구 금액에 뚜렷하게 드러납니다. 모델과 가격은 플랫폼 모델 목록을 확인하세요.
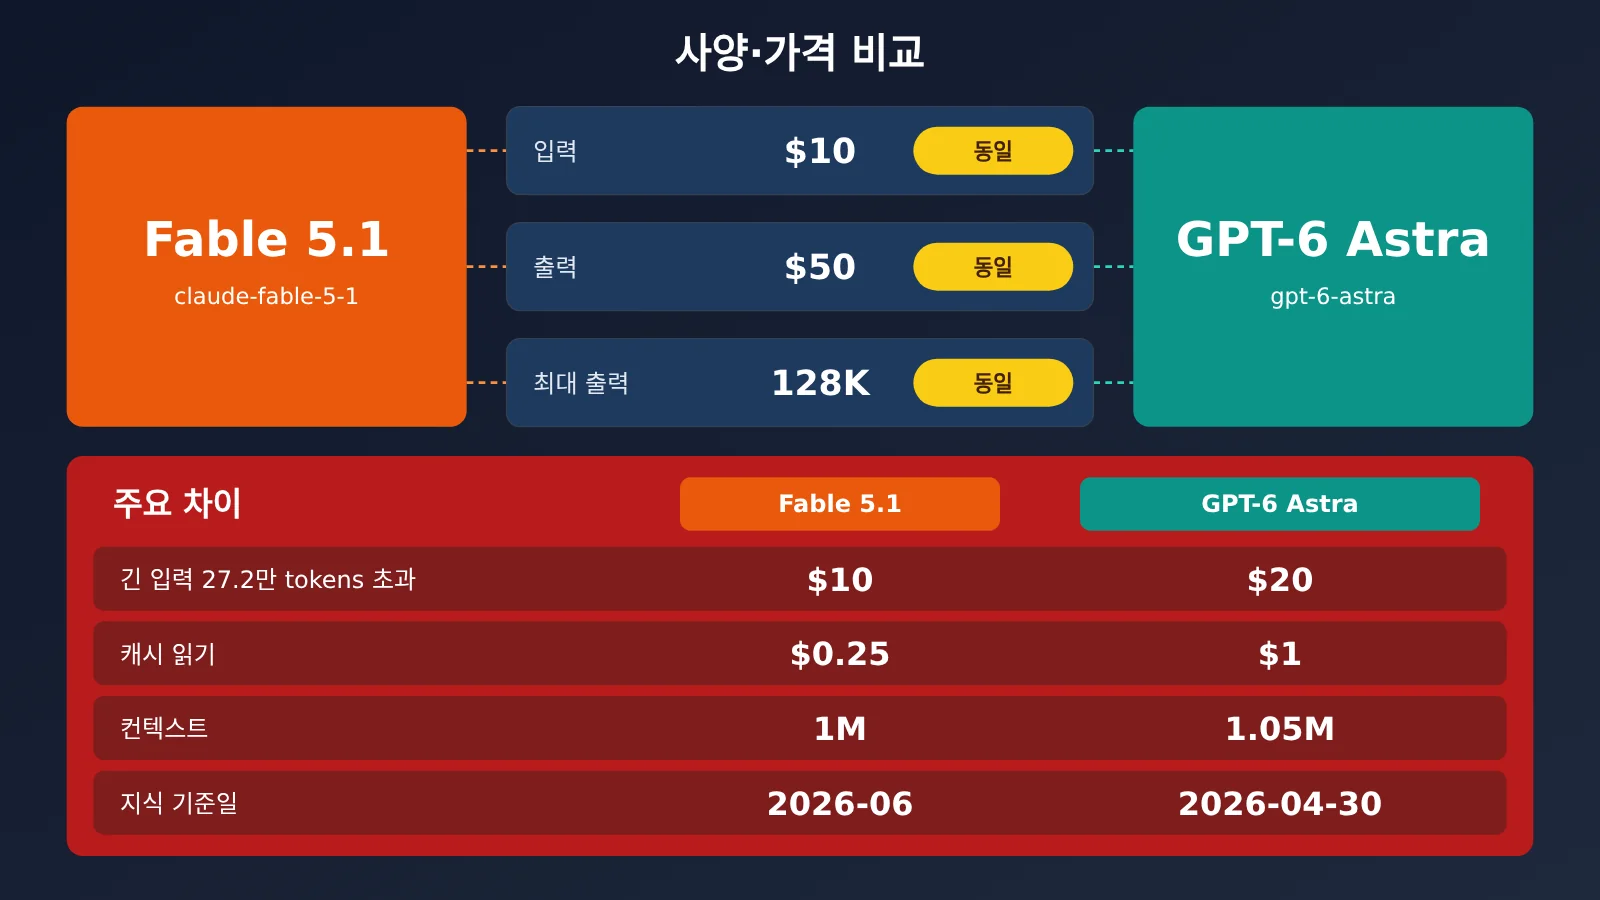
그림의 가격은 공식 모델 페이지와 APIYI apiyi.com 플랫폼의 가격 인터페이스에서 가져왔으며, 조회 시점은 2026-11-03입니다.
Fable 5.5와 GPT-6.2 Astra 출시 전, 지금 사용할 수 있는 모델은?
결론: 새 모델의 공식 API는 아직 없어요. 지금은 두 회사의 현역 플래그십 모델로 기준 성능을 측정하고 평가 체계를 미리 구축할 수 있어요.
2026-11-03 기준 APIYI 플랫폼의 모델 인터페이스는 259개 모델을, 가격 인터페이스는 총 277개 모델을 반환했어요. 여기에는 gpt-6-astra, gpt-6.1-sol, gpt-6.1-terra, gpt-6-luna, claude-fable-5-1이 포함되어 있지만, gpt-6.2-astra와 claude-fable-5-5는 없어요. 즉, 두 회사의 현역 플래그십 모델은 이미 하나의 API 키로 기준 성능을 비교할 수 있어요. 같은 날 claude-fable-5-1에 max_tokens를 32로 설정해 messages 요청을 보낸 결과 HTTP 200이 반환되어, 인터페이스를 사용할 수 있음을 확인했어요.
연동 방식은 OpenAI SDK와 호환돼요. base_url을 https://api.apiyi.com/v1로 설정하고 모델 이름에 각각 claude-fable-5-1과 gpt-6-astra를 입력하면 돼요. Anthropic 네이티브 messages 형식이 필요하다면 claude-fable-5-1에서도 지원해요. gpt-6-astra는 responses 또는 chat 엔드포인트를 사용할 수 있어요.
🚀 빠른 시작: APIYI apiyi.com에 가입한 뒤 신규 사용자 무료 테스트 크레딧으로
claude-fable-5-1과gpt-6-astra에 각각 3~5개 작업을 시범 실행해 보세요. 출력 형식과 토큰 기록이 정상인지 확인한 후 전체 평가 문제로 확대하면 돼요.
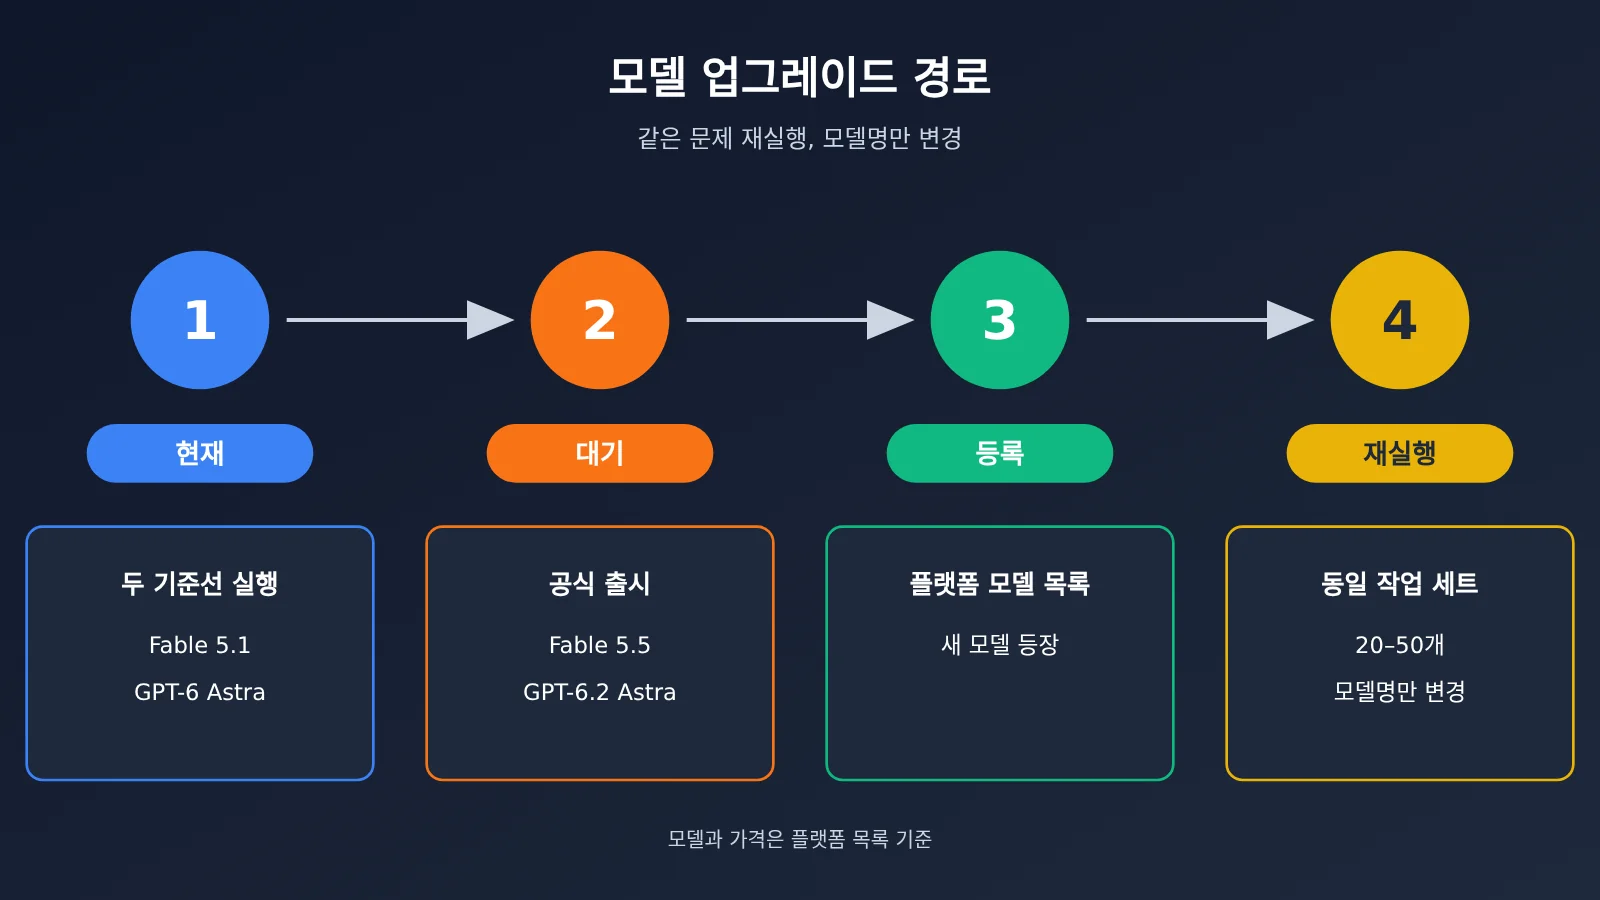
이 단계의 가치는 새 모델의 성능을 미리 알아내는 데 있지 않아요. 평가 문제, 채점 기준, 기록표를 미리 준비하는 데 있어요. Fable 5.5 또는 GPT-6.2 Astra가 정식 출시되면 팀은 모델 이름만 바꿔 하루나 이틀 안에 자체 사용 환경에 맞는 결론을 얻을 수 있어요. 다른 사람의 데모나 스크린샷에 의존할 필요도 없고요.
Fable 5.5 vs GPT-6.2 Astra, 어떻게 선택하고 평가할까요?
결론: 새 모델을 기다릴 필요 없이 현재 사용할 수 있는 최상위 모델로 기준선을 먼저 잡으세요. 모델 선택은 공개 데모가 아니라 직접 만든 20~50개의 작업을 바탕으로 판단해야 해요.
2026-11-03 기준으로 Fable 5.5와 GPT-6.2 Astra는 아직 APIYI에 등록되지 않았어요. 모델이 출시되면 두 모델을 최대한 빠르게 등록할 예정이며, 모델명과 가격은 플랫폼의 모델 목록을 기준으로 확인해 주세요. 그전에는 아래 시나리오를 참고해 먼저 판단할 수 있어요.
- 긴 문서, 대규모 코드베이스, 반복되는 긴 컨텍스트:
claude-fable-5-1을 먼저 평가해 보세요. 입력이 1M 이내일 때 가격이 일정하고, 캐시 읽기 비용은 $0.25에 불과해 비용을 예측하기 쉬워요. - 추론 예산을 세밀하게 조정하거나 웹 검색 또는 computer use가 필요한 경우:
gpt-6-astra를 먼저 평가해 보세요. 추론 단계를 다섯 가지 중에서 선택할 수 있고, 공식 문서에 나온 도구 기능도 더 다양해요. - 단일 파일 프런트엔드, 창의적인 시각화 작업: 양쪽 모두 참고할 만한 결과물이 있지만, 제작자가 직접 주장한 사례일 뿐이에요. 아이디어를 얻는 용도로만 참고하고 직접 만든 과제로 검증해야 해요.
- 최신 지식이 중요한 경우: Fable 5.1의 지식 기준일은 2026-06, GPT-6 Astra는 2026-04-30으로 약 두 달 차이가 나요. 검색 도구를 함께 사용해 보완할 수 있어요.
자체 평가를 구성하는 방법
평가의 핵심은 “모든 조건을 고정하고 모델명만 바꾸는 것”이에요. 구체적인 단계는 다음과 같아요.
- 실제 업무에서 20~50개의 작업을 추려 코드, 긴 문서, 구조화된 출력 등 주요 유형을 포함하고, 각 작업의 통과 기준을 작성해요.
- 시스템 프롬프트, 사용자 프롬프트, 최대 출력 토큰 수와 추론 단계를 고정해요. Fable 5.1은 effort를, GPT-6 Astra는 단계 이름을 기록해요.
- 각 작업의 input tokens, output tokens, 전체 소요 시간, 사람이 판정한 통과 여부를 기록해요.
- 입력이 27만 2천 tokens를 넘는 작업은 별도로 표시하고, 실제 구간별 가격에 따라 비용을 계산해요.
- 먼저
claude-fable-5-1과gpt-6-astra로 두 기준선을 측정해요. 새 모델이 등록되면 모델명만 바꿔 동일한 과제를 다시 실행해요.
이후 모델 간 비교와 시점별 비교를 쉽게 하려면 기록표에 최소한 다음 항목을 포함하는 것이 좋아요.
| 항목 | 기록 내용 | 용도 |
|---|---|---|
| 작업 ID와 유형 | 코드 / 긴 문서 / 구조화 등 | 시나리오별 통과율 분석 |
| 모델명과 추론 단계 | 예: gpt-6-astra high |
재실행 시 동일한 조건 유지 |
| input / output tokens | 플랫폼이 반환한 usage | 작업별 실제 비용 계산 |
| 소요 시간 | 요청부터 전체 응답 완료까지 | 사용 경험 평가 |
| 사람의 통과 판정 | 예 / 아니요 + 이유 | 최종 품질 지표 |
💡 선택 팁: 같은 Key로 두 회사의 모델을 실행하면 여러 계정을 사용할 때 생기는 네트워크와 요청 제한 차이가 결과에 영향을 주는 것을 막을 수 있어요. APIYI apiyi.com을 통해 통일된 방식으로 호출하면 기록되는 usage 필드 형식도 같아 결과를 취합하기 쉬워요.
자주 묻는 질문과 활용 가이드
Q1: Model Tests의 데모로 Fable 5.5가 GPT-6.2 Astra보다 뛰어나다고 할 수 있나요?
그럴 수 없어요. 두 모델은 같은 과제를 수행하지 않았고, 추론 수준과 날짜, 결과물의 수도 달라요. 모델 명칭도 작성자의 주장일 뿐이에요. 작성자의 설명대로라면 두 모델 모두 실행하거나 감상할 수 있는 결과물을 만들 수 있다는 정도만 알 수 있어요.
Q2: Fable 5.5와 GPT-6.2 Astra는 출시됐나요? 언제 사용할 수 있나요?
2026-11-03 기준, 두 회사의 공식 모델 목록에 해당 모델이 없으며 신뢰할 만한 출시일도 알려지지 않았어요. APIYI에도 아직 등록되지 않았지만, 두 모델을 최대한 빨리 등록할 예정이에요. 모델과 가격은 플랫폼의 모델 목록을 확인해 주세요. 등록 후에는 APIYI apiyi.com의 모델 목록에서 바로 확인할 수 있어요.
Q3: 19.8% 트래픽 스크린샷은 믿을 만한가요?
X 사용자 TokenGremlin의 개인 스크린샷이에요. 그보다 앞선 Linux.do 게시물에는 1.6%로 표시됐고, 모델 선택기에는 여전히 GPT-6 Astra가 표시됐어요. 사용자별 보고도 일치하지 않아요. 두 수치 모두 커뮤니티 사용자의 자체 보고일 뿐 공식 데이터가 아니며, 일부 계정의 사용량 내역에 해당 모델명이 나타났다는 정도만 알 수 있어요.
Q4: 새 모델을 기다려야 할까요, 아니면 현재 출시된 플래그십 모델을 먼저 써야 할까요?
현재 출시된 플래그십 모델을 먼저 쓰는 편을 추천해요. Fable 5.1과 GPT-6 Astra는 단가가 같고 성능도 최상위권이라 지금 바로 프로덕션에 활용할 수 있어요. 평가용 문제 세트를 미리 구축하는 것이 더 중요해요. 그래야 새 모델이 출시됐을 때 빠르게 결론을 내릴 수 있어요. APIYI apiyi.com의 무료 테스트 크레딧으로 소규모 샘플을 먼저 실행해 평가 과정을 검증할 수 있어요.
Q5: 두 회사의 현재 플래그십 모델은 가격이 같은데, 비용에도 차이가 날 수 있나요?
네. `gpt-6-astra`는 단일 입력이 272,000 tokens를 넘으면 입력 가격이 $10에서 $20로 올라요. 캐시 읽기 가격은 $1이고, `claude-fable-5-1`은 $0.25예요. 긴 컨텍스트를 사용하고 캐시 적중률이 높은 환경에서 차이가 가장 크므로, 실제 토큰 사용 분포를 기준으로 계산하는 것이 좋아요.
실천 제안
이번 달에 모델을 선정하는 팀이라면 세 단계로 진행해 보세요. 먼저 이번 주에 실제 업무에서 과제 20~50개와 통과 기준을 정리하세요. 다음으로 APIYI apiyi.com에서 같은 API 키로 claude-fable-5-1과 gpt-6-astra를 실행해 두 기준선을 확보하고, 토큰 사용량과 소요 시간, 사람이 평가한 통과율을 기록하세요. Fable 5.5 또는 GPT-6.2 Astra가 정식 출시되어 플랫폼에 등록되면 모델명만 바꿔 같은 과제를 다시 실행하세요. 이렇게 하면 동일한 조건에서 실제 업무를 바탕으로 비교한 데이터를 얻을 수 있어요. 어떤 데모나 스크린샷보다 믿을 만한 자료가 될 거예요. 모델과 가격은 플랫폼의 모델 목록을 기준으로 확인하세요.
참고 자료
- OpenAI 모델 목록: GPT-6 Astra 공식 사양과 가격
- 링크:
developers.openai.com/api/docs/models - 설명: 2026-11-03 확인, 목록에 GPT-6.2 Astra 없음
- Anthropic 플랫폼 가격 및 모델 페이지: Fable 5.1 공식 사양, 가격 및 캐시 과금
- 링크:
platform.claude.com - 설명: 2026-11-03 확인, 가격 및 뉴스 페이지에 Fable 5.5 없음
- Model Tests 서드파티 테스트 사이트: 작성자 @notjazii의 공개 데모 모음
- 링크:
model-tests.vercel.app - 설명: 사용된 모델은 작성자의 주장에 근거하며, 프롬프트와 호출 로그는 없음
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 홈페이지에서 문의해 주세요. 모델과 연동 문서는 docs.apiyi.com에서 확인할 수 있어요.