작성자 노트: 고객 상담 품질 검수 요청을 예로 들어, GPT-6.2 Sol을 Responses API에서 사용할 때의 출력 검수, 세션 상태 유지, 백그라운드 결과 회수를 풀어볼게요.
결론부터 말하면: GPT-6.2 Sol을 프로덕션 시스템에 연결하려면 하나의 업무 작업을 네 가지 동작으로 나누고, 각각의 검수 기준을 따로 정의해야 해요. 네 가지는 UI 즉시 피드백, 시스템에 적재 가능한 결과, 턴 간 컨텍스트, 최종 상태예요. 스트리밍 이벤트는 화면 표시만 담당하므로, 저장 전에는 전체 응답을 받아 스키마와 비즈니스 검증을 통과해야 해요. 턴 간 정보는 누가 상태를 보유할지 먼저 정해야 하고, 백그라운드 작업은 응답 ID와 최종 상태만 신뢰해야 해요. 알림은 중복될 수 있으니 쓰기는 반드시 멱등해야 해요.
이 네 가지를 갖추려면 전제가 두 개 있어요. 첫째, 내장 도구나 사용자 정의 도구가 필요할 때는 GPT-6.2 마이그레이션 안내에 따라 Responses API를 사용해야 해요. 이 글도 Responses의 런타임 동작만 다뤄요. 둘째, API 중계 플랫폼을 통해 호출할 경우 백그라운드 모드, Webhook 같은 기능이 제공되는지는 플랫폼의 현재 설정을 기준으로 봐야 해요. APIYI(apiyi.com)에서는 gpt-6.2-sol이 responses와 chat 두 엔드포인트로 공개되어 있어요.
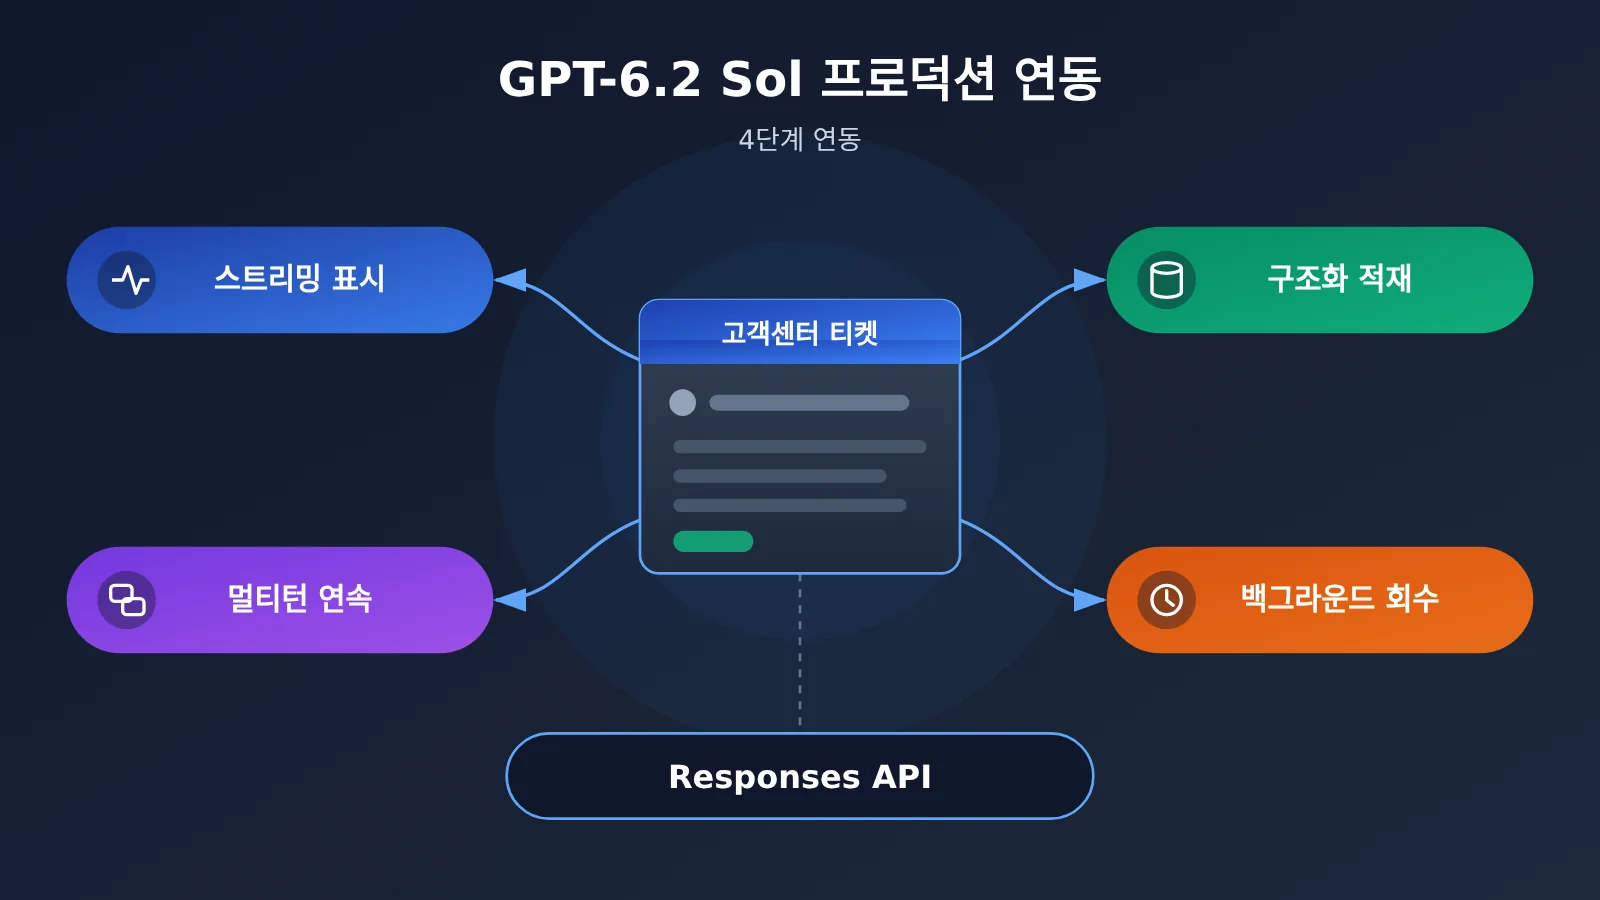
GPT-6.2 Sol 프로덕션 연동 지식 지도
이 글 전체는 하나의 흐름을 따라 전개돼요. 요청 시작 → 화면 표시 → 이어가기 → 다시 읽기 → 인수 검증이죠. 아래 흐름도는 각 단계의 산출물과 해당 본문 번호를 표시합니다.
요청 시작(model=gpt-6.2-sol, Responses API)
  │
  ├─▶ 표시【1절】
  │     증분 이벤트 → 페이지에 품질 검수 의견 실시간 표시
  │     최종 상태 이벤트 → 로딩 종료; 전체 응답 → Schema + 비즈니스 검증 → 저장 / 수동 검토
  │
  ├─▶ 이어가기【2절】
  │     자체 관리 히스토리 / previous_response_id / Conversation
  │     상시 규칙(developer)과 당회차 지시(instructions) 분리
  │
  ├─▶ 다시 읽기【3절】
  │     background 제출 → 응답 ID 저장 → Webhook 서명 검증·중복 제거 → ID로 재조회 → 최종 상태 저장
  │
  └─▶ 인수 검증【4절】
        성공 / 불완전 / 중복 알림 / 클라이언트 연결 끊김 / Schema 변경
GPT-6.2 Sol 연동 인덱스
| 절 | 답하는 질문 | 뒷부분에 무엇을 제공하는가 | 읽고 나면 할 수 있는 것 |
|---|---|---|---|
| 1. 스트리밍과 구조화 | 페이지는 스트림을 어떻게 보고, 시스템은 결과를 어떻게 받는가 | “완료”와 “저장 가능”의 판정 기준 정의 | 표시 경로와 저장 경로 구분 |
| 2. 멀티턴 상태 | 다음 회차 요청이 이전 회차와 어떻게 이어지는가 | 상태 보유 주체와 보존 조건 결정 | 당회차 초점만 바꾸고 프리픽스는 깨지 않기 |
| 3. 백그라운드 작업 | 사용자가 페이지를 떠난 뒤 결과가 어떻게 저장되는가 | 응답 ID, 작업 ID와 최종 상태의 대응 관계 | 서명 검증, 중복 제거, 멱등 쓰기 구현 |
| 4. 오픈 전 인수 검증 | 어떤 동작을 미리 검증해야 하는가 | 앞선 세 절의 판정 조건 요약 | 추적 가능한 회귀 기록 산출 |
1~3절은 각각 하나의 실행 경로에 대응해요. 그중 하나만 구현한다면 필요한 부분만 찾아봐도 됩니다. 4절은 앞 세 절에서 정의한 상태에 의존하니 마지막에 읽는 게 좋아요.
GPT-6.2 Sol 관련 용어 정리
| 용어 | 설명 |
|---|---|
| SSE | 서버가 하나의 HTTP 연결을 통해 클라이언트로 이벤트를 순서대로 푸시하는 프로토콜. |
| Structured Outputs | 성공적으로 반환되는 구조화 콘텐츠가 지원되는 JSON Schema를 준수하도록 요구하는 API 기능. |
| 거부 응답 | 모델이 작업 수행을 명시적으로 거부할 때 반환되는 콘텐츠 항목으로, 별도 흐름으로 처리해야 함. |
| 세션 상태 | 후속 요청을 위해 보존되는 메시지, 도구 결과 등의 컨텍스트. |
| 암호화 추론 항목 | 추론 상태를 이어가기 위해 사용하는 암호화된 응답 항목으로, 컨텍스트와 함께 되돌려 보낼 수 있음. |
| 프리픽스 | 현재 요청의 앞부분에서 이전 회차와 완전히 동일한 컨텍스트 시퀀스. |
| 완료 윈도우 | 서비스가 백그라운드 요청을 수락한 뒤 이 응답에 설정한 목표 완료 시간 범위. |
| Webhook | 서버가 애플리케이션이 지정한 URL로 능동적으로 보내는 서명 포함 알림. |
| 최종 상태 | 작업이 완료, 실패, 불완전 또는 취소된 이후의 최종 상태. |
| 멱등 | 동일한 콜백이나 작업이 중복 처리되더라도 비즈니스 효과는 한 번만 발생하는 성질. |
1. GPT-6.2 Sol 스트리밍 출력과 구조화된 검수
1.1 GPT-6.2 Sol의 두 가지 출력 경로
먼저 고객 상담 품질 검수 시나리오를 살펴볼게요. 당직 상담원이 티켓 하나를 열면, 페이지에는 모델이 제시한 검토 의견이 즉시 표시되어야 해요. 같은 분석 결과를 품질 검수 DB에도 기록해서 일 마감 통계에 사용해야 하고요. 이 두 요구사항은 ‘완료’의 정의가 달라서 두 경로로 나눠 처리해야 해요.
| 경로 | 사용처 | 의존 신호 | ‘완료’ 판정 조건 | 실패 시 이동 |
|---|---|---|---|---|
| 표시 경로 | 상담원 페이지 | response.output_text.delta 증분 이벤트 |
response.completed 또는 실패 계열 종료 이벤트 수신 |
페이지에 안내를 표시하고, 이미 표시된 내용은 유지 |
| 저장 경로 | 품질 검수 데이터베이스 | 전체 응답 객체 | 스키마 검증과 업무 검증을 모두 통과 | 거부, 불완전, 형식 오류는 각각 수동 검토로 이동 |
스트리밍 요청에서 stream=true를 설정하면 서버는 HTTP SSE를 통해 이벤트를 차례로 전송해요. 페이지는 response.output_text.delta의 텍스트를 덧붙여 표시하기만 하면 돼요. 로딩 상태는 종료 이벤트가 와야 끝나며, 텍스트 출력이 멈췄다고 해서 작업이 완료된 것은 아니에요.
1.2 GPT-6.2 Sol 스트리밍 표시 예시
아래 예시는 표시만 담당해요. 증분 텍스트를 프런트엔드로 넘기고, 최종 상태에서 로딩을 마무리해요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 엔드포인트
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # 페이지에 실시간 추가
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # 최종 상태로 로딩 종료
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # 실패와 불완전을 구분해 안내
push_to_page, finish_loading 등은 비즈니스 측 함수예요. 최종 상태 이벤트의 전체 목록은 공식 스트리밍 응답 문서를 기준으로 확인하세요.
1.3 GPT-6.2 Sol 구조화 출력의 검수 순서
Responses API에서 구조화 출력은 메시지가 아니라 text.format에 선언해요. 저장 경로에서 전체 응답을 받은 뒤에는 아래 순서로 판정해요:
- 응답 상태를 확인해요. 불완전 응답(
status가 incomplete)은 곧바로 수동 검수로 넘기고, 잘린 JSON을 억지로 파싱하지 않아요. - 콘텐츠 항목을 확인해요. 거부(refusal) 유형의 콘텐츠 항목이 나오면 형식 오류로 처리하지 않고 거부 절차로 보내요.
- JSON을 파싱하고 Schema 검증을 해요.
- 비즈니스 검증을 해요. 원본 티켓이 존재하는지, 누락 항목이 명확히 드러나는지 확인하고, 조용히 채워 넣지 않아요.
GPT-6.2 Sol 구조화 저장 전체 코드 보기
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
주의할 점은, Schema 검증을 통과했다는 건 구조가 맞다는 뜻일 뿐 내용이 맞다는 뜻이 아니에요. 티켓 번호가 실제로 존재하는지, 누락 항목이 사실대로 표시됐는지는 모두 비즈니스 계층에서 확인해야 해요.
🎯 기술 제안: 테스트 환경에서 APIYI apiyi.com을 통해 스트리밍과 비스트리밍 요청을 동시에 보내고, 같은 티켓이 두 경로에서 어떤 최종 상태와 저장 결과를 내는지 비교해 보세요. 이렇게 하면 프런트엔드 로딩 로직과 저장 분기가 서로 간섭하지 않는지 미리 확인할 수 있어요.
2. GPT-6.2 Sol 다중 턴 세션 상태 이어가기
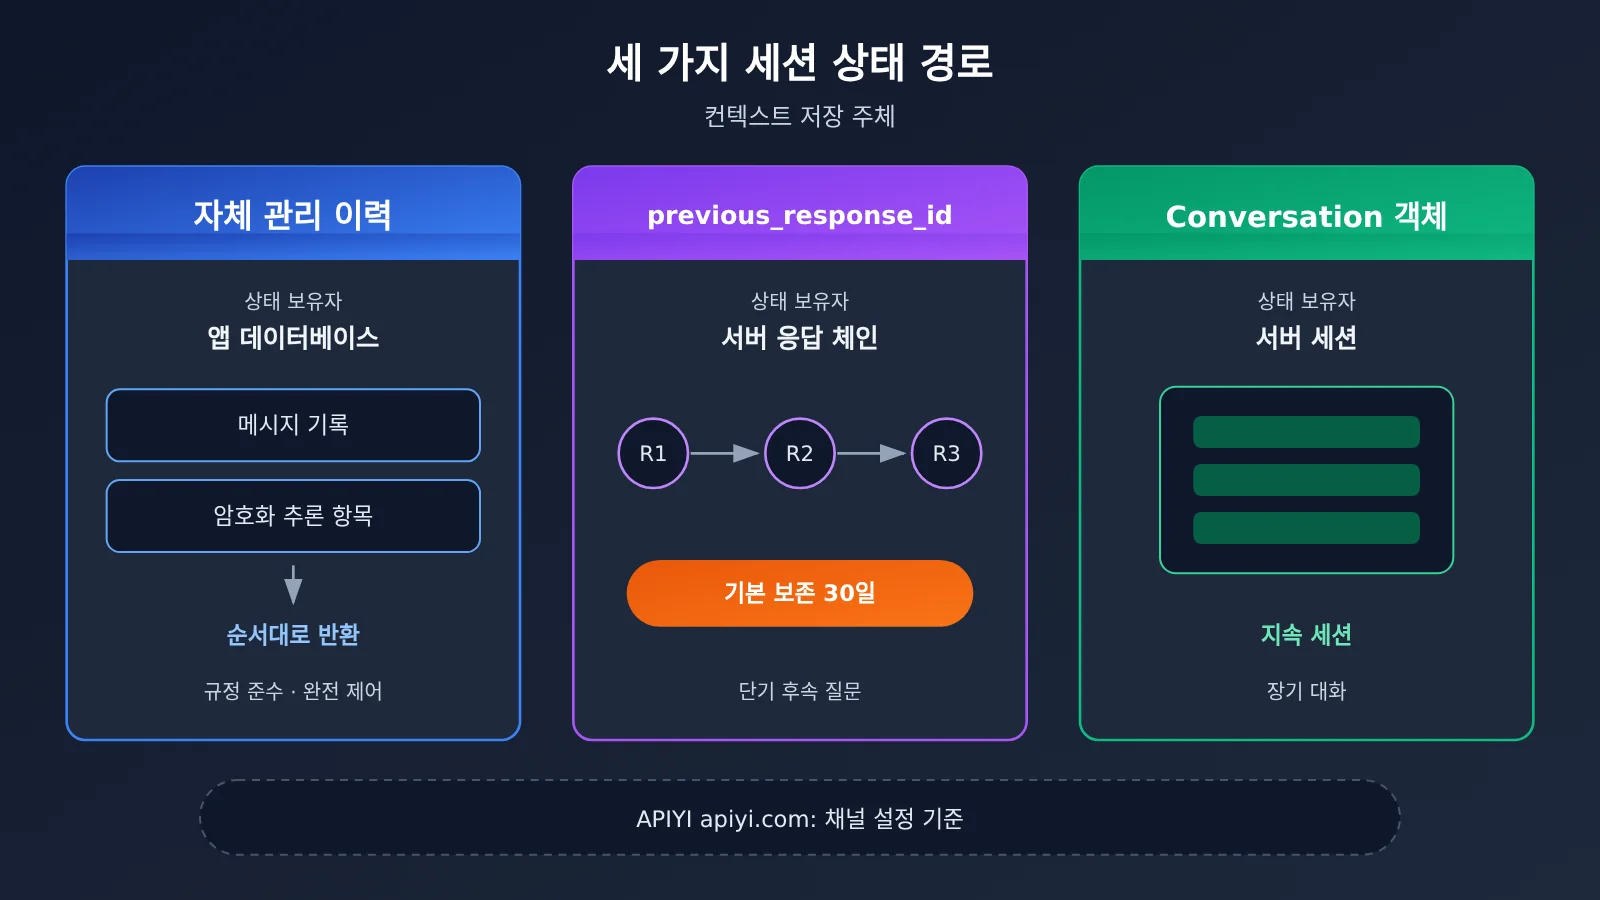
2.1 GPT-6.2 Sol 세 가지 상태 경로 비교
상담원이 같은 티켓에 새로운 사실을 추가했고, 모델이 이전 턴에 이어서 분석해주길 바란다고 해봐요. 이때 가장 먼저 답해야 할 질문은 “컨텍스트를 누가 보관하는가”예요.
| 경로 | 상태 보유 주체 | 보관 조건 | 적합한 상황 | 사용 가능 플랫폼 |
|---|---|---|---|---|
| 직접 관리 히스토리 | 애플리케이션 자체 | 애플리케이션이 결정; 메시지와 필요한 응답 항목을 원래 순서대로 반환해야 함 | 규정 준수 요구가 있거나 컨텍스트를 완전히 통제해야 하는 경우 | 공식 API, APIYI apiyi.com |
previous_response_id |
서버 측 응답 체인 | 응답이 계속 사용 가능할 때만 이어갈 수 있음; 응답 객체는 기본 30일 보관 | 단기간의 연속 질의 | 현재 채널 구성 기준 |
| Conversation 객체 | 서버 측 세션 객체 | Conversation에 첨부된 항목은 해당 객체의 보관 규칙에 따라 처리 | 더 오래 보관해야 하는 대화 | 현재 채널 구성 기준 |
직접 관리 히스토리를 선택하면서 추론의 연속성도 원한다면, 텍스트만 반환해서는 안 돼요. 필요한 응답 항목은 모두 보존하고 순서대로 재생해야 하며, 여기에는 암호화된 추론 항목도 포함돼요.
2.2 GPT-6.2 Sol 검토 초점만 바꾸는 방법
두 번째 턴에서 검토 초점만 “응답 시효”에서 “화법 준수”로 바꾸고 싶다고 가정해봐요. 올바른 방법은 공통 품질 검사 규칙을 체인의 첫 번째 developer 메시지에 넣고, 이번 턴 전용 초점은 최상위 instructions에 작성하는 거예요. instructions는 이를 제공한 요청에만 적용되고 이후 턴을 오염시키지 않아요.
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # 이번 요청에만 적용됨
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
이렇게 작성하면 장점이 하나 더 있어요. 첫 번째 규칙이 그대로 유지되고 프리픽스도 안정적으로 유지돼요.
2.3 GPT-6.2 Sol의 프리픽스 변경 위험
GPT-6.2는 몇 가지 경우에 관련 추론 항목을 지울 수 있어요. 오래된 히스토리를 다시 쓰거나, 부분 모델 전환(예: 다운그레이드)을 하거나, 사용자나 조직을 바꾸는 경우예요. 이어가야 하는 Standard 단일 에이전트 세션에서 추론 레벨이나 출력 스키마를 조정하려면, 이전 구성을 되돌아가 수정하는 대신 적용 가능한 configuration_update 항목을 추가해야 해요. 해당 항목의 구체적인 필드는 GPT-6.2 마이그레이션 가이드를 기준으로 해요.
장기 규칙을 업데이트해야 할 때는 컨텍스트 끝에 새로운 developer 메시지를 추가하고, 이전 규칙을 편집하지 않으며 이전 도구와 스키마 구성도 변경하지 않아요. 프리픽스가 안정적으로 유지되더라도 캐시 적중 여부는 구체적인 요청과 처리 조건에 따라 달라지므로, 이를 당연한 결과로 여기면 안 돼요.
3. GPT-6.2 Sol 백그라운드 작업 데이터베이스 저장
3.1 GPT-6.2 Sol 백그라운드 제출과 완료 윈도우
일일 마감 시 검토 대기 중인 티켓 요약은 시간이 오래 걸릴 수 있고, 상담원도 계속 화면을 지키고 있지는 않아요. 이런 작업은 background: true로 제출합니다. 제출한 뒤에는 반환된 응답 ID를 즉시 영구 저장하고, 이를 비즈니스 작업 ID와 일대일로 매핑해 둬요.
완료 윈도우는 허용 가능한 대기 시간에 맞춰 선택하는데, 기본값은 soonest예요. 2h와 8h는 Standard 등급의 할인 윈도우로, 현재는 공개 테스트 기능이며 제출할 때 스트리밍을 활성화할 수 없어요. 완료 윈도우의 파라미터 이름과 저장 요구사항은 백그라운드 모드 문서를 기준으로 삼습니다.
| 완료 윈도우 | 용도 | 스트리밍 | 적합한 품질 검사 작업 |
|---|---|---|---|
soonest(기본값) |
최대한 빠른 완료 | 백그라운드 모드 문서 따름 | 당일 근무 중 다시 확인할 재검토 |
2h |
Standard 할인 윈도우, 공개 테스트 | 비활성화 | 교대 후 집계 |
8h |
Standard 할인 윈도우, 공개 테스트 | 비활성화 | 일일 마감 일괄 요약 |
3.2 GPT-6.2 Sol Webhook 서명 검증, 중복 제거 및 재조회
작업이 대기 중이거나 진행 중일 때는 같은 ID로 계속 조회하면 돼요. 완료 이벤트를 받으면 다음 순서로 처리해요:
- 서명을 검증합니다. 검증에 실패하면 바로 버립니다.
webhook-id로 중복을 제거합니다. 같은 알림이 다시 전송될 수 있어요.event.data.id로 전체 응답을 다시 조회합니다. 알림 자체는 결과로 쓰지 않아요.- 작업 ID 기준으로 최종 상태와 결과를 멱등하게 기록합니다.
GPT-6.2 Sol 백그라운드 작업 회수 코드 보기
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 제출
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# Webhook 처리
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # 서명 검증, 실패 시 예외 발생
    if db.seen_webhook(headers["webhook-id"]):         # 중복 제거
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # 전체 응답 다시 조회
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # 작업 ID 기준 멱등 기록
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
사용자가 페이지를 닫았다가 다시 돌아오면, 프런트엔드는 비즈니스 작업 ID로 로컬 DB를 조회하기만 하면 돼요. 상태가 아직 최종 상태가 아니라면 서버가 저장해 둔 응답 ID로 계속 조회를 이어갑니다.
데이터 보존에는 특히 주의해야 해요. 백그라운드 모드는 재조회를 지원하려고 응답 데이터를 임시로 저장합니다. store: false로 설정하거나 조직에서 ZDR을 켜 두어도 이 점은 달라지지 않으니, 데이터 통제 문서와 대조해서 수용 가능한지 확인해야 해요.
💡 연동 제안: Webhook 콜백 주소와 백그라운드 모드는 채널 측의 지원이 필요합니다. APIYI apiyi.com을 통해 연동하기 전에 현재 계정 그룹에서 백그라운드 모드와 콜백 기능이 개방되어 있는지 먼저 확인하는 게 좋아요. 아직 개방되지 않았다면 응답 ID 폴링 방식으로 먼저 상태 머신을 검증할 수 있습니다.
4. GPT-6.2 Sol 출시 인수 검증 체크리스트
4.1 GPT-6.2 Sol 합성 인수 검증표
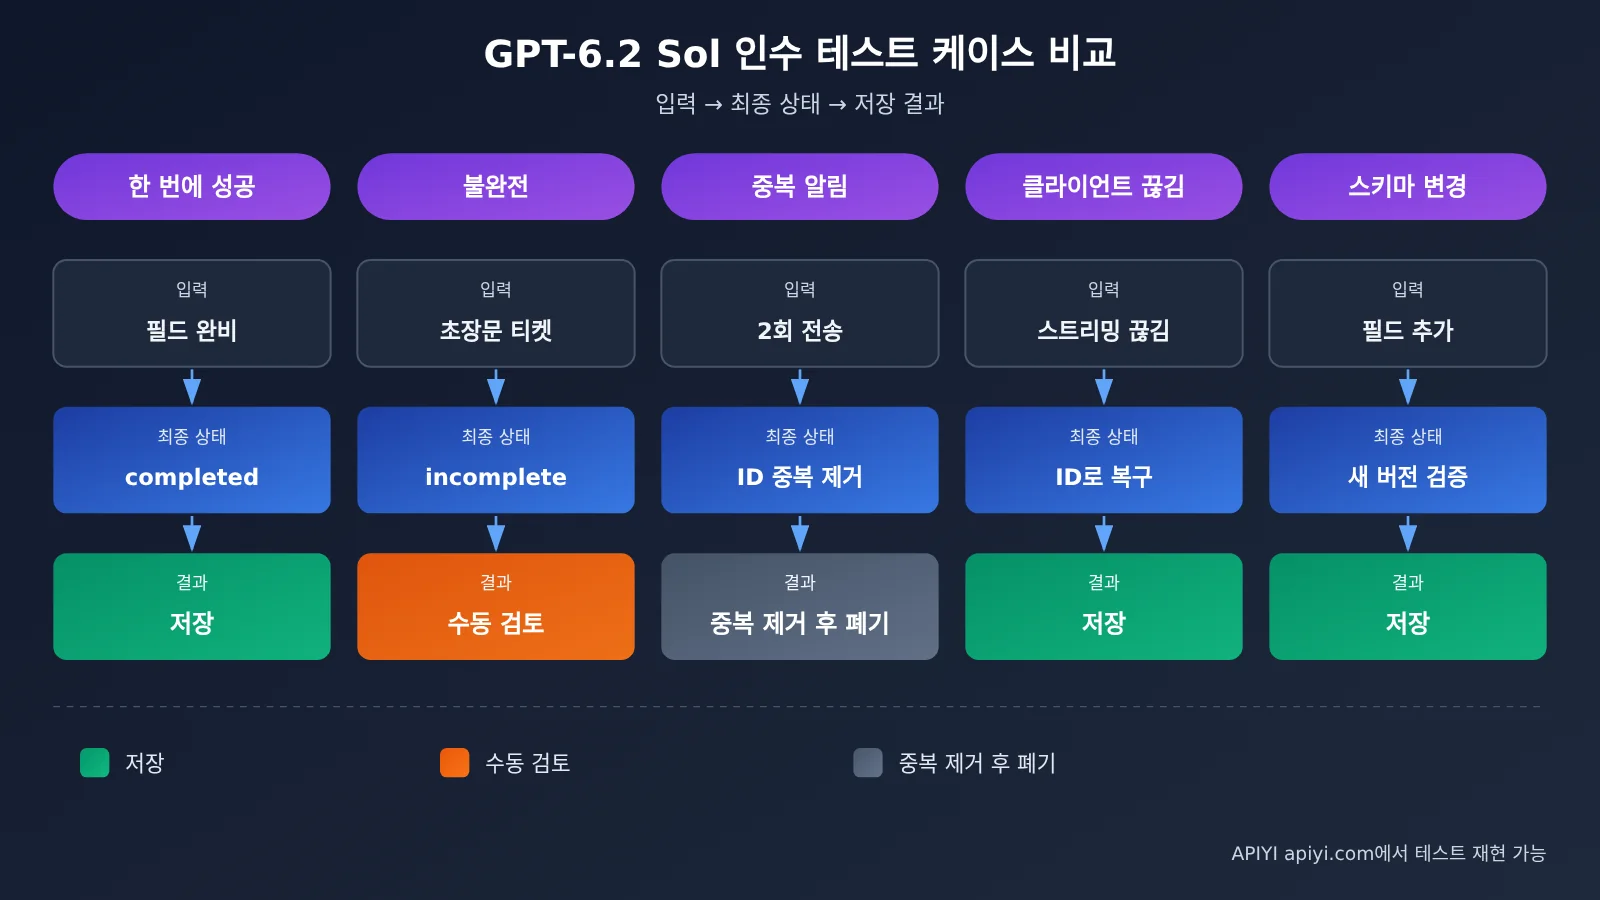
아래 검증표는 고객센터 품질 검사라는 합성 사례를 그대로 사용해, 앞선 세 절의 판정 조건을 하나씩 실행 가능한 케이스로 풀어낸 거예요.
| 케이스 | 입력 조건 | 예상 상태 또는 결과 |
|---|---|---|
| 1회 성공 | 실제로 존재하는 티켓, 필드가 모두 채워짐 | 최종 상태 completed, Schema 및 비즈니스 검증 통과, 작업 ID 기준으로 결과 1건 저장 |
| 1회 불완전 응답 | 출력 상한을 인위적으로 낮추거나 매우 긴 티켓 사용 | 상태 incomplete, JSON 파싱하지 않음, 수동 검토로 전환하고 사유 기록 |
| 1회 중복 알림 | 동일한 webhook-id를 두 번 전송 |
두 번째는 중복 제거됨, 결과 테이블에 레코드 1건만 존재 |
| 1회 클라이언트 연결 끊김 | 스트리밍 도중 브라우저 연결 해제 | 저장된 응답 ID로 상태 복구, DB 저장 결과는 페이지와 무관하게 유지 |
| 1회 Schema 변경 | 세션 도중 필수 필드 1개 추가 | 설정을 추가로 업데이트해 조정 완료, 기존 설정은 덮어쓰지 않음, 신규 결과는 새 Schema로 검증 |
각 케이스마다 네 가지 정보를 저장해야 해요. 호출한 모델 ID(gpt-6.2-sol), 실행 파라미터, 응답 ID, 그리고 애플리케이션 측 설정 버전이에요. 문제가 생기면 이 네 가지로 어느 요청이었는지 정확히 찾아낼 수 있어요.
4.2 GPT-6.2 Sol 회귀 검증 시 기준
| 항목 | 기록 내용 | 설명 |
|---|---|---|
| 모델 | gpt-6.2-sol |
모델 카드에 공개된 ID 인용 |
| 엔드포인트 | Responses | 함수 호출과 내장 도구는 이 경로를 사용 |
| 추론 단계 | 실제 사용한 단계 | Responses와 Chat Completions 모두 none을 허용하지 않음 |
| 사용량 | usage.output_tokens 및 그 안의 추론 토큰 하위 항목 |
출력 과금에 추론 토큰이 이미 포함됨 |
| 과금 구간 | 단일 요청 입력이 272K를 초과하는지 | APIYI 공개 가격 인터페이스는 272,000 입력 토큰 기준으로 구간을 나누며, 실제 청구는 청구서 기준 |
구 시스템을 마이그레이션할 때는 엔드포인트, 요청 파라미터, 멀티턴 입력, 추론 컨텍스트, 캐시 이 다섯 항목을 각각 확인해야 해요. 확인을 마친 뒤에는 동일한 케이스 묶음으로 예시 요청과 프로덕션 요청을 함께 회귀 테스트해요.
🚀 검증 제안: 다섯 가지 케이스를 CI에 넣어 두면 Schema를 수정하거나 채널을 전환할 때마다 자동으로 한 번씩 돌릴 수 있어요. APIYI apiyi.com의 통합 Key를 이용하면 동일한 케이스 묶음에서 서로 다른 그룹의 동작 차이를 비교할 수 있어요.
검증표의 다섯 케이스가 모두 통과하고, 각 케이스를 응답 ID로 추적할 수 있다면 이 품질 검사 파이프라인은 이미 출시 준비를 갖춘 셈이에요.
참고 자료
- GPT-6.2 Sol 모델 카드: 모델 ID, 컨텍스트 및 과금 규칙
- 링크:
developers.openai.com/api/docs/models/gpt-6.2-sol
- 링크:
- GPT-6.2 마이그레이션 가이드: 엔드포인트 선택, 접두사 변경 및 구성 업데이트
- 링크:
developers.openai.com/api/docs/guides/latest-model
- 링크:
- 스트리밍 응답과 구조화된 출력: SSE 이벤트와
text.format- 링크:
developers.openai.com/api/docs/guides/streaming-responses
- 링크:
- 대화 상태:
previous_response_id와 Conversations- 링크:
developers.openai.com/api/docs/guides/conversation-state
- 링크:
- 백그라운드 모드와 Webhook: 완료 윈도우, 서명 검증 및 중복 제거
- 링크:
developers.openai.com/api/docs/guides/background
- 링크:
저자: APIYI 기술 팀
기술 교류: APIYI 웹사이트 홈페이지에서 저희에게 연락해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요