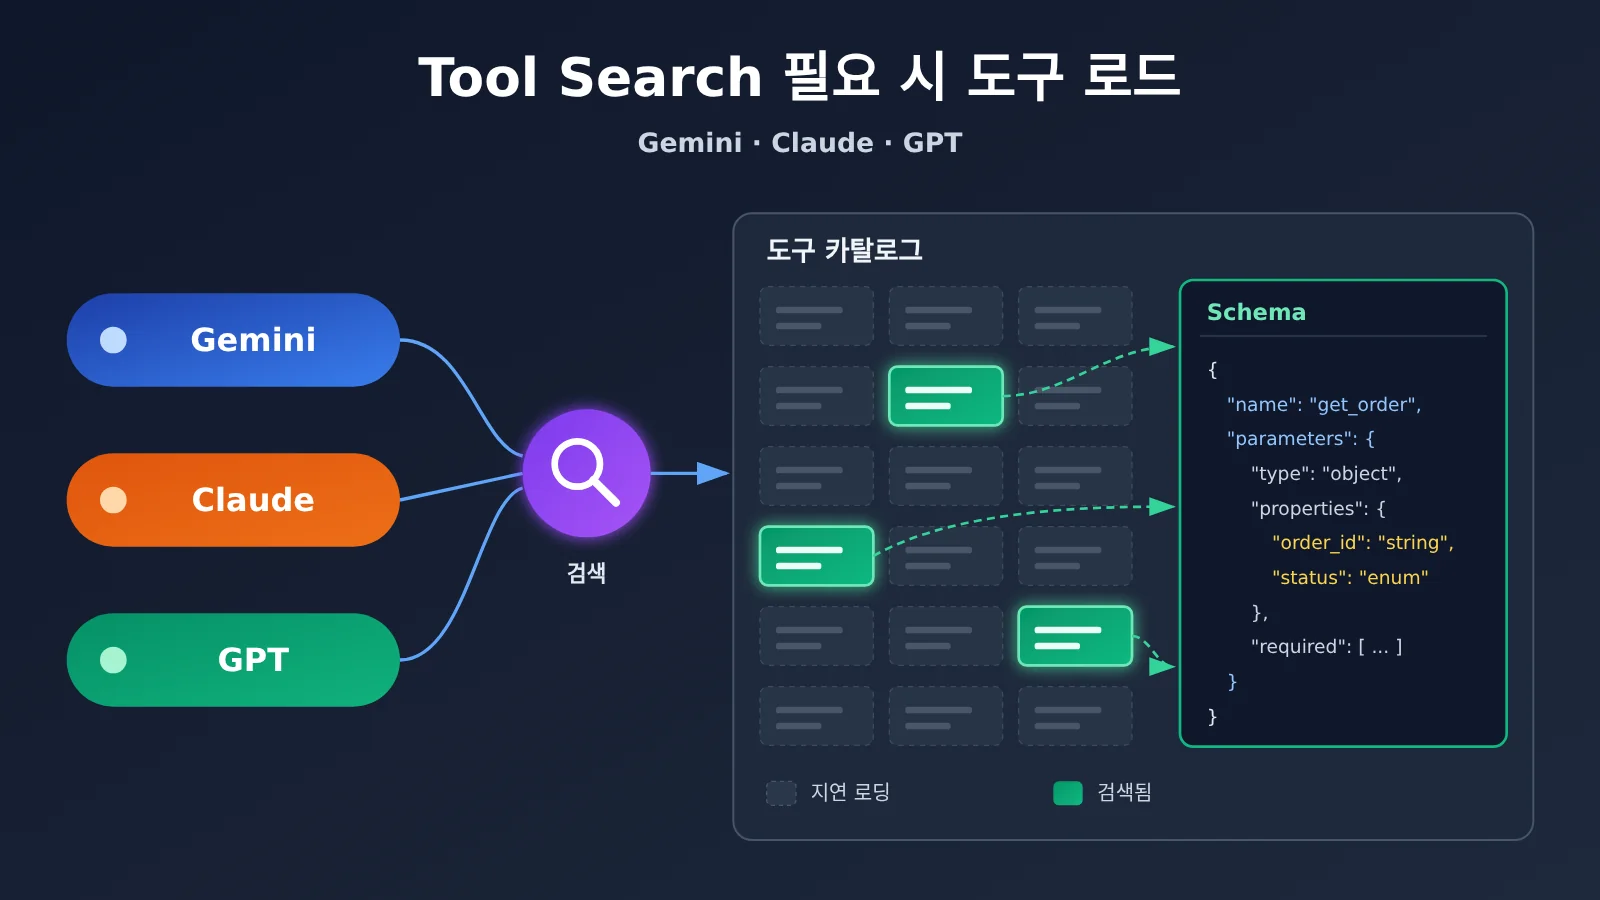
세 곳의 Tool Search는 같은 문제를 해결하지만 구현 경로는 크게 달라요. 세 곳 모두 모델이 처음에는 도구에 대한 간단한 힌트만 보게 하고, 호출이 필요할 때 전체 매개변수 스키마를 로드해요. 차이는 주로 세 가지예요. Gemini는 서버 측과 클라이언트 측, 두 가지 검색 모드를 제공하고 클라이언트 측 검색에서는 새 도구를 도입할 수 있어요. Claude는 Regex와 BM25, 두 가지 서버 측 검색 방식을 공개했으며 tool_reference를 통해 이미 선언된 도구 집합 안에서 도구를 찾아내요. GPT는 namespace로 도구를 그룹화하고, 클라이언트 모드에서는 tool_search_output으로 새 도구를 동적으로 주입할 수 있어요. 선택할 때는 도구 라이브러리가 고정되어 있는지, 자주 바뀌는지, 그리고 팀의 기존 API 아키텍처를 살펴야 해요.
이 글을 읽고 나면 무엇을 알 수 있을까요?
- 세 곳의 Tool Search가 각각 어떤 API에 속하고, 어떤 필드로 활성화되는지.
- 모델의 초기 컨텍스트에 남는 내용이 어떻게 다른지, 그리고
short_description,tool_reference,namespace가 각각 어떤 역할을 하는지. - 도구 검색과 실제 함수 호출의 이벤트 체인이 어떻게 구성되는지, 연동할 때 어디서 쉽게 실수하는지.
- 어느 쪽이 대화 중에 초기 요청에 없던 새 도구를 추가할 수 있는지.
- 주문 및 재고 같은 엔터프라이즈 에이전트에서 도구 라이브러리 구조에 따라 어떻게 선택할지.
목차: 본문에서는 먼저 세 곳의 발표 시점과 공통된 접근 방식을 설명한 뒤, Gemini, Claude, GPT의 검색 메커니즘과 네이티브 필드를 각각 분석해요. 이어서 하나의 종합 표로 여덟 가지 차원을 비교하고, 동일한 주문 및 재고 에이전트로 세 가지 기술 경로를 보여줘요. 마지막 분석 섹션에서는 선택 원칙을 제시하고, 크로스 모델 게이트웨이가 프로토콜을 맞출 때 주의할 점을 논의해요.
Tool Search 관련 개념 정리
| 개념 | 간단한 설명 |
|---|---|
| 도구 카탈로그 | 검색 대상이 되는 업무 도구 모음으로, 이름, 설명, 파라미터 정의, 권한 정보를 포함해요 |
| Tool Search | 현재 작업에 필요한 도구를 검색하고, 필요할 때 해당 도구의 전체 정의를 불러오는 기능이에요 |
defer_loading |
세 곳 모두에서 사용하는 필드로, 도구의 전체 정의를 지연 로딩하도록 표시해요 |
| Regex | 정규 표현식으로 도구 이름, 설명, 파라미터 단서를 매칭해요 |
| BM25 | 쿼리 단어와 텍스트의 관련성에 따라 검색 결과의 순위를 매기는 고전 알고리즘이에요 |
tool_reference |
Claude가 이미 선언된 도구를 참조할 때 쓰는 콘텐츠 블록으로, 이후 API가 전체 정의로 확장해요 |
namespace |
OpenAI Responses API에서 관련 함수를 업무 기능별로 묶는 선언이에요 |
| 동적 도구 주입 | 애플리케이션이 초기 요청에 선언되지 않은 도구 정의를 모델에 넘겨 계속 사용하게 하는 거예요 |
tool_search_output |
OpenAI 클라이언트가 검색할 때 매칭된 도구 선언을 돌려주는 응답 항목이에요 |
| 원격 MCP | Model Context Protocol을 통해 검색 가능하고 실행 가능한 도구를 제공하는 원격 서비스예요 |
| 캐시 프리픽스 | 여러 번의 모델 호출 사이에 일관되게 유지되어 캐시를 재사용할 수 있는 입력의 앞부분이에요 |
Tool Search 영향 한눈에 보기
- Agent 개발자: 도구가 많아지면 더 이상 모든 스키마를 한 번에 컨텍스트에 밀어 넣을 필요가 없어요. 다만 세 곳의 요청 본문과 반환 이벤트가 모두 달라서, 여러 모델을 넘나드는 Agent는 각각에 맞는 파싱 로직을 따로 구현해야 해요.
- 기업 플랫폼과 도구 카탈로그 유지보수 담당자: 도구 이름, 짧은 설명, 그룹화 방식이 검색 효과에 직접 영향을 미치기 시작했고, 도구 카탈로그 자체가 설계해야 할 자산이 되었어요.
- 비용과 운영 책임자: Tool Search가 반드시 비용을 절감해 주지는 않아요. Google 공식 계산 예시는 토큰이 절약되는 경우와 증가하는 경우를 동시에 보여주니까, 도입 여부는 실제 청구서를 기준으로 판단해야 해요.
객관적 사실: 세 회사 Tool Search의 출시 흐름과 메커니즘
Gemini, Claude, GPT가 모두 Tool Search를 제공하는 이유
하나의 에이전트가 CRM, 주문, 재고, 물류, 티켓, 여러 MCP 서버를 동시에 연결하면 도구 선언만으로도 컨텍스트를 크게 차지해요. Google 문서에 따르면 수십 개의 함수 선언만으로 수만 개의 토큰을 차지할 수 있어요. Anthropic은 예를 하나 들었는데, GitHub, Slack, Sentry, Grafana, Splunk 다섯 개 MCP 서버에 총 58개의 도구가 있고, 도구 정의만 약 55,000 토큰에 달한다고 해요.
세 회사의 출시 타임라인은 다음과 같아요. Anthropic은 2025년 11월 24일에 Tool Search Tool을 출시했고, OpenAI는 2026년 3월 5일에 GPT-5.4와 함께 API Tool Search를 출시했으며, Google은 2026년 11월 19일에 Gemini API의 Tool Retrieval을 프리뷰 버전으로 출시했어요. 세 회사의 기본 접근은 같아요. 모델이 먼저 어떤 기능이 있는지 알고, 실제로 쓸 때 전체 파라미터 정의를 읽는 방식이에요.
세 회사 모두 성능 데이터를 공개했지만, 테스트 조건이 완전히 달라서 순위를 매기기는 어려워요. Anthropic의 예에서는 초기 컨텍스트가 약 77,000 토큰에서 약 8,700 토큰으로 줄었고, 내부 MCP 평가에서 Claude Opus 4의 도구 선택 정확도는 49%에서 74%로 올랐어요. OpenAI는 MCP Atlas의 250개 작업과 36개 MCP 서버에서 총 토큰이 47% 감소했고 정확도는 그대로였다고 측정했어요. Google은 아직 가정에 기반한 계산 예만 제시했는데, 도구가 200개일 때는 약 85.6% 감소하고, 도구 10개에 긴 컨텍스트를 조합하면 오히려 약 36.5% 증가한다고 해요.
Gemini Tool Search: 서버와 클라이언트, 두 가지 검색 모드
Gemini의 Tool Retrieval은 Interactions API를 기반으로 동작하며 v1beta를 사용해야 해요. 기존 generateContent에서는 지원되지 않아요. 서버 모드를 활성화하려면 tools에 {"type": "tool_search"}를 추가하고, 사용 빈도가 낮은 function이나 mcp_server에 defer_loading: true를 설정하면 돼요. 모델은 처음에 지연된 도구의 이름과 short_description만 볼 수 있어요. Google의 초기 테스트에 따르면 도구 항목 하나당 평균 약 26토큰을 차지했어요. 간단한 설명이 설정되어 있지 않으면 전체 description의 첫 문장으로 대신해요.
오해하기 쉬운 부분이 하나 있어요. 서버 모드에서도 개발자는 여전히 전체 도구 정의를 제출해야 해요. previous_interaction_id를 사용하더라도 매 요청마다 전체 tools 배열을 다시 보내야 하죠. 지연 로딩은 전체 스키마가 미리 모델 컨텍스트로 들어가지 않도록 할 뿐이에요. 또한 한 번 로드된 스키마는 현재 세션에서 언로드할 수 없고, 단일 요청에서는 tool_search를 최대 하나만 선언할 수 있으며, 서버 검색과 클라이언트 검색은 같은 요청에서 함께 사용할 수 없어요.
| 구분 | 서버 검색 | 클라이언트 검색 |
|---|---|---|
execution |
server(기본값) |
client |
| 검색기 | Gemini API가 담당 | 개발자가 직접 구축 |
| 도구 라이브러리 사전 선언 | 필요 | 불필요 |
defer_loading |
적용 가능 | 적용 불가 |
| 추가 왕복 | 클라이언트 왕복 없음 | 검색할 때마다 왕복 한 번 추가 |
| 대표적 시나리오 | 규모가 크고 비교적 고정된 도구 집합 | 사설 Tool Registry, 멀티테넌트, 동적 도구 |
클라이언트 모드에서는 모델이 개발자가 정의한 검색 함수(예: search_tool_registry)를 호출하고, 애플리케이션이 function_result.result에 일치하는 전체 도구 선언 객체를 반환해요. 이 방식은 대화 도중 원래 요청에서 선언하지 않았던 도구를 도입할 수 있어요. 예를 들어 사용자가 세션에서 새로운 SaaS 서비스를 임시로 연결하는 경우죠.
Claude Tool Search: Regex, BM25, tool_reference
Claude의 Tool Search Tool은 Messages API에 속하고, 서버 쪽에서 두 가지 유형의 검색 도구를 제공해요. tool_search_tool_regex_20251119는 모델이 정규식을 생성하는 방식이라 이름 규칙이 또렷한 도구 라이브러리에 잘 어울리고, tool_search_tool_bm25_20251119는 모델이 자연어 쿼리를 생성하는 방식이라 능력 설명을 기준으로 도구를 찾아내기에 적합해요. 두 방법 모두 도구 이름, 설명, 파라미터 이름, 파라미터 설명을 검색해요. Claude의 파라미터 필드는 input_schema라서, parameters를 사용하는 다른 두 벤더와 다르죠.
대표적인 검색 한 번의 이벤트 체인은 이렇게 흘러가요. Claude가 먼저 server_tool_use로 내장 검색 도구 호출을 시작하면, API가 tool_search_tool_result를 반환하고, 그 결과 안에 tool_reference가 들어 있어요. 이어서 API가 이것을 완전한 정의로 확장하고, 마지막으로 모델이 업무 레벨의 tool_use를 만들어내요. Anthropic은 내장 검색 도구의 srvtoolu_... 식별자는 개발자가 tool_result로 되돌려줄 필요가 없다고 특별히 설명해요. 애플리케이션은 실제 업무 tool_use만 실행하면 된다는 뜻이에요.
| Claude Tool Search 규칙 | 공식 규정 |
|---|---|
| 요청당 지연 로딩 도구 상한 | 10,000개 |
| 검색 1회 기본 반환 | 최대 5개, limit으로 조정 가능 |
| Regex 쿼리 길이 | 최대 200자 |
| BM25 쿼리 길이 | 최대 500자 |
| 지원하지 않는 모델 | Claude Opus 4.1 및 이전 모델 |
| 캐시 제약 | defer_loading: true인 도구에는 cache_control을 설정할 수 없음 |
개발자가 임베딩 같은 자체 알고리즘으로 커스텀 검색을 구현할 수도 있지만, 그때도 반환되는 것은 여전히 tool_reference이고, 참조된 도구는 이미 최상위 tools에 선언되어 있어야 해요. 그래서 Claude의 설계는 “미리 선언해 둔 도구 라이브러리에서 필요한 도구를 골라내는” 쪽에 더 가까워요. MCP 쪽에서는 Claude가 MCP Connector의 mcp_toolset 설정으로 지연 정책을 정할 수 있는데, default_config에서 한꺼번에 설정할 수도 있고 configs에서 도구마다 하나씩 설정할 수도 있어요.
GPT Tool Search: 네임스페이스와 동적 도구 주입
OpenAI의 Tool Search는 Responses API에 자리하고, GPT-5.4 및 그 이후의 호환 모델에서 지원되며 마찬가지로 tool_search와 defer_loading으로 활성화해요. 특징은 namespace인데, 개발자가 관련 함수를 crm, billing 같은 업무 도메인별로 묶어두면 모델이 먼저 네임스페이스의 이름과 설명을 보고 어떤 종류의 역량이 관련 있는지 판단하고, 필요할 때 그룹 안의 지연 함수를 펼쳐서 써요. 이렇게 도구 그룹화가 단순한 명명 규칙이 아니라 API 레이어의 구조가 되는 셈이에요.
서버 측 모드의 이벤트 체인은 tool_search_call → tool_search_output → function_call → 애플리케이션이 function_call_output을 반환하는 흐름이에요. 클라이언트 모드에서는 애플리케이션이 tool_search_call을 받은 뒤 직접 도구 카탈로그를 조회하고, 동일한 call_id로 tool_search_output을 반환하는데, 그 tools 필드에 매칭된 완전한 도구 선언이 담겨요. 모델은 그다음 라운드에야 이 함수들을 호출해요. 공식 문서는 여기서 원래 요청에 선언되지 않았던 도구를 반환하는 것을 지원하면서도, 개발자가 동적 스키마를 엄격히 검증해 신뢰할 수 있는 도구 정의만 노출할 것을 요구해요.
캐시 측면에서 OpenAI는 새로 발견된 도구 정의를 컨텍스트 뒷부분에 덧붙여 기존 캐시 프리픽스에 미치는 영향을 줄여요. MCP와 관련해서는 주의할 점이 있어요. Responses API의 Tool Search는 MCP 도구의 온디맨드 발견을 지원하고, Agents API는 모델과 제공자가 지원할 때 런타임이 자동으로 도구 발견을 연결해요. 공식 문서는 두 설정을 서로 그대로 적용할 수 없다는 점을 분명히 알려줘요.
아래는 지연 로딩의 기본 구조를 보여주는 예시적인 Responses API 요청이에요. 필드는 OpenAI 공식 문서를 기준으로 해요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 진입점
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "inventory_get_stock",
        "description": "Inventory: check stock level by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    }
]

resp = client.responses.create(
    model="gpt-5.4",
    input="订单 A-1042 还没发货,帮我查一下 SKU-88 的库存。",
    tools=tools
)
for item in resp.output:
    print(item.type)  # 예상되는 이벤트: tool_search_call / function_call 등
클라이언트 검색과 동적 주입 예시 코드 보기
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI를 경유해 Responses API 요청 전달
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def search_registry(query: str) -> list:
    """기업의 프라이빗 도구 카탈로그에서 검색하고, 사용자 권한에 따라 필터링(예시)"""
    return [{
        "type": "function",
        "name": "warehouse_schedule_shipment",
        "description": "Warehouse: schedule a new shipment date.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "date": {"type": "string"}
            },
            "required": ["order_id", "date"]
        }
    }]

def handle(output_items: list) -> list:
    follow_ups = []
    for item in output_items:
        if item["type"] == "tool_search_call":
            query = item.get("arguments", {}).get("query", "")
            follow_ups.append({
                "type": "tool_search_output",
                "call_id": item["call_id"],      # 검색 호출과 동일한 call_id 사용
                "tools": search_registry(query)  # 초기 요청에 선언되지 않은 도구도 포함 가능
            })
    return follow_ups
# 주의: 동적으로 반환되는 스키마는 반드시 먼저 검증하고, 신뢰할 수 있는 도구만 노출하세요
🚀 빠른 검증 제안: 실제 업무에 연결하기 전에 APIYI apiyi.com의 통합 Key로 GPT, Claude, Gemini를 각각 호출해, 같은 도구 카탈로그를 세 곳에서 모두 한 번씩 돌려보세요. 이벤트 구조가 여러분의 파싱 레이어에서 올바르게 인식되는지 확인한 뒤에 주력 방안을 정하는 게 좋아요.
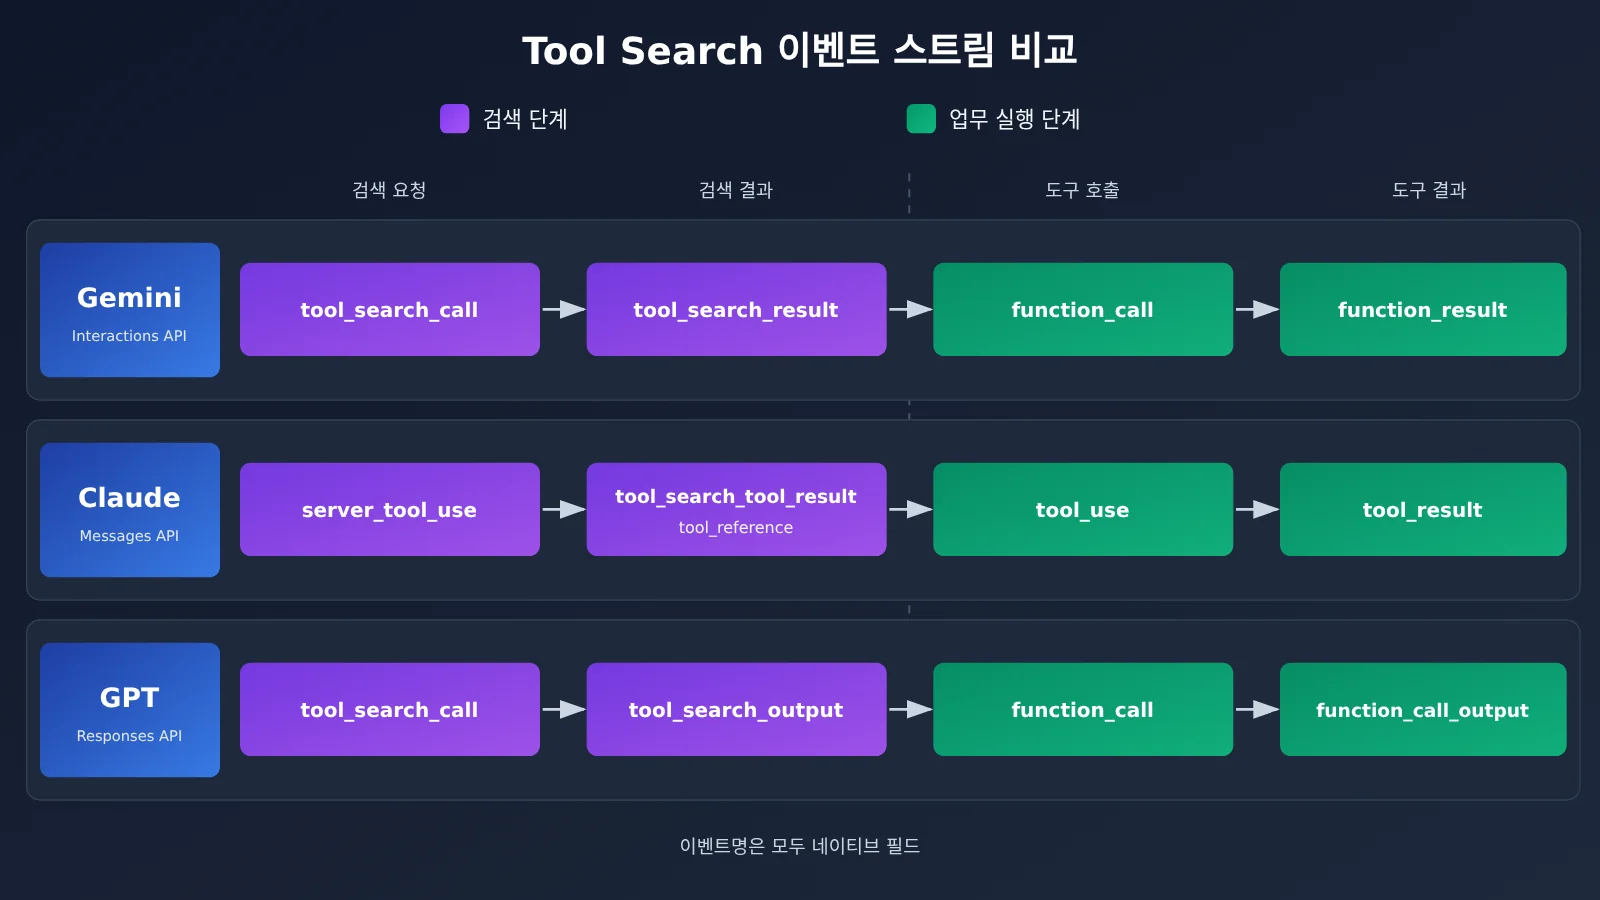
위 그림에 나온 이벤트 이름은 모두 각 사의 네이티브 필드예요. 각 사의 이벤트 흐름을 직접 테스트해 보고 싶은 독자라면 APIYI(apiyi.com)를 통해 동일한 테스트 스크립트로 모델만 바꿔 가며 비교해 볼 수 있어요.
세 사의 Tool Search 메커니즘 집중 비교
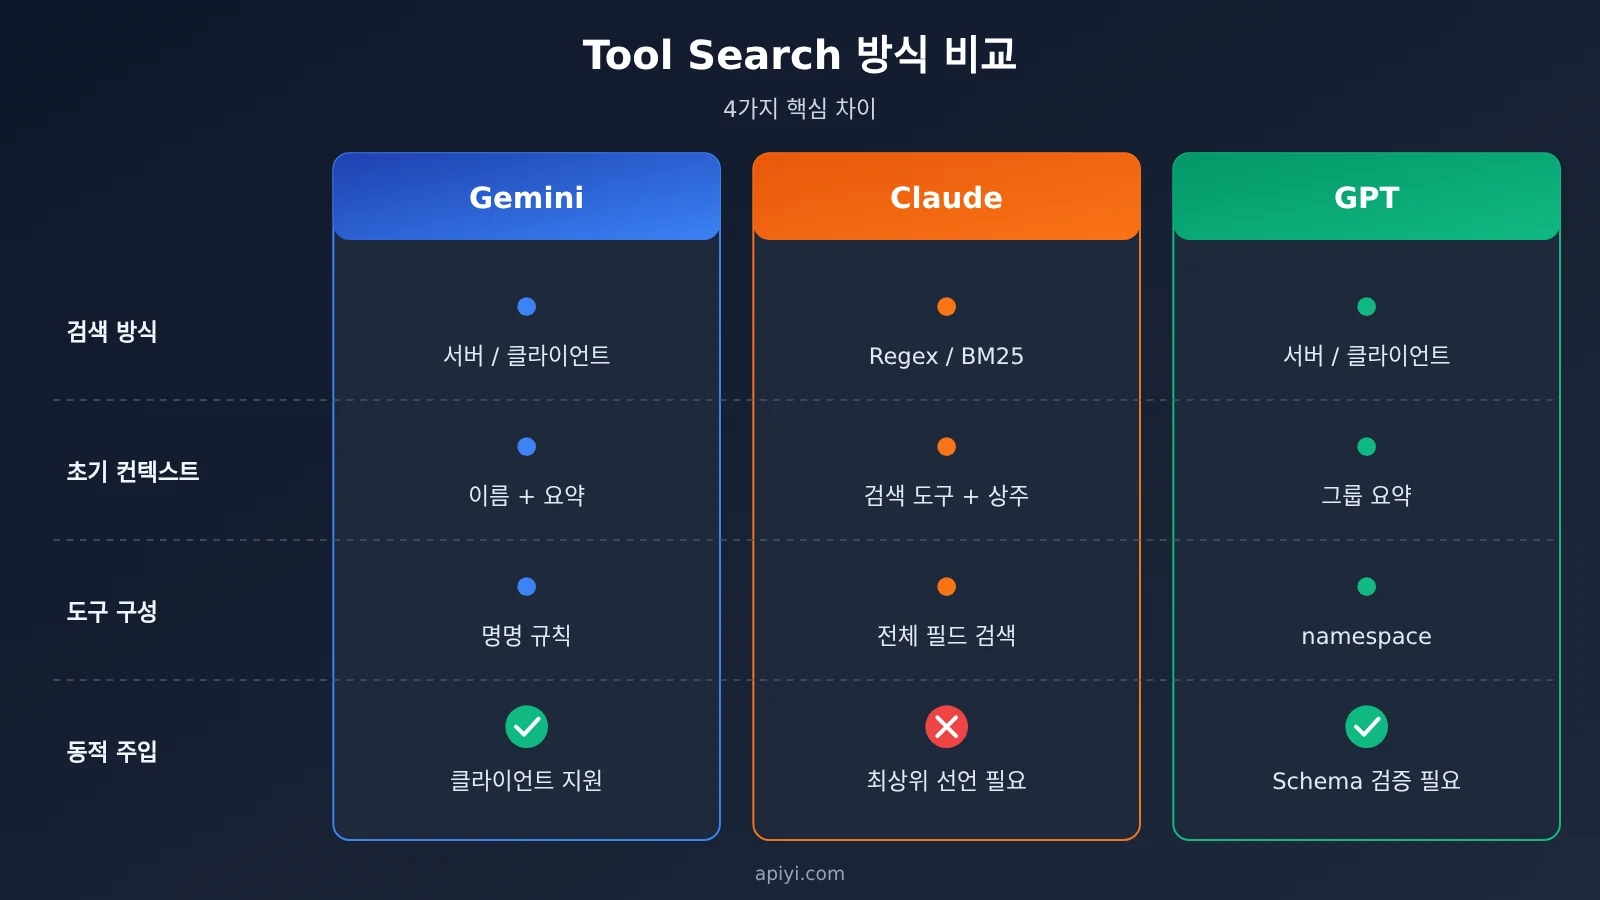
| 구분 | Gemini | Claude | GPT |
|---|---|---|---|
| 해당 API | Interactions API(v1beta) |
Messages API | Responses API |
| 검색 방식 | 서버 측(알고리즘 비공개) / 클라이언트 측 | Regex / BM25 / 사용자 정의 검색 | 서버 측 / 클라이언트 측 |
| 초기 컨텍스트 유지 | 이름 + short_description |
검색 도구 + 비지연 도구 | 지연 도구 또는 namespace 요약 |
| 도구 구성 | 명명 규칙 + 간단한 설명 | 이름, 설명, 파라미터 모두 검색 가능 | namespace 그룹화 |
| 파라미터 필드 | parameters |
input_schema |
parameters |
| 클라이언트 측 검색 | 지원 | 사용자 정의 검색이 tool_reference 반환 |
지원(tool_search_output) |
| 신규 도구 동적 추가 | 클라이언트 모드 지원 | 참조된 도구는 최상위에 이미 선언되어 있어야 함 | 클라이언트 모드 지원, Schema 검증 필요 |
| MCP 통합 | mcp_server + defer_loading |
mcp_toolset의 default_config / configs |
Responses와 Agents의 규칙이 다름 |
| 캐싱 및 과금 | 별도 기능 비용 없음, total_tool_use_tokens 주목 |
별도 과금 없음, 지연 도구에는 cache_control 설정 불가 |
캐시 프리픽스 보호를 위해 새 도구를 뒤쪽에 추가 |
💡 선택 가이드: 위 표는 검증 가능한 인터페이스 규칙만 비교한 내용이에요. 실제 효과는 여러분의 도구 라이브러리와 대화 길이에 따라 달라지므로, APIYI(apiyi.com)의 멀티모델 통합 엔드포인트를 활용해 작은 샘플로 A/B 테스트를 해 보고, 각 사의 청구 필드와 함께 비용을 계산해 보시길 권장해요.
분석 판단: Tool Search 선택의 적합 조건
주문 및 재고 Agent로 세 가지 기술 접근법 살펴보기
이런 비즈니스 요구 사항을 상상해 봐요. 사용자가 주문 상태를 조회했는데 상품이 아직 배송되지 않았고, 이어서 재고를 조회한 뒤 새 배송일을 잡을 수 있는지 판단하는 상황이요. 시스템에는 CRM, 주문, 재고, 창고 스케줄링, 물류, 환불, 청구, 알림, 승인 아홉 가지 유형의 도구가 있고, 각 유형에는 여러 함수가 있어요.
- Gemini 접근법: 자주 쓰는 주문 조회는 바로 로드하고, 재고·창고 스케줄링 같은 롱테일 도구는 지연 로딩으로 설정한 뒤
short_description을 잘 작성해서 서버 측 검색이get_inventory의 스키마를 골라내도록 해요. 창고 스케줄링 도구가 테넌트별로 동적으로 활성화된다면 클라이언트 측 검색으로 전환해 프라이빗 Registry에서 반환하게 해요. - Claude 접근법: 도구 이름이 규칙적이라면(예:
inventory_*,warehouse_*) Regex로 정확히 매칭할 수 있어요. 사용자가 “더 채워 넣을 수 있는지 볼 수 있을까” 같은 구어체로 말한다면 BM25가 더 적합하죠. 최종적으로tool_reference가 호출 가능한tool_use로 확장해 줘요. - GPT 접근법:
crm,inventory,logistics기준으로namespace를 만들고, 모델이 재고와 물류 두 도메인에 걸친다는 것을 먼저 판단한 뒤 그룹 안의 함수를 확장해요. 임시로 연동한 신규 물류 업체는 클라이언트 측tool_search_output으로 주입할 수 있어요.
이 시나리오는 메커니즘 차이를 설명하기 위한 것일 뿐, 세 가지 접근법의 실제 측정 성공률이나 지연 시간을 의미하지는 않아요.
개발자를 위한 네 가지 선택 원칙
- 도구 라이브러리가 크고 고정적이라면: 서버 측 검색 기능을 우선 살펴보세요. 세 곳 모두 커버할 수 있지만, Gemini는 매 요청마다 전체 도구 배열을 다시 전송해야 하고, Claude는 단일 요청당 지연 도구 수 상한이 10,000개라는 점을 유의해야 해요.
- 검색 전략을 명시적으로 제어해야 한다면: Claude가 공개한 Regex와 BM25는 알고리즘을 명확히 공개한 유일한 방식이라, 명명 규칙에 따라 정확히 매칭되길 원하는 팀에 적합해요. Gemini와 GPT의 서버 측 알고리즘은 공개되지 않았으므로, Claude와 같다고 추론해서는 안 돼요.
- 도구 라이브러리가 자주 바뀌거나 사용자 권한에 따라 필터링해야 한다면: 클라이언트 측 동적 주입을 중점적으로 보세요. Gemini와 GPT의 클라이언트 모드는 모두 새 도구를 도입할 수 있지만, Claude의 사용자 정의 검색은 이미 선언된 도구만 참조할 수 있어서 요청을 보내기 전에 후보 집합을 미리 구성해야 해요.
- 도구 규모가 작다면: Google의 산출 예시에 따르면, 도구 10개에 30,000 토큰의 긴 컨텍스트를 조합하면 토큰 사용량이 오히려 약 36.5% 증가해요. Google은 안정적인 도구가 약 20개 미만일 때는 계속 정적 로딩을 유지할 것을 권장하는데, 이 점은 나머지 두 곳에도 참고가 되지만 각자 실제 측정이 필요해요.
크로스 모델 게이트웨이의 프로토콜 적응 문제
크로스 모델 에이전트를 만드는 팀이 가장 쉽게 빠지는 함정은 “이 모델을 호출할 수 있다”를 “이 모델의 Tool Search를 쓸 수 있다”와 동일시하는 것이에요. 역량을 네 계층으로 나눌 수 있어요: 모델 접근, 프로토콜 엔드포인트(Interactions / Messages / Responses), 도구 선언 필드(tool_search, defer_loading, namespace, MCP 구성), 실행 및 상태 관리(검색 이벤트, 함수 결과, signature, 세션 히스토리). 모델 연결에 성공한 것은 첫 번째 계층에 문제가 없다는 것만 의미해요.
특히 Gemini의 한 가지 규칙에 주의해야 해요: store=false인 무상태 세션에서는 tool_search_call, tool_search_result 및 그 signature를 수정하거나 삭제할 수 없고, 그럴 경우 HTTP 400이 반환돼요. 이는 게이트웨이가 히스토리 메시지를 마음대로 압축하거나 재작성할 수 없다는 뜻이에요. 세 곳을 통일된 Tool Search 인터페이스로 추상화하려면 에이전트 프레임워크 계층에서 이벤트 매핑 테이블을 유지해야 하며, Base URL만 바꾸면 동일한 요청 본문이 그대로 통한다고 기대해서는 안 돼요.
🎯 기술 제안: APIYI apiyi.com 같은 집계 플랫폼을 통해 여러 모델을 연결할 때는, 먼저 소량 트래픽으로 대상 엔드포인트와
tool_search,defer_loading,namespace등의 필드가 완전히 그대로 전달되는지 확인한 다음 Tool Search를 프로덕션 파이프라인에 편입하는 것을 권장해요.
계속 주목해야 할 변수
Gemini Tool Retrieval은 아직 프리뷰 버전이라 정식 출시 전에 인터페이스가 조정될 수 있어요. 실제 프로덕션 환경에서의 평균 절감 비율, 지연 시간, 정확도는 2026년 11월 20일 기준으로 아직 독립적으로 검증된 테스트 결과가 없습니다. 예상할 수 있는 방향 중 하나는 세 업체 모두 ‘도구 카탈로그 거버넌스’를 개발자에게 넘기고 있다는 점이에요. 이름 짓기, 짧은 설명, 그룹화, 권한 설정이 점점 검색 시스템의 인덱스 엔지니어링처럼 변해갈 겁니다. 출시 전에는 초기 입력 토큰, 도구 사용 토큰, 정확한 도구 선택률, 무매칭 검색률, 평균 검색 횟수를 기준으로 대조 실험을 설계하는 걸 권장해요. APIYI apiyi.com 같은 멀티모델 환경에서 동일한 작업 세트로 횡방향 검증을 하면 단일 벤더의 마케팅 수치에 휘둘리는 걸 피할 수 있습니다.
도구가 많다고 해서 Agent가 더 똑똑해지는 건 아니에요. 필요할 때 적합한 도구를 정확히 찾아낼 수 있는지가 Agent의 상한을 결정하죠. 《논어·위령공》에 나오는 말처럼, “장인이 일을 잘하려면 먼저 도구를 날카롭게 해야 한다”고 했으니 말이에요.
참고 자료
- Google Tool Retrieval 기술 문서: 서버 측 및 클라이언트 측 검색, 제한, 과금, 산출 예시
- 링크:
aistudio.google.com/docs/tool-retrieval
- 링크:
- Google 공식 공지: Introducing Tool Retrieval in the Gemini API
- 링크:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- 링크:
- Anthropic Tool Search Tool 문서: Regex, BM25, tool_reference 및 제한
- 링크:
platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- 링크:
- Anthropic Advanced Tool Use 공지: Tool Search 출시 및 내부 평가
- 링크:
anthropic.com/research/advanced-tool-use
- 링크:
- OpenAI Tool Search 문서: namespace, 클라이언트 측 검색 및 동적 주입
- 링크:
developers.openai.com/api/docs/guides/tools-tool-search
- 링크:
- OpenAI GPT-5.4 공지: Tool Search 출시 및 MCP Atlas 테스트
- 링크:
openai.com/index/introducing-gpt-5-4
- 링크:
작성자: APIYI 기술팀
기술 교류: 멀티모델 Agent의 도구 호출 적응에 대해 더 논의하고 싶으시다면 APIYI apiyi.com에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다.