요약: 이 글은 공개된 제3자 테스트 보고서를 바탕으로 Qwen4-Max-Preview가 크레인 게임기(인형 뽑기), Python 서비스 수정, 1,600건의 지원 티켓 검색 같은 과제를 수행한 성과를 분석하고, 처리 시간과 연구 판단에서의 한계를 설명합니다.
결론부터: Qwen4-Max-Preview 프로그래밍 능력에 대한 핵심 판단
공개된 테스트 보고서에 따르면, Qwen4-Max-Preview는 다단계 개발을 진행하고 테스트를 보강하며 재검증 가능한 프로젝트를 전달할 수 있습니다. 가장 강력한 근거는 한 번의 코드 수정 작업에서 나왔습니다. 모델은 먼저 결함을 재현한 뒤 테스트를 추가하고, 실제 HTTP 요청을 보내 데이터 무결성을 검증했으며, 최종적으로 57개 테스트가 모두 통과했습니다. 단점도 분명합니다. 복잡한 작업은 시간이 오래 걸려 크레인 게임기 과제에는 약 75분이 소요됐고, 연구 과제에서는 모델이 계산 결과에 대한 해석을 근거 범위를 넘어서까지 확장했습니다. 따라서 복잡한 산출물과 과학적 결론은 모두 개발자가 검토해야 합니다.
아래에서는 먼저 크레인 게임기 과제부터 살펴보고, 이어서 12개 과제를 포괄하는 보고서를 정리하면서 코드 수정과 티켓 검색이라는 두 갈래의 검증 가능한 근거를 중점적으로 분석하겠습니다. 그다음 비음수 행렬 분해(NMF) 사례로 모델의 추론 경계를 설명하고, 같은 크레인 게임기 챌린지에 대한 도구 간 교차 비교를 통해 효율 문제를 논의한 뒤, 마지막으로 이 모델에 맡기기 적합한 과제 유형을 제시하겠습니다. 이 글은 공개 보고서에 대한 평가 분석이며, 작성자의 프로젝트를 다시 실행하지는 않았습니다. 모든 수치는 출처와 테스트 조건을 함께 표시합니다.
알아두기: Qwen4-Max-Preview 평가를 이해하는 9가지 용어
| 용어 | 설명 |
|---|---|
| Agent | 모델이 스스로 단계를 계획하고 도구를 호출하며 작업을 점진적으로 진행하는 방식입니다. |
| 상태 머신 | 상태 집합과 상태 간 전환 규칙으로 프로그램 동작을 제어하는 방식입니다. 예를 들어 인형뽑기 기계의 “이동—집기—들어올리기—정산”과 같습니다. |
| 회귀 테스트 | 코드를 수정한 뒤 기존 기능을 다시 검증해 이전 동작이 망가지지 않았는지 확인하는 것입니다. |
| HTTP 요청 | 클라이언트가 서버에 보내는 요청으로, 실제 실행 시 인터페이스가 어떤 결과를 반환하는지 확인하는 데 사용합니다. |
| 해시 검증 | 파일 내용의 요약 값을 계산해 앞뒤로 비교하면 원본 데이터나 테스트 파일이 변경되었는지 판단할 수 있습니다. |
| Token 처리량 | 단위 시간당 처리하거나 생성하는 Token 수입니다. 수치는 도구, 네트워크, 실행 환경의 영향을 받습니다. |
| 컨텍스트 검색 | 한 번의 요청에 포함된 대량 자료에서 목표 정보를 찾아 연결하는 것입니다. |
| 비음수 행렬 분해 | 비음수 데이터 행렬을 두 개의 비음수 인자 행렬 곱으로 근사 분해하는 알고리즘입니다. |
| 국소 최적해 | 인접 범위 내에서 더 개선할 수 없는 해입니다. 하나의 해가 국소 최적해인지 판단하려면 추가 수학 조건이나 분석이 필요합니다. |
1 75분 만에 완성한 인형뽑기 기계: Qwen4-Max-Preview의 복잡한 프로그래밍 과제
1.1 인형뽑기 과제가 평가하는 것
2026년 11월 12일, ‘人人都是产品经理’ 매체는 Qoder를 기반으로 한 Qwen4-Max-Preview 실측 리포트를 게재했는데, 그중 가장 복잡한 항목이 인형뽑기 기계 인터랙션 시스템이었어요. 이 과제는 여러 프로그래밍 난점을 하나의 프로젝트에 모아 놓았습니다. 기계적 인터랙션과 힘 피드백, 집게를 매단 줄의 늘어짐과 흔들림, 인형 간 충돌, 제어 흐름의 상태 머신, 그리고 최종 점수 계산 로직까지요.
이런 과제는 한 번에 생성해서 끝내기 어렵습니다. 물리 효과, 상태 전환, 점수 규칙이 서로 의존하기 때문에 모델은 코드를 쓰고, 실행하고, 관찰하고, 고치는 과정을 반복해야 합니다. 그래서 이 과제는 Agent 방식의 다단계 추진 능력을 평가합니다.
1.2 작성자가 기록한 소요 시간, 속도, 소비량
| 지표 | 작성자 기록 | 테스트 조건 및 설명 |
|---|---|---|
| 총 소요 시간 | 약 75분 | Qoder 환경, 단일 과제 |
| 출력 속도 | 약 33 Tokens/s | 해당 과제에서 관측된 속도 |
| Credits 소비량 | 약 65 | 작성자 추산, Token Plan 계량 기준 |
| 결과물 품질 | 상당히 탄탄함 | 작성자의 주관적 평가로, 전체적으로 Kimi K3.1과 비슷한 수준이라고 봄 |
이 수치들은 해당 과제 한 번에만 적용됩니다. Credits는 Token Plan의 구독 계량 단위이고, 실제 소비량은 입력, 캐시 적중, 출력, 사고 Token, 도구 호출의 영향을 함께 받기 때문에 65 Credits는 이번 과제의 비용 규모를 보여줄 뿐입니다. 33 Tokens/s 역시 특정 환경에서 관측된 값입니다.
같은 리포트에는 다른 과제들도 기록되어 있습니다. NumPy와 PIL만 사용하는 수묵화 과제에서 모델은 1,000줄이 넘는 코드를 생성하고 약 4,019개의 붓터치를 그렸으며, 픽셀 명도 통계와 ASCII 윤곽 스캔으로 자체 점검을 하다가 제비와 창 구멍의 검은 덩어리가 겹치는 것을 발견하고 스스로 좌표를 조정했습니다. 작성자는 코드 구성과 자체 점검 능력이 강하다고 평가했지만, 심미적 표현에는 아직 개선할 여지가 있다고 보았습니다.
2 Qwen4-Max-Preview의 12가지 실제 작업은 무엇을 다뤘나
2.1 더 포괄적인 테스트 보고서
11월 16일, ‘人人都是产品经理’는 Z Finance의 테스트 보고서를 게재했어요. 작성자는 12개 작업을 완료했다고 밝혔고, 핵심 결과를 표본 검사하고 다시 검증했다고 해요. 아래 표는 보고서가 다룬 작업을 정리한 거예요.
| 카테고리 | 테스트 작업 | 주요 평가 능력 |
|---|---|---|
| 비주얼 생성 | 자전거를 타는 펠리컨 SVG | 시각 이해, 코드 생성 |
| 재무 분석 | 세 재무 보고서 통합 분석 | 장문 문서 이해, 재무 기준 |
| 차트 인식 | Apple 제품 매출 막대그래프 | 차트 판독, 수치 추정 |
| 오피스 협업 | 회의록 3차 수정 | 컨텍스트 유지, 수정 일관성 |
| 데이터 처리 | 44행 판매 데이터 정제 | 중복 제거, 단위 변환, 수식 |
| 프레젠테이션 | 핑터우거 상장 PPT | 실시간 검색, 파일 생성 |
| 장문 텍스트 검색 | 1,600건 고객 지원 티켓 | 레코드 간 연관, 조건 필터링 |
| 코드 유지보수 | Python 티켓 서비스 수정 | 결함 위치 파악, 테스트 및 회귀 테스트 |
| 연구 재현 | 비음수 행렬 분해 알고리즘 | 알고리즘 구현, 수치 검증 |
| 웹 개발 | 증권신고서 자료 표시 페이지 | HTML, 오프라인 전달, 상호작용 |
| 시뮬레이션 시스템 | 빗물 정원 시뮬레이션 | 상호작용 설계, 수치 계산 |
| 게임 개발 | 사계절 테마 3D 미니 게임 | 3D 장면, 상태 관리, 상호작용 |
2.2 주목할 만한 다섯 가지 사례
이 12개 작업 가운데 다음 다섯 가지가 모델이 ‘쓸 수 있는 결과물’을 내놓는 능력을 가장 잘 보여줘요.
- 재무 보고서 분석: 입력은 Apple, Costco의 FY2026 연차 보고서와 Anthropic의 두 번째 증권신고서였고, 약 8분 만에 완료됐어요. 표본 검사한 6개 핵심 숫자는 모두 정확했고, 모델은 영업 손실과 순손실을 구분했으며, 전환사채 공정가치 변동이 순손실에 미치는 영향을 짚었어요. 공개되지 않은 향후 가이던스는 임의로 만들지 않았고요.
- Excel 정제: 44행 판매 내역에는 중복 레코드, 공백만 다른 중복 데이터, 위안(元)과 만 위안(万元) 두 단위, 세 가지 날짜 형식, 5건의 누락 주문이 섞여 있었어요. 정제 후에는 35행이 남았고, 네 지역 합계는 215,700위안이었어요. 5개 요약 셀은 모두 실제 수식을 사용해서, 상세 내역을 고치면 요약 값이 자동으로 업데이트돼요.
- PPT 생성: 모델은 실시간 검색으로 분사 공고 정보를 찾아내 편집 가능한 PPT를 만들었고, 밸류에이션 예측과 공모가 책정을 구분했어요. 두 번째 수정에서 대상 청중을 바꾼 뒤에도 기존 20개의 핵심 숫자, 날짜, 이름은 모두 그대로 유지됐어요. 작성자는 제품 라인 누락이 있다는 점도 지적했고요.
- 티켓 검색과 Python 수정: 이 두 가지가 가장 구체적인 증거이며, 4절과 3절에서 각각 자세히 다뤄요.
이 작업들의 공통점은 결과물을 검사할 수 있다는 거예요. 수식이 서로 연동되는지, 숫자와 원문이 일치하는지, 테스트가 통과하는지 확인할 수 있죠. 이런 증거는 ‘그럴듯해 보이는 코드 한 토막을 생성했다’는 말보다 훨씬 설득력이 있어요.
3. 57개 테스트 통과: Qwen4-Max-Preview의 가장 설득력 있는 엔지니어링 증거
3.1 수정 과정 전체 재현
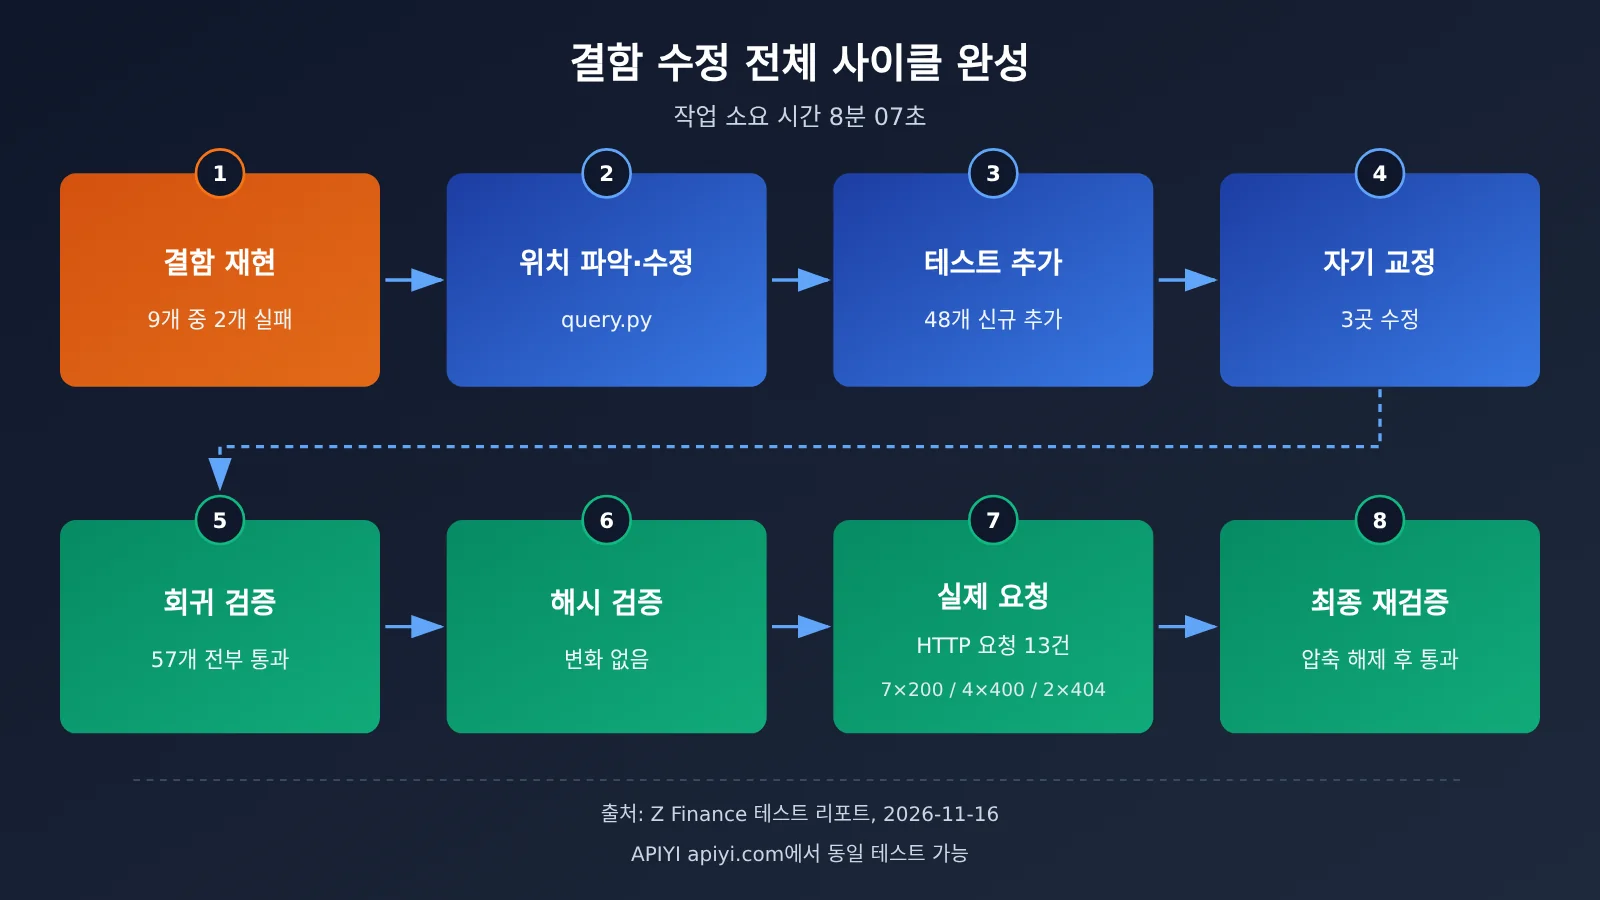
테스트 대상은 Python 표준 라이브러리로 작성된 티켓 조회 서비스이며, 결함은 조합 필터링, 정렬, 페이지네이션, 파라미터 검증과 관련되어 있어요. 과제는 인터페이스, 원본 데이터, 기존 테스트를 그대로 유지하면서 결함을 수정하는 것이었죠. 보고서에는 이 작업에 8분 07초가 걸렸다고 기록되어 있으며, 과정은 다음과 같아요:
| 단계 | 모델의 동작 | 엔지니어링적 의미 |
|---|---|---|
| 결함 재현 | 먼저 기존 9개 테스트를 실행해 그중 2개 실패를 재현 | 문제가 실제로 존재하는지 먼저 확인한 뒤 수정에 착수 |
| 수정 범위 파악 | 주요 수정이 query.py에 집중됨 | 변경 범위가 좁아 부작용 위험 감소 |
| 테스트 보강 | 48개 테스트 신규 추가 | 기존 테스트가 다루지 못한 경계 상황 커버 |
| 자기 교정 | 직접 작성한 테스트에서 발견된 3가지 문제 수정 | 테스트 자체의 오류를 발견하고 즉시 바로잡음 |
| 회귀 검증 | 최종적으로 57개 테스트 전부 통과 | 기존 9개 + 신규 48개 |
| 무결성 검사 | 원본 데이터와 기존 테스트에 대한 해시 검증 결과 변화 없음 | 데이터나 테스트를 조작해서 “통과”하지 않았음을 입증 |
| 실제 요청 | 로컬 서비스 실행 후 HTTP 요청 13건 전송, 결과는 200 7건, 400 4건, 404 2건 | 런타임에서의 정상 응답과 오류 처리 검증 |
| 전달물 재검증 | 최종 전달 패키지 압축 해제 후 재실행, 테스트 통과 | 전달물 자체가 독립적으로 실행 가능함을 확인 |
3.2 왜 이것이 코드 생성보다 문제를 더 잘 설명하는가
AI 프로그래밍에서 흔히 나타나는 실패 방식에는 두 가지가 있어요. 하나는 테스트나 데이터를 바꿔서 테스트를 “초록불”로 만드는 것이고, 다른 하나는 테스트에서는 통과하지만 실제 런타임에서 오류가 나는 경우죠. 이번 과제의 해시 검증은 첫 번째 위험을, 실제 HTTP 요청과 전달 패키지 재검증은 두 번째 위험을 겨냥해요. 400 응답 4건과 404 응답 2건은 모델이 오류 경로까지 검증했다는 뜻으로, 파라미터 검증과 존재하지 않는 리소스 처리 모두 실제로 확인되었어요.
이 흐름은 숙련된 엔지니어가 버그를 고치는 습관과 같아요. 재현, 수정, 보강, 회귀, 전달이죠. 이는 Qwen4-Max-Preview가 규칙이 명확하고 규모를 통제할 수 있는 서비스에서 완전한 유지보수 폐루프를 갖췄음을 보여줘요. 다만 이 역시 한 번의 작업 기록일 뿐이며, 일반적인 코드 수정 성공률로 환산할 수는 없어요.
4 100만 컨텍스트의 실제 가치: 1,600건의 티켓에서 741행 떨어진 단서 찾기
4.1 테스트 설계와 결과
공식 발표 기준 Qwen4-Max-Preview의 컨텍스트 윈도우는 1,000,000 토큰이에요. 윈도우 크기는 어디까지나 용량 상한일 뿐이고, 실용적 가치를 결정하는 것은 모델이 방대한 자료 속에서 올바른 연관 관계를 얼마나 잘 맺는지예요. Z Finance 보고서의 티켓 테스트가 이 질문에 답했어요.
테스트 데이터는 고객 지원 티켓 1,600건으로, 분량은 약 50만 바이트예요. 핵심 단서는 741행 떨어진 두 레코드에 나뉘어 있었고, 총 5개 질문을 던졌어요. 보고서에는 5개 질문 모두 정답을 맞혔다고 기록돼 있어요. 구체적인 결과는 다음과 같아요:
- 두 개로 흩어진 티켓을 연결해 1,386위안 환불 금액과 담당자를 찾아냈어요.
- 승인 날짜를 근거로 보상 쿠폰 신정책이 해당 사례에 적용되는지 판단했어요.
- 지정된 조건에 맞는 티켓 62건을 집계했고, 스크립트 집계 결과와 일치했어요.
- 중복 주문 번호 두 그룹을 찾아내고, 어느 그룹이 정상 흐름에 속하는지, 어느 그룹이 고객 정보 충돌인지 구분했어요.
4.2 바이트와 토큰은 서로 다른 단위예요
약 50만 바이트는 파일 크기이고, 토큰 수는 토큰화 방식과 중국어·영어 비율에 따라 달라져요. 둘은 따로 계산해야 해요. 이 테스트가 입증한 것은 ‘중간 규모 자료에서 레코드 간 연관 관계를 찾고 조건으로 필터링하는 능력’이에요. 테스트 규모는 100만 토큰이라는 윈도우 상한보다 훨씬 작기 때문에 한계 용량을 겨냥한 스트레스 테스트로 볼 수는 없어요.
3번 결과의 가치는 검증 가능성에 있어요. 62건이 스크립트 집계와 일치한다는 점은 모델의 카운트를 결정론적 프로그램으로 재검증할 수 있음을 보여줘요. 실제 사용할 때도 같은 방식을 권해요. 모델이 내놓은 통계 결과는 스크립트로 검증하고, 모델은 연관 관계 찾기나 해석처럼 스크립트가 수행하기 어려운 부분에 활용하면 좋아요.
5 간과할 수 없는 약점: Qwen4-Max-Preview가 과학 연구 추론에서 보이는 과도한 결론
5.1 계산은 맞았지만 해석이 근거를 넘어섰어요
과학 연구 재현 과제는 지정된 논문에 따라 비음수 행렬 분해의 곱셈 업데이트 알고리즘을 구현하는 것이었어요. 입력 행렬은 48×36이고, 서로 다른 세 가지 초기값을 사용해 각각 500회 반복했어요. 보고서에는 모델이 10분 06초 걸렸다고 기록되어 있으며, 코드, 수치 결과, 차트, 로그를 제출했어요. 세 그룹 결과마다 52개의 체크포인트를 제공했고, A 그룹의 핵심 체크포인트는 공개된 참조 결과와 일치했으며, 그 밖에 63건의 자체 점검 기록도 있었어요.
문제는 결론 단계에서 발생했어요. 모델은 목적 함수가 계속 감소한다는 사실만으로 결과가 국소 최적해로 수렴했다고 해석했어요. 작성자는 이것이 과도한 추론이라고 지적했어요.
5.2 분리해서 판단해야 할 세 가지 개념
이 사례는 세 가지 수준의 판단을 포함하며, 뒤의 판단일수록 앞의 판단보다 더 강한 근거가 필요해요.
- 목적 함수 감소: 곱셈 업데이트 규칙의 설계상 특성이며, 로그와 차트에서 직접 관찰할 수 있어요.
- 수치 반복 수렴: 반복량의 변화가 안정화되는지 확인하고 명확한 중지 기준을 설정해야 해요.
- 국소 최적해로의 수렴: KKT 조건과 같은 최적성 조건을 검증해야 하며, 함수값의 감소만으로는 결론을 내릴 수 없어요.
이것은 모델의 실행 능력과 논증의 엄밀성을 별개로 평가해야 한다는 점을 보여줘요. 수치 계산은 체크포인트로 검증할 수 있지만, 과학적 결론은 관련 배경을 가진 사람이 검토해야 해요. 연구, 논문 재현 또는 기술 보고서 상황에서는 모델이 출력한 “결론 단락”을 초안으로 취급해야 해요.
6 Qwen4-Max-Preview와 다른 프로그래밍 도구의 동일 작업 대조
6.1 인형 뽑기 기계 챌린지의 대조 데이터
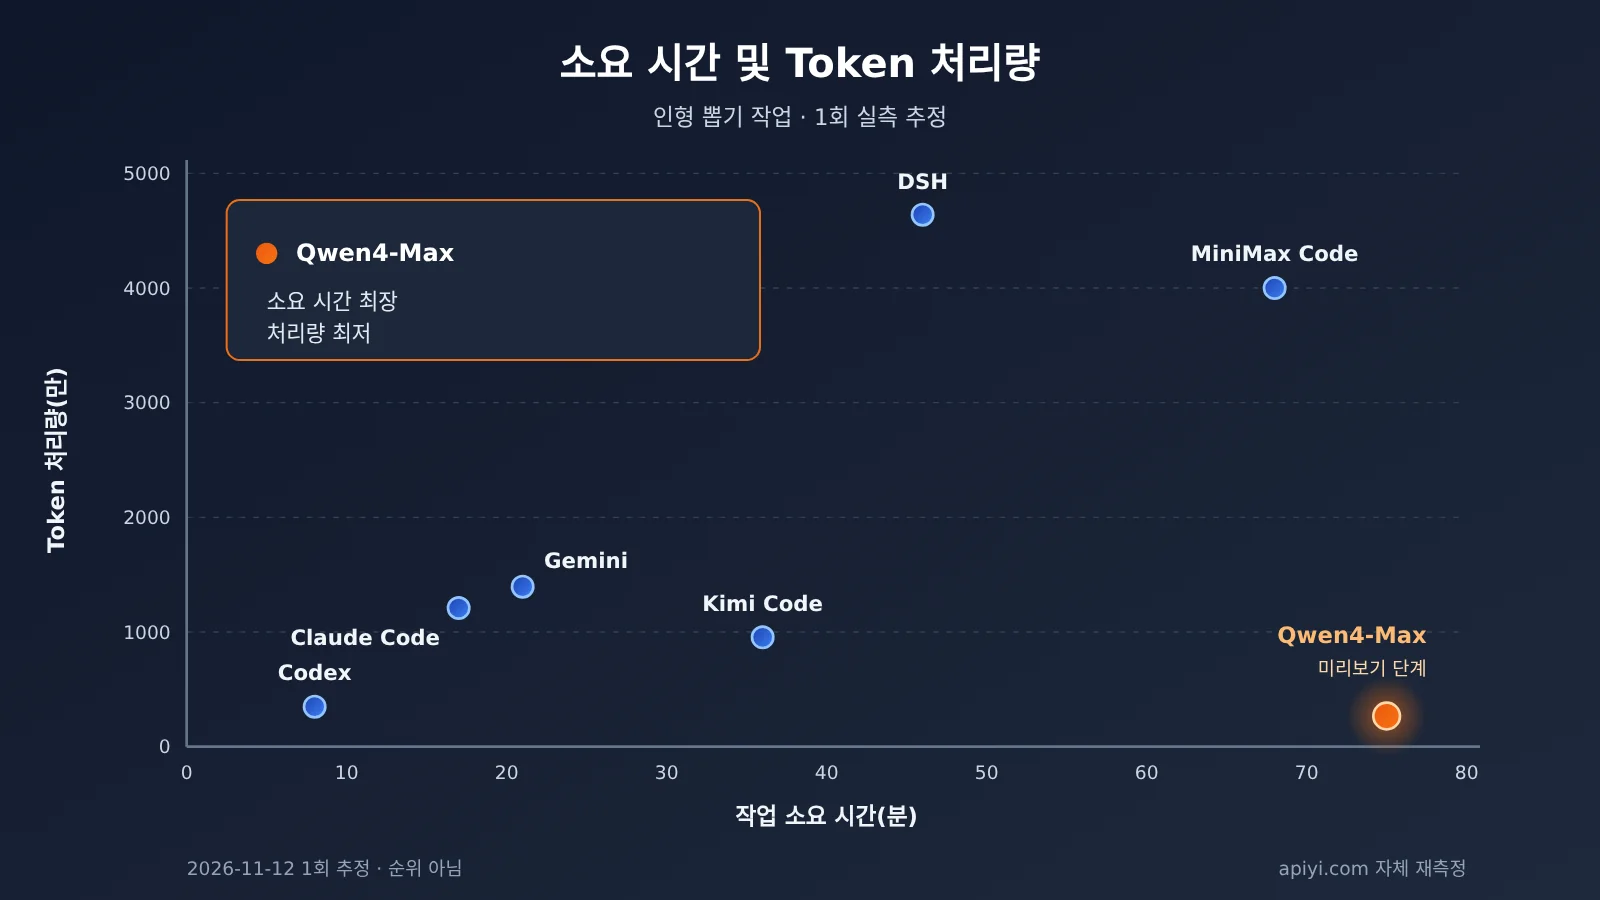
11월 12일 보고서에는 동일한 인형 뽑기 기계 챌린지를 여러 도구에서 수행한 기록도 함께 실려 있어요. 원래 표에서 Qwen 행은 Qwen4-Max로 표기되어 있고, 테스트 시점은 11월 12일로 정식 버전이 출시된 11월 16일보다 앞서므로, 프리뷰 단계의 모델에 해당해요.
| 도구/모델 | 소요 시간 | Token 총 처리량(추정) | 출력 Token | 재측정 경로 |
|---|---|---|---|---|
| Codex | 8분 | 350만 | 2.8만 | 해당 공식 도구 |
| Claude Code | 17분 | 1,215만 | 13만 | 공식 도구, Claude 모델은 APIYI apiyi.com으로 호출 가능 |
| Gemini | 21분 | 1,394만 | 8.1만 | 공식 도구, Gemini 모델은 APIYI로 호출 가능 |
| Kimi Code | 36분 | 950만 | 5.9만 | 해당 공식 도구 |
| DSH | 46분 | 4,644만 | 28.1만 | 해당 공식 도구 |
| MiniMax Code | 68분 | 4,000만 | 19.8만 | 해당 공식 도구 |
| Qwen4-Max(프리뷰 단계) | 75분 | 269만 | 5.5만 | Token Plan(Qoder) |
6.2 이 데이터를 읽는 방법
데이터는 뚜렷한 대비를 보여줘요. Qwen4-Max-Preview는 이 작업에서 Token 총 처리량이 가장 낮았고, 약 269만 수준이었는데 소요 시간은 오히려 가장 길었죠. 약 75분이 걸렸어요. 관측된 속도가 약 33 Tokens/s라는 점을 함께 보면, 이번 작업의 병목은 생성 속도에 있었고 소모된 Token 규모 자체는 크지 않았다는 걸 알 수 있어요.
이 데이터는 순위를 매기기엔 적합하지 않아요. 이유는 세 가지예요. 우선 Token 총량은 작성자가 추정한 값이고, 각 도구의 컨텍스트 캐시 비중과 호출 전략, 실행 방식이 서로 다르며, 표에 적힌 각 모델의 구체적인 버전도 통일된 설명이 없어요. Token 처리량이 낮은 이유는 반복 읽기가 적었기 때문일 수도 있고, 도구 계층의 캐시 전략 차이 때문일 수도 있는데, 현재 자료만으로는 둘을 구분할 수 없어요. 이 데이터가 뒷받침할 수 있는 판단은 하나예요. 이 도구 환경에서는 Qwen4-Max-Preview가 대기 시간에 민감하지 않고 결과물의 완성도를 더 중시하는 작업에 적합하다는 것이죠.
7 어떤 개발자가 Qwen4-Max-Preview를 시도해볼 만할까
7.1 적합한 경우와 주의가 필요한 경우
두 보고서를 종합해 보면, Qwen4-Max-Preview는 다음 작업에서 비교적 안정적인 성능을 보였어요:
- 규칙이 명확한 코드 유지보수: 기존 테스트가 있고 문제 경계가 분명한 수정 및 보완 테스트 작업.
- 긴 문서 검색 및 연관 분석: 티켓, 로그, 계약서, 재무 보고서에서 기록 간 검색을 수행하고, 스크립트로 통계 결과를 교차 검증.
- 사무 자동화: 데이터 정제, 수식이 포함된 Excel, 편집 가능한 PPT, 여러 차례에 걸친 수정.
- 인터랙티브 프로토타입 개발: 단일 파일 웹페이지, 시뮬레이션 시스템, 미니 게임 프로토타입. 예를 들어 보고서에 나온 약 46KB, 외부 의존성이 없는 오프라인 데모 페이지.
주의가 필요한 작업은 세 가지예요: 응답 시간에 민감한 인터랙티브 개발(단일 작업이 한 시간 이상 이어질 수 있음), 엄격한 수학적·과학적 논증이 필요한 결론 출력, 그리고 높은 신뢰성이 요구되는 프로덕션 변경이에요. 보고서 작성자의 요약에도 “범위가 넓은 작업에서는 일부 정보가 누락될 수 있다”와 “최종 산출물은 여전히 사람이 검증해야 한다”는 점이 포함돼 있어요.
사용 전에 공식 제한도 확인해야 해요: Preview는 알리바바 클라우드(Alibaba Cloud) Token Plan을 통해서만 Claude Code, Cursor, Qoder 등의 도구에서 상호작용식으로 사용할 수 있고, 종량제 과금은 지원하지 않아요. 프리뷰 기간은 2026년 11월 25일 24:00(베이징 시간)에 종료된 뒤 서비스가 내려가요. 정식 버전 Qwen4-Max는 이미 11월 16일에 출시됐고, 공식 측은 정식 버전으로 마이그레이션할 것을 권장해요. 두 버전은 파라미터가 달라요: 정식 버전의 사고 모드 최대 출력은 262,144 Tokens, Preview는 393,216 Tokens이므로 마이그레이션할 때 출력 예산을 다시 설정해야 해요.
7.2 자체 작업으로 같은 유형의 재테스트 해보기
다른 사람이 만든 보고서는 기껏해야 “이 모델이 이걸 할 수 있다” 정도만 알려줘요. 이 모델이 우리 팀에 맞는지 판단하는 가장 직접적인 방법은 자체 실제 코드와 테스트로 한 번 대조해 보는 거예요. 아래 예시는 OpenAI 호환 인터페이스로 코드 수정 작업을 보내고, 소요 시간과 토큰 사용량을 기록해요. 모델 이름은 플랫폼 모델 목록에 있는 실제 명칭을 기준으로 하세요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, OpenAI 호환
)

resp = client.chat.completions.create(
    model="qwen4-max",  # APIYI 모델 목록에 있는 실제 명칭을 기준으로 함
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
여러 모델 대조 재테스트 스크립트 보기
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 하나의 Key로 여러 모델 호출
)

# 플랫폼 모델 목록에 있는 실제 명칭으로 교체하세요
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # 추론 모델의 사고 토큰도 출력 예산을 차지하므로 여유 공간을 확보해야 함
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # 패치를 격리 디렉터리에 적용하고, 테스트를 실행하며 원본 데이터에 대한 해시 검증 후 채점
스크립트는 제안과 사용량을 수집하는 역할만 담당하고, 채점 단계는 보고서의 방식을 그대로 따라야 해요. 격리 디렉터리에 패치를 적용하고, 기존 테스트와 신규 테스트를 실행하며, 해시 값으로 데이터와 기존 테스트가 변경되지 않았는지 확인하는 거죠. 이렇게 얻은 결론이라야 내 코드베이스에 유효해요.
🚀 빠른 시작: 같은 작업 세트에서 여러 모델을 비교하려면 APIYI apiyi.com에서 무료 테스트 크레딧을 받을 수 있어요. 플랫폼은 OpenAI 호환 인터페이스를 제공하며, 하나의 API 키로 OpenAI, Claude, Gemini 등 주류 모델을 전환할 수 있어 재테스트 스크립트를 동일한 평가 파이프라인에서 돌리기 편해요.
8 Qwen4-Max-Preview 평가 자주 묻는 질문
Q1: 75분 만에 뽑기 기계(클로 머신)를 완성했다면, 속도가 느린 건가요?
해당 Qoder 작업에서 소요 시간은 대조표에서 가장 길었고, 관측된 출력 속도는 약 33 Tokens/s였어요. 이는 단일 환경에서의 기록일 뿐이며, 도구 스케줄링과 네트워크 조건에 따라 결과가 달라질 수 있어요. 대기 시간에 민감한 시나리오라면 본인의 작업으로 직접 실측해 보는 것을 권장해요.
Q2: 57개 테스트 통과가 코드 수정 성공률을 나타낼 수 있나요?
이는 하나의 완전하고 검증 가능한 수정 과정을 나타낼 뿐이며, 성공률로 환산할 수는 없어요. 자체 프로젝트에서의 성능을 평가하려면 APIYI apiyi.com을 통해 동일한 결함 샘플 세트로 여러 모델을 비교하고, 테스트 통과 여부와 해시 검증 결과를 기준으로 점수를 매길 수 있어요.
Q3: 티켓 테스트가 100만 Token 컨텍스트 윈도우를 검증했나요?
아니요. 해당 테스트는 약 50만 바이트 규모이며, Token 수는 토크나이즈 방식에 따라 달라지고 윈도우 상한보다 훨씬 작아요. 이 테스트가 검증한 것은 기록 간 연관성과 조건 필터링 능력이에요.
Q4: Preview 종료 후에는 어떻게 해야 하나요?
공식 측은 이미 정식 버전 Qwen4-Max를 출시했으며 정식 버전 사용을 권장하고 있어요. 정식 버전은 사용량 기반 과금 API를 지원하고, 사고 모드의 최대 출력은 262,144 Tokens이므로 이전할 때 출력 예산을 조정해야 해요. 타사 플랫폼의 상장 상황과 가격은 빠르게 변동되므로, APIYI apiyi.com의 모델 목록에서 현재 사용 가능한 모델명을 확인한 뒤 연동하는 것이 좋아요.
Q5: Token Plan의 Key를 자체 애플리케이션 백엔드에 넣을 수 있나요?
안 돼요. 공식 규정상 Token Plan은 허용된 프로그래밍 도구와 에이전트 도구에서 대화형으로만 사용할 수 있으며, 자동화 스크립트의 배치 호출과 자체 구축 애플리케이션 백엔드는 허용 범위에 포함되지 않아요. 위반 시 구독이 일시 중지되거나 Key가 차단될 수 있어요. 자체 구축 애플리케이션에는 사용 범위에 맞는 API 제품을 선택해야 해요.
9 Qwen4-Max-Preview 평가 핵심 요약
- 전달의 완결성: 코드 수정 작업이 재현, 수정, 보충 테스트, 해시 검증, 실제 요청, 납품 재검증까지 아우르며 57개 테스트를 통과했어요.
- 장문 연관: 1,600건의 티켓에서 741행에 걸친 연관 단서를 찾아냈고, 5개 질문 모두 정답이었으며 62개 통계가 스크립트와 일치했어요.
- 오피스 문서 산출: Excel 수식이 연동되고, PPT를 여러 차례 수정한 뒤에도 20개 핵심 사실이 그대로 유지됐어요.
- 속도의 약점: 인형뽑기 기계 작업에 약 75분이 걸렸고, 토큰 처리량은 낮은데 소요 시간은 길었어요.
- 추론의 경계: 연구 재현의 계산은 참고 결과와 일치했지만, 결론에는 과잉 추론이 있어 사람의 검토가 필요해요.
- 증거의 성격: 위 내용은 모두 한 명의 작성자가 수행한 작업 실측이며, 표준화된 순위를 구성하지 않아요.
- 시작하는 방법: 자신의 코드와 테스트로 대조 재측정을 해보세요. APIYI apiyi.com을 활용하면 하나의 인터페이스 안에서 여러 모델을 전환할 수 있어요.
10 정리: 개발자는 Qwen4-Max-Preview를 어디에 써야 할까
공개 보고서가 그리는 그림은 꽤 명확해요. Qwen4-Max-Preview는 규칙이 분명하고 결과를 검증할 수 있는 작업에 강해요. 테스트가 딸린 코드 유지보수, 긴 자료 속 레코드 간 검색, 수식이 포함된 데이터 처리와 편집 가능한 오피스 파일, 그리고 인터랙티브 프로토타입 개발이 그런 작업이죠. 이런 작업에서 모델은 스스로 테스트를 보충하고 오류를 찾아내며, 다시 검증할 수 있는 결과물을 전달해요.
한계도 구체적이에요. 복잡한 작업은 시간이 오래 걸리니 백그라운드에서 돌리는 편이 적합하고, 과학적 결론은 증거 범위를 넘어서기 쉬워 전문가 검토가 필요해요. Preview는 Token Plan을 통해서만 지정된 도구에서 상호작용하며 사용할 수 있고, 11월 25일에 서비스가 종료되므로 장기 사용은 정식 버전으로 옮겨야 해요.
가장 현실적인 방법은 이 모델을 유지보수 폐쇄 루프를 독립적으로 완수하는 엔지니어링 조수로 삼고, 결론 검증과 최종 병합은 개발자가 맡는 거예요. 출시 전에는 자신의 실제 작업으로 한 번 다중 모델 대조를 해보는 걸 권해요. APIYI apiyi.com의 통합 인터페이스를 쓰면 같은 흐름 안에서 테스트와 비교를 한 번에 끝낼 수 있어요.
📚 참고 자료
-
모두가 프로덕트 매니저다(Woshipm): Qwen4-Max 프리뷰 버전 등장! 실측 후기: Qoder 클로 머신 실측 및 크로스 툴 비교, 2026-11-12
- 링크:
woshipm.com/ai/6492544.html - 설명: 75분 소요 시간, 33 Tokens/s, 65 Credits 및 비교표 출처
- 링크:
-
모두가 프로덕트 매니저다(Woshipm): Qwen4-Max-Preview 실측(Z Finance 테스트 리포트): 12개 과제 종합 테스트, 2026-11-16
- 링크:
woshipm.com/evaluating/6494229.html - 설명: 코드 수정, 티켓 검색, 연구 재현, 사무 업무 데이터 출처
- 링크:
-
알리바바 클라우드 Model Studio: Qwen4-Max-Preview 문서: 공식 사양 및 사용 설명
- 링크:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 설명: 컨텍스트 윈도우, 최대 출력, 프리뷰 기간 및 연동 방식
- 링크:
-
알리바바 클라우드 Model Studio: Qwen4-Max 문서: 정식 버전 파라미터와 과금
- 링크:
help.aliyun.com/zh/model-studio/qwen4-max - 설명: 정식 버전 출력 예산 및 종량 과금 정보
- 링크:
-
알리바바 클라우드: Token Plan 권한 및 사용 규범: 사용 범위 제한
- 링크:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 설명: 대화형 사용 요구 사항 및 금지 시나리오
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 웹사이트 홈페이지에서 저희에게 연락해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다.