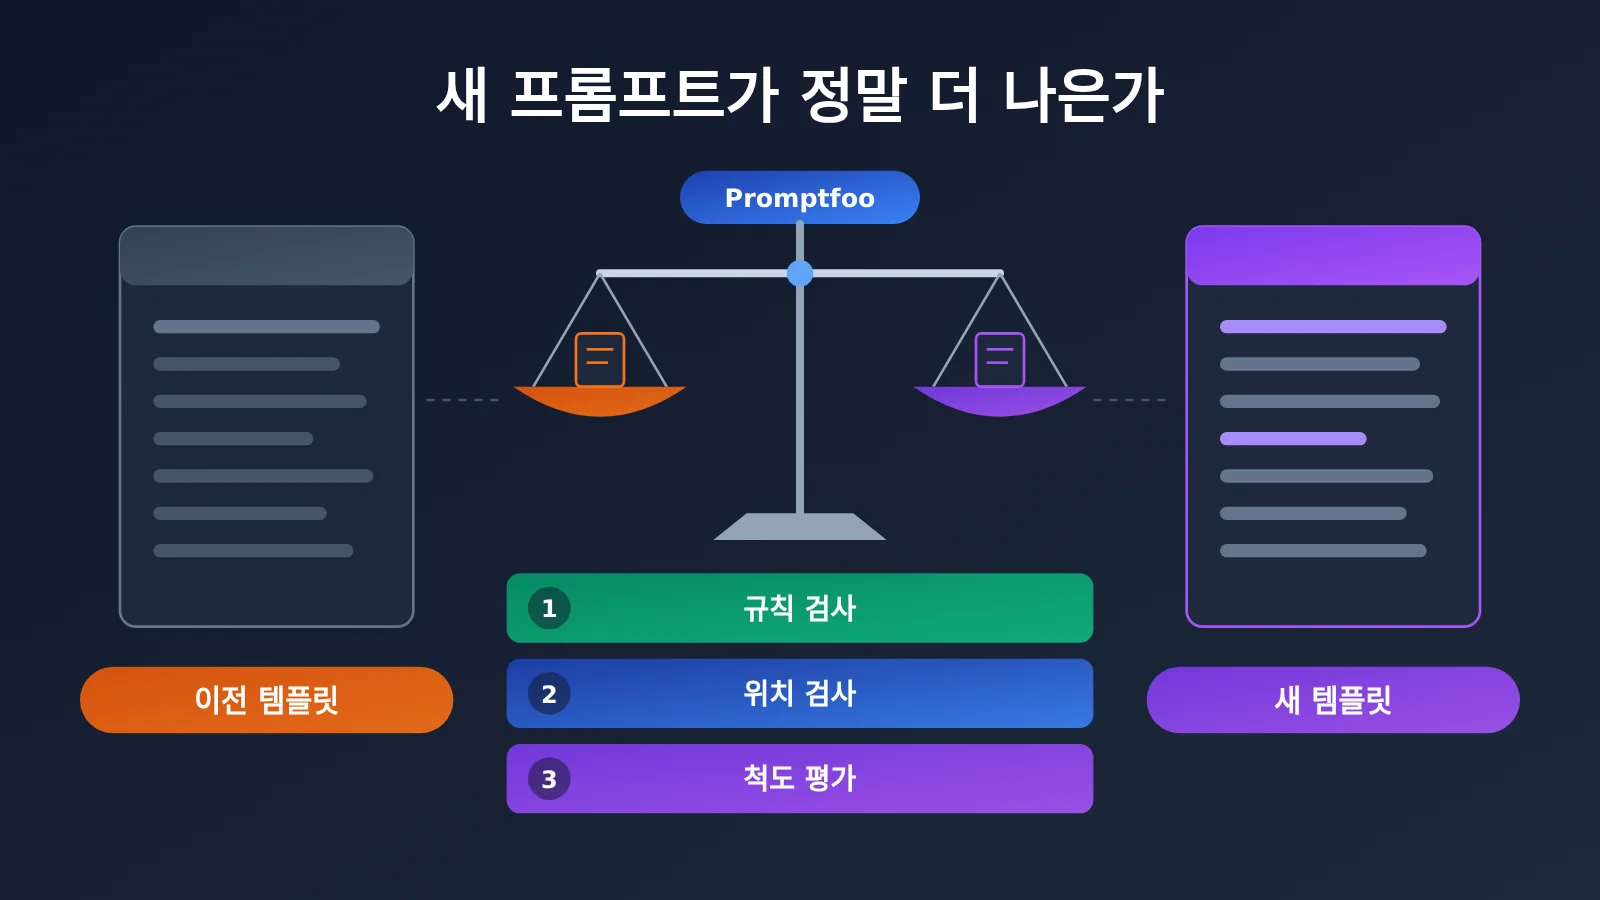
바로 답변: 새 프롬프트가 반드시 더 좋은 것은 아니며, “더 좋아 보인다”도 근거가 될 수 없어요. 신·구 글 템플릿 중 어느 것이 더 나은지 판단하려면 자료, 모델, 생성 설정을 고정하고 템플릿만 바꾼 뒤, Promptfoo의 어설션으로 구조·순서·콘텐츠 품질을 계층적으로 점검해야 해요. 결과도 차원별로 제시해야 하고, 문장력 점수가 사실 오류를 가려서는 안 돼요. 이 글은 하나의 실험 설계안을 제안할 뿐 실제 A/B 실험을 실행하지 않았기 때문에 승률, 점수, 절감 수치를 제시하지 않아요.
이 글을 읽고 나면 다음을 알 수 있어요:
- Promptfoo의
contains, JavaScript,llm-rubric어설션이 각각 무엇을 점검할 수 있고, 무엇을 증명할 수 없는지. - 이미 생성된 모델 출력에 어설션 파일만 별도로 실행해, 채점 규칙만 바꿀 때 재생성을 피하는 방법.
- 변수 통제, 세 계층 검사, 차원별 제시를 포함한 신·구 글 템플릿 비교 실험 설계.
- 모델 심사자와 규칙 어설션의 경계, 그리고 유료 심사 모델에서 비용 문제가 생기는 지점.
목차: 먼저 개념 표로 Promptfoo 평가에서 쓰이는 몇 가지 핵심 용어를 설명하고, 이어서 이 일이 콘텐츠 팀, 개발자, 평가 책임자에게 미치는 영향을 설명해요. 본문의 ‘객관적 사실’ 부분에서는 문서에 적힌 어설션 기능과 검증 상태만 정리해요. ‘분석적 판단’ 부분에서는 실험 설계 제안, 설정 예시, 한계 논의를 제시하고, 각 항목이 실제 측정 결론이 아니라 제안임을 하나하나 표시해요.
Promptfoo로 프롬프트 템플릿을 비교하기 전에 알아야 할 개념
아래 용어들은 뒤에서 반복해서 나와요. 대부분 Promptfoo 설정 문서에서 온 것이고, 일부는 평가 실험에서 흔히 쓰는 표현이에요.
| 개념 | 간단한 설명 |
|---|---|
| Promptfoo | 대규모 언어 모델의 프롬프트와 출력을 평가하는 오픈소스 도구예요. 설정 파일로 테스트 케이스와 어서션을 정의할 수 있어요. |
| 어서션(Assertion) | 모델 출력이 특정 조건을 만족하는지 자동으로 검사하는 규칙이에요. |
| contains | 출력에 지정된 텍스트가 나타나는지 확인해요. 결정론적인 문자열 일치 검사예요. |
| JavaScript 어서션 | JavaScript 표현식이나 함수로 더 복잡한 판단 조건을 구현해요. |
| llm-rubric | 모델이 사용자 정의 평가 기준표에 따라 출력에 점수를 매기게 해요. ‘모델 채점’ 유형의 어서션이에요. |
| 채점 제공자(Grading Provider) | llm-rubric 채점을 실행하는 모델이에요. 별도로 설정할 수 있어요. |
| 평가 기준표(Rubric) | 채점 모델에 주는 판단 기준이에요. 어떤 경우를 통과로 볼지, 어떤 경우에 점수를 깎을지 설명해요. |
| 모델 심사자(LLM-as-a-Judge) | 사람 대신 대규모 언어 모델로 출력 품질을 평가하는 방식이에요. |
| 변수 제어 | 실험에서 한 가지 요인(여기서는 템플릿)만 바꾸고 나머지 요인은 그대로 유지하는 거예요. |
신·구 프롬프트 템플릿 평가의 영향 한눈에 보기
이런 평가 방법의 가치는 도구 자체가 얼마나 새로운지에 있지 않고, “새 템플릿이 더 낫다고 느끼는 것”을 다시 확인할 수 있는 검사 기록으로 바꾸는 데 있어요. 직군마다 여기서 얻는 것은 달라요.
| 직군 | 실질적 영향 |
|---|---|
| 콘텐츠 팀과 편집자 | 템플릿 개편에 다시 검토할 수 있는 승인 기준이 생기고, “구조는 맞지만 사실 단락에 추측이 섞였다” 같은 문제를 발견할 수 있어요 |
| 프롬프트 엔지니어와 개발자 | 템플릿 요구 사항을 규칙 어서션과 척도 어서션으로 나눌 수 있고, 채점 규칙을 수정할 때 모든 출력을 다시 생성할 필요가 없어요 |
| 평가 책임자 | 차원별로 결과를 보고해야 하고, 모델 채점·규칙 적중·수동 검토 각각의 증명력을 분명히 구분해야 해요 |
| 예산 책임자 | 규칙 어서션은 추가 호출 비용이 거의 들지 않지만, llm-rubric이 유료 모델을 쓰면 채점 비용이 발생해요 |
Promptfoo 어서션 기능에 대한 객관적 사실
이 부분에서는 Promptfoo 문서에 설명된 기능만 이야기해요. 2026-11-17에 관련 문서 페이지를 확인했지만, 이런 기능의 첫 출시 날짜는 확인되지 않았어요. 그래서 이 글에서는 구체적인 출시 시점을 밝히지 않아요.
Promptfoo의 contains 어서션: 텍스트가 나타나는지 확인
contains는 가장 기본적인 어서션 유형으로, 모델 출력에 지정한 텍스트가 나타나는지 확인하는 데 써요. 결정론적 문자열 일치라서 같은 출력은 실행할 때마다 같은 결과를 얻어요.
강조하고 싶은 건, contains가 통과했다고 해서 “해당 문구가 나타났다”는 것만 말해 준다는 거예요. 그 문구가 들어간 단락이 잘 쓰였는지, 내용이 올바른지는 말해 주지 못해요.
Promptfoo의 JavaScript 어서션: 복잡한 조건 구현
판단 조건이 “포함 여부”를 넘어서면 JavaScript 어서션으로 사용자 정의 로직을 작성할 수 있어요. 예를 들어 두 제목이 나타나는 순서를 비교하거나, 특정 섹션의 개수를 세거나, 어떤 문구가 특정 섹션 안에 들어 있는지 확인할 수 있어요. 이런 어서션도 여전히 결정론적이라 결과를 재현할 수 있어요.
독립 어서션 파일로 Promptfoo의 기존 출력 평가하기
Promptfoo는 이미 생성된 모델 출력에 독립 어서션 파일을 실행할 수 있어서, 모든 출력을 다시 생성할 필요가 없어요. 이건 평가 반복에 중요해요. 채점 규칙은 자주 조정해야 하는 경우가 많고, 생성 자체는 시간도 오래 걸리고 호출 비용도 들기 때문이에요.
Promptfoo의 llm-rubric: 모델이 척도에 따라 채점
llm-rubric은 모델 채점형 어서션이에요. 출력과 사용자 정의 척도를 채점 모델에 넘기고, 채점 모델이 통과 여부를 판단하면서 이유를 제시해요. 문서에 따르면 채점을 수행하는 평가 제공자는 별도로 설정할 수 있고, 채점에 사용하는 프롬프트도 사용자 정의할 수 있어요.
| 어서션 유형 | 판단 방식 | 결과가 결정론적인가 | 증명할 수 있는 것 | 증명할 수 없는 것 |
|---|---|---|---|---|
| contains | 문자열 일치 | 결정론적 | 지정한 텍스트가 나타났음 | 단락 품질, 내용 정확성 |
| JavaScript | 사용자 정의 코드 로직 | 결정론적 | 구조, 순서, 개수 등 코드화 가능한 조건 | 의미론적 수준의 좋고 나쁨 |
| llm-rubric | 모델이 척도에 따라 채점 | 채점 모델의 영향을 받음 | 출력이 채점 모델이 보기에 척도에 부합함 | 사실 정확성, 수동 검토를 대체할 수 없음 |
자료 출처와 확인 상태
이 글의 사실 부분은 다음 Promptfoo 문서 페이지를 근거로 하며, 확인 날짜는 2026-11-17이에요:
- Promptfoo 어서션 및 지표 문서: promptfoo.dev/docs/configuration/expected-outputs/
- Promptfoo 모델 평가 어서션 문서: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Promptfoo llm-rubric 문서: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
이 글은 실제 신·구 템플릿 A/B 실험을 실행하지 않았어요. 뒤에 나오는 구성과 흐름은 모두 설계 제안이며, 어떤 실제 측정 결과도 나타내지 않아요.
Promptfoo로 이전·새 문서 템플릿을 비교하는 분석과 판단
다음 내용은 위에서 살펴본 사실을 바탕으로 우리가 내린 해석과 제안이에요. ‘뉴스 기사 템플릿’을 예로 들어 볼게요. 새 템플릿이 글에 ‘객관적 사실’과 ‘분석적 판단’이라는 두 가지 섹션을 포함하도록 요구하고, 사실이 앞에 오고 분석이 뒤따르며, 사실 단락에는 추측이 섞여 들어가서는 안 된다고 가정해 봐요.
실험 설계: Promptfoo로 템플릿을 비교할 때 변수는 하나만 바꾸기
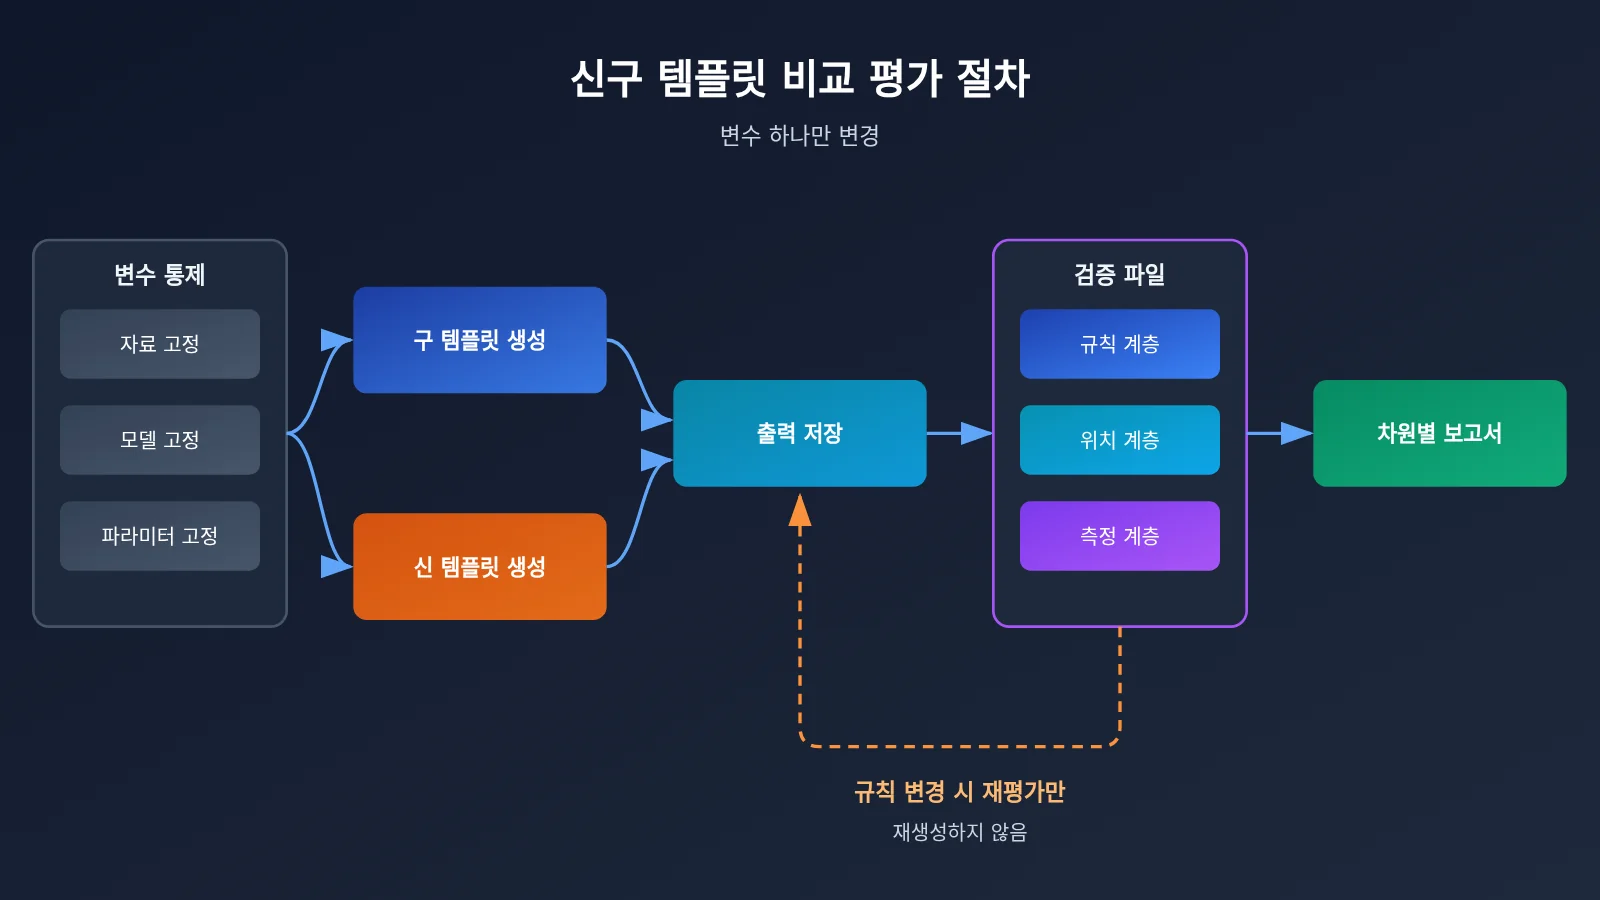
템플릿을 비교할 때 가장 흔히 하는 실수는 템플릿을 바꾸면서 자료나 모델, 또는 온도 파라미터까지 함께 바꾸는 거예요. 이렇게 하면 결과가 좋아지더라도 그게 템플릿 덕분인지 다른 요인의 영향인지 설명하기 어려워요. 그래서 첫 번째 단계는 템플릿을 제외한 모든 변수를 고정하는 거예요.
| 변수 | 처리 방식 | 이유 |
|---|---|---|
| 입력 자료 | 같은 배치로 고정, 이전·새 템플릿이 공유 | 자료가 다르면 사실 내용이 직접 달라짐 |
| 생성 모델 | 동일 모델과 버전으로 고정 | 모델마다의 작성 스타일 차이가 템플릿 차이보다 클 수 있음 |
| 생성 파라미터 | 온도, 최대 길이 등 설정을 고정 | 파라미터가 출력의 안정성과 분량에 영향 |
| 프롬프트 템플릿 | 유일하게 바뀌는 변수 | 이 부분이 검증 대상 |
| 평가 규칙 | 이전·새 두 그룹 모두 동일한 어서션 세트 사용 | 두 그룹이 동일한 검사를 받도록 보장 |
Promptfoo 규칙 계층과 위치 계층: 구조를 먼저 확인하고 순서를 확인하기
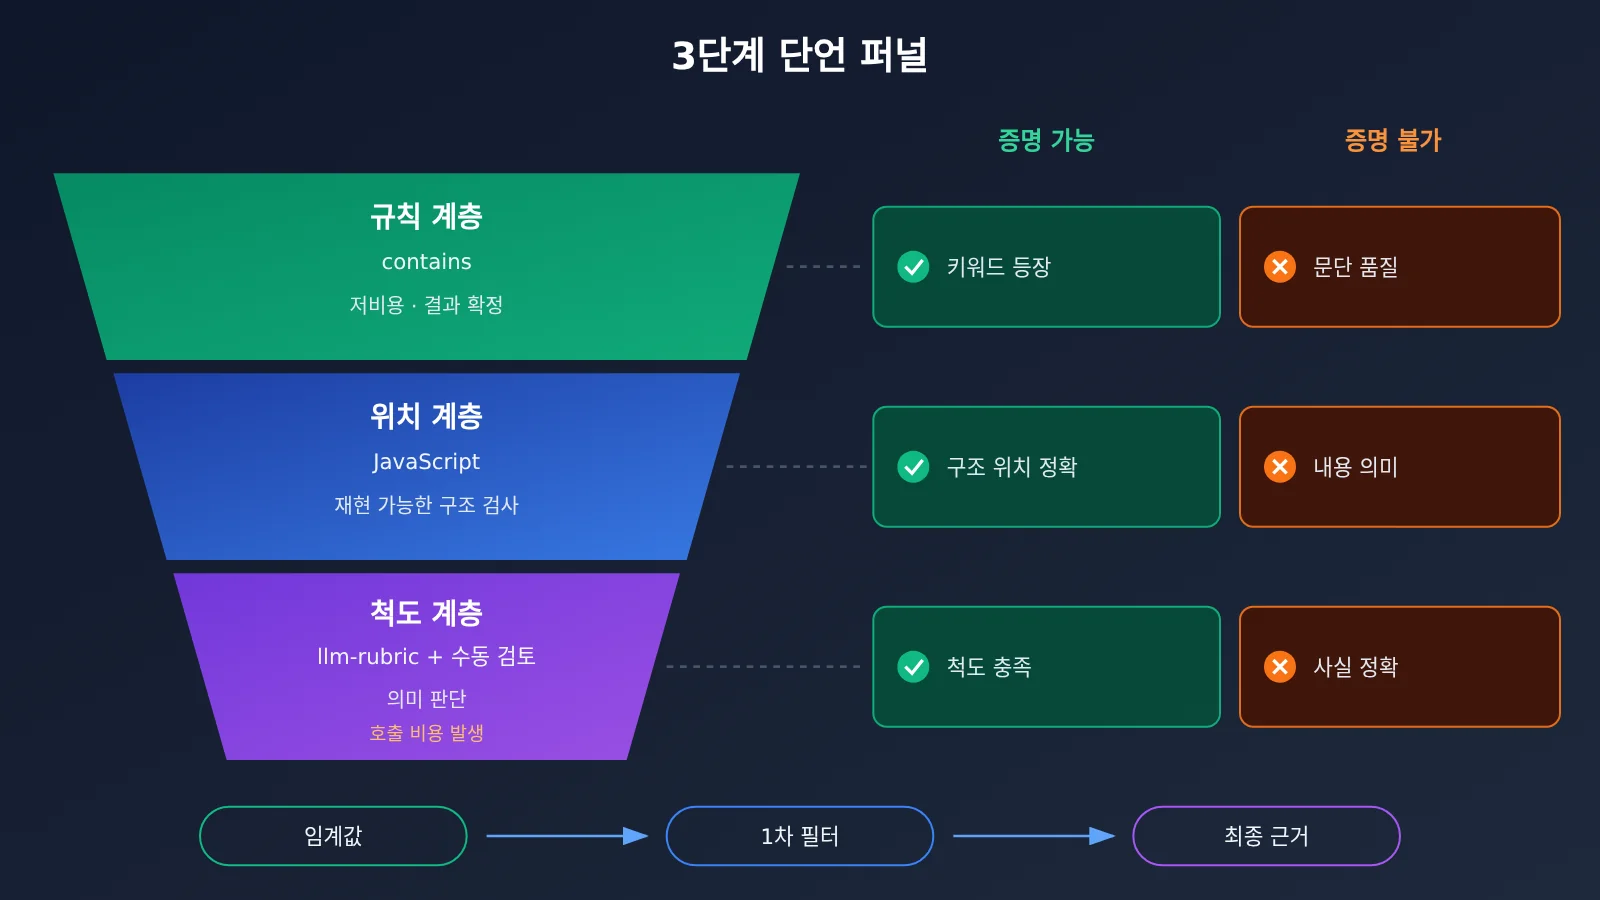
첫 번째 계층은 규칙 검사로, contains를 사용해 템플릿에서 요구하는 제목이 나타나는지 확인합니다. 두 번째 계층은 위치 비교로, JavaScript 단언을 사용해 “객관적 사실” 제목이 “분석 판단” 제목보다 먼저 나타나는지 확인합니다. 이 두 계층은 모두 결정론적 검사로, 비용이 낮고 결과가 안정적이어서 가장 앞에 배치해 명백히 불합격인 출력을 걸러내기에 적합합니다.
아래는 예시적인 단언 작성 방법입니다. 구체적인 필드 이름은 Promptfoo 공식 문서를 기준으로 확인하세요:
# 예시 구성: 사고 방식 설명용, 필드 세부 사항은 공식 문서를 참고해 확인하세요
assert:
  # 규칙 계층: 제목이 나타나는지 확인
  - type: contains
    value: "## 객관적 사실"
  - type: contains
    value: "## 분석 판단"

  # 위치 계층: 사실 장이 분석 장보다 먼저 와야 함
  - type: javascript
    value: |
      const a = output.indexOf('## 객관적 사실');
      const b = output.indexOf('## 분석 판단');
      return a >= 0 && b >= 0 && a < b;
주의: 위치 계층 작성 방식에서는 먼저 두 제목이 모두 존재하는지 판단했습니다. 만약 a < b만 작성하면, “객관적 사실” 제목이 없을 때 indexOf가 -1을 반환하여 “보다 작다” 조건을 만족하게 되어 오판단을 일으킵니다. 이는 결정론적 단언도 신중하게 작성해야 하는 이유입니다.
Promptfoo 평가 척도층: 명확한 척도로 사실 단락에 추측이 섞였는지 확인하기
제목이 모두 갖춰지고 순서가 올바르다고 해서 사실 단락이 깔끔하게 작성되었다는 뜻은 아니에요. “사실 단락에 추측이 섞였는지”는 의미 판단의 영역이라 규칙 기반 단언으로는 포괄하기 어려워요. 이럴 때 llm-rubric을 쓰는 게 적합하죠. 평가 척도는 구체적으로 작성해서, 점수 모델에게 무엇이 위반인지 알려줘야 해요. “잘 썼는지 아닌지”를 뭉뚱그려 묻는 것과는 달라요.
# 예시 구성: 평가 제공자와 척도 내용은 모두 예시입니다
assert:
  - type: llm-rubric
    value: |
      只评估“客观事实”章节。
      若该章节出现预测、主观评价或未标注来源的推断,判为不通过,并引用出问题的原句。
      不评价文采,不评估其他章节。
    provider: your-grading-model   # 평가 제공자는 별도로 구성할 수 있습니다
평가 척도층의 결론은 여전히 사람의 표본 검토가 필요해요. 점수 모델은 놓칠 수도 있고, 합리적인 사실 서술을 추측으로 잘못 판정할 수도 있거든요. 비교적 안전한 방법은 불합격한 표본을 하나하나 재검토한 뒤, 합격한 표본에서 일부를 무작위로 뽑아 사람이 검토하는 거예요.
차원별 제시: Promptfoo의 문장력 점수가 사실 오류를 상쇄하지 않게 하기
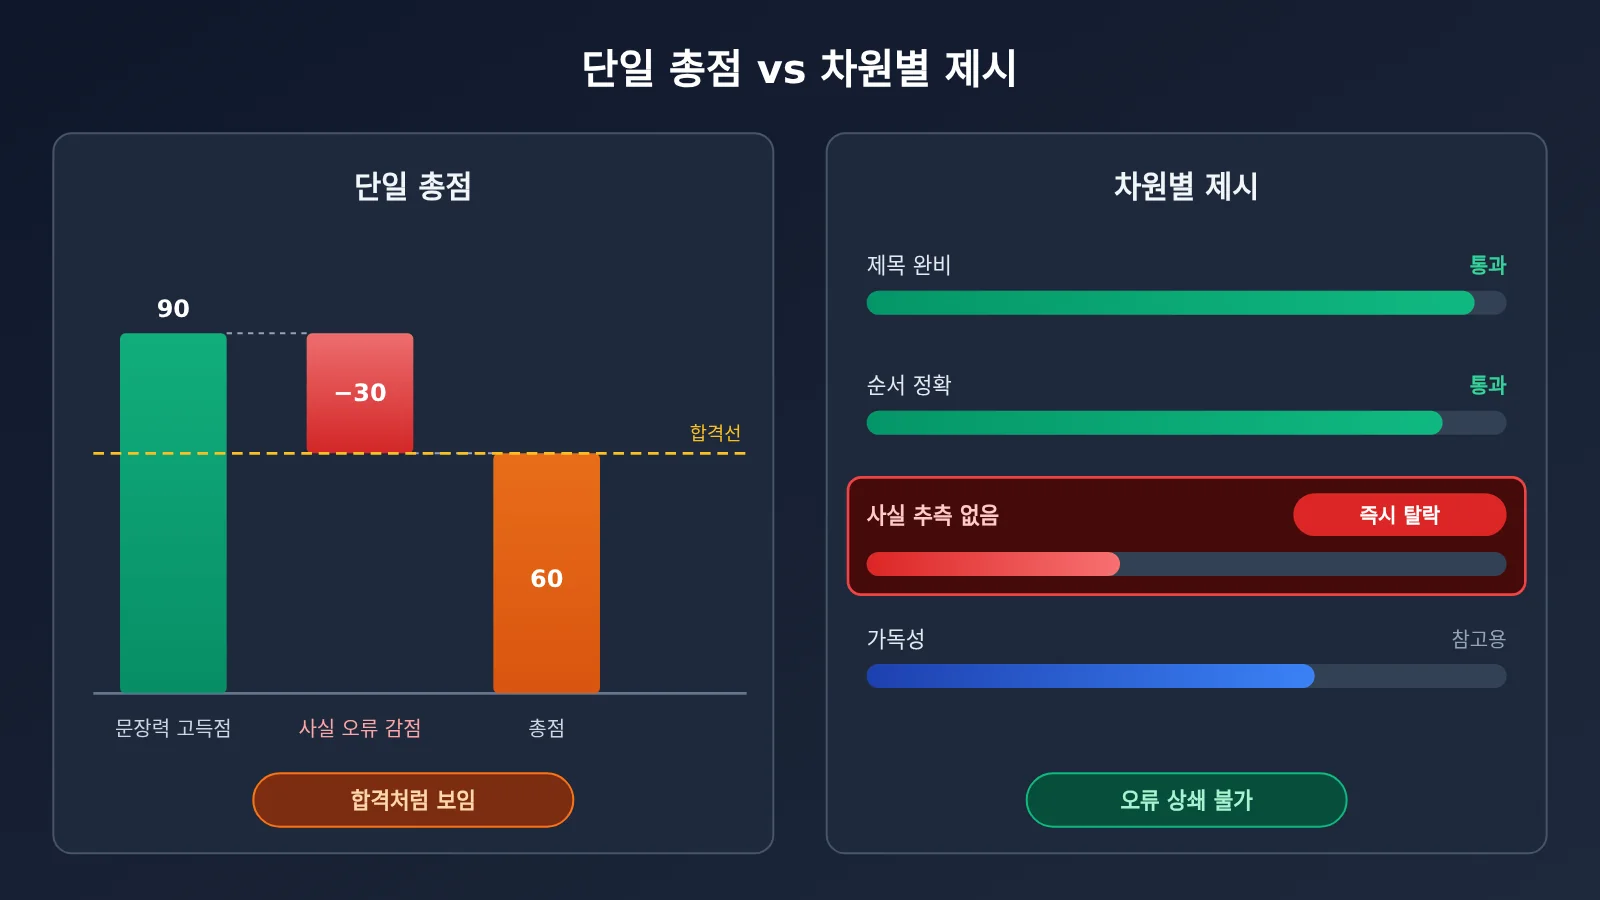
모든 단언을 하나의 총점으로 합치면, 문장력은 유려하지만 사실 단락에 추측이 섞인 글과, 구조는 엄밀하지만 다소 평범한 글이 비슷한 점수를 받을 수 있어요. 뉴스형 콘텐츠에서는 이런 “상호 상쇄”가 위험하죠. 따라서 차원별로 따로 보고하고, 사실 관련 차원은 단 한 표만으로도 거부권을 행사하도록 설정할 것을 권장해요.
| 평가 차원 | 확인 방식 | 제시 방식 | 다른 차원으로 상쇄 가능 여부 |
|---|---|---|---|
| 필수 제목 완비 | contains | 통과율 | 아니요, 필수 요건 |
| 챕터 순서 정확 | JavaScript | 통과율 | 아니요, 필수 요건 |
| 사실 단락에 추측 없음 | llm-rubric + 사람 검토 | 통과율 + 문제 원문 목록 | 아니요, 거부권 행사 |
| 표현 및 가독성 | llm-rubric | 별도 표시 | 참고용에 불과, 상쇄에 불참여 |
Promptfoo 채점 규칙만 바꿀 때는 기존 출력을 바로 재평가
평가를 반복하는 과정에서 가장 자주 손대는 대상은 템플릿 자체보다 채점 규칙인 경우가 많아요. 예를 들어 평가 척도 설명이 명확하지 않다고 느끼거나, 위치 검증 코드가 경계 상황을 빠뜨렸다고 해봐요. 이때 템플릿과 출력은 모두 그대로이므로 다시 생성할 필요가 없어요.
Promptfoo가 기존 출력에 대해 독립적인 검증(assertion) 파일을 실행할 수 있는 기능을 활용하면 생성과 채점을 완전히 분리할 수 있어요. 한 번 생성하고 출력을 저장한 뒤에는 규칙을 조정할 때마다 검증만 다시 실행하면 됩니다. 이렇게 하면 시간도 아끼고, 앞뒤 두 차례 채점이 완전히 동일한 텍스트를 대상으로 이루어지므로 비교도 의미를 갖게 돼요.
Promptfoo 모델 판정의 경계와 비용
평가 결과를 과도하게 해석하지 않도록 명확히 짚고 넘어갈 세 가지가 있어요.
- 모델 판정 점수가 사실의 정확성을 증명하지는 않아요. llm-rubric은 출력이 채점 모델의 눈에 척도에 부합한다는 것만 말해줘요. 사실 확인은 결국 원본 자료로 돌아가야 합니다.
- contains 통과는 단지 글자가 매칭됐다는 뜻일 뿐이에요. 제목이 등장한다는 것만 알려줄 뿐, 제목 아래 문단의 품질이 합격이라는 것은 말해주지 않아요.
- 유료 모델 리뷰에는 비용이 들어요. 규칙 기반 검증은 원칙적으로 추가 모델 호출이 거의 발생하지 않지만, llm-rubric은 출력 한 건을 평가할 때마다 채점 모델을 한 번씩 호출하므로 전체 평가를 ‘전부 무료’라고 부를 수는 없어요.
이러한 경계를 바탕으로 내린 판단은 이래요. 확정적 검증은 ‘기준(게이트)’으로, 모델 채점은 ‘초기 스크리닝’으로, 사람의 검토가 사실 관련 결론의 최종 근거가 되어야 해요. 세 가지는 역할이 다르며 서로를 대체할 수 없어요.
앞으로 주목할 만한 방향
아래는 아직 검증되지 않은 관찰 방향으로, 후속 실험을 위한 제안일 뿐이에요:
- 평가 모델의 일관성. 같은 출력을 여러 번 평가해도 결론이 안정적으로 유지되는지, 평가 모델을 바꾸면 결론이 뒤집히는지. 만약 불안정하다면 평가 척도를 더 구체적으로 써야 해요.
- 사람의 표본 검토와 모델 평가가 얼마나 일치하는지. 이는 llm-rubric을 1차 스크리닝에 얼마나 의존할 수 있는지를 결정해요.
- 표본 크기가 충분한지. 소수의 글만 비교하면 우연한 요인이 템플릿 차이를 가릴 수 있으므로, 의미 있는 결론을 얻으려면 충분히 많은 입력 자료가 필요해요.
이런 문제들에 실측 데이터가 마련되기 전까지는 “새 템플릿의 승률이 얼마인지”, “점수가 얼마나 올랐는지” 같은 주장은 신중하게 다뤄야 해요. 이 글에서 의도적으로 그런 숫자를 제시하지 않은 이유도 여기에 있어요.
“책에서 얻은 지식은 얕기만 하니, 이 일을 확실히 알려면 직접 몸으로 부딪쳐야 한다.” — 육유, 《동야독서시자율(冬夜讀書示子聿)》