先日、ある顧客がグループチャットでとても典型的な質問をしました。「うちのような images2 でも、ECのセット画像って作れますか?」答えはイエスですが、1回の呼び出しで一整套の画像が出てくるわけではありません。gpt-image-2 のインターフェースは「1つのプロンプトにつき1回の生成」です。メイン画像、セールスポイント画像、シーン画像、詳細ページといった内容の異なるセットを狙うなら、呼び出し方に少し工夫が必要です。
本記事では gpt-image-2 によるECセット画像を2つのルートに分けて解説します。1つは1枚の画像に多面的な情報を盛り込むルートで、詳細ページの長画像に向いています。もう1つはまずテキストモデルで要件を分解し、各画像のプロンプトを生成してから gpt-image-2 を並行呼び出しするルートで、本当の意味での複数画像セットに向いています。読み終える頃には、完全なフロー設計、実行可能なコード、そしてセット全体のスタイルを統一するための重要なコツが手に入ります。
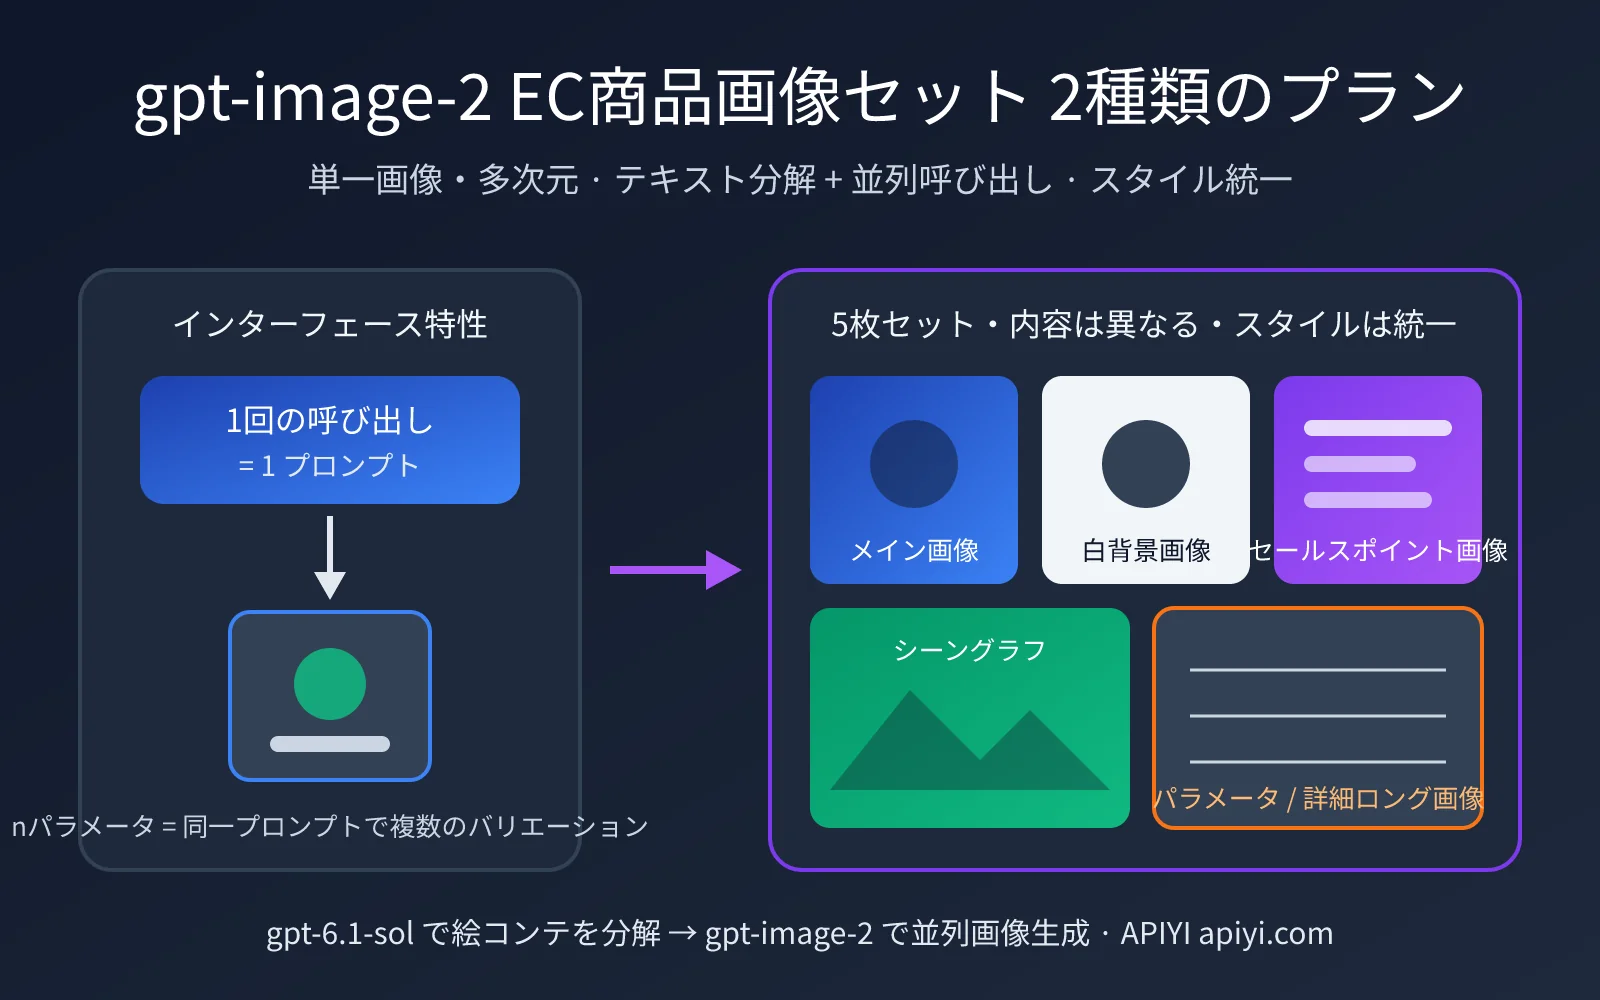
gpt-image-2 电商画像セットの核心的な制限:1回の呼び出しに1つのプロンプト
まずインターフェースの動作をはっきりさせておきます。以降の設計はすべてこの前提の上に成り立っています。gpt-image-2 の /v1/images/generations と /v1/images/edits は、1回のリクエストで1つのプロンプトしか受け付けません。公式の gpt-image-2 と 2.5 シリーズは n パラメータに対応しており、APIYI も完全対応しています。ただし n の意味は「同じプロンプトで n 枚のバリエーションを生成する」であり、「n 個のプロンプトから各1枚ずつ出す」ではありません。
つまり n=5 で得られるのは同じ画面の5バージョンで、「多めに出力して一番良いものを選ぶ」には向いていますが、セット画像には向いていません。ECセット画像の本質は内容が異なりつつスタイルが統一された複数の画像です。メイン画像は製品を際立たせ、セールスポイント画像にはコピーを添え、シーン画像には使用環境を描き、パラメータ画像にはサイズ表記を入れます。それぞれの画像でプロンプトが異なるため、当然ながら複数回の呼び出しが必要になります。
gpt-image-2 电商画像セットの3つの本当の難点
制限を整理すると、セット画像の難しさは実は「複数枚を出すこと」ではなく、次の3点にあると分かります。
- 被写体の一貫性:5枚の画像に写る製品は同じ製品でなければならず、色、ロゴ、構造が画像ごとに変わってはいけません。
- スタイルの一貫性:色調、光線、背景の質感、フォントのスタイルが、同じデザイナーの手によるもののように見える必要があります。
- 情報の役割分担:各画像が異なるマーケティング課題を担い、5枚すべてが同じセールスポイントを語っていてはいけません。
この3点があるため、セット画像は「一言をモデルに投げる」だけでは解決できず、呼び出しの前に計画を立てる必要があります。次の表は一般的なECプラットフォームのセット画像の標準構成で、計画の出発点として使えます。
| セット内の位置 | 主な用途 | 推奨比率 | 情報密度 | テキストの要否 |
|---|---|---|---|---|
| メイン画像(サムネイル) | 検索結果のクリック率 | 1:1 | 低、製品を強調 | 任意、少量 |
| 白背景画像 | プラットフォーム規約、広告配信 | 1:1 | 極めて低い | 不要 |
| セールスポイント画像 | 2〜3個の核心的な卖点を伝える | 1:1 または 3:4 | 中 | 必要 |
| シーン画像 | 使用シーンの雰囲気を演出 | 1:1 または 4:5 | 中 | 任意 |
| サイズ/パラメータ画像 | 問い合わせと返品を減らす | 1:1 | 高 | 必要 |
| 詳細ページ長画像 | 製品を完全に解説 | 9:16 またはそれ以上 | 非常に高い | 必要 |
🎯 計画のヒント:コードを書く前に、上の表に沿ってプラットフォームに必要な画像枚数と各画像の役割を決めましょう。APIYI apiyi.com で gpt-image-2 を使い、まず2〜3枚の単体画像を手動で生成して、製品の再現度とテキストレンダリングの効果が期待どおりか確認してから、バッチセット画像のフローに進むことをおすすめします。
方案1:gpt-image-2 で1枚の画像に多次元情報を載せる(商品詳細ページの長尺画像)
最初のルートは「1枚の画像で1つのストーリーを語り切る」という考え方です。gpt-image-2 は中国語のテキストレンダリングとレイアウト理解に優れており、縦長の大きな画像の中にメインビジュアル、セールスポイント、スペック表を領域ごとに配置することは十分可能です。商品詳細ページの長尺画像、セールスポイントまとめ画像、インフォグラフィックといったニーズなら、1回の呼び出しで情報量の多い完成品を生成できます。
このルートの最大のメリットはそもそも一貫性の問題が発生しないことです。すべてのコンテンツが同じ1枚の画像の中でモデルによって一度に生成されるため、色調やスタイルは自然に統一され、追加のレイアウト用コードも不要です。デメリットは1枚の画像に収められる情報量に限りがあること。内容が多すぎると文字が小さく窮屈になり、独立したメイン画像として広告に使うために分割することもできません。
gpt-image-2 で詳細ページ長尺画像を作るための領域別プロンプトの書き方
1枚の画像に多次元の情報を載せる鍵は領域ごとの記述にあります。ごちゃ混ぜにした長い説明を書くのではなく、上から下へというレイアウトの順序に沿って、各領域に何を置くかをモデルに伝えます。以下は保温マグカップの詳細ページ長尺画像を作るためのプロンプト構成の例です:
縦長 9:16 のEC商品詳細ページ長尺画像。全体のスタイル:シンプルな北欧風、アイボリーの背景、柔らかな自然光。
【上部領域】商品メインビジュアル:マットな深緑の保温マグカップを45度に傾けて配置。タイトル文字「24時間の長時間保温」。
【中部領域】3列のセールスポイント。各列に線画アイコンと短いコピー:「316ステンレス内胆」「ワンタッチで片手開閉」「500mlの大容量」。
【下部領域】スペック表:容量500ml、重量320g、高さ22cm、素材316ステンレス。
すべての文字はクリアなサンセリフ体の中国語フォントを使用し、余計な文字は入れないこと。
サイズについては、長尺画像は 9:16 の縦長を推奨します。たとえば 2K グレードの 1152x2048 です。より高精細な最終素材が必要なら、4K グレードの 2160x3840 を使います。
1枚画像の方案は呼び出しが1回だけで済み、コストは最も低く、スタイルも自然に統一されます。その代わり情報容量には限りがあり、5ブロックを超えると文字が窮屈になりやすく、検索用のメイン画像として単独で切り出すこともできません。家電、デジタルアクセサリー、日用品といったスペック重視の標準品の詳細ページやセールスポイントまとめに最適です。
💡 実践のヒント:領域が5つを超えると、テキストレンダリングのエラー率が明らかに上がります。長尺画像を2〜3枚の「ハーフスクリーン画像」に分けて個別に生成し、詳細ページで縦に結合することをおすすめします。このハーフスクリーン画像はそれ自体が小さな画像セットになるので、自然と方案2へとつながります。
方案2:テキストモデルで分解し、gpt-image-2 を複数回呼び出してEC用の画像セットを生成
本当に複数枚の画像セット(メイン画像、セールスポイント画像、シーン画像がそれぞれ独立)が必要なら、小さなパイプラインを組む必要があります。考え方は「要件の理解と絵コンテの計画」をテキストモデルに任せ、「画像の生成」を gpt-image-2 に任せ、両者を構造化 JSON でつなぐというものです。
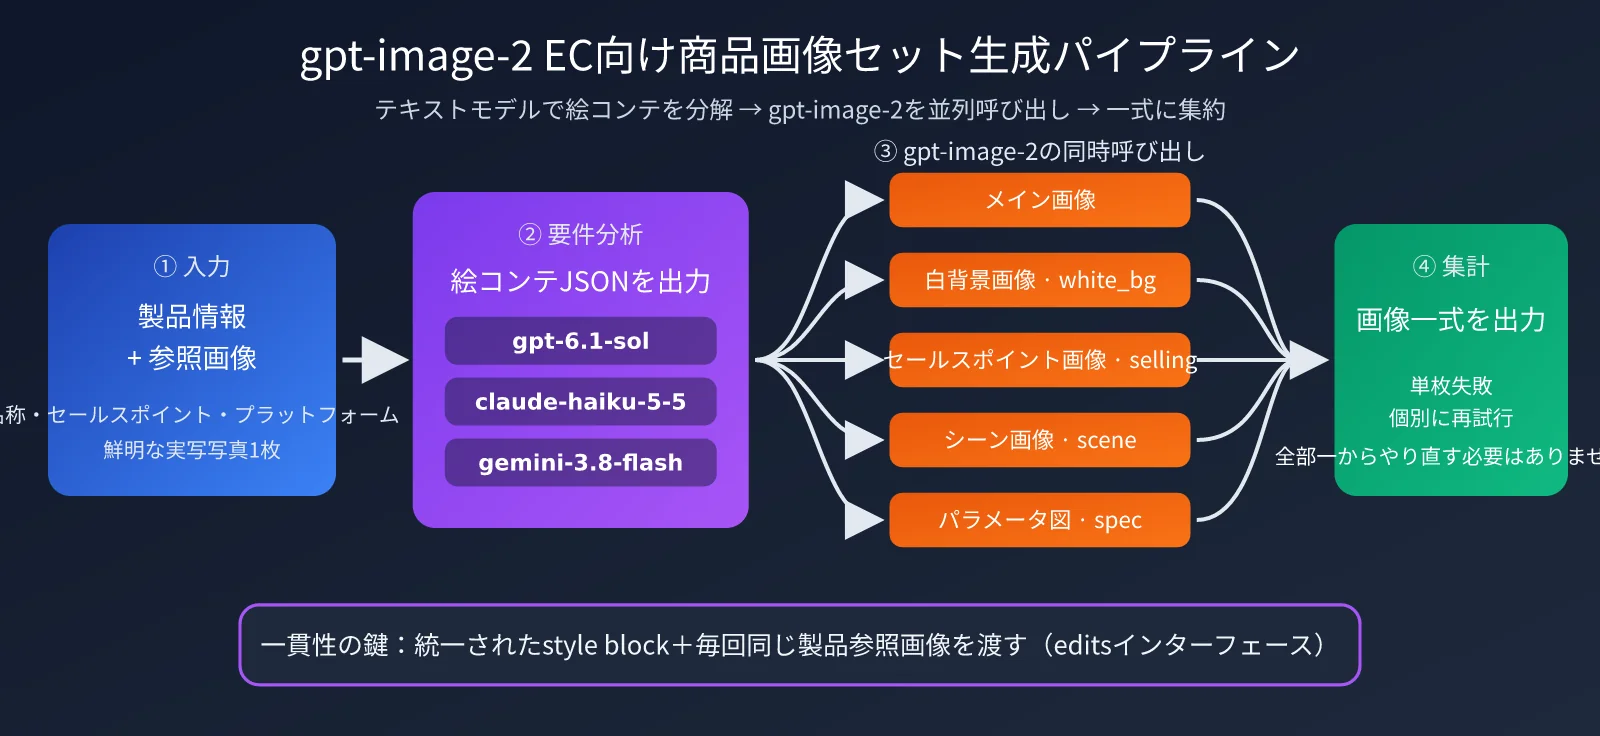
全体の流れは4ステップです:
- 入力:事業者から商品名、セールスポイント、ターゲットプラットフォーム、そして少なくとも1枚の鮮明な商品実写画像を受け取ります。
- 要件分析:テキストモデルが入力に基づいて JSON 配列を出力します。各要素は1枚の画像の絵コンテで、用途、プロンプト、サイズ、コピーを含みます。
- 並行生成:プログラムが絵コンテの配列を走査し、各絵コンテごとに gpt-image-2 を1回呼び出します。その際、同じ商品の参照画像を渡します。
- 集約と検証:すべての結果を収集し、失敗したものは個別に再試行します。最後に順番どおりに画像セットを出力します。
テキストモデルの選び方:gpt-image-2 画像セットの「頭脳」
要件分析のステップでテキストモデルに求められるのは、ECマーケティングの論理を理解できること、安定して JSON を出力できること、映像的な表現力のあるプロンプトを書けることです。現在 APIYI(apiyi.com)にある最新モデルはどれもこの役割を果たせます:
| モデル | 位置づけ | 適したシーン | 選ぶ理由 |
|---|---|---|---|
| gpt-6.1-sol | フラッグシップ推奨 | 高単価商品、複雑なセールスポイントの抽出 | マーケティングコピーと絵コンテ計画の品質が最も良い |
| claude-haiku-5-5 | 低価格・高速 | 大量 SKU、標準化されたカテゴリ | 指示追従が安定しており、JSON 出力が整っている |
| gemini-3.8-flash | 低価格・高速 | 大量処理、多言語の越境商品 | 高速・低コストで、多言語コピーが自然 |
要件分析は画像セットごとに1回しか呼び出さないため、token の消費はごくわずかで、コストの大半は画像生成にあります。まず gpt-6.1-sol でプロンプトテンプレートを納得いくまで調整し、大量処理の段階で claude-haiku-5-5 や gemini-3.8-flash に切り替えてコストを下げることをおすすめします。3つのモデルは APIYI(apiyi.com)上でいずれも OpenAI 互換インターフェースを使っているので、切り替えは model パラメータを変更するだけです。
gpt-image-2 によるEC画像セットの絵コンテ JSON 設計
テキストモデルに固定構造の JSON を出力させることは、パイプライン全体を安定して動かす鍵です。以下は推奨するフィールド設計です:
| フィールド | 型 | 説明 | 例 |
|---|---|---|---|
scene |
string | 画像セット内の位置識別子 | main / white_bg / selling |
purpose |
string | この画像のマーケティング上の役割 | 商品の外観を強調し、クリック率を高める |
prompt |
string | gpt-image-2 に渡す完全なプロンプト | マットな深緑の保温マグカップを木製のテーブルに置く… |
size |
string | 出力サイズ | 2048x2048 |
text_overlay |
string | 画像内にレンダリングする文字 | 24時間の長時間保温 |
gpt-image-2 画像セットのミニマルコード
以下は最小限で動作するバージョンです。まずテキストモデルに絵コンテを生成させ、そのあと1件ずつ gpt-image-2 の edits エンドポイントを呼び出します(商品の参照画像付き)。
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "为墨绿色 316 保温杯规划 5 张淘宝套图,输出 {\"shots\": [...]},"
               "每项含 scene/purpose/prompt/size/text_overlay,统一风格:北欧简约、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
このコードは直列実行なので、5枚の画像は順番に待つ必要があります。次の節で並行バージョンに書き換えます。
gpt-image-2 でEC画像セットのスタイルを一致させるには
複数回呼び出すときに最も起きやすい問題は、5枚の画像がまるで5つの異なる店舗のもののように見えてしまうことです。以下のいくつかのテクニックを組み合わせれば、一貫性を商用レベルまで高められます:
- style block を統一:色調、光線、背景、カメラワークを固定の文章にまとめ、各絵コンテのプロンプトの末尾に連結します。テキストモデルに毎回自由にスタイルを記述させないようにしましょう。
- 商品の参照画像を固定:毎回の呼び出しで edits エンドポイントを通じて同じ商品実写画像を渡し、プロンプトで「参照画像内の商品の色、ロゴ、構造を変えないこと」を明示します。これは被写体の一貫性を保つ最も効果的な手段です。
- パラメータを固定:同じ画像セットでは同じ
qualityグレードを使い、サイズは必要なときだけ変えます(たとえば長尺画像は縦長にする)。 - n パラメータで最良のものを選ぶ:メイン画像のような最も重要な位置では、
n=2やn=3を設定していくつかのバリエーションを生成し、人で一番良いものを選びます。これこそが n パラメータの正しい使い方です。
🎯 一貫性のヒント:style block は画像セット全体の「ブランドガイドライン」です。店舗ごとに固定テンプレートを蓄積しておくことをおすすめします。APIYI(apiyi.com)を通じて gpt-image-2 を呼び出す際、style block を設定ファイルに保存しておけば、すべての SKU で共用でき、季節の変わり目に一括で更新するだけで済みます。
gpt-image-2 のEC用画像セット並列呼び出し:高速化とスケール戦略
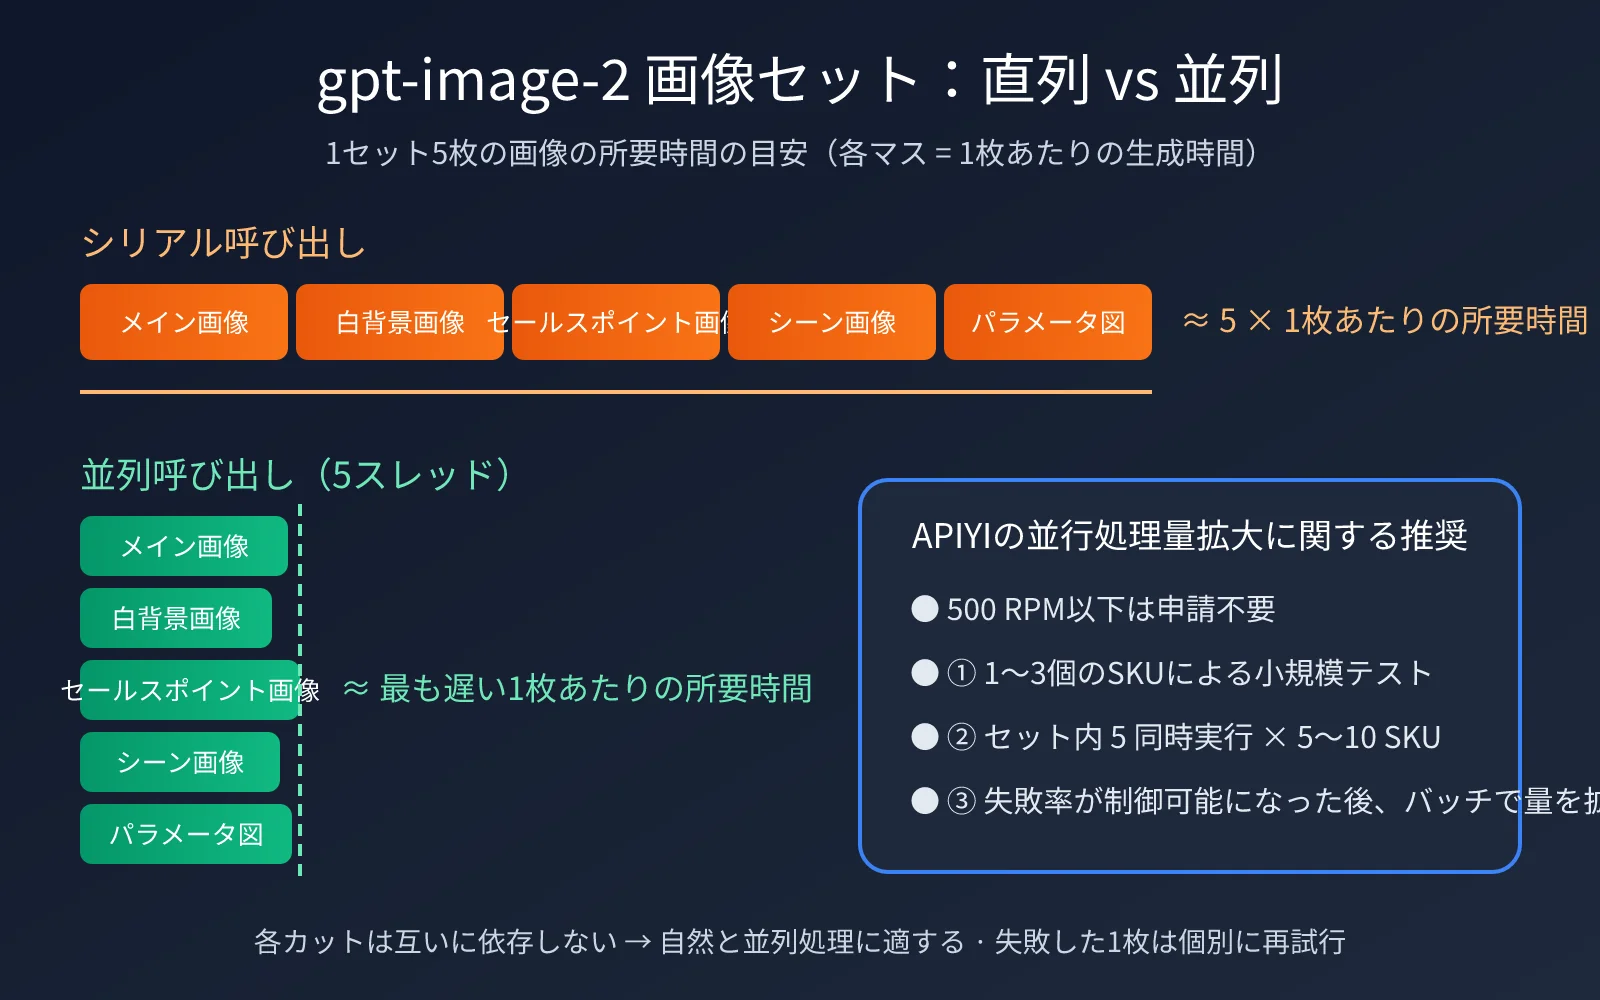
5枚1セットの画像を直列で生成すると、待ち時間は各画像の処理時間の合計になります。枚数が増えるほど遅くなるわけです。各カットは互いに依存していないので、並列に呼び出せます。そうすればセット全体の所要時間を「いちばん遅い1枚」の時間に近づけられます。
APIYI は gpt-image-2 の呼び出しに並列数の上限を設けていません。500 RPM 以下ならそのまま利用できますし、追加申請も不要です。ほとんどの事業者にとって、数十 SKU の画像セットを同時に回しても、この水準には到底届きません。
gpt-image-2 画像セットの並列コード
上記の直列ループをスレッドプールに置き換えれば、並列出図が実現できます。あわせて失敗時のリトライも組み込み、1枚の失敗でセット全体をやり直す事態を避けましょう。
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
完全版コードを見る(スタイルブロック、複数 SKU のバッチ処理、失敗分の再生成、結果のファイル保存を含む)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。全体のスタイル:北欧ミニマル、オフホワイトの背景、柔らかな自然光、低彩度の配色。"
    "参照画像に写る商品の色・ロゴ・構造は完全に維持し、文字はクリアなサンセリフ体の中国語フォントで描画する。"
)

PLAN_PROMPT = """あなたは経験豊富なECビジュアルプランナーです。以下の商品情報をもとに、{platform}向けの{count}枚セットの画像構成を企画してください。
商品情報:{product}
JSONで出力:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要件:各画像はそれぞれ異なるマーケティング役割を担うこと。prompt は画面の内容のみを記述し、全体スタイルには触れないこと。
文字が必要な場合は、原稿テキストをそのまま prompt に書き、引用符で囲むこと。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """テキストモデルで絵コンテを分解。バッチ処理時は claude-haiku-5-5 / gemini-3.8-flash に差し替え可能"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """1枚ずつ生成。失敗時は指数バックオフでリトライ"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] {attempt + 1} 回目の失敗:{e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # 失敗した1枚を追加で再生成
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: 成功 {sum(1 for v in results.values() if v)}/{len(shots)} 枚")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="深緑の316ステンレス保温ボトル、500ml、24時間保温、ワンタッチオープン",
        ref_image="cup.png",
    )
並列スケールの3ステップ
並列数の上限はないとはいえ、段階的にスケールさせることをおすすめします。まず効果を検証してから規模を広げ、いきなり数百枚の不合格画像を量産してしまう事態を避けましょう。
- 小規模テスト:1〜3 SKU を選び、直列または低並列で一通り回してみます。商品の再現度、文字の正確さ、スタイルの統一感を人の目でチェックします。
- 中程度の並列:効果が安定してきたら、1セットあたり5並列・同時5〜10 SKU まで上げ、失敗率と平均所要時間を観察します。
- バッチでスケール:失敗率が許容範囲だと確認できたら、業務量に応じて並列数をさらに上げます。500 RPM 以内ならそのまま実行できます。
| 呼び出し方式 | 5枚1セットの所要時間 | 安定性 | 適するフェーズ |
|---|---|---|---|
| 直列呼び出し | 単枚の約5倍 | 最も安定、デバッグしやすい | プロンプト調整期 |
| セット内並列(5スレッド) | ほぼ最も遅い1枚と同じ | 安定 | 日々の新商品投入 |
| 複数 SKU +セット内並列 | 1セットとほぼ同じ | リトライとの併用が必要 | 大型セール前の一括投入 |
🚀 スケールのヒント:大型セール前の集中投入では、APIYI(apiyi.com)経由で「複数 SKU +セット内並列」のパターンをおすすめします。500 RPM 以下なら申請は一切不要です。失敗分の再生成の仕組みと組み合わせれば、数十 SKU 分のセット画像もごく短時間で完成します。
gpt-image-2 EC商品画像セットのプラン選び
2つのプランは排他的なものではなく、実際の業務では組み合わせて使うこともよくあります。以下、一般的なプラットフォームとシーン別におすすめをまとめます。
| プラットフォーム/シーン | 推奨プラン | 推奨枚数 | 説明 |
|---|---|---|---|
| タオバオ/Tmallのメイン画像 | プラン2 | 5枚 | メイン画像、白背景、訴求ポイント、シーン、パラメータを各1枚 |
| タオバオ/拼多多の商品詳細ページ | プラン1 + プラン2 | 3〜6枚の半画面画像 | セクションごとに生成して縦方向に結合 |
| Amazon Listing | プラン2 | 7枚 | メイン画像は白背景で厳格にコンプライアンスを遵守し、残りは訴求ポイントとシーン |
| 自社ECサイトの商品ページ | プラン2 | 4〜6枚 | シーン画像の比重が高く、ブランドトーンを強調 |
| 小紅書(RED)でのシード投稿 | プラン2 | 3〜6枚 | 3:4の縦長で、生活感のあるシーン中心 |
| キャンペーンポスター/訴求ポイントまとめ | プラン1 | 1枚 | 1枚に情報を集中させ、拡散効率が高い |
選び方の核心はとてもシンプルです。個別に配信・表示する画像はプラン2、1つのページ内で連続して読ませるコンテンツはプラン1を使います。迷ったら、まずプラン2でメイン画像とシーン画像を制作し、次にプラン1で訴求ポイントまとめの長い画像を1枚作ると、カバー範囲が最も広くなります。
💡 組み合わせの提案:どちらのプランも同じ gpt-image-2 モデルと同じ APIキーを使います。2つのフローを1つのサービスとしてまとめ、商品タイプに応じて自動でプランを選ぶ仕組みにするのがおすすめです。販売者は商品画像1枚と訴求ポイントの数行のテキストをアップロードするだけで済みます。
よくある質問
gpt-image-2 の n パラメータでEC商品画像セットを直接生成できますか?
できません。公式の gpt-image-2 と 2.5 シリーズはいずれも n パラメータに対応しており、APIYI も対応していますが、これは同じプロンプトで n 枚のバリエーションを生成するものです。画像セットでは各画像の内容が異なるため、それぞれ別のプロンプトが必要で、複数回の呼び出しが求められます。n はメイン画像のような重要な位置で候補を比較して選ぶ用途に向いています。
生成した複数枚の画像で商品の見た目が変わってしまう場合は?
これは画像セットで最もよくある問題です。最も効果的な方法は、毎回の呼び出しで editsエンドポイントに同じ商品の実物写真を渡し、プロンプトに「参照画像内の商品の色、ロゴ、構造を変えないでください」と明記することです。同時に、スタイル記述を style block として固定し、テキストモデルに自由に表現させないようにします。参照画像は背景がすっきりしていて光が均一な実物写真を使うと、再現効果が最も良くなります。
画像内の中国語テキストが正しくレンダリングされない場合は?
gpt-image-2 の中国語レンダリング能力はすでにかなり高いですが、文字量が増えるほどエラーの確率も上がります。各画像のテキストは2〜3個の短い文に抑え、プロンプト内でテキスト原文を引用符で囲んで指定することをおすすめします。特定の画像で文字に誤りがあった場合は、その1枚だけを再生成すればよく、セット全体を作り直す必要はありません。
テキスト分解にはどのモデルが最もコスト効率が良いですか?
プロンプトテンプレートを調整するときは gpt-6.1-sol を使うと構成の品質が最も高くなります。テンプレートが安定したら、大量処理のために claude-haiku-5-5 や gemini-3.8-flash に切り替えると、コストを抑えられて速度も上がります。このステップは画像セットごとに1回しか呼び出さないため、コストは画像生成自体よりはるかに低く抑えられます。3つのモデルは APIYI apiyi.com 上で同じ APIキーを使って呼び出せます。
同時呼び出しにはクォータ申請が必要ですか?
不要です。APIYI は gpt-image-2 に同時呼び出しの上限を設けていません。500 RPM 以下ならそのまま利用できます。まず1〜3 SKUで小規模にテストし、効果を確認してから徐々に同時呼び出し数を増やして拡張することをおすすめします。
まとめ
gpt-image-2 でEC用の画像セットを生成するポイントは、「1回の呼び出しが1つのプロンプトに対応する」というインターフェースの特性を理解することにあります。n パラメータが解決するのは最適な1枚を選ぶ問題であり、画像セットには複数の異なるプロンプトによる複数回の呼び出しが必要です。この前提に立てば、詳細ページやセールスポイントまとめのように連続して読まれるコンテンツは単一画像・多次元の手法で一度に生成でき、メイン画像やシーン画像のように個別に表示する必要がある画像セットは、テキストモデルによる分解 + 並行呼び出しのパイプラインで一括処理できます。
両ルートに共通する核心は一貫性のコントロールです。固定の style block と同一の商品参照画像を組み合わせることが、複数の画像を同じデザインチームが制作したように見せる鍵になります。並行処理については、500 RPM 以下であればそのままフル稼働させることができ、「小規模テスト → 中程度の並行数 → 一括フル稼働」という3ステップで進めるのが最も確実です。
パイプライン全体は APIYI apiyi.com でワンストップに完成させることをおすすめします。gpt-6.1-sol、claude-haiku-5-5、gemini-3.8-flash が要件の分解を担当し、gpt-image-2 が画像生成を担当します。1つのAPIキーですべての工程をつなげられるため、独自のEC画像セット生成サービスを素早く構築できます。
作者: APIYI Team | AI大規模言語モデルAPIの技術共有に特化。その他のモデル連携チュートリアルは APIYI apiyi.com をご覧ください。