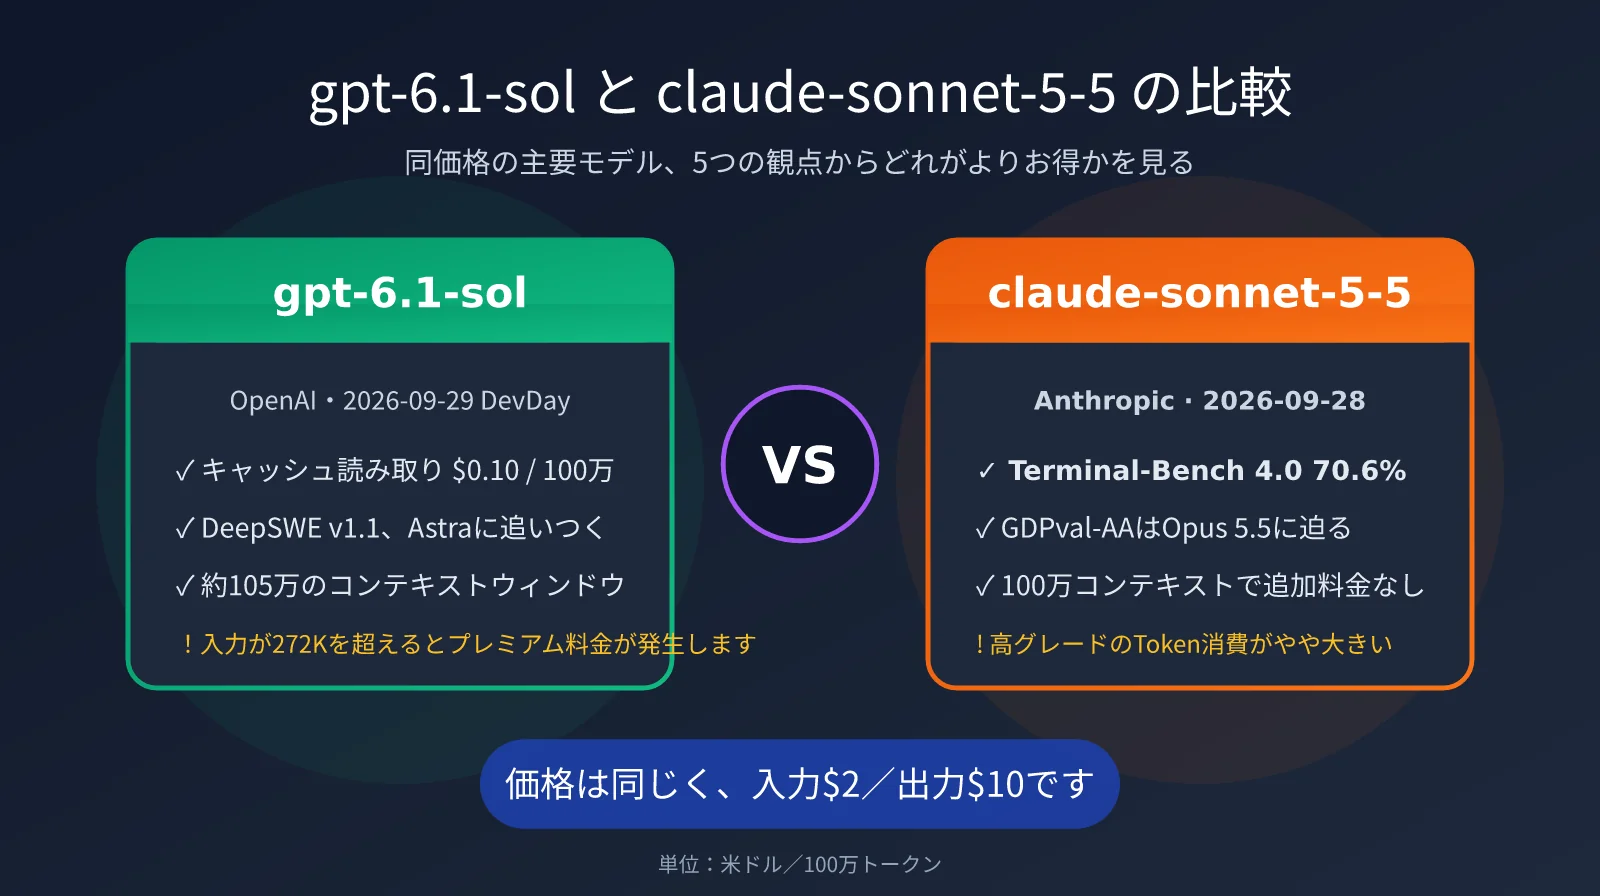
9月28日にAnthropicがclaude-sonnet-5-5を発表し、その翌日にはOpenAIがDevDayでgpt-6.1-solを公開しました。両社の新世代主力モデルはほぼ同時に登場し、価格も同じです。入力は100万Tokenあたり$2、出力は$10です。多くの開発者は「どちらも安くなったなら、好きな方を選べばよい」と考えるかもしれません。しかし実際に本番環境へ導入すると、単一タスクのコスト、長大なコンテキストの課金、エージェント性能には、価格表からは見えない大きな差があります。本記事では5つの観点から、gpt-6.1-solとclaude-sonnet-5-5の実質的な違いを解説します。ブランドへの好みやアカウントの利用可否に左右されず、用途に応じて合理的に選べるようになりましょう。
この記事でわかること: 読了後には、コーディングエージェント、オフィス文書、長大なコンテキストの検索、高並列バッチ処理といったシーンで、gpt-6.1-solとclaude-sonnet-5-5をそれぞれどう選び、どう使い分けるべきかが明確になります。
gpt-6.1-solとclaude-sonnet-5-5の主要仕様を一覧で確認
まず、よくある誤解を解いておきましょう。厳密に言えば、この2モデルの表示価格はどちらも値下げされていません。claude-sonnet-5-5はSonnet 5の入力$2/出力$10という価格を引き継ぎ、gpt-6.1-solも前世代のgpt-6-solと同じ価格です。
「値下げ」と言われる理由は、主に2つあります。1つ目は、フラッグシップ級の性能が主力モデルの価格帯へ降りてきたことです。gpt-6.1-solはgpt-6-astraの5分の1、claude-sonnet-5-5はOpus 5.5の半額で利用できます。2つ目は、見えにくいコストが下がっていることです。gpt-6.1-solのキャッシュ入力は$0.20から半額の$0.10へ引き下げられました。claude-sonnet-5-5はツール呼び出し回数を減らすことで、単一タスクあたりのコストを最大約30%削減できます。
| 項目 | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| リリース日 | 2026-09-29(DevDay) | 2026-09-28 |
| モデルID | gpt-6.1-sol |
claude-sonnet-5-5 |
| コンテキストウィンドウ | 約105万Token | 100万Token |
| 最大出力 | 128K | 128K(Batchベータ版では最大300K) |
| 推論レベル | low / medium(デフォルト)/ high / xhigh / max | low / medium / high(APIのデフォルト)/ xhigh / max |
| 思考モード | レベルごとに調整可能 | 適応型思考、無効化は不可 |
| 同系列のフラッグシップ | gpt-6-astra($10/$50) | Claude Opus 5.5($4/$20) |
| 利用可能なプラットフォーム | APIYI apiyi.com、OpenAI公式API | APIYI apiyi.com、Anthropic公式API |
仕様表からわかる重要な違いは、両モデルでデフォルトの推論レベルが異なることです。gpt-6.1-solのデフォルトはmediumであるのに対し、claude-sonnet-5-5のAPIではhighがデフォルトです。デフォルト設定のまま比較すると、Sonnetだけが1段階多く「考える」ことになり、Token消費量やレイテンシが同じ条件になりません。公平に比較するには、両方でreasoning_effortを明示的に指定することをおすすめします。
🎯 テストのポイント: 2モデルを比較する際は、推論レベルとプロンプトを必ず同一に固定してください。APIYI apiyi.comなら、同じAPIキーでgpt-6.1-solとclaude-sonnet-5-5を同時に呼び出せます。
modelパラメータだけを変更してA/Bテストを行うことで、アカウントやネットワークの差による影響を排除できます。
gpt-6.1-sol と claude-sonnet-5-5 の5つの主要な違い
違い1:コーディングエージェントでは、claude-sonnet-5-5 がターミナル系タスクで優位
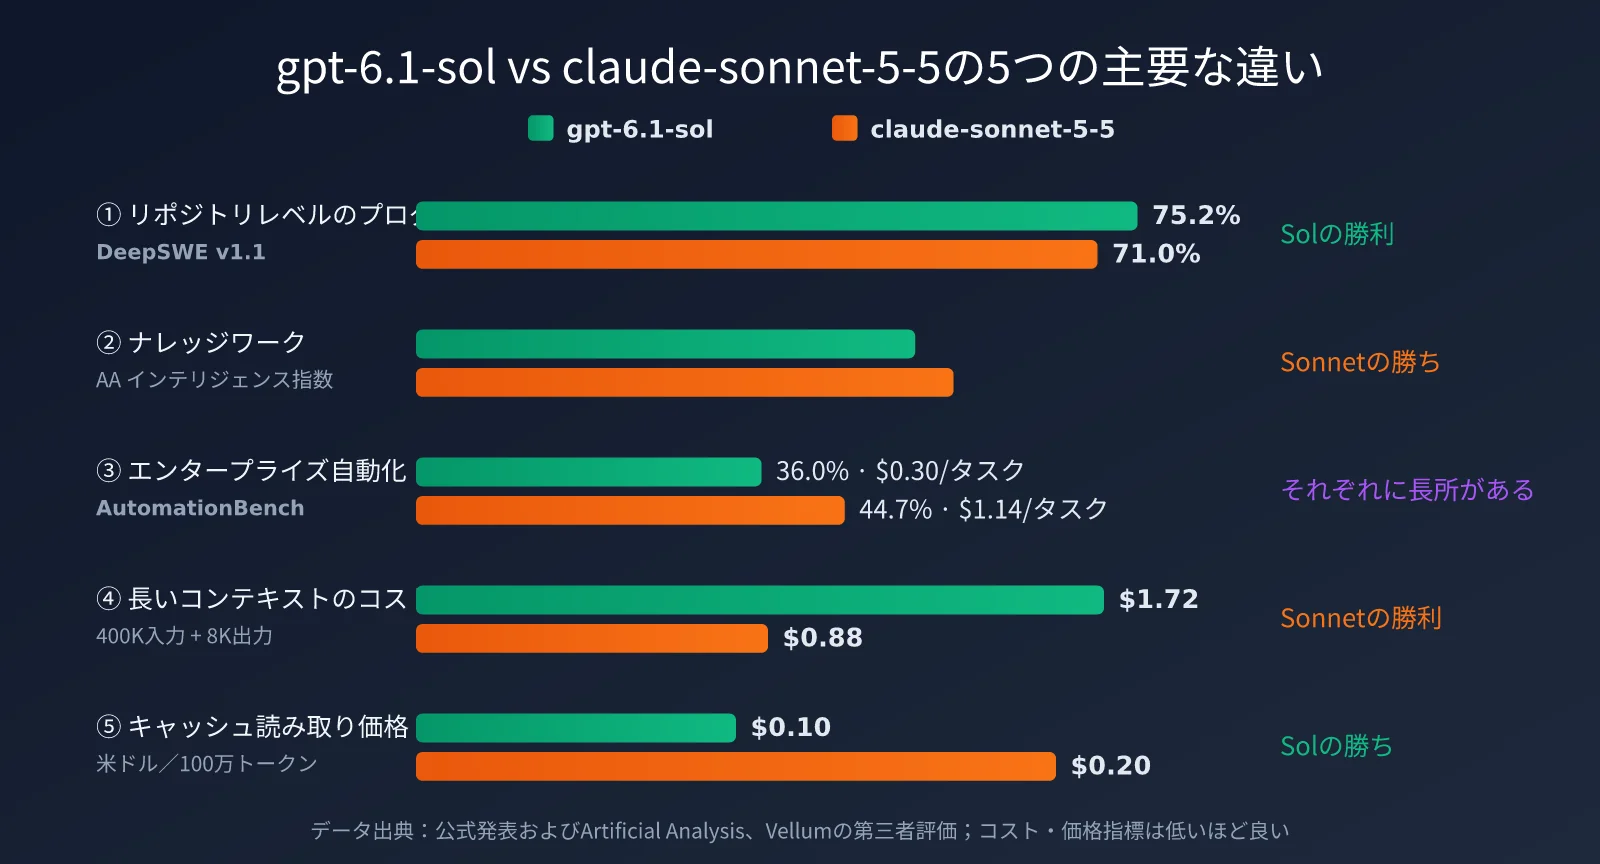
コーディングは両モデルが最も激しく競合する領域ですが、各社が公開しているベンチマークは完全には重複していないため、分けて見る必要があります。claude-sonnet-5-5 は Terminal-Bench 4.0 の公式スコアで 70.6% を記録しました。Sonnet 5 の 10.3% から大幅に伸び、Opus 5.5 の 66.4% も上回っています。Artificial Analysis による独立再評価でも 64% となり、Opus 5.5 および gpt-6-astra の 60% を超えました。SWE-Bench Pro では 81.3%、CursorBench 4.0 では 55.5% を獲得しており、後者は Opus 5.5 に次ぐ成績です。
一方、gpt-6.1-sol では OpenAI が DeepSWE v1.1 における 75.2% を主な指標として掲げています。gpt-6-astra の 74.8% をわずかに上回り、1タスクあたりのコストは約 $1.50 と、Astra の5分の1未満です。第三者による集計では、claude-sonnet-5-5 の同ベンチマークのスコアは 71.0% です。つまり、ターミナル操作を中心とするエージェント型コーディングでは claude-sonnet-5-5 の優位性を示す証拠がより強く、リポジトリ規模のソフトウェアエンジニアリングでは gpt-6.1-sol の費用対効果が際立つといえます。
違い2:ナレッジワークでは、claude-sonnet-5-5 が Opus に肉薄
オフィス業務を含むナレッジワークでは、claude-sonnet-5-5 が非常に優れた結果を示しています。GDPval-AA v2.1 は 1844 で、Opus 5.5 の 1846 とほぼ同等です。AA-Briefcase では 1811 を記録し、こちらも Opus に迫っています。Artificial Analysis の知能指数では、claude-sonnet-5-5 は 56 点で2位となり、Opus 5.5 との差はわずか2点です。gpt-6.1-sol(max)は 52 点でした。
gpt-6.1-sol は、文書分析に独自の強みがあります。GDP.pdf ベンチマークでは 32.0% を記録し、gpt-6-astra の 32.2% にほぼ並んだほか、Opus 5.5 の 28.8% も上回りました。1タスクあたりのコストは約 $0.38 です。企業の業務フロー自動化を評価する AutomationBench では、claude-sonnet-5-5 が 44.7% で gpt-6.1-sol の 36.0% をリードしています。ただし、前者のコストは1タスク約 $1.14、後者は $0.30 にとどまります。
違い3:コンピューター操作では、両者とも実用的な水準に到達
コンピューター操作(Computer Use)では、gpt-6.1-sol は OSWorld 2.0 で 71.4% を獲得しました。gpt-6-astra の 73.5% との差はわずか 2.1 ポイントで、1タスクあたりのコストは約 $1.30 です。claude-sonnet-5-5 は OSWorld 2.1 で 80.1% を記録し、Opus 5.5 の 81.8% に近づいています。
ただし、OSWorld はバージョンごとにテストセットが異なるため、両スコアを単純に横並びで比較することはできません。それでも、両モデルともデスクトップアプリケーションを安定して操作できる能力を備えていることは確かです。
違い4:長大なコンテキストの料金体系では、gpt-6.1-sol に見落としやすい条件がある
これは見落とされがちでありながら、請求額に大きく影響するポイントです。gpt-6.1-sol は約 105 万 Token のコンテキストをサポートしていますが、1回のリクエストの入力が 272K Token を超えると、リクエスト全体の入力とキャッシュは2倍、出力は1.5倍の料金で課金されます。
対して claude-sonnet-5-5 の 100 万 Token コンテキストには、長大なコンテキストに対する追加料金がありません。最初から最後まで標準価格で利用できます。業務でマニュアル全冊やコードリポジトリ全体をコンテキストに投入することが多い場合、この違いだけでモデル選定の結論が変わる可能性があります。
違い5:Token 効率とキャッシュでは、gpt-6.1-sol が低コスト
gpt-6.1-sol のキャッシュ読み取り料金は $0.10 で、claude-sonnet-5-5 の $0.20 の半額です。エージェントループのように、繰り返し利用するプレフィックスが多いシナリオでは明確なメリットがあります。
一方、claude-sonnet-5-5 は高推論設定における Token 消費が大きい傾向にあります。Artificial Analysis の測定では、max 設定で1タスクあたり約 19.3 万 Token を出力しており、これは現時点で測定された中で最も多い値です。独立テストでも、API のデフォルトである high 設定は medium と比べて出力 Token の消費量がほぼ2倍となる一方、品質に明確な改善は見られなかったとされています。
| ベンチマーク / 指標 | gpt-6.1-sol | claude-sonnet-5-5 | 優位 |
|---|---|---|---|
| Terminal-Bench 4.0(公式) | 未公開 | 70.6% | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75.2% | 71.0% | gpt-6.1-sol |
| GDPval-AA v2.1 | 未公開(前世代の gpt-6-sol は 1487) | 1844 | claude-sonnet-5-5 |
| GDP.pdf 文書分析 | 32.0% | 未公開 | gpt-6.1-sol |
| AutomationBench | 36.0%(約 $0.30/タスク) | 44.7%(約 $1.14/タスク) | 品質は Sonnet、コストは Sol |
| AA 知能指数 | 52 | 56 | claude-sonnet-5-5 |
| キャッシュ読み取り料金 | $0.10 / 100万 | $0.20 / 100万 | gpt-6.1-sol |
💡 データに関する補足: 上記のベンチマークは、OpenAI・Anthropic の公式発表に加え、Artificial Analysis、Vellum など第三者機関の評価に基づいています。テストのバージョンや推論設定は機関ごとに異なります。どのランキングよりも、自社の実際の業務サンプルで比較テストを一度実施することをおすすめします。
gpt-6.1-sol と claude-sonnet-5-5 の実コスト比較
同じ価格表でも、実際の請求額が同じとは限りません。以下では、代表的な3つのワークロードにおける1リクエストあたりのコストを見積もります(キャッシュ書き込みは除外し、公式価格に基づいて計算)。どこで差が生じるのかをひと目で確認できます。
| ワークロード | リクエスト構成 | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| エージェントループ(高キャッシュ) | 入力 100K(キャッシュヒット率 90%)+ 出力 5K | 約 $0.079 | 約 $0.088 |
| 通常の対話 | 入力 5K + 出力 1K | 約 $0.020 | 約 $0.020 |
| 超長文コンテキスト検索 | 入力 400K(キャッシュなし)+ 出力 8K | 約 $1.72(追加料金が発生) | 約 $0.88 |
| バッチ処理(Batch) | 定価の50% | $1 / $5 | $1 / $5 |
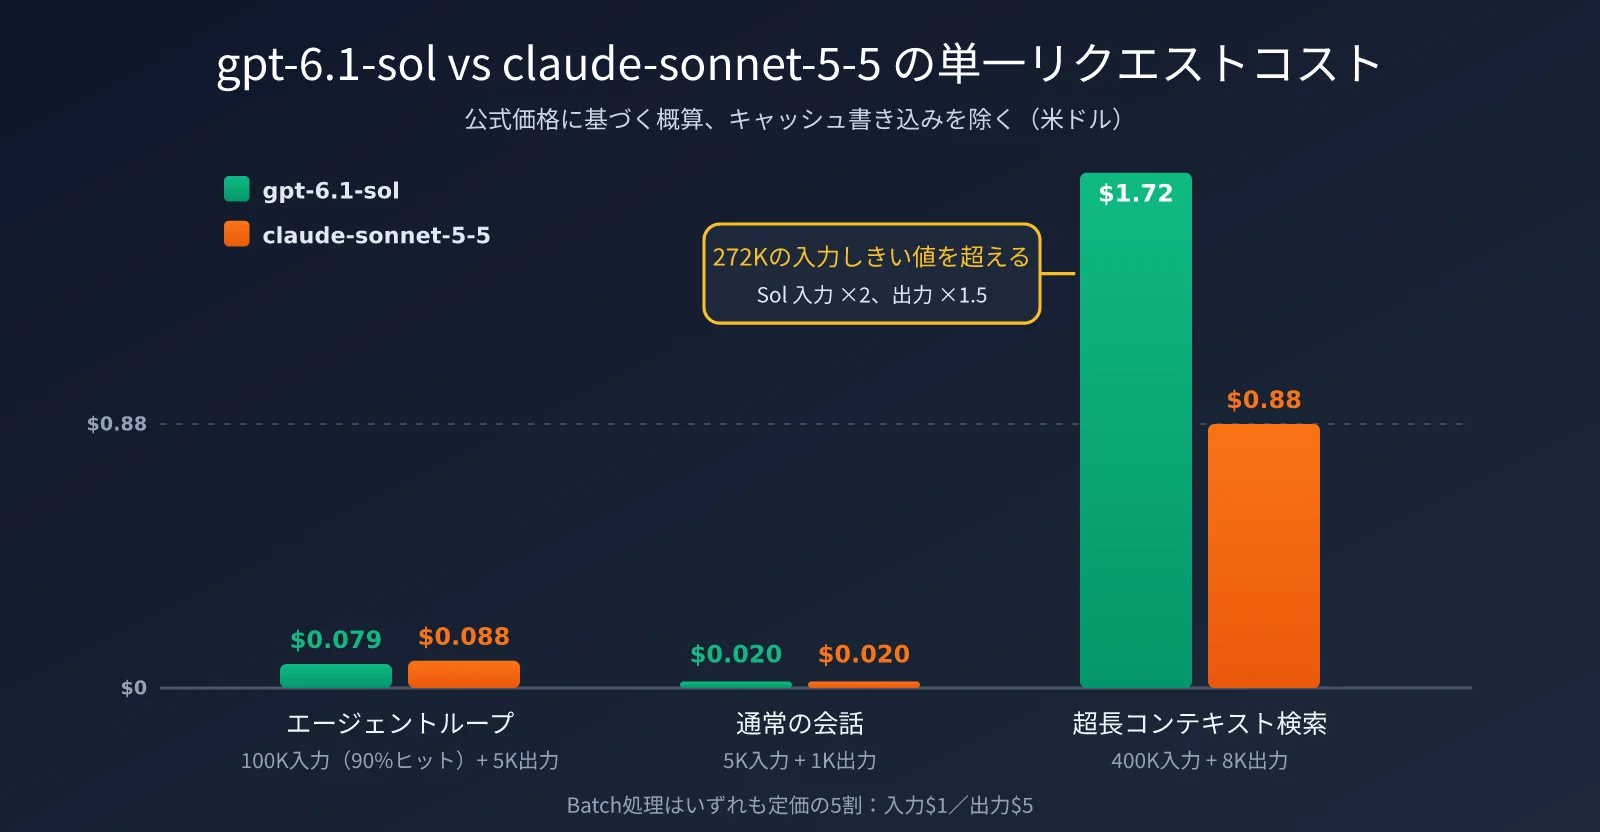
結論は明確です。プレフィックスの重複率が高いエージェントループでは、gpt-6.1-sol がより安価なキャッシュ読み取りによって約10%有利です。通常の対話では両者のコストはほぼ同じですが、1回の入力が272Kを超えると、claude-sonnet-5-5 のコストは gpt-6.1-sol のおよそ半分になります。
さらにToken効率も考慮する必要があります。claude-sonnet-5-5 を high または max の推論レベルで動かす場合、実際の出力Token数が2倍になる可能性があり、長文コンテキストにおけるコスト優位性が相殺されます。Sonnetを効果的に使うには、推論レベルを適切に制御することが重要です。
同じコードで2つのモデルを手早く比較する
OpenAI互換インターフェースでは、model パラメータを切り替えるだけで、2つのモデルを横断的にテストできます。以下は最小限の例です。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェース。両モデルで同じKeyを使用
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # 同じレベルに固定して、公平に比較する
        messages=[{"role": "user", "content": "この関数にユニットテストを追加してください:def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
展開して確認:所要時間とコストを集計する完全な比較スクリプト
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェース
)

# 100万Tokenあたりの価格:入力、キャッシュ読み取り、出力
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "Pythonで有効期限付きのLRUキャッシュを実装し、テストも作成してください",
    "以下の要件を読み、データベースのテーブル設計とインデックスの提案を出してください:注文、ユーザー、クーポン",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 すぐに始める: Anthropicアカウントをまだ持っていない場合や、海外決済・電話番号認証で手続きが止まっている場合は、APIYI apiyi.com に登録してテスト用クレジットを取得できます。1つのKeyだけで gpt-6.1-sol と claude-sonnet-5-5 を呼び出せるため、両社の公式アカウントを個別に開設する手間を省けます。
gpt-6.1-sol と claude-sonnet-5-5 の用途別おすすめ
品質、コスト、レイテンシに対する優先度は、ビジネスごとに異なります。ここでは代表的な用途別におすすめをまとめます。
| ビジネスシーン | 推奨モデル | 主な理由 |
|---|---|---|
| ターミナル駆動のコーディングエージェント(Claude Code系) | claude-sonnet-5-5 | Terminal-Bench 4.0で優位。ツール呼び出し回数も少ない |
| リポジトリ規模のコード修正、Codexワークフロー | gpt-6.1-sol | DeepSWEでAstraに並び、1タスクあたり約 $1.50 |
| 超長文ドキュメント/リポジトリ全体のコード分析(>272K) | claude-sonnet-5-5 | 長文コンテキストの追加料金がなく、Solの約半額 |
| 高同時接続のカスタマーサポート、RAG型Q&A(高キャッシュ) | gpt-6.1-sol | キャッシュ読み取りが $0.10。プレフィックス再利用が多いほど有利 |
| レポート作成、表計算、オフィス系ナレッジワーク | claude-sonnet-5-5 | GDPval-AAでOpus 5.5とほぼ同等 |
| PDF文書の解析、情報抽出 | gpt-6.1-sol | GDP.pdfでAstraに並び、1タスクあたり約 $0.38 |
| セキュリティ研究、ペネトレーションテスト支援 | gpt-6.1-sol | Sonnet 5.5にはサイバーセキュリティ保護機能が組み込まれ、拒否率が上昇 |
gpt-6.1-sol を選ぶ代表的なケース
gpt-6.1-sol は、コストに敏感で、リクエスト数が多く、プレフィックスの重複率が高いワークロードに特に向いています。たとえば、AIカスタマーサポート、ナレッジベースQ&A、バッチデータクレンジングなどです。システムプロンプトや検索コンテキストを高い頻度で再利用するため、$0.10のキャッシュ読み取り料金による優位性が継続的に効いてきます。
幻覚率も大きく改善されており、低推論レベルでの事実誤認率は前世代の11.4%から7.7%へ低下しています。low または medium レベルで大量の軽量タスクを処理する用途にも適しています。また、OpenAIは gpt-6.1-sol 向けに Ultrafast レベルを提供予定で、生成速度は最大約300 Token/秒、価格は標準レベルの6倍です。リアルタイム対話型プロダクトでは有力な選択肢になるでしょう。
claude-sonnet-5-5 を選ぶ代表的なケース
claude-sonnet-5-5 は、タスクが複雑で、コンテキストが非常に長く、一発で成功させる精度が求められるワークロードに適しています。エージェントタスクでは、Sonnet 5なら12〜13回必要だった作業を、通常はツール呼び出し約3回で完了できます。出力速度も前世代より30%以上高速です。
大量の資料を一度にコンテキストへ入れる法務レビュー、コードベース移行、長文レポートの作成では、追加料金なしで100万Tokenまで扱えるコンテキストウィンドウが大きな利点になります。
注意点として、claude-sonnet-5-5 には Sonnet 5からの破壊的変更がいくつかあります。思考モードは無効化できず、特定ツールの使用を強制する tool_choice: "tool" も廃止されました。既存コードがこれらの挙動に依存している場合は、移行前に必ずリグレッションテストを実施してください。
🎯 アーキテクチャの提案: この2モデルは、必ずしも二者択一にする必要はありません。APIYI apiyi.com を通じてシンプルなモデルルーティングを構築し、短いリクエストと高キャッシュ率のトラフィックは gpt-6.1-sol、超長文コンテキストと複雑なコーディングタスクは claude-sonnet-5-5 に振り分ける方法がおすすめです。同じOpenAI互換インターフェース上で、用途に応じて柔軟に切り替えられます。
gpt-6.1-sol と claude-sonnet-5-5 を選ぶための判断ガイド
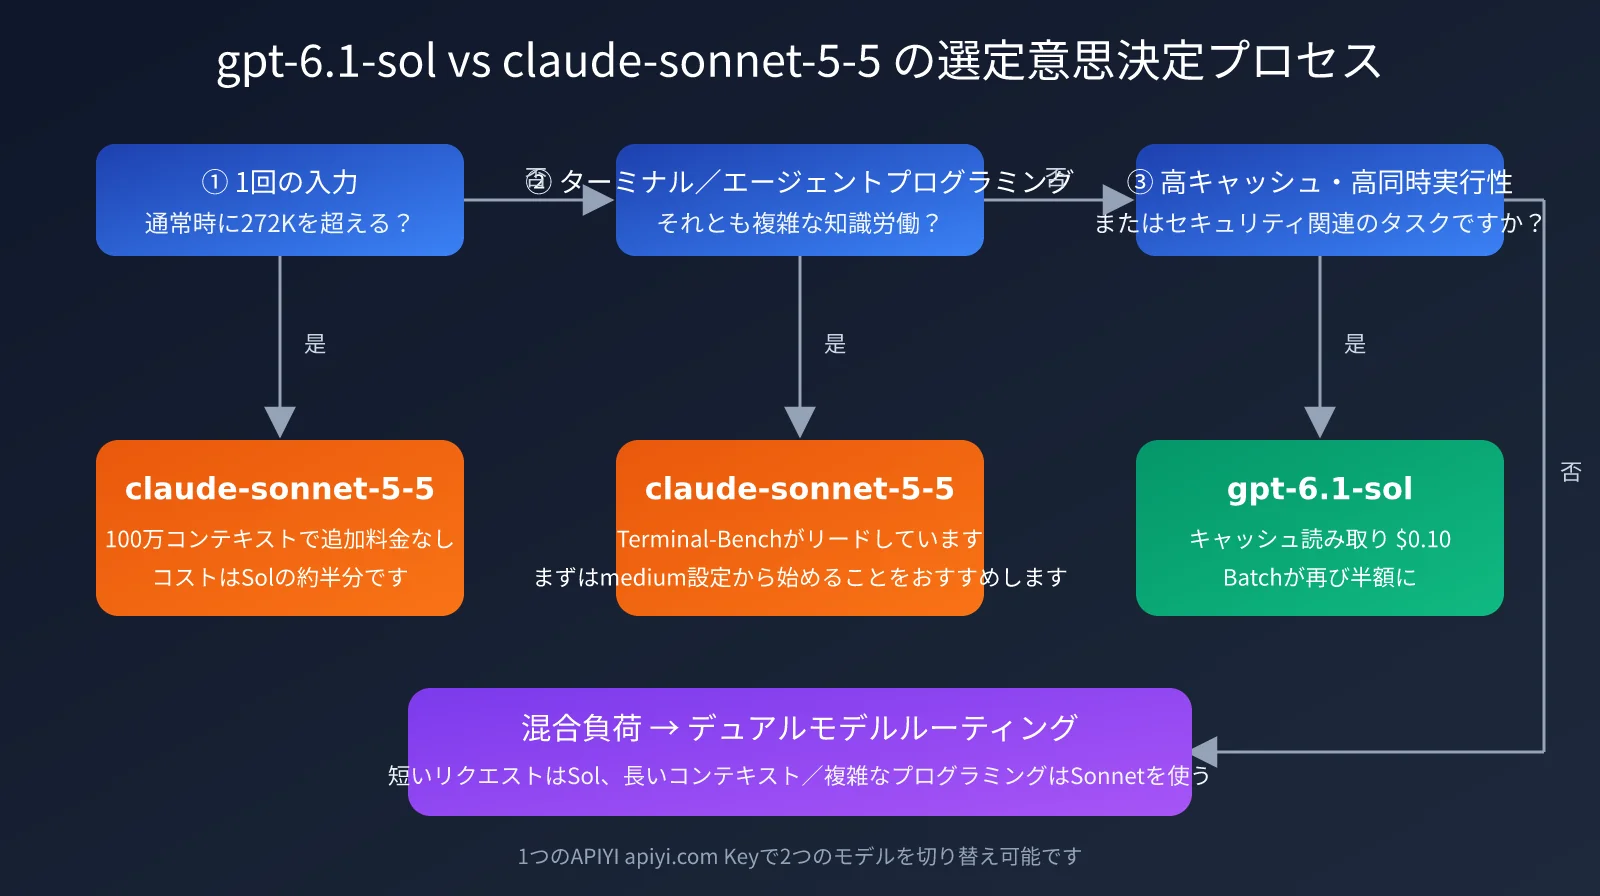
ここまでの分析を、実行しやすい意思決定フローにまとめます。
- まず入力長を確認する:通常のリクエストが 272K Token を超える場合は、claude-sonnet-5-5 を優先します。それ以外は次のステップへ進みます。
- 次にタスクの種類を見る:ターミナル/エージェント型コーディングや複雑なナレッジワークには claude-sonnet-5-5、リポジトリ規模のコード修正や PDF 解析には gpt-6.1-sol が向いています。
- 続いてトラフィック構成を確認する:キャッシュヒット率が高く、同時実行数も多いサービスでは、gpt-6.1-sol のコスト優位性が規模に応じてさらに大きくなります。
- 最後に推論レベルを抑える:どちらを選ぶ場合でも、まずは medium からテストしてください。特に claude-sonnet-5-5 は、API のデフォルトである high をそのまま使わないようにしましょう。Token 消費量が倍増する可能性があります。
| 優先したいこと | 第一候補 | 代替戦略 |
|---|---|---|
| 品質優先、予算に余裕がある | claude-sonnet-5-5(medium/high) | 難易度の高いタスクのみ Opus 5.5 へアップグレード |
| コスト優先、トラフィックが非常に多い | gpt-6.1-sol(low/medium) | リアルタイム性が不要なタスクは Batch で 50% 割引 |
| 速度優先、リアルタイム対話 | gpt-6.1-sol(Ultrafast 提供開始後) | claude-sonnet-5-5 の low 設定 |
| 安定性優先、単一障害点を避ける | 2モデルルーティング | 一方がレート制限された場合、もう一方へ自動切り替え |
ブランドへの好みや利用可能性は、技術選定の決定要因にすべきではありません。Claude の公式アカウントは地域・決済方法に対する要件が比較的厳しく、確かに利用開始のハードルになります。しかし、これはモデル性能ではなく接続レイヤーの問題です。接続レイヤーを統合 API プラットフォームに任せれば、タスクの実行性能とコストだけに基づいてモデルを選べます。
よくある質問
Q1:gpt-6.1-sol と claude-sonnet-5-5 は、本当にどちらも値下げされたのですか?
表示価格自体は変わっておらず、どちらも $2/$10 を維持しています。実質的な「値下げ」は、gpt-6.1-sol が gpt-6-astra に近い性能を 5 分の 1 の価格で提供し、キャッシュ読み取り料金も $0.20 から $0.10 に引き下げた点にあります。一方、claude-sonnet-5-5 は Opus の半額で Opus 5.5 に近い性能を提供し、ツール呼び出し回数を減らすことで、タスク単位のコストを最大約 30% 削減できます。そのため、両者を比較する際は単価ではなく、1 タスクあたりの総コストを見るべきです。
Q2:Anthropic アカウントがなくても、claude-sonnet-5-5 を呼び出せますか?
Anthropic の公式アカウントでは、登録地域・電話番号・決済方法のすべてに要件があります。個人開発者や日本国内を含む一部地域のチームでは、この段階で利用できないことも少なくありません。簡単な方法として、APIYI apiyi.com 経由で呼び出せます。プラットフォームは OpenAI 互換インターフェースを提供しているため、base_url を https://api.apiyi.com/v1 に変更し、model を claude-sonnet-5-5 に設定するだけで利用できます。ほかの業務コードを変更する必要はありません。
Q3:gpt-6.1-sol の 105 万 Token コンテキストは、上限まで安心して使えますか?
利用できますが、料金には注意が必要です。1 回の入力が 272K Token を超えると、リクエスト全体の入力料金とキャッシュ料金が 2 倍になり、出力料金は 1.5 倍になります。超長文コンテキストが本当に必要な場合は、まず検索ベースで情報を圧縮するか、長コンテキスト追加料金のない claude-sonnet-5-5 へこの種のリクエストをルーティングすることをおすすめします。
Q4:claude-sonnet-5-5 が予想より高額になることがあるのはなぜですか?
主な原因は推論レベルです。API のデフォルト設定は high であり、思考モードも無効化できません。単純なタスクでも不要な思考 Token が大量に生成されやすくなります。独自テストでは、medium 設定は Sonnet 5 と同程度の Token 消費量でありながら、より高い性能を示しています。そのため、日常的なタスクでは medium を明示的に指定することをおすすめします。
Q5:コーディング用途では、結局どちらを選べばよいですか?
Claude Code のようなターミナル型エージェントで、複数ステップにわたる開発を行うなら、claude-sonnet-5-5 の Terminal-Bench スコアのほうが説得力があります。一方、リポジトリ規模の不具合修正を中心に行い、Codex ワークフローで使う場合は、gpt-6.1-sol がより低いタスク単価で gpt-6-astra と同等の成果を出しています。チームの条件が許すなら、両方を接続し、タスクタイプに応じて振り分けるのが最も堅実な方法です。
まとめ
gpt-6.1-sol と claude-sonnet-5-5 の比較に、絶対的な勝者はありません。claude-sonnet-5-5 はエージェント型コーディング、ナレッジワーク、知能指数でより優れており、100万トークンのコンテキストウィンドウも追加料金なしで利用できます。一方、gpt-6.1-sol はキャッシュ料金、リポジトリ規模のコード修正、文書解析、単一タスクあたりのコストで優位です。そのため、大規模かつ再利用率の高い本番トラフィックに適しています。
両者の標準価格は同じですが、実際の料金差を大きく左右するのは、入力長、キャッシュヒット率、推論レベルという3つの変数です。
実践では、次の3ステップで進めるとよいでしょう。まず、本記事の意思決定フローを使って主力モデルを選定します。次に、比較スクリプトで実際のタスクを対象にA/Bテストを実施し、同じ推論レベルに固定して比較します。最後に、タスクタイプ別のデュアルモデルルーティングを構築し、各リクエストを最もコストパフォーマンスの高いモデルへ振り分けます。
Anthropic と OpenAI、それぞれの公式アカウントを開設する手順を省きたい場合は、APIYI apiyi.com を通じて gpt-6.1-sol と claude-sonnet-5-5 を一元的に呼び出す方法がおすすめです。このプラットフォームは OpenAI 公式形式と互換性のあるインターフェースを提供しており、1つのAPIキーだけで2つのモデルを自由に切り替えられます。モデル選定テストや、本番環境でのマルチモデルルーティングに適しています。
参考資料:
– OpenAI 公式発表:GPT-6.1 Sol の紹介 openai.com/index/introducing-gpt-6-1-sol
– Anthropic 公式発表:Claude Sonnet 5.5 の紹介 anthropic.com/claude-sonnet-5-5
– Artificial Analysis 知能指数ベンチマーク:artificialanalysis.ai
– Vellum による GPT-6.1 Sol ベンチマーク解説:vellum.ai/blog
– The Decoder による Claude Sonnet 5.5 の報道:the-decoder.com
著者紹介: APIYI 技術チームは、AI大規模言語モデルAPIの導入とエンジニアリング実践に注力しています。gpt-6.1-sol と claude-sonnet-5-5 の選定やコスト最適化については、APIYI apiyi.com までお気軽にご相談ください。