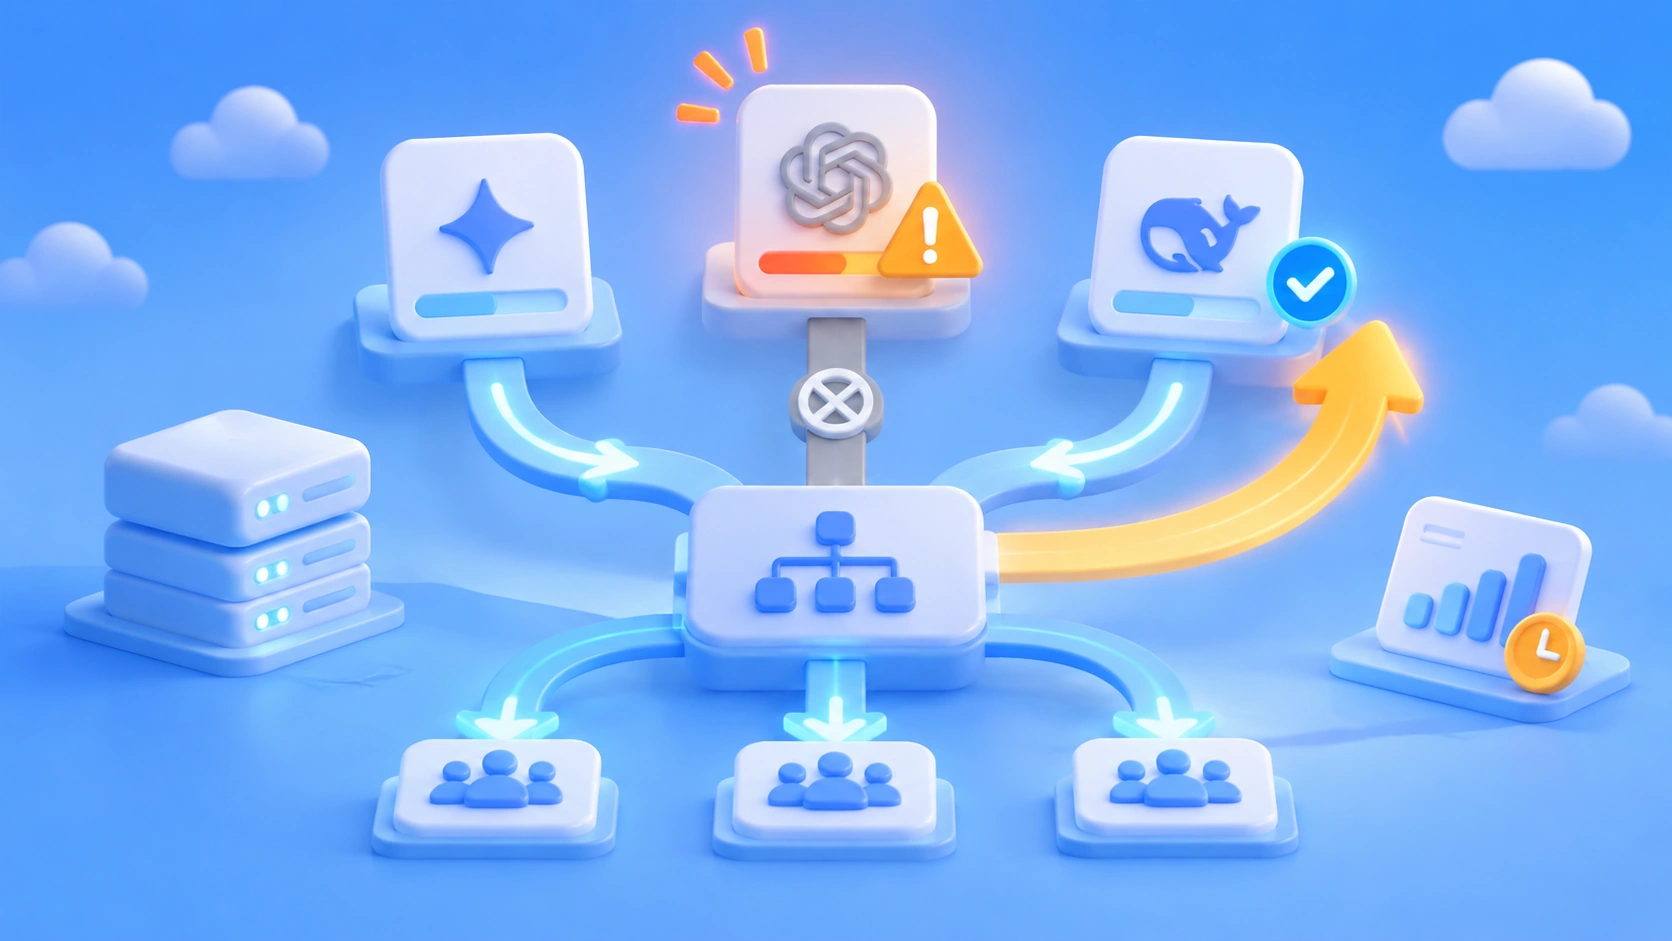
作者注:新モデルのリリース日に利用枠の上限、レート制限、タイムアウトに直面することは想定できます。この記事では、モデルの階層化、代替モデルのマッピング、優先度付きキュー、時間をずらしたスケジューリング、監視と予算管理という5つの設計ポイントと、リリース日のキャパシティチェックリストを紹介します。
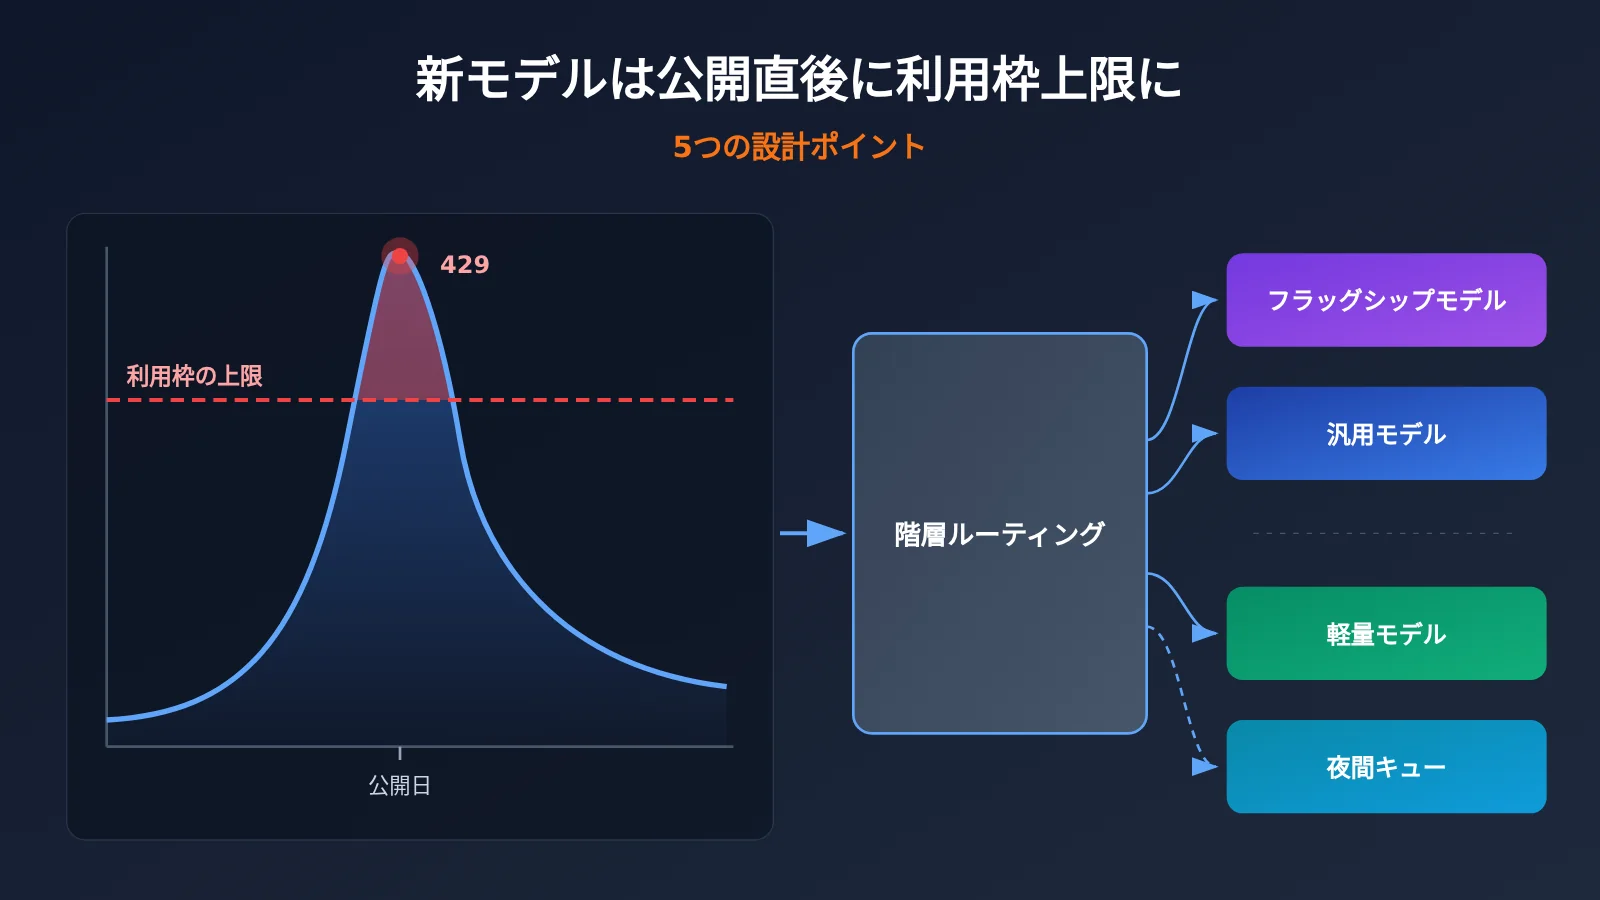
結論から言うと、新モデルのリリース直後に利用枠の上限に達するのは、予想外の事故ではなく、製品リリースの流れの一部です。無料枠には多くの試用ユーザーが集まり、リリース日にはトラフィックが集中します。一方、提供元のキャパシティ拡張には時間がかかるため、これらが重なると、容量不足はほぼ避けられません。アプリケーション側で本当に必要なのは、429 が発生してから何度もリトライすることではなく、リリース前に複数モデルの切り替えと時間をずらしたスケジューリングを設計しておくことです。
この記事は「リトライ回数を増やす方法」を紹介するものではありません。リトライは一時的な不安定さには対応できますが、利用枠の枯渇や提供元の過負荷は解決できません。リリース日に重要なのはリトライ回数ではなく、事前に設計した階層化とキューイングです。この記事では、モデルの階層化、代替モデルのマッピング、優先度付きキュー、時間をずらしたスケジューリング、監視と予算管理を通じて、実践できるキャパシティ設計の方法を紹介します。いつ切り替え、いつキューに入れ、いつ処理を止めるべきかも分かります。
新モデルのリリース日に利用枠の上限に達しやすい理由
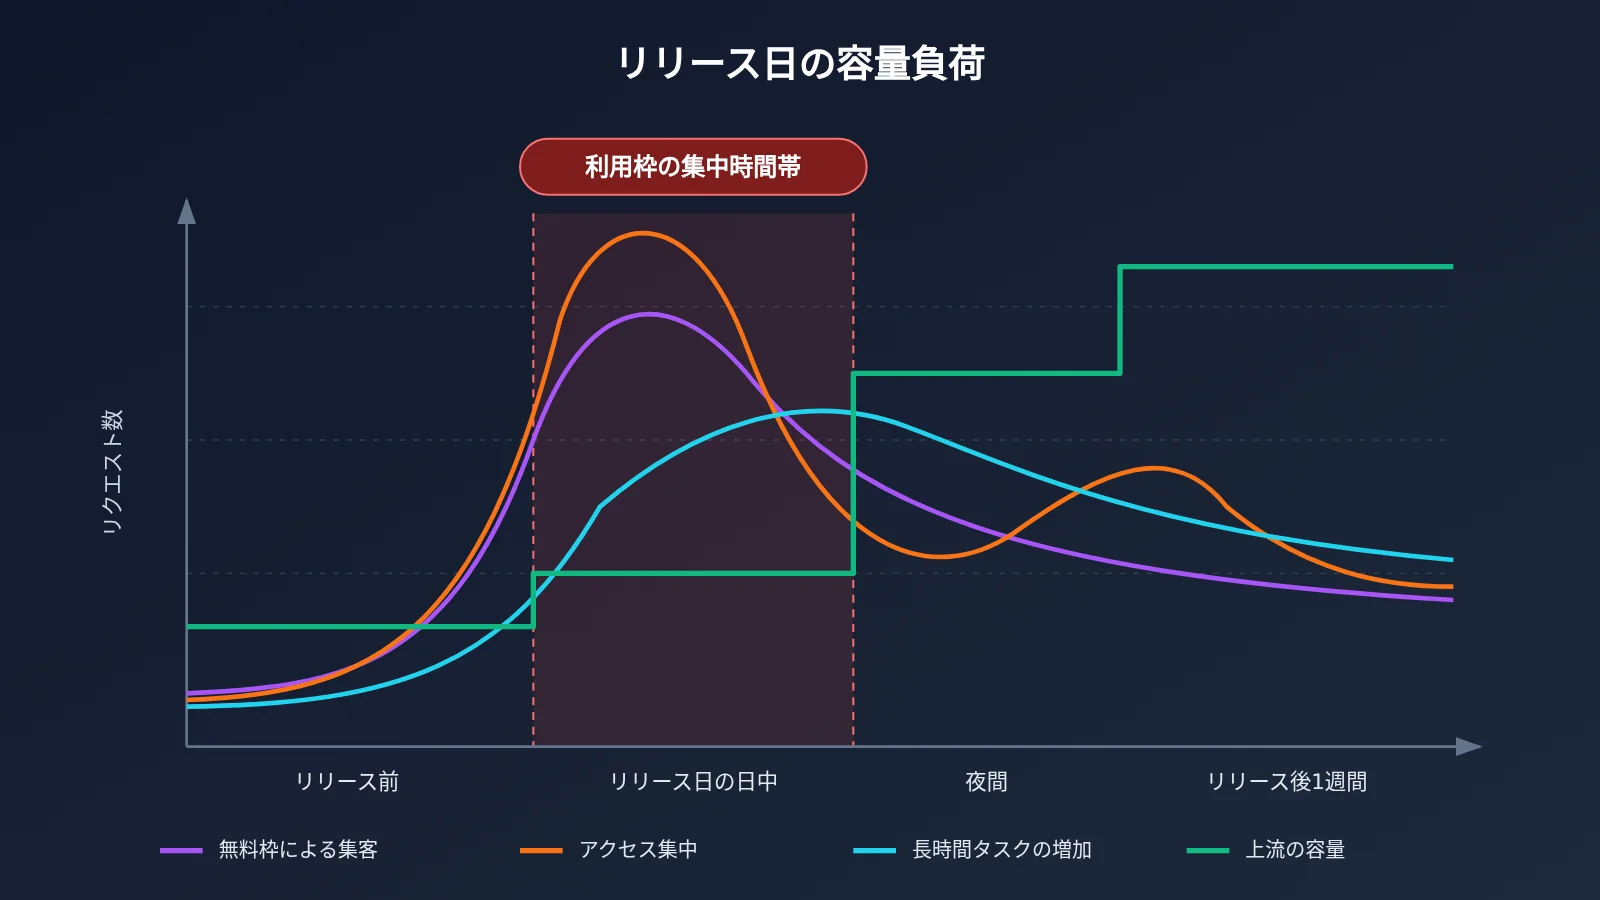
結論から言うと、リリース日に利用枠の上限に達しやすいのは、需要が一気に集中する一方で、供給側の増強が追いつかないためです。アプリケーション側では、これを予測可能な事態として設計に織り込む必要があります。
最近の典型例が、Tencent の Hy4 です。Tencent の公表によると、Hy4 は 11 月 4 日に WorkBuddy で先行公開され、初日に多くのユーザーが利用枠の上限に達しました。その後、推論クラスターを 10 倍に増強し、無料利用枠も引き上げています。Tencent は、上限に達した場合は Hy3 に切り替えるか、緊急でないタスクを夜間に処理するよう推奨するとともに、Hy3 の期間限定無料提供を 11 月 15 日 23:59 まで延長しました。
特に注意したいのは、今回の利用枠の問題は WorkBuddy の製品レベルで発生した、エンドユーザー向けの利用枠に関するものであり、API のレート制限と直接同一視することはできないという点です。製品の利用枠は通常、アカウントや会員ランクごとに計算されます。一方、API のレート制限は Key、組織、モデルなどを単位として、リクエスト速度や同時実行数に適用されます。両者では制限に達する条件も対処方法も異なります。ただし、ここから見えてくる傾向は共通しています。新モデルが公開されると、ごく短時間に需要が集中するのです。
需要の規模自体も急速に拡大しています。同じ 11 月 4 日には、DeepSeek が Harness の日間アクティブユーザー数を約 154 万人、1 日の消費量を約 92 兆 token と公表しました。こうした数字はベンダーによる自己申告であり、第三者による監査を受けたデータではありません。規模感をつかむ参考にはなりますが、容量計画の正確な根拠として使うべきではありません。それでも、Agent 系アプリケーションの token 消費量が、通常のチャットをはるかに超えていることはうかがえます。
新モデルが利用枠の上限に達しやすい4つの要因
| 要因 | 具体的な状況 | アプリケーション側への影響 |
|---|---|---|
| 無料枠・試用枠 | 新モデルには試用枠が用意されることが多く、大勢のユーザーが同時に試す | 利用枠がすぐに尽き、402 や 429 が発生する |
| アクセスの集中 | リリース日、キャンペーン期間、平日の日中のトラフィックが重なる | ピーク時の負荷が通常の 3〜10 倍に達することがある |
| 長時間タスクによる占有 | Agent の複数ラウンドにわたる処理、ツール呼び出し、長いコンテキスト | リクエストあたりの token 数が多く、推論リソースを長時間占有する |
| 上流の増強の遅れ | 推論クラスターの増強には時間がかかる | 5xx、待ち行列、タイムアウト、さらには出力品質の変動が発生する |
この4つの要因のうち、アプリケーション側が直接コントロールできるのは、自身のリクエストの形態とスケジューリング方法だけです。そのため、上流が負荷に「耐えてくれる」ことを期待するよりも、自分たちの側で負荷分散とバッファリングを準備しておくほうが得策です。
新モデルで直面する5種類の容量問題
結論:容量上限への到達は一種類のエラーではなく、性質の異なる5種類の問題があります。種類に応じて対処を分けることが重要です。
多くのチームは、あらゆる失敗を同じリトライ処理にまとめています。しかし、それこそがリリース日の障害を拡大させる原因です。利用枠が尽きた状態ではリトライしても失敗が続き、上流側が過負荷のときに頻繁にリトライすると、混雑をさらに悪化させます。次の表で5種類の問題を整理しました。処理の分岐を設計する際に参考にしてください。
| 問題 | 代表的なステータスコード | 原因 | 対処 |
|---|---|---|---|
| 利用枠の枯渇 | 402、429 |
無料枠、試用枠、アカウント残高の使い切り | リトライを停止し、代替モデルに切り替えるか、利用枠の追加を促す |
| レートまたは同時実行数の制限 | 429、多くの場合 Retry-After を伴う |
単一キーまたは単一モデルのRPM、TPM、同時実行数が上限を超過 | Retry-After に従って待機し、待機時間がしきい値を超える場合は切り替えまたはキューへの追加を行う |
| 上流側の容量不足 | 500、502、503、529 |
推論クラスターの過負荷または局所的な障害 | 指数バックオフで少数回リトライし、連続して失敗したら代替モデルに切り替える |
| 長時間タスクによるリソース占有 | タイムアウト、接続切断 | Agentの複数ターン処理、ツール呼び出し、長いコンテキストにより単一リクエストの負荷が増大 | タスクを分割し、コンテキストを制限し、長時間タスク専用の同時実行プールを用意する |
| ピーク時の集中 | 429 と 5xx が混在 |
日中、リリース日、イベント期間中のトラフィックが重なる | 優先度付きキューと時間をずらしたスケジューリングを組み合わせ、緊急でないタスクを後回しにする |
表の中で、特に押さえておきたい点が2つあります。1つ目は、429 だけでは原因を特定できないことです。レート制限超過の場合もあれば、利用枠の枯渇の場合もあるため、レスポンス本文のエラー情報と Retry-After をあわせて判断する必要があります。2つ目は、529 のような過負荷を示すコードは、上流側が一時的にサービスを提供できない状態を表すことです。この場合は、リトライを速めるよりもリクエストの頻度を下げるほうが効果的です。
エラーコードを区別できて初めて、後に続く5つの設計ポイントを具体化できます。どのケースで切り替え、どのケースでキューに入れ、どのケースですぐに処理を止めるかを判断しましょう。
複数モデルの切り替えとオフピークスケジューリングにおける5つの設計ポイント
結論から言うと、5つの設計ポイントは、それぞれ「どのモデルを使うか」「どのモデルに切り替えるか」「誰が先に使うか」「いつ使うか」「いくらかかったか」という問題に対応します。どれか一つでも欠けると、リリース当日に問題が表面化します。
設計ポイント1:モデルの階層化
どう進めるか:モデルを性能とコストに応じて、フラッグシップ、汎用、軽量の3層に分け、業務タスクを優先度と難易度に応じて各層に割り当てます。複雑な推論や重要なコード生成にはフラッグシップ層、日常的な質問応答、要約、書き換えには汎用層、分類、抽出、意図認識といったシンプルなタスクには軽量層を使います。新モデルのリリース時には、通常、すべてを置き換えるのではなく、フラッグシップ層の一部のトラフィックにだけ導入します。
いつ適用するか:階層化は、障害時だけに有効にするものではなく、常時適用する設定です。平常時からタスクごとの割り当て先を決めておき、リリース当日はその配分を調整します。
どう検証するか:各層について固定の評価問題セットを用意し、合格率、P95レイテンシ、タスクあたりのトークンコストを記録します。軽量層でシンプルなタスクを処理しても、品質が大きく低下しないことを確認します。
実装面では、「ベンダーを追加するたびにSDKとAPIキーが増える」ことが、階層化の大きな障壁になりがちです。APIYI apiyi.com のような集約プラットフォームを使えば、1つのAPIキーでOpenAI、Claude、Geminiなど複数のモデルを呼び出せます。インターフェースはOpenAI形式と互換性があるため、階層化の際にはモデル名を変更するだけで済み、各層で個別に認証やクライアントを管理する必要がありません。
設計ポイント2:代替モデルのマッピング
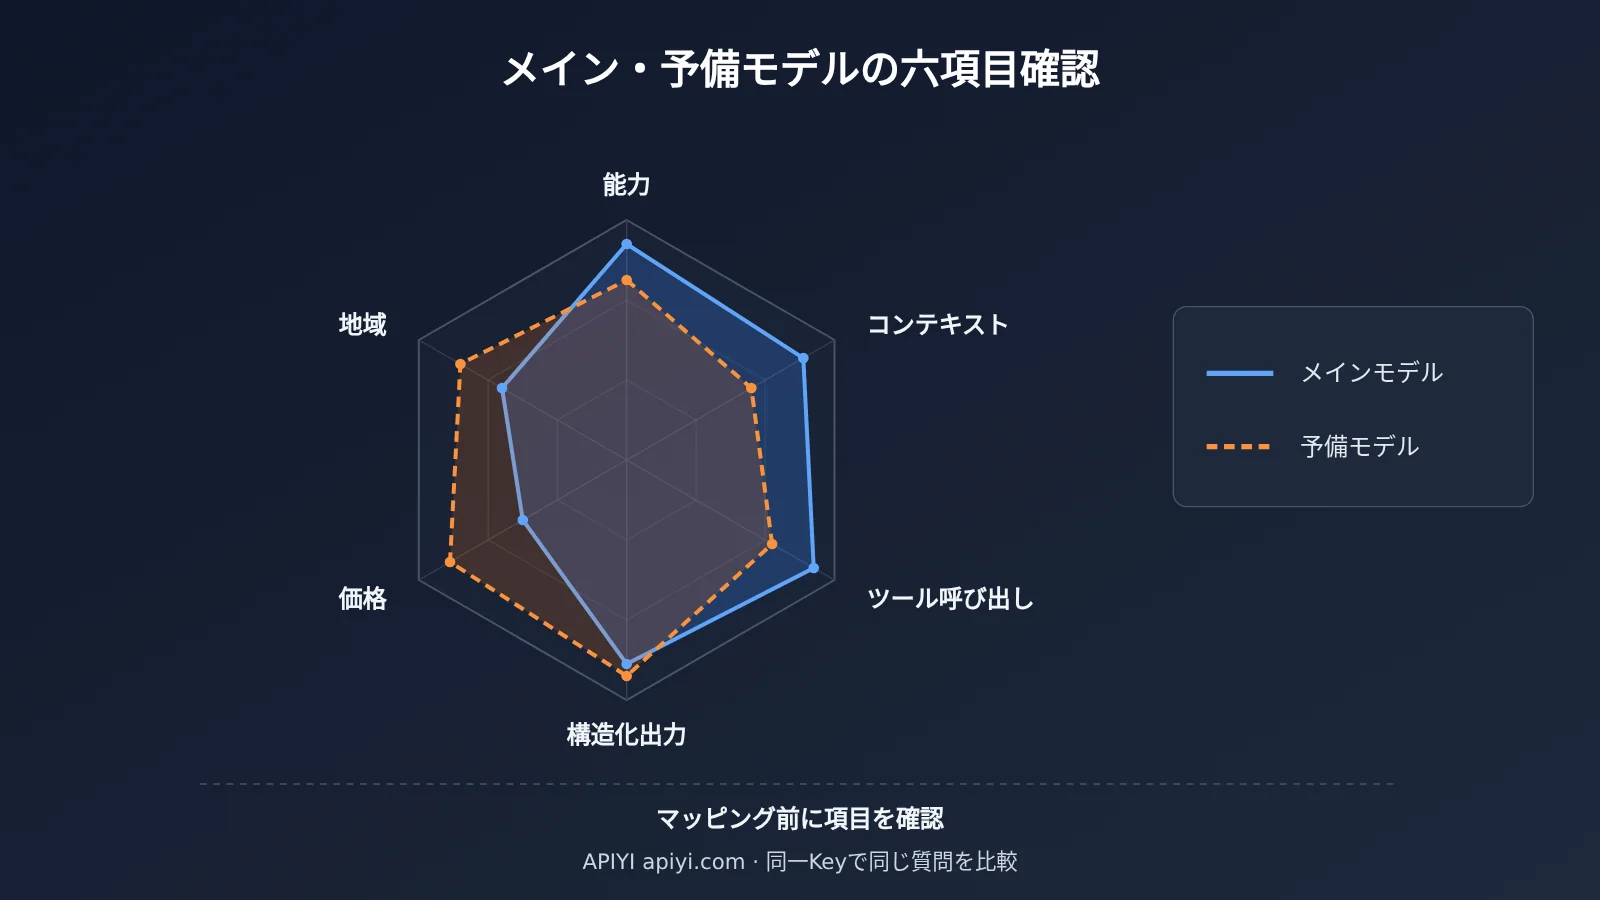
どう設定するか:各メインモデルに少なくとも1つの代替モデルを指定し、マッピングの際に、能力レベル、コンテキスト長、ツール呼び出しのサポート、構造化出力の能力、価格、利用可能な地域の6項目を確認します。特に見落としやすいのは、ツール呼び出しと構造化出力です。代替モデルが同じ関数呼び出し形式に対応していないと、切り替え後にAgentが停止してしまいます。
いつ切り替えるか:切り替え条件は具体的なルールにします。例えば、5xx が2回連続する、429 の Retry-After がタスクの許容待ち時間を超える、P95レイテンシが継続してベースラインの2倍を超える、あるいは利用枠の枯渇が明示的に返されるといった条件です。「失敗したらすべて切り替える」と設定すると、一時的な変動でも大量の切り替えが発生するため避けましょう。
どう検証するか:同じ問題セットをメインモデルと代替モデルでそれぞれ実行し、合格率、構造化出力の検証合格率、ツール呼び出しの成功率を比較します。差が業務上の許容範囲を超える場合は、代替モデルを選び直します。
| 階層 | 適用タスク | メインモデル | 代替モデル | 切り替え条件 |
|---|---|---|---|---|
| フラッグシップ層 | 複雑な推論、重要なコード、Agentの計画立案 | 新しくリリースされたフラッグシップモデル | 前世代のフラッグシップモデルまたは同等クラスの他社モデル | 5xx が2回連続;429 の Retry-After が30秒を超過 |
| 汎用層 | 質問応答、要約、書き換え、レポート生成 | 主力の汎用モデル | 同等クラスの他社製汎用モデル | P95レイテンシがベースラインの2倍を超え、5分間継続 |
| 軽量層 | 分類、抽出、ルーティング、意図の識別 | 軽量モデル | 他社の軽量モデル | 5xx の発生率が5%を超過;利用枠の枯渇 |
| バッチ処理層 | オフライン分析、データアノテーション、評価 | 利用可能な任意の低価格モデル | 切り替えず、そのまま延期 | 即時切り替えはせず、夜間キューに追加 |
| 利用可能なプラットフォーム | 上記の各階層を一元的に接続 | APIYI apiyi.com、各社の公式API | 同左 | 管理画面とドキュメントを参照 |
表内のしきい値は例です。自社の業務におけるベースラインに合わせて調整してください。
💡 縮退運転のヒント:アプリケーション内ですべての切り替えロジックを管理したくない場合は、プラットフォーム側の機能を組み合わせることもできます。APIYI apiyi.com は公式に、マルチノード展開、インテリジェントルーティング、自動縮退、負荷分散を採用していると説明しており、上流で部分的な障害が発生した際の負担を一部軽減できます。具体的な発動条件や切り替えルールは公式ドキュメントを確認してください。アプリケーション側でも、最後の備えとして独自の代替モデルのマッピングを維持することをおすすめします。
設計のポイント 3:優先度キュー
どう実装するか:リクエストを優先度に応じて、有料・緊急タスク、内部タスク、バッチ処理タスクの3段階に分けます。緊急タスクはメインモデルに直接送ります。内部タスクはメインモデルが混雑している場合、代替モデルに切り替えます。バッチ処理タスクはキューに入れて待機させます。各キューには最大同時実行数、最大待機時間、タイムアウト時のフォールバック方針を設定し、長時間のタスクが同時実行枠を占有しないようにします。
いつ発動するか:メインモデルの 429 発生率またはキューの長さがしきい値を超えると、キュー制御が有効になります。優先度の低いリクエストは、メインモデルの同時実行枠を奪わなくなります。
どう検証するか:キューの状態を可視化し、少なくともキューの長さ、平均待機時間、待機を諦めた割合を確認できるようにします。負荷テストではメインモデルのレート制限を意図的に発生させ、緊急タスクのレイテンシが安定していることと、低優先度タスクが失敗せずにキューで待機していることを確認します。
ここで守るべき原則があります。冪等でないリクエストは自動リトライしてはいけません。注文、メッセージ送信、データベースへの書き込み、外部の有料ツールの呼び出しなどは、失敗後にまず状態を照会し、前回の操作がすでに反映されているかを確認してから、再送するかどうかを判断します。このようなリクエストには冪等性キーを生成し、サーバー側で重複を排除することもできます。すべてのエラーを一律に自動リトライすると、リリース当日の二重課金や重複書き込みにつながりやすくなります。
設計のポイント 4:ピークを避けたスケジューリング
やり方:オフラインレポート、バッチ要約、データアノテーション、回帰評価など、遅延を許容できるタスクを特定し、夜間や閑散時間帯に実行します。Tencent が Hy4 の制限に達したユーザーに勧めている対策の一つも、緊急性の低いタスクを夜間に回すことです。この考え方は API 呼び出しにも応用できます。
いつ実行するか:2種類のトリガーを併用できます。一つは時間帯によるトリガーで、夜間の閑散時間帯にバッチタスクを定期実行します。もう一つは負荷によるトリガーで、日中の 429 率や P95 レイテンシが基準を超えたときに、バッチ処理キューの実行を自動的に延期します。
検証方法:実行時間をずらした後、日中のピーク時のリクエスト数が減ったか、夜間タスクの完了率と失敗後のリトライ率が許容範囲内に収まっているかを確認します。タスクが失敗した場合はリトライできますが、同様に冪等性の原則を守る必要があります。
設計のポイント 5:監視と予算
やり方:使用量を Key、モデル、タスクの種類という3つの軸で分けて集計し、合計だけを見ないようにします。合計が安定していても、特定の Agent タスクの token 使用量が倍増している可能性があります。軸ごとに集計して初めて、こうした変化を把握できます。また、リリース日には臨時の予算とアラートを設定します。アラートのしきい値は適度に緩めてもかまいませんが、予算の上限は維持してください。
いつ発動するか:アラートルールは、429 率の急増、5xx 率の急増、タスク単位の token 使用量の基準値超過、日次予算の消化率が一定割合を超えた場合、という4種類のシグナルをカバーすることをおすすめします。
検証方法:リリース前に少量のトラフィックでテストし、ダッシュボードで各軸のデータを正しく確認できること、アラートが想定時間内に届くことを確認します。
| 指標 | 注目する軸 | 説明 |
|---|---|---|
429 率 |
Key、モデル | レート制限超過と利用枠の枯渇を区別する |
5xx 率 |
モデル | 上流サービスが過負荷かどうかを判断し、切り替えを行う |
| P95 レイテンシ | モデル、タスクの種類 | 長時間タスクは別に集計し、全体の基準値を押し上げないようにする |
| キューの長さと待ち時間 | 優先度別キュー | 優先度の低いタスクが滞留していないかを確認する |
| token/タスク、コスト/タスク | タスクの種類 | Agent の複数ターン処理やツール呼び出しによって大幅に増える |
| 切り替え回数とフォールバック成功率 | メイン・バックアップの対応関係 | バックアップモデルが実際にトラフィックを引き受けられたかを判断する |
コストの集計には、プラットフォームの機能を活用できます。APIYI apiyi.com のコンソールでは、モデル一覧、使用量、請求情報、ログを確認できます。リリース日に Key とモデルごとの実際の消費量を照合し、独自に計測したタスク単位のデータと組み合わせれば、「いくら使ったか」と「何に使ったか」を対応づけられます。
容量の見積もりでは、日間アクティブユーザー数、リクエスト数、平均 token 数からピーク時の QPS を推定し、さらに Agent の複数ターン処理やツール呼び出しによる増幅係数を掛けます。リリース日のピークは通常の3〜10倍になる可能性があるため、30%〜50%の予備容量を確保するか、いつでも切り替えられるバックアップモデルを用意しておくことをおすすめします。チャット用途だけを基準に見積もると、長いコンテキストやツール呼び出しによる消費を大幅に過小評価してしまいます。
マルチモデル切り替え入門:フォールバックを検証するには
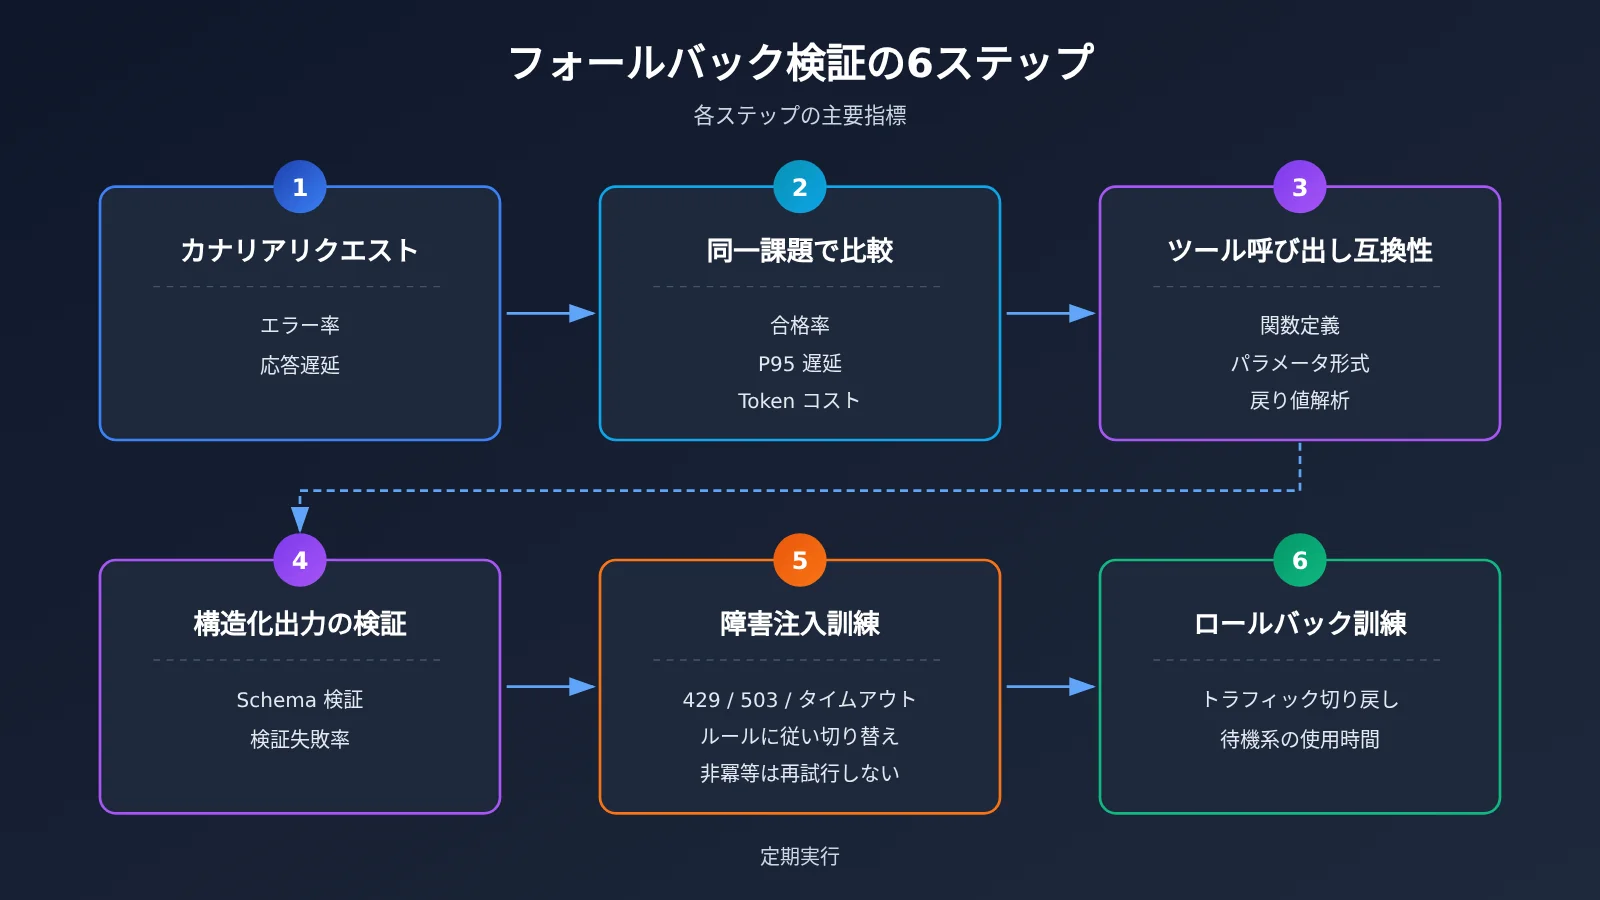
結論から言うと、バックアップ経路は演習していなければ、ないのと同じです。フォールバックの検証はリリース前に済ませましょう。
接続設定の変更は複雑ではありません。すでにOpenAI互換のSDKを使っているなら、base_url を https://api.apiyi.com/v1 に設定し、api_key をプラットフォームから提供されたキーに変更するだけです。新しいクライアントを導入しなくても、model パラメータを変更することで、メインモデルとバックアップモデルを切り替えられます。時間をかけるべきなのは検証です。次の順序で進めることをおすすめします。
- カナリアリクエスト:まず少量の実トラフィックをバックアップモデルに送り、エラー率とレイテンシを確認します。
- 同じ問題で比較:固定の評価セットをメインモデルとバックアップモデルの両方で実行し、合格率、P95レイテンシ、トークンコストを比較します。
- ツール呼び出しの互換性:関数定義、パラメータ形式、戻り値の解析がバックアップモデルでも正常に動作するか、一つずつ確認します。
- 構造化出力の検証:JSON出力をスキーマで検証し、検証失敗率を記録します。
- 障害注入演習:
429、503、タイムアウトを意図的に発生させ、ルールに従って切り替わることと、非冪等なリクエストが自動的にリトライされないことを確認します。 - 切り戻し演習:メインモデルの復旧後、トラフィックが想定どおりに戻り、バックアップモデルに長時間とどまらないことを確認します。
フォールバック演習は、リリース前に一度だけ行うのではなく、定期的に実施するのが理想です。上流のモデルはバージョンが更新され、プロンプトやツール定義も変わります。3か月前に検証したマッピングが、今も有効とは限りません。
🚀 クイックスタート:まずは APIYI apiyi.com に登録して無料のテスト枠を受け取り、同じキーでメインモデルとバックアップモデルを同じ問題で比較してから、リリース時のマッピングを決めることをおすすめします。価格とモデルの利用可否は、コンソールとドキュメントで確認してください。
よくある質問 FAQ
結論:リリース当日の疑問の多くは、「まずエラーの性質を見極め、切り替え、待機、処理の停止のどれを選ぶか決める」ことで整理できます。
Q1:新モデルのリリース日に備えて、アプリ側で事前にレート制限を設けるべきですか?
設けることをおすすめします。上流側の `429` によって受動的に制限されるよりも、アプリ側で事前に最大同時実行数と優先度付きキューを設定するほうが、制御しやすくなります。上流側のレート制限は業務上の優先度を区別しませんが、アプリ側なら優先するユーザーやタスクを決められます。制限のしきい値は、通常時のピーク値に想定される増加倍率を掛けて設定するとよいでしょう。
Q2:429 が発生したら、すぐにモデルを切り替えるべきですか?
必ずしもそうではありません。まず `Retry-After` を確認し、待機時間がタスクの許容範囲内なら、待ってから再試行します。しきい値を超える場合や、レスポンスが利用枠の枯渇を明示している場合は、代替モデルに切り替えます。APIYI apiyi.com で複数社のモデルを1つのキーで呼び出す場合、モデル名を変更するだけで切り替えられます。そのため、しきい値をより細かく設定でき、`429` が発生するたびに全体を切り替える必要はありません。
Q3:緊急性の低いタスクはどのようにキューに入れればよいですか?
緊急性の低いタスクには専用のキューと同時実行枠を用意し、最大待機時間を設定します。タイムアウトしたタスクは破棄せず、夜間やオフピークの時間帯に実行を延期します。キューの長さ、待機時間、離脱率も監視しましょう。失敗したタスクは再試行できますが、冪等でないタスクは必ず先に状態を確認してください。
Q4:自動フォールバックによって出力品質が低下することはありますか?
可能性はあります。そのため、フォールバック前に同じ課題で出力を比較し、品質差が業務上許容できる範囲に収まるようにする必要があります。APIYI apiyi.com の公式説明では自動フォールバックと負荷分散に対応していますが、切り替えルールは公式ドキュメントを確認し、切り替え後の効果の違いは自身の評価セットで検証してください。品質に敏感なタスクでは、すぐにフォールバックするより、キューに入れて主モデルを待つほうがよいでしょう。
Q5:プロダクトの利用枠の使い切りと API のレート制限は、どう見分けますか?
発生元と適用単位を確認します。プロダクトの利用枠は、WorkBuddy における Hy4 の利用枠のように、エンドユーザー向けアプリ内で発生します。アカウント単位で計算され、通常は画面上に通知が表示されます。一方、API のレート制限はインターフェースのレスポンスに `429` として現れ、`Retry-After` を伴う場合もあります。適用単位はキー、組織、またはモデルです。前者はプロダクト内のモデルを切り替えるか、利用枠の回復を待ちます。後者はバックオフ、キューイング、代替モデルへのマッピングで対処します。
複数モデルの切り替えと時間分散スケジューリングの要点
結論:リリース日の安定性は、事前に整えたモデルの階層化、キュー、予算管理で決まります。
- 容量不足は想定内:新モデルのリリース日に利用枠の上限に達するのは、製品リリースに伴う状況の一つです。事前に対策を設計しましょう。
- エラーは分類して対応:
402、429、5xx、タイムアウトにはそれぞれ異なる処理が必要です。一律にリトライしてはいけません。 - 切り替えより先に階層化:フラッグシップ、汎用、軽量の3層にタスクを割り当て、新モデルにはまず一部のトラフィックを流します。
- 代替モデルの対応付けを確認:能力、コンテキスト、ツール呼び出し、構造化出力、価格、地域を一つずつ確認します。
- 非冪等リクエストは一旦停止:失敗後はまず状態を確認し、再送するかどうかを判断します。
- 時間分散でピークを緩和:遅延を許容できるタスクは夜間に回し、日中の同時実行枠は緊急タスクのために確保します。
- 監視は軸ごとに分ける:APIYI apiyi.com の利用ログで、キー別・モデル別の実際の消費量を確認します。
まとめとリリース日の容量チェックリスト
結論:リリース日に重要なのはリトライ回数ではなく、事前に整えたモデルの階層化とキュー管理です。
新モデルの公開直後に利用枠の上限に達する背景には、無料利用枠、アクセスの集中、長時間タスク、上流側の容量拡張の遅れが重なっています。アプリケーション側では、モデルの階層化で通常の振り分け先を決め、代替モデルを用意し、優先度付きキューで重要なタスクを守りましょう。さらに、時間分散スケジューリングでピークを緩和し、監視と予算管理でリスクとコストを把握できる範囲に抑えます。以下のチェックリストは、リリース前とリリース当日の2つに分けており、そのままリリース審査に使えます。
| 段階 | チェック項目 | 完了基準 |
|---|---|---|
| リリース前 | メイン・代替の両方を検証 | メインモデルと代替モデルの両方について、同じ課題での比較、ツール呼び出し、構造化出力の検証を完了している |
| リリース前 | エラーコードを区別 | 402、429、500、503、529、タイムアウトそれぞれに独立した処理を用意している |
| リリース前 | 非冪等リクエストは一旦停止 | 書き込み操作と有料ツール呼び出しの自動リトライを禁止し、失敗後はまず状態を確認する |
| リリース前 | 優先度付きキュー | 優先度を3段階に分け、最大同時実行数、最大待機時間、タイムアウト時の代替処理を設定している |
| リリース前 | 時間分散するタスクの一覧 | 夜間に延期できるバッチ処理タスクを洗い出し、負荷に応じた実行ルールを設定している |
| リリース前 | 訓練 | 障害注入、切り替え、ロールバックの訓練を完了し、結果を記録している |
| リリース日 | 監視 | キー、モデル、タスクごとに 429 率、5xx 率、P95レイテンシ、キューの長さを確認する |
| リリース日 | 予算 | 一時的な予算とアラートを設定し、しきい値を緩和しつつ上限を維持する |
| リリース日 | 切り替えの観察 | 切り替え回数と代替モデルへの切り替え成功率を確認し、メインモデルの復旧後は計画に従って戻す |
| リリース日 | 関係者への通知 | 発生しうる遅延と機能縮退の範囲を、事業部門に事前に知らせる |
次のモデルリリースに備えるなら、APIYI apiyi.com を通じて1つのキーでメインモデルと代替モデルの両方を動作確認し、コンソールの利用ログを基に予算を設定したうえで、このチェックリストを一項目ずつ実行することをおすすめします。
📚 参考資料
まとめ:以下の資料は、モデルの接続方法とプラットフォームの機能を確認するためのものです。具体的なパラメータについては、公式の最新ドキュメントをご確認ください。
- APIYI ドキュメントセンター:モデル一覧、インターフェースの説明、使用量と請求の確認
- リンク:
docs.apiyi.com -
内容: 利用可能なモデル、OpenAI互換インターフェースの使い方、自動フォールバックに関する説明
-
OpenAI API エラーコードの説明:
429などのレート制限エラーの意味と対処方法 - リンク:
platform.openai.com/docs/guides/error-codes -
内容: レート制限と利用枠の枯渇の違い
-
Anthropic API エラーの説明:過負荷によるエラーなどへの対処方法
- リンク:
docs.anthropic.com/en/api/errors - 内容:
529過負荷エラーの意味
著者: APIYI 技術チーム
技術交流: お問い合わせは APIYI のサイトトップページからどうぞ。接続に関する詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください