著者注:モデルアップグレード後、プロンプトとパッチコードは感覚で削除してはいけません。本記事では4種類の分類法と5ステップの回帰フローを用いて、削除すべきもの、修正すべきもの、残すべきものを見極める方法を解説します。
2026年11月、中国メディア36氪の、Claude Codeの主要人物がAnthropicを離れたという報道をきっかけに、多くの開発者が再びAIプログラミングツールについて語り始めました。人物の物語はさておき、多くのチームにとってより現実的な問題は、モデルをアップグレードするたびにプロンプトとパッチコードが増え続ける中で、それらにまだ存在価値があるのか、という点です。本記事では、まず分類し、次に照合し、最後に段階的にロールアウトするというクリーンアップ手法を紹介します。安定性を犠牲にせずに不要なものを削ぎ落とすための方法です。
これは「思い切って全部削除しよう」と勧める記事ではありません。プロンプトには業務ルールが、パッチコードには安全ガードレールが隠れている可能性があり、一度の誤削除のコストは、多少余分にトークンを消費するコストを上回ることが多いからです。また、本記事では汎用的なベンチマークも提示しません。クリーンアップの効果は業務サンプルによって異なるため、最終的には自社のデータで結論を出す必要があります。
核心価値:本記事を読み終えるころには、モデルアップグレード後にどのプロンプトとパッチコードを削除できるかを判断できるようになり、ロールバック可能なプロセスでクリーンアップを完了できるようになります。
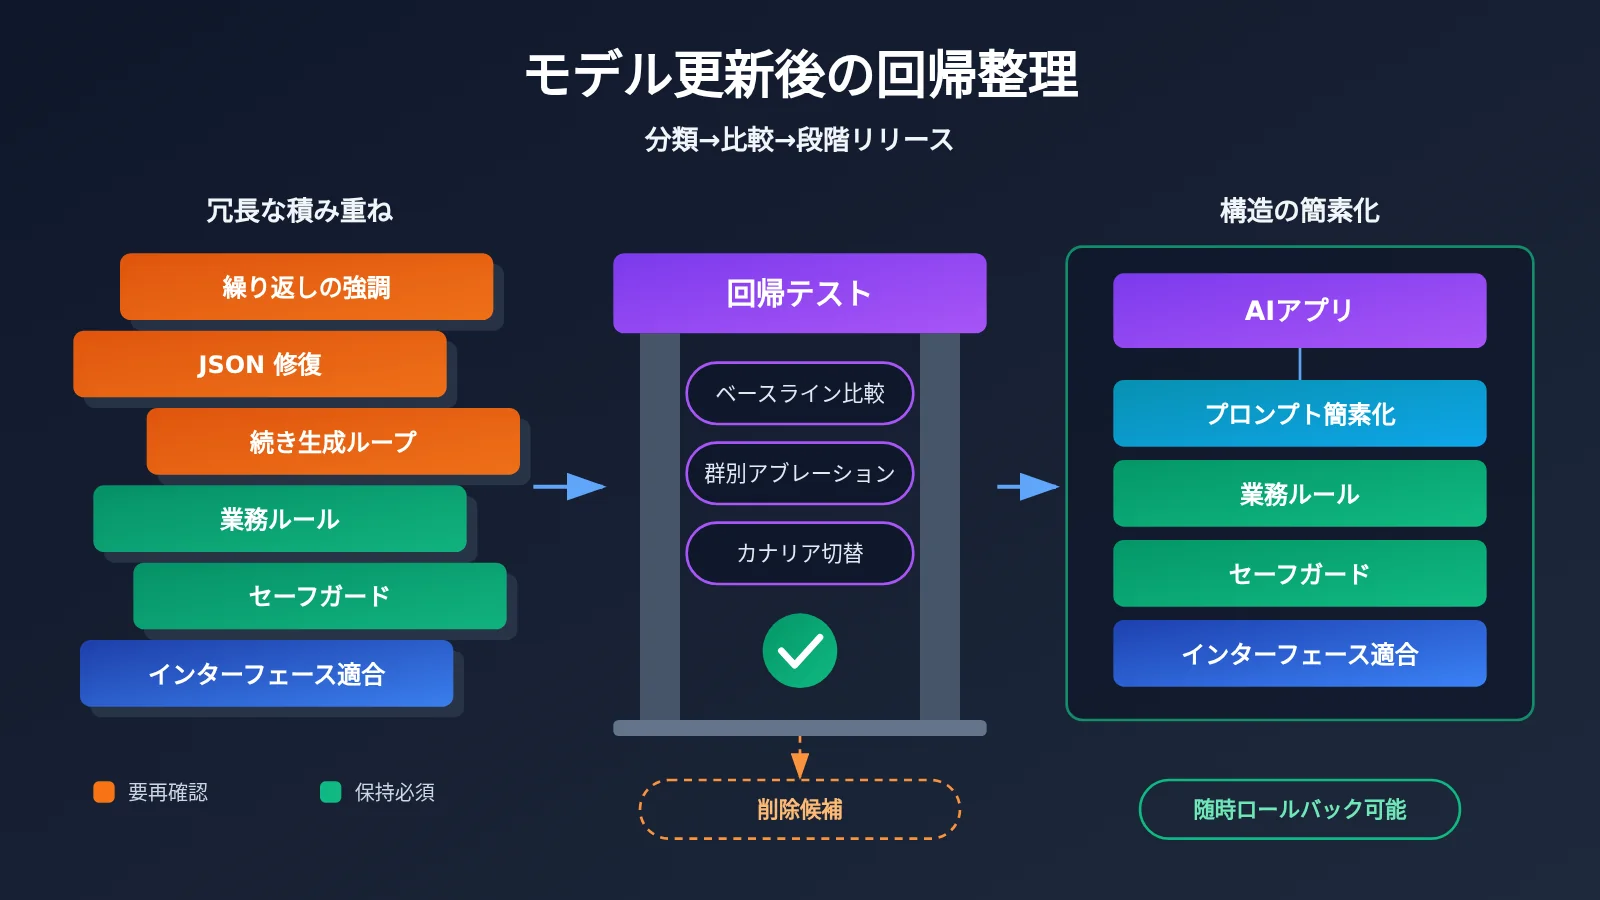
モデルアップグレード後のプロンプトとパッチコード整理の核心ポイント
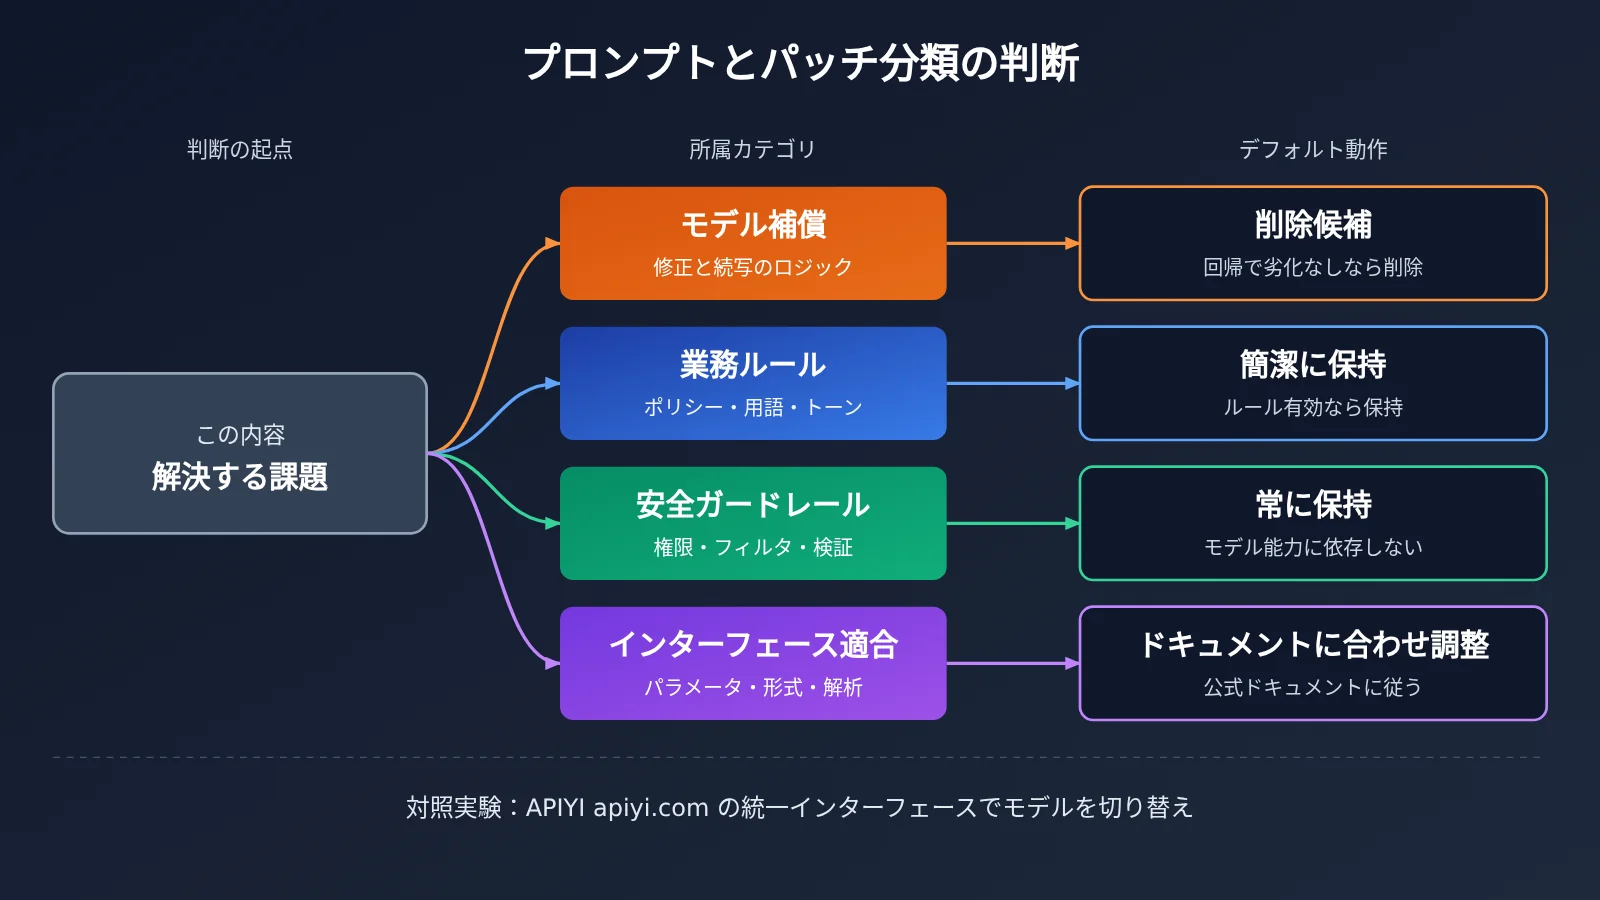
まず覚えておきたい判断原則が1つあります。あるプロンプトやパッチが、旧モデルの不足を補うためのものなら、それは再検討の対象にすべきです。一方、業務ルールを表現したりリスクを制御したりするためのものなら、モデルのアップグレードを理由に削除すべきではありません。 以下の表は、後述するフローの要点を凝縮したものです。
| 要点 | 説明 | 価値 |
|---|---|---|
| まず分類してから手を動かす | モデル補償、業務ルール、セーフティガードレール、インターフェース適応の4種類に分ける | 重要なロジックの誤削除を防ぐ |
| 最初はモデルだけを変えてベースラインを取る | 第1ラウンドではプロンプトもコードも変えない | モデルの変化と整理による変化を切り分ける |
| グループ単位でのアブレーションテスト | 一度に1グループずつ取り除いて結果を比較する | 各項目の役割を正確に特定する |
| 段階的リリースとスイッチ | 整理結果は設定でコントロールし、いつでもロールバックできるようにする | 本番障害のリスクを下げる |
| コストは個別に再確認する | プロンプトが短くなっても総コストが下がるとは限らない | token数だけを見て誤判断するのを防ぐ |
モデルアップグレード後にプロンプトやパッチコードが陳腐化する理由
ほとんどのAIアプリケーションにおけるプロンプトは、本番で発生した問題によって「育てられて」きたものです。モデルがフォーマットを抜かせば、強調する一文を追加する。出力が途中で切れれば、続きを書かせるループを加える。たまにJSONを崩せば、さらに修復関数を足す。こうしたやり方は当時はどれも合理的でしたが、それらが結びついているのは旧モデルの挙動であり、その結びつきが記録されることはほとんどありませんでした。
モデルをアップグレードすると、こうした内容は3つのケースに分かれます。問題がすでに消えており、パッチが無効なコードになるケース。問題が残っていて、パッチが引き続き有効なケース。モデルの挙動が変わり、古い書き方がむしろ副作用を生むケースです。たとえば、かつてモデルの注意を引くために繰り返し使っていた強調文が、指示への反応の仕方が異なる新しいモデルでは、あるルールを過剰に実行させてしまうかもしれません。つまり、アップグレード後の再検討の目的は「短ければ短いほど良い」ではなく、すべての記述に明確な存在理由を持たせることなのです。
プロンプトとパッチコードを4種類に分類する方法
クリーンアップを始める前に、まずシステムプロンプトを段落ごとに分解し、モデル呼び出しの前後に行う処理ロジックも項目ごとに洗い出します。その後、以下の表に従って分類すれば、その後の削除判断に根拠を持たせられます。
| カテゴリ | よくある例 | 既定の対応 | 判断基準 |
|---|---|---|---|
| モデル補償 | 「省略しない」と繰り返し強調する、JSON修復関数、出力切れ時の継続生成ループ | 削除候補とする | 回帰テストで劣化が見られない場合にのみ削除 |
| ビジネスルール | 返金ポリシー、用語集、ブランドトーン、ドメイン制約 | 保持し、表現を簡潔にする | ルールが依然として有効なら保持 |
| セーフガード | 権限チェック、機密情報フィルタリング、出力検証、インジェクション対策 | 常に保持 | モデル能力を前提としない |
| インターフェース適合 | パラメータマッピング、ツール呼び出し形式の変換、レスポンス解析 | 新しいモデルに合わせて調整 | 公式インターフェースドキュメントに従う |
ここで補足しておきたい点が一つあります。修復ロジックは削除を検討できますが、検証ロジックは削除できません。新しいモデルの構造化出力がより安定しているなら、正規表現でJSONを修復するコードは不要にできるかもしれません。しかし、スキーマ検証は引き続き保持すべきです。同様に、出力切れに対応する継続生成ループは再検討できますが、ネットワークエラーやレート制限に対するリトライはモデル能力とは無関係であり、クリーンアップの対象に含めるべきではありません。
モデルアップグレード後のプロンプトとパッチコード整理をすぐに始める
以下の5ステップの流れは、複雑なプラットフォームを必要としません。既存のテストフレームワークと表でも実行できます。ポイントは、一度に1つの変数だけを変更し、各決定を記録することです。
ステップ1:プロンプトとパッチコードの出所を洗い出す
git log と git blame を使って、各内容がいつ導入されたか、どの問題に関連していたかを追跡し、チェックリストに4つの情報を記録します。内容の位置、カテゴリ、対象となる問題、検証方法です。あるプロンプトの出所を誰も説明できなくなっている場合は、「検証待ち」とマークし、すぐに無用と判断しないでください。
ステップ2:モデルアップグレードの回帰サンプルセットを構築する
回帰セットには、オンライン上の実際の通常リクエスト、過去にインシデントを引き起こした失敗サンプル、ビジネスの境界シナリオという3つの部分を含めることをおすすめします。サンプルの規模はリスクに応じて決めればよく、小規模なチームであれば数十件の価値の高いサンプルから始めても十分に意味があります。モデルの出力には不確実性があるため、重要なサンプルは複数回繰り返し実行し、偶発的な通過を安定した通過と誤って判断しないようにしましょう。
ステップ3:モデルだけを差し替え、対照ベースラインを確立する
最初のラウンドではモデル名だけを変更し、プロンプトとコードはそのままにし、temperature などの制御可能なパラメータを固定します。これにより「旧モデル + 旧構成」と「新モデル + 旧構成」の差分を把握でき、APIパラメータやレスポンス構造の変化も事前に発見できます。プラットフォームがバージョン固定のモデル名に対応している場合は、固定バージョンを優先して使用し、テスト期間中にモデルが変化して結果が乱れるのを防ぎましょう。
次の表は、対照実験に接続する際に確認が必要な設定項目をまとめたものです。
| 設定項目 | 記入方法 | 注意事項 |
|---|---|---|
base_url |
APIYI ドキュメントに記載された対応インターフェースのアドレスを使用 | OpenAI と Anthropic 形式のアドレスやパスはドキュメントに従う |
api_key |
コンソールで作成したキーを使用 | 環境変数で管理し、リポジトリには書き込まない |
model |
料金ページまたはドキュメントのモデル名を記入 | 新旧の実験グループはモデル名以外を一致させる |
temperature |
すべての実験グループで同じ値を使用 | 一部のモデルはパラメータの範囲が異なる場合があるため、ドキュメントを確認する |
max_tokens |
新旧モデルに十分な余裕を設定 | 切り捨てをモデル品質の問題と誤判定しないようにする |
🚀 クイックスタートのヒント:対照実験で最も時間がかかるのは、複数のインターフェースへの適応であることが少なくありません。APIYI は本記事で扱う Claude、GPT などのモデルの API 呼び出しを提供しており、OpenAI と Anthropic のインターフェース形式に互換性があります。通常は
base_url、api_key、modelを調整するだけでテストを開始できます。接続方法については APIYI ドキュメントを参照してください:https://docs.apiyi.com
ステップ4:プロンプトとパッチコードのグループ単位アブレーション
ベースラインが安定したら、モデル補償のカテゴリから順にグループごとに削除していきます。各グループには、同じ問題を解決する内容だけを含めます。たとえば、まず「フォーマット強調」に関するプロンプトとその修正関数を削除し、リグレッションを実行し終えてから次のグループに取り掛かります。一度に削除しすぎると、結果が悪化したときに原因を特定しにくくなり、最終的には全体をロールバックするしかなくなってしまいます。
| 指標 | 観察する内容 | 判断の参考 |
|---|---|---|
| 重要サンプルの合格率 | 過去の障害や高リスクなシナリオを通過できるか | 劣化が出たらそのグループの内容を復元する |
| 全体タスクの合格率 | 通常リクエストの品質変化 | チームが事前に設定したしきい値で判断する |
| パッチ発動率 | 修正や続き生成ロジックが実際に発動した回数 | 長期的にゼロに近ければ削除の根拠にできる |
| トークンとレイテンシ | 入力・出力の使用量と応答時間 | クリーンアップによる実際の効果を評価する |
| 人的介入率 | 人への引き継ぎやユーザーの手戻りの割合 | リリース後も継続的に観察し、オフラインサンプルの盲点を補う |
判断基準はテストを実行する前に書き留めておきましょう。そうしないと、チームは結果を見てから基準をその場で調整しがちです。パッチコードについては、まず記録だけして介入しないという方法もあります。そのまま動かし続けながら「これがなければ何が起きるか」を報告し、数日後に発動データをもとに削除するかどうかを決めるのです。これは特に高リスクな業務で有効です。
ステップ5:段階的にリリースし、ロールバックできる状態を保つ
整理後のバージョンは、設定スイッチ経由でリリースするのがおすすめです。まずは少量のトラフィックに適用し、指標が安定していることを確認してから対象を広げます。削除記録には根拠を明確に残しましょう。たとえば「あるバージョンのモデル回帰テストに合格し、パッチの発動率が継続的にほぼゼロである」といった内容です。こうしておけば、次回のアップグレード時にその判断をそのまま再利用できます。
特に確認したいのがモデルのフォールバック経路です。メインモデルが使えないときに旧モデルへフォールバックする場合、旧モデル向けに書いたパッチが依然として必要なことがあります。より安全な方法は、プロンプトを2層に分けることです。業務ルールと安全要件は基礎層に置き、モデルに関連する内容はモデル適応層に置きます。そしてルーティング設定で、モデルごとに読み込むようにします。
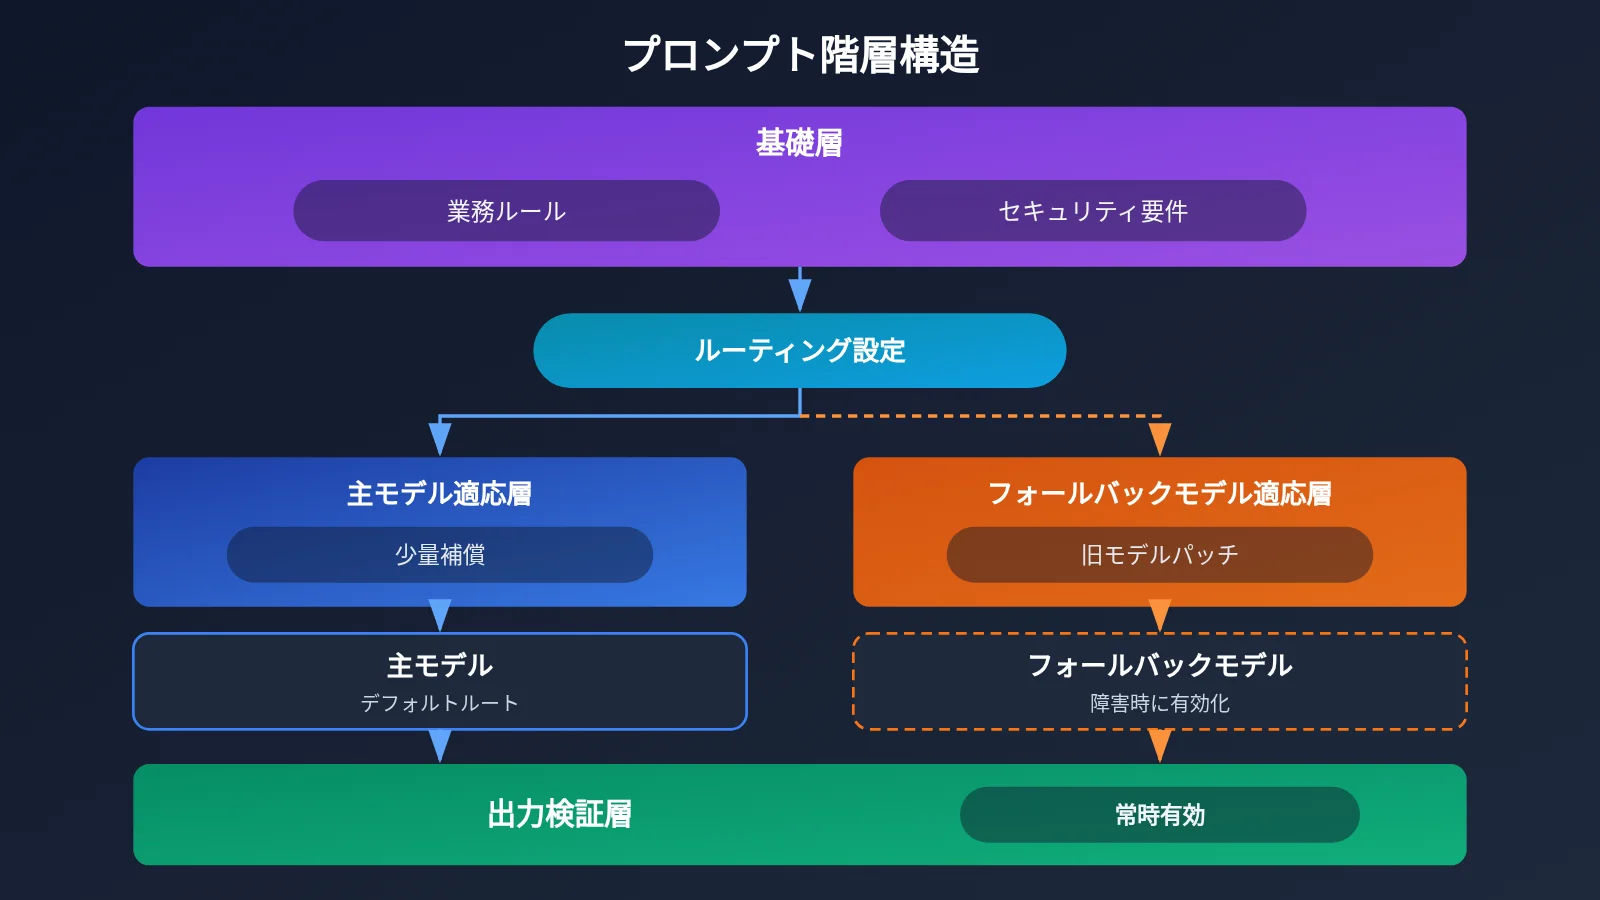
モデルアップグレード後のプロンプトとパッチコードに対する3つの処理方針の比較
整理には「すべて削除」と「そのまま」の二択しかないわけではありません。以下の表では、よく使われる3つの戦略を比較しています。業務リスクとチームの投入量に応じて選んでください。
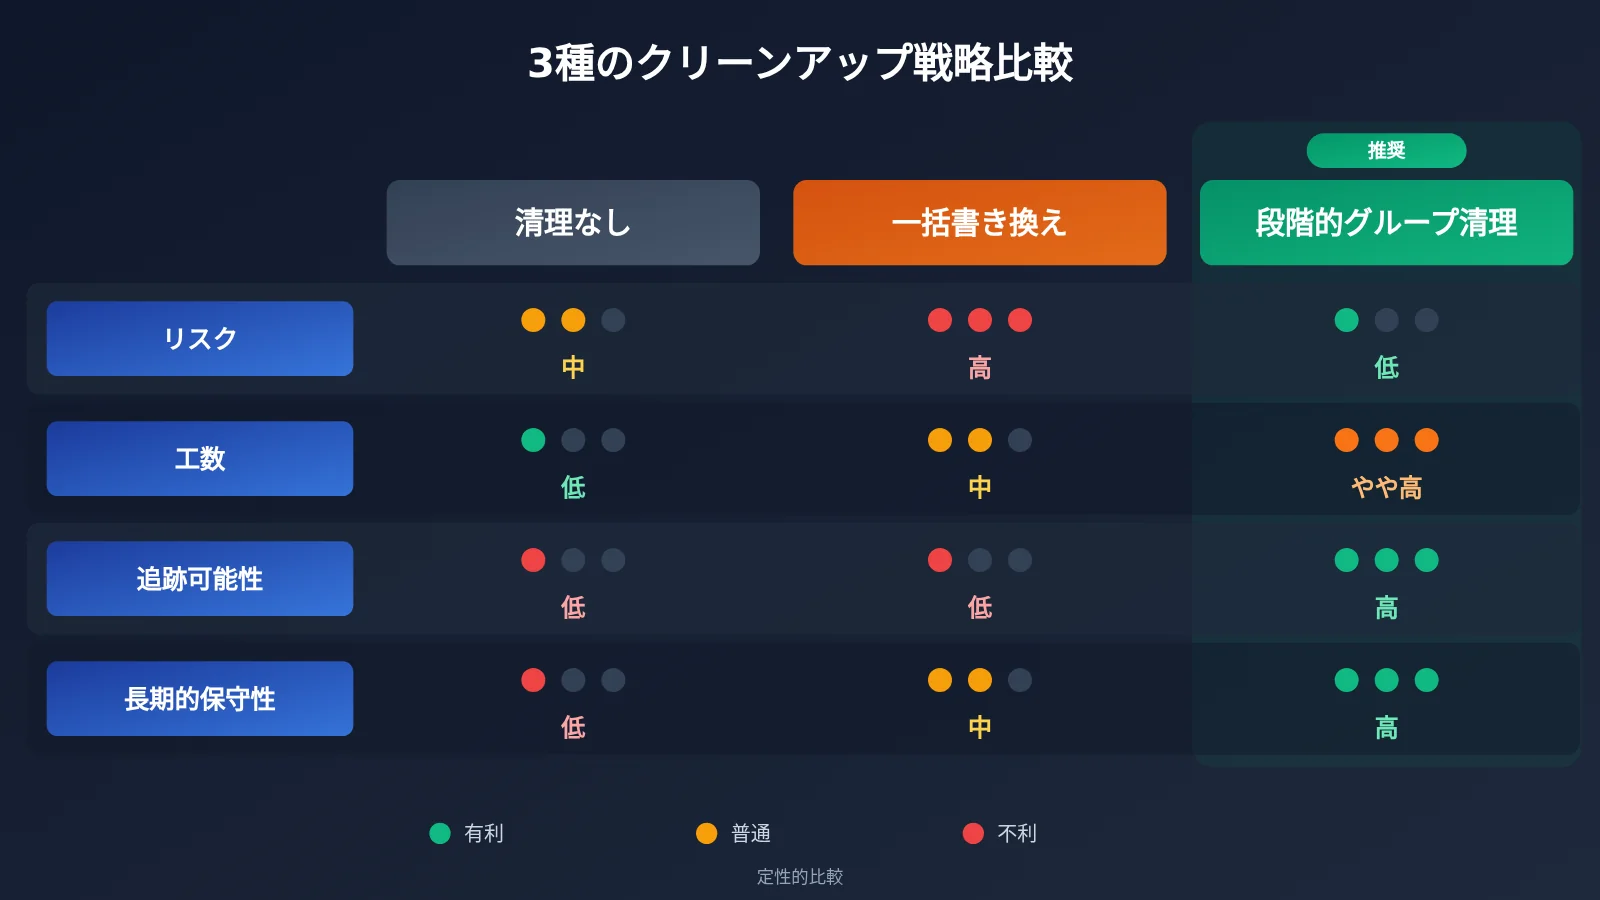
| 方針 | 進め方 | 主なリスク | 向いている場面 |
|---|---|---|---|
| そのまま保持 | モデル名だけ切り替え、その他の内容は変更しない | 無効な内容が蓄積し続け、新しいモデルの能力を引き出しにくい | 一時的なアップグレード、または短期的にテストリソースがない場合 |
| 一括書き換え | 新しいモデルのプロンプトガイドに沿ってゼロから作成 | 暗黙の業務ルールが失われる可能性がある | プロンプトの規模が小さい、または業務を再構築中の場合 |
| グループ単位の段階的整理 | 分類後にグループごとにアブレーションを行い、段階的にリリース | 回帰テストセットの整備に時間を要する | 本番環境や、長期的に保守する多くのアプリケーション |
そのまま保持の比較分析:この方針はリリース速度の面で優位に立てますが、旧プロンプトの副作用や保守負担が自然に消えるわけではありません。それに比べると、グループ単位の段階的整理は、長期的に反復改善する本番システムに向いています。
一括書き換えの比較分析:この方針はプロンプト構造の簡潔さに優れますが、過去のパッチに埋もれた業務ノウハウを見落としやすいです。どうしても書き換える場合は、同じ回帰テストセットで検証し、旧バージョンの業務ルールを1つずつ確認することをおすすめします。
モデルアップグレード後のプロンプトとパッチコード整理のコスト試算
プロンプトが短くなっても、総コストが下がるとは限りません。1回の呼び出しコストは「入力トークン × 入力単価 + 出力トークン × 出力単価」で概算できます。キャッシュを使う場合は、キャッシュの読み書きで課金が分かれる点も考慮し、リトライやフォールバックによる追加呼び出しも含めて計算してください。新しいモデルでは出力が長くなる可能性があり、プロンプトのプレフィックスを変更するとキャッシュヒットに影響することもあります。そのため、実験で得た実際の使用量に基づいて再確認しましょう。
💰 料金体系の注意:本記事では具体的な単価を掲載しません。モデル価格、課金体系、入力・出力単価、キャッシュ価格については、APIYIの価格ページ https://docs.apiyi.com/models の実際のデータを参照し、試算時には確認日を記録してください。
よくある質問(FAQ)
Q1:プロンプトとパッチコードにおける「モデル補償」とは何ですか?
モデル補償とは、特定のモデルの弱点を回避するために追加された内容のことです。たとえば、出力形式を繰り返し強調する、壊れたJSONを修復する、途中で切れた結果をつなぎ合わせる、といったものが該当します。ビジネスルールとの違いは、より能力の高いモデルに切り替えた場合に不要になる可能性があるという点です。
Q2:モデルをアップグレードしたら、プロンプトとパッチコードはすべて削除して書き直すべきですか?
通常はおすすめしません。すべて書き直すとすっきりしますが、暗黙のビジネスルールや過去の事故から得た経験が失われやすくなります。本番システムでは、グループごとに段階的に整理していくほうが適しています。プロンプトの規模が非常に小さい場合や、業務そのものを再構築している最中であれば書き直しも選択肢になりますが、その場合でも回帰テストセットによる検証は必要です。
Q3:プロンプトとパッチコードの整理に適したタイミングはいつですか?
最適なタイミングは、モデル切り替えの評価期間です。この時期はもともと回帰テストを実施するからです。また、パッチの発動率が長期間ほぼゼロになっている場合や、プロンプトが多くなりすぎて誰も手を入れられなくなった場合にも、専用の整理作業を一度計画するとよいでしょう。ただし、大規模なキャンペーンや業務のピーク前に集中的に整理するのは避けてください。
Q4:モデルアップグレードを理由に、絶対に削除してはいけないプロンプトやパッチコードはどれですか?
権限チェック、機密情報のフィルタリング、出力スキーマの検証、プロンプトインジェクション対策、監査ログといったものは常に残すべきです。これらはシステムのリスクを制御するためのものであり、モデルが「高い確率でうまく動作する」ことに依存すべきではありません。ネットワークエラーやレート制限のリトライ処理も基盤的な仕組みであり、同様に整理の対象には含めるべきではありません。
Q5:APIを使って新旧モデルを素早く比較するにはどうすればよいですか?
回帰テストセットを用意したら、新旧の実験グループに同じプロンプトとパラメータを使わせ、モデル名だけを変えます。APIYIを使えば、OpenAIやAnthropic互換のインターフェース形式でさまざまなモデルを呼び出せるため、同じテストスクリプト内で切り替えられます。具体的な設定についてはドキュメントを参照してください:https://docs.apiyi.com
Q6:整理後に本当にコストを削減できたかは、どう判断しますか?
整理前後で入力トークン、出力トークン、キャッシュヒット、リトライ回数をそれぞれ集計し、現在の単価を掛けます。単価とキャッシュの課金については、APIYIの価格ページを確認してください:https://docs.apiyi.com/models 。1回の呼び出しコストを比較すると同時に、1件の成功タスクあたりのコストも見てください。後者のほうが実際の業務コストに近い指標です。
Q7:この整理プロセスにはどのような制約がありますか?
回帰テストセットは既知の問題しかカバーできません。テストに通ったからといって、本番で新しい事態が起きないとは限らないため、カナリアリリースと監視は省略できません。また、このプロセスには人手の投入が必要で、頻度の低い内部ツールやリスクの低いツールにそのまま当てはめる必要はありません。サンプルが少ないと指標が大きく変動することがあるため、それに基づいて細かすぎる判断をするのは適切ではありません。
モデルアップグレード後のプロンプトとパッチコード整理:要点
- 判断基準:その内容が旧モデルを補っているのか、それとも業務ルールやリスク管理を表現しているのかを見極めます。
- 4分類:モデル補償、業務ルール、セーフティガードレール、インターフェース適応に分け、それぞれ異なる対応を取ります。
- ベースライン優先:最初のラウンドではモデルの差し替えだけを行い、プロンプトとパッチコードは同時に変更しません。
- 段階的アブレーション:一度に削除するのは1グループの関連内容だけにします。そうすれば、性能が劣化したときに原因を正確に特定できます。
- 検証は維持:JSON修復ロジックは見直してかまいませんが、Schema検証と権限チェックは残すべきです。
- フォールバック確認:パッチを削除する前に、ロールバック経路にある旧モデルがまだそれに依存していないかを確認します。
- 比較ツール:APIYI の互換インターフェースを使えば、同じスクリプトでモデルを切り替えてリグレッションを実行できます。
まとめ
モデルアップグレード後にプロンプトやパッチコードを削除すべきかどうかは、新しいモデルの宣伝文句ではなく、あなたの手元のリグレッションデータで決まります。整理作業は次の3点にまとめられます。
- まず出所を明らかにする:各内容がどんな問題を解決しているのかを説明したうえで、4分類に沿って整理します。
- 実験で判断する:ベースラインを確立し、グループごとにアブレーションを行い、あらかじめ決めておいた指標で残すかどうかを判断します。
- 変更をロールバック可能にする:スイッチを使った段階的リリースで公開し、モデル関連の内容と業務ルールを階層に分けて管理します。
まずは呼び出し量が適度でリスクを制御しやすいシナリオから始め、フロー全体を一度通してから基幹業務へ広げていくことをおすすめします。複数のモデルを比較したい場合は、APIYI 経由で本記事で扱ったモデルを呼び出せます。接続方法は https://docs.apiyi.com を、料金は価格ページ https://docs.apiyi.com/models の実際のデータを参照してください。
📚 参考資料
- 36氪 – プリンストン大学CS専攻の才女、突然Anthropicを離れ、Claude Codeを一躍人気に:冒頭の時事背景の出典
- リンク:
36kr.com/p/4055331476526214 -
説明:2026年11月4日に公開。本記事のクリーンアップ手法は汎用的なエンジニアリング実践のまとめであり、当該報道内容の転載ではありません。
-
APIYI ドキュメント:インターフェース形式と接続設定の説明
- リンク:
docs.apiyi.com -
説明:
base_url、エンドポイントパス、呼び出し方法の確認に使用。 -
APIYI モデルと価格ページ:モデル一覧および課金情報
- リンク:
docs.apiyi.com/models -
説明:本記事で扱うモデル価格、課金基準、キャッシュ価格は、すべてこのページの実際のデータに準拠します。
-
Anthropic 公式ドキュメント:Claude モデルとプロンプトガイド
- リンク:
docs.anthropic.com -
説明:Claude モデルをアップグレードする際に、インターフェースの変更点とプロンプトの推奨事項を確認できます。
-
OpenAI 公式ドキュメント:GPT モデルと API ガイド
- リンク:
platform.openai.com/docs - 説明:GPT モデルをアップグレードする際に、パラメータの変更点と移行ガイドを確認できます。
著者:APIYI 技術チーム
技術交流:APIYI ウェブサイトのトップページからお気軽にお問い合わせください。詳細な資料は docs.apiyi.com ドキュメントセンターをご覧ください。