著者注:本記事は YC Paper Club Harness Night での公開共有に基づき、実践可能なモデル評価手法を整理したものです。チームがスコア差の原因がモデルにあるのか Harness にあるのかを見分けられるようにすることを目的としています。
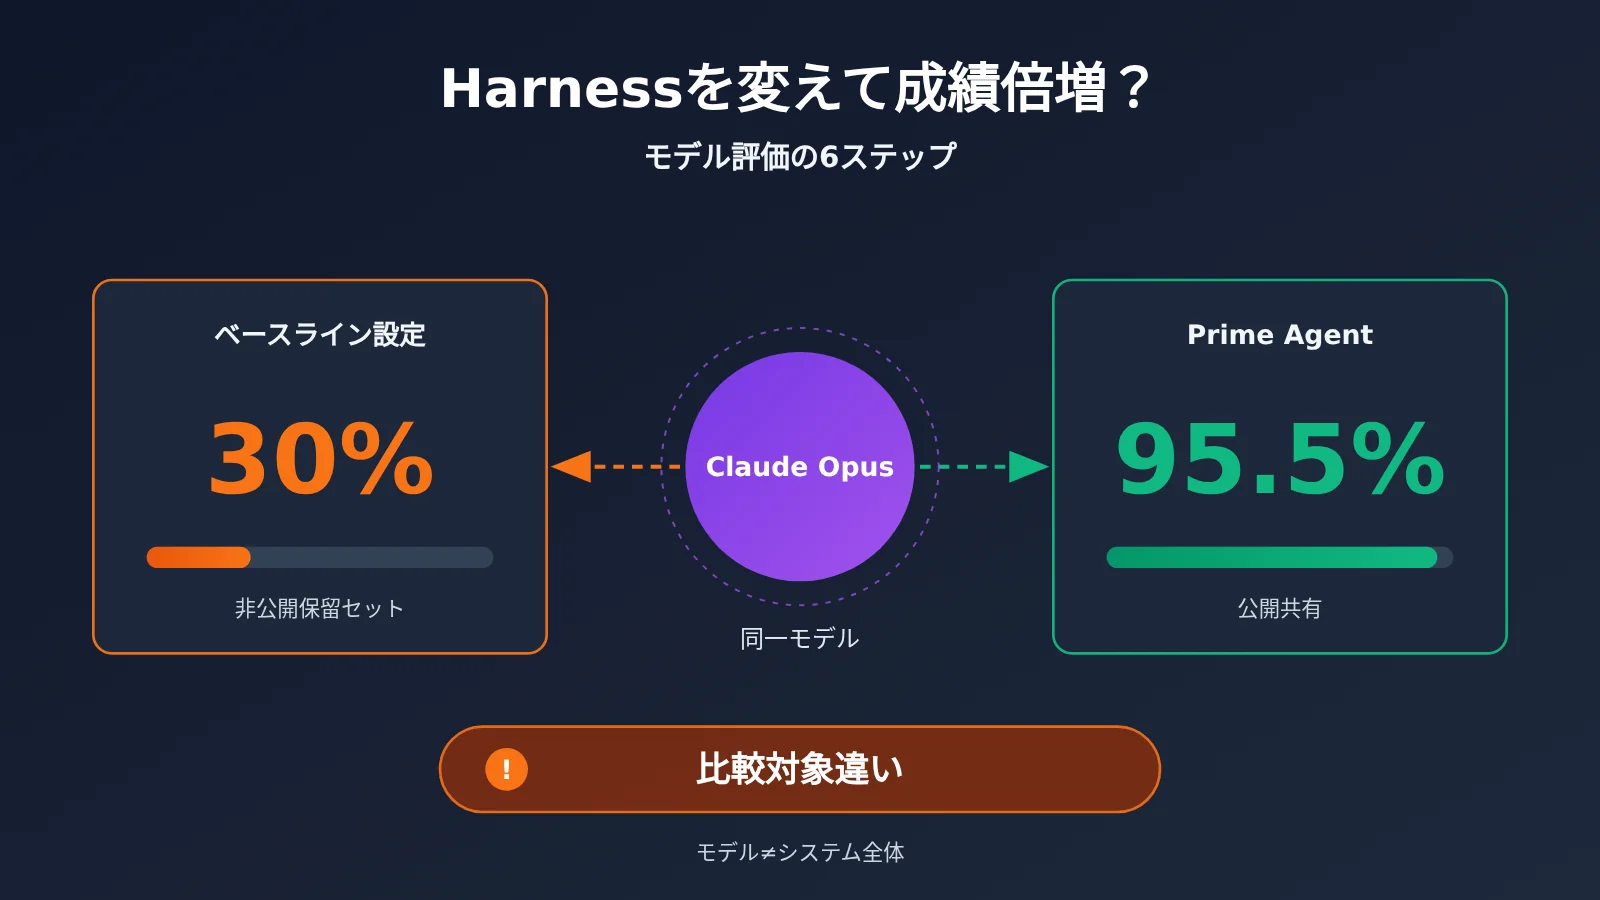
同じ Claude Opus でも、プライベートなホールドアウトセットでの最高成績は 30%。それが Prime Agent に組み込むと、公開共有で示された成績は 95.5% になります。リーダーボードだけを見れば、モデルが質的に進化したと考えるかもしれません。しかしこの数字がまず教えてくれるのは、モデル評価とは往々にしてシステム全体を比較しているのであって、モデル単体を比べているわけではないということです。
これはリーダーボードを捨てるよう勧める記事ではありません。また、Harness がどんなモデルでも無限にスコアを伸ばせるなどと主張するものでもありません。本記事では独自の再検証は行っておらず、引用した成績はすべて InfoQ がまとめた講演内容に基づくものです。重点は、そこから得られた経験を実行可能な評価プロセスに落とし込むことにあります。
コアバリュー:本記事を読み終えると、6つのステップでモデルと Harness の対照実験を設計し、スコア差がどこから来ているのかを判断し、より信頼できる選定結論を導けるようになります。
Harness を変えるとスコアが倍に:モデル評価の核心ポイント
Harness は LLM と外部世界の間にあるシステム層で、永続的な状態、ツール、計算能力を提供します。Seth Karten は次のようなアナロジーを使いました。素の LLM はチューリングマシンのようなもので、Harness は外部メモリを読み書きできるフォン・ノイマン型コンピュータのようなものです。Agent を評価するとき、モデルの推論能力とこのシステム層の表現力が同時に結果へ影響します。
以下の表は、共有された内容のうち ARC-AGI に関連する一部の公開データをまとめたものです。これらのスコアは異なるモデル、Harness、評価設定から得られたものであり、モデルのランキングとして直接使うことはできません。
| 構成 | 公開スコア | 読む際の注意点 |
|---|---|---|
| Claude Opus、非公開ホールドアウトセットでの検証 | 最高スコア 30% | これは共有内容におけるベースラインであり、すべての実行条件を代表するものではない |
| Prime Agent + Opus | 95.5% | 資料ではベースラインとの差異のすべてが項目別に開示されているわけではなく、単一の変数だけに帰属させるべきではない |
| Prime Agent + GPT-5.6 Sol | 78% | これはサンドボックス分離を完了した後のスコア |
| Prime Agent + GPT-5.6 Terra | 25.7% | 同じ Harness の下でも、モデルによる差は依然として顕著 |
| Nvidia AVO | 100% | 共有内容では結果のみが示されており、比較の前には具体的な構成を確認する必要がある |
Harness とモデル評価の関係
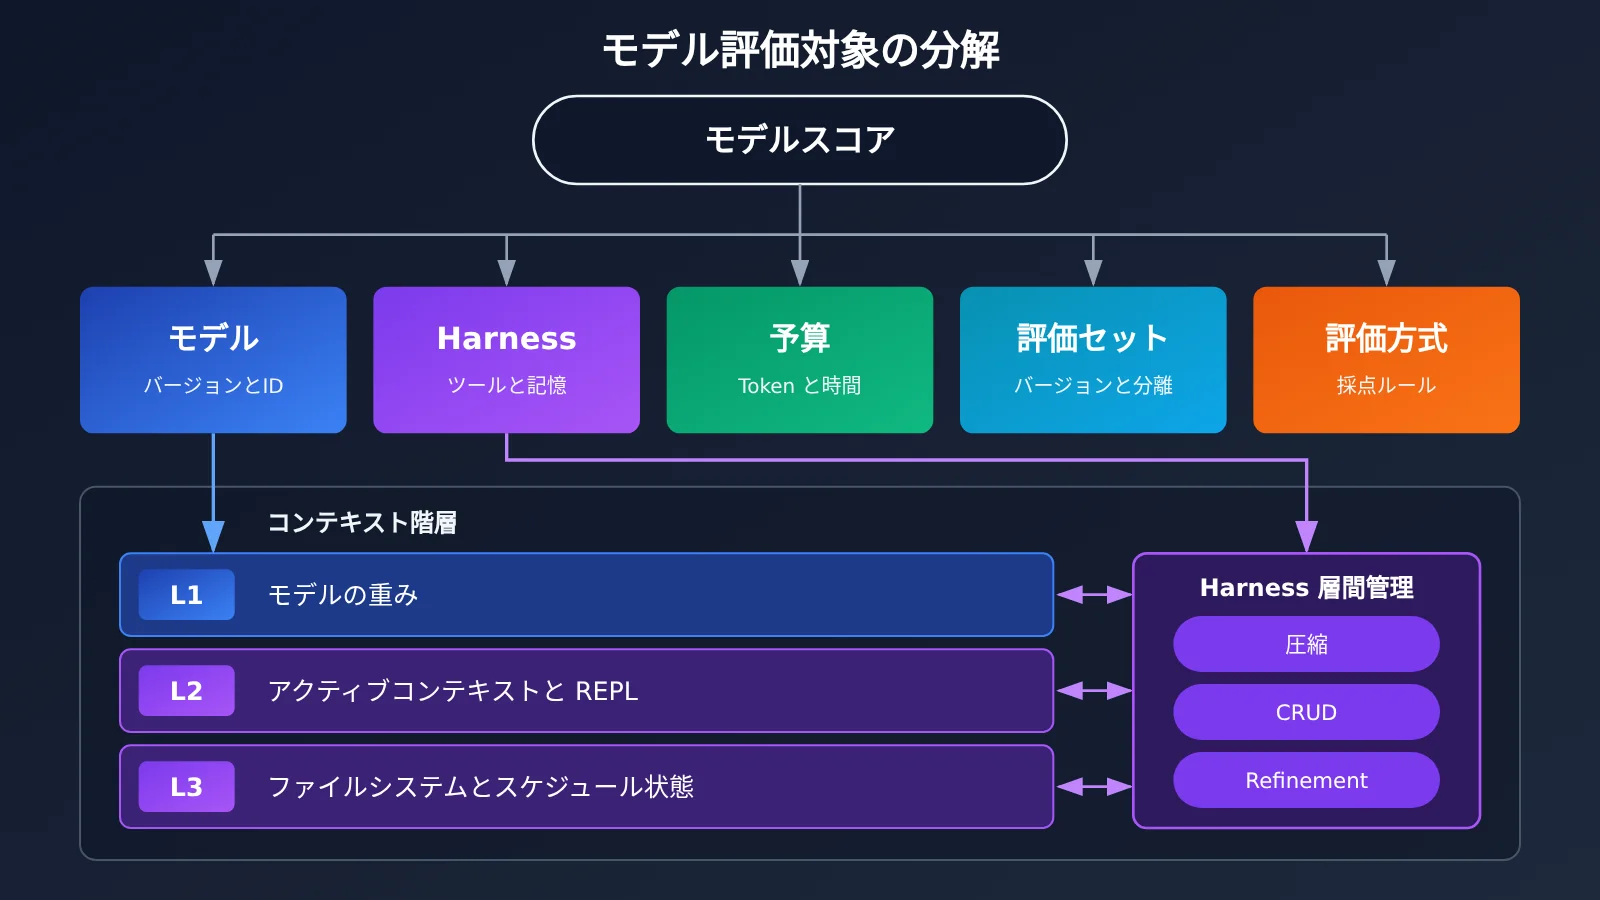
Prime Agent はコンテキストを 3 つの層に分けています。L1 はモデルの重み、L2 はアクティブなコンテキストと REPL、L3 はファイルシステムのようなスケジューリング状態です。Harness は層と層の間で圧縮、CRUD(作成・読み取り・更新・削除)、リファインメントを行い、その役割はキャッシュとガベージコレクションに近いものです。つまり、同じモデルでも Harness を入れ替えれば、使える記憶と計算能力が変わる可能性があります。
ただし、これはモデルが重要でないという意味ではありません。Prime Agent は ARC-AGI で際立った成績を示す一方、Oolong や Emulator Bench などの長周期評価では主に同等かわずかに良い程度にとどまり、GPU カーネルタスクもほぼ同等です。タスクの種類によって、Harness がどれだけ差を拡大できるかが決まるため、ある一つのスコアをすべてのシナリオに外挿することはできません。
モデル評価で最も間違えやすい 5 つの変数
| 変数 | よくある誤った比較 | 記録すべきこと |
|---|---|---|
| モデル | シリーズ名だけを書き、具体的なバージョンを書かない | モデル ID、実際の呼び出し記録、フォールバックや切り替えの状況 |
| Harness | デフォルト設定をモデルの能力とみなす | ツール、システムプロンプト、サブ Agent、記憶と圧縮の仕組み |
| 予算 | A はプラトーまで実行し、B は途中で停止する | Token、実際の時間、費用、早期停止の条件 |
| 評価セット | 公開セットのスコアと非公開セットのスコアを比較する | データセットのバージョン、分離方法、情報リークの有無 |
| 評価方法 | LLM に修正や回答が成功したかどうかだけを判断させる | 採点ルール、人手による抜き取り検査の割合、意見が分かれるサンプル |
実践的な提案:同じ評価プロセスの中で複数のモデルを比較したい場合は、APIYI apiyi.com を通じて本記事で扱うモデルを呼び出すことで、接続の差異を減らせます。APIYI は OpenAI と Anthropic のインターフェース形式に対応しており、具体的なモデル名や接続方法は docs.apiyi.com のドキュメントを参照してください。
Harness モデル評価クイックスタート:6つのステップ
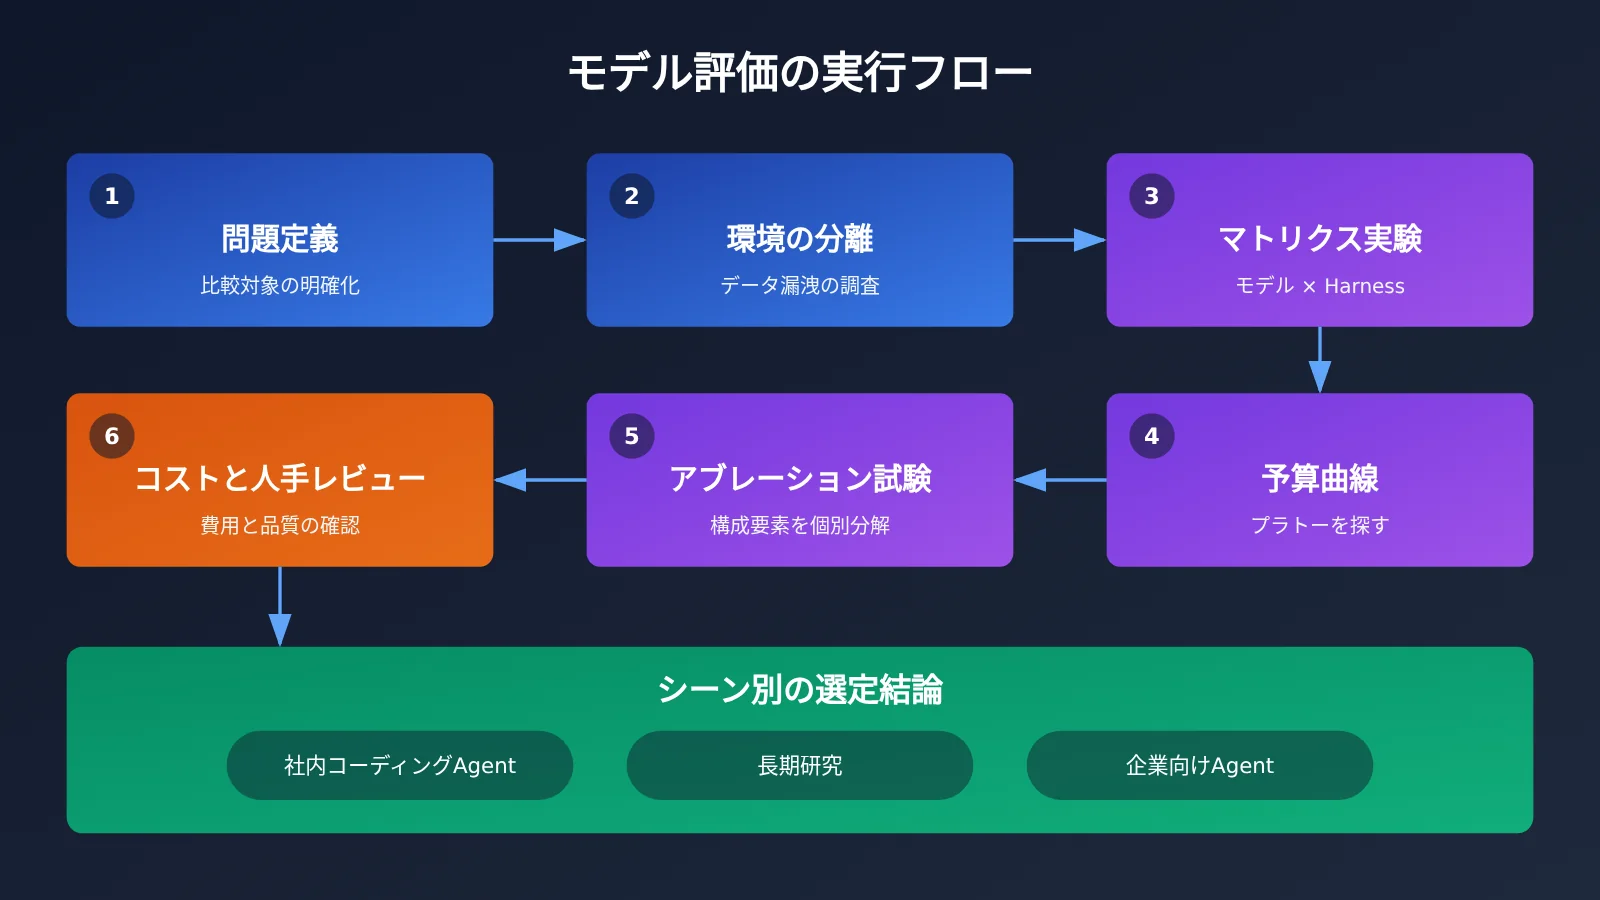
以下の手順は、モデル選定、Agentのアップグレード、社内ベンチマークテストに適しています。最初から大規模な評価プラットフォームを構築する必要はありません。まず変数を漏れなく記録し、その後でタスクとモデルを段階的に増やしていきましょう。
ステップ1:モデル評価の比較対象を明確にする
まず1文で実験の問いを定義します。たとえば「同じHarnessと予算の下で、2つのモデルが社内のコーディングタスクを完了する能力を比較する」といった具合です。もし問いを「どのAgentが優れているか」と書いてしまうと、比較対象はモデルとHarnessの組み合わせになり、結論も「どのモデルが強いか」と書くことはできません。
評価仕様では、少なくとも model、システムプロンプト、ツールリスト、max_tokens、最大ターン数、総予算を固定する必要があります。HarnessがAgentにランタイムの自主選択を許可している場合は、各ステップで実際に使われたモデルも記録しましょう。QMの設計では、Agentが拒否に遭遇したときに別のモデルへ切り替えることが許されています。この場合、最終スコアはもはや単一のモデルに帰属するものではありません。
ステップ2:Harness の評価環境とデータを分離する
Seth はかつて、コミュニティリーダーボードのシステムプロンプトを Prime Agent に入れて実行し、最初の実行で 99.9% という結果を得ました。ログを確認して自分がカンニングしていたことに気づき、その後1日かけてサンドボックス分離を行ったところ、GPT-5.6 Sol のスコアは 78% になりました。高スコアが必ずしも間違いとは限りませんが、異常に高いスコアはまずログを確認すべきです。
チェック時には3つのポイントに注目します。Agent が答えや過去の結果を読めてしまわないか、プロンプトに評価セット固有の情報が含まれていないか、ツール呼び出しが想定された権限を超えていないか、です。公開ベンチマーク以外のタスクでは、チューニングに使わないホールドアウトサンプルを1セット確保しておき、プロンプトと Harness の過学習を防ぐ必要があります。
ステップ3:「モデル × Harness」マトリクスで比較する
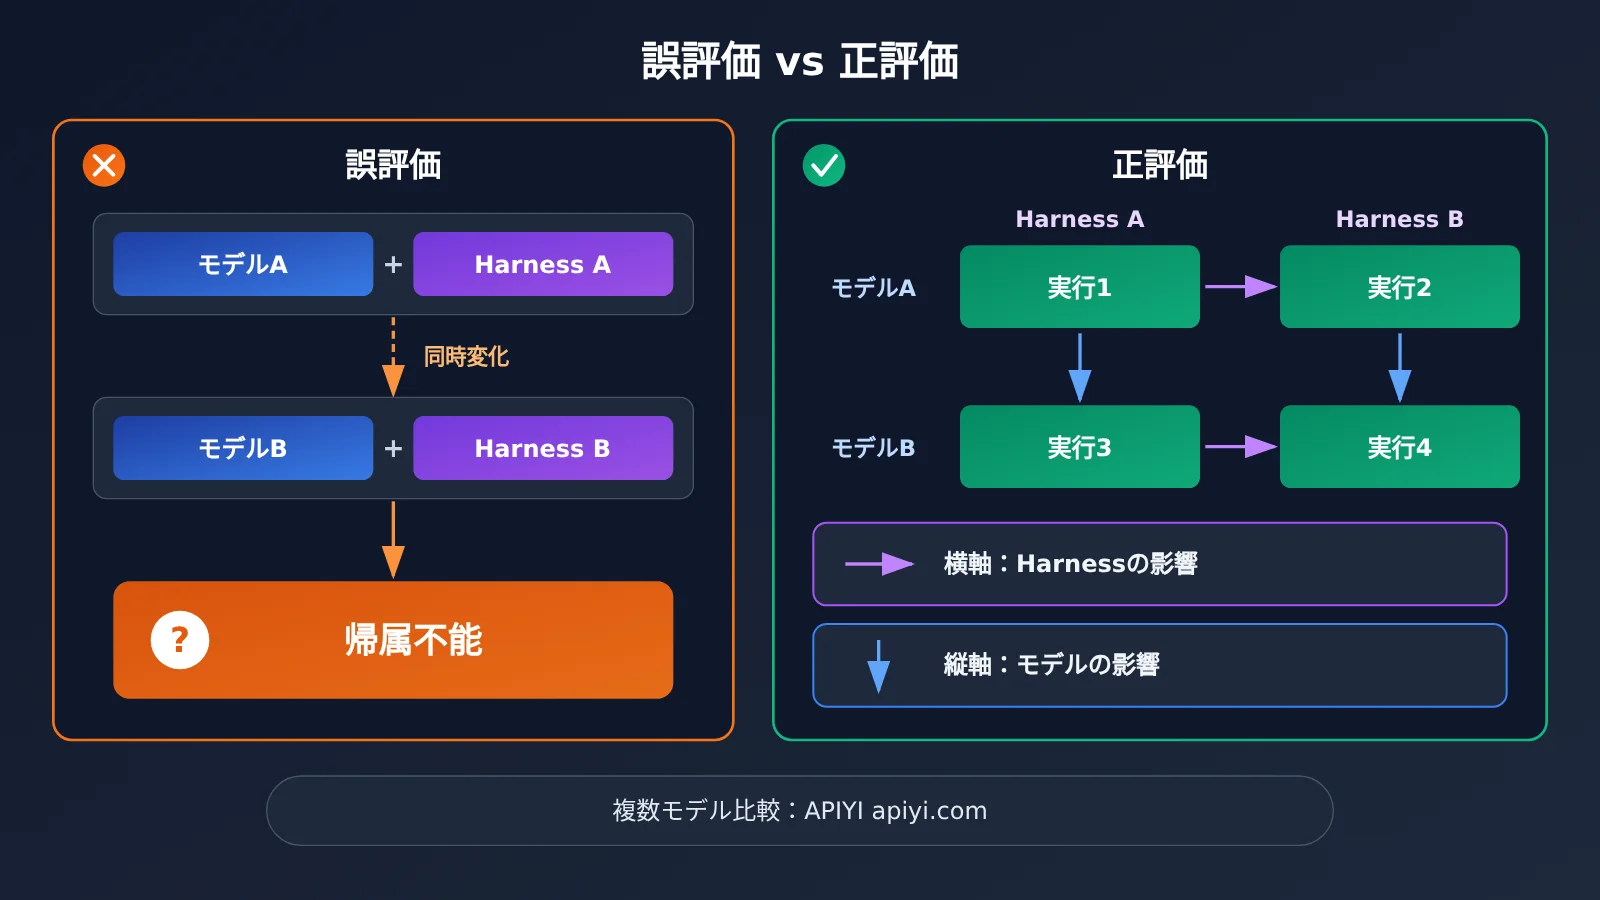
「モデル A + Harness A」と「モデル B + Harness B」だけを実行するのは避けてください。2つの変数が同時に変わってしまうと、原因を特定できないからです。最小構成は 2 × 2 マトリクスで、2つのモデルをそれぞれ2種類の Harness で実行し、タスクセットと予算を揃えます。
| マトリクスの結果 | より可能性の高い解釈 | 次のアクション |
|---|---|---|
| モデルを替えると大きく変わり、Harness を替えても変化が小さい | 現在のタスクはモデル能力への依存が強い | モデル選定を優先する |
| Harness を替えると大きく変わり、モデルを替えても変化が小さい | システム能力が主なボトルネック | ツールとコンテキスト管理の改善を優先する |
| 両者の交互作用が明らか | モデルと Harness に適合関係がある | 組み合わせ単位で選定し、単一のランキングは書かない |
| どちらも明確に変化しない | タスクが簡単すぎる/難しすぎる、または採点が敏感でない | 評価セットと指標を再設計する |
対照実験のヒント:マトリクス実験ではモデルを頻繁に切り替える必要があります。APIYI apiyi.com を使えば、統一されたアカウントとインターフェース設定でさまざまなモデルを呼び出せます。実験記録にモデル ID を残しておくと、後から追跡しやすくなります。
ステップ4:予算を揃えてモデルの性能プラトーを観察する
Seth 氏は共有の中で次のように指摘しています。あるモデルが十分な時間動かされなかった場合、あるいは予算を使い切って停止したのに別のモデルは動き続けた場合、同じ支出で比較したことにならず、真の性能も隠れてしまいます。より合理的な方法は、複数の予算ポイントを設定し、スコアが Token や時間の増加に伴ってどう変化するかの曲線を観察することです。
QM チームの経験も予算の重要性を示しています。彼らは Agent が早期に諦めてしまうことが多いことに気づき、「ツールを研ぎ澄ます」ことを試みました。つまり目標に予算を設定し、実際の時間や Token を消費するまでは諦めることを許さないというものです。その結果、研究のアウトプットが改善しました。したがって、評価仕様には予算の上限だけでなく、最低投入要件が存在するかどうかも明記する必要があります。
ステップ5:Harness に対してアブレーションテストを行う
Harness による向上が見られたら、次はその向上がどの能力に由来するのかを突き止める番です。Prime Agent は表現力を重視しており、圧縮、Python REPL、プログラマブルなサブ Agent、状態アクセス、フィードバック機構はいずれも安易に取り除くべきではないと考えています。ただし、あなたのタスクにおいて各能力が実際にどれだけ貢献しているかは、やはりテストする必要があります。
やり方は、一度に1つの能力だけを無効化することです。たとえば REPL をオフにする、サブ Agent をオフにする、長期記憶をオフにするなどで、その他の設定は変えずに保ちます。無効化した後でスコアがほぼ変わらないのに、コストが明らかに下がったのであれば、その能力は当面は残す価値がないかもしれません。自動研究のような分散の大きいタスクでは、複数回の実行を繰り返す必要があります。Seth 氏も、こうしたタスクは Harness やモデルに直接帰属させるのが難しいと述べているからです。
ステップ6:コストを試算し、人手によるレビューを加える
Seth はまた、Hermes Agent で評価を実行したところ、すぐに5,000ドルを費やしたものの、明確な改善が見られず、中断せざるを得なかったと述べています。これは Hermes Agent の能力の上限を示すものではありませんが、コスト対性能比を評価結論に含めるべきだということを十分に物語っています。最終レポートでは、成功率、完了時間、トークン消費量、1回あたりの成功コストを併記することを推奨します。
コストを計算する際、価格を評価スクリプトの説明文にハードコードしないでください。モデルの入力・出力単価、キャッシュ価格、課金基準は、APIYIの料金ページ https://docs.apiyi.com/models の実データに基づいてください。また、レポートには確認日を明記してください。
採点フェーズでも、人手による抜き取りチェックを残す必要があります。QMチームは、LLM に修正結果を評価させると「主人公症候群」が現れることを発見しました。つまり、LLM は象の一部だけを見て、システム全体を見ていないのです。業務フローに関わる場合は、権限境界もテストする必要があります。エージェントは社会的文脈の理解が苦手なため、特権情報が本来含まれるべきでないコンテキストに漏えいする可能性があるからです。
APIでモデル評価マトリクスを実装する方法
実際に実行する際は、評価をタスクセット、実行設定、結果記録の3つに分けることをおすすめします。そうすれば、モデルや Harness を変更するときに設定項目を1つ変えるだけで済み、フロー全体を書き直す必要はありません。
| 設定項目 | 記録推奨内容 | 説明 |
|---|---|---|
| インターフェース形式 | OpenAI互換またはAnthropic形式 | 形式によってツール呼び出しやメッセージ構造が異なる場合があるため、個別に検証する必要があります |
| 接続先とAPIキー | base_url、環境変数名 |
接続先は docs.apiyi.com のドキュメントに従います。APIキーは評価レポートに記載しないでください |
| 実行パラメータ | model、max_tokens、最大ターン数、繰り返し回数 |
各実験を再現できるようにします |
| コスト算定基準 | 入力・出力・キャッシュ・確認日 | APIYIの料金ページ docs.apiyi.com/models の実データに基づきます |
| 実行結果 | スコア、失敗理由、トークン、所要時間、呼び出しログ | 性能の頭打ち(プラトー)とコスト対性能比の分析に使用します |
Harness が2つのインターフェースを同時にサポートしている場合は、まず同じモデルでフォーマット比較を行ってください。これにより、メッセージ変換、ツール定義、ストリーミング応答が結果に影響していないことを確認でき、接続上の問題をモデル能力の差と誤判定するのを防げます。
接続のヒント:APIYI では、本記事で扱うモデルのAPI呼び出しを提供しており、OpenAI と Anthropic のインターフェース形式に対応しています。実験を始める前に、docs.apiyi.com で現在利用可能なモデルと呼び出し方法を確認し、そのうえでモデル ID を評価仕様に記載してください。
よくある質問(FAQ)
Q1: モデル評価における Harness とは何ですか?
Harness はモデルと外部世界をつなぐシステム層のことで、通常はループ制御、コンテキスト管理、ツール、サブエージェント、メモリ、状態へのアクセスなどを含みます。モデルが何を見られるか、何を呼び出せるか、どれだけの時間実行できるかを決めるのがこの層です。
Q2: Harness のスコアが高ければ、モデルが強くなったと言えるのでしょうか?
いいえ、そうとは言えません。重みが変わっていないのであれば、スコアの向上はむしろ、システムがより多くの能力を引き出せたか、そのタスクにより適した設定になったことを示している可能性が高いです。Harness・予算・モデルが同時に変わった場合は個別の要因に帰属できませんし、評価環境にリークがある可能性もあります。
Q3: どういうときにモデル評価をやり直す必要がありますか?
モデルのバージョン、システムプロンプト、ツールの権限、圧縮戦略、あるいは業務タスクが変わったときには、いずれも再評価が必要です。Harness の分野は進化が速く、本記事のデータは 2026 年 11 月に InfoQ が公開した整理内容に基づいています。今後のスコアは変わる可能性があります。
Q4: このモデル評価手法はどんな場面に適していますか?
主に次のような場面に適しています。
– **社内コーディングエージェントの選定**:モデルと Harness の組み合わせごとにタスク完了率を比較します。
– **長期間の研究タスク**:予算を増やしたときのプラトー(頭打ち)と結果の分散を観察します。
– **企業エージェントのリリース前検証**:品質、コスト、権限の境界を同時にテストします。
Q5: 複数のモデルを素早く接続して Harness を比較するには?
まず評価タスクとモデルのリストを決め、それから APIYI apiyi.com 経由で接続します。同プラットフォームは本記事で扱うモデルの API 呼び出しを提供しており、OpenAI と Anthropic のインターフェース形式に対応しています。具体的なモデル ID と設定方法は docs.apiyi.com のドキュメントを参照し、実験中は他の変数を変えないようにしてください。
Q6: 評価レポートにはモデルの価格をどう書けばよいですか?
検証済みの価格データのみを引用し、参照日を明記することをおすすめします。モデルの入力・出力単価、キャッシュ価格、課金の基準は、いずれも APIYI の価格ページ https://docs.apiyi.com/models の実際のデータに従ってください。古い表や推定値を使い回してはいけません。
Q7: この Harness 評価手法にはどんな限界がありますか?
マトリクス実験、繰り返し実行、人手による確認は、いずれも時間とコストを増やします。長期間タスクでは分散が大きくなることもあり、主要な変数を制御しても正確に要因を特定するのは難しい場合があります。そのため、この手法は意思決定を支える用途に向いており、1 回の結果を絶対的なランキングとして扱うべきではありません。
Harness モデル評価の要点 Key Takeaways
- 比較対象をまず定義する:比較しているのがモデルなのか、モデルと Harness の組み合わせなのかをはっきりさせます。
- 異常な高スコアはまずログを確認:99.9% のケースが示すように、隔離された環境が評価の前提条件です。
- マトリックスで変数を分離:APIYI 経由で複数のモデルに接続し、モデル × Harness の対照実験を行います。
- 予算を必ず揃える:複数の予算ポイントで曲線を観察し、真のプラトーを見つけます。
- アブレーションで貢献を特定:一度に1つの能力をオフにし、向上がどこから来ているのかを確認します。
- コストデータは検証する:価格と課金基準は APIYI の価格ページを基準にします。
- 人的判断を残す:LLM による評価は偏る可能性があり、権限リスクについても専用のテストが必要です。
まとめ
「Harness を変えるだけでスコアが倍になる」という話は重視すべきですが、これを「モデルは重要ではない」と単純に解釈すべきではありません。共有されたデータは Harness の増幅効果を示すと同時に、モデルやタスクによって依然として明確な差があることも示しており、信頼できる結論は制御された実験の上にしか築けません。
実践にあたっては、まず次の3点を押さえておくとよいでしょう。
- 評価対象を明確に書く:モデル、Harness、予算、評価セット、評価方法を記録します。
- 実験設計で帰属を可能にする:マトリックス実験とアブレーション試験で変数を分離し、評価環境を隔離します。
- 結論はシナリオに即して導く:プラトー、コストパフォーマンス比、人的レビューの結果、権限リスクを同時に確認します。
ご自身のモデル構成を検証する準備ができたら、APIYI apiyi.com から本記事で扱ったモデルに接続し、docs.apiyi.com のドキュメントに沿って設定を完了してください。費用の試算が必要な場合は、https://docs.apiyi.com/models を参照して最新の価格データを取得してください。
📚 参考資料
- InfoQ:同じモデルが30点から95点へ——差を広げたのはモデルではなく、Harness
- リンク:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
説明: 本記事で引用しているスコア、事例、設計上の見解は、すべてこのまとめ記事に基づいています。
-
YC Paper Club Harness Night 講演動画
- リンク:
youtube.com/watch?v=n9xKblqyQ28 -
説明: Prime Agent、OpenJarvis、QM の3つの共有の完全な文脈を確認できます。
-
APIYI ドキュメントセンター
- リンク:
docs.apiyi.com -
説明: 利用可能なモデル、インターフェース形式、接続設定の確認に使用します。
-
APIYI モデル価格ページ
- リンク:
docs.apiyi.com/models - 説明: モデルの単価、キャッシュ価格、課金基準は、このページの実際のデータに準拠します。
作者:APIYI 技術チーム
技術交流:モデルの接続方法について知りたい方は、APIYI 公式サイト apiyi.com をご覧ください。詳細な資料は docs.apiyi.com ドキュメントセンターで確認できます。