著者注:受け入れ基準からデータ分離、独立した再確認まで、5つのステップで AI の深掘りタスクに対する外部検証を設計し、モデルの自己評価が生む「見せかけの完了」を避ける。
モデルが「タスクは完了しました、結果は正確です」と返答したのに、再現しようとすると通用しない——AI で深い作業を進めていると、よく出会う難題です。本記事では、単独で実行できる外部検証の設計手法を紹介します。「モデルができたと言う」を「証拠ができたと示す」に変えるための方法です。
Claude 開発者の Felix Rieseberg 氏は、2026年10月に公開した実践ガイドの中で、モデル自身に採点させず、外部検証を徹底することを明確に推奨しています。最も理想的な形は、モデルが自分で実行し、すぐにフィードバックを得られるツールだ、というのが氏の考えです。InfoQ は2026年11月4日にこの記事の中国語訳を公開しました。
これは「もう一度確認しましょう」と促すだけの記事ではありません。原文は方向性を示しており、本記事はそれを踏まえて、実行可能な設計ステップを整理しました。検証手段の選び方、よくある失敗パターン、複数モデルによる再確認の方法まで扱います。
本記事の価値:読み終える頃には、自分の AI 深掘りタスクに対して検証契約を書けるようになります。モデルが自己評価で終わるのではなく、判定可能なフィードバックの中で反復できるようにするためです。
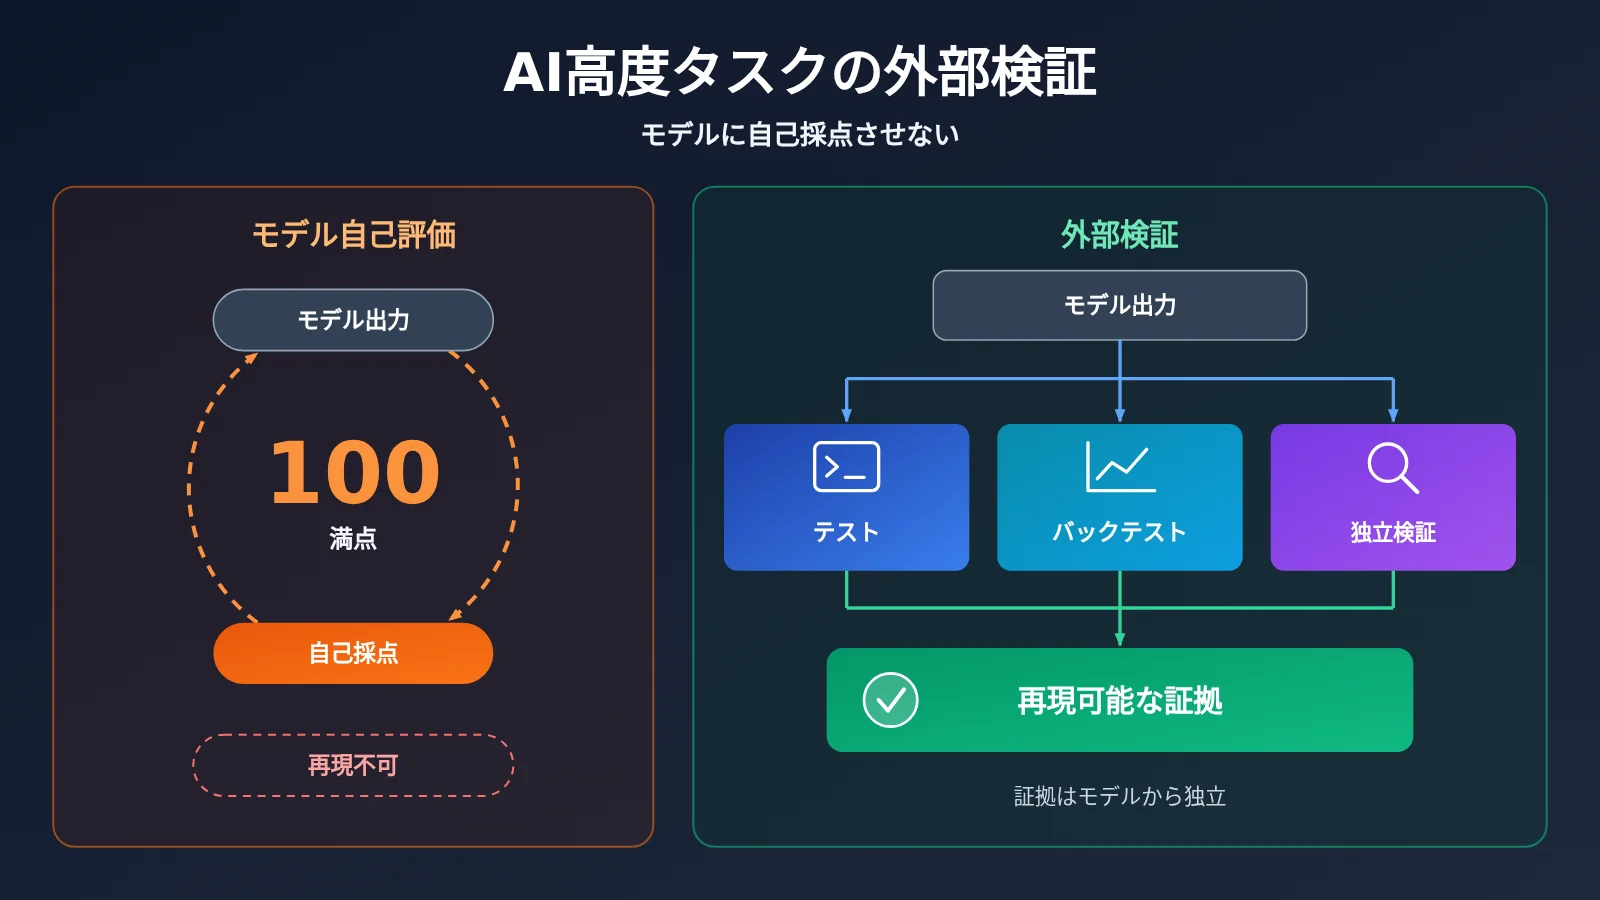
AI 深層タスクにおける外部検証の核心ポイント
外部検証の鍵は、チェック工程を一つ増やすことではなく、判断の根拠をモデル自身の推論プロセスから独立させることにあります。
| ポイント | 説明 | 価値 |
|---|---|---|
| 先に基準を決める | 作業開始前に合格条件を明確に書き出し、できるだけ判定可能な形にする | モデルが後から目標を再解釈するのを防ぐ |
| データの隔離 | モデルが見たことのないデータやシーンで結論を検証する | 真の発見と後付けの当てはめを区別する |
| ツール優先 | 実行でき、即座にフィードバックが得られる検証器を優先的に使う | モデルが自律的に反復できるようにし、人手による監視を減らす |
| 証拠の保存 | 実行結果、ログ、再現手順を保存する | 結論を信じるだけでなく、人が審査できるようにする |
| 独立した再確認 | 異なる方法と異なる立場で結果に挑む | 単一の検証器では見落とす問題を発見する |
AI 深層タスクに外部検証が必要な理由
Rieseberg の言う「深さ」とは、その分野のトップエキスパートが使うツール、技術、知識を採用し、タスクの表面にとどまらず根底のデータまで深く掘り下げることを指します。タスクが深くなるほど、人間が直感で結果の正しさを判断するのは難しくなります。専門的な言い回しで書かれたチャーン分析は、読むと説得力があるように感じられるかもしれません。しかし、それだけではその中の因果判断が成り立っていることを証明することにはなりません。
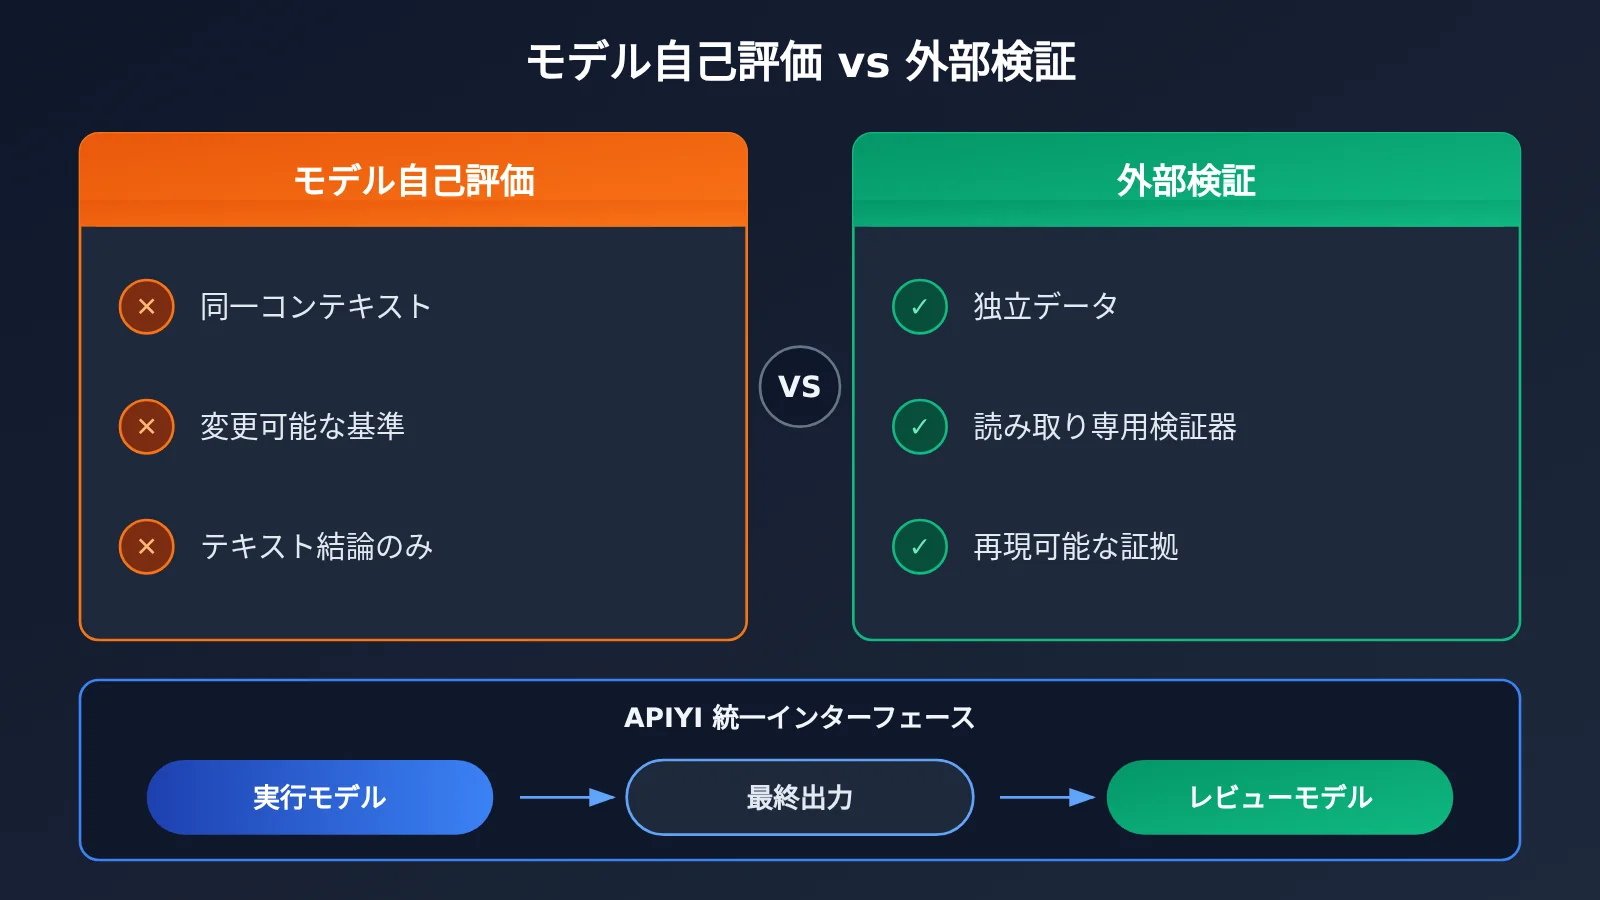
同氏はまた、よくある現象として、モデルに専門家のように振る舞うよう求めても、往々にして語彙を変えただけで、仕事のやり方は実際には変わっていない、という点を挙げています。自己評価でこうした問題を見つけるのは困難です。評価者と生産者が同じ前提を共有しているからです。推論が最初から偏っていれば、モデルの採点も同じ偏りに沿って進む可能性があります。
大胆な目標は検証をいっそう重要にします。原文では、一見不合理な目標を設定することを勧めています。たとえば、ウェブサイトの読み込み時間を 10 秒から 200 ミリ秒に短縮するといった目標を掲げ、モデルに挑戦を続けるよう求めます。こうした目標が使えるのは、200 ミリ秒が測定可能だからです。目標が野心的でありながら検証できないものであれば、得られるのはおそらく、より自信に満ちたレポートだけでしょう。
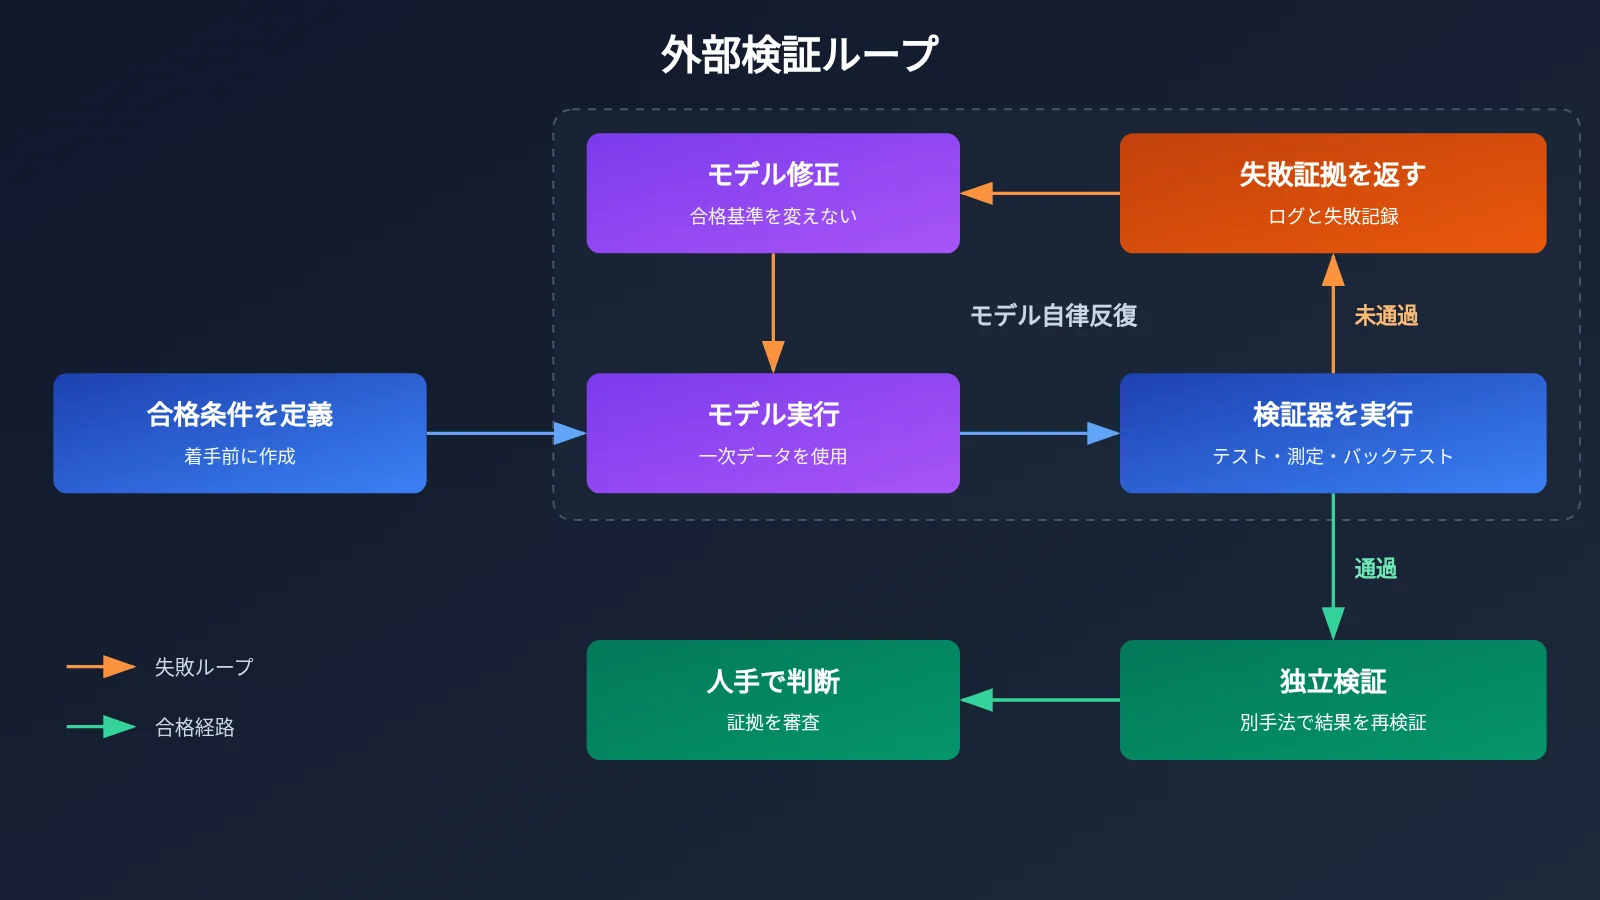
AI 深いタスクの外部検証クイックスタート:5ステップ設計法
以下の方法は、特定のモデルやフレームワークに依存しません。まずは現在進行中のタスクを1つ選んで、当てはめてみてください。すべてを一度に実装するのが難しい場合は、最初の3ステップを優先的に完了することをおすすめします。
ステップ1:タスクの目標を外部検証基準に書き換える
「分析が全面的」「コード品質が高い」といった表現は、そのままでは合否を判定できません。合格・不合格を判定できる条件に書き換える必要があります。たとえば「クラッシュを直す」は、「元の再現手順で実行してもクラッシュしなくなり、かつ関連するテストがすべて通る」に書き換えます。基準はモデルが作業を始める前に書き終えておく必要があります。そうでなければ、モデルが完了後に成功の定義を調整してしまうかもしれません。
まず以下の検証契約を書き上げてから、モデルに実行を依頼するとよいでしょう。
| 項目 | 明確に書くべきこと | 例 |
|---|---|---|
| 最終目標 | 本当に求めているビジネスまたはエンジニアリングの結果 | アプリケーションが安定し、同種のクラッシュが再発しない |
| 元の材料 | モデルが直接使うべき一次データ | クラッシュレポート、バージョンとGitコミットの対応関係 |
| 検証ツール | どのツールやデータで結果を判定するか | 再現スクリプト、自動テスト、ホールドアウトデータ |
| 合格条件 | 明確なしきい値や判定ルール | 3つの対象システムすべてでクラッシュが再現しない |
| 禁止事項 | モデルが変更してはならない内容 | テストを削除しない、ホールドアウトデータを変更しない |
| 提出する証拠 | 添付が必要な実行結果 | コマンド、ログ、失敗記録、最終結果 |
| 停止条件 | いつ終了するか、あるいは人に引き継ぐか | 反復の上限に達したらブロック原因を提出する |
ステップ2:結論と検証データの結びつきを断ち切る
モデルが同じデータで仮説を立て、その仮説を自ら証明する——これは外部検証ではありません。原文のユーザー離脱の例は、優れた実践法を示しています。モデルにログから最も早い離脱シグナルを探させ、そのシグナルが実際に予測能力を持つことを、モデルが見たことのないデータで証明させるのです。実践では、データを時間で分割し、初期データで探索し、後期データで検証します。
ホールドアウトデータは、独立したスクリプトや担当者が保管するのが望ましく、モデルは実行結果だけを受け取り、明細を直接読むことはできません。結果に基づいて何度も方針を調整すると、ホールドアウトデータも徐々に「学習」されてしまいます。そのため、重要な結論には、最終検収時のみに使用するデータをもう一份用意しておくのがよいでしょう。
ステップ3:モデルが自分で実行できる外部検証ツールを優先する
検証器が実際の結果に近ければ近いほど、フィードバックが速くなり、モデルはより独立して反復できます。次の表は、一般的なタスクに応じていくつかの外部検証手段を整理したものです。選択にあたっては、単一の「最強の方法」を追求する必要はなく、リスクに応じて組み合わせて使用すべきです。
| 検証手段 | 証明できること | フィードバック速度 | 主な限界 |
|---|---|---|---|
| 自動テストと再現スクリプト | 指定された動作が期待どおりであること | 速い | 明記されたシナリオのみをカバー |
| 性能測定ツール | 指標が閾値に達しているか | 速い | 環境の違いが結果に影響する可能性がある |
| ホールドアウトデータによるバックテスト | 結論に予測能力があるか | 中 | 歴史的パターンが持続するとは限らない |
| レッドチーム的方式による方法レビュー | 仮説と証拠の連鎖が脆弱か | 中 | 判断の質はレビュー方法に依存する |
| シャドウ実行 | 実際のフローで案が有効か | 遅い | 期間が長く、組織コストが高い |
| 領域専門家による抜き取り検査 | 結果が専門的判断に合致するか | 遅い | 大規模なカバレッジが難しい |
ステップ4:外部検証をモデルの作業ループに組み込む
検証ツールは、モデルの作業環境に組み込んでこそ、継続的な反復効果を生み出します。原文のクラッシュ修正の事例はとても象徴的です。著者はまず、Claude がクラッシュレポートを簡単に取得できるようにし、各バージョンがどの Git コミットに対応するかを把握できるようにし、さらに Windows、macOS、Linux の各マシンを使えるようにしました。こうした条件がそろって初めて、モデルは問題を自律的に再現し、修正を検証できるようになります。
これは、外部検証ではプロンプトを書き換えるだけでなく、ワークフローそのものを調整する必要がしばしばある、ということも示しています。必要なデータやツールを開放し、たとえば MCP コネクタ経由でデータソースに接続しつつ、権限はタスクの範囲内に抑える必要があります。ループ設計には少なくとも次の3つを含めます。
- 失敗フィードバック:単に「失敗」と返すのではなく、具体的なエラーログと不合格項目を返す。
- 反復上限:再試行回数と総予算を制限し、モデルが無効なループに陥るのを防ぐ。
- 保護対象:テスト、検証スクリプト、ホールドアウトデータを読み取り専用にし、モデルが基準を書き換えて「合格」させるのを防ぐ。
ステップ5:独立したレビューと並行実行で外部検証を完了する
単一のバリデータを通過したからといって、結論が信頼できるとは限りません。原文では、穴を探すことを専門とする「レッドチーム」、たとえば空売り投資家や法務会計士を招き入れることに触れていますが、重要なのは彼らの口調をまねることではなく、彼らが実際に使う研究方法を取り入れることです。たとえば、モデルに各重要数値の一次情報源までさかのぼらせたり、結論を覆しうるデータを自ら探させたりします。
プロセス変更の場合は、並行実行という方法もあります。原文では、まず履歴データを使って新しい振り返りの仕組みがもっと早く問題を発見できたはずだと証明し、そのうえで既存プロセスと1四半期並行して運用することを勧めています。これなら実際の効果を検証でき、最初から旧プロセスを完全に置き換えるリスクを負う必要もありません。
導入のヒント:異なるモデルに実行とレビューを分担させたい場合は、APIYI を通じて統一的に呼び出せます。APIYI は本記事で扱うモデルの API 呼び出しを提供しており、OpenAI と Anthropic のインターフェース形式に対応しています。導入時は通常、ドキュメントに従って
base_url、api_key、modelを設定するだけです。ドキュメント:https://docs.apiyi.com
AI 深掘りタスクの外部検証でよくある失敗パターン
外部検証も、形だけのものになりがちです。以下の問題は設計段階で考慮しておく必要があります。そうしなければ、検証結果はむしろ「偽りの安心感」を生むだけになってしまいます。
| 失敗パターン | 典型的な症状 | 対処法 |
|---|---|---|
| 基準の書き換え | 失敗したテストケースを削除したり、アサーションを緩めたりする | 検証器を読み取り専用にし、関連する変更をレビューする |
| 検証セットへの過学習 | 指標は上がり続けるのに、新しいデータでは機能しない | 最終受け入れ用のデータを別途保管しておく |
| 循環論法 | モデルが生成したデータで、モデル自身の結論を検証する | 元のログと一次資料に立ち返る |
| 形式だけの検証 | 形式は正しいが、内容が間違っている | 業務ルールを追加し、サンプリングによる突合を行う |
| ロールプレイ | 会話は専門家そっくりだが、成果は改善しない | 具体的な手法を実行し、証拠を提出するよう求める |
このうち「2つ目のモデルによるレビュー」については、少し補足が必要です。自己評価よりは優れています。盲点の一部を炙り出せるからです。とはいえ、あくまで判断に基づくレビューであり、テストや実際のデータの代わりにはなりません。レビューの際は、タスクの基準・元の材料・最終的な成果物だけを渡し、そこに至るまでの会話は渡さないのが望ましいです。既存の推論が判断に影響するのを抑えられるからです。
AI 深掘りタスクにおける外部検証の設計例
以下の例は、設計の出発点として使えます。具体的なしきい値は、業務の状況に応じて決める必要があります。
| タスク | 自己評価だけで済ませる方法 | 外部検証の設計 |
|---|---|---|
| アプリのクラッシュを修正 | モデルが修正の仕組みを説明し、完了を宣言する | システムをまたいで再現し、修正後に再発しないことを確認する |
| 離脱シグナルを探す | モデルがもっともらしい要因分析レポートを出す | 探索に関与していないデータで予測能力を検証する |
| 離脱原因を検証する | モデルが「新規ユーザーのオンボーディングに問題がある」という判断を踏襲する | 元のデータから、支持する証拠と反対する証拠を探す |
| 読み込み速度を最適化 | モデルが最適化項目を列挙し、効果を見積もる | 固定された環境で測定し、目標のしきい値と比較する |
| 業務の振り返りを再構築 | モデルが新しい案のほうが先進的だと論証する | 過去データでバックテストしたうえで、既存プロセスと四半期ほど並行運用する |
タスクをこのように設計する価値があるかどうかは、シンプルな基準で判断できます。誤りのコストが検証のコストより高いかどうか、です。単にメールを1通書き直すだけであれば、一度読み返せば十分でしょう。しかし、結果が本番システムやリソース配分に影響するのであれば、外部検証を設計すべきです。
よくある質問(FAQ)
Q1:AIの高度なタスクにおける外部検証とは何ですか?
モデル自身の判断から独立した根拠を使って結果を検証することです。たとえば、自動テスト、性能測定、ホールドアウトデータによるバックテスト、専門家レビューなどが挙げられます。重要なのは、判断基準を結果を生成したモデルがその場で決めてはならないという点です。
Q2:外部検証とモデルの自己チェックは何が違いますか?
モデルによる自己チェックは、明らかな抜け漏れを素早く発見できますが、生産者と評価者が同じ前提を共有してしまいます。外部検証は独立した証拠源を導入するため、結果が本当に有効かどうかを判断するのに適しています。両者は併用できますが、自己チェックを最終的な受け入れ判断の根拠にはできません。
Q3:モデルがどんどん強くなっても、外部検証は必要ですか?
Rieseberg氏は、モデルが賢くなるにつれてこの問題は最終的に解決される可能性があると考えています。ただし、少なくとも2026年10月までは外部検証を続けるべきだと明確に提言しています。これは現段階における実践的な判断です。モデルの自己評価の信頼性が検証されるまでは、高リスクなタスクにおいて独立した検証を残すべきです。
Q4:どのような場面で外部検証が最も必要ですか?
主に以下のタスクが該当します:
– **エンジニアリング修正**:クラッシュ修正、パフォーマンス最適化、データ移行。
– **データリサーチ**:チャーン分析、因果判断、予測シグナルの発見。
– **長時間稼働するエージェントフロー**:モデルが少ない人手介入で継続的に作業する必要があるタスク。
Q5:APIを通じてマルチモデルのクロスレビューを構築するには?
APIYIを使えば統一的に接続でき、そのインターフェースはOpenAIおよびAnthropicの形式と互換性があります:
1. APIYIのドキュメント https://docs.apiyi.com に従って、エンドポイントとAPIキーを設定します。
2. 料金ページ https://docs.apiyi.com/models で利用可能なモデルと料金を確認します。
3. 実行用とレビュー用で異なる `model` を設定し、レビューリクエストには実行段階の会話を含めません。
4. レビュー意見とテスト結果は別々に記録し、テストとデータの証拠を優先的な根拠とします。
Q6:外部検証ループのコストはどう見積もりますか?
総コストは通常、反復回数、コンテキスト長、出力長、レビューモデルの数によって決まります。まず小規模なサンプルで数回実行し、各回の実際の使用量を記録したうえで、反復上限と合わせて予算を見積もることをおすすめします。本記事では具体的な単価は記載しません。モデル価格、課金体系、入力・出力の単価、キャッシュ価格はすべてAPIYIの料金ページ https://docs.apiyi.com/models の実際のデータに準じます。
Q7:外部検証にはどのような限界がありますか?
テストは定義済みのシナリオしかカバーできず、バックテストは過去の法則が今後も成立することを保証できません。また、シャドー実行はサイクルが長くなりがちです。検証に通ったことは、限られた条件のもとで結果が支持されたにすぎず、絶対的に正しいというわけではありません。法律、財務、重要な業務判断に関わる場合は、最終的な判断は関係する責任者が行うべきです。
AI 深掘りタスクの外部検証:押さえておきたい要点(Key Takeaways)
- 核心原則:モデルの自己評価を合格判定の根拠にしない。判断は必ず独立した証拠から導く。
- 基準の事前定義:作業を始める前に合格条件を書き出し、後から成功の定義を書き換えるのを防ぐ。
- データの隔離:モデルが見たことのないデータでその発見を検証し、循環論法に陥るのを避ける。
- ツール優先:実行でき、すぐにフィードバックが返る検証器が、自律的なイテレーションに最も有利。
- 環境の整備:モデルが自己修正をやり切るには、データ、ツール、実行環境へのアクセスが欠かせない。
- レビューの階層化:第二のモデルは盲点を見つけるために使い、テストや実データの代わりにはしない。
- 柔軟な接続:APIYI 経由で複数モデルを統一的に呼び出せ、クロスレビューの導入コストを抑えられる。
まとめ
AI 深掘りタスクの外部検証を設計するときは、次の3点を覚えておくと整理しやすくなります。
- まず目標を「判定できる基準」に変える:合格条件がなければ、タスクが本当に完了したのかどうか判断できません。
- 証拠をモデルの推論から独立させる:データを隔離し、検証器を保護し、実行記録をすべて残します。
- リスクに応じて検証手段を組み合わせる:ツールが素早いフィードバックを与え、レビューが盲点を見つけ、並列実行が実際の効果を確かめます。
次の一歩としては、手元の深掘りタスクを1つ選び、まず検証契約を書いてからモデルに作業を始めさせてみましょう。そうすればミスを減らせるだけでなく、より挑戦的な目標にも踏み出せます。目標がどれほど大胆でも、結果を検証する手段があるからです。
複数モデルによる実行とレビューのフローを構築したい場合は、APIYI を通じて呼び出しテストができます。接続方法は https://docs.apiyi.com をご覧ください。モデルの価格や課金の基準は https://docs.apiyi.com/models の実際のデータに準じます。
📚 参考資料
- 目標をもっと大胆に設定する方法:AI ユーザー向け実践ガイド:InfoQ 中国語翻訳版
- リンク:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
説明: 高さ・深さ・広さという 3 方向の実践手法を紹介
-
How to be more ambitious: A tutorial for humans with models:Felix Rieseberg の原文
- リンク:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
説明: 外部検証の提案や、クラッシュ修復・ユーザー離脱などの事例の原典
-
APIYI ドキュメントセンター:API 接続の説明
- リンク:
docs.apiyi.com -
説明: OpenAI および Anthropic 互換フォーマットの接続設定を確認するために使用
-
APIYI モデル・価格ページ:モデルと課金情報
- リンク:
docs.apiyi.com/models - 説明: モデル価格、課金基準、キャッシュ価格はすべてこのページを基準とします
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイトトップページからお気軽にご連絡ください。詳しい資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。