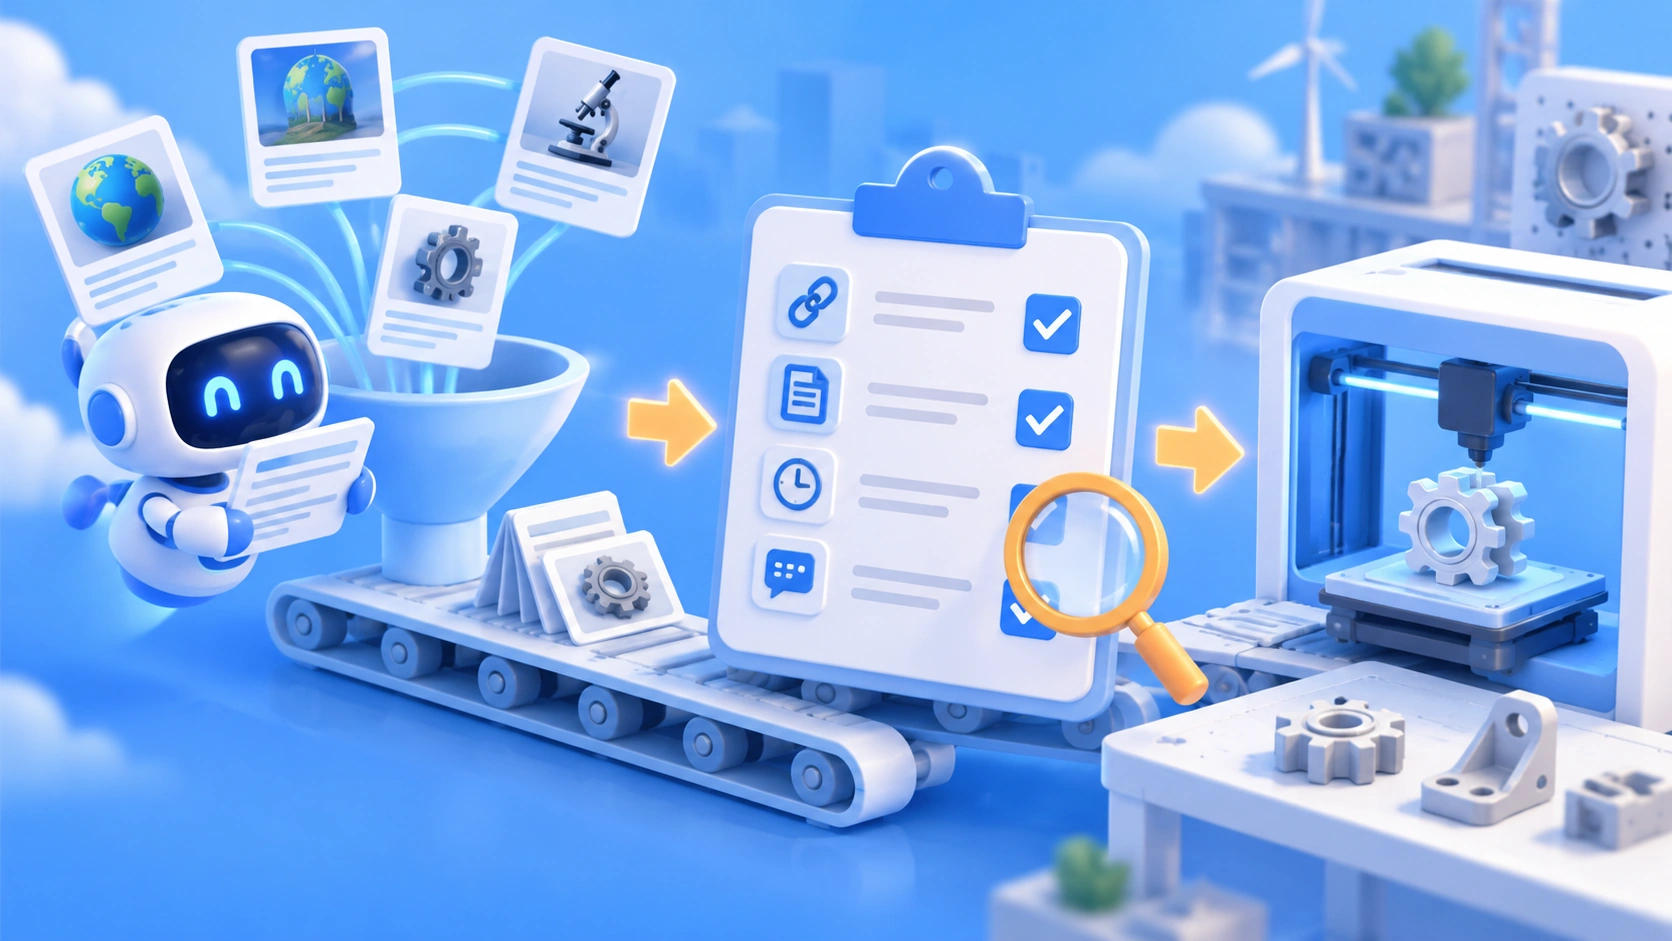
著者注:Agent はWebページを読み取り、情報をリストにまとめてくれます。ただし、手元に届くのは「取捨選択して読める手がかり」であって、「そのまま引用できる根拠」ではありません。この記事では、公開されている利用記録をもとに、Agent による情報収集後、書き手が自分で確認すべき4つのポイントを解説します。
「技術革新」のようなテーマは範囲が広すぎて、そのまま書こうとすると内容が漠然としがちです。そこで、AI Agent にWeb上の情報をまとめて集めてもらい、大量の回答や投稿から具体的な切り口を探すクリエイターや研究者が増えています。この記事では、Agent による情報収集後の人による確認をテーマに、リストの中で使える情報はどれか、単なるスナップショットや伝聞はどれか、まだ不完全な情報はどれかを判断する方法を紹介します。
この記事はツールのレビューではありません。参考にした事例は、プロモーションと明記されたコミュニティの投稿から採ったもので、事例も1件だけです。そのため、効果の証明ではなく「個人の体験」として読み解きます。また、記事中の3Dプリントに関する回答については、投稿者自身が原文に戻って確認していないと明記しているため、この記事でも事実として引用しません。
この記事で得られること:繰り返し使える、Agent による情報収集後の確認チェックリストを紹介します。大きなテーマを具体的な問いに絞り込み、未確認の伝聞をそのまま記事に書かないための方法がわかります。
Agentを使った取材の要点:リストでできること、できないこと
まずは参考事例の流れを見てみましょう。あるライターが、同僚がCodexとMoliを使ってQuoraを読み取った記録を確認しました。同僚はCodexでMoli Web Fetch Skillを選び、Quoraの「Technological Innovation」トピックのリンクを貼り付けて、ひと言「View all content」と指示しました。Codexは手順を組み立て、Moliを呼び出してページから内容を取得し、質問、回答者、要約、出典をリストにまとめました。
この過程には、書き手が特に注意したい3種類の問題に対応する細部があります。最初の読み取りコマンドは正常に終了したものの、取得できたのはトピックのタイトルと「Something went wrong」だけで、回答本文はありませんでした。ページのレスポンスを確認する方法に切り替えて、ようやく10件の回答カードを取得できましたが、返されたデータの hasNextPage は真で、次のページがあることを示していました。また、リストの7件目は途中で切れたプレビューしかありませんでした。
| 要点 | 説明 | 書き手にとっての意味 |
|---|---|---|
| リストは拾い読みに向いている | Agentが質問、回答者、要約、出典をまとめるため、ざっと目を通しやすい | Webページとチャット画面の間で資料を行き来させる時間を節約できる |
| コマンドの成功≠内容の取得 | 最初の読み取りは正常に終了したが、得られたのはタイトルとエラー表示だけだった | 取材のたびに、結果に本文が含まれているかをまず確認する |
| ページ送りと途中で切れた表示=資料の不足 | hasNextPage が真で、7件目は途中で切れたプレビューしかない |
最初に取得した結果を「すべての意見」と見なしてはいけない |
| 反応数はスナップショット | リスト内の反応数は、取得時点の状態にすぎない | 参考程度にとどめ、「最も人気がある」とする根拠には使えない |
| 要約は間接的な記述 | 生活にまつわる例はAgentがまとめた要約に基づいており、まだ原文で確認されていない | 引用する前に、元の回答に戻って一つずつ確認する必要がある |
Agent の資料リストが「選び読み」に向いている理由
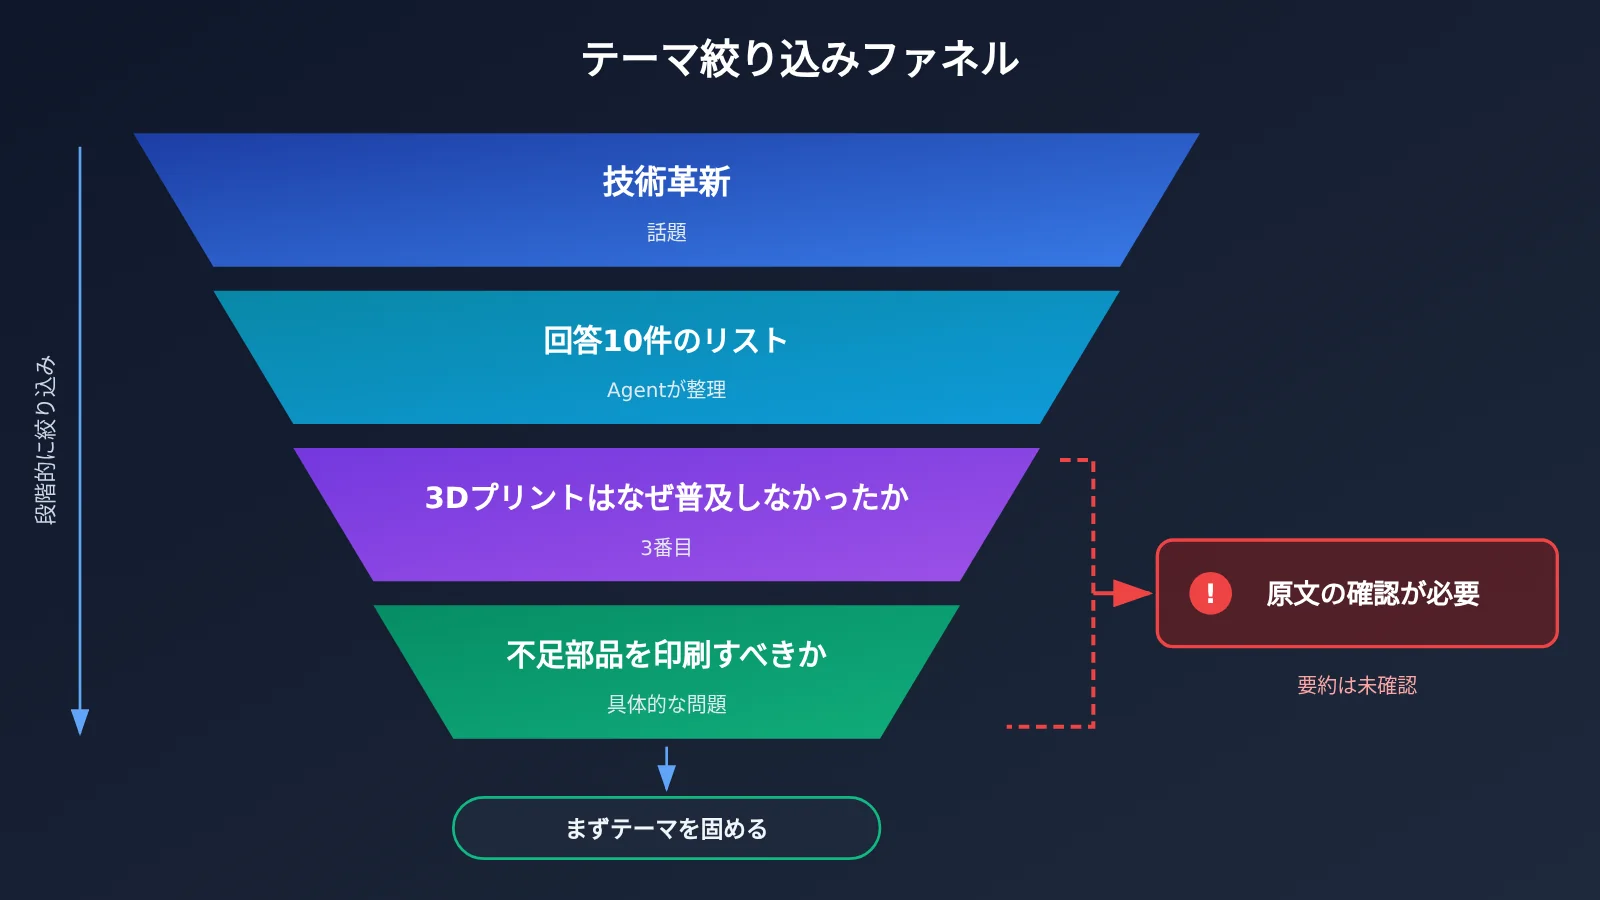
リストの価値は、注目する範囲を絞れることにあります。事例の筆者は10件をざっと確認し、3件目の「What happened to 3D printing?」(著者:James Martin)に目を留めました。要約に、モデル設計や材料、価格、量産コストといった制約が挙げられていたからです。リストがあれば、まず読みたいものを選び、出典をたどって詳細を確認できます。これこそが、Agent を使った資料収集で時間を節約できるポイントです。
ただし、リスト自体は二段階の加工を経ています。まず Agent がウェブページからデータを取得し、次にモデルがそれを要約します。どちらの段階でも、情報が抜け落ちたり、ニュアンスが変わったり、内容が別の人のものとして伝えられたりする可能性があります。参考資料には Agent の要約の正確性に関するデータがなく、数字を作り出すつもりもありません。そのため、要約には「偏りがあるかもしれない」と考え、証拠そのものではなく、道しるべとして扱うのが堅実です。
大きなテーマから具体的な問いへ絞り込む
事例の筆者がテーマを絞り込んだ道筋は、参考になります。元のテーマは「技術革新」でしたが、リストを見て「3Dプリント」に注目。さらに、資料で紹介されていた日常のエピソードから、テーマを絞り込みました。資料によると、回答者は店が閉まっているときに水道の蛇口のパッキンを自分でプリントし、ほかの人が公開したモデルでコーヒーメーカーの部品も作ったそうです。一方、安い量産品がある場合は、直接買ったほうが得だと感じていました。
そこで問いは、「急に必要になった、買えない部品を自分でプリントするべきか」に変わりました。十分に具体的な問いであり、「緊急時に不足した部品を作ること」と「長期的に買い物をプリンターで代替すること」という2つの異なる状況も区別できます。ここで筆者は、これらは資料を通して伝えられた回答者自身の話であり、元の回答に戻って一つずつ確認したものではないと明記しています。テーマは先に決めても構いませんが、引用は確認してからです。
Agent による取材のクイックスタート:リストから引用可能な資料までの6ステップ
ここでは、事例から得られた知見を汎用的な手順にまとめます。特定のツールのバージョンに依存せず、Moli と Codex の組み合わせや、Webページを読めるほかの Agent でも活用できます。手順に登場する指示やパラメータはインラインで示しているので、コードを書く必要はありません。
ステップ1〜3:Agent に情報を取得・整理させる
- リンクと最低限の要件を伝える:事例のように、トピックのリンクを貼り、
View all contentのような指示を一言添えます。表の構成はあらかじめ指定せず、まずは Agent が何を取得できるか確認しましょう。 - 結果に本文が含まれているか確認する:コマンドが正常に終了しても、取得に成功したとは限りません。タイトルや
Something went wrongのようなメッセージしか表示されない場合は、ページの読み込みを待つ必要があるかもしれません。Agent に、Webページが受け取ったレスポンスデータを確認するなど、別の方法で読み取るよう指示します。 - リストに出典を含めるよう求める:質問、投稿者、要約、出典リンクはいずれも欠かせません。出典のない項目は後からさかのぼって確認できないため、引用候補から除外します。
ステップ4〜6:人による判断と検証
- 完全性に関する情報を記録する:
hasNextPageのようなページネーションのフラグ、途中で切れたプレビュー、項目数に注意し、「これは最初の取得分」とメモに書いておきます。 - 結論ではなく切り口を選ぶ:一覧から続きを読みたくなる細部を見つけ、出来合いの主張ではなく、具体的な問いに言い換えます。
- 原文に戻って一つずつ確認する:引用予定の主張、事例、数字について、元のページを開いて一つずつ照合し、記事に書くかどうかを判断します。
🎯 技術的なアドバイス:ステップ3で要約を生成するときは、異なる2つのモデルにそれぞれ要約を書かせて比較する方法もあります。同じ回答について両者の記述が大きく異なる場合は、その回答を優先して原文で確認しましょう。APIYI apiyi.com のような統一インターフェースを提供するプラットフォームなら、複数の主要モデルを呼び出せます。モデル名を変えるだけで切り替えられるため、こうした相互比較がぐっと楽になります。
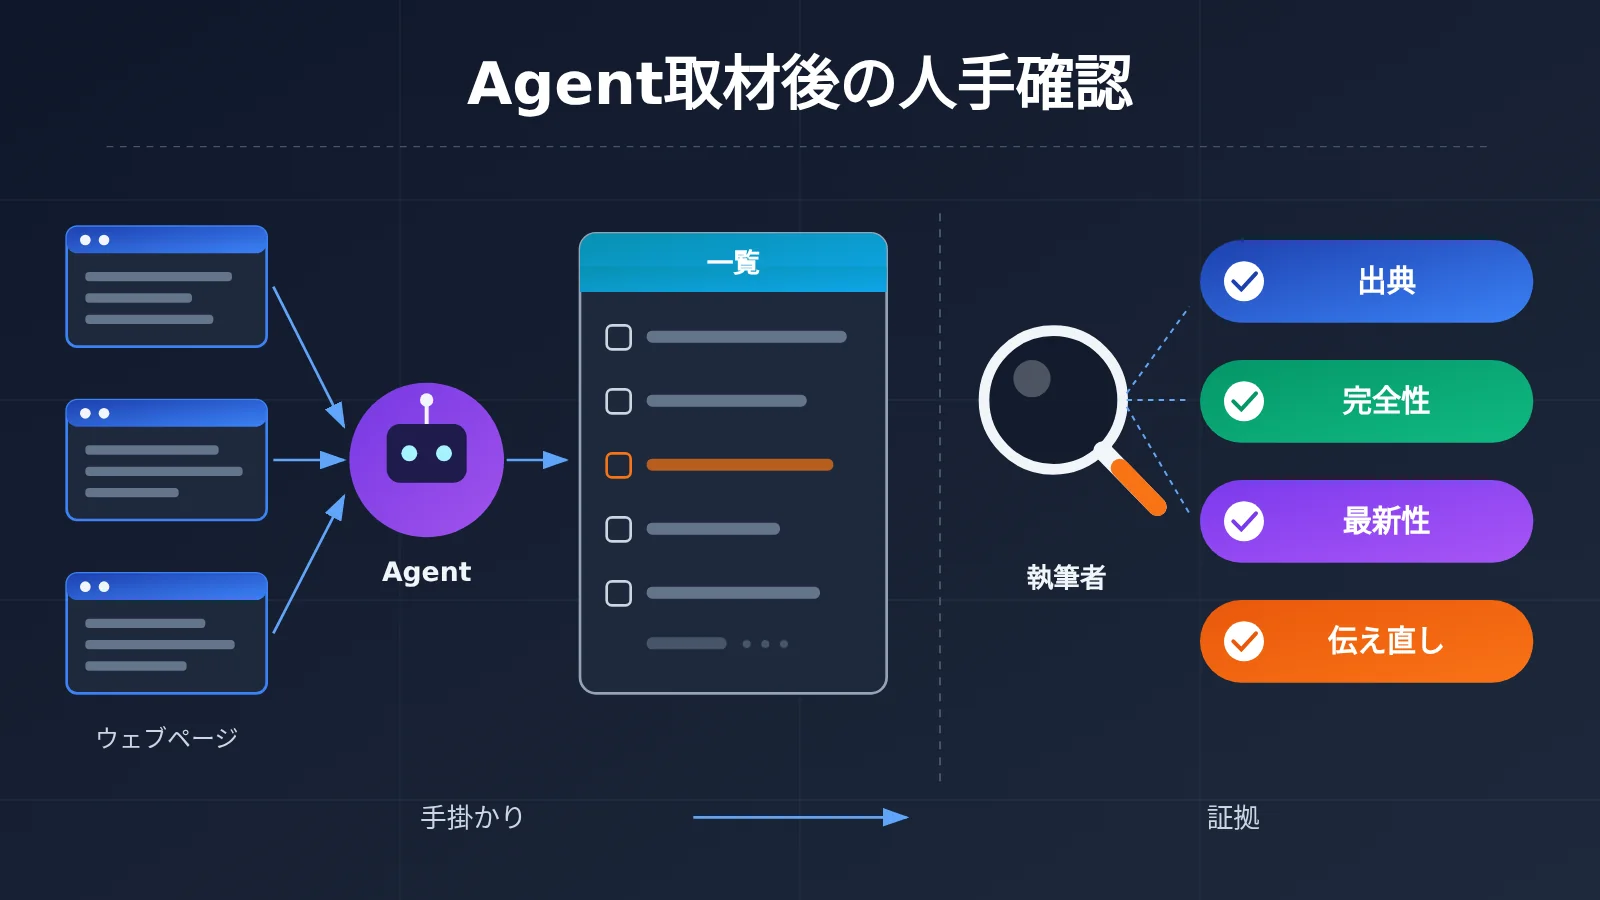
Agent による取材後の4項目チェックリスト
ここがこの記事で最も重要な部分です。事例の著者は記事の末尾で「引用前には原文を確認すべき」と述べています。この言葉を、一つずつチェックできる4つの観点に分けてみましょう。
| 確認する観点 | 確認すべきこと | 事例での手がかり | 確認できない場合の対応 |
|---|---|---|---|
| 出典 | どのページ、どの著者による内容か? 元のリンクを開けるか? | 一覧には著者 James Martin と出典が記載されている | 元のリンクが見つからなければ引用せず、着想にとどめる |
| 完全性 | 見ているのは全文、プレビュー、それとも最初の取得分か? | hasNextPage が真。7件目は途中で切れたプレビューのみ |
残りのページを取得するか、元の回答を開いて全文を読む |
| 時点 | データはいつ取得されたか? 反応数は変わる可能性があるか? | 反応数は取得時点のスナップショット | 引用時に時点を明記するか、具体的な数字を書かない |
| 要約との違い | 要約は原文と一致しているか? 内容が脚色されていないか? | 蛇口のパッキンやコーヒーメーカーの部品は要約から得た情報で、未確認 | 原文に基づいて表現し直し、必要なら原文をそのまま引用する |
この4項目の中で、最も見落としやすいのが「要約との違い」です。Agent の要約はたいてい読みやすくまとまっているため、かえって警戒心が薄れがちです。たとえば、原文では一度部品を印刷した経験に軽く触れただけなのに、要約では「長年にわたり必要な部品を自分で印刷してきた」と書かれるかもしれません。ニュアンスが変われば、それを基に書く論点もずれてしまいます。
💡 使い分けのアドバイス:原稿で外国語の回答を多く引用する場合は、翻訳と要約を分けて行うのがおすすめです。まずモデルに原文を段落ごとに翻訳させ、その後で自分で要約を書きましょう。APIYI apiyi.com は同じインターフェースで異なるモデルを呼び出せるため、翻訳と要約を別々のモデルに割り当てられます。これにより、一つのモデルが「翻訳しながら書き換える」ことで生じる偏りを抑えられます。
Agentによる取材の役割と限界:読む材料と引用の根拠を比較
Agentを取材に使うと、見落としやすい問題があります。リストの内容が充実し、形式も整っているため、いつの間にかそれ自体を引用元として扱ってしまうことです。次の表では、「読む材料を選ぶ」と「引用する」という2つの用途を比較します。
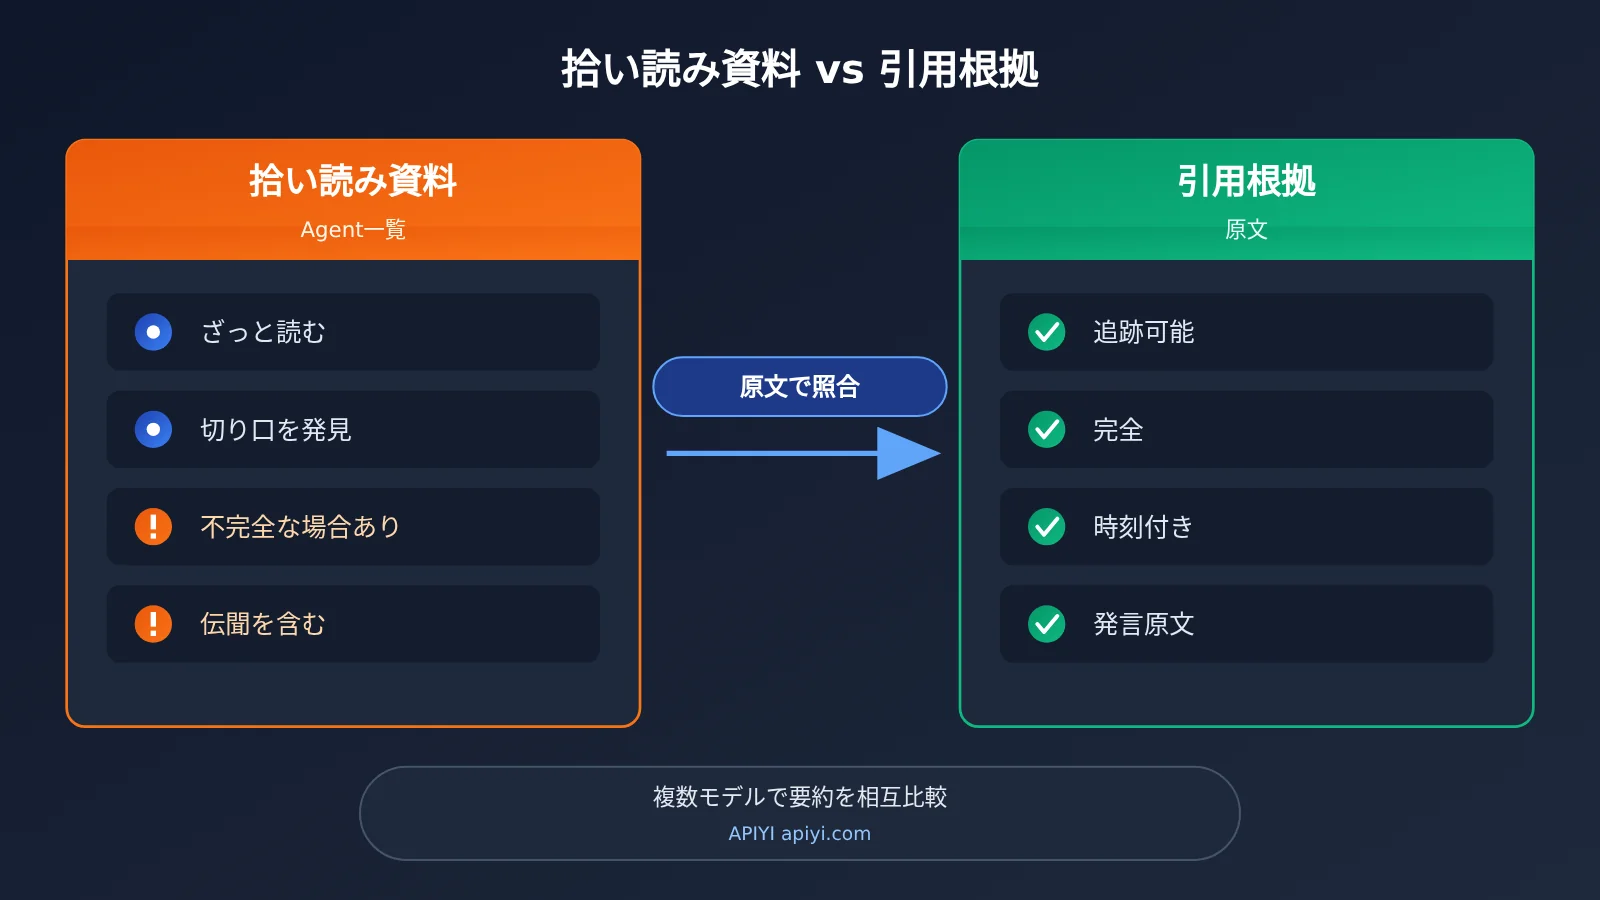
| 比較項目 | Agentが整理したリスト | 原文に戻って確認した資料 |
|---|---|---|
| 主な用途 | ざっと読み、選別し、切り口を探す | 記事に書き、論点を裏付ける |
| 網羅性 | 最初の一部だけの場合や、途中で切れている場合がある | 回答の全文を読む |
| 表現方法 | モデルによる言い換えや要約 | 著者の言葉そのまま、または原文に忠実な書き換え |
| 時間に関する情報 | 取得時点のスナップショット | 引用時に閲覧日を明記する |
| 誤りの影響 | どの項目を読むかに影響するだけ | 記事の信頼性に直接影響する |
比較からわかること
Agentのリストは、「一通り目を通し、読む価値のあるものを選ぶ」作業にとても役立ちます。事例の著者も、ウェブページとチャット画面の間で資料を何度も移す手間が減ったことを、最も有用な点として挙げています。一方で、内容が不完全な可能性があること、言い換えを含むこと、取得時点の情報に限られることなど、限界も明確です。原文に戻って確認する作業には時間がかかりますが、引用に責任を持つために欠かせないステップです。
別の見方をすれば、Agentによる取材は、書き手の仕事の重心を「資料の移動」から「判断」へと移します。以前はコピー&ペーストに多くの時間を費やしていましたが、今は確認や思考に時間を使えます。まさにそこが、人にしか担えない部分です。
📌 進め方のヒント:固定の「要確認」タグを用意しましょう。Agentのリストから抜き出した見解は、下書きに入れる際にすべてこのタグを付け、確認が済んでから外します。APIYI apiyi.comでモデルを呼び出して整理を補助してもらう場合も、出力する各要約に「言い換え」と明記するよう指示すれば、原文そのものではないことを忘れずに済みます。
Agent を使った取材の検証が役立つ場面と、その限界
この検証方法は、Quora のような質問回答コミュニティだけでなく、さまざまな場面で使えます。事例の著者も記事の末尾で、今後は製品ドキュメントや更新情報でも同じ手順を試したいと述べています。資料の種類によって、重点的に確認すべき点は異なります。
| 資料の種類 | 特に確認したい観点 | よくあるリスク |
|---|---|---|
| 質問回答コミュニティの回答 | 言い換えによる差異、網羅性 | 個人の経験が一般的な結論として要約される |
| 製品ドキュメント | 最新性 | ドキュメントの更新により、旧版の記述が通用しなくなる |
| 更新情報 | 出典、最新性 | 予告をリリース済みの機能と勘違いする |
| ニュースや宣伝投稿 | 出典 | 宣伝コンテンツを中立的なレビューと見なす |
最後の行については、特に説明が必要です。この記事で参考にした投稿自体に「プロモーション」と明記されており、紹介されているのは一度の使用記録であって、独立したレビューではありません。引用した理由は、特定のツールの効果を証明しているからではなく、取材過程で注意すべきいくつかのポイントが分かりやすく表れているからです。宣伝目的の資料に接するときも、同じように「出典」を確認しましょう。
一つの事例だけでは不十分。何を補うべきか
事例の著者が取り上げたテーマを、まだそのまま記事にできないのは、根拠となる回答が一つしかないからです。「急に部品が足りなくなったとき、自分で印刷するべきか」に答えるには、少なくともほかの利用者の経験も集め、モデルの入手先、材料費、作業の手間がそれぞれどの程度の障壁になるのかを確かめる必要があります。著者自身も、次は元の回答に戻って確認し、さらに事例を探すと述べています。
これは、Agent を使った取材のもう一つの限界でもあります。最初の手がかりを見つける手助けはできますが、その手がかりに代表性があるかどうかを代わりに判断することはできません。自分の主張が一つの要約だけに支えられていると気づいたら、急いで書き始めるのではなく、検索の段階に戻りましょう。
🔍 補足のヒント:事例を増やすときは、Agent にキーワードを変えながらそれぞれ情報を集めてもらい、複数のリストをモデルに統合・重複排除させる方法があります。APIYI apiyi.com の統一インターフェースを使い、同じ整理指示を異なるモデルでそれぞれ実行して、選ばれたポイントが一致するか比較するのも、低コストでできるセルフチェックの一つです。
よくある質問 FAQ
Q1:Agent による取材とは何ですか?
Agent による取材とは、AI Agent があなたに代わってWebページを開き、コンテンツの読み込みを待って本文を読み取り、リストに整理することです。参考事例では、Codex が手順を組み立て、Moli のような AI 向けブラウザがWebページを読み取り、最後に質問、投稿者、要約、出典を出力します。
Q2:Agent が整理したリストと原文はどう違いますか?
リストは、読み取りと要約という2段階の加工を経たもので、内容を手早く選んで読むのに適しています。原文は投稿者本人の完全な文章で、引用の根拠に適しています。リストは効率的ですが、内容が途中で切れたり、言い換えによって意味がずれたりする可能性があります。原文を読むには時間がかかるものの、信頼性を確保するための拠り所になります。
Q3:読み取りコマンドが成功したのに、なぜ結果を確認する必要があるのですか?
参考事例では、最初の読み取りコマンドは正常に終了したものの、結果にはトピックのタイトルと “Something went wrong” しか表示されませんでした。ページによっては、読み込み後にコンテンツが表示されます。そのため、「コマンドが完了したこと」と「内容を取得できたこと」は別です。毎回、結果に本文が含まれているかをまず確認しましょう。
Q4:取得した資料が不完全かどうかは、どう判断できますか?
3つのサインに注目しましょう。返されたデータにページ送りを示すフラグがある(例えば `hasNextPage` が真)、項目が途中で切れたプレビューしか表示されていない、項目数がページの実際の内容より明らかに少ない、というものです。いずれかに該当する場合、手元にあるのは資料の一部にすぎず、それをもとに「みんなが何と言っているか」をまとめることはできません。
Q5:複数のモデルで要約を相互にチェックするには、どう始めればよいですか?
方法は簡単です。Agent が取得した同じ元の内容を2つの異なるモデルにそれぞれ渡して要約を生成し、差が最も大きい項目から優先して原文に戻って確認します。APIYI apiyi.com のような集約プラットフォームを使えば、同じ OpenAI 互換インターフェースで異なるモデルを切り替えられるため、複数のサービスに個別に接続する手間を減らせます。
Q6:Agent の要約の誤り率はどのくらいですか?
現時点で参照した資料には、この点に関する統計データがなく、事例も1件しかないため、信頼できる数値は示せません。要約には誤りがあり得ることを前提に、「怪しいと思ったときだけ確認する」のではなく、照合を決まった手順にするのが無難です。
Q7:リスト内のエンゲージメント数を記事に書いてもよいですか?
参考にはできますが、直接論拠にすることはおすすめしません。エンゲージメント数は取得時点のスナップショットであり、その後変化します。どうしても記事に書く場合は、確認日を明記しましょう。材料を選ぶ際は、いいねの数よりも回答そのものの質を見ることが大切です。
Q8:宣伝投稿に載っている事例は参考にできますか?
参考にはできますが、その性質を理解しておく必要があります。宣伝投稿は通常、うまくいった1回の使用例を紹介するもので、一般的な効果を示すわけではありません。引用する際は出典が宣伝投稿であることを明示し、具体的な内容は検証が必要な情報として扱いましょう。これは、この記事で参考事例を扱う際の姿勢と同じです。
Agentによる取材内容の確認:押さえておきたいポイント
- リストは拾い読みのために使う:Agentがまとめたリストは、ざっと目を通して切り口を探すのに便利ですが、そのまま引用の根拠にはできません。
- 成功しても取得できたとは限らない:読み取りコマンドが正常終了しても、結果に本文が含まれているかを確認しましょう。
- ページ分割や途中切れがあれば不完全:
hasNextPageや途中で切れたプレビューが表示されたら、手元にあるのは最初の一部だけです。 - リアクション数は取得時点のもの:数値は変化するため、引用する際は時点を明記するか、数値を書かないようにしましょう。
- 要約を引用する前に原文に戻る:要約内の事例や意見は、引用前に元の回答と一つずつ照合しましょう。
- 事例は一つだけでは足りない:切り口を見つけたら、さらに事例を集め、その傾向に代表性があるかを確かめましょう。
- 複数モデルで相互チェック:APIYI apiyi.com の統一インターフェースを使い、異なるモデルの要約を比較することもできます。
まとめ
Agentが取材した後に、書き手自身が確認すべきことは、次の4つにまとめられます。
- 出典:各情報について、具体的なページと著者までたどれるようにします。出典が見つからないものは、着想にとどめましょう。
- 完全性:ページ分割、途中切れ、読み取り失敗に注意し、最初の一部をすべてだと思い込まないようにします。
- 時点:リアクション数や文書の内容は、その時点の情報です。引用する際は時点を明記しましょう。
- 要約と原文の違い:要約は原文そのものではありません。引用前に原文に戻り、一つずつ照合しましょう。
「技術革新」から「急に部品が足りなくなったとき、自分でプリントするか」まで、Agentが短縮してくれるのは資料を探す道のりです。企画が成立するか、資料を引用できるかの判断は、自分で原文を読んで行う必要があります。Agentを取材助手として活用し、確認を決まった手順に組み込むことで、速さと信頼性を両立できます。
確認の際にもう一段階チェックを加えたい場合は、APIYI apiyi.com を通じて複数のモデルを呼び出し、要約を相互に比較できます。まずは、よく知っているウェブページから始めて、この手順を一通り試してみましょう。
📚 参考資料
- V2EX 投稿 – 同僚が Moli + Codex で Quora を読み、10件の回答から記事のテーマを探す様子を見て:本記事の事例の出典(プロモーション投稿と明記)
- リンク:
www.v2ex.com/t/1254246 -
説明:トピックのリンクからリストを整理するまでの一連の流れを記録。初回の読み取り失敗やページ分割、途中での切り捨てなどの詳細も含まれています
-
Moli オープンソースプロジェクトの公式リポジトリ:AI Agent 向けのオープンソースブラウザ
- リンク:
github.com/lexmount/moli - 説明:Moli のインストール方法や機能を確認できます。事例では、コンテンツの読み取りとネットワークレスポンスの確認機能を使用しています
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイトのトップページからお気軽にお問い合わせください。複数モデルの呼び出しに関する資料は、docs.apiyi.com のドキュメントセンターをご覧ください