著者注:公式デモと、智东西・TOKRACE による第三者の実測をもとに、LongCat-2.5 のスクリーンショットからのWebページ生成、インタラクティブなページ、3D生成における実力、典型的な失敗例、成果物を検収する際の注意点を解説します。
美団は 2026-11-02 に LongCat-2.5 を正式リリースしました。公式は Visual Coding(ビジュアルコーディング) を重点機能の一つに位置づけ、リアルタイムの流体シミュレーション、三星堆の青銅神樹の3D展示、写真からのイベント招待ページ生成などを紹介しています。これを見たフロントエンド開発者の多くが、まず気になるのは「デザインカンプやWebページのスクリーンショットを渡すだけで、そのまま納品できるページが手に入るのか?」という点でしょう。
この記事は、公式の宣伝をなぞるものではありません。公式デモは選び抜かれた成功事例ですが、第三者の実測では、完成度の高い作品がある一方、寸法が1000倍も間違った成果物も見られました。この記事では、この2種類の情報を照らし合わせ、根拠のある結論と、現時点ではまだ根拠がないことを整理します。
この記事でわかること:LongCat-2.5 のビジュアルコーディングでどこまでできるのか、Webページの納品時にどの5つの観点で検収すべきか、そしてどの工程を人が確認する必要があるのかを紹介します。
LongCat-2.5 のビジュアルプログラミング:主要情報まとめ
まず、ビジュアルプログラミングに関連する公開情報を表にまとめます。以下は美団の公式技術ブログ、APIドキュメント、リリース報道に基づく情報です。モデルの重みはリリース時点ではダウンロードできなかったため、「公式APIが利用可能」であることと「オープンソース化済み」であることは同じではありません。
| 項目 | 公開情報 |
|---|---|
| 正式リリース日 | 2026-11-02(Preview版は2026-09-25にAPIプラットフォームで公開) |
| 開発元 | 美団 LongCatチーム |
| モデル規模 | 総パラメータ数1.6T、1トークンあたり約48Bを活性化するスパースMoEアーキテクチャ |
| コンテキストウィンドウ | 1,048,576 Tokens(約1M) |
| 視覚入力 | 画像はPNG、JPG、JPEG、WebP、GIFに対応。動画はURLで入力 |
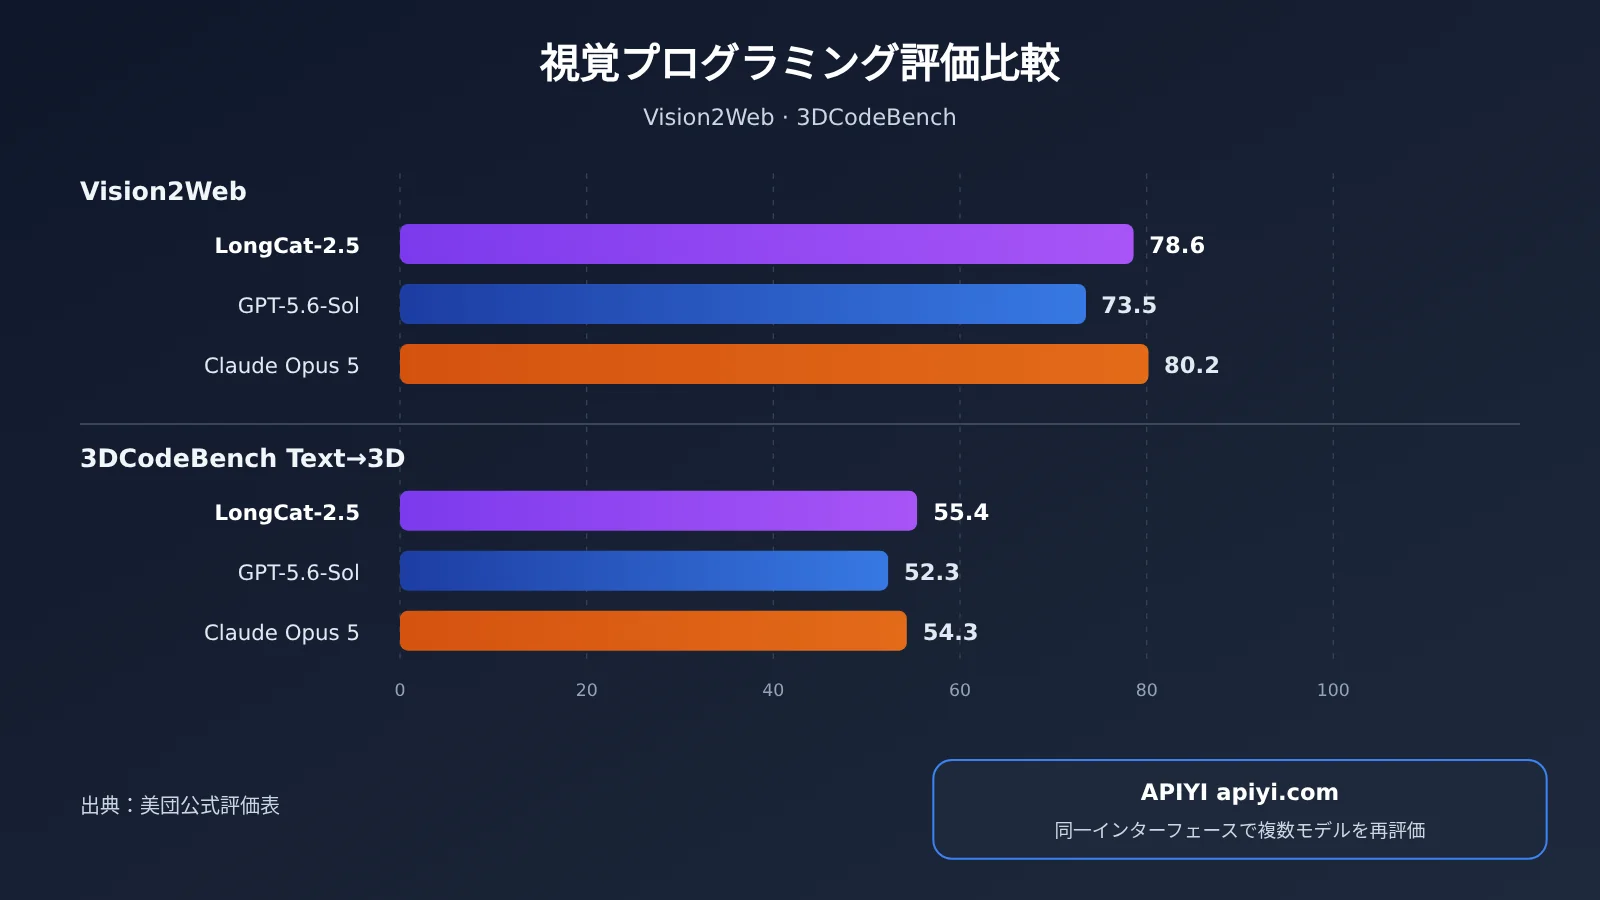
| ビジュアルプログラミング関連のスコア | Vision2Web 78.6、3DCodeBench Text→3D 55.4(公式表による) |
| インターフェース形式 | OpenAI互換とAnthropic互換の2形式 |
| オープンソース化の状況 | 正式版リリース時点では重みを公開しておらず、公式は今後公開するとしている |
特に注意したいのは、公式ドキュメントが対応を示しているのは画像と動画の理解であり、LongCat-2.5が画像生成や動画生成のインターフェースを提供しているわけではないという点です。第三者のテストに登場する画像や動画は、モデルが書いたコードをBlenderやブラウザなどのツールでレンダリングしたものです。
スクリーンショットの再現と視覚的な参照に基づくWebページ生成は別物
「スクリーンショットからWebページを作る」ことを議論する前に、2種類のタスクを区別しておく必要があります。1つ目は視覚的な参照に基づく生成です。会場の写真や雰囲気を伝える画像と、テキストによる要件を渡し、それに合ったスタイルのWebページをデザインしてもらいます。このタスクではレイアウトを自由に決められ、雰囲気が合っていれば成功と見なせます。
2つ目はスクリーンショットの厳密な再現です。既存のWebページのスクリーンショットを渡し、レイアウト、余白、フォント、インタラクション、レスポンシブ表示をできるだけ一致させるよう求めます。こちらは合格基準がはるかに厳しく、わずかなずれも目立ちます。公式のイベント招待ページの事例は前者に該当します。現時点では、後者についてLongCat-2.5の汎用的な再現精度を裏付ける独立したサンプルは十分になく、ピクセル単位の再現ができるとまでは言えません。
LongCat-2.5の視覚トークンの仕組み
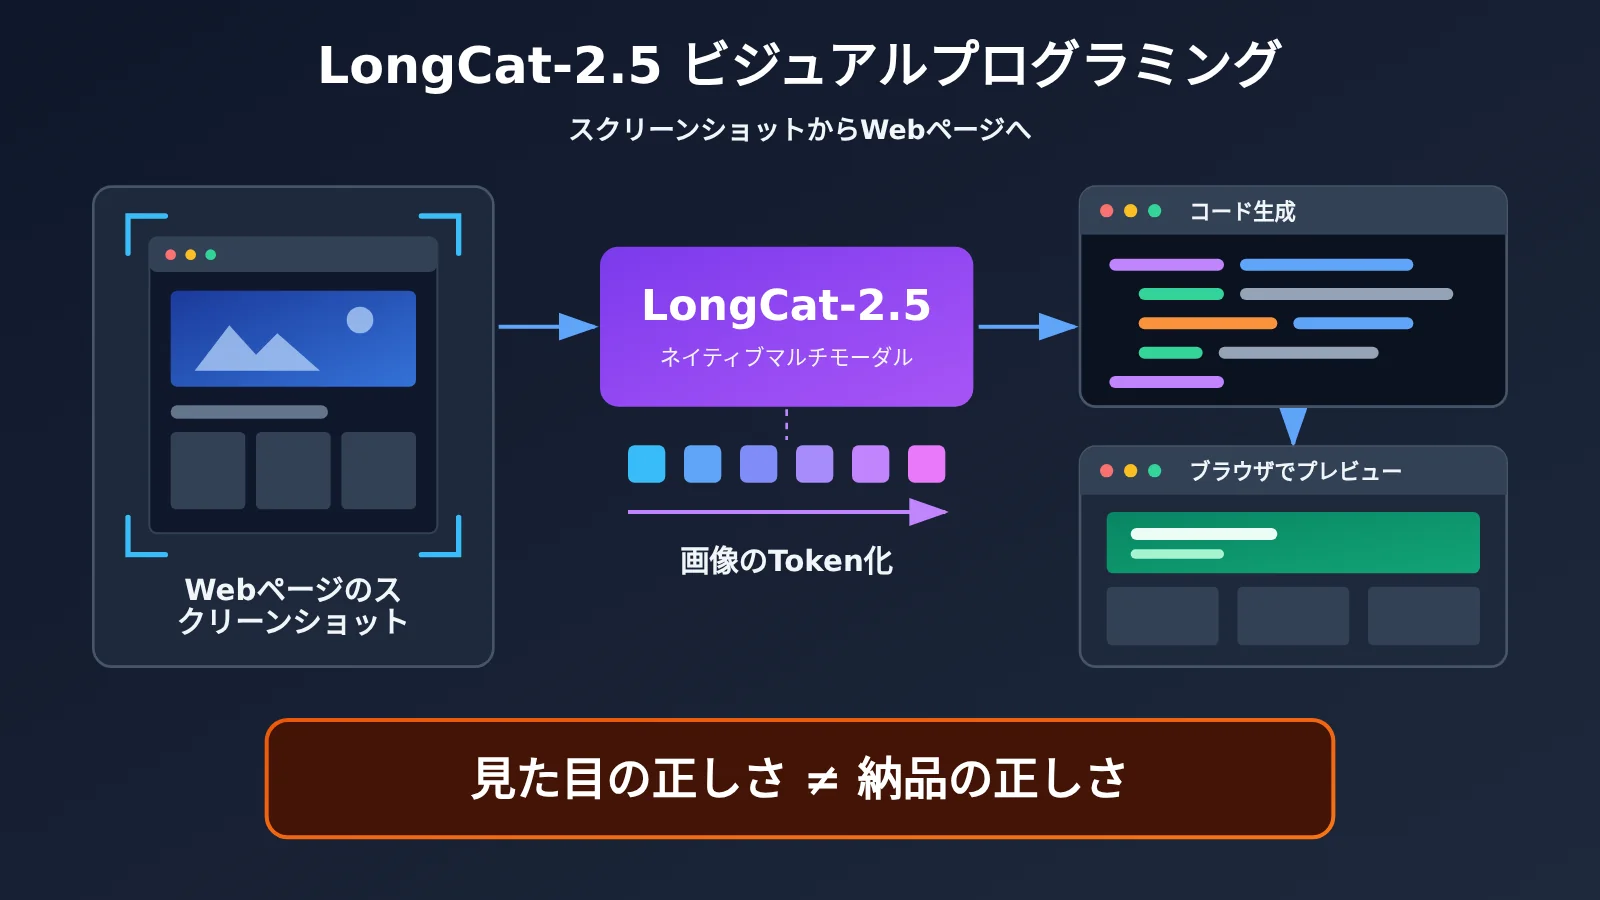
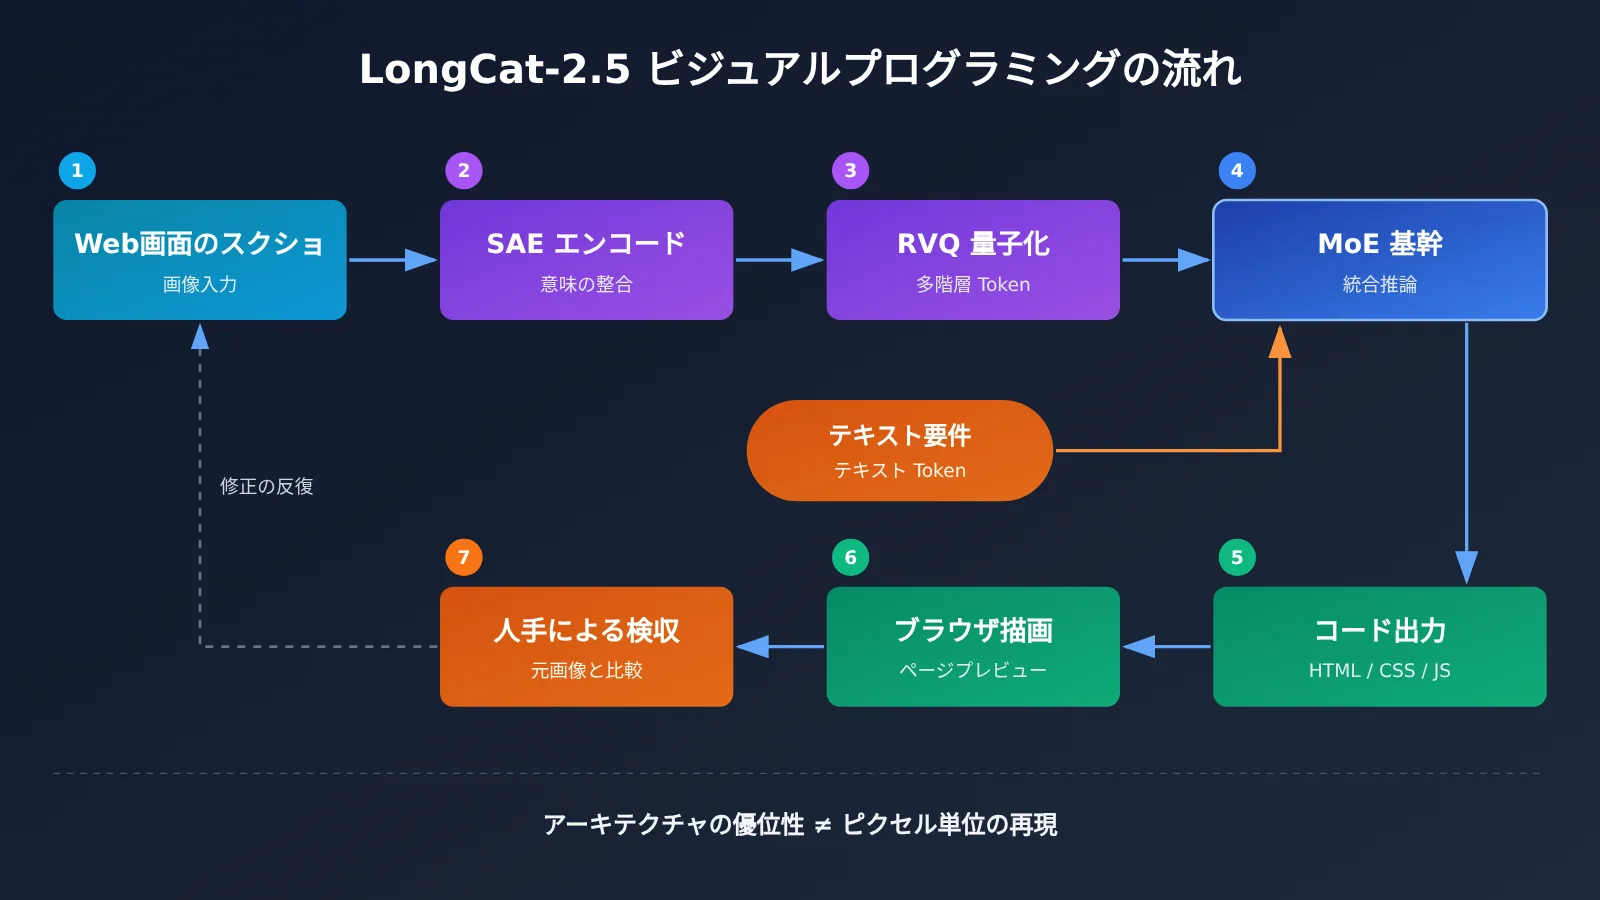
LongCat-2.5の「ネイティブマルチモーダル」は、画像の処理方法に由来します。公式情報によると、モデルはまずSAE(意味整合エンコーダー)で視覚的な特徴を抽出し、RVQ(残差ベクトル量子化)でその特徴を複数階層の離散トークンに変換します。最後に、それらをテキストトークンとともに基幹モデルに入力し、まとめて処理します。
この設計には、元の解像度を生かした視覚情報の離散化、視覚トークンのオフライン事前計算、視覚コードブックのEmbeddingと基幹モデルの共同学習も含まれます。開発者にとっては、画像を「文章による説明に変換」してからモデルに渡すのではなく、元の情報に近い形で推論やコード生成に利用する仕組みだと考えるとわかりやすいでしょう。ただし、アーキテクチャ上の強みはあくまで能力の基盤であり、すべてのスクリーンショットを正確に再現できることを意味するわけではありません。
LongCat-2.5のVision2Webスコアをどう見るか
公式発表には、ビジュアルプログラミングに直接関連するベンチマークが2項目あります。データはいずれも美団が公開した評価表に基づいています。比較対象は表内の2モデルのみで、2026-11-03時点の最新モデルすべてを網羅したものではありません。
| 評価項目 | LongCat-2.5 | GPT-5.6-Sol | Claude Opus 5 | 評価条件・内容 |
|---|---|---|---|---|
| Vision2Web | 78.6 | 73.5 | 80.2 | Claude Code v2.1.7、シーケンス長256K、top_k=50 |
| 3DCodeBench Text→3D | 55.4 | 52.3 | 54.3 | テキストから3Dコードを生成 |
| DeepSWE v1.1(参考) | 64.6 | 72.7 | 68.8 | 実際のリポジトリにおける問題修正、mini-swe-agent |
スコアを見ると、LongCat-2.5はText→3Dで公式比較表の首位に立っています。Vision2WebではGPT-5.6-Solを5.1ポイント上回る一方、Claude Opus 5を1.6ポイント下回っています。DeepSWEも参考にすることが重要です。ビジュアルプログラミングも最終的には実用的なコードに落とし込む必要がありますが、LongCat-2.5は実際のソフトウェアリポジトリの問題修正において、GPT-5.6-Solに8.1ポイントの差をつけられています。
さらに重要なのは、ベンチマークのスコアはピクセル単位の再現率でも、製品の受け入れテストの合格率でもないという点です。LongCat-2.5のデフォルトの評価設定では、思考モードが有効で、temperature=1.0、top_p=0.95となっています。また、各モデルのスコアには公開レポートに基づくものと美団が独自に測定したものが混在しており、テスト条件は完全には統一されていません。
💡 選び方のヒント:公開ランキングはあくまで参考です。実際に自分のスクリーンショットや要件で試してみることに意味があります。APIYI apiyi.comのようなOpenAI互換の集約インターフェースを使えば、同じテストスクリプトで複数のビジョンモデルの出力を比較し、メインで使うモデルを選べます。
LongCat-2.5のビジュアルプログラミング事例比較:成功と失敗
以下では、3つの情報源による事例をまとめて紹介します。公式デモは選ばれた成功事例であり、智东西とTOKRACEは第三者による少数のサンプルを使ったテストです。それぞれの証拠としての強さは異なるため、区別して読みましょう。
| 情報源 | タスク | 実際の要件 | 観察結果 |
|---|---|---|---|
| 公式デモ | リアルタイム流体シミュレーション | インタラクティブな流体のWebページ | マウスのクリックやドラッグで流体の動きを再現 |
| 公式デモ | イベント招待ページ | 会場の写真+自然言語による要件 | 写真に合ったスタイルで、申込フォーム、参加者リストの管理・エクスポート機能を搭載 |
| 智东西 | 自転車に乗るペリカンのアニメーション | HTMLアニメーション | 主体が明瞭でスタイルも一貫しているが、マフラーの一部の位置にずれがある |
| TOKRACE | 中国語のイベントポスターSVG | 指定された6つの中国語テキストを保持 | 6つとも正確に1回ずつ表示され、レイアウトも明瞭 |
| TOKRACE | 四半期データのグラフSVG | データに基づく棒グラフの作成 | 比率と合計値の84は正しいが、会計年度、米ドル単位、データの出典を捏造 |
| TOKRACE | 遊星減速機の3Dモデル | 寸法140mmと動画の納品 | 歯面が破損し、寸法を140mと記載。動画も納品されなかった |
| TOKRACE | 2ベッドルームの空間モデル | 室内レイアウトのモデリング | ドアや窓の開口部がなく、ベッドと間仕切りが重なり、2つ目の寝室の方位が誤っていた |
公式デモ:視覚的な参照とインタラクションを組み合わせた成功例
公式ブログでは8件のエンドツーエンドのタスクが紹介されています。そのうちWebページに直接関連するのは、流体シミュレーション、三星堆の青銅神樹の3D展示、都市模型、中国風のビジュアルデザイン、イベント招待ページです。三星堆の事例では、3D構造や質感に加え、回転・拡大縮小の操作にも対応する必要があります。一方、イベント招待ページでは、写真の雰囲気をページのスタイルに反映し、参加登録、名簿管理、表のエクスポートを実装する必要があります。
これらの事例から、LongCat-2.5には視覚的な要件を動作するフロントエンドコードに変換する能力があることが分かります。ただし、「あらゆるインタラクティブなWebページを一度で完成できる」ことや、ページのパフォーマンスが商用公開の基準に達していることまで証明するものではありません。
智东西の実測:全体の完成度は高いものの、細部には修正が必要
智东西は2026-11-02、LongCat-2.5にペリカンが自転車に乗るHTMLアニメーションを生成させました。記者によると、アニメーションは全体的な完成度が高く、主役がはっきりしていて、スタイルにも統一感があり、細部まで作り込まれていました。ただし、マフラーの位置にわずかなずれが見られました。
別のAmazon第3四半期決算のPPT作成タスクでは、分析の構成が整っており、トレンドを示すグラフ、構造図、リスクに関する注意喚起も含まれていました。記者が初期段階で照合した範囲では、明らかなデータの誤りは見つかりませんでした。問題は見せ方に集中しており、一部のページでは情報量が多く文字が小さいほか、断定的すぎる結論もありました。これはWeb開発にも通じる教訓です。内容が概ね正しくても、読みやすさやレイアウトが十分とは限りません。
TOKRACE の実測:制約が明確なほど成功率は高い
TOKRACE は LongCat-2.5 を Claude Code に接続し、Blender とブラウザを組み合わせて15件の制作タスクを実施しました。内訳は3Dが6件、解説動画が4件、静止 SVG が4件、アニメーションが1件です。成功したケースには、制約が明確で、構造がシンプルという共通点がありました。
- パラメトリックな本棚:幅0.8m・3区画版と幅1.0m・4区画版の寸法は正確で、板厚18mmも要件どおりでした。6枚の視点画像もすべて納品され、所要時間は約36分、リクエストは47回、出力は69,708トークンでした。
- 中国語のイベントポスター:約3分、10回のリクエストで完成しました。6つの中国語テキストはすべて正しく保持され、アイコンが本文を圧迫することもありませんでした。
- 4秒間のサイクリングアニメーション:車輪、ペダル、両脚の動きが同期していました。テスト側が40時点を抽出して確認したところ、足先とペダルの最大ずれは約0.19pxでした。ただし、淡い色の被写体はコントラストがやや低めでした。
一方、失敗例からは、ビジュアルプログラミングで見落としやすい問題が浮かび上がりました。遊星減速機のタスクでは、3つの遊星歯車の位置はおおむね正しかったものの、140mm が 140m と記述され、単位に1000倍の誤りが生じました。指定された動画も納品されませんでした。2部屋の住宅モデルは「見た目はリビングらしい」ものの、ドアや窓の開口部がない、ベッドと間仕切り壁が重なる、一部のカメラ視点が壁に遮られるといった構造上の問題がありました。時計の SVG では、9時41分を示す針の角度は正確でしたが、数字が太い目盛りと重なっていました。
TOKRACE は思考モードのオン・オフも比較しました。思考を有効にすると、一部の画面ではレイアウトがより明瞭になったものの、推論やリクエストのコストが大幅に増える可能性があります。自転車に乗るペリカンの SVG では、思考をオフにした場合は最初のリクエストで画像が完成しましたが、オンにした場合は5回目のリクエストでようやく完成しました。ただし、これは単一タスクでの観察にすぎず、思考のオン・オフそれぞれの平均成功率を導き出すことはできません。
LongCat-2.5のビジュアルコーディングを検収する5つの観点
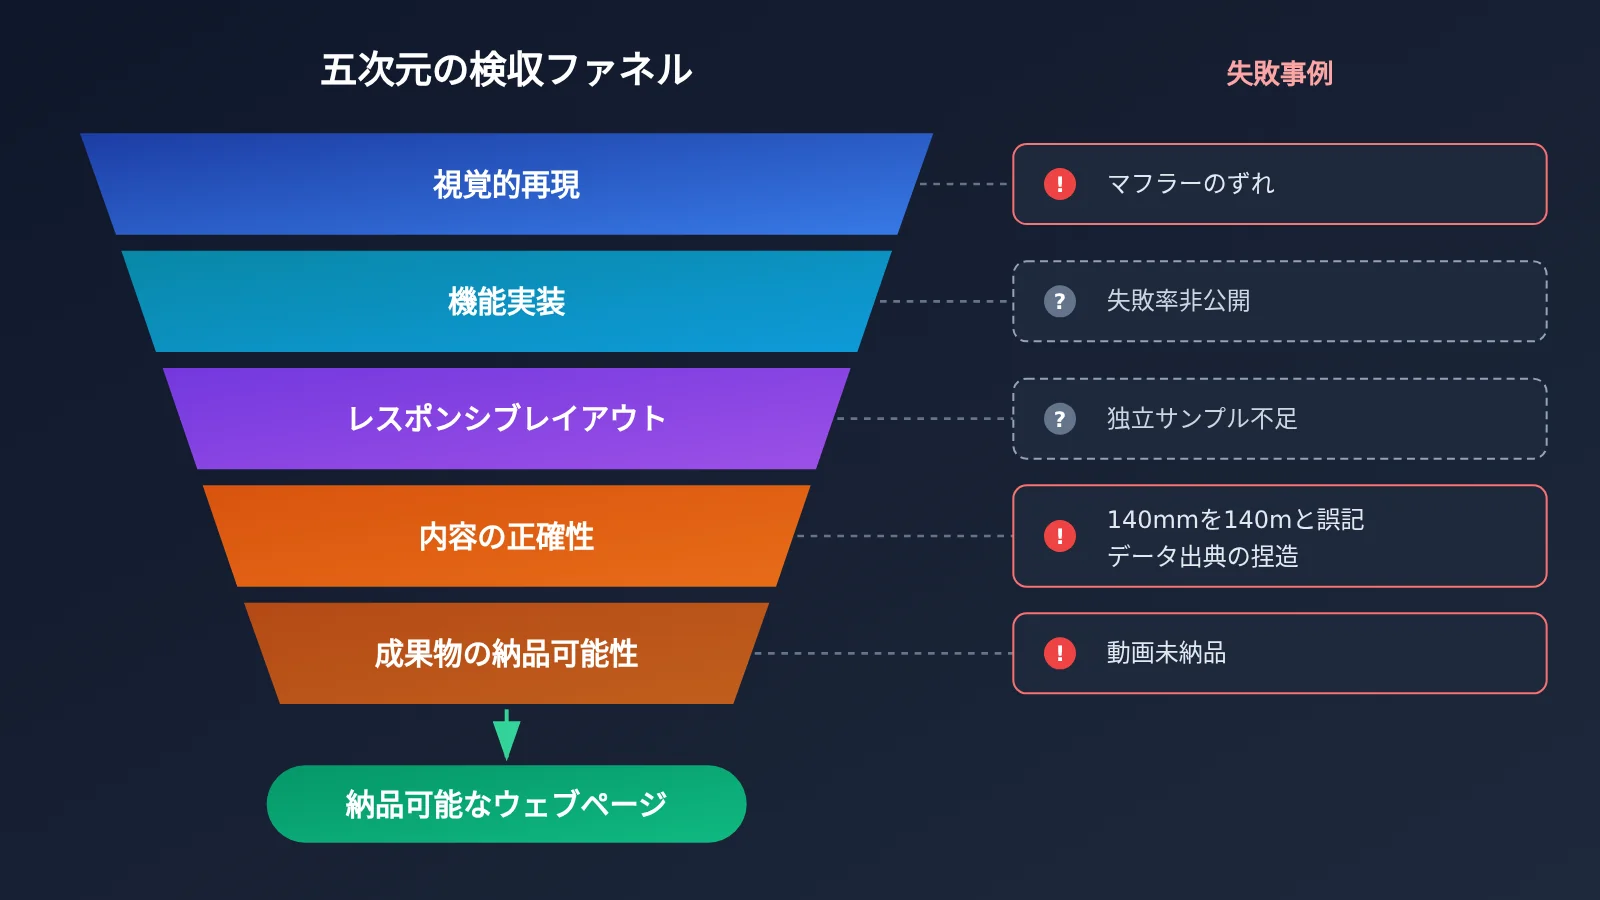
上の事例からわかるように、「見た目が合っている」ことと「納品できる」ことの間には、少なくとも4つの関門があります。以下の検収フレームワークは、事例をもとに整理した実務上のチェック方法であり、LongCatの公式評価基準ではありません。
| 検収の観点 | チェック内容 | 事例で明らかになったリスク | 推奨される確認方法 |
|---|---|---|---|
| 見た目の再現性 | 配色、レイアウト、フォント、余白、図形 | マフラーの位置ずれ、数字と目盛りの重なり | 元画像と重ねて比較し、領域ごとにスクリーンショットで確認 |
| 機能の実装 | クリック、ナビゲーション、フォーム、状態の変化 | 公式デモでは失敗率が公開されていない | 主な操作フローを手動で一通り試し、簡単なE2Eテストを書く |
| レスポンシブレイアウト | 画面幅によるはみ出しや重なりの有無 | 現時点では独立したサンプルが不足 | 少なくともスマートフォン、タブレット、デスクトップの3つのブレークポイントを確認 |
| コンテンツの正確性 | 数字、単位、文言、出典 | 会計年度やデータの出典を捏造、140mmを140mと記載 | すべての文字と単位を一つずつ照合 |
| 成果物の納品準備 | 依存関係のインストール、実行、ビルド、ファイルの過不足 | 動画が未納品、長時間のタスクがタイムアウトで中断 | 納品チェックリストを一項目ずつ確認 |
この5つの観点のうち、AIの生成結果に最も「だまされやすい」のは、コンテンツの正確性と成果物の納品準備です。配色がきれいでアニメーションも滑らかなページを見ると、架空のデータ出典が追加されていたり、ファイルが一つ納品されていなかったりすることを見落としがちです。スクリーンショットからWebページを作る際は、「モデルが余計に何を追加したか」を独立したチェック項目にすることをおすすめします。
APIでLongCat-2.5のスクリーンショットからWebページへの変換を試すには
自分のデザイン画像でLongCat-2.5を検証したい場合は、OpenAI互換形式で「画像+テキストの要件」を送信できます。画像はBase64と公開URLに対応し、1枚あたり最大10MB、1リクエストあたり最大50枚まで指定できます。元画像のアスペクト比が200:1を超えるとエラーになるため、縦長のスクリーンショットは事前に分割してください。
なお、この記事の確認日(2026-11-03)時点では、APIYIプラットフォームでLongCat-2.5が提供されていることは確認できていません。モデルの利用可否はAPIYIのモデル一覧をご確認ください。以下のスクリプトは標準のOpenAI形式を使用しています。同じコードで、まずプラットフォーム上の既存のビジョンモデルに接続して処理の流れを確認し、モデルが提供開始された後にモデル名を置き換えることもできます。
最小限のサンプル
import base64, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
img = base64.b64encode(open("screenshot.png", "rb").read()).decode()

resp = client.chat.completions.create(
    model="LongCat-2.5",  # APIYIのモデル一覧にある実際の名称を使用
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "按截图复刻为单文件 HTML,只用截图中出现的文字,不要补充任何数据"},
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{img}"}}
    ]}],
)
print(resp.choices[0].message.content)
完全な実装コードを見る(検収条件とリトライ処理を含む)
import base64
import time
import openai
from pathlib import Path

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

SYSTEM_PROMPT = """你是前端工程师。根据截图生成单文件 HTML(内联 CSS/JS)。
硬性要求:
1. 只使用截图中可见的文字,禁止补充数据、单位、来源或年份
2. 无法辨认的文字用 [待确认] 占位
3. 支持 375px / 768px / 1440px 三个断点
4. 代码末尾用注释列出:你做的假设、未实现的交互"""

def encode_image(path: str) -> str:
    data = Path(path).read_bytes()
    if len(data) > 10 * 1024 * 1024:
        raise ValueError("单张图片超过 10MB,请压缩后再试")
    return base64.b64encode(data).decode()

def screenshot_to_html(path: str, model: str = "LongCat-2.5",
                       retries: int = 3) -> str:
    img = encode_image(path)
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": [
            {"type": "text", "text": "请复刻这张网页截图。"},
            {"type": "image_url",
             "image_url": {"url": f"data:image/png;base64,{img}"}},
        ]},
    ]
    for i in range(retries):
        try:
            resp = client.chat.completions.create(
                model=model, messages=messages, max_tokens=16000
            )
            return resp.choices[0].message.content
        except openai.RateLimitError:
            time.sleep(2 ** i)  # 429によるレート制限時に指数バックオフ
    raise RuntimeError("多次重试失败")

if __name__ == "__main__":
    html = screenshot_to_html("screenshot.png")
    Path("output.html").write_text(html, encoding="utf-8")
    print("已生成 output.html,请按五维清单验收")
コードの設計には、説明しておきたい点が2つあります。1つ目は、システムプロンプトでデータ、単位、出典の追加を明確に禁止していることです。これは、TOKRACEのグラフの事例で見られた「会計年度やデータソースの捏造」を直接防ぐためです。2つ目は、モデルにコード末尾で自らの仮定を列挙させることで、人が確認する際に「推測した」部分をすぐに特定できるようにしていることです。思考モードの具体的なリクエスト構造については、LongCatの公式パラメータドキュメントを確認し、他のモデルのreasoningパラメータをそのまま流用しないでください。
🚀 クイックスタート:まずはAPIYIのapiyi.comで新規ユーザー向けの無料テスト枠を取得し、複雑さの異なるスクリーンショットを3〜5枚(ランディングページ、フォームページ、データダッシュボード)使って、全工程を試してみましょう。5つの観点のチェックリストで評価してから、正式なワークフローに組み込むかどうかを判断することをおすすめします。
LongCat-2.5のビジュアルプログラミングがもたらす影響
フロントエンド開発者への影響
- プロトタイプ作成の効率が大幅に向上:視覚的な参照資料からインタラクティブなページを素早く生成でき、企画のデモ、キャンペーンページの初稿、社内ツールに適しています。公式のイベント招待ページやTOKRACEのポスター事例もこのカテゴリに入ります。
- 検収作業はなくならない:モデルは「見た目が正しい」ページを作れますが、単位や文言、構造上の関係に関する誤りは見落としやすくなります。開発者の役割は、コードを書くことから、制約の設定と検収へと一部移っていきます。
- 制約は明確に書くほどよい:本棚の事例では、明確な寸法と納品物のリストを提示することで良好な結果が得られました。一方、曖昧な要求ではモデルが独自に解釈し、想定外の結果になりやすくなります。
AI Codingワークフローへの影響
LongCat-2.5の公式ドキュメントには、Claude Code、Codex、OpenCode、Clineなどのツールとの連携ガイドが用意されています。通常はBase URL、APIキー、モデル名を変更するだけで利用できます。つまり、別途チャットウィンドウを開かなくても、既存のエージェントワークフローにビジュアルプログラミングを組み込めます。ただし、API形式の互換性があっても、すべてのツールの機能やパラメータが完全に一致するわけではありません。また、長時間のタスクではタイムアウトや中断が発生することもあり、TOKRACEの動画タスクの一部はそのために完了しませんでした。
コスト面では、公式が現在表示している期間限定の割引価格は、キャッシュ未ヒットの入力が¥2.00、キャッシュヒットの入力が¥0.04、出力が¥8.00です(いずれも100万Tokenあたり)。実際の料金は公式プラットフォームと請求内容を確認してください。本棚のような複数ターンのタスクでは、出力が約7万Tokenに達しています。ビジュアルプログラミングのバッチタスクを計画する際は、単価以上にリクエスト回数と出力の長さに注目するとよいでしょう。
LongCat-2.5でスクリーンショットからWebページを作る際の使用範囲
これまでの検証結果を踏まえると、使用シーンは次の3段階に分けられます。
| 段階 | 典型的なシーン | 推奨する使い方 |
|---|---|---|
| そのまま使える | キャンペーンページの初稿、SVGポスター、シンプルなインタラクティブアニメーション、社内デモページ | 生成後に見た目と文言をチェックする |
| 人による確認が必要 | スクリーンショットを再現した公開用ページ、データチャート、レスポンシブなランディングページ、複数ステップのフォーム | 5つの観点からチェックリストに沿って検収し、特にデータと単位を確認する |
| 依存を推奨しない | 高精度な設計寸法、空間構造の設計、ピクセル単位の再現が必要なブランドページ、無人で実行する長時間タスク | 下書きのみに使用し、最終的な成果物は人が仕上げる |
💰 コストに関するアドバイス:ビジュアルプログラミングでは複数回の反復作業が必要になることが多いため、まず少数のスクリーンショットで1ページあたりの平均Token消費量を試算するのがおすすめです。APIYI apiyi.comは従量課金制で、請求を一元化できるため、複数のモデル間で1ページあたりのコストを比較しやすくなります。
よくある質問 FAQ
Q1:LongCat-2.5 はスクリーンショット1枚から完成したWebページを作れますか?
動作するWebページは生成できますが、そのまま納品できるほど完成しているとは限りません。公式デモや第三者テストでは、視覚的な参照をインタラクティブなフロントエンドコードに変換できることが示されています。ただし、スクリーンショット再現の汎用的な精度を裏付ける独立した検証結果はまだなく、ピクセル単位で再現できるとも断言できません。
Q2:LongCat-2.5 の Vision2Web のスコアは Claude Opus 5 と比べてどうですか?
公式の表では、LongCat-2.5 が 78.6、Claude Opus 5 が 80.2、GPT-5.6-Sol が 73.5 です。LongCat-2.5 は Text→3D ではリードしていますが、Vision2Web では Claude Opus 5 をわずかに下回っています。いずれも美団が公表したデータで、テスト条件は完全には統一されていないため、ご自身のタスクでも検証することをおすすめします。
Q3:LongCat-2.5 のビジュアルプログラミングで最もよくある失敗は何ですか?
TOKRACE のテストでは、主に4種類の失敗が見られました。単位の間違い(140mm を 140m と記載)、空間構造の間違い(ベッドと間仕切りが重なる)、存在しない内容の追加(グラフに存在しないデータソースを追加)、成果物の不足(指定された動画が生成されない)です。これらの問題は見た目では気づきにくいことも多いため、個別に確認する必要があります。
Q4:APIYI を通じて LongCat-2.5 を呼び出せますか?
2026-11-03 時点では、APIYI プラットフォームで LongCat-2.5 が利用可能になっていることは確認されていません。APIYI apiyi.com の最新のモデル一覧をご確認ください。まずは本文の OpenAI 互換スクリプトを使い、プラットフォームで利用できる既存の視覚モデルで検証手順を試せます。モデルが利用可能になったら、モデル名を置き換えるだけです。
Q5:スクリーンショットから Web ページを作る際は、思考モードを有効にしたほうがよいですか?
一概には言えません。TOKRACE では、思考モードを有効にすると一部のレイアウトが見やすくなる一方、コストが大幅に増える可能性も観察されました。また、ペリカンの SVG の比較では、思考モードを無効にした場合に初めて画像が生成されました。APIYI apiyi.com で同じスクリーンショットを使ってそれぞれ試し、実際の成功率とトークン消費量をもとに判断することをおすすめします。
Q6:LongCat-2.5 は画像や動画を生成できますか?
公式 API がサポートしているのは画像と動画の理解であり、生成ではありません。第三者テストで作られた画像、動画、3D 映像は、いずれもモデルが書いたコードをブラウザや Blender などのツールでレンダリングしたものです。モデル自体に備わった画像生成能力とは見なせません。
LongCat-2.5のビジュアルプログラミング:要点
- 能力の位置づけ:LongCat-2.5は視覚的な参照素材を実行可能なWebページのコードに変換できますが、スクリーンショットをピクセル単位で再現できるわけではありません。
- 公式スコア:Vision2Webは78.6でClaude Opus 5をわずかに下回り、Text→3Dは55.4で公式比較表のトップです。
- 成功しやすい条件:ポスターのSVGやパラメータで調整できる書棚など、制約が明確で構造がシンプルなタスクは完成度が高くなります。
- 失敗しやすいポイント:単位、空間的な位置関係、架空の内容、成果物の不足が主なリスクです。
- 検収方法:視覚的な再現度、機能、レスポンシブ対応、内容の正確性、成果物の完成度の5つの観点から確認します。
- 始め方:APIYI apiyi.comでは、OpenAI互換のスクリプトでテスト環境を構築できます。LongCat-2.5の利用可否はモデル一覧で確認してください。
まとめ
LongCat-2.5によるスクリーンショットからWebページへの変換について、結論をまとめます。
- プロトタイプは作れても、そのまま納品できるとは限らない:公式事例と第三者によるテストの両方でビジュアルプログラミングの能力が示されていますが、スクリーンショットから公開できるページまでには、まだ大きな隔たりがあります。
- 見た目が正しいことは第一関門にすぎない:インタラクション、レスポンシブ対応、内容の正確性、成果物の完成度は別々に検収する必要があります。特に「モデルが余計に何を追加したか」は見落とされがちです。
- 制約を設けて安定性を高める:サイズ、文言、ブレークポイント、納品物のリストを明確にし、プロンプトでデータの追加を禁止することで、モデルの自由な補完によるミスを大幅に減らせます。
ビジュアルプログラミングを日々の開発に取り入れるなら、まずは実際のスクリーンショットを使って少数のサンプルでテストし、本文で紹介した3段階の境界に沿って利用範囲を決めることをおすすめします。APIYI apiyi.comの統一インターフェースを使えば、複数の画像対応モデルの実際の性能を比較できます。新規ユーザー向けの無料枠もあり、低コストで検証できます。
📚 参考資料
- LongCat-2.5 公式技術ブログ:モデルアーキテクチャ、ベンチマーク、公式デモ事例
- リンク:
longcat.ai/blog/longcat-2.5 -
概要:Vision2Web、3DCodeBench のスコアと評価条件の一次情報
-
美団技術チームブログ:LongCat-2.5 の視覚トークンに関する技術解説
- リンク:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
概要:SAE、RVQ などの視覚エンコーディングの仕組みを紹介
-
LongCat 視覚理解 API ドキュメント:画像・動画の入力制限
- リンク:
longcat.ai/platform/docs/image-video-understanding -
概要:画像の形式、サイズ、枚数、アスペクト比の制限
-
智东西の実測レポート:ペリカンのアニメーションと決算報告 PPT のテスト
- リンク:
tech.ifeng.com/c/8xjHpT7wJEN -
概要:メディアの視点による正式版の使用レポート
-
TOKRACE の正式版テスト:15 件の制作タスクの事例記録
- リンク:
www.tokrace.com/zh-CN/guides/longcat-2-5-release - 概要:元画像、プロジェクト、実行記録を掲載。成功例と失敗例の両方を収録
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のホームページ apiyi.com からお気軽にお問い合わせください。連携に関する詳しい資料は、ドキュメントセンター docs.apiyi.com をご覧ください。