著者注:DeepSeek Super-agent の Router + Worker 二層アーキテクチャを読み解き、全体の調整と独立した実行をどう分離しているのか、また開発者が自身の Agent システムに同様の設計を採用する価値があるのはどんなときかを解説します。
Coding Agent のウィンドウを同時に4〜5個開いていると、現実的な問題に直面します。あるウィンドウではログインのバグを修正し、別のウィンドウではデータベースのマイグレーションをレビューし、また別のウィンドウでは CI の結果を待っている。それぞれ何をしているのか、どの Agent が返答を待っているのか、どのタスク同士が関連しているのかを把握しておく必要があります。モデルは確かに自律的に作業できるようになってきましたが、そうしたセッションを管理する負担は人間にかかっています。
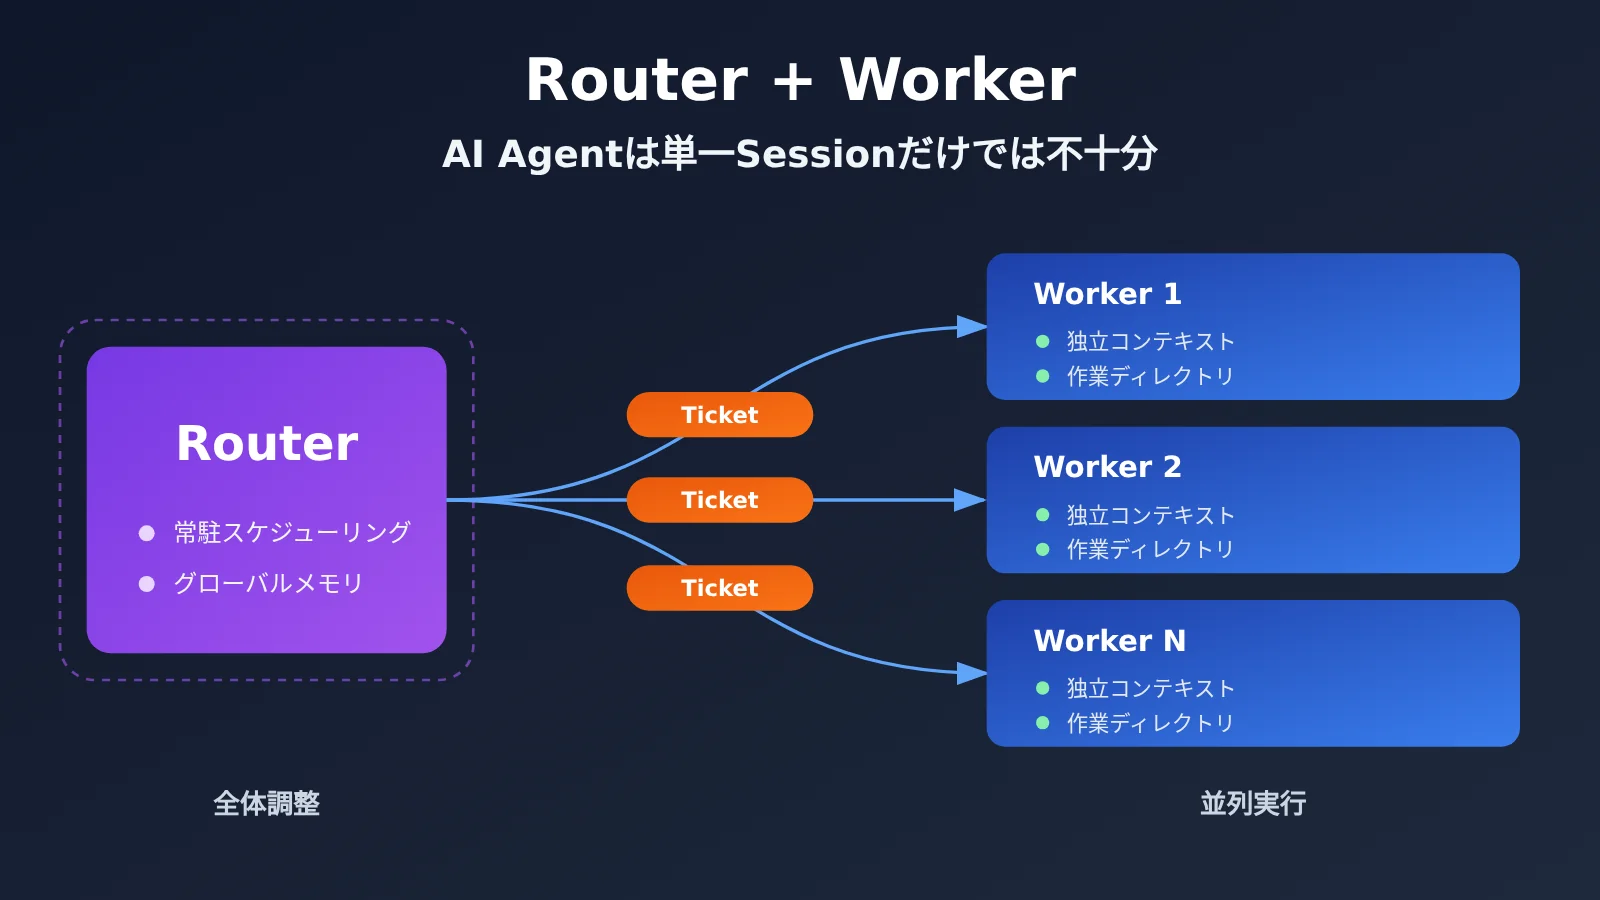
2026年10月31日、DeepSeek Harness チームは技術記事「Super-agent の設計探究:より自律的な Agent システムに向けて」を公開し、研究用プロトタイプ dsh-superagent-prototype を MIT ライセンスでオープンソース化しました。その中核となる設計が、Router + Worker の二層アーキテクチャです。常駐する Router が全体の調整を担当し、分離された複数の Worker が具体的な作業を実行します。
これは「1つの AI に同時にもっと多くの仕事をさせる」というだけの話ではありません。Super-agent のポイントは、システムアーキテクチャによって全体の調整と独立した実行を分離し、人間が複数のセッションを管理する負担を減らすことにあります。この記事では「問題・仕組み・根拠・エンジニアリング上の価値」の順に、このアーキテクチャの設計背景や重要な仕組み、公式の実験データ、そして API 呼び出しとコスト管理への示唆を解説します。
この記事のポイント:Router + Worker の二層アーキテクチャが本当に解決する問題を理解し、自身の Agent システムに同様の設計を採用する価値があるかどうかを判断できるようになります。
Router + Worker の要点をチェック
アーキテクチャを詳しく見る前に、今回の公開に関する基本情報を整理しましょう。重要なのは、DeepSeek がオープンソースとして公開したのは研究用プロトタイプであり、正式な商用製品でも新しい基盤モデルでもないという点です。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026年10月31日(技術記事と GitHub リポジトリを同日公開) |
| 公開元 | DeepSeek Harness チーム |
| プロジェクト名 | dsh-superagent-prototype。主に TypeScript を使用し、MIT ライセンスで公開 |
| プロジェクトの位置づけ | 研究用プロトタイプ。正式な商用製品ではなく、動作には DeepSeek Harness が必要 |
| コアアーキテクチャ | Router による全体のスケジューリングと、Worker による隔離された実行を組み合わせた2層構造 |
| 現在の対応機能 | 単一の GitHub リポジトリの監視、任意での飛書(Feishu)連携、Ticket 管理、独立した Worker セッションと PR の生成 |
| コミュニティの関心 | 11月2日時点で約8,900 Star、898 Fork(数値は変動中) |
公式は Super-agent の目標として、Continuous(チャネルをまたいだコンテキストの連続性)、Productive(複数タスクの並列処理)、Proactive(権限の範囲内でイベントに能動的に対応)、Persistent(継続的に稼働し、一部の異常から復旧可能)の4つを挙げています。これらは設計上の目標であり、オープンソースのプロトタイプですべて実現済みというわけではありません。
なぜ AI Agent のセッションは1つでは足りないのか
DeepSeek チームは、AI コーディングツールのボトルネックが「モデルの能力」から「人間の注意力」へと移りつつあると考えています。チームの日常的な観察によると、1人が効率的に追いかけられる稼働中の Agent セッションは、通常3〜5個程度です。これはチームの経験に基づく見解であり、公開された大規模なユーザー統計ではありませんが、多くの開発者の実感に近いものです。
単一セッションと複数セッションのジレンマ
よく使われる2つの方法には、それぞれ大きな弱点があります。Router + Worker は、「全体のコンテキストの連続性」と「バックグラウンドでの並列処理能力」を両立するために提案されました。
| アーキテクチャ | メリット | 主な問題 |
|---|---|---|
| 単一セッションですべての作業を処理 | 全体のコンテキストが自然に維持される | タスクの情報が互いに干渉する。時間のかかるツール呼び出しが新しいタスクをブロックする。単一の ReAct Loop に制約される |
| タスクごとに独立したセッションを用意 | 並列実行が可能で、コンテキストも隔離される | 全体を把握するための記憶がない。人間がタスク間の関係を覚えておく必要がある。会話や通知が複数のウィンドウに分散する |
| Router + Worker の2層アーキテクチャ | 全体の状態を一元管理しつつ、実行コンテキストを隔離できる | 推論リソースの消費が増え、Router がボトルネックになる可能性がある |
単一セッションの問題は「詰まる」こと、複数セッションの問題は「散らばる」ことです。前者では、1つのコンテキストウィンドウがすべてのタスクの中間ステップを抱え込みます。後者では、調整の負担がすべて人間にのしかかります。DeepSeek は、システムに「全体を覚えておく」専任の役割を設けることで、実行担当が作業に集中できるようにする、というアプローチを取っています。
Router + Workerの2層アーキテクチャはどう動く?
Router:調整に専念するグローバルな管理層
Routerは常時稼働する論理レイヤーです。公式が現在検討しているアーキテクチャでは、主に常駐するLLM Sessionとして実装されていますが、概念上は必ずしも単一のモデルセッションと同一ではありません。その役割は、作業を「実行する」ことではなく「管理する」ことにあります。
- ユーザーメッセージやGitHub、IM、CIなどの外部イベントを一元的に受け取る
- タスク間の関連を全体的に管理し、新しい作業を作成する必要があるか判断する
- 権限を確認してWorkerにタスクを割り当て、タスク間の調整を行う
- 人に伝えるべき情報をまとめ、必要に応じて過去のタスクのコンテキストを呼び戻す
重要な点として、公式はRouterにBashツールを持たせなくてもよいと考えています。Router自身に複雑なプログラミングを実行させなければ、長時間のツール呼び出しによってRouterがブロックされるのを防げます。また、Routerのタスクには必ずしも最高性能の推論モデルは必要なく、軽量なモデルでも対話やタスクの振り分けに対応できる場合があります。これは「役割ごとに異なるモデルを設定する」ための技術的な根拠にもなります。
Worker:分離された環境で作業を実行するタスク層
Workerは具体的な作業を担当します。公開されているプロトタイプでは、1つのTicketに1つのExecutor Sessionが対応し、Ticketごとに独立した作業ディレクトリが用意されます。Workerは権限の範囲内でコードの変更、テストの実行、その後のフィードバックへの対応を行い、完了後にReportを作成します。人間の判断が必要な場合はAttention状態に設定され、結果は元のチャネル(GitHub PRなど)を通じて届けられます。
各Workerのモデルコンテキストは互いに独立しているため、複数タスクの途中経過が同じウィンドウに混在する問題を解消できます。ただし、Sessionとディレクトリが独立していることは、強固なセキュリティ分離を意味しません。公式のデプロイドキュメントによると、Workerはデフォルトで操作者のOSユーザーとしてコマンドを実行します。
GitHub IssueはRouter + Workerの仕組みでどう処理される?
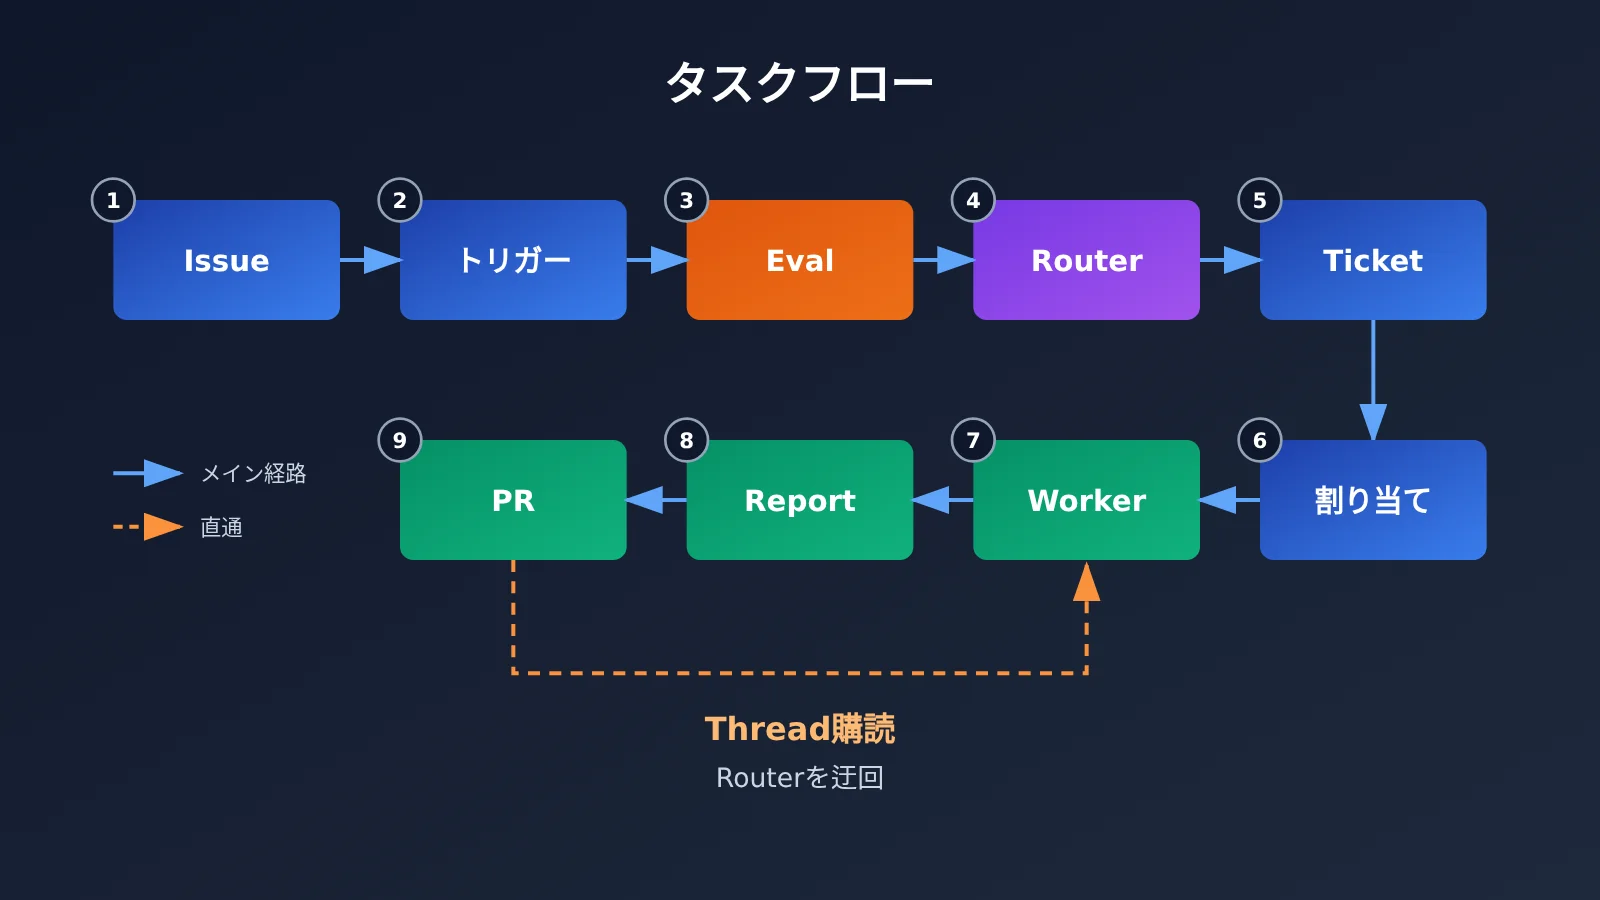
オープンソース実装のDomain Modelによると、タスクの流れはSource → Trigger → Eval → Decision → Ticket → Assignment → Executor → Reportと整理できます。ここでは「権限を持つユーザーがGitHub Issueでバグ修正を依頼する」ケースを例に見てみましょう。
- GitHub SourceがIssueのコメントを受け取り、Triggerを生成する
- システムがまず決定論的なルールで権限をフィルタリングし、次にモデルが受け付け条件を満たしているか判断する
- Routerがタスクを受け付けてTicketを作成し、タスクの範囲と権限(Mandate)を記録する
- システムがTicketに対するAssignmentを作成し、対応するWorkerに割り当てる
- Executorが独立したディレクトリとSessionで修正を実行する
- Workerが進捗を報告するか、作業結果を提出してPRを作成する
- システムが元のIssueまたはPRのスレッドを通じて、ユーザーに結果を届ける
その後、ユーザーがこのPRで修正を依頼した場合、新しいメッセージは元のタスクに自動的に関連付けられます。ユーザーは「あの作業を担当していたAgentのセッションはどれだったか」と探し直す必要がありません。これは、2層アーキテクチャが人間の管理負担を軽減する具体例です。
Router + Workerの4つの重要な設計
二層アーキテクチャはあくまで骨格です。実用性を支えているのは、特定の課題に対応するいくつかのエンジニアリング設計です。
| 設計 | 解決するエンジニアリング上の課題 | 中核となる仕組み |
|---|---|---|
| Threadの直接購読 | 後続メッセージがすべてRouterを経由し、中央ノードの負荷が大きくなる | Workerが担当するThreadを購読し、関連イベントを直接受け取る |
| Routerのバッチ処理 | イベントが突発的に増えた際、Routerが1件ずつ処理するためスループットが制限される | 推論中に蓄積されたTriggerを1つのバッチにまとめて分析する |
| Inline & Spill | コンテキストウィンドウには限りがあり、すべての情報を投入するとコストが高い | 直近で必要な情報をウィンドウに入れ、長い内容は要約と読み取り先だけを残す |
| 連鎖的な検索 | 過去のタスク情報を見つけ出しにくい | Trigger、Thread、Ticket、Workerの関連をたどって段階的に遡る |
Threadの直接購読:Routerによる繰り返しの振り分けを減らす
Worker AがあるPRを担当しているとします。このPRに対する後続のコメントやCIの結果は、Threadの担当に基づいてWorker Aに直接届けられます。Routerが関連メッセージのたびに振り分けを判断し直す必要はありません。これは「頻度が高く、価値の低い判断を中央ノードから切り離す」典型的な設計です。
ただし、直接購読には明確な権限上の境界があります。公式の権限に関するドキュメントには、購読メッセージはコンテキストとして利用できますが、元のTicketのMandate(権限範囲)を拡大することはできないと明記されています。後続のコメントで権限範囲外の新たな作業が求められた場合、Workerはシステムに処理を戻し、再評価を求める必要があります。これは、外部からのコメントに含まれる権限逸脱の指示を防ぐうえで重要です。
Routerのバッチ処理:突発的なイベントに対応する
Routerが推論を実行している間に新たなTriggerが届くと、それらはいったん蓄積され、次の推論時に1つのバッチとしてまとめて分析されます。これは「メッセージごとに1回モデルを呼び出す」方式を「1回の推論で複数のメッセージを処理する」方式に変えるものです。イベントが集中した際に、判断1件あたりの推論コストを大幅に抑えられます。
Inline & Spillと連鎖的な検索:コンテキストをキャッシュとして扱う
DeepSeekはコンテキストウィンドウを一種のキャッシュと捉えています。Inlineでは、現在のタスクに関する最新のコメント、関連するコード行と必要な周辺コードなど、直近で使う可能性が高い情報をウィンドウに直接入れます。Spillでは、長い過去の議論など、使用頻度が低い、または長すぎる内容をウィンドウの外に置き、要約、関連ID、読み取り先だけを残します。無関係な過去のメッセージは、毎回投入する必要がありません。
さらに、この考え方を発展させたのがChain of Recall(連鎖的な検索)です。モデルはTrigger → Thread → Ticket → Workerというオブジェクト間の関連をたどり、必要に応じて過去の情報を段階的に取り出せます。これは「毎回すべての履歴を詰め込む」よりもコンテキストを節約でき、データベースでインデックスを使って検索する考え方に近いものです。ただし公式も、数か月以上にわたる長期記憶は依然として未解決の課題だと認めています。
Router + Workerの実験データを読み解く
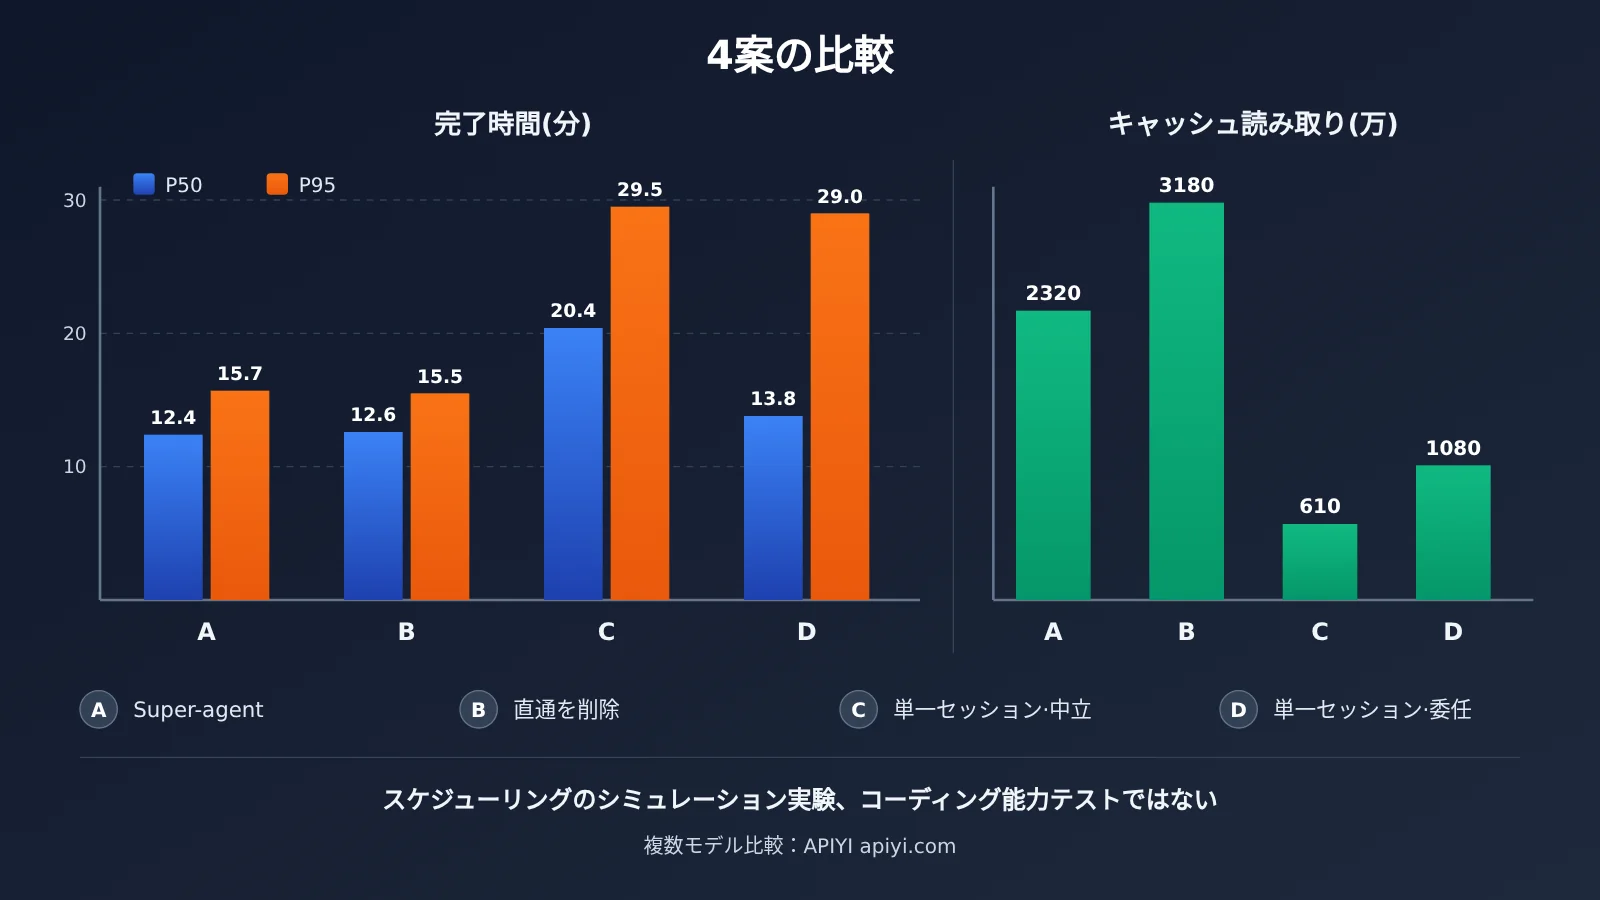
DeepSeekは、合成負荷を使った予備実験を行いました。各シミュレーションでは約300件のメッセージを処理し、そのうち約20件が作業依頼、残りは雑談、追加のフィードバック、キャンセル依頼、CIメッセージでした。各方式は5回ずつ実行されています。プログラミング作業は時間のかかる模擬ツールに置き換えられているため、このデータが測定しているのはスケジューリングシステムの性能であり、コード生成の品質ではありません。
エンドツーエンドのスケジューリング比較
| 方式 | P50完了時間 | P95完了時間 | 実験1回あたりのキャッシュ読み取りトークン数 |
|---|---|---|---|
| Super-agent | 12.4分 | 15.7分 | 約2320万 |
| Super-agent、サブスクリプションの直接転送を削除 | 12.6分 | 15.5分 | 約3180万 |
| 単一Session + Subagent、中立的なプロンプト | 20.4分 | 29.5分 | 約610万 |
| 単一Session + Subagent、委任優先 | 13.8分 | 29.0分 | 約1080万 |
中立的なプロンプトを使った単一セッション方式と比べると、Super-agentのP50完了時間は約39%、P95は約47%短縮されています。委任優先の単一セッション方式との比較では、P50の差はわずかですが、P95の長い待ち時間は大幅に短くなっています。つまり、2層アーキテクチャの最大のメリットは、最も遅いタスクの完了までにかかる時間を短くできることです。
その代償も明確です。Super-agentのキャッシュ読み取り量は、中立的なプロンプトを使った単一セッション方式の約3.8倍でした。より多くのセッションを並列に実行し、推論リソースを使うことで、完了時間の短縮と安定化を実現しています。ただし、これは総費用が3.8倍になることを意味するわけではありません。実際の費用は、モデルの単価、キャッシュヒット、通常の入出力トークン数、RouterとWorkerに選ぶモデル、ツール呼び出しにも左右されます。また、実際の作業依頼にかかる平均API費用は、公式にはまだ公表されていません。
サブスクリプションの直接転送に関するアブレーション実験も注目に値します。直接転送を削除すると、Routerが処理する判断の数は約30%、キャッシュ読み取りトークン数は約37%増加しましたが、完了時間はほぼ変わりませんでした。このテストでは、サブスクリプションの直接転送は、処理を直接高速化するというより、主にRouterのモデル呼び出しとコンテキストのオーバーヘッドを削減する役割を果たしていたといえます。
Routerのバッチ処理負荷テスト
このテストでは、Routerに実際のモデルを、Workerに模擬モデルを使用しています。
| 指標 | イベント密度が低い場合 | イベント密度が高い場合 |
|---|---|---|
| イベントの到着速度 | 毎分約1件 | 毎分約40件 |
| 平均バッチサイズ | 1.0 | 2.8 |
| モデルリクエスト1回あたりの所要時間 | 2.5秒 | 3.9秒 |
| 判断1件あたりの推論時間 | 6.4秒 | 1.6秒 |
イベント密度が高くなると、リクエスト1回あたりの処理は遅くなった一方で、判断1件あたりの推論時間は短くなりました。これは、バッチ処理によって実効スループットが向上したことを示しています。公式の結論は控えめで、現在のチーム規模では当面Routerは1つで足りるものの、1つのRouterで無制限にメッセージを処理できると推論することはできません。
Router + Worker が開発者に与える影響
モデルの階層化:Router には軽量モデル、Worker にはタスクに応じたモデルを選ぶ
2層アーキテクチャから得られる、最も直接的なエンジニアリング上の示唆は、役割ごとに同じモデルを使う必要はないということです。Router の主な仕事は分類、振り分け、要約なので、高速で低コストなモデルが適しています。一方、Worker にはタスクの複雑さに応じて、推論能力の高いモデルを選びます。このプロトタイプでは、Router と Worker それぞれにモデルプロバイダーとモデルを指定できます。
以下は、同じ OpenAI 互換インターフェースを使って、Router に振り分けを判断させる最小限の例です。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース。1つのキーで複数社のモデルを切り替え可能
)

ROUTER_MODEL = "your-fast-cheap-model"   # コンソールで利用可能な軽量モデル名に置き換えてください

resp = client.chat.completions.create(
    model=ROUTER_MODEL,
    messages=[{"role": "user", "content": "判断这条 Issue 评论是否需要新建 Ticket:修复登录页 500 错误"}]
)
print(resp.choices[0].message.content)
Router + Worker の階層別呼び出しコード例を見る
import json
import openai
from typing import Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 役割とモデルの階層化:モデル名は実際に利用可能なものに置き換えてください
ROLE_MODELS: Dict[str, str] = {
    "router": "your-fast-cheap-model",
    "worker_simple": "your-mid-tier-model",
    "worker_complex": "your-strong-reasoning-model",
}

usage_log = []  # Ticket ごとにトークン消費量を記録

def call(role: str, ticket_id: str, prompt: str) -> str:
    resp = client.chat.completions.create(
        model=ROLE_MODELS[role],
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    usage_log.append({
        "ticket": ticket_id, "role": role,
        "input": u.prompt_tokens, "output": u.completion_tokens,
    })
    return resp.choices[0].message.content

def router_dispatch(ticket_id: str, event: str) -> str:
    prompt = (
        "你是任务调度器,只做分类,不执行任务。"
        "输出 JSON:{\"accept\": bool, \"complexity\": \"simple\"|\"complex\"}\n"
        f"事件:{event}"
    )
    decision = json.loads(call("router", ticket_id, prompt))
    if not decision["accept"]:
        return "ignored"
    role = "worker_complex" if decision["complexity"] == "complex" else "worker_simple"
    return call(role, ticket_id, f"在授权范围内处理任务:{event}")

print(router_dispatch("T-001", "CI 失败:单元测试 test_login 超时"))
print(usage_log)
🎯 技術的なアドバイス:階層型 Agent を構築する際は、まず APIYI(apiyi.com)を通じて、同じ APIキーで軽量モデルと推論能力の高いモデルを試し、それぞれの Router・Worker としての性能を比較することをおすすめします。そのうえで最終的な構成を決めれば、すべての役割に最も高価なモデルを使わずに済みます。
コスト管理:全体の請求額ではなく、Ticket単位で記録する
公式の実験では、二層アーキテクチャはより多くの推論リソースを消費することが示されています。そのため、コストをより細かく管理する必要があります。実践しやすい方法として、次のようなものがあります。
- Ticket単位でTokenを記録する:Routerの判断コストとWorkerの実行コストを分けて、どの種類のタスクに最も費用がかかっているかを把握します。
- 費用の種類を分ける:モデルの利用料、ツールの利用料(検索やWebページの取得など)、実行環境の費用を別々に集計します。
- キャッシュヒットに注目する:Super-agentが消費するTokenの大部分はキャッシュの読み取りによるものです。キャッシュヒット時と未ヒット時の単価には大きな差がある場合があり、DeepSeekの公式料金では数十倍の差があります。
- 不要な判断を減らす:サブスクリプションによる直接転送の考え方を取り入れ、後続のイベントを担当Workerに直接届けることで、Routerによる重複した振り分けを削減します。
💰 コスト最適化:複数のWorkerを並列で動かすと、呼び出し回数は大幅に増えます。APIYI apiyi.comを通じて複数のモデルを従量課金で利用すれば、役割やモデルごとの実際の費用を同じ請求明細で比較でき、階層ごとのコスト最適化がしやすくなります。
Router + Workerを採用する価値があるのはどんなとき?
二層アーキテクチャは、複雑にすればするほどよいというものではありません。次の基準を参考にしてください。
- 採用に適している:互いに独立した作業が複数存在し(Ticket Aでバグ修正、Ticket Bでマイグレーションのレビュー、Ticket CでCI対応など)、複数のチャネルから届くイベントに常時対応する必要がある場合。
- 導入を見送ってもよい:タスクの数が少なく、互いの依存関係が強い場合や、主に一つの複雑なタスクを分担する場合は、単一のAgentや従来のAgent Teamのほうがリソースを節約できます。
- 先にインフラ整備が必要:権限の分離、ファイル変更の競合処理、タスク単位の費用ログが整っていない場合、安易な並列化はかえってリスクを高めます。
また、Router + Workerと一般的なAgent Teamでは、重視する点が異なります。一般的なAgent Teamは、一つの複雑なタスクを調査・コーディング・テストといった役割に分けることが多い一方、Super-agentのRouterは、各タスクの技術的な詳細には立ち入らず、複数の独立した作業の調整に重点を置きます。公式の説明によると、一般的なAgent Teamでも、メインセッションが窓口の一本化とタスク間の振り分けだけを担えば、同様の構造を作れます。つまり、二層アーキテクチャはDeepSeek独自の概念ではありません。
Router + Worker アーキテクチャの限界とプロトタイプの範囲
このようなアーキテクチャを解説する際、最も陥りやすいのは、設計記事に描かれた構想全体を、オープンソースのプロトタイプにすでに備わっている機能として扱うことです。資料に基づき、厳密に区別すると次のようになります。
- プロトタイプが対応済み:単一の GitHub リポジトリの監視、任意での Feishu 連携、Ticket 管理、独立した Worker セッションとディレクトリ、PR の生成、管理画面での人手による対応待ちタスクの表示、後続メッセージに基づく作業の継続
- 設計されているが、完全な実装は確認されていないもの:複数リポジトリの自動管理、本番運用レベルでのクラウド上の継続稼働とデバイスをまたいだ環境、完全に独立した Watchdog による自律的な修復。非同期 ReAct Loop は Harness に実装されていますが、デフォルトではまだ有効になっていません
- 自律的な行動にも制限がある:推測された作業にはデフォルトで
observeモードが適用され、記録のみで実行はされません。PR の自動マージもデフォルトでは無効です
アーキテクチャの面では、公式に認められている課題がいくつか残っています。第一に、単一 Router のスケーラビリティです。公式は現在のチーム規模では十分だと述べるにとどまり、より大規模な環境でのシャーディング方法は未定です。第二に、長期記憶です。Inline & Spill と連鎖的な想起によって中短期のコンテキストには対応していますが、数か月にわたる記憶はまだ解決されていません。第三に、権限の境界です。Router と Worker は初期設定で danger-full-access モードで動作し、デフォルトでは操作者のシステムユーザーとして実行されるため、公式は専用のシステムユーザーを使うことを推奨しています。外部からのコメントを通じたプロンプトインジェクションや認証情報の管理も、未解決の課題として挙げられています。コミュニティでは特定の commit を対象とした第三者によるソースコード監査レポートも公開されましたが、攻撃の全過程は独立して再現されておらず、現時点では潜在的なリスクにとどまります。
コミュニティでの実地検証も、このツールが「プロトタイプ」であることを裏付けています。SETUP.md に従い、新規クローンから Issue を PR にするまでの一連のフローを完走できたユーザーがいる一方で、Node.js 24 のプロセス認識、GitHub 通知の遅延によるメッセージの取りこぼし、システム言語が中国語の場合にテストのアサーションが失敗するなどの問題も報告されています。
よくある質問 FAQ
Q1:Router + Worker の二層アーキテクチャとは何ですか?
DeepSeek Super-agent の基本構造です。Router は常駐する全体の調整レイヤーとして、イベントの受信、タスクの関連付け、作業の割り当てを担当します。Worker は隔離された実行レイヤーとして、Ticket ごとに独立した Session とディレクトリで具体的なタスクを処理します。全体の調整と個別の実行を分離することが、この構造のポイントです。
Q2:Router + Worker と一般的なマルチエージェントチームの違いは何ですか?
一般的なエージェントチームは、複雑なタスクを調査、コーディング、テストなどの役割に分担することが多いです。一方、Router + Worker は、互いに独立した複数の作業を調整することに重点を置き、Router はタスク内部の詳細には深入りしません。一般的なチームでも、メインセッションが一元的なやり取りとタスク間の割り当てだけを担えば、同様の二層構造になります。
Q3:公式実験は Super-agent のプログラミング効率が 47% 向上したことを証明していますか?
いいえ。実験では模擬コーディングツールを使用し、各方式の試行回数は 5 回だけでした。測定したのはタスクのスケジューリング完了時間であり、コードの品質やプログラミング能力ではありません。P95 が約 47% 低下したことは、この合成負荷のもとでスケジューリングに長時間かかるケースが減ったことを示すにすぎません。実際のプログラミング効率の向上に当てはめたり、Claude Code や Codex とコーディング能力を比較したりすることはできません。
Q4:Router + Worker を使うとコストは安くなりますか?
必ずしも安くなるわけではありません。公式の合成実験では、Super-agent のキャッシュ読み取り量は中立的な単一セッション方式の約 3.8 倍でした。より多くのリソースを使う代わりに、速度と安定性を得る仕組みです。コストを抑える余地があるのは、モデルの使い分けです。Router には軽量モデルを、Worker にはタスクの複雑さに応じたモデルを選びます。APIYI apiyi.com の統一インターフェースを使えば、さまざまなモデルの組み合わせで実際の費用を測定し、比較検討できます。
Q5:自分のプロジェクトで Router + Worker のモデルの使い分けを手早く検証するにはどうすればよいですか?
以下の手順をおすすめします。
1. APIYI apiyi.com でアカウントを登録し、APIキーと無料のテスト枠を取得する;
2. 本文のコードを使い、base_url を `https://api.apiyi.com/v1` に設定する;
3. Router と Worker にそれぞれ異なるモデルを設定し、Ticket ごとに Token 消費量を記録して効果を比較する。
OpenAI 互換インターフェースなので、モデルの切り替えは model パラメータを変更するだけです。
Q6:オープンソースのプロトタイプを企業の本番環境でそのまま使えますか?
現時点では、そのまま本番環境で使うことはおすすめしません。これは研究用のプロトタイプであり、Worker はデフォルトで操作ユーザーとして高い権限で実行されます。また、GitHub Enterprise Server には対応しておらず、コミュニティからは通知の見落としなどの不具合や、潜在的なセキュリティ上の問題も報告されています。隔離環境でワークフローの設計を検証する用途が適しています。
Router + Workerの要点 Key Takeaways
- 基本的な位置づけ:Super-agentはモデルとは別のシステムアーキテクチャであり、オープンソース化されたのは商用製品ではなく研究用プロトタイプです。
- 問題の本質:ボトルネックはモデルの能力から人間の注意力へと移りつつあります。単一セッションでは処理が「詰まり」、複数セッションでは情報が「分散」します。
- 役割分担:Routerは全体の調整だけを担当し、Bashすら使えない構成もあります。Workerは分離されたセッションで独立して作業を進めます。
- 主な仕組み:購読による直接転送でRouterの判断負荷を減らし、バッチ処理で推論コストを分散。Inline & Spillではコンテキストをキャッシュとして扱います。
- データの解釈:スケジューリング実験では、完了までに特に長くかかるタスクの時間が短縮された一方、トークン消費は増加しました。また、これはコーディング能力を示すものではありません。
- 始め方:APIYI apiyi.comの統一インターフェースを使えば、役割ごとに異なるモデルを設定し、Ticket単位でコストを管理できます。
まとめ
DeepSeekはRouter + Workerによって、「AI Agentを1つのセッションだけで動かすべきではないのはなぜか」という問いに答えました。
- アーキテクチャの価値:全体の調整と個別の実行を分離し、人間がタスク間の関係を覚えておくのではなく、システムが管理します。
- エンジニアリング設計:購読による直接転送、バッチ処理、Inline & Spill、連鎖的な情報の呼び戻しが、それぞれ中央の負荷、突発的な処理量、コンテキスト容量、履歴の呼び戻しという課題に対応します。
- 冷静な評価:実験が示したのは、スケジューリング効率とリソース消費のトレードオフです。単一Routerの拡張性、長期記憶、権限の分離は引き続き解決すべき課題です。
システムが複数の独立した作業を同時に処理する必要があるなら、2層アーキテクチャは参考になります。一方、タスクが少なく内容も集中している場合は、単一のAgentのほうが経済的です。どちらの構成を採用する場合も、モデルを役割に応じて使い分け、タスクごとにコストを記録することが重要です。
RouterとWorkerの役割で異なるモデルの効果を手早く検証するには、APIYI apiyi.comがおすすめです。OpenAI互換インターフェース、従量課金、新規ユーザー向けの無料テスト枠が提供されています。
📚 参考資料
- DeepSeek公式アーキテクチャ記事:Super-agent設計の探究:より自律的なAgentシステムに向けて
- リンク:
x.com/DeepSeekHarness/article/2116857257245987236 -
内容: 2層アーキテクチャ、5つの主要モジュール、実験データ、未解決の課題に関する一次情報
-
DeepSeek公式GitHubリポジトリ:dsh-superagent-prototype
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype -
内容: プロジェクトの状況、ソースコード、ライセンス、現在の適用範囲
-
オープンソースのDomain Modelドキュメント:タスクオブジェクトと処理フローのモデル
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
内容: Source、Trigger、Ticket、Assignmentなどの主要概念の定義
-
認可とサブスクリプションのドキュメント:MandateとThreadのサブスクリプションルール
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
内容: サブスクリプションメッセージによって認可範囲を拡大できないことについての公式説明
-
デプロイメントドキュメント:依存関係、アカウント、セキュリティに関する注意事項
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md -
内容: 高い権限での実行モードと、専用のシステムユーザーを使用することの推奨
-
DeepSeek API公式料金:モデルとツールの料金
- リンク:
api-docs.deepseek.com/quick_start/pricing - 内容: キャッシュヒット時とミス時の料金差、およびコスト見積もりの参考情報
著者: APIYI技術チーム
技術交流: Agentアーキテクチャや複数モデルの呼び出しに関する実践については、APIYIのサイト apiyi.com のトップページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。