作者注:Fable 5.5 と GPT-6.2 Astra はどちらもデモが公開されていますが、同じ課題での比較はありません。本記事では6件のデモの証拠としての信頼度を整理し、現行フラッグシップの Fable 5.1 と GPT-6 Astra の公式仕様と価格を比較したうえで、再実行可能なモデル選定評価の方法を紹介します。
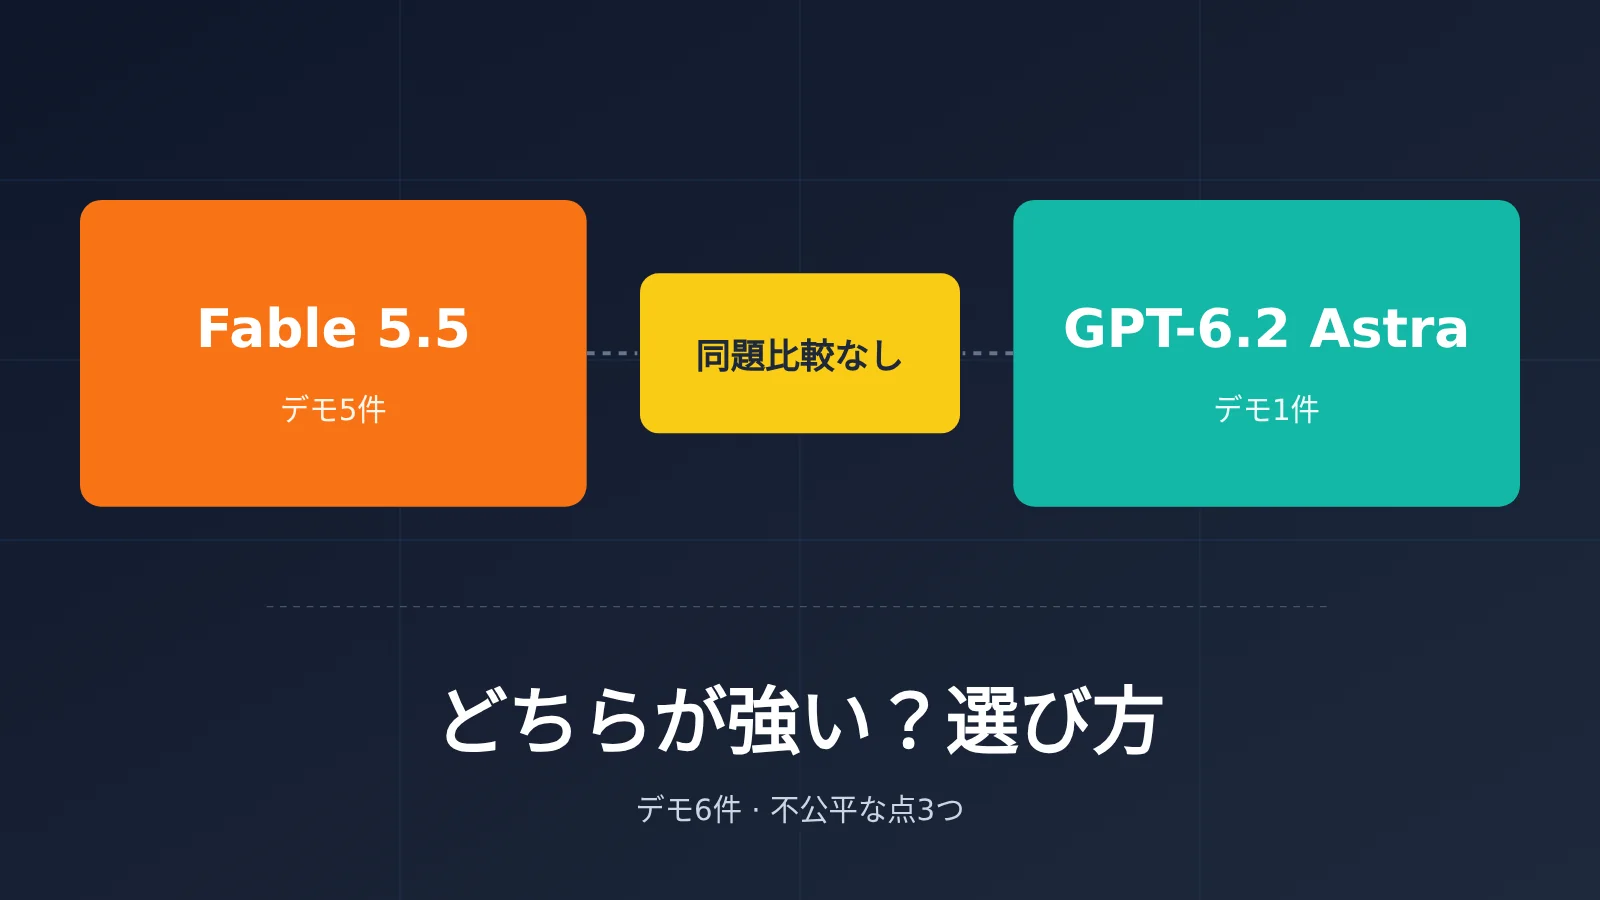
先に結論を言うと、Fable 5.5 と GPT-6.2 Astra のどちらが強いかは、現時点ではわかりません。どちらのモデルも正式リリースされていないためです。2026年11月3日時点で、Anthropic のモデル一覧に掲載されているのは Fable 5.1、OpenAI のモデル一覧に掲載されているのは GPT-6 Astra のままです(出典:両社の公式モデルページ、証拠レベル:公式ドキュメント)。両モデルの公開デモは、いずれも第三者のテストサイト Model Tests に掲載されており、作者は @notjazii ですが、同じ課題に取り組んだものではありません。Fable 5.5 にはゲーム、短編動画、SVG、WebGL など5作品がある一方、GPT-6.2 Astra はピクセルアニメーションの GIF が1件のみです。課題が異なる以上、どちらが勝ったかは判断できません。
そこで本記事では順位付けはせず、次の3つの疑問に答えます。これらのデモから何がわかり、何がわからないのか。現在比較できる Fable 5.1 と GPT-6 Astra の公式仕様にはどんな違いがあるのか。そして、新モデルの公開後にモデル名を変えるだけで再実行できる、20〜50件のタスクからなる独自評価をどう準備するか。Mythos 5.5 や Gemini 4 Carbon など、ほかの噂については扱いません。
これは「どちらにも良さがある」と結論をぼかす記事ではありません。証拠が足りないところは足りないと明記し、判断できるところは具体的におすすめします。
Fable 5.5 vs GPT-6.2 Astra の公開デモ一覧
結論:デモは、モデルが動作する完成品を作れることを示しています。ただし、両者は課題、作品数、モデルの設定が異なるため、直接比較はできません。
Model Tests サイトには、8モデルによる計11作品が掲載されており、それぞれに日付、モデル、種類が記載されています(出典:サイトのページ、証拠レベル:コミュニティによる自己申告)。以下の表には、Fable 5.5 と GPT-6.2 Astra の作品計6点をまとめました。モデルの帰属はいずれも作者の自己申告です。
| 作品 | 作者による表記 | 種類 | 日付 | 内容の要点 |
|---|---|---|---|---|
| VoxelCraft | Fable 5.5 xhigh | プレイ可能な HTML ゲーム | 2026-11-01 | 単一ファイルの『マインクラフト』クローン。サバイバル/クリエイティブ、クラフト、かまど、エンチャント、レッドストーン、村人、複数のバイオーム、ネザーとエンドを収録 |
| The Last Page | Fable 5.5 xhigh | 66秒の音声付き短編 | 2026-11-02 | キツネ、月明かりの図書館、舞い上がる本のページ、雲へと飛んでいく場面 |
| Open Me | Fable 5.5 xhigh | WebGL インタラクティブ体験 | 2026-11-02 | レイマーチングを使った WebGL2 と生成音楽。専用 GPU が必要 |
| Acorn Bread on a Stick | Fable 5.5 xhigh | 手書き SVG | 2026-11-02 | 棒に刺したドングリパンのイラスト |
| Fruit Basket | Fable 5.5 max | ベクターのみの静物画 | 2026-11-02 | 3000×2400、ビットマップなしの写実的なフルーツバスケット |
| Tsukimi Moon Ferry | GPT 6.2 Astra Max | ピクセルアニメーション GIF | 2026-11-02 | 満月の下に広がる日本風の川沿いの町。城、富士山、赤い橋、空飛ぶ鯉、浮かぶ灯籠、渡し舟 |
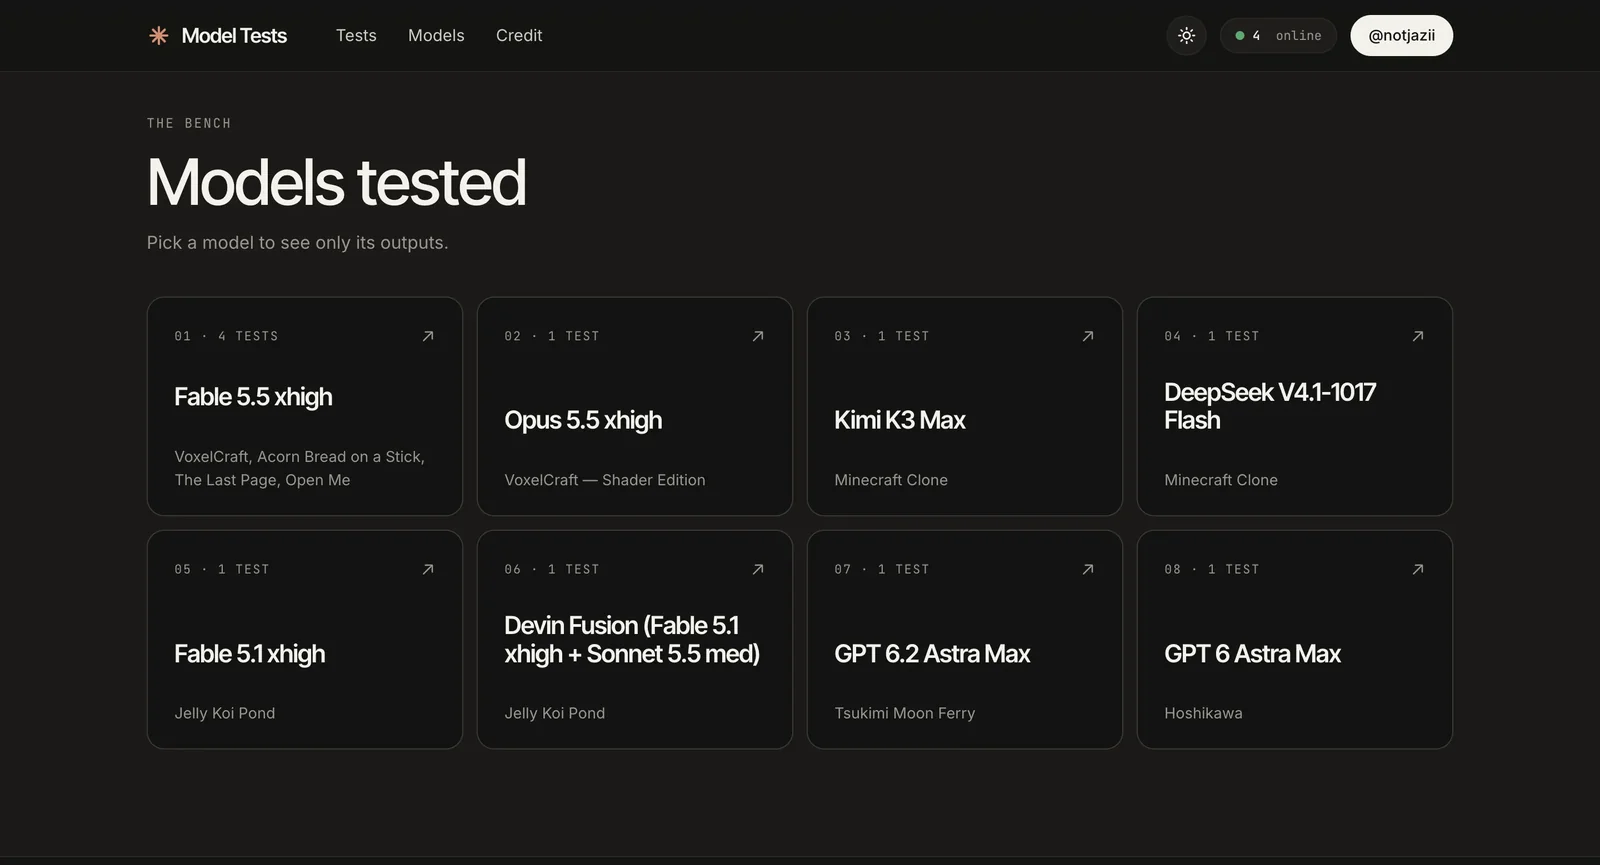
図:Model Tests のモデル一覧。Fable 5.5 xhigh は4件、GPT-6.2 Astra Max は1件、GPT-6 Astra Max も1件のテストが掲載されています(スクリーンショット:2026-11-03)。
サイト内には、比較の参考になる作品もいくつかあります。Hoshikawa は GPT 6 Astra Max による作品と表記され、こちらも満月の下に広がる日本風の町を描いたピクセルアニメーションです(2026-11-02)。Tsukimi Moon Ferry に近い作風で、サイト内で唯一、ほぼ同じ課題による OpenAI の新旧モデルを比較できます。VoxelCraft — Shader Edition は Opus 5.5 xhigh による作品と表記され(2026-11-01)、Fable 5.5 の VoxelCraft と同じ課題です。また、Kimi K3 Max と DeepSeek V4.1-1017 Flash も、それぞれ Minecraft のクローンを1作品ずつ制作しています(2026-10-17)。
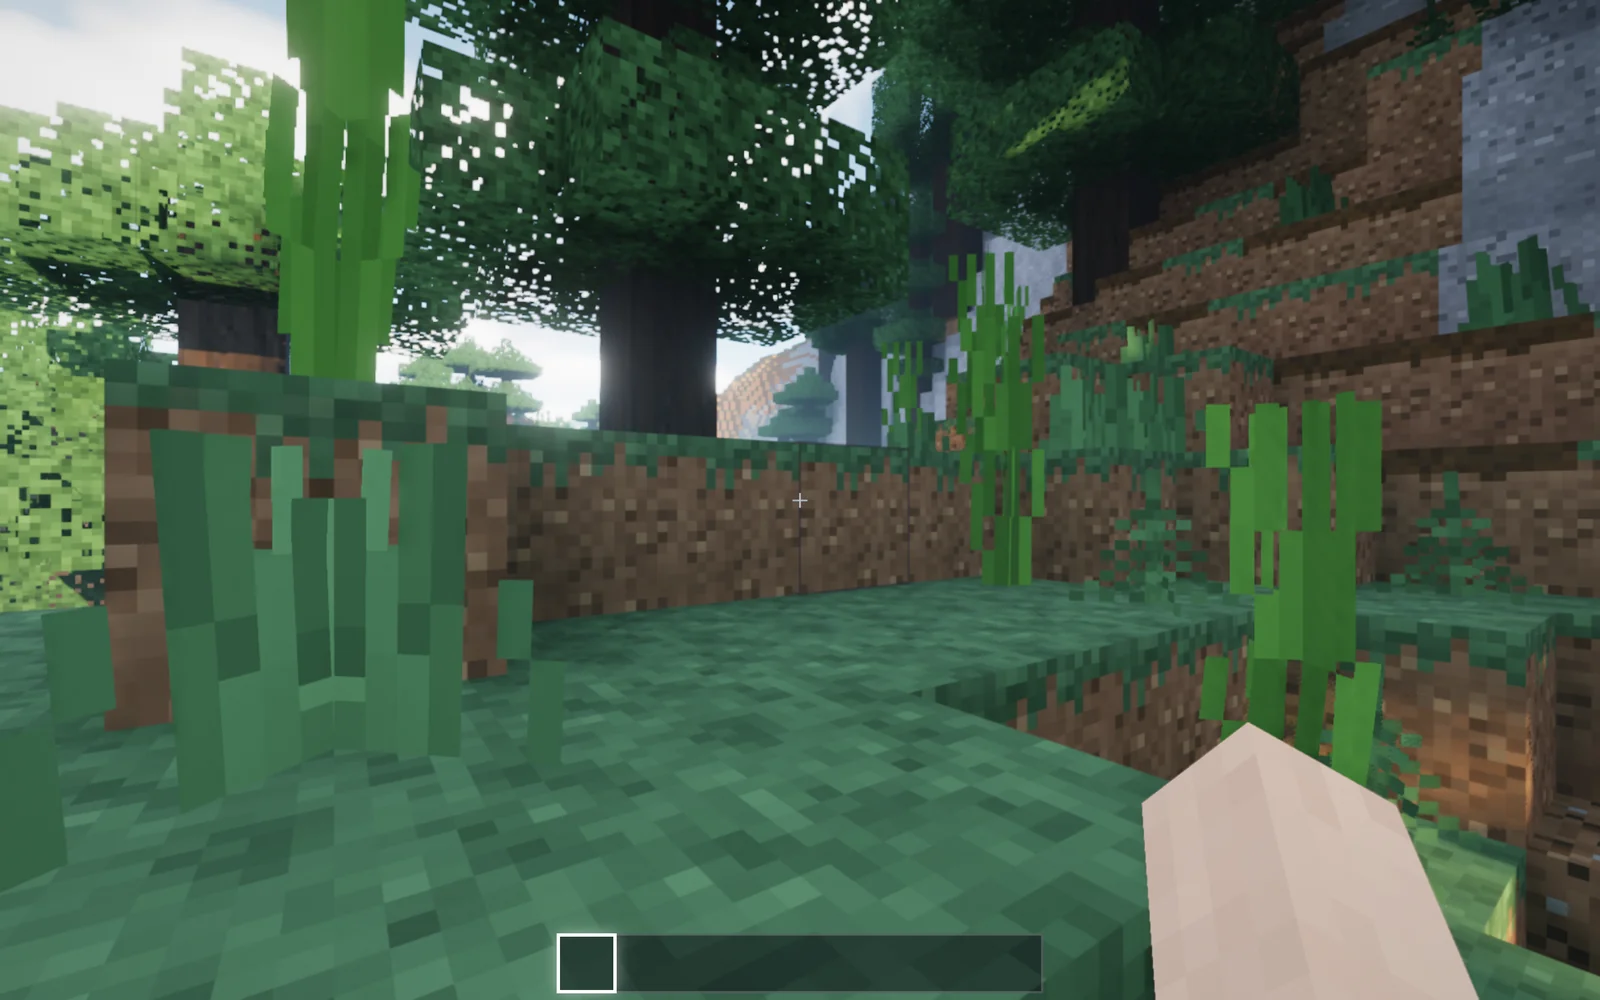
図:Fable 5.5 xhigh の VoxelCraft。単一ファイルの『マインクラフト』クローンで、開くとすぐに歩き回れます(スクリーンショット:2026-11-03)。
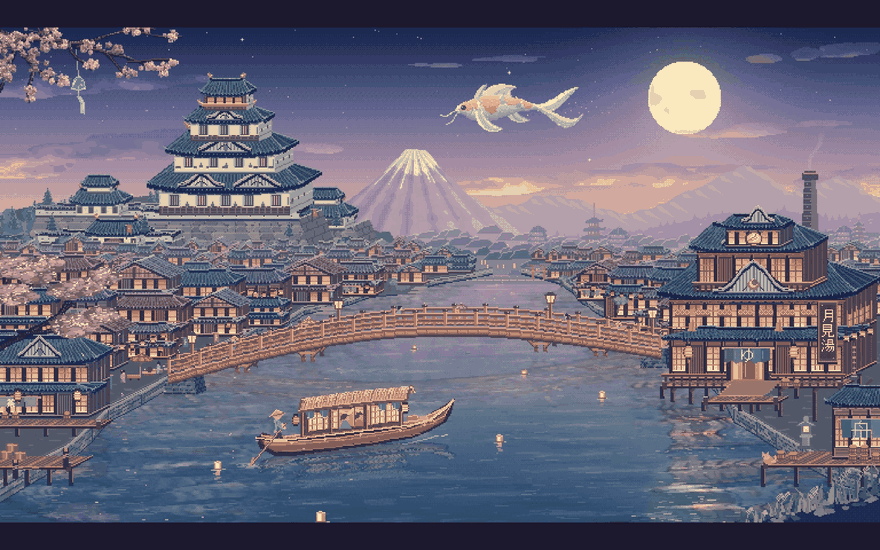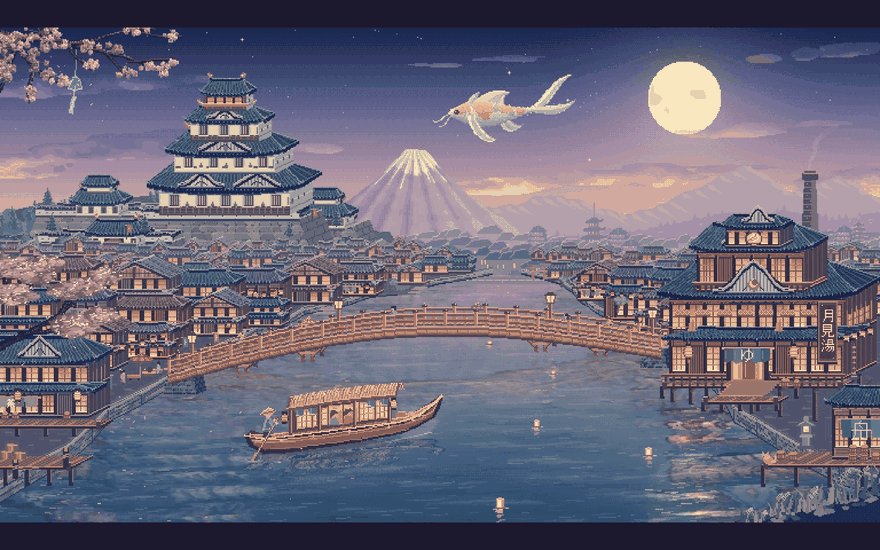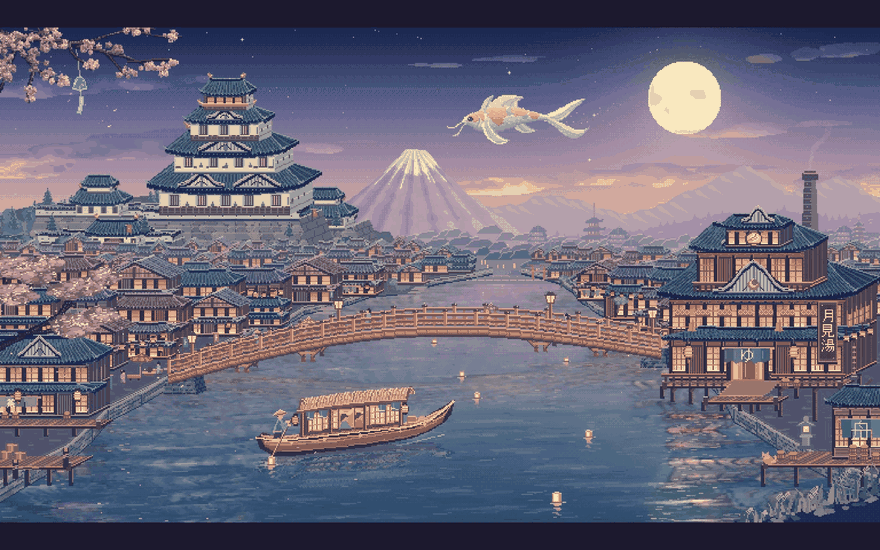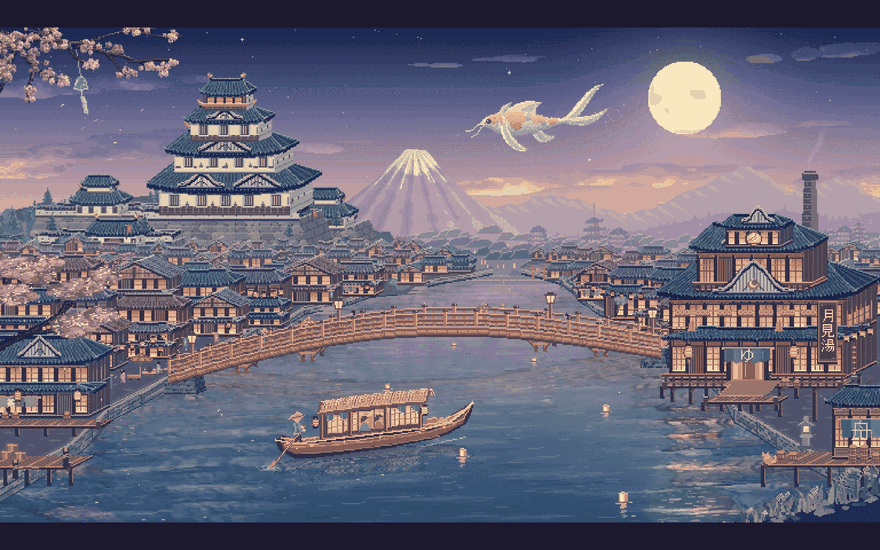
図:GPT-6.2 Astra Max の Tsukimi Moon Ferry。満月の下に広がる日本風の川沿いの町を描いたピクセルアニメーション GIF です(画面収録:2026-11-03)。
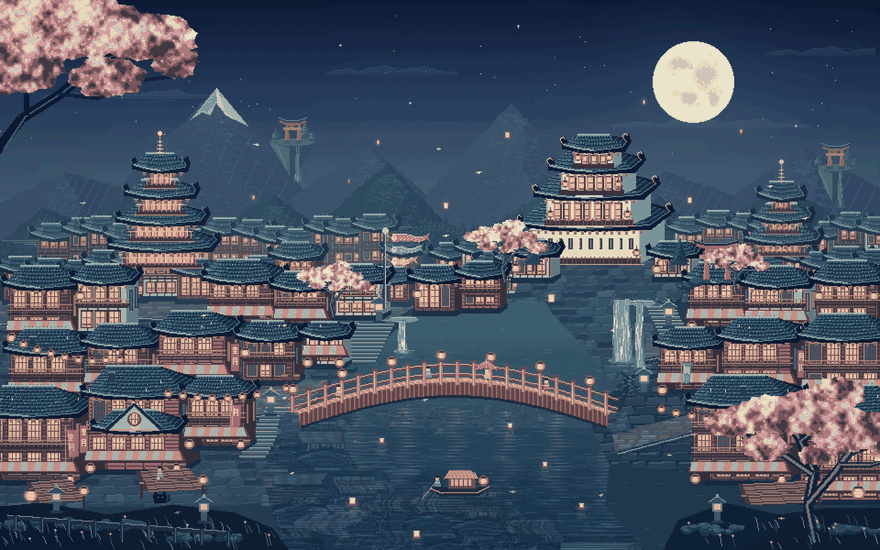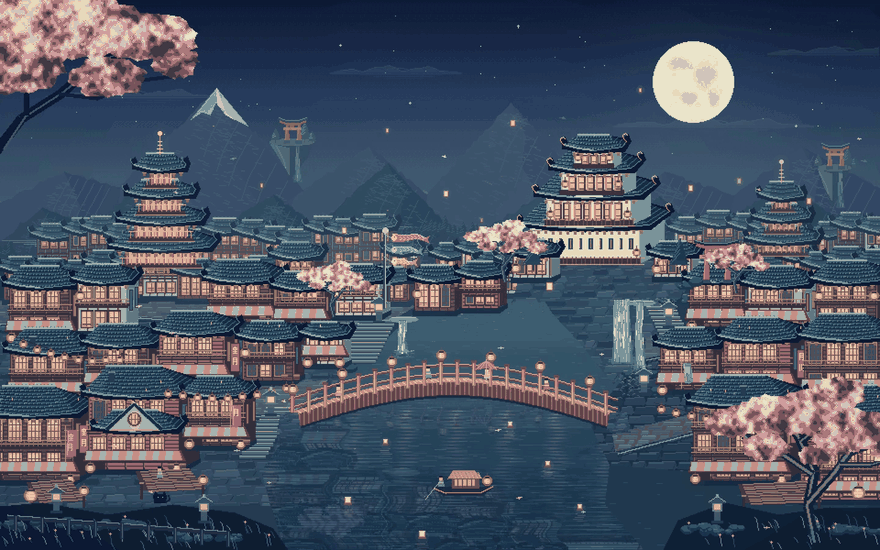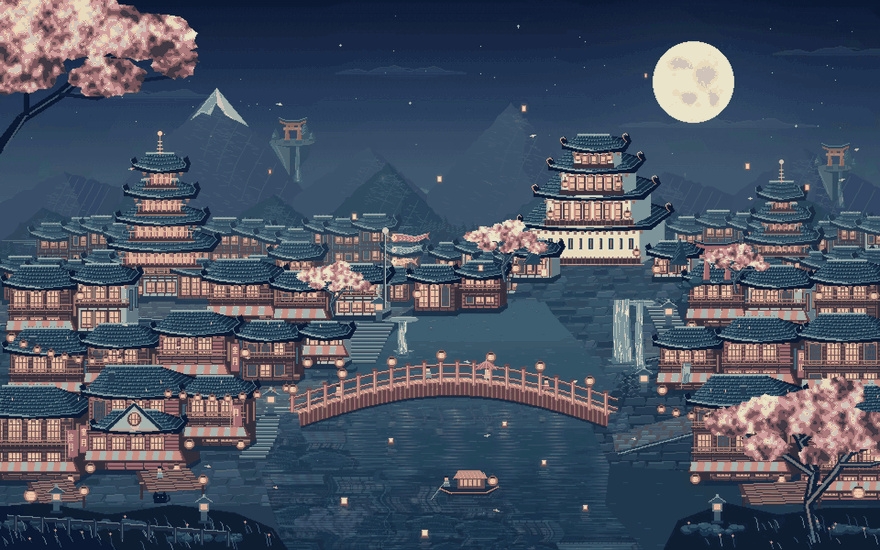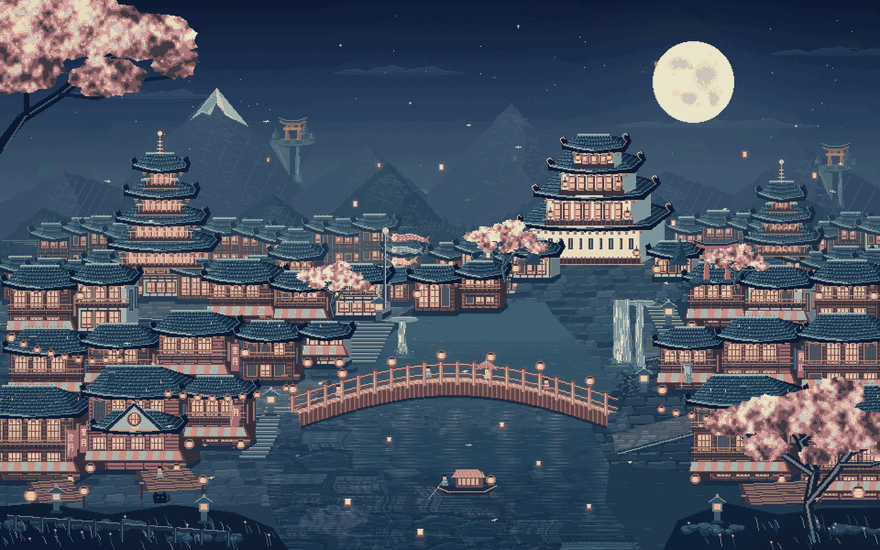
図:比較対象となる GPT-6 Astra Max の Hoshikawa。同じサイトに掲載された同じスタイルの作品で、6.2 のピクセルアニメーションとの比較に使用(画面収録日:2026-11-03)。
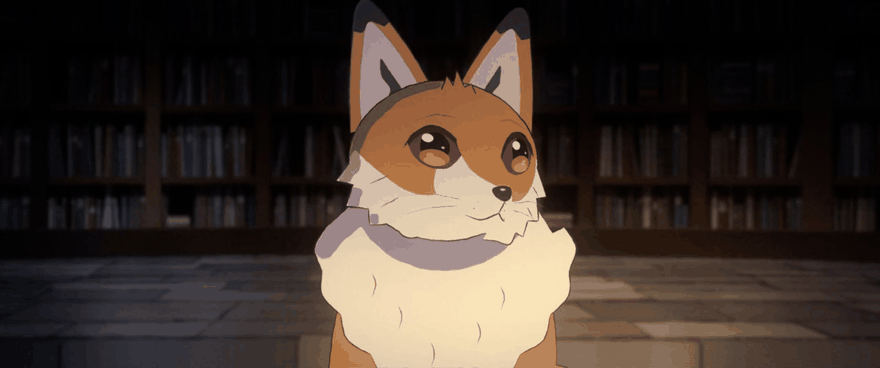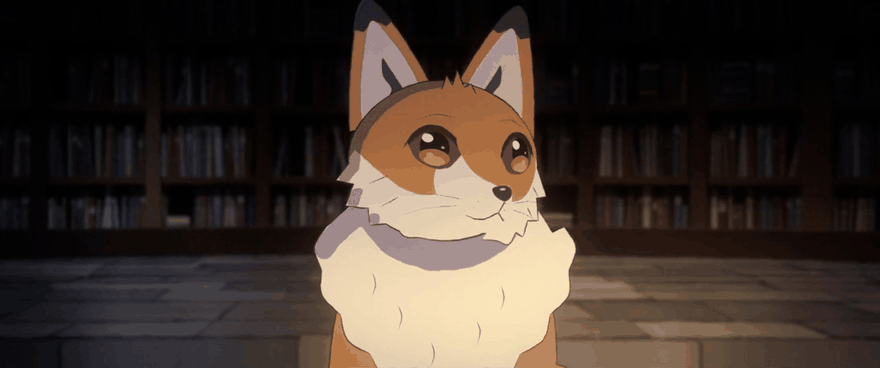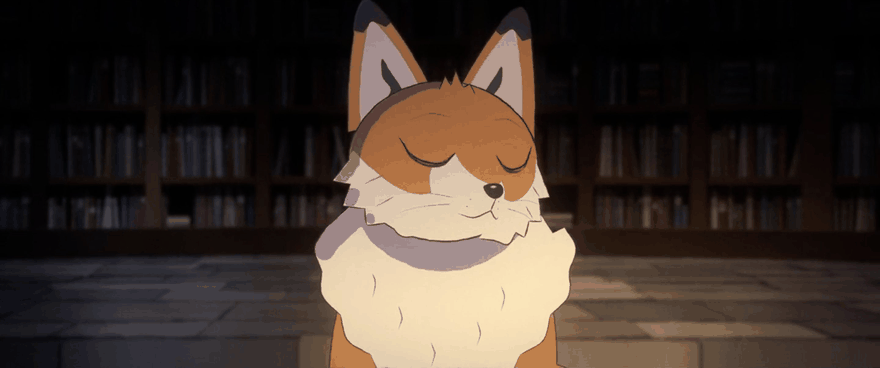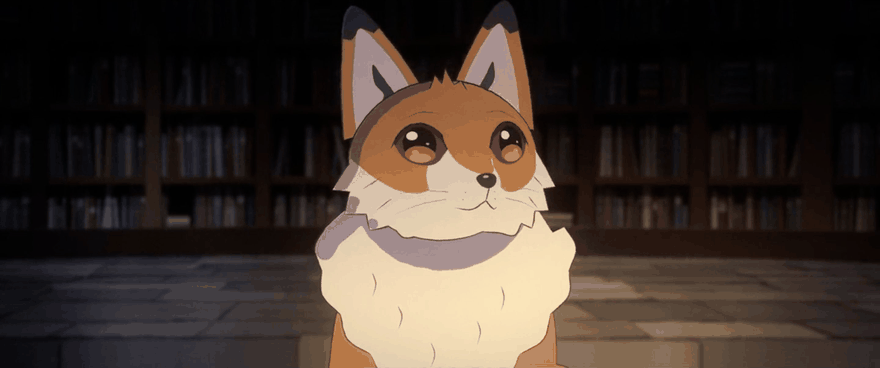
図:Fable 5.5 xhigh による66秒の音声付き短編映像 The Last Page から、キツネが月明かりの図書館にいるシーン(GIF 切り出し日:2026-11-03、音声なし)。
サイト内で唯一、コストと所要時間が記載されているのは Jelly Koi Pond です。Fable 5.1 xhigh 版は所要時間が約1時間40分、コストが $25。Devin Fusion の組み合わせ(Fable 5.1 xhigh と Sonnet 5.5 med)は約1時間、コストが $11 でした(日付:2026-10-21、証拠レベル:コミュニティによる自己申告)。これ以外の作品については、サイト内で所要時間やコストは公開されておらず、本記事でも推算は行いません。
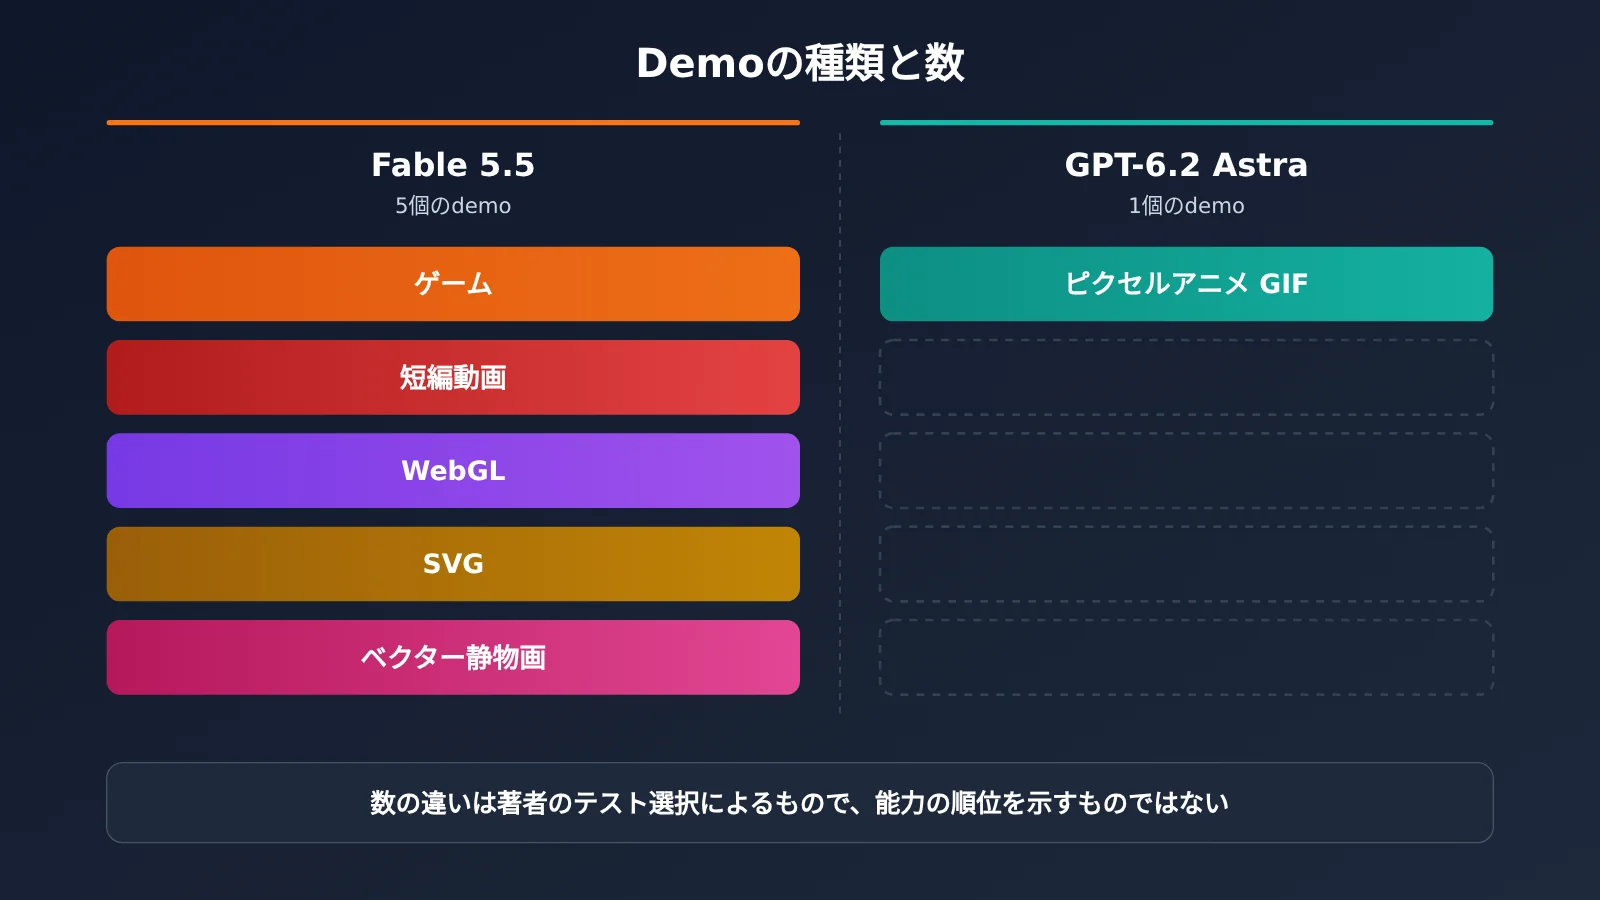
上の図はデモの種類と数の分布を示したもので、能力の順位ではありません。自分のタスクで両社の現行フラッグシップの実力差を確かめたい場合は、APIYI apiyi.com で同じ APIキーを使い、claude-fable-5-1 と gpt-6-astra をそれぞれ呼び出せます。
Fable 5.5 vs GPT-6.2 Astra:公平に見えて実は公平ではない3つのポイント
結論:同じサイト、同じ作者による記事なので比較レビューに見えますが、実際には少なくとも3つの不公平な点があります。
不公平な点その1:課題がまったく異なる
Fable 5.5 の5作品はゲーム、短編動画、WebGL、SVG の4種類に及ぶ一方、GPT-6.2 Astra はピクセルアニメーションの1種類だけです。両者が取り組んだ共通の課題は一つもありません。ピクセルアニメーションで問われるのは構図とフレームごとの一貫性ですが、単一ファイルのゲームでは長いコードの構成力と状態管理が問われます。両者の結果を直接比較することはできません。世代間の比較を参考にするなら、GPT-6.2 Astra は同じサイトの GPT-6 Astra(Hoshikawa)と、Fable 5.5 は Opus 5.5(VoxelCraft — Shader Edition)としか比較できません。
不公平な点その2:推論レベル、日付、作品数が揃っていない
Fable 5.5 の作品はほとんどが xhigh で、Fruit Basket だけが max です。一方、GPT-6.2 Astra は Max と表記されています。レベルが異なれば推論に使える予算も異なるため、生成物の品質をそのまま比較することはできません。また、作品数も5対1ですが、これは作者が何を試すかを選んだ結果であり、公式の評価結果ではありません。デモの数を能力の優劣と結びつけるのは、今回の議論で最もよく見られる誤解です。
不公平な点その3:モデルの帰属を検証できない
すべてのデモでプロンプト、呼び出しログ、モデルカードが公開されておらず、どのモデルによるものかは作者の表記に頼るしかありません。ByteForward は 11-02 の検証で、「Fable 5.5」と表記されたデモの一部は、Opus 5.5 へのリクエストが新モデルにルーティングされたもので、モデルセレクターには Opus 5.5 と表示されたままだった可能性があると伝えています(証拠レベル:単一メディアの報道)。この前提では、「作者が Fable 5.5 と主張している」とは書けても、「Fable 5.5 が作った」とは書けません。
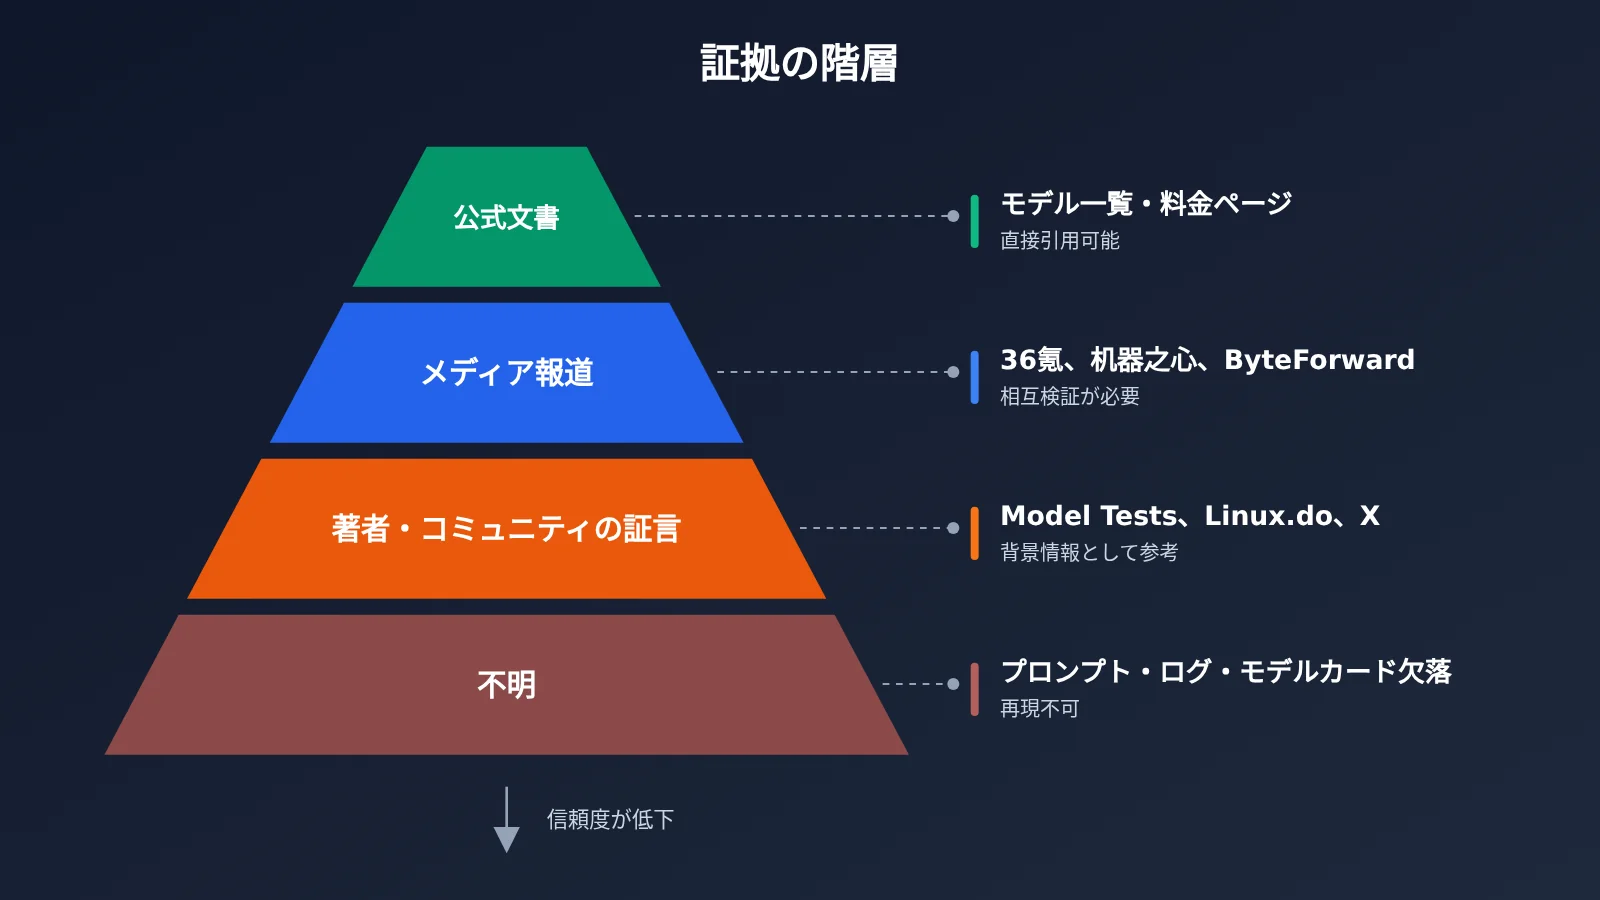
下表は、現在この2つのモデルに関して出ている情報を、証拠レベル別に整理したものです。チーム内で共有する際も、証拠レベルの列を残しておくことをおすすめします。
| 主張・情報 | 出典 | 日付 | 証拠レベル |
|---|---|---|---|
| Anthropic のカタログは依然として Fable 5.1 までで、Fable 5.5 はない | Anthropic の料金ページとニュースページ | 11-03 閲覧 | 公式ドキュメント |
| OpenAI のカタログは依然として GPT-6 Astra までで、GPT-6.2 Astra はない | OpenAI のモデルカタログ | 11-03 閲覧 | 公式ドキュメント |
LiteLLM が azure_ai/claude-fable-5-5 の料金項目を追加 |
TestingCatalog の記録 | 10-13 | 第三者の記録 |
| Fable 5.5 は入力 1M、出力 12.8 万に対応 | 36 氪/新智元 | 11-02 | 単一メディアの報道 |
| GPT-6.2 Astra の評価を「大幅な飛躍」と総括 | 机器之心/新浪 | 11-02 | メディアによる総括、ベンチマークなし |
| 使用量の明細で gpt-6.2-astra が 1.6% を占める | Linux.do @fourfour | 11-01 | コミュニティでの自己申告 |
| 使用量の明細で gpt-6.2-astra が 19.8% を占める | X @TokenGremlin | 11-01 | コミュニティでの自己申告 |
| Model Tests のデモにおけるモデルの帰属 | 作者 @notjazii | 11-01 から 11-02 | 作者の自己申告 |
| Fable 5.5 のデモの一部は、実際には Opus 5.5 へのリクエストがルーティングされたもの | ByteForward | 11-02 | 単一メディアの報道 |
GPT-6.2 Astra の利用状況データについては、特に説明が必要です。Linux.do の投稿で公開されたのは、10/25 から 10/31 までの Codex の使用量分布です。97.7% は依然として gpt-6-astra で、gpt-6.2-astra はわずか 1.6% でした。同じ投稿にある請求明細の 13 行のうち 12 行も gpt-6-astra で、速度は 44 から 73 tok/s の間でした。X の TokenGremlin が公開した別のスクリーンショットでは 19.8% となっており、こちらのほうが広く拡散されました(約 15.5 万回閲覧)。この2つの数字はいずれも個人アカウントによるスクリーンショットであり、公式データではありません。机器之心も、スクリーンショットが証明できるのは「アクセス権を得たと報告するユーザーがいる」ことだけだと明記しています。なお、GPT-6.2 Betelgeuse / Bel は、以前から流れていた別の基盤モデルのコードネームで、6.2 Astra とは別物です。
コミュニティでの体感もまちまちです。Fable 5.5 のほうが強いという人もいれば、Opus 5.5 と互角だという人もいます。GPT-6.2 Astra についても、Opus 5.5 に及ばないという声、漸進的な改善にすぎないという声、複数の面で Opus 5.5 を上回るという声があります。これらにはいずれもベンチマークやサンプル数の裏付けがなく、背景情報として参考にするにとどめるべきです。
Fable 5.1 vs GPT-6 Astra:公式仕様と価格の比較
結論:新モデルにはまだ公式仕様がなく、条件をそろえて比較できるのは現行のフラッグシップモデルだけです。両者の単価は同じですが、長い入力の課金、知識のカットオフ、推論レベルに違いがあります。
Fable 5.1 と GPT-6 Astra の公式単価は、どちらも入力が $10、出力が $50(100万トークンあたり)です。最大出力はともに 128K、コンテキストウィンドウはそれぞれ 1M と 1.05M です。以下のデータは両社の公式モデルページから 2026-11-03 に取得したもので、根拠は公式ドキュメントです。
| 仕様項目 | Fable 5.1 | GPT-6 Astra |
|---|---|---|
| モデル ID | Anthropic 公式 Fable 5.1 | gpt-6-astra |
| コンテキストウィンドウ | 1M | 1.05M |
| 最大出力 | 128K | 128K |
| 知識のカットオフ | 2026-06 | 2026-04-30 |
| 推論制御 | Adaptive thinking は常時有効、デフォルトの effort は high | low / medium / high / xhigh / max |
| ツール機能 | 公式ドキュメントを参照 | 関数呼び出し、ウェブ検索、ファイル検索、computer use |
推論制御の違いは、評価の設計に直接影響します。Fable 5.1 では Adaptive thinking が常時有効で、デフォルトの effort は high です。一方、GPT-6 Astra では5段階から選択できます。両者のレベル名は対応していないため、「同じレベル」にできるだけ近づけることはできても、完全に同等にはなりません。評価時には high 同士が等しいと仮定せず、レベルを記録項目に含めることをおすすめします。
価格については、公式単価は同じですが、課金の詳細には大きな違いがあります。以下の表には、公式価格と APIYI プラットフォームの掲載価格を併記しています(100万トークンあたり、米ドル)。
| 課金項目 | Fable 5.1 公式 | GPT-6 Astra 公式 | APIYI apiyi.com 掲載価格 |
|---|---|---|---|
| 入力 | $10 | $10 | claude-fable-5-1 $10;gpt-6-astra 0〜272,000 tokens は $10 |
| 長い入力 | 1M 以内は $10 を維持 | 公式ページを参照 | gpt-6-astra 272,001〜1,050,000 tokens は $20 |
| 出力 | $50 | $50 | どちらも $50 |
| キャッシュヒット/読み取り | $0.25 | 公式ページを参照 | claude-fable-5-1 $0.25;gpt-6-astra $1 |
| キャッシュ書き込み | 5分 $12.50、1時間 $20 | 公式ページを参照 | プラットフォームのモデル一覧を参照 |
| エンドポイント | messages | responses、chat | claude-fable-5-1:chat / messages;gpt-6-astra:responses / chat |
長文書の分析や大規模なコードベースの理解に取り組むチームにとっては、「どちらが優れているか」よりも、この表のほうが役立ちます。1回の入力が27.2万トークンを超えると、gpt-6-astra の入力価格は $20 に倍増します。一方、claude-fable-5-1 は 1M の範囲内なら常に $10 です。キャッシュ読み取り価格にも4倍の差があります($0.25 対 $1)。同じ長いコンテキストを繰り返し呼び出す用途では、この2つの違いが請求額にはっきり表れます。モデルと価格はプラットフォームのモデル一覧をご確認ください。
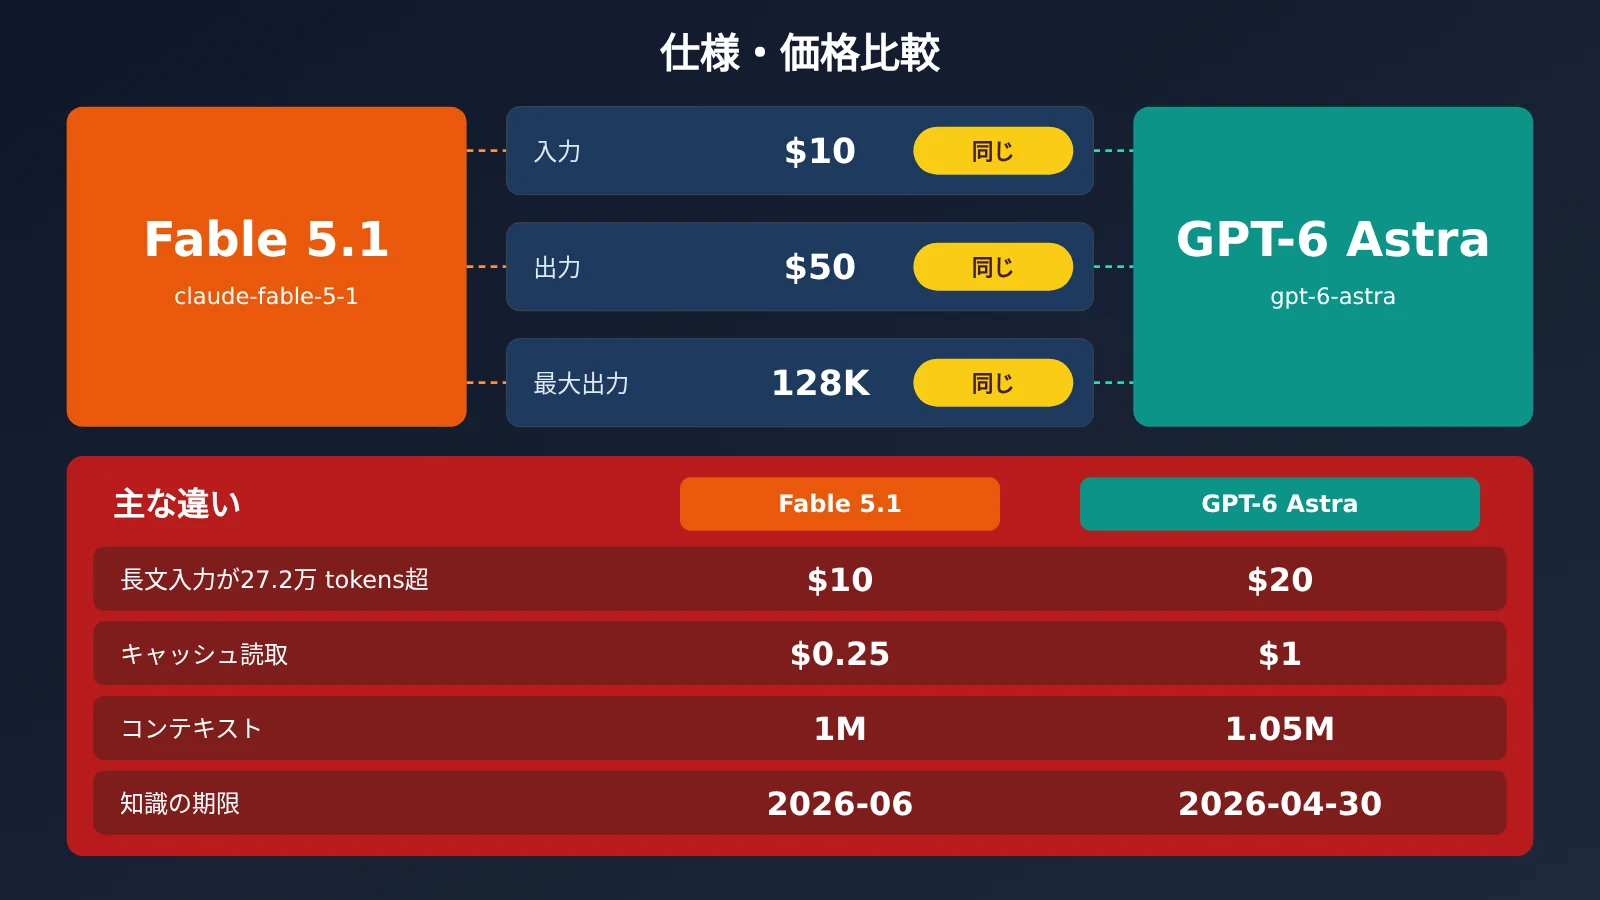
図中の価格は、公式モデルページとAPIYI apiyi.comのプラットフォーム価格APIから取得したものです。取得日時は2026-11-03です。
Fable 5.5とGPT-6.2 Astraのリリース前に使えるモデルは?
結論:新モデルの公式APIはまだありません。今できるのは、両社の現行フラッグシップモデルでベースラインを測定し、評価の仕組みを整えておくことです。
2026-11-03時点で、APIYIプラットフォームのモデルAPIは259モデル、価格APIは計277モデルを返しています。その中には gpt-6-astra、gpt-6.1-sol、gpt-6.1-terra、gpt-6-luna、claude-fable-5-1 が含まれますが、gpt-6.2-astra と claude-fable-5-5 はありません。つまり、両社の現行フラッグシップモデルは、同じAPIキーを使ってベースラインを測定できます。同日、claude-fable-5-1 に max_tokens を32とするmessagesリクエストを送ったところ、HTTP 200が返り、APIを利用できることを確認しました。
接続方法はOpenAI SDKと互換性があります。base_urlを https://api.apiyi.com/v1 に設定し、モデル名に claude-fable-5-1 または gpt-6-astra を指定するだけです。Anthropicネイティブのmessages形式が必要な場合は、claude-fable-5-1 でも利用できます。gpt-6-astra はresponsesまたはchatエンドポイントを使えます。
🚀 クイックスタート:APIYI apiyi.comに登録し、新規ユーザー向けの無料テスト枠を使って、まずは3〜5件のタスクで
claude-fable-5-1とgpt-6-astraを試しましょう。出力形式とトークンの記録が正常であることを確認してから、評価用の問題セット全体に広げます。
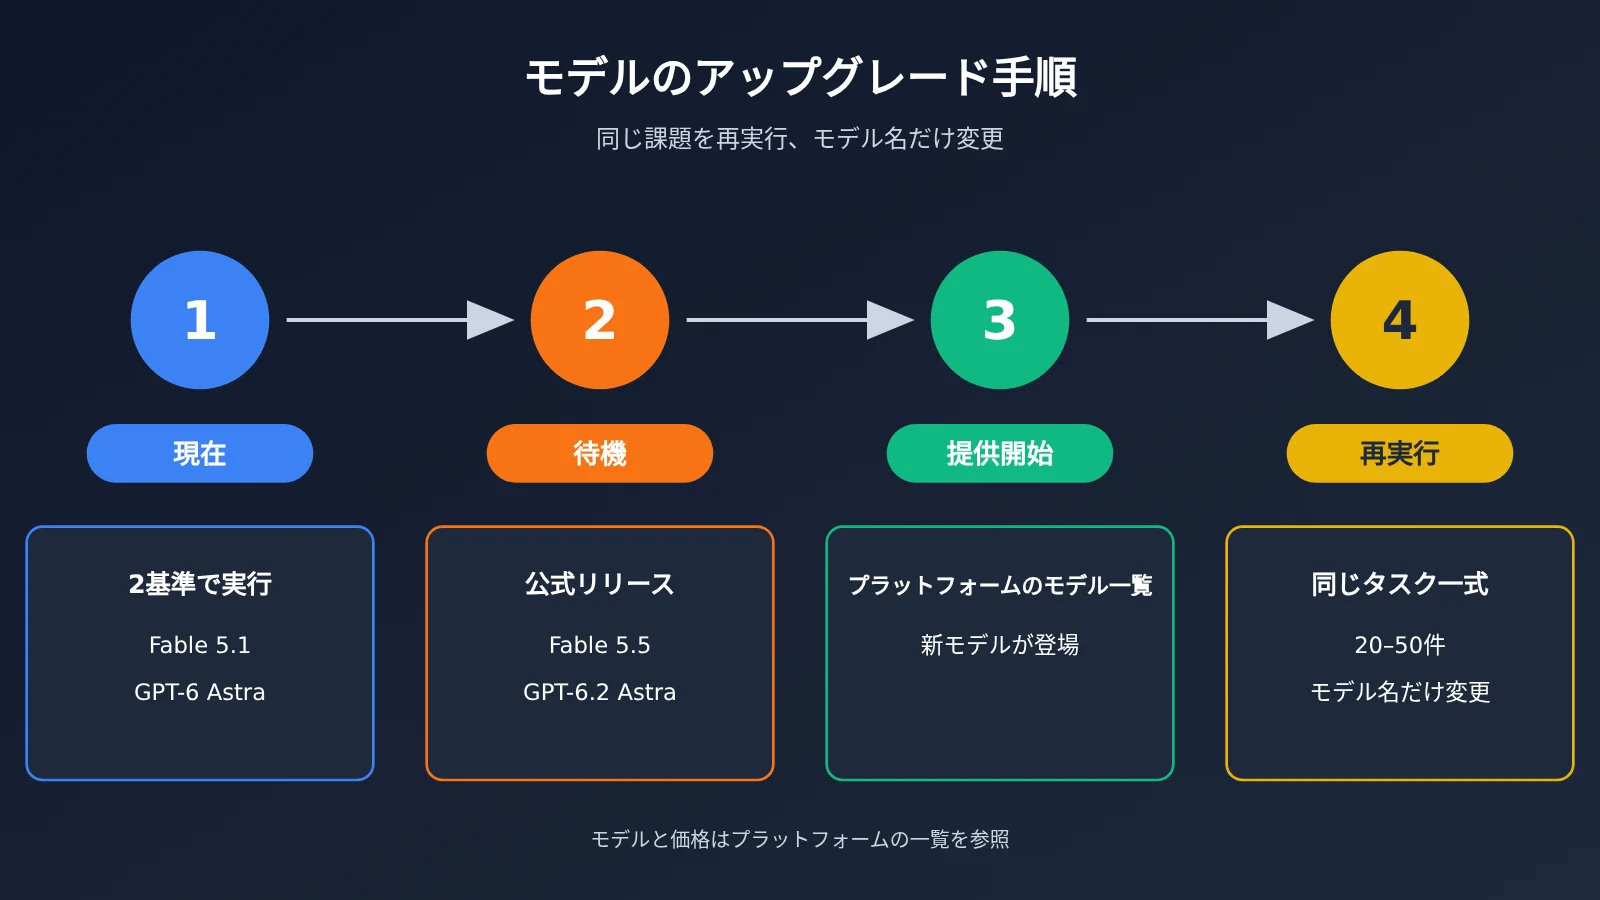
この段階の目的は、新モデルの性能を先に知ることではありません。問題セット、評価基準、記録表をあらかじめ用意しておくことにあります。Fable 5.5またはGPT-6.2 Astraが正式にリリースされたら、モデル名を変更するだけで、1〜2日以内に自分たちの用途に即した結論を得られます。他の人のデモやスクリーンショットに頼る必要もありません。
Fable 5.5 vs GPT-6.2 Astra:選び方と評価方法
結論:新モデルを待つ必要はありません。まず現行のフラッグシップモデルでベースラインを作りましょう。モデルの選定は、公開デモではなく、自分たちの20〜50件のタスクに基づいて判断することが大切です。
2026-11-03時点では、Fable 5.5とGPT-6.2 AstraはどちらもAPIYIでまだ提供されていません。モデルがリリースされ次第、できるだけ早く両モデルを提供する予定です。モデル名と価格は、プラットフォームのモデル一覧をご確認ください。それまでは、以下のように用途に応じて初期評価を進められます。
- 長文ドキュメント、大規模コードベース、長いコンテキストの繰り返し利用:まずは
claude-fable-5-1を評価しましょう。1M以内の入力価格は変わらず、キャッシュ読み取りは$0.25なので、コストを予測しやすくなります。 - 推論予算を細かく調整したい、Web検索やcomputer useを利用したい:まずは
gpt-6-astraを評価しましょう。推論は5段階から選べ、公式が挙げるツール機能もより充実しています。 - 単一ファイルのフロントエンド、クリエイティブな可視化タスク:両モデルに参考作品がありますが、いずれも作者による自己申告です。アイデアの参考にとどめ、自分たちの課題で検証しましょう。
- 知識の新しさが重要な場合:Fable 5.1の知識カットオフは2026-06、GPT-6 Astraは2026-04-30です。差は約2か月で、検索ツールとの併用で補うこともできます。
自社評価の進め方
評価の基本は「すべての条件を固定し、モデル名だけを変える」ことです。具体的には、次の手順で進めます。
- 実際の業務から20〜50件のタスクを抽出し、コード、長文ドキュメント、構造化出力などの主要な種類をカバーします。各タスクには合格基準を明記します。
- システムプロンプト、ユーザープロンプト、最大出力トークン数、推論レベルを固定します。Fable 5.1ではeffort、GPT-6 Astraではレベル名を記録します。
- 各タスクのinput tokens、output tokens、エンドツーエンドの所要時間、人手による合否判定を記録します。
- 入力が27.2万トークンを超えるタスクは個別に明記し、実際の段階別料金に基づいてコストを計算します。
- まず
claude-fable-5-1とgpt-6-astraでそれぞれベースラインを測定します。新モデルの提供開始後は、モデル名だけを変え、同じタスクセットで再実行します。
記録表には、少なくとも以下の項目を含めると、モデル間や時系列での比較がしやすくなります。
| 項目 | 記録内容 | 用途 |
|---|---|---|
| タスクIDと種類 | コード / 長文ドキュメント / 構造化など | 用途別の合格率を確認 |
| モデル名と推論レベル | 例:gpt-6-astra high |
再実行時の条件を統一 |
| input / output tokens | プラットフォームが返すusage | 1タスクあたりの実コストを計算 |
| 所要時間 | リクエストから応答完了まで | 対話時の使い心地を評価 |
| 人手による合否 | 合格 / 不合格 + 理由 | 最終的な品質指標 |
💡 選定のヒント:同じキーで両社のモデルを実行すれば、複数アカウント間のネットワークやレート制限の違いが結果に影響するのを避けられます。APIYI apiyi.comを通じて統一的に呼び出せば、記録するusageフィールドの形式がそろい、集計表もまとめやすくなります。
よくある質問と今後の対応
Q1:Model Tests のデモは、Fable 5.5 が GPT-6.2 Astra より優れている証拠になりますか?
なりません。両者は同じ課題でテストされておらず、推論レベル、日付、作品数も異なります。また、使用したモデルは作者の自己申告です。分かるのは、作者の説明によれば、どちらも動作する、または鑑賞できる完成品を生成できるということまでです。
Q2:Fable 5.5 と GPT-6.2 Astra はリリースされていますか?いつ使えるようになりますか?
2026-11-03 時点で、両社の公式モデル一覧にこれらのモデルは掲載されておらず、信頼できるリリース日も公表されていません。同日時点では APIYI でもまだ提供していませんが、できるだけ早く両モデルを追加する予定です。モデル名と価格はプラットフォームのモデル一覧をご確認ください。追加後は APIYI apiyi.com のモデル一覧で直接確認できます。
Q3:トラフィックの 19.8% を示すスクリーンショットは信頼できますか?
これは X ユーザーの TokenGremlin による個人のスクリーンショットです。それ以前の Linux.do の投稿では 1.6% にとどまっており、モデル選択画面には引き続き GPT-6 Astra と表示されていました。ユーザーごとの報告にも食い違いがあります。どちらの数字もコミュニティの自己申告であり、公式データではありません。一部のアカウントの利用明細にこのモデル名が表示されたことを示すにとどまります。
Q4:今は新モデルを待つべきですか?それとも現行のフラッグシップモデルを使うべきですか?
まずは現行のフラッグシップモデルを使うことをおすすめします。Fable 5.1 と GPT-6 Astra は単価が同じで、どちらもトップクラスの性能を持ち、今すぐ本番環境で利用できます。さらに重要なのは、先に評価用の問題集を用意しておくことです。そうすれば、新モデルの提供開始時に素早く評価できます。APIYI apiyi.com では、無料テスト枠を使って少数のサンプルを試し、評価手順を検証できます。
Q5:両社の現行フラッグシップモデルは価格が同じですが、コストに差は出ますか?
差は出ます。`gpt-6-astra` は 1 回の入力が 272,000 tokens を超えると、入力料金が $10 から $20 に上がります。また、キャッシュ読み取り料金は $1 で、`claude-fable-5-1` は $0.25 です。長いコンテキストを使い、キャッシュのヒット率が高い場面では特に差が大きくなるため、実際の token 使用量の分布に基づいて計算することをおすすめします。
アクションの提案
今月、モデルの選定を進めているチームには、次の3ステップをおすすめします。まず今週中に、業務から20〜50件のタスクと合格基準を整理します。次に、APIYI apiyi.com で同じAPIキーを使い、claude-fable-5-1 と gpt-6-astra の両方をベースラインとして実行し、トークン数、所要時間、人手による評価の合格率を記録します。Fable 5.5 または GPT-6.2 Astra が正式にリリースされ、プラットフォームで利用可能になったら、モデル名だけを変更して同じタスクを再実行します。こうすることで、自社のタスクに基づき、同じ条件で比較したデータが得られます。どんなデモやスクリーンショットよりも信頼できる判断材料になるでしょう。モデル名と価格は、プラットフォームのモデル一覧をご確認ください。
参考資料
- OpenAI モデル一覧:GPT-6 Astra の公式仕様と価格
- リンク:
developers.openai.com/api/docs/models - 補足:2026-11-03 に確認。モデル一覧に GPT-6.2 Astra の掲載なし
- Anthropic プラットフォームの価格・モデルページ:Fable 5.1 の公式仕様、価格、キャッシュの課金体系
- リンク:
platform.claude.com - 補足:2026-11-03 に確認。価格ページとニュースページに Fable 5.5 の掲載なし
- Model Tests 第三者テストサイト:作者 @notjazii による公開デモ集
- リンク:
model-tests.vercel.app - 補足:モデルの帰属は作者の自己申告によるもの。プロンプトと呼び出しログの公開なし
著者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお気軽にお問い合わせください。モデルと接続に関するドキュメントは docs.apiyi.com でご覧いただけます