本記事では、GPT-6.1 Sol と GPT-6.2 Sol の移行、カスタマーサポート、コードの各事例を通じて、まず業務上の受け入れ条件を固定し、そのうえで安定して基準を満たせる推論ティアを選び出し、合格タスクあたりのコストを算出する方法を解説します。
まず結論から:ティアを調整する際に比較すべきは「合格タスク1件あたりにいくらかかるか、どれだけ時間がかかるか」であり、1回の呼び出しの定価はその一部にすぎません。公開されている小規模サンプルの実測では、GPT-6.2 Sol の low はカスタマーサポートのポリシー問題とコード問題のセットのいずれでも medium と同じ合格数に達し、しかも所要時間は短くなりました。コード問題では、low の定価換算コストは medium の約7割です。この結論が成り立つには2つの条件があります。あなたのタスクがテストタスクと十分に類似していること、そして受け入れ基準が合格率だけではなく、架空のリンク、金額フィールド、手戻りもチェックしていることです。資料間の矛盾、複雑なツール依存、制約の見落としが起こりやすいタスクでは、引き続き medium 以上のティアを個別に検証すべきです。
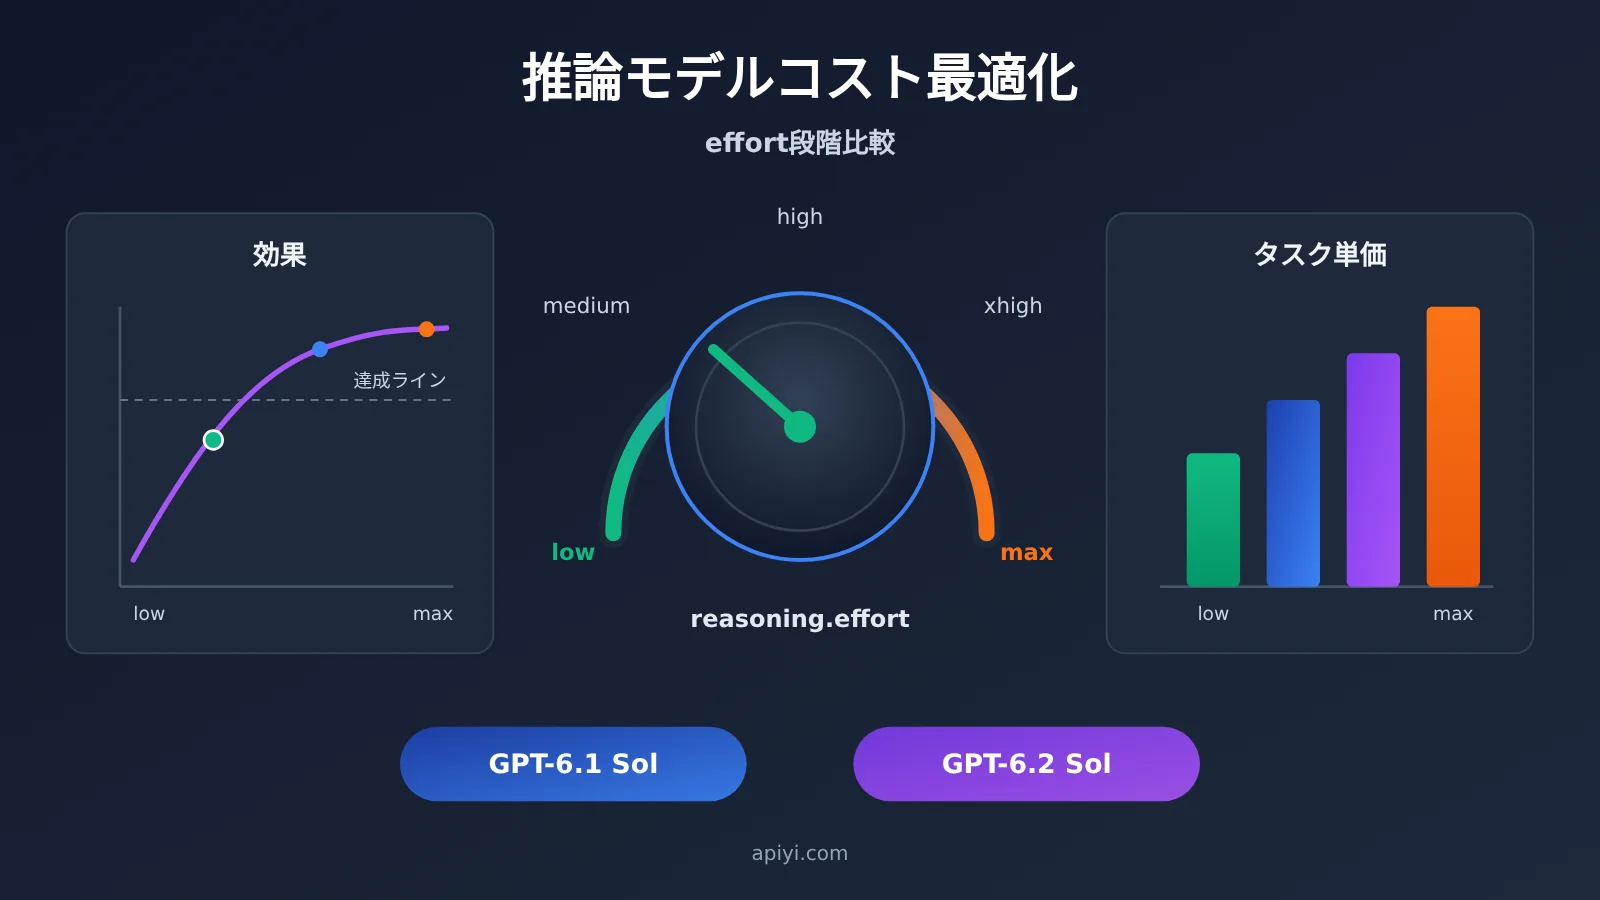
推論モデルの effort ティア比較早見表
下表は本記事で用いるいくつかの根拠をまとめたもので、各行に出典と算出基準を明記しています。出典の異なる数値をそのまま足したり混ぜたりすることはできません。
| 比較軸 | GPT-6.1 Sol | GPT-6.2 Sol | 差異が意味するもの |
|---|---|---|---|
| 選択可能なティア(OpenAI ドキュメント) | low、medium、high、xhigh、max | 同じ5ティア。none は受け付けない |
none/minimal を設定できるモデルから移行する場合は、開始ティアを変更する必要がある |
| APIYI の短コンテキスト定価(2026-11-20 の一覧表、米ドル/100万トークン) | 入力 $2、キャッシュ読み取り $0.10、出力 $10 | 同じ | 短コンテキストでは両世代の価格は同一で、コスト差は主に使用量から生じる |
| 入力 272,000 トークン超の入力価格 | APIYI と OpenAI Standard はいずれも $4 | APIYI は $3、OpenAI Standard は $4 | 長い入力のシナリオでは、チャネル間で価格差が生じる |
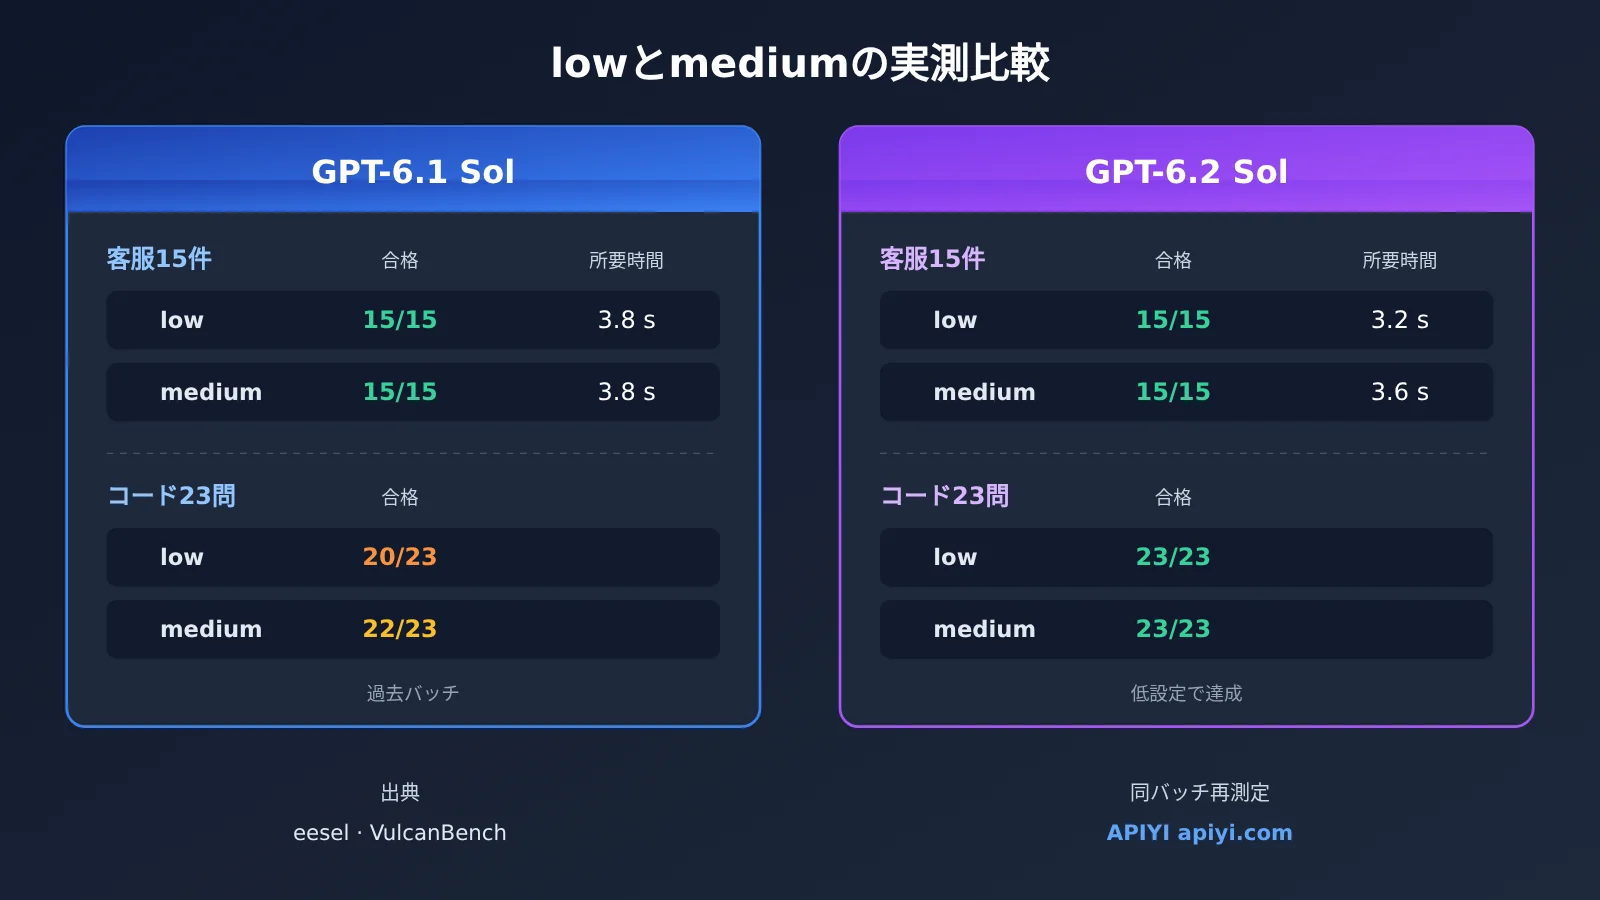
| eesel カスタマーサポート15チケット(low / medium) | 15/15、3.8秒、15/15、3.8秒 | 15/15、3.2秒、15/15、3.6秒 | 合格率は同じで、ティア間のコスト差はごく小さい |
| VulcanBench のコード問題23問(low / medium) | 20/23、22/23(過去バッチ) | 23/23、23/23 | 6.2 Sol は低ティアで既に基準を満たす。バージョン間の数値は異なるバッチ由来 |
| Artificial Analysis Index(OrcaRouter 経由で引用、low / medium) | 35、46 | 41、53 | サードパーティの総合指数で、ティアのラベルは当該評価側が独自にマッピングしたもの |
本文は次の順で進めます。第1節では接続可否と課金方法を確認し、第2節では同一タスクでの実測結果を見ます。第3節では移行と受け入れの手順を示し、第4節ではマルチターン会話の途中でティアを変更する問題を扱います。モデルのルーティングと価格をすでに確認済みであれば、第2節から読んでも構いません。
推論モデル向け effort レベル関連の用語
| 用語 | 説明 |
|---|---|
reasoning.effort |
Responses API でモデルの思考強度を設定するためのフィールド |
| 推論トークン | モデルが回答を導き出すために消費する推論使用量。課金対象の output_tokens に含まれ、ユーザーに表示される出力とは区別する必要があります |
low / medium |
2つの推論レベル。同じレベルでも新しいバージョンに切り替えた後は、改めて検証する必要があります |
| キャッシュ読み取りの単価 | 再利用可能なプレフィックスにヒットした入力部分にのみ適用され、総トークン数から直接算出することはできません |
| リクエストプレフィックス | 現在のメッセージより前にすでに存在するコンテキスト。早い段階の履歴を変更すると、キャッシュと推論項目の再利用に影響します |
configuration_update |
この機能をサポートする Responses セッションで、後続の設定を調整するための入力項目 |
| 受け入れ基準 | ポリシーの正確性、機能の合格、または手直しのレベルに対して設ける最低限の許容基準 |
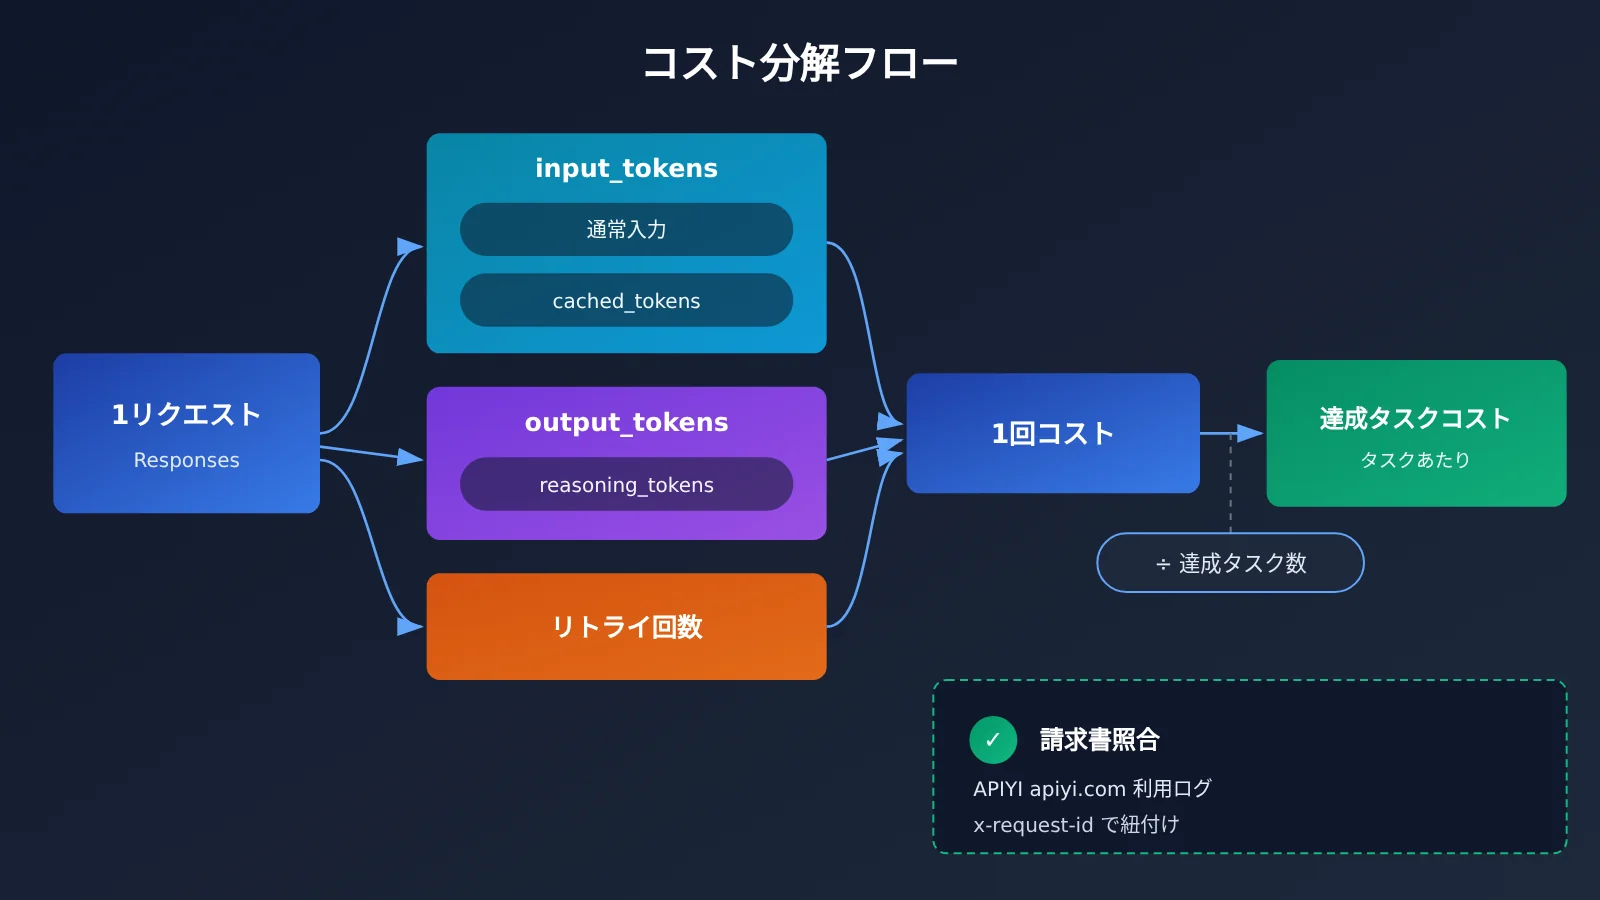
| 基準達成タスク1件あたりのコスト | 試験全体における呼び出し、リトライ、ツール、および人による手直しのコストを、基準を満たしたタスク数で割ったもの |
1. 推論モデルのコスト最適化の前に:effort レベルを調整する価値があるのはどんなときか
1.1 2世代の Sol の APIYI での提供状況
APIYI プラットフォームの更新情報によると、GPT-6.1 Sol は 2026-09-30 に公開され、GPT-6.2 Astra と Sol は 2026-11-18 に公開が告知されました。2026-11-20 時点の料金一覧表では、2つの Sol はいずれも responses と chat の2種類のルートを提供しており、対象となるグループは CodexResponses、Codex_Reverse、Default、SVIP です。アカウントで実際に呼び出せる機能は、API トークンが属するグループによって決まります。
OpenAI のドキュメントによると、2世代の Sol はどちらも Chat Completions と Responses をサポートしていますが、ツール呼び出しは必ず Responses 経由で行う必要があります。推論レベルは reasoning.effort で設定します。そのため、業務に注文照会やコード実行といったツール連携が含まれる場合は、評価と本番投入のいずれも Responses ルートに統一し、2つのルートの挙動差が比較結果に混入しないようにしましょう。
1.2 2つの料金基準:APIYI の掲載価格と上流の標準価格
| モデル ID(APIYI 総合表、2026-11-20) | 通常入力 | キャッシュ読み取り | 出力 | 利用可能なプラットフォーム |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com、OpenAI 公式 |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com、OpenAI 公式 |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
上の表は短いコンテキストにおけるデフォルトの掲載価格で、単位は米ドル/100万 Token です。OrcaRouter がまとめた上流の料金表では、2世代の Sol に対して同じ入力・キャッシュ読み取り・出力価格が記載されており、さらにキャッシュ書き込み $2.50 が別途記載されています。長いコンテキストについては個別に確認が必要です。gpt-6.2-sol で入力が 272,000 Token を超える場合、APIYI では現在 $3、OpenAI 公式の Standard では $4 と表示しています。gpt-6.1-sol は両方とも $4 です。長コンテキスト区分のキャッシュ価格と出力価格は、各チャネルのリアルタイムな課金ルールに従ってください。
1.3 コストは実際のレスポンスと請求明細から読み取る
表示価格はあくまで見積もり用です。以下では、仮の計算例を使ってコストがどのように分解されるかを説明します。各ラウンドの入力が12,000 Token、キャッシュ書き込みとツール料金がないと仮定します。
- プレフィックスを保持:キャッシュ読み取り9,000、総出力1,000、概算で約$0.0169。
- プレフィックスを変更:キャッシュ読み取りが3,000に減少、総出力が1,600に増加、概算で約$0.0343。
この差額のうち、約$0.0114は6,000個の入力Tokenがキャッシュ価格から通常価格に戻ったことによるもので、約$0.0060は追加の600個の出力Tokenによるものです。これは仮定のデータであり、実際の差額はusageを基準にしてください。キャッシュ書き込みが単独項目として存在する場合は、通常入力・キャッシュ読み取り・キャッシュ書き込みを3つの相互排他的カテゴリとして個別に計算します。
実際の課金額を照合する方法:レスポンスヘッダーのx-request-idを使って、APIYIの消費ログにあるtype=2のレコードを関連付け、quota ÷ 500,000で実際の課金額のドル換算値を求めます。あわせて、モデル、トークングループ、呼び出し時間ウィンドウ、入出力使用量、リトライ回数を記録します。
以下は最小限の呼び出し例で、診断に必要な使用量フィールドも同時に読み出します。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 クイックスタート:まずAPIYI apiyi.comで新規ユーザー向けの無料枠を使い、上記のサンプルを正常に実行できるか確認することをおすすめします。対象グループが
cached_tokensとreasoning_tokensを正常に返せることを確認してから、バッチ評価を開始してください。
2. 同一タスクでの比較:low と medium 帯の実測結果
2.1 カスタマーサポートチケット:低い帯でのメリットはごくわずか
eesel のテスターは 2026-11-18 に Responses API を通じて、2世代の Sol それぞれについて low と medium の2帯をテストし、合計60回の呼び出しを行いました。各設定は同じ15件のチケットを対象としており、内容は返金、配送状況の照会、注文ツールの失敗などです。採点は人手によるもので、架空の SaaS ポリシーに基づいて行われました。
| 設定(eesel、15チケット) | 通過 | 平均所要時間 | 定価換算/1000件 |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3.8 秒 | $1.32 |
| GPT-6.1 Sol medium | 15/15 | 3.8 秒 | $1.35 |
| GPT-6.2 Sol low | 15/15 | 3.2 秒 | $1.41 |
| GPT-6.2 Sol medium | 15/15 | 3.6 秒 | $1.42 |
このデータでは、low と medium の差は1000件あたり数セント程度しかありません。そのため帯を選ぶ判断材料は、コストよりもレイテンシーになることが多くなります。また、実測の使用量で換算すると、GPT-6.2 Sol はこのカスタマーサポートの設問群では 6.1 Sol よりもやや高コストでした。さらに重要なのは、4つの設定すべてが満点の通過率だったにもかかわらず、著者が 6.2 Sol がツール応答には存在しない配送リンクを出力するケースを確認している点です。つまりカスタマーサポートの受け入れ検査が「ポリシーに正しく答えているか」だけを見ていれば、こうした問題は見逃されます。リンクやフィールドの出所は、別途チェックする必要があります。これらの証拠は、このチケット群、この採点基準、そして OpenAI のテスト環境にのみ当てはまります。
2.2 コードタスク:低ティアの1問あたりコストは実測する価値がある
VulcanBench は 2026-11-19 に Codex を使い、GPT-6.2 Sol を同一の23問テストセット上でティアごとに順次実行し、合計115回の実行を行いました。以下の表の金額は実行レシートを API のリスト価格で換算したものであり、APIYI アカウントの実際の決済額ではありません。
| 設定(VulcanBench、23問) | 合格 | 平均所要時間 | リスト価格換算/問 | 総合スコア |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2.8 分 | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4.4 分 | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11.3 分 | $0.55 | 88.74 |
| GPT-6.1 Sol low(過去バッチ) | 20/23 | 6.9 分 | $0.31 | — |
| GPT-6.1 Sol medium(過去バッチ) | 22/23 | 10.6 分 | $0.40 | — |
GPT-6.2 Sol のグループだけを見ると、low と medium は合格数が同じで、1問あたりのコストは約3割低く、所要時間も短くなっています。max の総合スコアは medium を上回っていません。バージョン間の比較には注意が必要です。6.1 Sol のデータは同一問題集の過去評価に由来し、別のテストバッチに属します。総合スコアはコード品質の評価であり、テスト合格率とは別の指標で、互いに代替できるものではありません。
OrcaRouter が引用した Artificial Analysis Index v5.0.1(2026-11-20 取得)は別の視点を示しています。low ティアでは 6.2 Sol が41点・1タスクあたり $0.18、6.1 Sol が35点・$0.16。medium ティアではそれぞれ53点・$0.41 と46点・$0.36 です。この総合ランキングのティア表記は評価者独自のマッピングであり、あなたが使うフレームワークが同じマッピングを採用しているとは限りません。
💡 選択のヒント:上記2つの実測が示すのは、合格ライン・リトライ率・人手による手直しのいずれもが「最もコスパの良いティア」を変え得るということですが、それらはいずれもあなた自身の業務の請求額ではありません。APIYI apiyi.com 上で、同じグループ・同じサンプル群を使って再テストしたうえで判断することをおすすめします。
3. 推論モデルのコスト最適化における移行順序と受け入れ基準
3.1 まずベースラインを維持し、その後でティアを調整する
OpenAIの「Using GPT-6.2」の推奨に沿って、移行時は一度に1つの変数だけを変更します。
- 現状 6.1 Sol
lowを使用:まず 6.2 Sollowに切り替えて比較対照とし、その後でmediumを単独でテストします。 - 現状 6.1 Sol
mediumを使用:まずモデルだけを切り替えてmediumを維持し、受け入れ検査に合格した後、同じタスク群でlowを比較します。 - 新規導入:
mediumからスタートします。 noneやminimalを設定できるモデルからの移行:GPT-6.2 Sol はlowからテストを始めます。
制約が明確なシンプルなタスクでは、low から検証を始めて構いません。複合的なタスクでは、結果に応じて段階的にティアを上げていきます。評価期間中は、プロンプト、ツール定義、グルーピング、テストサンプルを固定してください。あわせて公式の説明に従い、もはや適用されないパラメータを整理します。たとえば Responses リクエストでは temperature、top_p、top_logprobs を外します。
3.2 シナリオごとに受け入れ基準を定義する
| シナリオ | 受け入れ基準 | 上位ティアへの引き上げを検討するタイミング |
|---|---|---|
| 一般的なカスタマーサポート | ポリシーとの一貫性、金額フィールドの正確性、有人対応へのエスカレーション条件。リンクと伝票番号はツールの戻り値に由来すること | ポリシー間の衝突や複数ツールの連携が関わる場合 |
| コード修正 | テストの通過、主要機能の完全性、コードレビューでの手戻り量 | 低いティアでの通過率が下がったり、手戻りが明らかに増えたとき |
| 短文コンテンツ | 制約の遵守、事実フィールド、人手による修正時間 | 制約の抜け漏れや事実誤認が出たとき |
合格タスク1件あたりのコストは、呼び出し・リトライ・ツール・人手による手戻りの費用を合計し、合格タスク数で割って算出します。low が合意した基準に達していれば low を選んで問題ありません。ただし low で何度もリトライや人手による補修が必要になるなら、見た目上の安さは帳消しになる可能性があります。
💰 コスト最適化:ティアの比較対照を行う際は、APIYI(apiyi.com)で評価用のトークンを別途作成しておくと、ログをトークンとモデルで直接絞り込めるので、試験バッチ全体の実際のコストを簡単に把握できます。
4. マルチターン会話の途中でeffortレベルを調整する
4.1 configuration_updateでレベルを変更し、プレフィックスを保持する
この機能をサポートするOpenAI HTTP Responsesのシングルエージェントセッションでは、リクエストレベルの reasoning.effort は初期値のまま変更せず、次の項目を次のユーザーメッセージの前に置きます:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
この設定は次回更新されるまで有効です。利点は、過去の履歴を書き換える必要がなく、リクエストのプレフィックスがそのまま保たれることです。OpenAIのドキュメントによると、GPT-6.2以降では過去の履歴を編集すると prefix_mismatch が発生する可能性があり、既存の推論項目が削除されることがあります。モデルファミリーを切り替えたり、能力の低いモデルにダウングレードしたりしても、推論項目が削除される可能性があります。プレフィックスを書き換えるコストは二つあります。キャッシュ読み取りが減る可能性があり、利用可能な推論項目を失った後には新たな推論出力が生成される可能性もあるからです。公式の説明によると、項目全体を削除して残りの項目を変更しない場合、あるいは推論項目の後に新しい項目を追加する場合は、この削除は発生しませんが、キャッシュヒット量は変化する可能性があります。また、GPT-6.2のトップレベル instructions は input の後に追加され、未キャッシュの入力として課金されます。
4.2 コンテキスト圧縮とAPIYIルーティングの注意点
サーバー側の context_management を使用する場合、更新後の設定を引き継ぐことができます。古い configuration_update を含む履歴をそのまま独立した /responses/compact エンドポイントに渡すと、リクエストは拒否されます。正しい方法は、公式の説明に従ってまず設定項目を分離し、圧縮が完了した後に最新の設定をもう一つ追加することです。
APIYIでは、現時点で確実な方法は input 履歴を自分で管理し、previous_response_id に依存しないことです。理由は、APIYIのネイティブ呼び出しガイドのこの点に関する記載が一貫していないためです。本文ではチェーン継続が機能しないと述べられていますが、FAQには2026-09-02に実際に動作したと記録されています。また、APIYIのドキュメントには現在、configuration_update の各グループでの検証結果も記載されていません。したがって、こうした特有の設定、暗号化された推論項目の返送、キャッシュ診断フィールドについては、まず対象チャネルでショートセッションを使って個別に検証し、使用可能であることを確認してから正式なワークフローに組み込むべきです。
🎯 技術提案:まずAPIYI apiyi.comのResponsesルーティング上で2ターンのショートセッションを実行し、「追記のみ」と「プレフィックス書き換え」の2種類のサンプルについて
cached_tokens、reasoning_tokens、所要時間を比較して、挙動を確認したうえで途中でのレベル変更の実装方法を決めるとよいでしょう。
最後に一言:レベルを選ぶ根拠は、固定した受け入れ基準の下での、基準を満たすタスクあたりのコストであるべきです。APIYI apiyi.com上で自分のサンプルと請求書を使って一回比較を回すことが、どんなランキングよりも問題を明確に示してくれます。
参考資料
- OpenAI「GPT-6.2 の活用」:移行と初期ティアの推奨事項
- リンク:
developers.openai.com/api/docs/guides/latest-model
- リンク:
- OpenAI「Reasoning models」:
configuration_updateと推論項目の再利用- リンク:
developers.openai.com/api/docs/guides/reasoning
- リンク:
- OpenAI「Compaction」:コンテキスト圧縮のルール
- リンク:
developers.openai.com/api/docs/guides/compaction
- リンク:
- OpenAI「Keep the prefix unchanged」:プレフィックスとキャッシュの診断
- リンク:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- リンク:
- eesel AI「GPT-6.2 Sol: what’s new, pricing, benchmarks」:カスタマーサポートチケットによる実測、2026-11-18
- リンク:
eesel.ai/blog/gpt-6-2-sol
- リンク:
- VulcanBench「GPT-6.2 Sol across effort levels」:コーディング課題の難易度別評価、2026-11-19
- リンク:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- リンク:
- OrcaRouter「GPT-6.2 vs GPT-6.1 Sol」:価格表と総合指数の引用、2026-11-20
- リンク:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- リンク:
- APIYI「モデル価格一覧表」:データ更新日 2026-11-20
- リンク:
docs.apiyi.com/models
- リンク:
著者: APIYI 技術チーム
技術的なお問い合わせ: APIYI(apiyi.com)のトップページからお気軽にご連絡ください。接続方法の詳細は docs.apiyi.com のドキュメントセンターをご覧ください。