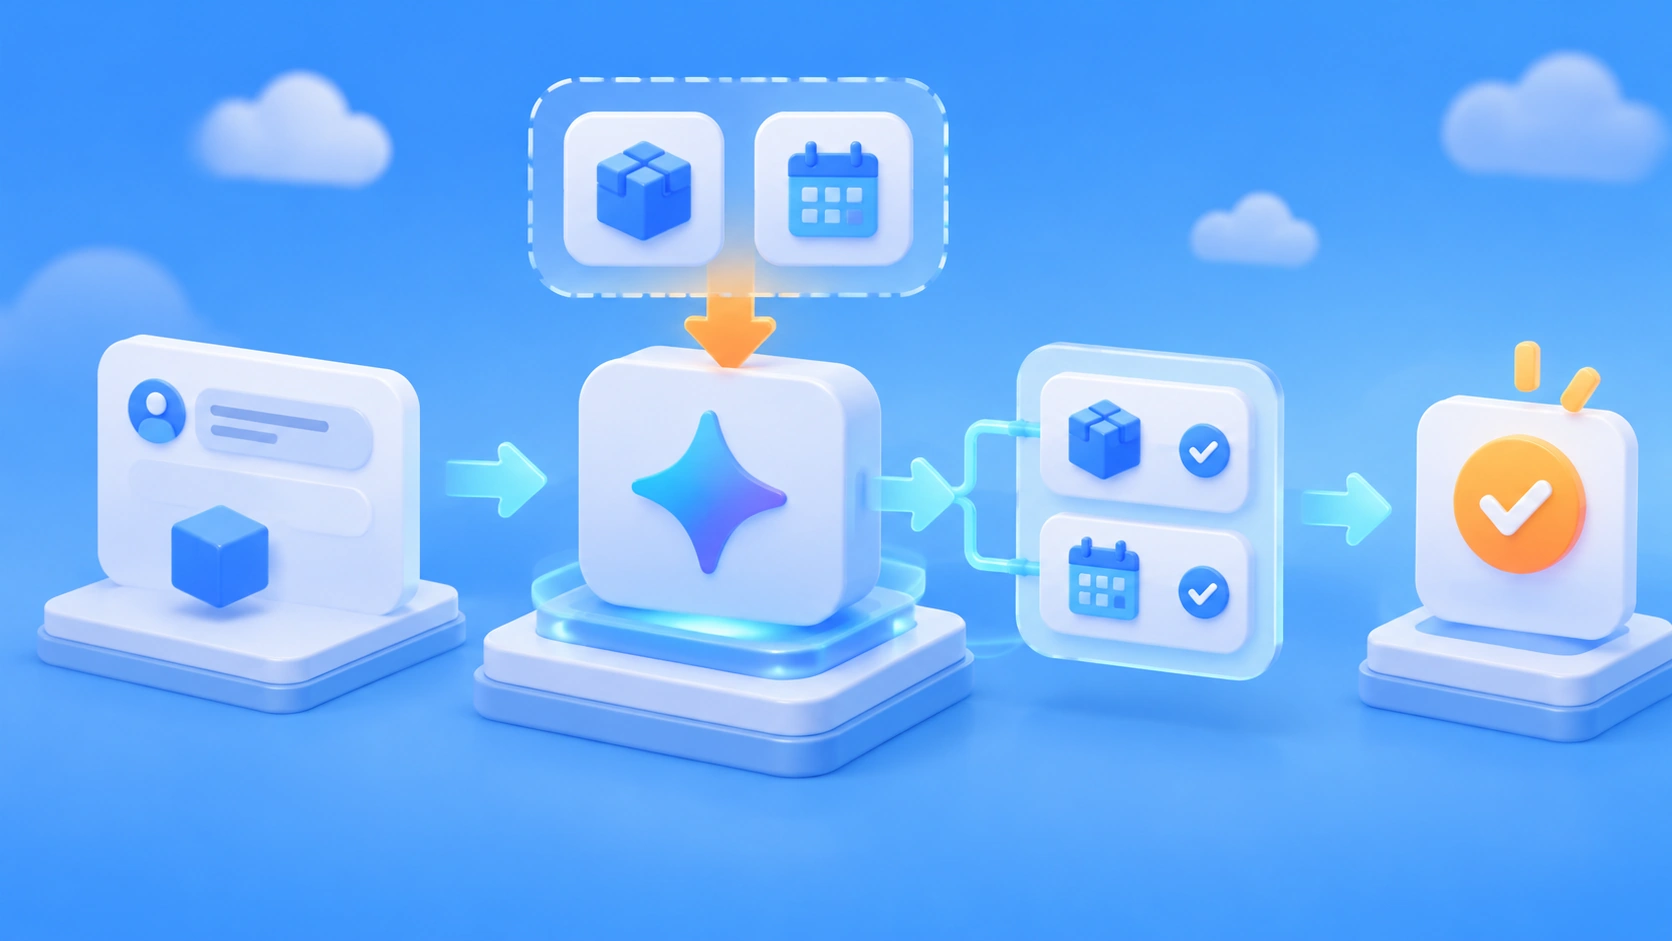
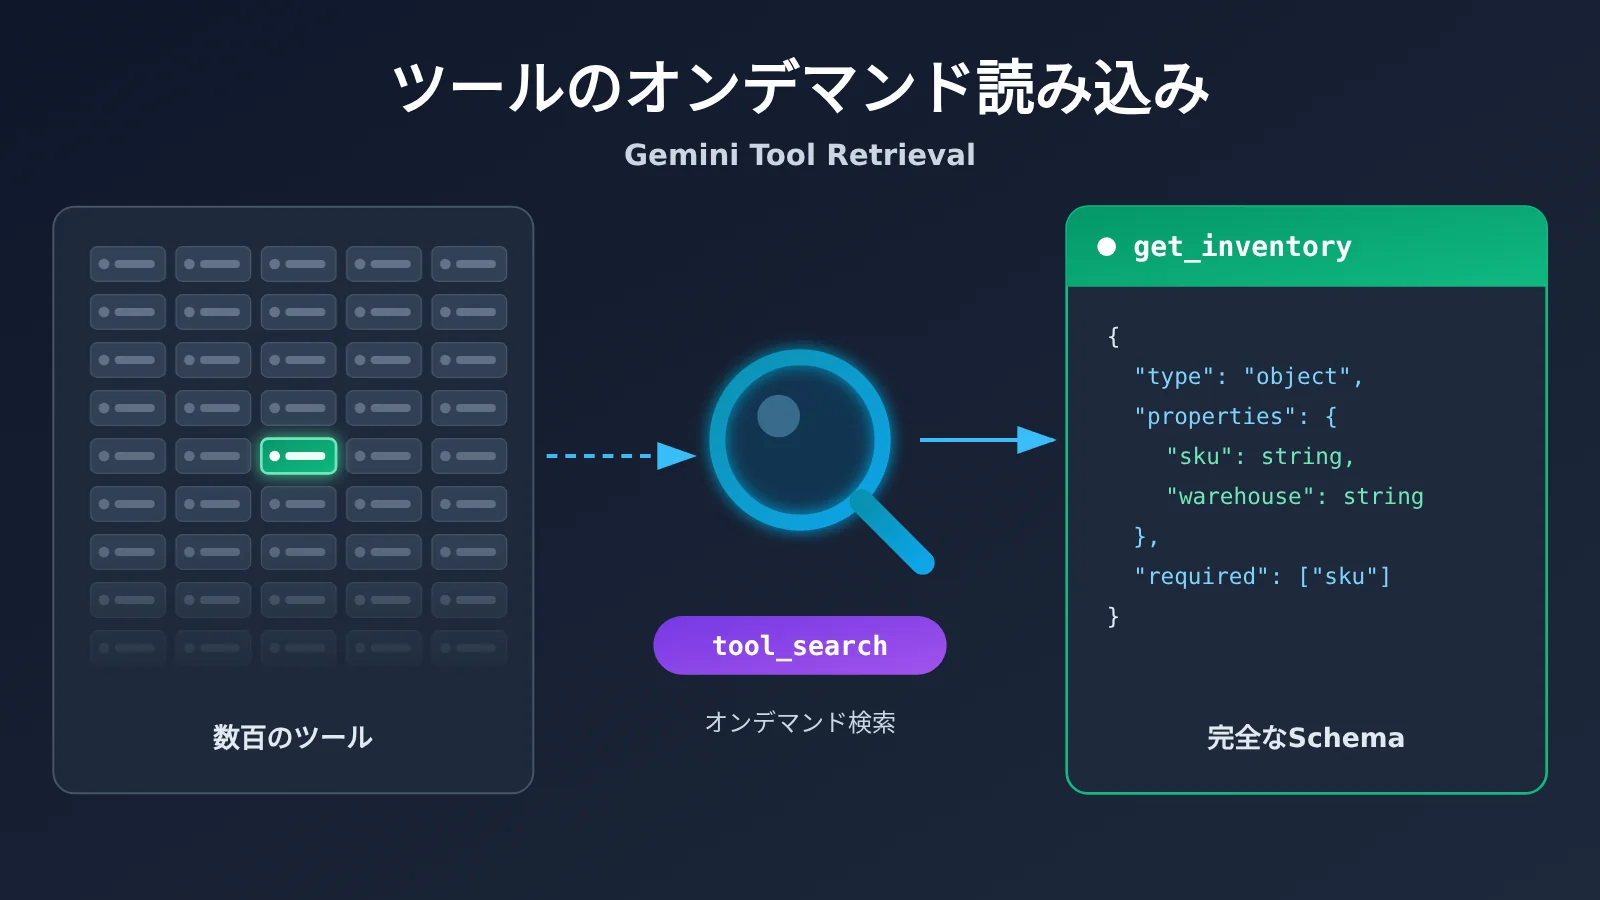
Gemini Tool Retrieval を導入するには、3つのことを行う必要があります。1つ目は、tools 配列に {"type": "tool_search"} を追加し、呼び出し頻度の低い業務関数に defer_loading: True を設定すること。2つ目は、v1beta バージョンの Interactions API でリクエストを送り、interaction.steps から function_call を見つけること。3つ目は、ローカルで関数を実行し、call_id に基づいて function_result を組み立て、完全な tools 配列を付けて返送することです。このプロセス全体を通じて、ツールサーチャーを自分で書く必要はありません。ツールの検索とパラメータ Schema のローディングはサーバー側が行います。
まずはっきりさせておきたいのは、Tool Retrieval が変えるのは「ツールのパラメータ定義がいつモデルのコンテキストに入るか」だけであって、関数は依然として開発者が実行しなければならないという点です。また、必ずしもコスト削減になるとは限りません。ツールが少なくコンテキストが長いシナリオでは、Token 消費がかえって増える可能性もあります。
この記事を読むと、次のことがわかります。
- Gemini Tool Retrieval がサポートするモデル、必要な SDK バージョン、そしてなぜ
v1betaを明示指定しなければならないのか - 変数名が前後で一貫した Python の完全なサンプル:在庫と注文という2つの遅延ツールを、検索から最終回答まで
tool_search_call、tool_search_result、function_call、function_resultをそれぞれ誰が処理するのか- リモート MCP の遅延読み込み、クライアント側での検索、自前の Tool Registry という3つの拡張ルートの違い
- HTTP 400 などのよくあるエラーをまとめて切り分ける方法、そして導入前に採算が合うかどうかをどう判断するか
索引:まず To Know テーブルでコアフィールドを説明し、続いて「影響の早見表」で、このプレビュー機能が役割ごとに何を意味するのかを示します。「客観的事実」パートは導入の順序に沿って展開します。環境準備、ツールの定義、検索ステップの観察、関数結果の返送、そして最後に MCP とクライアント側検索へと拡張し、エラーの切り分けはこのパートの末尾にまとめます。「分析・判断」パートでは、Google が示した2組の仮説的な算例をもとに、Tool Retrieval が向いている場面と向いていない場面を検討します。
Gemini Tool Retrieval の主要概念(理解すべき点)
| 概念 | 简要解释 |
|---|---|
| google-genai | Google 公式の Python SDK パッケージ名。インポート方法は from google import genai |
| v1beta | プレビュー版 API のバージョン。Tool Retrieval では必須であり、本記事ではクライアント初期化時に明示的に指定します |
| Interactions API | Google が Agent ワークフロー向けに提供するインターフェース。状態を持つ対話と、実行ステップの可観測性をサポートします |
tool_search |
ツール検索を有効化することを宣言する特殊なツールタイプ。1 リクエストにつき最大 1 つまで |
defer_loading |
指定した関数や MCP サーバーの完全なパラメータ定義を、モデルのコンテキストへの読み込みを遅延させます |
short_description |
モデルが最初に参照できる遅延関数の概要説明。遅延関数にのみ使用可能 |
tool_search_call |
サーバー側の検索フローにおいて、モデルが発行する検索ステップ |
tool_search_result |
サーバーが一致するツールの完全な Schema を返すステップ |
function_call |
モデルが開発者側のコードに対して特定の関数の実行を要求し、引数を提示するもの |
function_result |
アプリケーションが関数の実行結果をモデルに返す際に使用する入力タイプ |
call_id |
関数の実行結果を元の function_call.id に対応付けるための識別子 |
previous_interaction_id |
後続のリクエストを、サーバー側に保存済みの対話記録に引き続き接続させるための識別子 |
signature |
ステートレスなセッションで履歴ステップを再生する際、元のステップと一緒にそのまま返す必要がある署名フィールド |
Gemini Tool Retrieval の影響早見表
| 対象者 | 実際の影響 |
|---|---|
| エージェント開発者 | ツール数の多いエージェントでは、ロングテールなツールを遅延読み込みできるようになり、自前でベクトル検索を構築する必要がなくなります。ただし Interactions API への切り替えが必要です |
| generateContent を既に利用しているチーム | 旧メソッドは Tool Retrieval に対応していないため、インターフェースの移行と戻り値構造のパース処理の見直しが必要です |
| MCP 連携者 | mcp_server レイヤーでまとめて defer_loading を設定でき、ツールごとに個別に宣言する必要がありません |
| コスト責任者 | 単独の機能課金はありませんが、サーバー側で検索するたびに課金対象のモデル呼び出しが追加で発生するため、total_tool_use_tokens を注視する必要があります |
| 小規模ツールライブラリのプロジェクト | ツールが十数個でコンテキストが長いといったシナリオでは、必ずしも割に合わず、静的読み込みのほうがコストを抑えられる場合があります |
Gemini Tool Retrieval の客観的事実:リリース情報と接続フロー
Gemini Tool Retrieval のリリース状況と対応モデル
2026年11月19日(北京時間11月20日未明)、Googleは公式ブログで「Introducing Tool Retrieval in the Gemini API」を公開し、Interactions APIにてTool Retrievalのプレビューを開放しました。執筆者はGemini APIプロダクトマネージャーのLucia Loher氏と、Google DeepMindのリサーチサイエンティストNora Kassner氏です。現在この機能はPreview状態にあり、正式リリース前にインターフェースが調整される可能性があります。
公告の表現はやや広範で、「Gemini 3.6以降のモデル、およびすべてのGemini 4モデルを含む」としています。しかし開発ドキュメントでは2026年11月20日時点で、4つのモデルIDのみが明示されています:gemini-4-hydrogen、gemini-4-argon、gemini-3.8-flash、gemini-3.6-flash。接続時はドキュメントに記載されたリストを基準にしてください。サポートされていないモデルに defer_loading を設定すると、HTTP 400が直接返されます。
Gemini Tool Retrieval の接続前準備:SDKとv1beta
Google公式のPython SDK googleapis/python-genai は2026年11月18日に v3.6.0 をリリースし、Tool Retrievalと関数結果に関連する公開Schemaを追加しました。インストールコマンドは次のとおりです:
pip install -U "google-genai>=3.6.0"
export GEMINI_API_KEY="your-key"   # 実際のキーをコードに書き込まないでください
バージョン番号には落とし穴があります。SDKは v3.0.0 以降、Gemini Developer APIクライアントがデフォルトで v1 を使用しますが、Tool Retrievalは v1beta を要求するため、初期化時に明示的に指定する必要があります:
from google import genai

client = genai.Client(
    http_options={"api_version": "v1beta"}
)
SDKは環境変数 GEMINI_API_KEY から認証情報を読み取ります。RESTを使用する場合、対応するエンドポイントは POST https://generativelanguage.googleapis.com/v1beta/interactions、認証ヘッダーは x-goog-api-key です。
ステップ1:tool_search と defer_loading で Gemini ツールを定義する
デモのシナリオには業務ツールが2つだけあります。get_inventory は商品在庫を照会し、get_order_status は注文ステータスを照会します。どちらも遅延読み込みに設定します。tools 配列内の各フィールドの役割は次のとおりです:
{"type": "tool_search"}:サーバー側検索を有効にします。デフォルトのexecutionはserverです。これがない状態でdefer_loadingを設定すると、defer_loading requires tool_searchというエラーが発生します。defer_loading: True:完全なparametersは初期コンテキストに入りません。モデルは最初、名前と簡単な説明だけを認識します。short_description:初期リストに表示される簡単な説明です。未記入の場合はdescriptionの最初の文が使われます。遅延でない関数に記入すると不正と判定されます。parameters:引き続き完全に提出する必要があります。遅延されるのは Schema がモデルのコンテキストに入るタイミングであり、サーバー側は依然として完全な定義を取得する必要があります。
どのようなツールが遅延に適しているのでしょうか。Google の推奨は混在利用です。高頻度のツールは直接読み込みを維持し、低頻度で専門的なロングテールツールは遅延読み込みします。また、システム指示で直接名前を指定するツールは遅延に設定しないでください。そうしないと、モデルが検索を迂回して直接呼び出し、読み込みコンテキストが不足してエラーになる可能性があります。名前が似ているツールには業務名前空間を付けることをおすすめします。たとえば billing_get_customer と crm_get_customer で区別し、どちらも get_customer という名前にしないようにしてください。
ステップ2:リクエストを送信して Gemini のツール検索ステップを観察する
以下がデモコードの全体です。在庫「12件」、注文ステータス demo_pending はいずれもローカルでシミュレートしたデータで、実際のシステムへの問い合わせは行いません。コードを実行するには、有効な Gemini APIキーとモデルへのアクセス権限が必要です。
import json
from google import genai

MODEL = "gemini-4-hydrogen"

client = genai.Client(
    http_options={"api_version": "v1beta"}
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "short_description": "Check product inventory by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    },
    {
        "type": "function",
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "short_description": "Check an order's current status.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"]
        }
    }
]

def execute_demo_tool(name, arguments):
    """ローカルで業務関数をシミュレートするもので、実際の在庫や注文は照会しません。"""
    if name == "get_inventory":
        return {"sku": arguments["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": arguments["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(f"Unknown tool: {name}")

# 1回目のリクエスト:モデルが必要なツールを発見して選択します
interaction = client.interactions.create(
    model=MODEL,
    input="查询商品 SKU-42 的可用库存。",
    tools=tools
)

print("执行步骤:")
for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
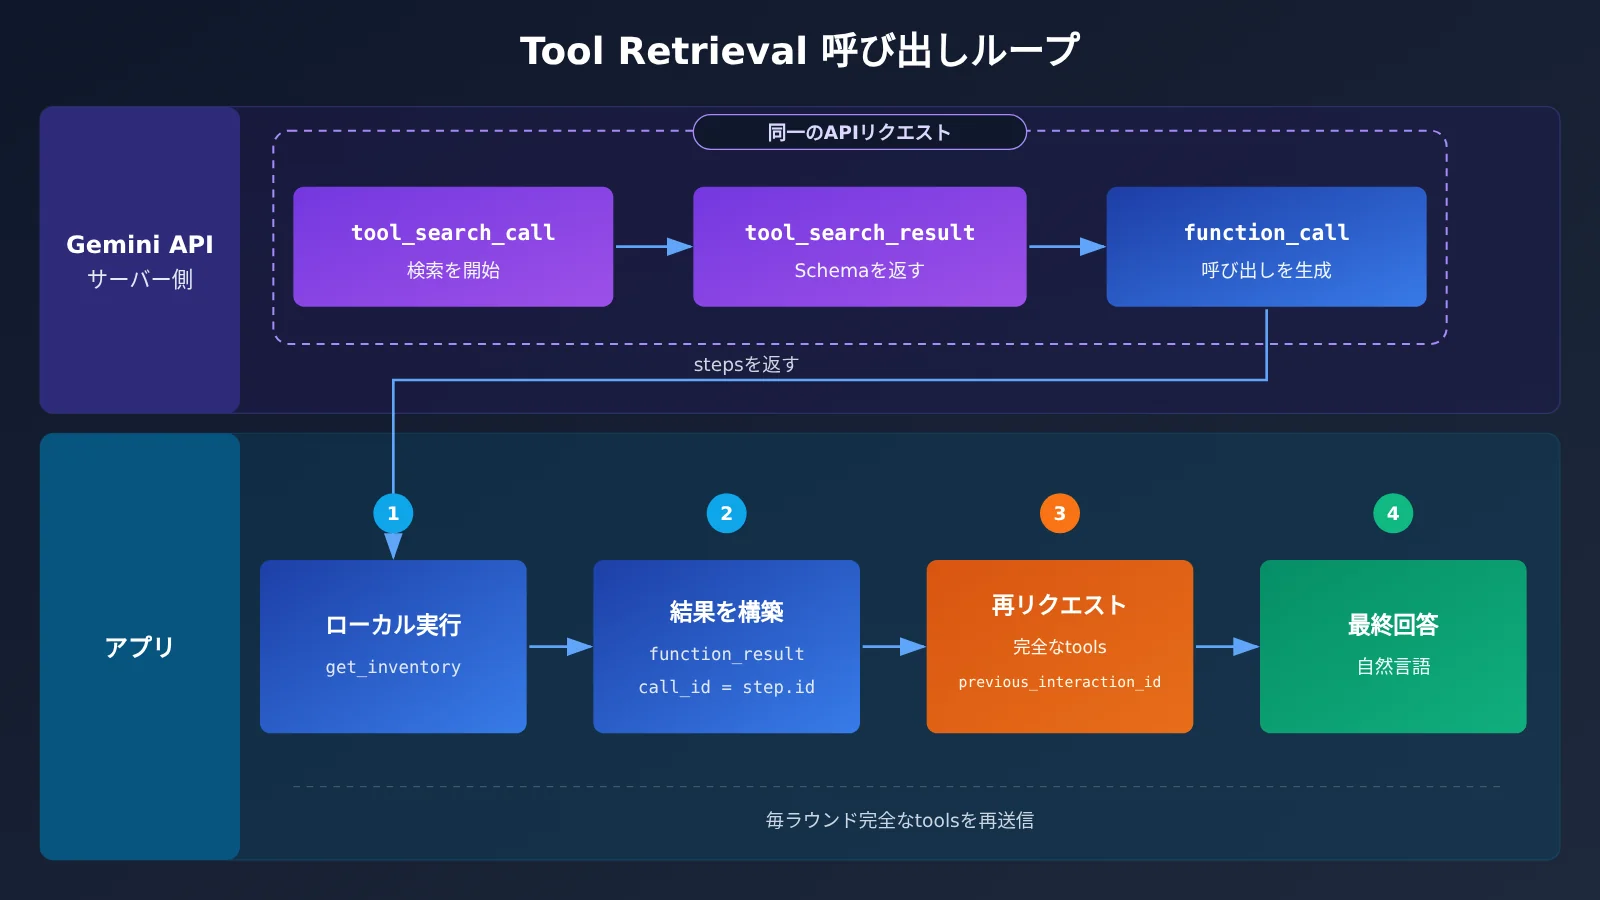
出力される interaction.steps は通常、次の順序で現れます。実際の順序や検索結果はモデルが決定し、1回のやり取りの中で検索が複数回発生することもあります。
tool_search_call:モデルは、読み込み済みのツールの中に適切なものがないと判断し、サーバー側の検索を開始します。tool_search_result:API が一致したget_inventoryの完全なパラメータ Schema を返します。function_call:モデルは Schema を読み取り、get_inventory(sku="SKU-42")のような呼び出しを生成します。
これら3つのステップは同一の外部 API リクエスト内で発生するため、アプリケーション側で検索器を別途書く必要はなく、検索リクエストを改めて送る必要もありません。最初の2ステップは観察と記録だけにとどめ、ローカルで検索を重複して実行しないでください。ただし「同一のリクエスト」は「推論が1回だけ走る」という意味ではありません。サーバー側の検索のたびに追加のモデル呼び出しが発生し、その分の Token は通常どおり課金されます。デバッグ時にもう1つ注意すべき点があります。interaction.status だけを見てはいけません。ステータスが requires_action でなくても、steps の中に実行待ちの function_call が含まれていることがあります。
ステップ3:関数を実行し、function_result を返送する
Tool Retrieval はツールの検索とパラメータの読み込みのみを担当し、実際のビジネス関数は引き続きアプリケーション側で実行します。この部分は標準の Function Calling メカニズムを踏襲します。前述のコードに続けて、次のように記述します。
# 実際のビジネス関数呼び出しのみを実行し、アプリ側では tool_search_call を実行しない
function_results = []

for step in interaction.steps:
    if step.type != "function_call":
        continue
    result = execute_demo_tool(step.name, step.arguments)
    function_results.append({
        "type": "function_result",
        "name": step.name,
        "call_id": step.id,
        "result": [{"type": "text", "text": json.dumps(result, ensure_ascii=False)}]
    })

# ローカル関数の結果を Gemini に返送する
if function_results:
    followup = client.interactions.create(
        model=MODEL,
        previous_interaction_id=interaction.id,
        tools=tools,
        input=function_results
    )
    print("最终回答:", followup.output_text)
else:
    print("当前回答:", interaction.output_text)
このコードには3点注意があります。第一に、call_id は元の function_call の step.id から取得する必要があります。1ラウンドに複数の呼び出しがある場合、モデルはこれを使って各結果を対応付けます。第二に、previous_interaction_id=interaction.id により、サーバー側が保存済みのインタラクション記録(すでに検索されたツールを含む)を引き継げます。第三に、2回目でも tools 配列全体を渡す必要があります。API はステップ履歴を保持しますが、ツール宣言は保持しません。tool_search、すべての遅延ツールと非遅延ツール、MCP 設定は毎ラウンド再送信する必要があります。
この例は1回の関数呼び出しのクローズドループのみを示しており、汎用的なマルチターン Agent スケジューラは含んでいません。followup にまだ function_call がある場合は、同じ方法で処理を続ければよいです。
🎯 技術アドバイス:Tool Retrieval 自体は Google 公式の
v1betaInteractions API に依存しています。標準の Function Calling で先にビジネス関数を動作確認し、異なるモデルがツールを選択してパラメータを埋めるパフォーマンスを比較したい場合は、APIYI apiyi.com で同じキーを使って Gemini、Claude、GPT などのモデルを切り替え、ベースラインテストを行えます。
拡張:リモート MCP と Gemini クライアント側検索
リモート MCP サーバーはサーバー側で遅延ロードを設定でき、公開するツールは必要に応じて読み込まれます。
mcp_tools = [
    {"type": "tool_search"},
    {
        "type": "mcp_server",
        "name": "weather_service",
        "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
        "defer_loading": True
    }
]
カスタム関数とは異なり、リモート MCP ツールは API 側が代わりに実行するため、steps に現れるのは mcp_server_tool_call と mcp_server_tool_result であり、アプリケーション側で結果を返す必要はありません。現時点の公式ドキュメントには「遅延可能なツールの最大数」は記載されていません。
企業がすでに独自のツールレジストリ、ベクトル検索、ユーザーレベルの権限フィルタリングを持っている場合は、クライアント側検索に切り替えられます。"execution": "client" を設定し、完全な name、description、parameters を提供してください。この場合、1 回目の応答で返るのは search_tool_registry に対する通常の function_call です。アプリケーション側で検索を行った後、function_result.result に完全なツール宣言オブジェクトの配列を返してください。JSON 文字列にシリアライズしてはいけません。クライアントモードでは defer_loading は使われず、同一リクエスト内で 2 つのモードを混在させることもできません。
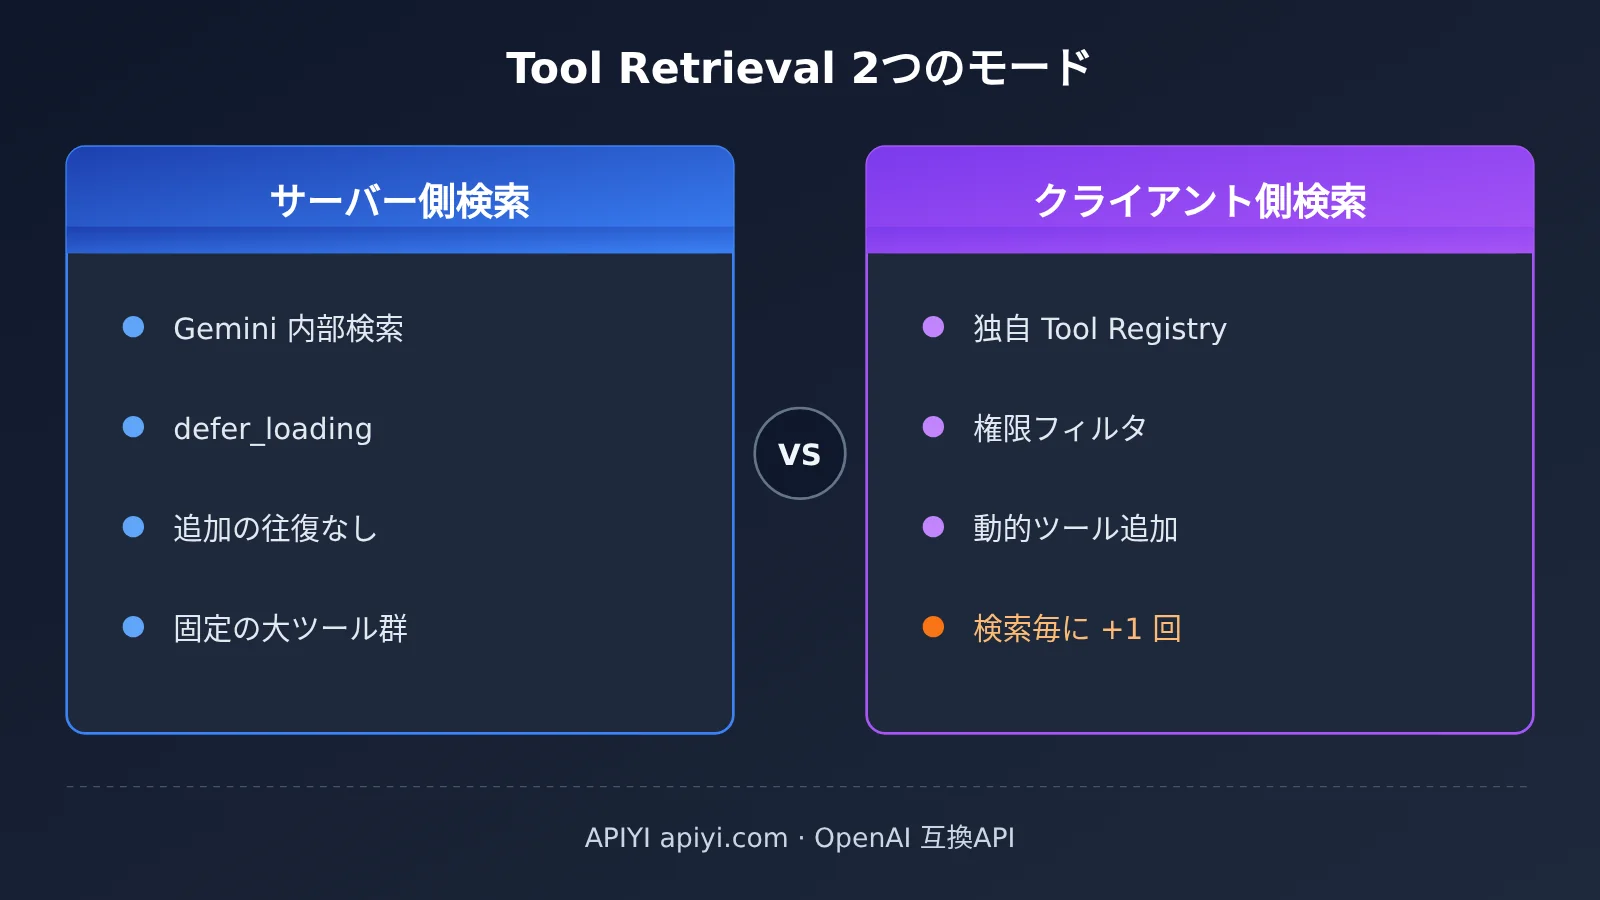
| 観点 | サーバー側検索 | クライアント側検索(Gemini) | 自前 Tool Registry(汎用方案) |
|---|---|---|---|
| 検索の実行者 | Gemini API | 開発者アプリケーション | 開発者アプリケーション |
| 主要な設定 | tool_search + defer_loading |
tool_search + execution: client |
通常の Function Calling |
| 全ツールを事前に宣言する必要 | あり | なし | なし |
| 追加のネットワーク往復 | なし | 検索ごとに +1 回 | 検索ごとに +1 回 |
| ツールの動的追加 | 不便 | 対応 | 対応 |
| 典型的な用途 | 大規模で比較的固定されたツールライブラリ | マルチテナント、プライベートレジストリ | モデル間での再利用、マルチベンダー切り替え |
| 利用可能なプラットフォーム | Google 公式 v1beta | Google 公式 v1beta | APIYI apiyi.com などの OpenAI 互換インターフェース |
最後の列は Gemini Tool Retrieval ではなく、考え方が近いエンジニアリング実装です。まず検索関数だけを公開し、検索でヒットした後に対応する Schema を tools に追加します。複数のモデルを切り替える必要があるチームに適しています。最小構成は次のとおりです。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)
MODEL = "your-model-name"  # プラットフォームのモデル一覧に準拠

search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}
自前 Tool Registry の完全な 2 段階呼び出しを見る
import json, os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"
)
MODEL = "your-model-name"  # プラットフォームのモデル一覧を参照

TOOL_REGISTRY = {
    "get_inventory": {"type": "function", "function": {
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "parameters": {"type": "object", "properties": {"sku": {"type": "string"}}, "required": ["sku"]}}},
    "get_order_status": {"type": "function", "function": {
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "parameters": {"type": "object", "properties": {"order_id": {"type": "string"}}, "required": ["order_id"]}}},
}
search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools (inventory, orders) by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}

def search_registry(query):
    q = query.lower()
    return [name for name, t in TOOL_REGISTRY.items()
            if any(w in t["function"]["description"].lower() for w in q.split())]

def execute_demo_tool(name, args):
    if name == "get_inventory":
        return {"sku": args["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": args["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(name)

messages = [{"role": "user", "content": "查询商品 SKU-42 的可用库存。"}]
tools = [search_tool]

for _ in range(4):  # 無限ループを防ぐための単純なループ上限
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    if not msg.tool_calls:
        print("最终回答:", msg.content)
        break
    messages.append(msg)
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        if call.function.name == "search_tool_registry":
            names = search_registry(args["query"])
            tools += [TOOL_REGISTRY[n] for n in names if TOOL_REGISTRY[n] not in tools]
            content = json.dumps({"loaded_tools": names})
        else:
            content = json.dumps(execute_demo_tool(call.function.name, args), ensure_ascii=False)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": content})
💡 選択のヒント:レジストリ方式の検索品質は、あなたが実装する検索関数の出来によって変わります。サンプル内のキーワードマッチはデモ用の簡易実装です。APIYI apiyi.com 上でモデルを切り替えながら同じタスク群を実行し、「正しいツールを検索できたか」と「引数を正しく埋められたか」を比較すれば、どのモデルがあなたのツールライブラリに適しているかが見えてきます。
Gemini Tool Retrieval でよくあるエラーの集中トラブルシューティング
| 現象 | 原因 | 対処 |
|---|---|---|
defer_loading requires tool_search |
遅延関数を宣言したが、サーバー側の tool_search がない |
tools に {"type": "tool_search"} を追加する |
short_description が不正 |
遅延対象でない関数に記述してしまった | defer_loading=True の関数にのみ使用する |
| HTTP 400 unsupported model | モデルがサポート対象リストに含まれていない | ドキュメントに記載の 4 つのモデル ID に切り替える |
| リクエストが有効にならない、またはバージョンエラーが発生 | SDK がデフォルトで v1 を使用する、または generateContent を呼び出している |
api_version="v1beta" を明示的に設定し、Interactions API に切り替える |
| 2 回目のリクエストで HTTP 400 | store=False 時に検索ステップまたは signature を省略した |
tool_search_call/result とすべての署名をそのままリプレイする |
| モデルが古いツールを誤用、ツールが利用できない | 後続リクエストで tools の送信を忘れた |
毎ラウンドで完全な tools 配列を再送信する |
| 検索後にパラメータが空になる | 遅延ツールが名前と概要しか送信していない | 遅延ツールにも完全な parameters を送信する |
| クライアント側の検索設定が失敗 | name、description などのフィールドが欠けている |
クライアント側の検索関数定義を補完する |
ステートレスモード(store=False)については別途説明が必要です。このモードでは previous_interaction_id に依存できないため、アプリケーション側でユーザー入力、tool_search_call、tool_search_result、function_call、function_result、およびすべての signature を独自に保存し、そのままリプレイする必要があります。これらのうちどれか 1 ステップでも削除・変更すると、サーバー側で検索コンテキストを再構築できなくなる可能性があります。また、サーバーが一致するツールを見つけられなかった場合、構造化されたエラーではなくテキストを直接返すことがあります。つまり「リクエストでエラーが出なかった」ことは「検索が成功した」ことを意味しません。検証時には、steps の中に期待どおりの検索ステップと関数呼び出しが現れているかを項目ごとに確認してください。
Gemini Tool Retrieval の分析と判断:いつ導入する価値があるか
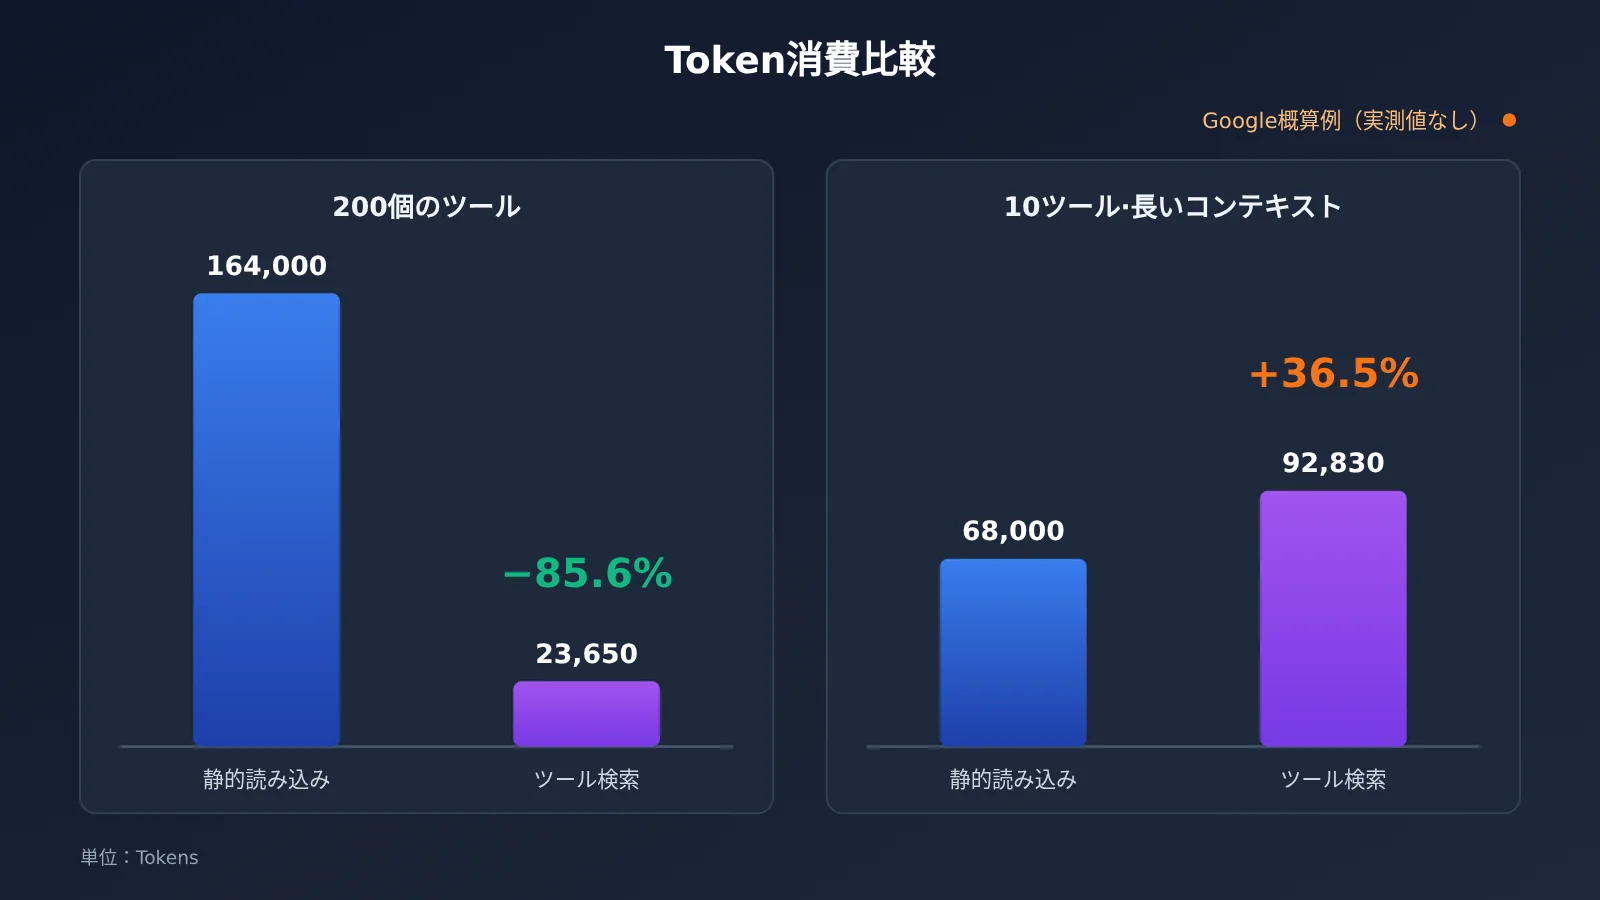
判断その1:効果はツールライブラリの規模とコンテキスト長に依存し、有効化すればコストが下がるわけではありません。 Google のドキュメントには方向性の異なる2つの仮想試算例が示されており、本番ベンチマークではないと明記されています。1つ目は200個のツール、各400トークン、基本コンテキスト2,000トークン、リクエスト2回という条件で、静的読み込みが約164,000トークン、Tool Retrieval が約23,650トークンとなり、これに基づく試算では約85.6%の削減です。2つ目は10個のツール、基本コンテキスト30,000トークンで、静的読み込みが68,000トークンに対し、Tool Retrieval は逆に92,830トークンとなり約36.5%増加します。これは追加の検索推論が長いコンテキスト全体を再処理する必要があるためです。Google のエンジニアリング上の推奨は、「安定したツールが約20個未満なら、通常は静的読み込みで十分」というものです。
判断その2:コスト評価は total_tool_use_tokens を見るべきで、初回の入力だけでは判断できません。 公式の初期テストでは、遅延読み込みされる各ツールの概要が平均約26トークン、100個のツールで約2,600トークンという概算値でした。本当に注視すべきなのは、検索によって発生する追加のモデル呼び出しと、読み込まれたスキーマがセッション内で累積していくことです。現在のドキュメントには、検索済みツールをアンロードする仕組みが用意されていません。長いセッションで検索するツールが増えるほど、コンテキストは大きくなります。キャッシュも無条件に恩恵があるわけではなく、初期プロンプトが短くなった結果、暗黙的キャッシュの最低しきい値を下回る可能性があります。
判断その3:必要に応じたツール読み込みは業界の共通認識になりつつありますが、各社のデータを横断的に当てはめることはできません。 Anthropic は2025年11月に Tool Search Tool を発表し、OpenAI は2026年3月に GPT-5.4 とともに Tool Search を発表しました。両社とも自社の条件下での実測節約データを公開しています。一方、Google が今回示したのは仮想試算例のみです。2026年11月20日時点で、検証可能な Gemini Tool Retrieval の独立した本番実測は存在しません。したがって「Gemini は実測で85%削減」といった言説は、現時点では根拠が薄弱です。
開発者へのアドバイス:まず既存の Agent のツールを呼び出し頻度で階層化し、高頻度のツールは直接読み込み、ロングテールのツールは遅延読み込みにします。次に同じタスク群で、静的読み込みと Tool Retrieval の総トークン数、エンドツーエンドの所要時間、正しいツールを選べた割合、パラメータの正確率を比較します。機能はまだプレビュー段階で正式リリース日も未定のため、本番環境では静的読み込みに戻せるスイッチを残しておくのが賢明です。モデル選定の段階では、まず APIYI apiyi.com の統一インターフェースを使って標準の Function Calling ベースラインを低コストで通し、その後公式の v1beta に移行して Tool Retrieval の純利益を検証するとよいでしょう。
ツールが増えるほど、いつそのツールを繰り出すのかを先に考える必要があります。『論語・衛霊公』にもある通り、「工欲善其事、必先利其器」(仕事をうまく成し遂げたいなら、まず道具を研ぎ澄ませよ)です。
📚 参考資料
-
Introducing Tool Retrieval in the Gemini API:Google 公式発表
- リンク:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - 内容:公開日、設計目標、MCP と 2 つの検索モード
- リンク:
-
Tool retrieval 公式ドキュメント:設定、制限、課金、計算例
- リンク:
aistudio.google.com/docs/tool-retrieval - 内容:本記事のコード、エラールール、ステートレスリプレイ、Token 計算例の主な根拠
- リンク:
-
Function Calling 公式ドキュメント:関数の実行と結果の返送
- リンク:
aistudio.google.com/docs/function-calling - 内容:
function_resultとcall_idの標準的な使い方
- リンク:
-
Interactions API 公式ドキュメント:インターフェース構造と実行手順
- リンク:
aistudio.google.com/docs/interactions-overview - 内容:ステートフルな対話、steps と generateContent の違い
- リンク:
-
python-genai v3.6.0 / v3.0.0 Release:SDK バージョン履歴
- リンク:
github.com/googleapis/python-genai/releases - 内容:Tool Retrieval Schema のサポートとデフォルト API バージョンの変更
- リンク:
作者:APIYI 技術チーム
技術交流:複数モデルの Function Calling 比較テストは APIYI apiyi.com からご利用いただけます。その他の接続資料は docs.apiyi.com のドキュメントセンターをご覧ください。