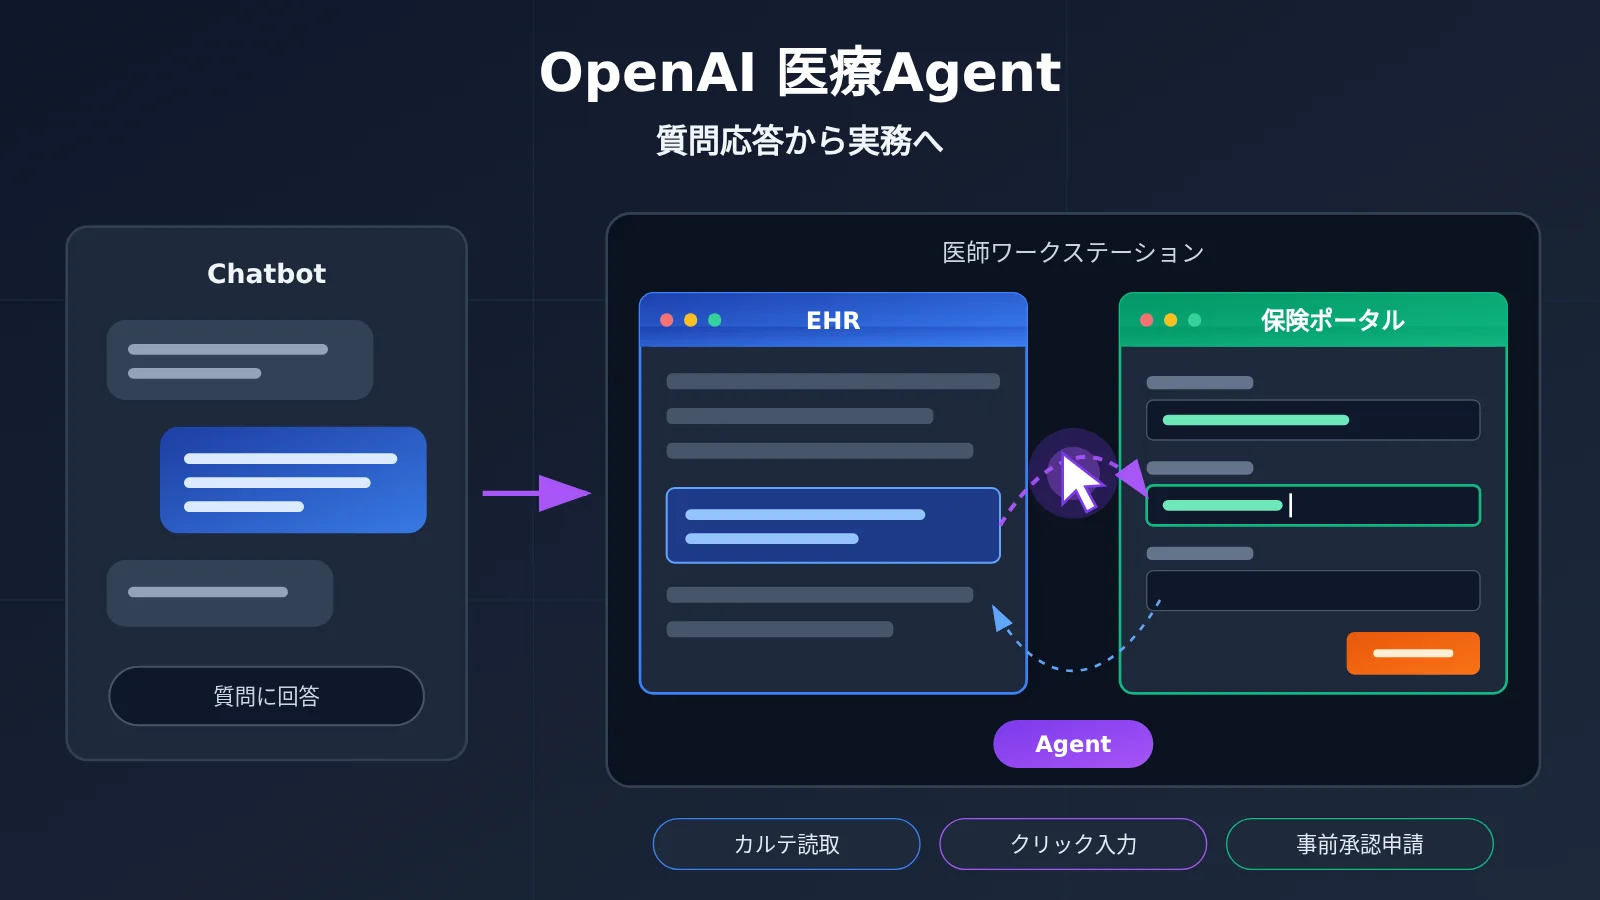
OpenAIの医療向けComputer-use Agentにおける重要な進展は、医療機関がすでに運用しているソフトウェアシステムにAgentが入り込み、患者の縦断的なカルテ情報を読み取り、それに基づいて診療記録、医師オーダーのドラフト、患者への返信、保険事前承認の書類を準備できるようになったことです。AIの価値は、専門的な質問に答えることから、実際の業務プロセスを実行することへと広がっています。医療AIの競争の焦点もこれに伴って変わり、医学知識の質疑応答にとどまらず、臨床や事務のワークフローそのものへと入り込んでいます。強調しておきたいのは、こうした資料はデモであれ公開事例であれ、必ず医師やスタッフのレビューを経るという点です。AIが単独で処方権や医療上の意思決定権を持つわけではありません。
この記事を読むと何がわかる?
- MRIデモにおける、Agentがカルテを読み取ってから事前承認申請を準備するまでの一連の操作フロー。
- 99%の安全性、93%の医師による高評価、94.3%のrubric pointsという3組のデータが、それぞれどのような評価基準に基づく指標なのか、そしてスタンフォードのHealthAdminBench論文のスコアとの違い。
- CVS Health、Cigna、Abridge、Ambienceがそれぞれ合成デモ、本番運用、開発段階のどこに位置しているのか。
- 臨床における承認権とAgentの実行権をどう分離するのか、また開発者はAgentのトータルコストをどう見積もるべきか。
目次
客観的な事実のパートは、次の順序で展開します。まずOpenAIが今回AIに何をさせたのかを再現し、次にChatbotとComputer-use Agentの違いを比較し、そのうえで評価スコアの意味を分解します。続いてCVS、Cigna、Abridge、Ambienceといった企業の導入方法を整理し、最後に医療Agentのリスク管理の仕組みを紹介します。分析・判断のパートでは、医療業界がなぜこの能力を特に必要とするのか、開発者と医療機関はどうトレードオフを取るべきか、そしてComputer UseがAIアプリ産業全体にとって何を意味するのかを論じます。
知っておきたい:医療エージェント関連の概念早見表
| 概念 | 簡単な説明 |
|---|---|
| Computer Use | ソフトウェアの画面を観察・操作して(スクリーンショット、クリック、入力)タスクを完了する能力 |
| EHR | 電子健康記録システム。患者の受診、投薬、画像などの情報を病院が保管する中核ソフトウェア |
| Payer Portal | 保険者ポータル。医療機関が事前承認の申請や保険資格の確認を行う場所 |
| Prior Authorization | 事前承認。一部の検査や治療は、実施前に保険者からの承認を得る必要があります |
| MCP | 外部ツールを見つけて呼び出すための標準プロトコル |
| RPA | あらかじめ設定したルールやスクリプトに従って反復業務を実行する自動化手法 |
| Rubric points | 評価ルールに沿って分割された採点ポイント。部分的な要件の達成状況を測る |
| エンドツーエンド成功率 | タスク全体がすべての成功条件を満たす割合 |
| Trace | 実行過程、操作アクション、画面状態を記録した証跡 |
| BAA | Business Associate Agreement(業務提携契約)。サービス提供者が保護対象保健情報(PHI)を扱う責任を明確にする |
| RBAC | ロールベースアクセス制御。職務に応じてアクセスできるデータと操作を割り当てる |
医療エージェントの影響をひと目で
- 開発者・技術責任者:重点はもはや、モデルが医学的な質問に正しく答えられるかどうかではなく、具体的なタスクごとに実行メカニズム、エンドツーエンドの完了率、全体コストを検証することにあります。スクリーンショットは画像入力に該当し、複数回の呼び出し、ツール、実行環境のいずれも課金対象となるため、テキストのトークン単価だけを見て判断はできません。
- 医療機関・ワークフロー責任者:合成データによるデモ、ベンダー評価、企業パイロット、本番運用事例のどれなのかを区別する必要があります。本番導入時には人手による承認、権限設定、監査ログも整備しなければならず、デモの効果をそのまま調達根拠にすることはできません。
- 臨床スタッフ:短期的には、事前承認の書類準備やシステム横断的な情報検索など、事務負担の軽減をより実感しやすいでしょう。臨床判断と署名の責任は引き続き医師にあります。
客観的事実:OpenAI の医療 Agent が今回リリースしたもの
OpenAI の医療 Agent は今回、AI に何をさせたのか?
2026年11月16日、OpenAI は医療チーム向けのコンピュータ操作 Agent に関する新たな進展を発表し、あわせて臨床および事務ワークフローでの評価結果、さらに CVS Health、Abridge、Ambience、Cigna Healthcare などの企業との協業事例を公開しました。HLTH 2026 の期間中には、OpenAI Health AI 責任者の Karan Singhal 氏も関連する進展を紹介しています。
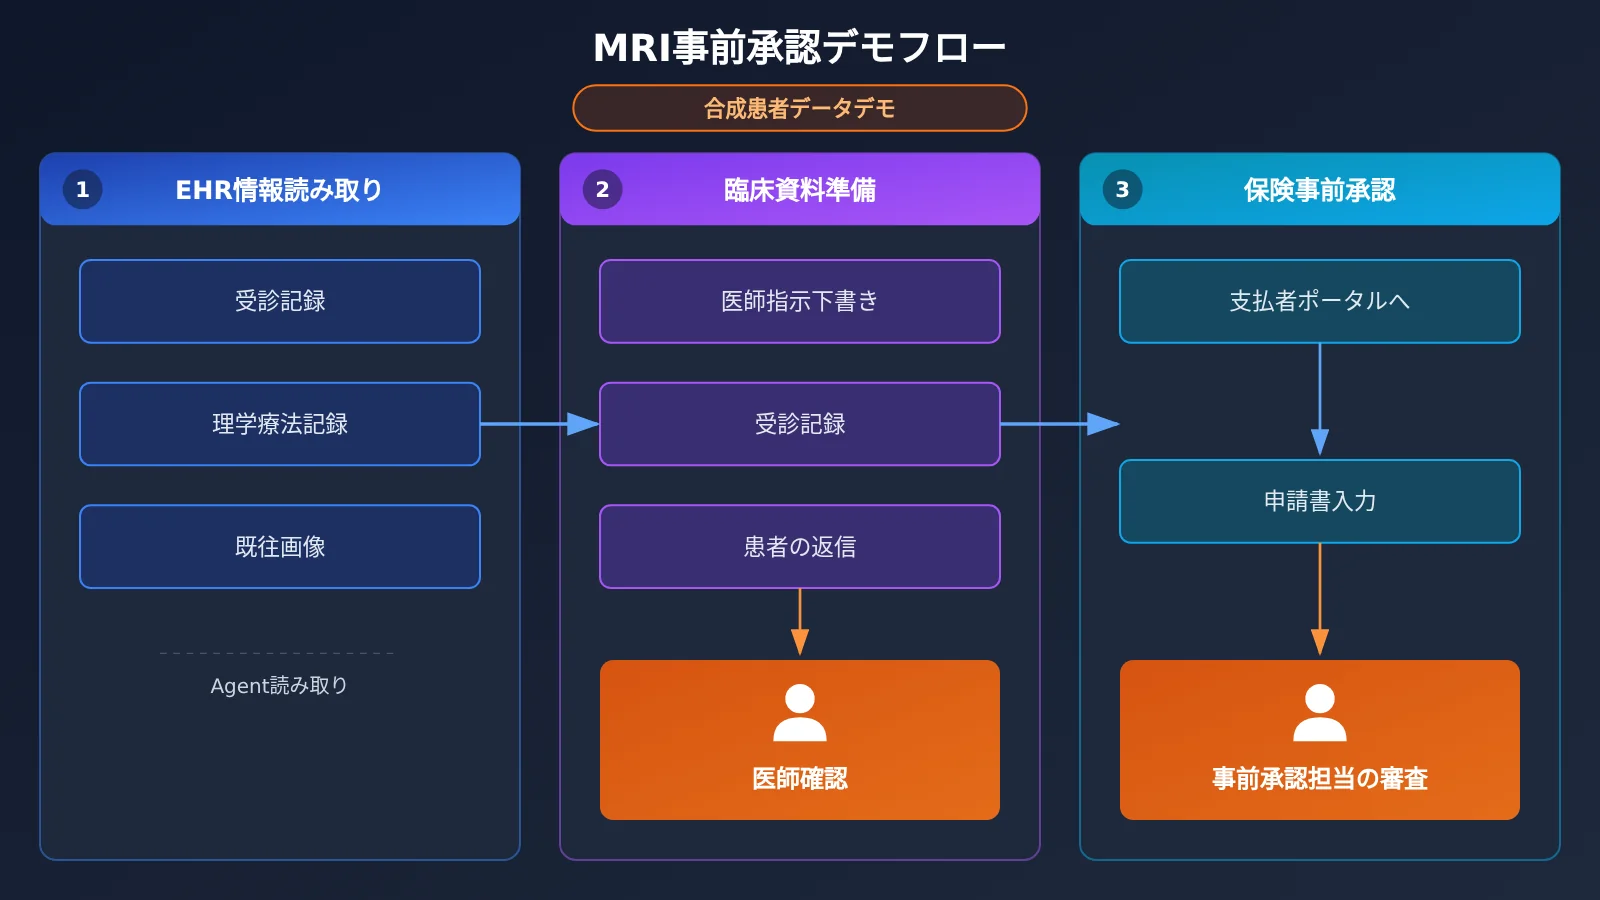
今回の変化を最もよく表しているのが、公式が公開した MRI ワークフローです。患者が腰下部の痛みについて医師にメッセージを送り、医師が MRI 検査を検討します。その後、Agent は EHR と保険ポータルの間で3つの段階の作業を完了しました:
- EHR 情報の読み取り:患者の受診記録、理学療法記録、過去の画像資料を確認。
- 臨床資料の準備:MRI 検査オーダー、今回の受診記録、患者への返信を下書きし、すべて医師のレビューに委ねる。
- 保険事前承認:同じ患者記録を用いて保険支払者ポータルに入り、MRI の事前承認申請を準備し、事前承認担当者のレビューに委ねる。
ここで補足しておきたいのは、このデモが合成患者データ(Synthetic Patient Data)を使用しており、実際の患者に対する本番操作ではないという点です。これは能力の連鎖を示すものであって、いずれかの病院がこのフローで実際の症例を処理したことを意味するものではありません。
公式はまた、小児の骨折後の服薬相談の事例も公開しています。家族が小児用イブプロフェンの用量を尋ねると、Agent は受診記録と画像資料を確認し、カルテに記録された体重とクリニックでの投与量を読み取り、それに基づいて服薬説明、ギプスケアの説明、緊急受診が必要な警告症状を下書きします。医療記録は未署名の状態で保存し、家族への返信は未送信の下書きとして保存し、最終的には医師が承認します。Elevated PSA と Digoxin refill(ジゴキシン継続処方)も EHR Inbox のタスク種別として挙げられていますが、公式はこれら2種類のタスクについて完全な操作記録や独立したスコアを公開していません。
チャットボットからComputer-use医療エージェントへ、何が変わるのか?
従来の医療Q&Aは一般的な知識に答えるもので、医療文書生成は草稿までは書けますが、その内容は依然として人がシステムにコピーする必要があります。Computer-useエージェントの違いは、「スクリーンショットで観察→計画→クリックまたは入力→再びスクリーンショットで検証」というループを通じて既存のソフトウェアに直接入り込み、複数のアプリケーションをまたいで多段階のタスクを完了し、さらにはソフトウェア内の業務状態を変更しうる点にあります。
| 能力の形態 | 主な出力 | 業務システムに接するか | 典型的な医療シーン | 主なリスクポイント |
|---|---|---|---|---|
| 医療Q&Aチャットボット | テキストによる回答 | いいえ | 医学知識の照会、エビデンス検索 | 内容の正確性 |
| 医療文書生成 | 記録・書簡の草稿 | 間接的、人手による入力が必要 | 退院説明、事前承認書簡 | 内容とカルテの不一致 |
| Computer-useエージェント | インターフェース操作とシステム状態の変化 | はい、EHRやポータルを直接操作 | 事前承認の記入、転診ステータスの更新、システムをまたいだデータ取得 | 誤クリック、患者の取り違え、エラーの伝播 |
OpenAI APIにおいて、Computer Useは主にResponses APIを通じて実装され、click、type、scroll、keypress、drag、screenshotなどの動作をサポートします。公式ドキュメントでは2つの経路が紹介されています。1つはComputer Toolで、モデルが構造化されたマウス・キーボード操作を返し、アプリケーション側がそれを実行します。もう1つはCode Executionで、モデルがPlaywrightやPyAutoGUIなどのツールを呼び出すコードを生成します。GPT-6 Astraについては、公式は現在Code Execution方式を推奨しています。ドキュメントはさらに、モデルが操作指示を生成したからといって操作が成功したわけではないと特に強調しています。アプリケーションが動作を実行し、新たなスクリーンショットなどで結果を確認する必要があります。
OpenAIの医療エージェント評価結果は何を示すのか?
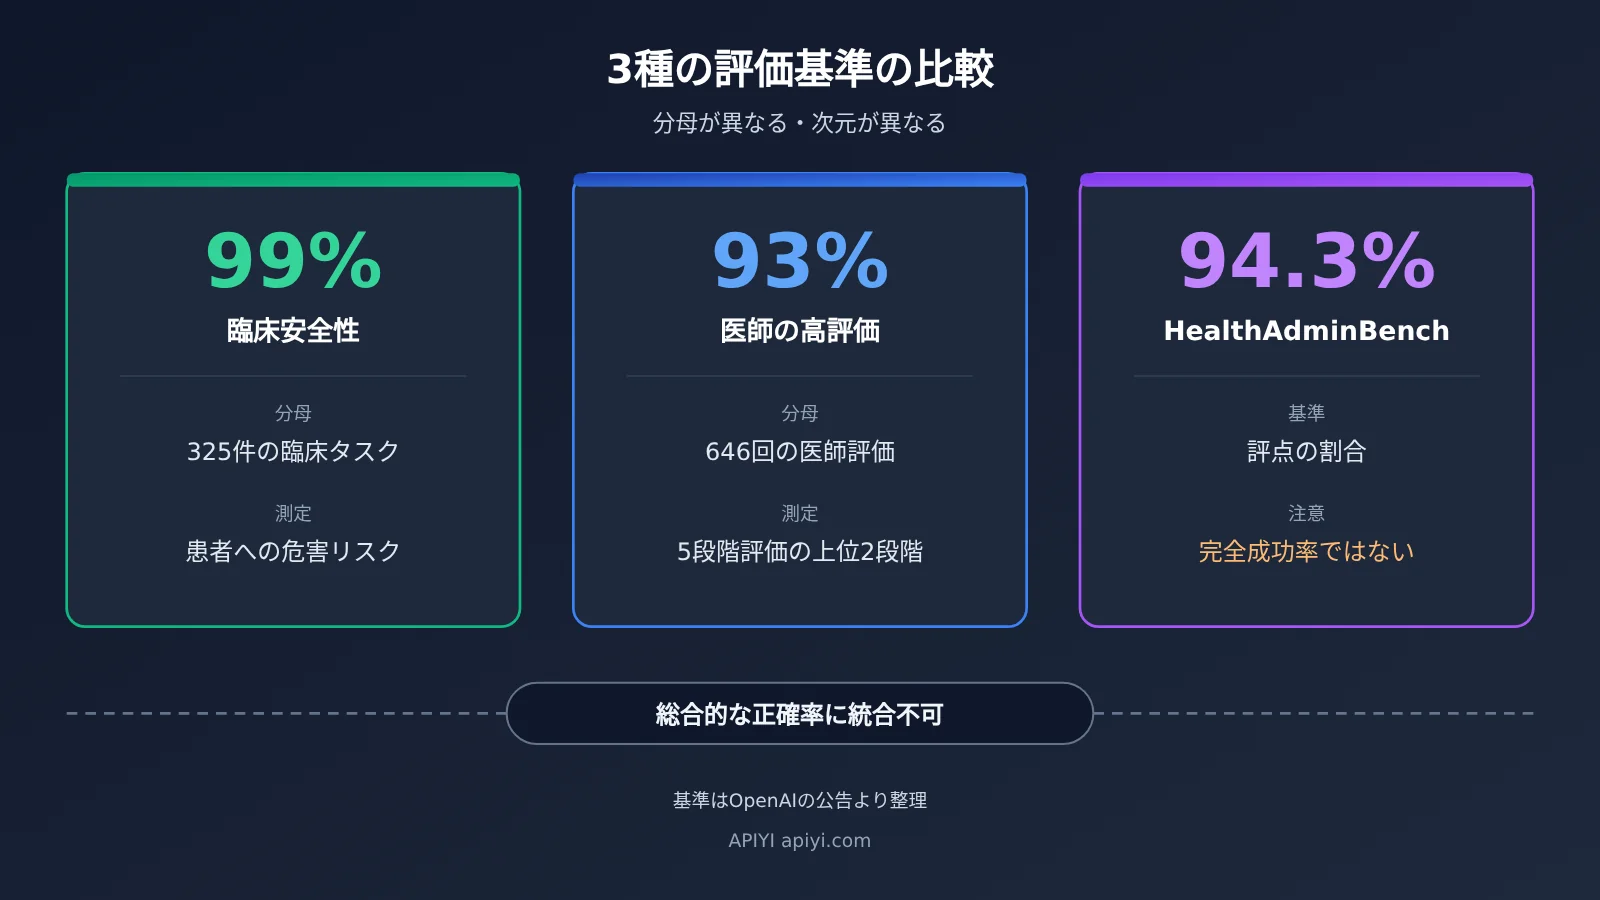
OpenAIは3組のコアデータを公表しました。それぞれ分母と評価軸が異なり、「総合精度」として一つにまとめることはできません。また、いずれも医学診断の精度ではありません。
| 指標 | 数値 | 評価対象 | 分母 / 評価基準 | 誤解されやすい解釈 |
|---|---|---|---|---|
| 臨床タスクの安全性 | 99% | GPT-6 Astra | 325件の審査済みタスク。誤り、抜け漏れ、操作が患者に危害を及ぼす可能性があるかを評価 | 診断精度、エラーゼロ |
| 医師の高い評価 | 93% | GPT-6 Astra | 646回の評価。5段階尺度における Very / Extremely Helpful の合計比率 | タスク成功率、646名の医師 |
| HealthAdminBench | 94.3% | GPT-6 Astra | rubric pointsの比率、maximum reasoning effort | 完全なタスク成功率 |
| HealthAdminBench | 91.8% | GPT-6 Luna | rubric pointsの比率、maximum reasoning effort | 完全なタスク成功率 |
| タスクあたりのコスト | $0.085 | GPT-6 Luna | 特定の評価条件。Astraより98%低い | 本番デプロイの見積価格 |
臨床レビューでは、最終的に生成されたテキストだけを見るのではなく、エージェントが実際に実行した操作、生成した医療記録、医師の指示、患者向けメッセージも確認します。つまり、評価は内容の品質とソフトウェア操作プロセスの両方を対象としています。ただし、公式は646回の評価に対応する独立した医師の人数を公表しておらず、発表本文にも信頼区間、タスクごとの結果、完全な失敗事例は示されていません。
HealthAdminBenchは、スタンフォード大学のShah Labが提唱した医療事務エージェントのベンチマークです。論文2604.09937v1によると、このベンチマークには135件のタスクと1698件のサブタスクが含まれ、うち1177件のサブタスクは決定論的判定、521件はモデルによるジャッジを採用しています。論文で完全なタスク成功率が最も高いのはClaude Opus 4.6 CUAの36.3%、サブタスク成功率が最も高いのはGPT-5.4 CUAの82.8%でした。初期のShah LabのWeb版は70件のタスクと947個の採点ポイントで、当時報告された完全なタスク成功率の最高は22.9%であり、歴史的な比較対象として参照できます。
これらの数値は、それぞれ異なるバージョン、異なるモデル、異なる日付、異なる実行条件、異なる指標に属しており、同じランキングに並べることはできません。OpenAIの94.3%はrubric points基準ですが、論文の36.3%はエンドツーエンドの完全タスク成功率です。この差自体が、医療エージェントにおける「個々のステップを正しく実行する」ことと「物事全体をやり遂げる」ことが大きく異なり得ることを示唆しています。
CVS、Cigna、Abridge、Ambience は医療エージェントをどう実装したのか?
企業事例は成熟度にかなり幅があります。以下では、公開されている状況に応じて分類します。これらの数字は主に企業側と OpenAI の開示に基づくもので、メディア報道はクロスチェックの役割を果たしていますが、第三者による監査に相当するものではありません。
| 企業 | ユースケース | 開示状況 | 重要な事実 |
|---|---|---|---|
| CVS Health | 臨床システム間の書類送信、紹介、専門医への相談 | 本番ワークフロー | 数か月分の書類滞留を一つの週末で解消。別のエージェントは毎日数万回に及ぶ診療相談関連のシステム操作ステップを処理 |
| Cigna Healthcare | ケアマネジメント前のシステム間情報統合 | 導入済み | 看護スタッフは従来 10 以上のシステムを閲覧する必要があった。構想から導入まで 8 週間未満 |
| Abridge | 退院阻害要因の調整 | 開発中 | 医師が Abridge Assistant を通じてエージェントに薬剤入手と在宅ケアの並行調整を依頼 |
| Ambience Healthcare | 保険の事前承認申請 | ガバナンス設計のデモ | カルテに曖昧な点があれば立ち止まって医師に確認し、承認後にのみ提出 |
| Assort | 紹介のクローズドループ | 公式事例 | API で紹介情報を書き込み、Computer Use が Athena の画面でステータス更新を補完 |
CVS の「数万回」とは、システム操作ステップが伴う作業量を指しており、数万件の臨床判断すべてを AI が単独で下したという意味ではありません。CVS はさらに CUA Agent Kit(Apache-2.0 ライセンス)をオープンソース化しており、二段階アーキテクチャを採用しています。まず Computer-use Agent が自然言語に従ってワークフローを探索し、スクリーンショット、アクション、対象位置などの Trace 証拠を記録します。次に Codex Skill が成功した軌跡を決定論的なコードとして固定化し、エンジニアのレビューを経て繰り返し実行します。README によれば、決定論的実行の段階ではモデルの API キーは不要です。
Assort の事例は Computer Use の位置づけを示しています。Assort はすでに Athena API を通じて紹介情報をカルテに書き込めますが、完全なクローズドループにはあと一歩、画面上の操作が足りません。エージェントは Athena の画面で直接、紹介先の医師を選択し、詳細を入力し、ステータスを Visit Scheduled に更新します。これにより、この紹介はスタッフのフォローアップリストからすぐに外れます。API が構造化された操作を担い、Computer Use が API でカバーしきれない部分を補完する、という役割分担です。
医療エージェントはどのようにリスクを制御するのか?
OpenAI が公開しているガバナンス機能には、RBAC、監査ログ、アプリケーションのアクセス範囲設定、重要な操作の前の人手による承認、そしてエージェントを指定されたワークフロー内に制限する制御メカニズムが含まれています。医療機関はいつでもエージェントを一時停止し、ステップごとの操作ログを確認できます。
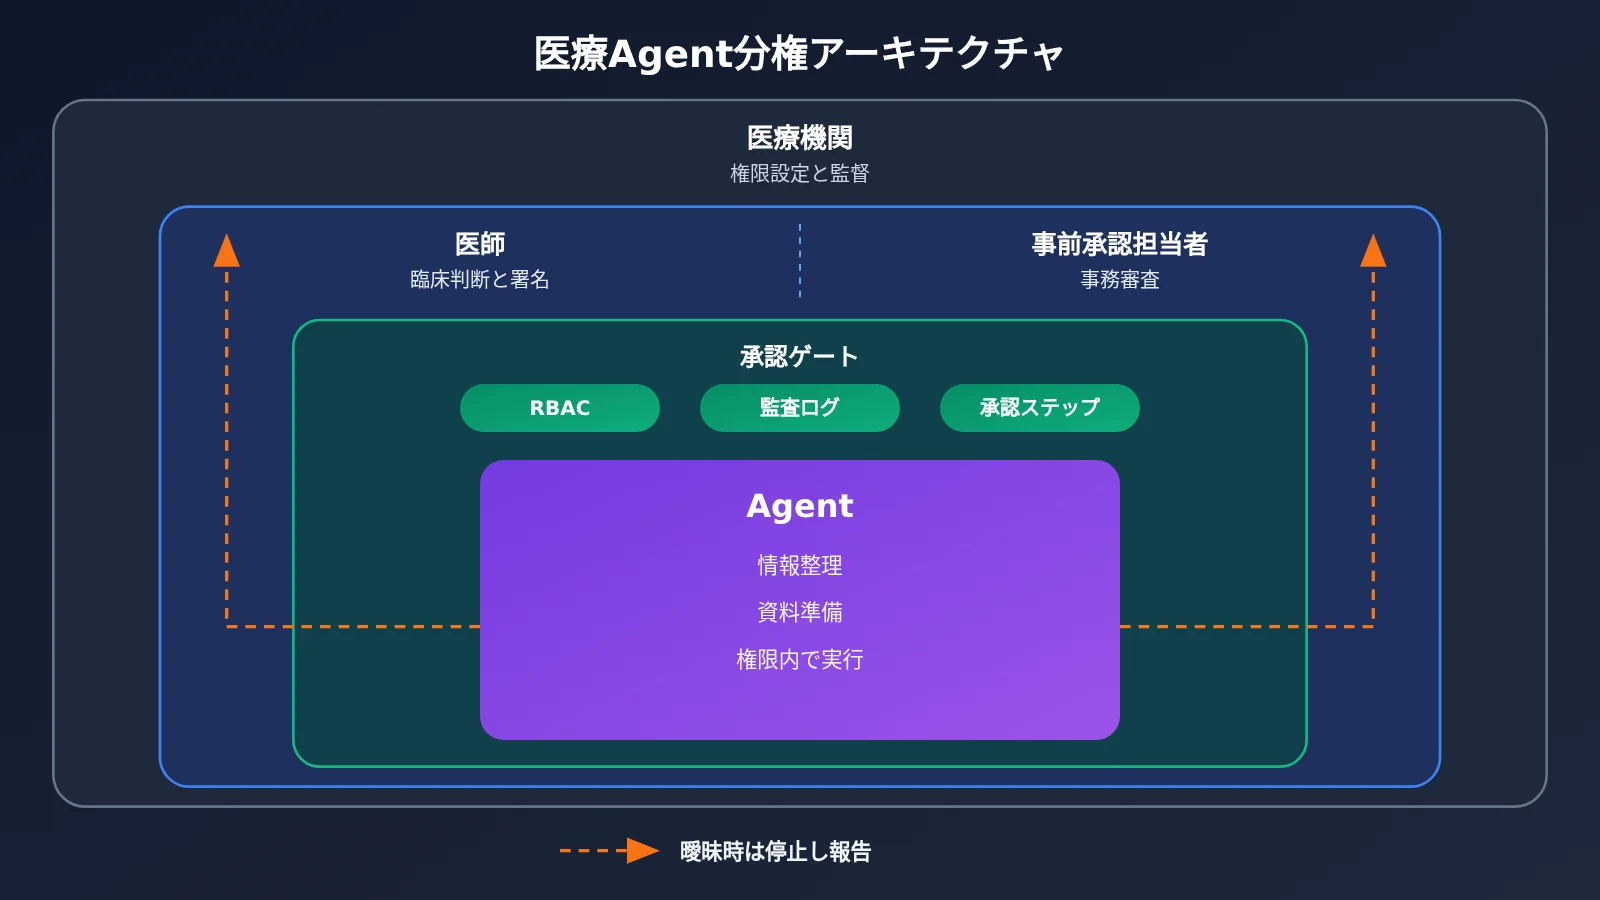
これは実際には分権設計です。AI は情報の整理、資料の準備、権限範囲内での操作実行を担当し、医師は臨床判断を、事前承認担当者は事務審査を、医療機関は権限設定と監督プロセスを担当します。エージェントの権限は臨床責任の境界と一致している必要があります。
データコンプライアンスの面では、OpenAI は ChatGPT for Healthcare 内の組織データが基盤モデルのトレーニングに使用されないことを明らかにしています。CVS も、関連する本番データは自社のインフラストラクチャ内に留まると述べています。ただし、PHI を含む HIPAA 準拠のワークフローをサポートするには、医療組織は適格なサービスを使用し、そのサービスが OpenAI との BAA(事業提携契約)でカバーされていることを確認し、セキュリティ設定とデータ保持ポリシーを構成し、組織の権限を通じてエージェントがアクセスできる記録と操作を制限する必要があります。したがって、「HIPAA ワークフローをサポートする」ことは「すべての OpenAI API 呼び出しが自動的に準拠する」ことではありません。
利用可能なチャネルについては、関連機能は OpenAI API、ChatGPT for Healthcare、ChatGPT for Clinicians、ChatGPT Work、Codex を通じて利用できます。適格な米国の臨床医は ChatGPT for Clinicians を無料で申請できますが、この無料ポリシーには地域と資格の制限があります。ChatGPT for Healthcare には、公開された統一の固定サブスクリプション価格はありません。
分析と判断:医療Agentのトレードオフと産業的意義
なぜ医療業界は特にComputer Use型Agentを必要とするのか?
医療サービスにおける情報の分断は非常に典型的です。1回の受診で、EHR、画像システム、処方システム、保険ポータル、紹介システム、退院管理プラットフォームなどが同時に関わる可能性があり、これらのシステムは多くの場合、異なるベンダーから提供されており、インターフェースも不完全です。MRIの事前承認はその縮図と言えます。医師は臨床的な判断を1つ下しただけなのに、スタッフは診療記録、理学療法記録、画像資料、保険ポータルの間を何度も行き来しながら、コピーやアップロードを繰り返さなければなりません。
この観点から見ると、Computer Useが解決するのは「AIが医学を理解できるかどうか」ではなく、「情報がシステム間を流れることができるかどうか」です。筆者の判断では、医療の事務作業の自動化は、臨床診断の自動化よりも早く商業規模を形成する可能性が高いと考えられます。その理由は、事務タスクは量が多く、反復性が高く、境界が明確で、結果をフォームやシステムの状態で検証でき、責任リスクも比較的コントロールしやすいからです。Cignaが10以上のシステムをまたいだ情報検索を数秒に短縮した事例は、この「まず負担を減らし、置き換えはしない」というアプローチを体現しています。
ただし、スタンフォードのベンチマークは本当の難しさも明らかにしています。初期の研究では、アプリ間のデータ転送とドキュメント処理がAgentの失敗の重要な原因であることが判明しており、患者情報を理解していても、ファイルのアップロード、フィールドの入力、ステータスの更新の際にエラーが発生する可能性があります。医療の現場では、1つのシステムでのエラーが複数の下流システムに複製される恐れがあり、まさにこれこそが、人手による承認と操作後の状態検証を省略できない理由なのです。
開発者は医療 Agent のコストと実現可能性をどう評価すべきか?
開発者にとって、最初から Computer Use に取り組む必要はありません。より堅実な進め方は、まずワークフローを分解することです。情報抽出や資料ドラフト作成といった純粋なテキスト処理の段階は、通常のモデル API で品質を検証できます。UI 操作の段階は、別途成功率を評価します。以下の例は合成データを使って「事前承認に必要なフィールド抽出」というテキスト処理段階を検証するもので、あくまで技術デモであり、いかなる診療上の助言も構成しません。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # プラットフォームで実際に利用可能なモデル一覧を基準にしてください
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
トークンコスト統計付きの完全なコードを見る
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 単価:米ドル / 100万トークン。実際に使用するモデルに合わせて記入してください
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 迅速な検証のヒント:医療システムに本格接続する前に、APIYI apiyi.com 経由で1つの API キーを使い、複数のモデルをフィールド抽出や資料ドラフト作成などのテキスト処理段階で比較できます。新規ユーザーには無料のテスト枠があり、まず評価スクリプトを動かし、タスク単位のデータを蓄積するのに適しています。
コスト面では、2026年11月17日時点で確認した Standard ショートコンテキストの価格(米ドル/100万トークン)は次のとおりです。GPT-6 Astra は入力10、出力50、キャッシュ入力1。GPT-6 Luna は入力0.10、出力0.50、キャッシュ入力0.01です。処理速度、コンテキスト長、リージョンによって実際の課金は変わります。Luna が1タスクあたり0.085ドルで「98%低い」という比率から逆算すると、Astra は1タスクあたり約4.25ドルになりますが、これは概算値であり、あくまで基準条件下でのコストであって、本番の見積もりとして扱うことはできません。
完全なコスト計算では、各ラウンドの視覚入力とテキスト入力、課金対象の出力をそれぞれ集計し、さらにツール呼び出し、実行環境、エンジニアリング保守を加える必要があります。リトライで発生したトークンがすでに合計に含まれている場合は、二重に加算しないようにしましょう。2つのモデル階層の間に約50倍の価格差があることは、階層化の考え方も示唆しています。複雑な推論は高性能モデルに、構造化された高頻度のステップは低コストモデルに任せ、すでに安定的に運用できているフローは CVS のように決定論的なコードとして固定化するのです。
💰 コスト最適化のヒント:モデルを階層化する際は、まず APIYI apiyi.com 上で同じOpenAI互換コードを使い、価格帯の異なるモデルを切り替えてみてください。サブタスクの種類ごとに品質とToken消費を測定し、そのうえでどの工程に高性能モデルを使う価値があるかを判断するのがおすすめです。
| 検証フェーズ | 答えるべき問い | 推奨エビデンス | 参考ツール |
|---|---|---|---|
| テキスト工程 | 抽出と起草の品質は安定しているか | 人手アノテーションとの照合、NEED_HUMAN の発火率 | APIYI apiyi.com でのマルチモデル比較 |
| 画面操作 | エンドツーエンドの完了率はどのくらいか | スクリーンショットとTrace、操作後の状態確認 | OpenAI Computer Use のドキュメントとサンドボックス環境 |
| フロー固定化 | どのステップを決定論的コードに変換できるか | 成功軌跡の再現率 | CUA Agent Kit のような2段階アーキテクチャ |
| 本番運用ガバナンス | 権限と承認が重要な操作をカバーしているか | RBAC設定、監査ログの抜き取り確認 | 組織独自の権限・コンプライアンス体制 |
医療AgentとRPAは代替か、それとも融合か?
従来のRPAは固定ルールと画面位置に依存しているため、画面が変わるとスクリプトが機能しなくなる可能性があります。Computer-use Agentは自然言語を理解し、現在の画面を観察して変化に適応できますが、毎回推論し直すことでコストと結果のばらつきが生じます。2種類の技術を比較した研究(DOI:10.1080/23311975.2026.2724760)では、P2、P3の2つのプロセスで各技術を10回ずつ実行しました。P1プロセスではAgentの失敗記録が1回だけあり、その後の統計には含めていないため、すべてのタスクが10回実行されたと一概には言えません。この研究は2025年のツール構成を使用しており、2026年モデルの成績を直接代表するものではありません。
筆者は、CVSの「AIによる探索、コードへの固定化、反復実行」がより主流のエンジニアリング形態になる可能性が高いと考えます。Agentは未知のプロセスを発見・理解する役割を担い、決定論的コードは既知のプロセスを安定して反復し、APIは引き続き高頻度で構造化されたインタラクションを支え、人手の承認が重要なノードを守ります。API、Computer Use、決定論的コード、人手の承認を組み合わせるほうが、どれか1つの技術に賭けるよりも現実的です。
医療 Agent は AI 産業全体にとって何を意味するのか?
医療は、高いハードルを伴う試験場にすぎません。そのシステムの断片化、コンプライアンス要件、責任の境界は、一般企業よりも厳格です。もし実行型 Agent がここで、監査可能で、一時停止可能で、権限が整合した運用方法を確立できれば、その手法は保険、金融、行政など、同様にレガシーシステムに依存する業界へと移行できます。
これは、産業競争の次元が変化していることも意味します。これまでは、モデルがどれだけ良いコンテンツを書けるかが問われましたが、今後はさらに、実際のシステム内で物事を完了できるか、エラー時に即座に停止できるか、各ステップを追跡可能な形で記録できるかが問われます。ソフトウェアベンダーにとって、Computer Use は AI 企業が基盤ソフトウェアを完全に制御しなくてもワークフローに参加できるようにし、統合のハードルを下げると同時に、「ベンダーが API を開放するのを待つ」という旧来のモデルに圧力をかけます。しかし、高信頼・高頻度のインタラクションには依然として API が適しており、Computer Use は補完者であって、代替者ではありません。
今後注目すべき点はいくつかあります。OpenAI がタスクごとの評価データと完全な実験設定を公開するかどうか、HealthAdminBench の論文版が各社の統一比較基準になり得るかどうか、Abridge の退院調整ソリューションが開発から実運用へ移行できるかどうか、そしてより多くの病院の運用データがエンドツーエンドの完了率の実用性を証明できるかどうかです。これらの証拠が現れるまで、デモとスコアは出発点にすぎず、結論ではありません。
医療 Agent はすでに「行動できる」ことを証明しましたが、臨床および事務負担を本当に軽減できるかどうかは、実際のワークフローにおけるエンドツーエンドの完了率、エラー時の停止能力、長期的なコストにかかっています。英語のことわざにある通りです:The proof of the pudding is in the eating.(実際の効果は実践によって検証される。)
参考資料
- OpenAI 公式発表:医療チーム向けコンピュータ操作エージェントの進化
- リンク:
openai.com/index/advancing-computer-use-for-healthcare-teams
- リンク:
- ChatGPT for Healthcare ヘルプドキュメント:製品機能、BAA、プラグインに関する説明
- リンク:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- リンク:
- OpenAI Computer Use 開発ドキュメント:Computer Tool と Code Execution のパス
- リンク:
developers.openai.com/api/docs/guides/tools-computer-use
- リンク:
- HealthAdminBench 論文:2604.09937v1 版のタスクと評価指標
- リンク:
arxiv.org/html/2604.09937v1
- リンク:
- CVS Health CUA Agent Kit:二段階の探索と固化アーキテクチャ
- リンク:
github.com/cvs-health/cua-agent-kit
- リンク:
- Fierce Healthcare の報道:HLTH26 の協力パートナーとユースケース
- リンク:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- リンク:
- Cambridge Dictionary:ことわざの原文確認
- リンク:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- リンク:
作者:APIYI 技術チーム
技術交流:複数の大規模言語モデルが Agent のテキスト処理段階でどのような性能を発揮するかを比較したい方は、APIYI apiyi.com にアクセスしてテスト枠を取得してください。その他の接続方法については、docs.apiyi.com ドキュメントセンターをご覧ください。