筆者注:本記事では、GPT-6.2 Sol と Claude Opus 5.5 について、サードパーティの総合スコア、公式定価、キャッシュ読み取り価格、APIYI での提供状況をそれぞれ分けて整理し、ひとつの総合スコアではなく「タスクに合わせて」モデルを選べるようにしています。
OpenAI は 2026-11-17 に GPT-6.2 Astra と GPT-6.2 Sol をリリースしました。Claude Opus 5.5 をすでに使っているチームも多く、いま「切り替えるかどうか」の判断を迫られているはずです。本記事では GPT-6.2 Sol と Claude Opus 5.5 を比較し、総合スコア、定価、キャッシュ読み取り、プロトコル、現在の呼び出し可否という観点から提案していきます。
本記事は、どちらが強いか・どちらが安いかを告げるものではありません。 サードパーティの総合指数では、Sol の最上位ランクは Opus の最上位ランクより 2 ポイント低くなっています。一方、公式のショートコンテキスト定価で見ると、Sol の入力・出力・キャッシュ読み取りの単価はいずれも Opus の半分程度です。この 2 つの事実はセットで見る必要があり、どちらか一方だけを取り上げて判断しても不完全です。
この記事で得られること:読み終える頃には、両モデルの総合スコア・定価・キャッシュ読み取りがそれぞれいくらなのか、どの数字が公式の自己申告でどれがサードパーティの実測なのか、そして現時点で APIYI からどちらを呼び出せるのかがわかります。
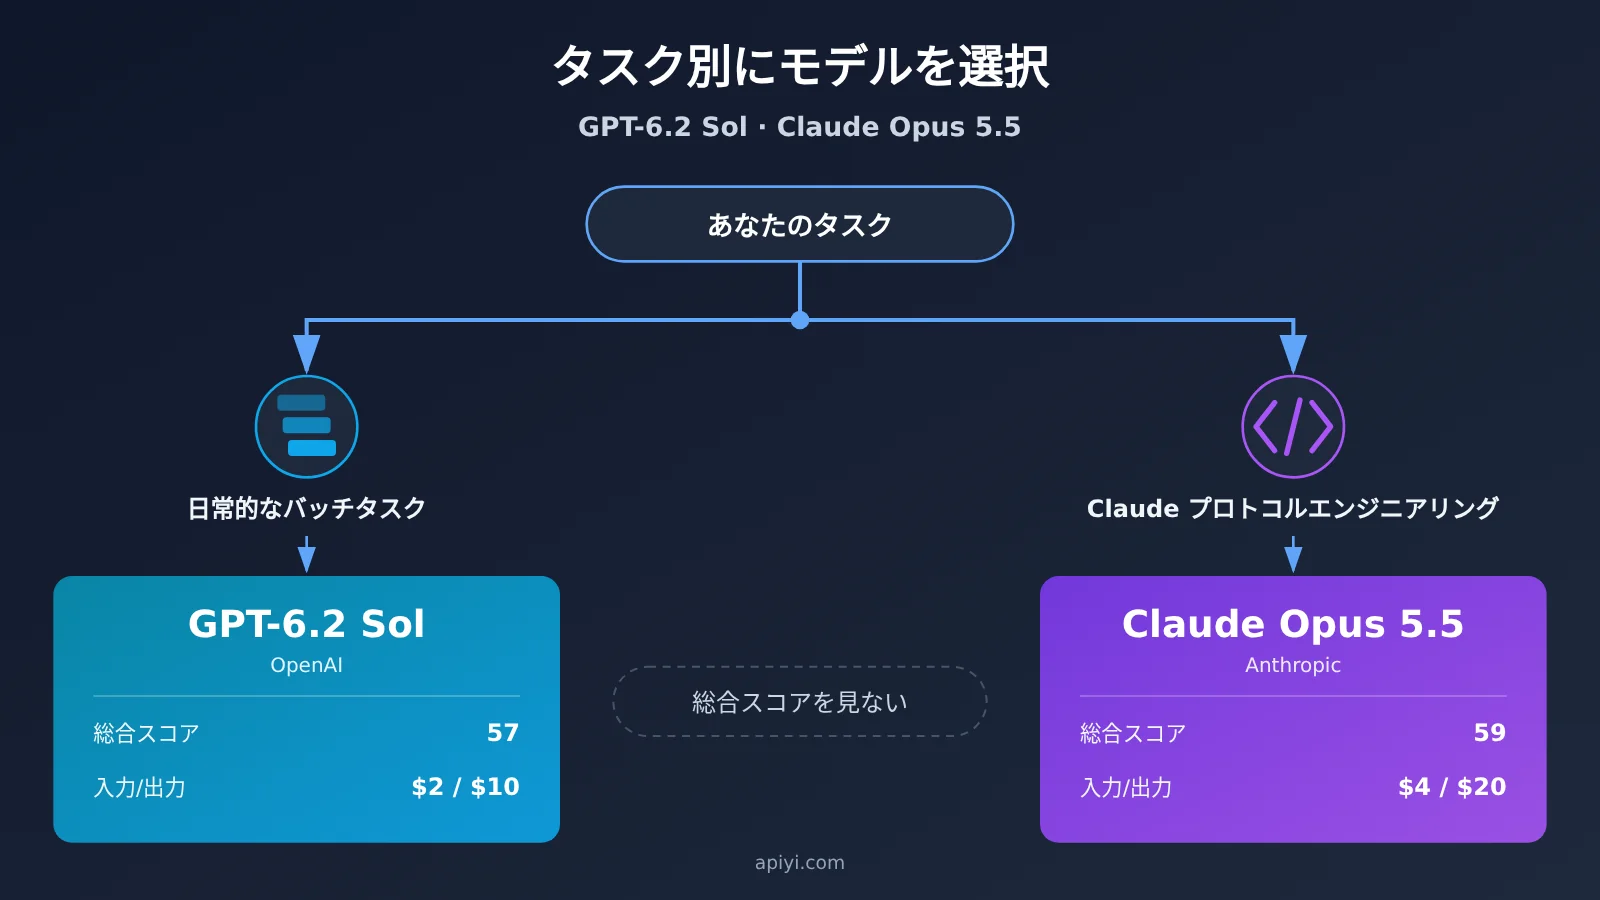
GPT-6.2 Sol と Claude Opus 5.5 の主な違い早見表
まず、モデル選定で最もよく使う5つの情報を1つの表にまとめました。各行には数値の出典を明記してあるので、詳細は以降のセクションでそれぞれ見ていきます。
| 比較項目 | GPT-6.2 Sol | Claude Opus 5.5 | 数値の出典 |
|---|---|---|---|
| 第三者機関の総合指数(最高推論レベル) | 57(Max レベル) | 59(最高レベル) | Artificial Analysis(第三者機関) |
| 短コンテキスト入力 / 出力の公式価格 | $2 / $10 | $4 / $20 | 各社の公式価格、100万トークンあたり |
| キャッシュ読み取りの価格 | $0.10 | $0.20 | OpenAI のモデルページ。Opus は Anthropic 料金表からの引用 |
| コンテキスト / 最大出力 | 1,050,000 / 128,000 | 1M / 128K | 公式モデルページとドキュメント |
| APIYI での現在の掲載状況 | まだ未掲載 | 掲載済み、claude-opus-5-5 |
APIYI のモデル一覧表と料金API |
総合スコアで2点低く、価格は約半分。なぜ両方を一緒に見るのか
総合スコアだけ見れば「Opus の方が高い」、価格だけ見れば「Sol の方が単価が安い」という結論になりがちです。どちらも間違いではありませんが、どちらも話の半分にすぎません。総合スコアが示すのは複数の混合タスクを合わせた平均的なパフォーマンスで、価格が示すのは100万トークンあたりの単価です。そして実際の請求額は、タスクごとにどれだけのトークンを消費するかにも左右されます。
さらに、この2点の差は Artificial Analysis が最高推論レベルで実施したテストによるものです。業務でデフォルトの推論強度を使っている場合や、タスクの種類がこの指数のテスト内容と大きく異なる場合には、この2点差をそのまま当てはめられないこともあります。そこで本記事では、まず数値をはっきり整理した上で、タスクの種類に応じてモデルを選ぶ、という方針で進めます。
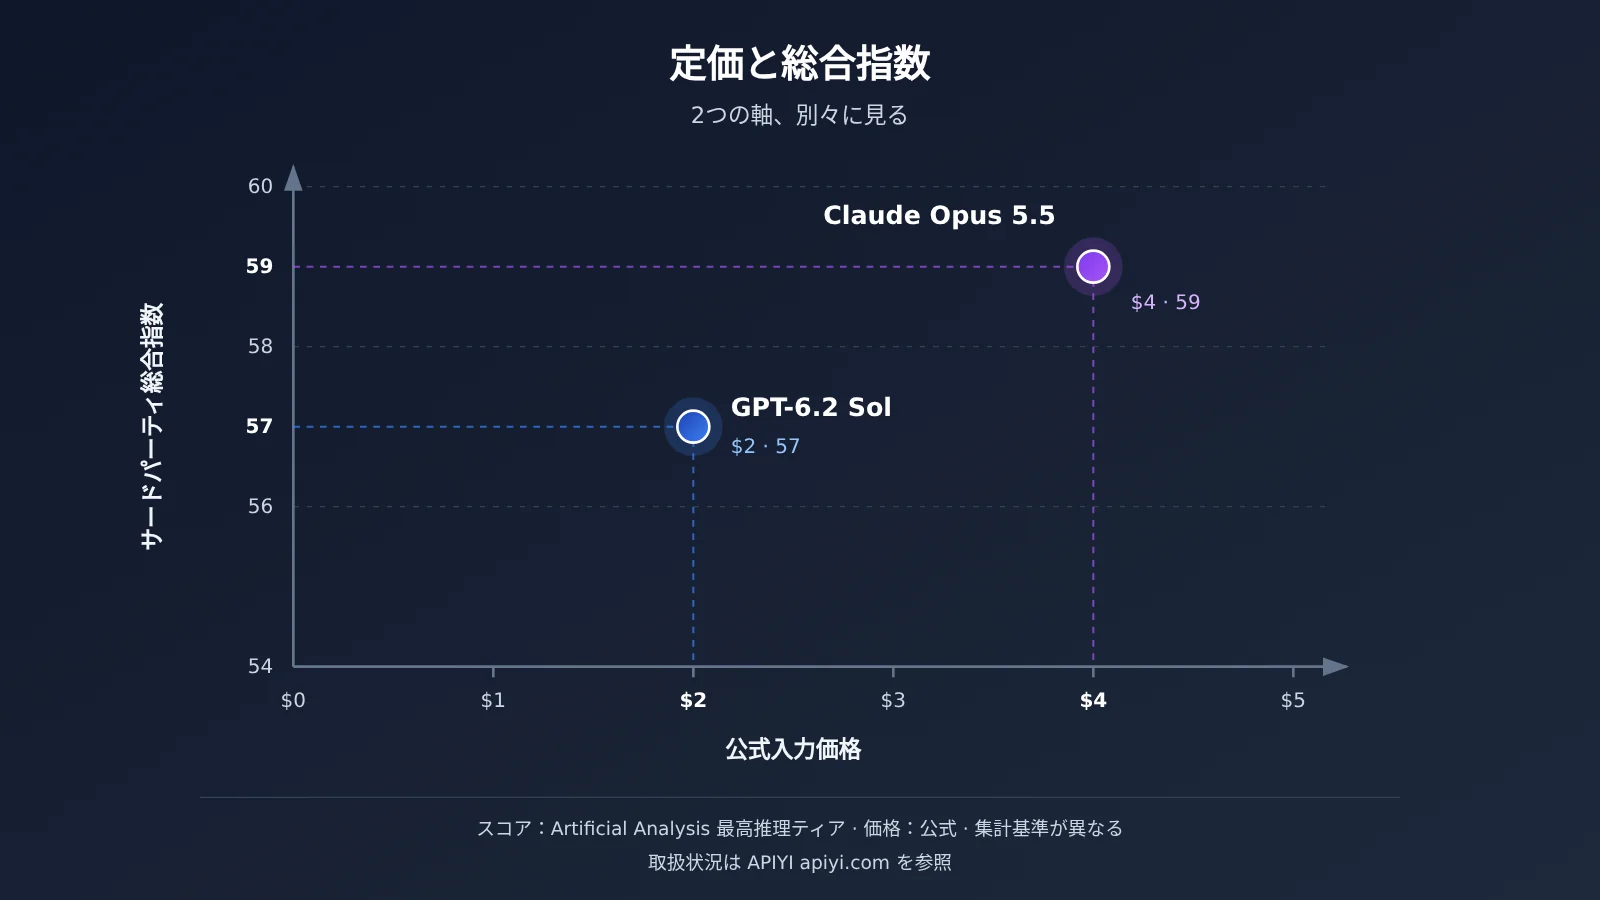
GPT-6.2 Sol と Claude Opus 5.5 の公式価格とキャッシュ読み取りの比較
価格は、今回のモデル選定で最も誤解しやすい部分です。下の表では、公式価格と APIYI プラットフォームの価格を分けて記載しています。すべての数値は 100 万トークンあたりの価格で、デフォルトは短いコンテキストの標準料金です。
| 料金項目 | GPT-6.2 Sol 公式価格 | Claude Opus 5.5 公式価格 | Claude Opus 5.5 の APIYI 価格 | GPT-6.2 Sol の APIYI 価格 |
|---|---|---|---|---|
| 入力 | $2 | $4 | $4 | 未掲載 |
| 出力 | $10 | $20 | $20 | 未掲載 |
| キャッシュ読み取り | $0.10 | $0.20 | $0.2 | 未掲載 |
| キャッシュ書き込み | 30分 $2.50/12時間 $5 | 5分 $5/1時間 $8(料金案からの転記) | プラットフォームのリストを参照 | 未掲載 |
| 超長文入力のルール | 272K を超えるとリクエスト全体に追加料金 | 参考資料に記載なし | プラットフォームのリストを参照 | 未掲載 |
GPT-6.2 Sol の公式の短いコンテキスト価格は、入力 $2、出力 $10、キャッシュ読み取り $0.10 です。発表文では、GPT-6.1 Sol の API トークン価格をそのまま引き継ぐと説明されています。APIYI では GPT-6.2 Sol はまだ取り扱いがありませんが、できるだけ早く取り扱いを開始する予定です。モデル名と価格の正式な情報は、プラットフォームのモデルリストとなります。
Claude Opus 5.5 の公式価格は入力 $4、出力 $20 です。キャッシュ読み取りの $0.20 とキャッシュ書き込み価格(5分 $5、1時間 $8)は Anthropic の料金案からの転記で、書き込み価格については Anthropic の公式ページをご確認ください。APIYI のモデル一覧表(データ時点 2026-11-17 15:54、UTC+8)では、claude-opus-5-5 と claude-opus-5-5-thinking の両方がすでに掲載されており、プラットフォームの価格は $4 / $20 / $0.2 となっています。これらの項目は APIYI apiyi.com のモデルリストで直接確認できます。
特に注意していただきたいのは、APIYI の一覧表で現在確認できる gpt-6.1-sol($2 / $10 / $0.1)と gpt-6-sol($2 / $10 / $0.2)は、どちらも 6.2 ではないという点です。これらの価格を GPT-6.2 Sol のプラットフォーム価格と見なすことはできませんし、6.2 の能力を示すものでもありません。
GPT-6.2 Sol の 272K 超過時の全体課金ルール
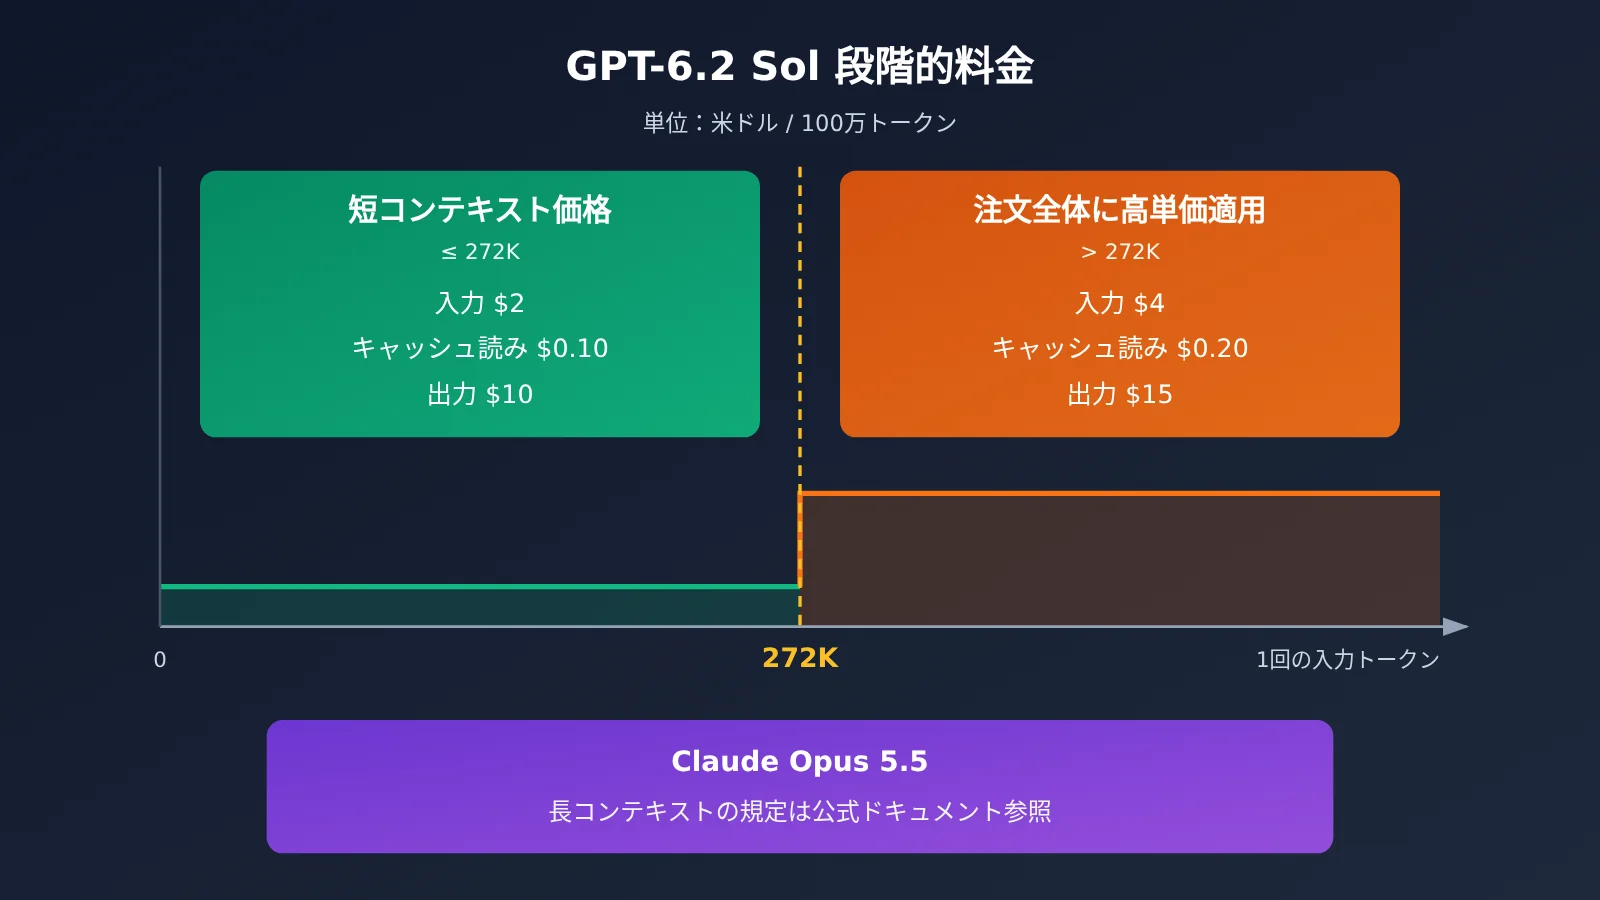
OpenAI のモデルページには、1 回のリクエストの入力が 272K トークンを超えると、入力とキャッシュの単価が 2 倍になり、出力は短いコンテキスト価格の 1.5 倍で計算されると明記されています。しかも重要なのは、超過部分だけでなくリクエスト全体が新しい単価で課金されるという点です。これを Sol に当てはめると、入力 $4、キャッシュ読み出し $0.20、出力 $15 となります。
このルールは、長文ドキュメントを扱うタスクに大きな影響を与えます。典型的なリクエストが 272K 前後になることが多いなら、定価で「約半分」という優位性はかなり縮まってしまいます。Opus 5.5 に同様の長コンテキストルールがあるかどうかは、本記事の参考文献では確認できていないため、比較する前に Anthropic のドキュメントを直接確認することをおすすめします。
それ以外にも、Sol の Batch は標準価格の 50%、Fast は同じコンテキスト長における標準価格の 2 倍です。Ultrafast は 2027-02-28(太平洋時間)まで標準価格の 3 倍、2027-03-01 からは 6 倍になります。
定価換算による単一リクエストの試算例
感覚をつかみやすくするため、以下では公式の定価だけで計算した純粋な数値例を紹介します。実際の請求額を表すものではありません。1 回のリクエストで入力 10 万トークン、出力 1 万トークン、キャッシュを使わないと仮定すると、Sol は約 $0.20 + $0.10 = $0.30、Opus は約 $0.40 + $0.20 = $0.60 になります。
この試算には 2 つの前提があります。1 つは両モデルが同じタスクで同じ量のトークンを消費すること、もう 1 つはリクエストが 272K を超えないことです。実際の利用では、推論トークンの消費量はモデルや推論の強度、タスクの内容によって変わるため、実際のコストは自分のタスクで一度走らせてから計算し直す必要があります。
GPT-6.2 Sol と Claude Opus 5.5 の性能数値:2つの基準を分けて読む
性能数値には2つの情報源があります。1つは Artificial Analysis による第三者評価、もう1つは OpenAI の発表文やモデルページにおける公式自己申告です。両者はタスク、推論レベル、コストの測定基準がすべて異なるため、以下では分けて列挙し、一つの結論にまとめません。
第三者機関 Artificial Analysis の総合指数(Intelligence Index v5.0.1)
| モデルと推論レベル | 総合指数 | 総合指数の1タスクコスト | 備考 |
|---|---|---|---|
| GPT-6.2 Sol(Max) | 57 | $1.01 | GPT-6.1 Sol より 2 ポイント高い |
| GPT-6.2 Sol(Xhigh) | 56 | 個別掲載なし | 第三者 |
| GPT-6.2 Sol(High) | 55 | 個別掲載なし | 第三者 |
| GPT-6.2 Sol(Medium) | 53 | 個別掲載なし | 第三者 |
| GPT-6.2 Sol(Low) | 41 | 個別掲載なし | 第三者 |
| Claude Opus 5.5(最高レベル) | 59 | 本記事の資料に記載なし | 同一記事より |
Sol の $1.01 は、この総合指数で1タスクを実行した際の平均コストにすぎず、すべてのタスクの単価ではありません。また、他の情報源のコスト数値と割り算して比較することもできません。Opus 5.5 のこの指数における1タスクあたりコストは、参照資料に記載がないため、本記事では推算しません。
同じ第三者記事には、注目に値する細分化した結果もいくつか示されています。Coding Agent Index(Codex harness、Max)では、Sol は GPT-6.1 Sol より 3 ポイント低くなっています。主な原因は、SWE-Atlas-QnA-AA が 14 ポイント低く、重要な事実を見落としやすい点にあります。AA-Omniscience のハルシネーション率(Max)は Sol で 55%。AA-Robotics v0.1 のリサーチプレビューでは、Sol は 78 です。これらの細目には Opus 5.5 の比較数値が示されていないため、Sol 自身の強みと弱みを理解するためにのみ使えます。
OpenAI 公式自己申告の GPT-6.2 Sol データ
以下の数値はすべて OpenAI の発表文によるもので、公式自己申告に該当します。比較対象の多くは Claude Opus 5.5 ではなく、OpenAI 自社のモデルです:
- FrontierCode 2.0(Cognition 製。実際のコードベースへの変更がメンテナーにマージされるかを評価):Sol は GPT-6.2 Astra と 0.5 ポイント未満の差で、コストは約5分の1。両者とも Max レベルを使用。
- LifeVal(OpenAI 自作の日常タスクセット):Sol は GPT-6 Astra より高いスコアで、コストは約7分の1。
- GDPval v2(公式の内部評価):Sol は GPT-6.1 Sol より 5.3 ポイント高い。
- AA-3D による人間ブラインド評価 Elo(公式による引用):Sol は 1259。
なぜ2つの数値を合算してはいけないのか
第三者の総合指数は、最高推論レベルで一連の固定タスクを実行した結果です。一方、公式自己申告の多くは「前世代よりどれだけ高いか、コストは何分の1か」という相対的な表現にとどまります。両者ではベンチマーク、推論レベル、コストの算出方法がすべて異なります。「総合スコアが 2 ポイント低い」と「ある公式テストでは Astra に肉薄」とを組み合わせても、「Sol の方が全体的に強い」あるいは「Opus の方が全体的に強い」という結論は導き出せません。
より実用的な読み方をすると、こうなります。第三者の総合スコアは、2つのモデルが汎用的な混合タスクでどのあたりに位置するかの目安になります。一方、公式自己申告は、Sol が OpenAI によってどのシーンで重点的に最適化されているか——たとえば日常タスクやコードマージ系のタスク——を示しています。最終的にモデルを選ぶ際は、やはり自分のタスクでの実際のパフォーマンスを基準にしましょう。
GPT-6.2 Sol と Claude Opus 5.5 のスペックとプロトコルの違い
スコアや価格以外に、すぐに乗り換えられるかどうかを左右するのは、むしろ接続方式であることが多いものです。以下の表に、両モデルのスペックとエンドポイントの違いをまとめました。
| スペック項目 | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| 入力モダリティ | テキスト、画像(音声・動画は非対応) | 参考資料に個別の記載なし |
| コンテキストウィンドウ | 1,050,000(最大入力 922,000) | 1M |
| 最大出力 | 128,000 | 128K |
| ナレッジカットオフ | 2026-06-01 | 2026-06 |
| 推論強度 | 推論 token に対応。ただし API では effort を none に設定不可 | デフォルトの effort は medium |
| 公式エンドポイント | Chat Completions、Responses、Batch | Anthropic Messages |
| APIYI エンドポイント | まだ未提供 | chat、messages |
Claude Code や Anthropic SDK ベースで書かれた Agent のように、ツールチェーンが Claude の Messages プロトコルに依存している場合、Opus 5.5 は APIYI 上で chat と messages の両エンドポイントを提供しており、グループには ClaudeCode、Claude_Reverse、Claude_Enterprise、Default、SVIP が含まれます。切り替えの手間は実質、base URL と Key を変更するだけです。
GPT-6.2 Sol は OpenAI の Chat Completions と Responses を採用しています。公式のモデルページには、Realtime、Assistants、ファインチューニング、画像生成、動画、音声には非対応と明記されているため、これらのニーズには期待できません。
GPT-6.2 Sol と Claude Opus 5.5 のユースケース別おすすめ
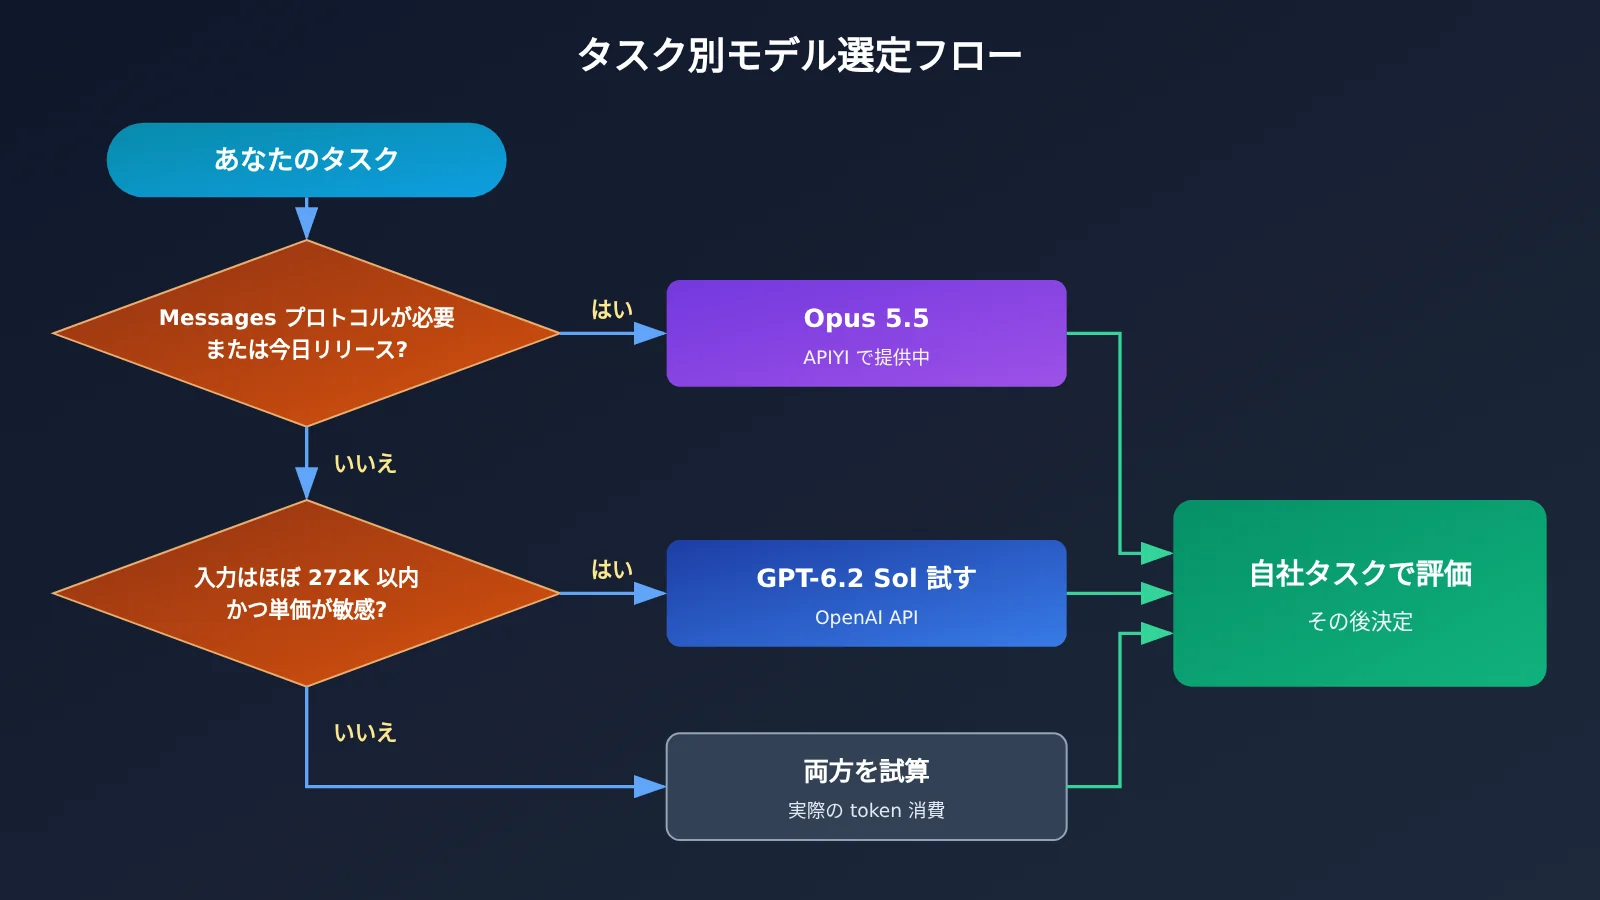
タスクに合わせて選ぶ方が、総合スコアだけで選ぶよりも確実です。以下では2つのシーンに分けて説明し、最後に1つの表でまとめます。
Claude Opus 5.5 を選ぶべきシーン
- Claude プロトコルが必要な場合:既存のコードが Anthropic Messages ベースだったり、Claude Code のようなツールに依存している場合、プロトコルを切り替える改修コストは単価差を上回ります。
- 今すぐ本番投入したい場合:Opus 5.5 はすでに APIYI で提供中なので、すぐに接続できます。新モデルの登場を待つ必要はありません。
- 総合スコアが絶対条件の場合:タスクが汎用的な混合ベンチマークに近く、最高推論レベルでのその2点差が結果に実際の影響を与えるケースです。
まず GPT-6.2 Sol を検討したいシーン
- 日常のバッチタスクで単価に敏感な場合:公式の短コンテキスト価格は Opus の約半分、キャッシュ読み取りも半分です。高頻度でプロンプトの再利用が多いシーンに適しています。
- リクエストの大半が 272K 以内に収まる場合:そうすることで短コンテキスト価格を安定的に適用でき、リクエスト全体への割増を避けられます。
- すでに OpenAI プロトコルのエコシステムにいる場合:Responses や Chat Completions を使っていれば、移行時の変更は最小限で済みます。
注意したいのは、「まず Sol を検討」は Sol の総合スコアが高いという意味ではない点です。サードパーティの数値はむしろ逆になっています。ここで言いたいのは、単価に敏感で日常的なタスクが中心のシーンでは、まず Sol で自分のタスクを一通り試してみる価値がある、ということです。
| タスクの種類 | 優先候補 | 主な理由 | 利用できるプラットフォーム |
|---|---|---|---|
| Claude Code / Messages プロトコルのエンジニアリングタスク | Claude Opus 5.5 | プロトコルネイティブで改修不要 | APIYI(apiyi.com)、すでに提供中 |
| 今すぐリリースが必要な本番タスク | Claude Opus 5.5 | 現時点で利用可能 | APIYI、すでに提供中 |
| 高頻度の日常タスク、プロンプトキャッシュの再利用 | GPT-6.2 Sol | 公式の入力・出力・キャッシュ読み取り価格が約半分 | OpenAI API。APIYI では現時点で未提供 |
| 272K を超える長文ドキュメントの処理 | 両モデルとも実際のトークン量で試算 | Sol にはリクエスト全体への割増ルールあり | 各プラットフォームのモデル一覧を参照 |
| 重要な事実の見落としが許されないQ&A | 先に個別評価を実施 | Sol は SWE-Atlas-QnA-AA でスコアが低下(サードパーティ調べ) | 各プラットフォームのモデル一覧を参照 |
GPT-6.2 Sol と Claude Opus 5.5 のクイックスタート
現在 APIYI ですぐに呼び出せるのは Claude Opus 5.5 です。導入手順は以下のとおりで、すべて設定の変更だけで完結し、追加の依存関係は不要です。
- APIYI に登録して APIキーを作成します。新規ユーザーには無料テストクレジットが付与されます。
- クライアントの base URL を
https://api.apiyi.com/v1に設定します。これは OpenAI 互換インターフェースのアドレスです。 - モデル名には
claude-opus-5-5を入力します。明示的な思考プロセスを出力させたい場合はclaude-opus-5-5-thinkingに切り替えられます。 - Anthropic スタイルのクライアントをお使いの場合はそのまま messages エンドポイントへ、OpenAI SDK をお使いの場合は chat エンドポイントを利用します。
- 実際の業務リクエストを 5〜10 件使って 1 ラウンドの評価を行い、入力・出力・キャッシュヒットの各トークン数を記録します。そのうえで、$4 / $20 / $0.2 というプラットフォームの表示価格に基づいてタスクごとのコストを算出します。
GPT-6.2 Sol のモデル ID は gpt-6.2-sol で、公式には OpenAI API 経由で呼び出せます。また、ChatGPT Work と Codex では Plus・Pro・Enterprise・Edu プラン向けにすでに開放されています。APIYI ではまだラインアップに追加されていませんが、できるだけ早くこのモデルを追加する予定です。モデル名と価格については、プラットフォームのモデル一覧をご確認ください。提供開始までの間、評価の代用として gpt-6.1-sol を使うのは避けてください。この 2 つは別のモデルです。
🚀 クイックスタート:まずは APIYI(apiyi.com)の無料クレジットで
claude-opus-5-5を一通り動かし、自分のタスクでのトークン消費量を記録しておくのがおすすめです。gpt-6.2-solが提供開始になったら、同じリクエスト・同じ base URL のままモデル名だけ変えてもう 1 ラウンド実行すれば、両方のコストと効果を同じ表で比較できます。
GPT-6.2 Sol と Claude Opus 5.5 の選択ガイド
💡 選び方の目安:Claude プロトコルが必要、今すぐにでも動かしたいなら、Claude Opus 5.5 を選びましょう。公式定価がより安い日常使いのモデルを求めるなら、GPT-6.2 Sol に注目する価値があります。ただし、その総合スコアのほうが上だと言うのは避けたほうが無難です。最終的には、自分のタスクで評価して決めるのが一番です。APIYI(apiyi.com)の統一インターフェースを通せば、両モデルで同じ呼び出しコードを共用でき、切り替え時はモデル名を変更するだけで済みます。
実際の運用では、押さえておくべきポイントが 3 つあります。第一に、評価時は両モデルの推論強度を揃えることです。サードパーティの総合スコアは最高レベルの設定で測定されていますが、Opus のデフォルトは medium であり、レベルが異なるとスコアもトークン消費も変わります。第二に、プロンプトの接頭辞が安定するタスクではキャッシュを考慮に入れましょう。キャッシュ読み取り単価はどちらのモデルも入力価格の 1/20 なので、ヒット率が高い場合は請求額の差が拡大されたり縮小されたりします。第三に、長文ドキュメントのタスクでは、272K 以上のケースは必ず別途試算してください。
よくある質問(FAQ)
Q1:GPT-6.2 Sol と Claude Opus 5.5 はそれぞれどんな位置づけのモデル?
GPT-6.2 Sol は OpenAI が 2026-11-17 にリリースしたモデルで、テキストと画像を入力として受け付け、テキストを出力します。コンテキスト長は 1,050,000 で、公式には効率的な日常タスクや実際の業務向けという位置づけです。Claude Opus 5.5 は Anthropic のモデルで、コンテキストは 1M、最大出力は 128K、デフォルトの推論強度は medium です。
Q2:GPT-6.2 Sol と Claude Opus 5.5、どちらが強い?
この問いに一つの総合スコアで答えることはできません。Artificial Analysis のサードパーティ総合指数では、Sol の Max レベルは 57、Opus の最高レベルは 59 です。公式の自己申告では、Sol は FrontierCode 2.0 や LifeVal などの項目で見どころがありますが、比較対象は主に OpenAI 自社のモデルです。総合スコアで選ぶのではなく、実際のタスクで評価して選ぶことをおすすめします。
Q3:GPT-6.2 Sol は今、APIYI で呼び出せますか?
まだ呼び出せません。APIYI のモデル一覧(2026-11-17 15:54、UTC+8 時点)と公開されている価格 API のどちらにも `gpt-6.2-sol` は見当たりません。GPT-6.2 Sol は現在未掲載ですが、できるだけ早く追加する予定です。モデル名と価格はプラットフォームのモデルリストを基準にご確認ください。
Q4:APIYI での Claude Opus 5.5 の価格とエンドポイントは?
`claude-opus-5-5` と `claude-opus-5-5-thinking` はどちらもすでに掲載されています。プラットフォームの表記価格は入力 $4、出力 $20、キャッシュ読み取り $0.2(100 万トークンあたり)で、エンドポイントは chat と messages に対応しています。APIYI(apiyi.com)なら同じ APIキー 1 本で呼び出せて、base URL には `https://api.apiyi.com/v1` を設定してください。
Q5:Sol の 1 タスクあたりコスト $1.01 をそのまま試算に使えますか?
そのまま使うことはできません。$1.01 は Artificial Analysis が総合指数の一連のタスクを Max 推論レベルで測定した平均コストで、あくまでその評価セット固有の数字です。あなたのタスクの長さや推論の消費量が違えば、コストも変わってきます。Opus 5.5 のこの指数におけるタスクあたりコストは本記事の資料では扱っていないため、両者を割り算して比較することもできません。
Q6:GPT-6.2 Astra と Sol はどんな関係? Astra も検討すべき?
Astra は Sol と同時期にリリースされた別のモデルで、公式の短コンテキスト向け表記価格は入力 $8、キャッシュ読み取り $0.40、出力 $40 です。サードパーティ総合指数では Sol より高いスコアを出しています。APIYI では GPT-6.2 Astra は現在未掲載ですが、できるだけ早く追加する予定です。モデル名と価格はプラットフォームのモデルリストを基準にご確認ください。本記事の比較対象は Sol と Opus 5.5 であり、Astra の価格帯はこの 2 モデルとは別の水準です。
Q7:同じ価格帯で他に比較できるモデルはありますか?
Gemini 4 Carbon が参考になります。APIYI にはすでに `gemini-4-carbon` が掲載されており、プラットフォームのページに書かれているのは紹介価格:入力 $2、キャッシュ読み取り $0.1、出力 $10 です。ただし、Google の公式価格は 2026-12-01 から入力 $4、出力 $20、キャッシュ読み取り $0.20 に改定される点にご注意ください。プラットフォームのページには現時点でこの改定が反映されていないため、12 月 1 日以降は APIYI(apiyi.com)のモデルリストを基準にしてください。
Q8:GPT-6.2 Sol に既知の制限事項はありますか?
公式のモデルページには、音声・動画入力に非対応であること、Realtime、Assistants、ファインチューニング、画像生成、音声機能にも対応していないことが明記されています。API も推論エフォートを none に設定することを受け付けません。サードパーティのデータでは、SWE-Atlas-QnA-AA において GPT-6.1 Sol より 14 点低く、重要な事実を見落としやすいことが示されています。公式のアライメント評価でも、6.2 シリーズは 2 つのテストにおいて、ファイルの欠落や検索ツールの利用不可といった作業を妨げる問題を報告し忘れやすいと指摘されています。
GPT-6.2 Sol と Claude Opus 5.5 の重要ポイント(Key Takeaways)
- 総合スコア:サードパーティ評価の最高推論レベルでは、Sol(Max)が 57、Opus 5.5 が 59 と、2 点差です。
- 公式価格:Sol は入力 $2、出力 $10、キャッシュ読み込み $0.10。Opus は $4、$20、$0.20 です。
- 長いコンテキスト:Sol は 1 回の入力が 272K を超えると請求全体が割り増しになり、入力とキャッシュは 2 倍、出力は 1.5 倍になります。
- 評価基準は別物:公式の自己報告とサードパーティ評価では、タスクも推論レベルも異なるため、1 つの結論にまとめることはできません。
- 現在の利用可否:Opus 5.5 はすでに APIYI で提供中です。Sol はまだ未掲載のため、プラットフォームのモデル一覧をご確認ください。
- モデル選びの指針:Claude プロトコルへの対応やすぐに使えることを重視するなら Opus。単価がシビアな日常タスクでは、まず Sol を評価してから決めるのがおすすめです。
まとめ
GPT-6.2 Sol と Claude Opus 5.5 の選択は、次の3点に整理できます。
- スコアと価格はセットで見る:Sol はサードパーティの総合スコアで2ポイント低い一方、公式の短いコンテキストの定価は Opus の約半分。どちらか一项だけでは判断材料として不十分です。
- タスクとプロトコルで選ぶ:Claude のプロトコルに依存している、すぐに本番投入したいタスクには Opus 5.5 を選びましょう。単価が重要で、リクエストのほとんどが 272K 以内に収まる日常的なタスクなら、まず Sol で評価してみる価値があります。
- 自分のタスクで計算する:サードパーティのタスクあたりコストは、あくまでその評価環境固有の数字。実際のコストは、あなたのトークン消費量、キャッシュヒット率、推論強度によって決まります。
現段階で最も現実的なのは、まず Opus 5.5 で評価フローを構築しておき、Sol の提供開始後に同じリクエスト群で比較を追加実施することです。APIYI(apiyi.com)なら 1 つの APIキー で複数モデルを同時に管理でき、無料クレジットでも初回の検証は十分に完了できます。
📚 参考資料
-
OpenAI 発表記事:GPT-6.2 Astra と Sol のリリースノートおよび公式自己申告の評価
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol - 説明: 定価の概要、利用可能範囲、各項目の公式自己申告比較
- リンク:
-
OpenAI モデルページ gpt-6.2-sol:仕様、エンドポイント、完全な価格規則
- リンク:
platform.openai.com/docs/models/gpt-6.2-sol - 説明: キャッシュ書き込み価格、272K 全体適用ルール、Batch / Fast / Ultrafast の倍率
- リンク:
-
OpenAI システムカード:安全性とアライメントの評価
- リンク:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 説明: セーフティ準備フレームワークのレベルとアライメントテストの結論
- リンク:
-
Artificial Analysis サードパーティ評価記事:Intelligence Index v5.0.1 の結果
- リンク:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - 説明: 推論レベル別の総合スコア、細分化された各種指数、Opus 5.5 最高レベルとの対比
- リンク:
-
Artificial Analysis モデルページ GPT-6.2 Sol:タスクあたりコストなどの指標
- リンク:
artificialanalysis.ai/models/gpt-6-2-sol - 説明: 総合指数のタスクあたりコスト $1.01(Max レベル)
- リンク:
-
Claude モデルドキュメント:Opus 5.5 の仕様と公式定価の比較
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 説明: Opus 5.5 の入出力価格、コンテキスト、デフォルトの推論強度
- リンク:
著者:APIYI 技術チーム
技術交流:APIYI(apiyi.com)のサイトトップページからお気軽にご連絡ください。モデルと価格の最新情報は、docs.apiyi.com ドキュメントセンターのモデル一覧表でご確認いただけます。