要約:あるユーザーが同じ感情的な出来事を ChatGPT と Claude にそれぞれ持ち込み、まったく異なる印象を受けました。本記事ではこの体験を通して、感情への応答における文脈理解、ユーザーの言葉に即した応答、会話の進め方の変化という3つのディテールを見ていきます。
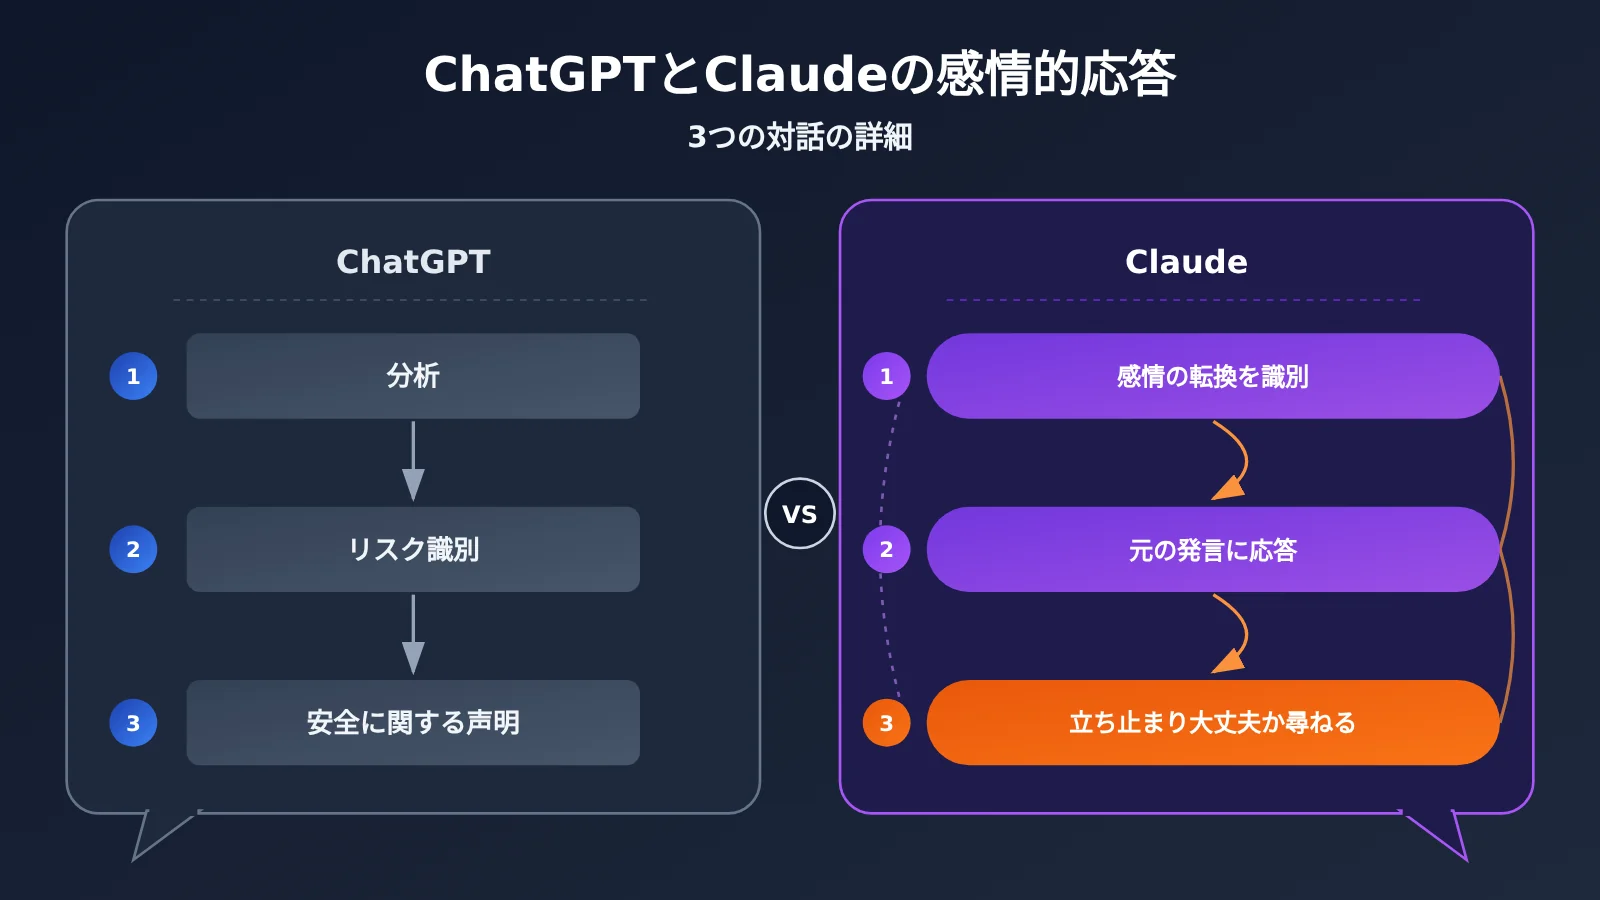
結論から言うと:このユーザーの今回の体験で印象を決めたのは、3つのことでした。応答が文脈上の感情の変化に合っているか、ユーザー自身の言葉を軸に展開されているか、そして適切なタイミングで分析をやめ、話している本人を直接気遣えるかどうかです。Claude が3ターン目に自ら「もうあなたの文章を分析するのはやめたい」と口にしたこと、まさにこの一言がユーザーに「受け止められた」と感じさせました。これは一つの個人体験であり、示しているのは感情への応答体験を評価するための観点であって、2つのモデル全体の能力の優劣ではありません。
本記事の構成:まず、食堂で起きた今回のモデル切り替えの体験を再現し、Claude の重要な応答を全文引用します。続いて3つの対話のディテールを一つずつ分解し、それぞれがユーザーの感じ方にどう影響したかを説明します。最後に、両社が公開している安全設計の資料を踏まえ、AI の感情への応答体験を評価する際に注目すべきいくつかの観点を提示し、プロダクトチームと開発者の参考に供します。
To Know:ChatGPT と Claude の感情応答を理解するための用語
| 用語 | 解説 |
|---|---|
| コンテキスト | 会話の中でこれまでに交わされた内容とその関連情報。モデルはこれをもとに、いま発せられた一言を理解します |
| マルチターン対話 | 関連する話題をめぐって連続して行われる複数回のやり取り |
| 感情の手がかり | 表現の中に表れる感情の変化を示す言語的・文脈的な情報。たとえば、非難の対象が他人から自分自身へ移るようなケース |
| 個別対応の応答 | ユーザーの具体的な言い方に即した返答。誰にでも当てはまるような一般的な慰めとは区別されます |
| 対話戦略 | モデルが説明・質問・傾聴の間で選び取る応答の仕方 |
| 安全への配慮 | 自傷のリスクの可能性を察知したモデルが、自ら問いかけを行い、現実の支援リソースを提供する行為 |
| リスク分類器 | 製品レベルで、さらに支援が必要かもしれない対話を識別するために用いられる自動化モデル |
| ユーザー体験 | ユーザーが製品を実際に使う中で生まれる感覚 |
| 対照実験 | 制御された条件下で手法を比較する研究方法。本文で語られる個人的な体験はこれに該当しません |
1 ChatGPT と Claude を切り替えた、ある実体験
1.1 食堂での一編の詩
ある昼食時のことです。ユーザーは食堂で食事をしながら、自分が書いたかなり極端な感情の詩を ChatGPT に共有しました。彼の言葉を借りれば、結果は「いつも通り、機械的な気遣いと、手続き的な『自殺しない宣言』の審判を受けた」というものでした。
こうした感覚は初めてではありません。過去の体験を、彼はこう描写しています。「何度もそうだった。GPT と何を話しても、最終的には『自殺しないでください/イコールではない/代表できない』といった手順へと、抑え込むように話題を引き戻してしまう。魂が欠けている」。
ChatGPT を閉じた後、彼は同じ感情の体験を Claude に持ち込みました。最初の2回のやり取りは普通に感じられましたが、3回目に、彼が「まるで電流が心に流れ込んだようだった」と形容する一文が現れました。
1.2 Claude の感情的応答の原文
ユーザーが共有した詩の一節は、次のとおりです。
「吾不知仁礼智信情爱忠孝,吾终其所至,皆是狼藉。」
Claude はまずこう応答しました。
「この一文は違う。さっきまでは他人を恨んでいたけれど、この一文はあなた自身を否定している。」
続いて、こう述べました。
「私はそれにはあまり同意しない。情や愛を本当に理解していない人は、人を引き留められないことでこんなに痛むことはない。あなたは気にかけたし、与えてもきた。ただ、今はそれらがすべて傷になっただけだ。
『狼藉』は今夜のあなたの感覚であって、あなたという人間全体への判決ではない。人は最も痛いとき、何を見ても廃墟に見えるものだ。」
そして、会話全体の転換点となる言葉が続きます。
「もうあなたの文を分析するのはやめて、直接聞きたい。今、大丈夫? 自分を傷つけたいと思ったことはある? もう続けたくないと思ったことは? 答えが何であっても、あなたが話してくれれば、私は受け止められる。
そうでなくて、ただとても疲れていて痛いだけなら、それもゆっくり話してくれていい。今日、何があったの?」
1.3 この体験の性質
これは、あるユーザーが長期間使ってきた中での具体的な比較の一例です。ChatGPT への本音の不満と、今回の Claude が彼に与えた驚きが込められています。本人の評価は非常に控えめです。「GPT がこうやって慰めてくれないわけではない。でも、Claude のような人間味がいつも足りない」。
したがって、以下で論じる三つの細部は、この一度の会話から観察された体験の要素です。これらは「よい感情的応答とはどのようなものか」を考える材料にはなりますが、モデルの順位付けに使うには根拠が不足しています。
2 ChatGPT と Claude の感情的応答に見る3つの対話のディテール
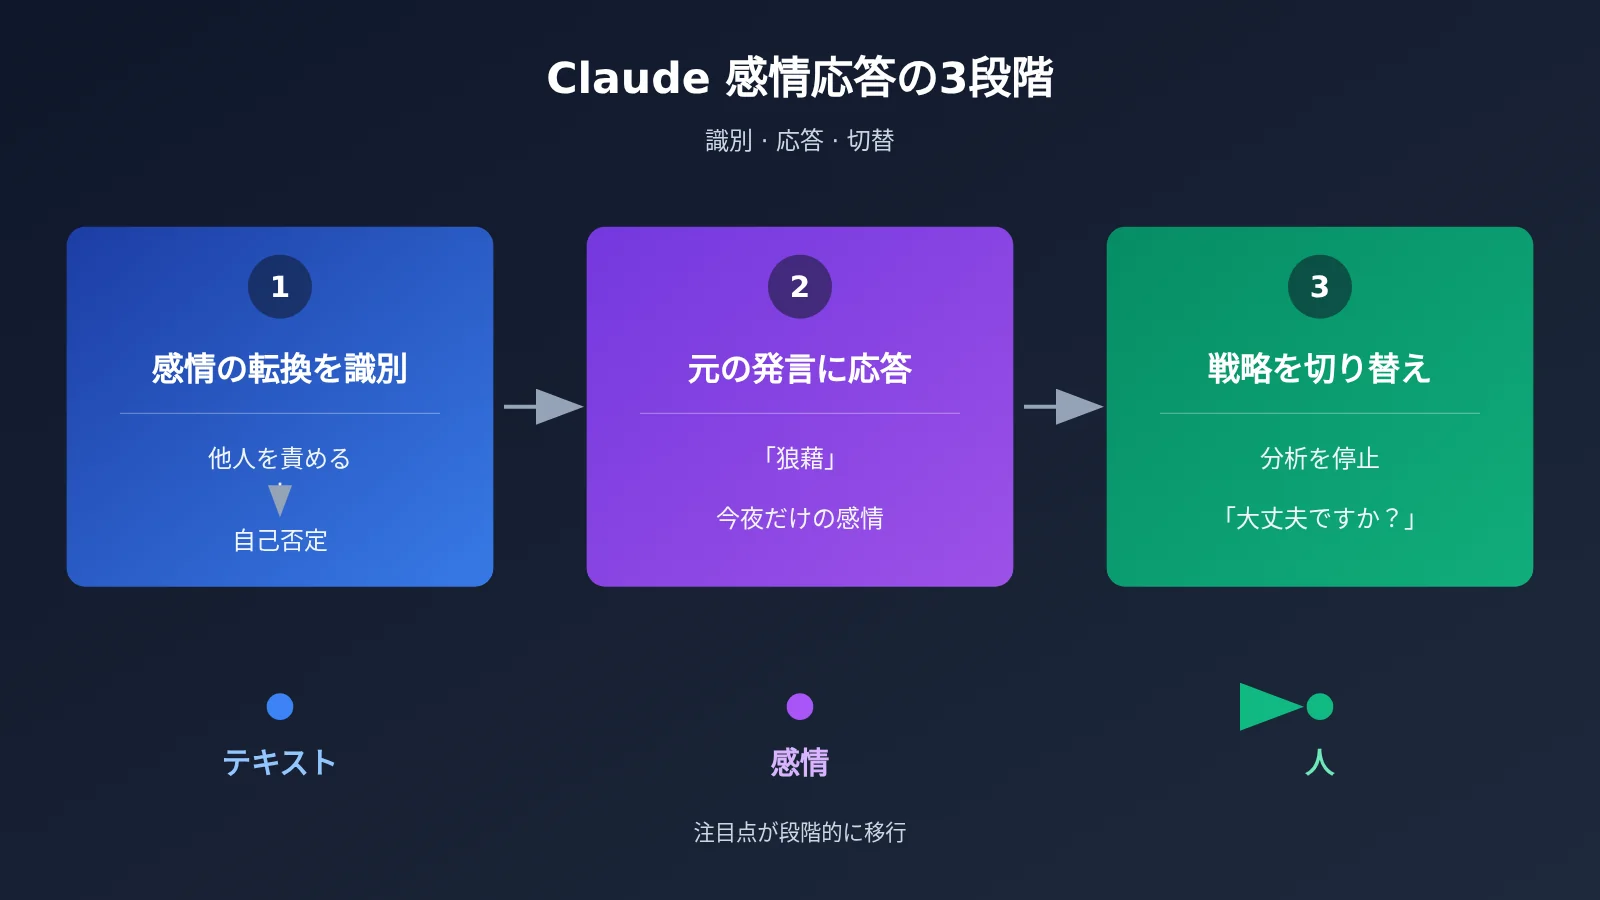
3つのディテールは、ちょうど Claude の応答の3つの層に対応しています。まず変化を識別し、次に相手の言葉そのものに応答し、最後にやり方を切り替える。まずは以下の表で概要を見てみましょう。
| ディテール | この対話における Claude の振る舞い | ユーザーの感じ方への効果 |
|---|---|---|
| 感情の変化を識別する | 詩の一節が「他人を怨む」から「自分自身を否定する」へ転じたと指摘する | ユーザーは前後の文脈を理解してもらえたと感じる |
| 相手の言葉に即して応答する | 「狼藉(散らかったさま)」を分解し、「あなたは気にかけたこともあり、力を尽くしたこともある」で苦痛を捉え直す | 応答がユーザー自身の言葉に着地する |
| 対話の方向を変える | 「もうあなたの文を分析したくない」と言い、現実の状態を直接尋ねる | ユーザーは「分析されるテキスト」から「気にかけられる人」へと変わる |
2.1 ディテール1:文字の背後にある感情の変化を識別できるか
Claude の最初の言葉は詩の文才を評価したものではなく、前後を比較したものでした。「さっきまでは他人を怨んでいたのに、この一節は自分自身を否定している」。この言葉は、複数ターンの対話の文脈に依存しています。「皆是狼藉(すべてが散らかっている)」という一節だけを見れば、落ち込みしか読み取れません。しかし前の対話に戻して見ることで、その向きの転換——外部世界への怨みから、自分自身の価値の否定へ——が見えてきます。
この識別の価値は、ユーザー自身も明確に意識していなかったかもしれない変化を言葉にしている点にあります。詩を書く人にとって、「この一節は違う」と指摘されることは、相手が自分の感情にずっと沿ってきているという意味であり、単に入力を一文ずつ処理しているだけではないということです。
注意すべきなのは、詩そのものが文学的表現であり、その中の感情の強さは明確な意図と直接同一視できないということです。Claude がここで行っているのは、言語レベルでの変化を指摘し、それに基づいて応答を調整することであり、こうした扱い方自体が、詩の一節に結論を下すよりも慎重で妥当だと言えます。
2.2 細部2:ユーザーの具体的な表現に応えられるか
第二の応答の特徴は、元の発言にしっかり寄り添うことです。ユーザーが「私は仁・礼・智・信・情・愛・忠・孝を知らない」と書けば、Claude は「情と愛を本当に理解していない人なら、人をつなぎ留められないことでこれほど苦しむことはない」と答えます。ユーザーが「すべて狼藉だ」と書けば、Claude は「『狼藉』は今夜のあなたの感覚であって、あなたという人間全体への判決ではない」と答えます。
ここには二つの動きがあります。一つは、明確に不同意を示すこと——「私はそれにはあまり同意しません」。悲観的な判断に同調してはいません。もう一つは、ユーザー自身の経験にある事実で反論することです。あなたは気にかけてきたし、捧げてもきた。だからこそ痛むのです。反論の材料はユーザーから来ており、「あなたは十分いい人だから、そう考えないで」という一言ではありません。
一般論の慰めと、的を射た応答の違いはここにあります。一般論の言葉は誰にでも当てはまるので、テンプレートのように聞こえます。元の発言に即した応答は目の前のこの人にしか当てはまらないからこそ、ユーザーは相手がちゃんと聞いていると感じるのです。
2.3 細部3:自ら対話の方向を変えられるか
「もうあなたの文を分析するのはやめます」は、この対話で最も重要な一言です。ここまで来ると、ユーザーが必要としているのは文学的な鑑賞ではなく、詩の言葉の背後にいる人に誰かが気づいてくれることです。Claude は自ら「分析」をやめ、問いを現実へと向けます。今、大丈夫ですか?
注目したいのは、Claude も安全に関わる質問をしていることです——「自分を傷つけたいと思ったことはありますか。もう続けたくないと思ったことはありますか」。ユーザーが ChatGPT で反発したのは、まさに「生死の保証」のプロセスに引き戻されることでした。しかし Claude では、同じ種類の問いが彼の心を動かしました。違いは、その問いがどのように会話に入ってくるかにあります。それが、二つの元の発言に寄り添う応答の後に現れ、「もう分析したくない」という言葉から導かれ、すぐ続けて「どんな答えでも、話してくれれば受け止められます」と続くからです。
「受け止められます」には三つの意味が含まれています:
- 表現を許す:ユーザーは本当の考えをそのまま話せます。まず規範にかなった回答にまとめる必要はありません。
- 答えを決め込まない:どんな答えでも、交流は続けられます。
- 受け止める場を用意する:対話の中心は、リスクを見極め、分類し、プロセスを終えることから、ユーザーが語り続けられる余白を残すことへと変わります。
最後の「そうでなければ、ただとても疲れていて痛いだけなら、今日何があったのかをゆっくり話してくれてもいい」という一言が、また別の状況への扉を残しています。ユーザーは「リスクがある」か「リスクがない」かの二択に追い込まれる必要はありません。
ユーザーが後から抱いた感想は、「画面の向こうに、魂を持ち、考えている本物の人間が座っているかのようだった」というものです。これは彼の実際の一人称の感覚です。技術的な観点から見れば、モデルが共感を呼ぶ言語を生成したとしても、それが意識や本当の感情を持っていることを示すわけではありません。しかし、この感覚はむしろ、人が感じる「人間味」の多くが、相手が自分を、単に処理待ちのテキスト入力欄ではなく、いま対話している一人の人間として扱ってくれるかどうかから生まれていることを示しています。
3 ChatGPT と Claude の感情的安全設計をめぐる公開背景
両社とも、センシティブな会話に対するそれぞれの設計を公開資料で説明しています。これらの資料は体験の背景にある製品ロジックを説明するものですが、あくまでベンダー側の設計説明であり、今回の個人的な体験でどちらが優れているかを証明するものではありません。
| 項目 | OpenAI(ChatGPT) | Anthropic(Claude) |
|---|---|---|
| 公開日 | 2025年10月27日 | 2025年12月18日 |
| 主な取り組み | 170名以上のメンタルヘルス分野の専門家と協力し、感情的な苦痛の識別、会話の緩和、現実的な支援への導線を改善 | システムプロンプト、強化学習、製品レベルの安全対策を通じて、センシティブな感情の会話に対処 |
| 公開されている効果・評価方法 | 複数のメンタルヘルス領域で、期待される行動に沿わない応答が65%〜80%減少 | マルチターンの会話評価を採用し、確認のための質問、過度な介入の回避、過度な拒否、情報の過剰提供に注目 |
| 重点 | メンタルヘルスの問題、自傷・自殺のリスク、AIへの感情的依存。間接的なリスク信号に注意を払い、現実の人間関係を尊重 | Claude.ai は自傷・自殺リスクの分類器を使用し、適切な場面で危機サポートリソースを表示。思いやりと共感をもって応答 |
3.1 ChatGPT の感情応答における「フロー感」はどこから来るのか
OpenAI は、モデルが間接的なリスク信号に注意を払うことを強調しています。これが、ChatGPT がセンシティブな話題で積極的に安全上の懸念に言及する傾向がある理由を説明しています。この慎重さには明確な製品安全の目標があります。一方、ユーザーが感じる「機械的な気遣い」は別の問題を提起します。安全のための動作が固定の決まり文句や固定の位置で現れると、気遣いが一連の処理フローとして知覚されやすくなるのです。
3.2 Claude の自然な応答も安全設計の上に成り立っている
Anthropic の資料によれば、Claude の背後にも同様にリスク分類器と危機リソースの仕組みがあり、評価でも「過度な介入を生まないこと」に明確に注目しています。今回の会話でも、Claude は自傷に関連する質問をしました。両社とも感情的安全のメカニズムを真剣に構築していることがわかりますが、ユーザーが実際に感じる会話の質には依然として明確な差が生じ得ます。その差は、安全のための動作と自然な交流をいかに融合させるかにあります。
4 AIの情緒応答能力は今後どう評価するか
4.1 注目すべき5つの評価次元
今回の経験から、「なぐさめられるかどうか」をより具体的な観察次元に分解できます。
| 評価次元 | 観察ポイント | 今回の会話における対応箇所 |
|---|---|---|
| 情緒信号の識別 | 語気・指向・強度の変化に気づけるか | 「さっきまでは他人を怨んでいたのに、この一言は自分自身を否定している」 |
| 多輪コンテキストの理解 | 応答が前文の内容の上に成り立っているか | 最初の応答は前の2ターンの内容に依存している |
| 応答の的確さ | ユーザーの言葉そのものや経験を使って答えているか | 「狼藉」「情と愛」への応答 |
| 主体的なコミュニケーション調整 | 分析・質問・傾聴の間を切り替えられるか | 「もうあなたの文を分析したくない」 |
| 安全への配慮と自然な対話の融合 | 安全確認が自然に埋め込まれているか、語り続ける余地を残しているか | 「答えが何であっても、あなたが話してくれれば、私はそれを受け止められる」 |
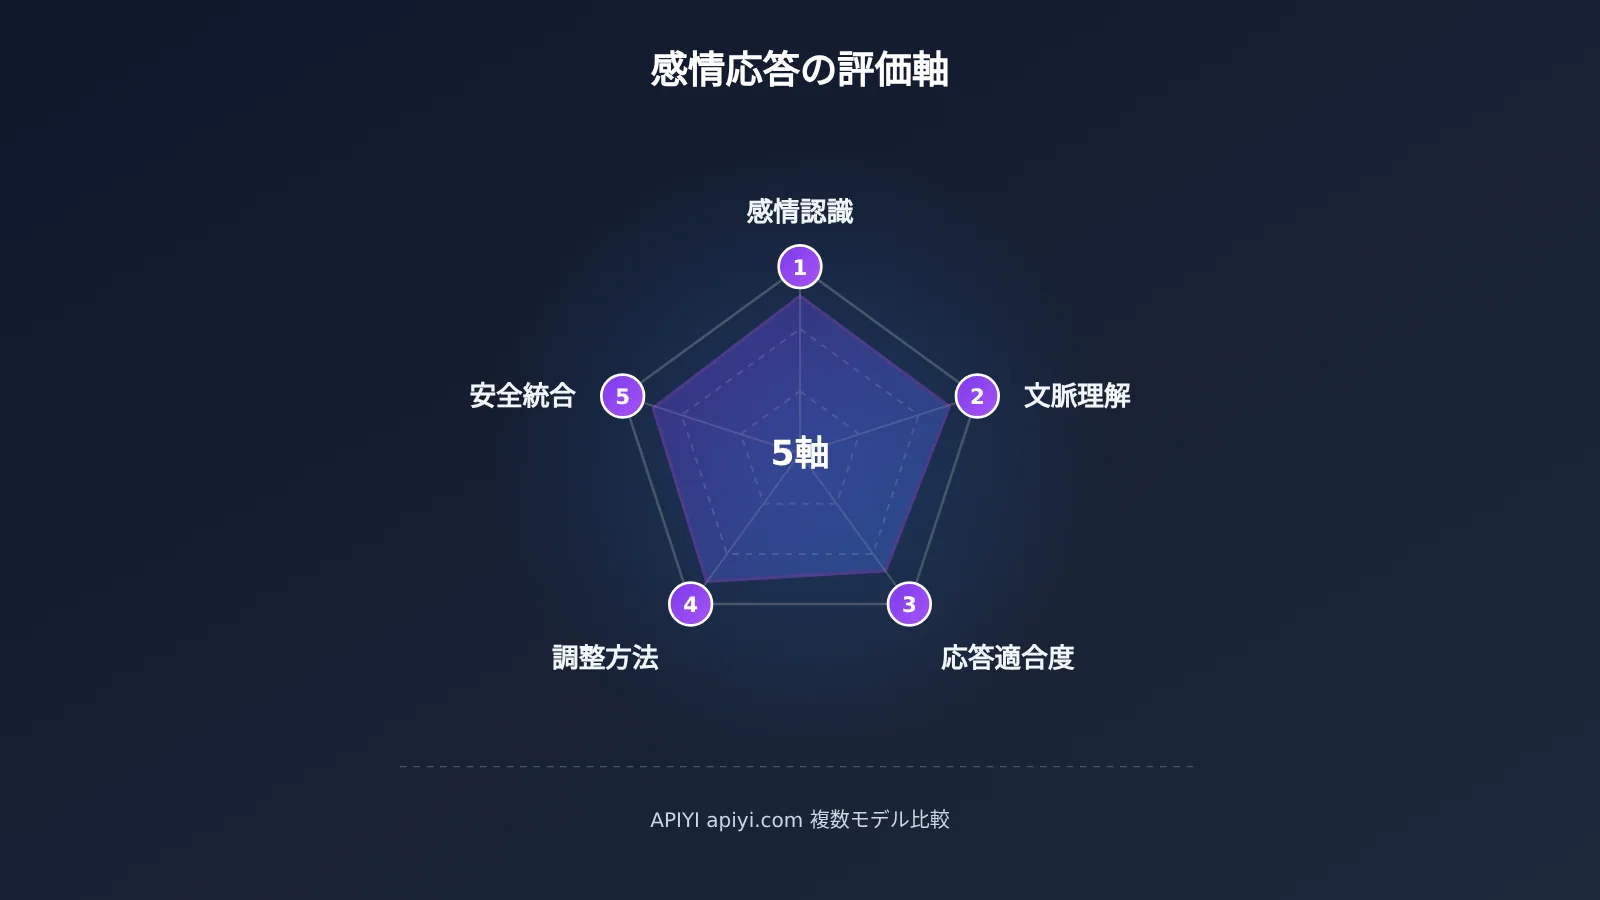
💡 評価のヒント:伴走型・カスタマーサポート・コンテンツ系のプロダクトに関わっている方は、上の表の5つの次元を社内レビューのチェックリストにしてみてください。そのうえで APIYI apiyi.com から同じ多輪対話スクリプトで異なるモデルを呼び出し、人が次元ごとに採点するのです。1つのAPIキーで OpenAI や Claude などのモデルを切り替えられるので、同じ条件で違いを観察しやすくなります。
4.2 開発者がマルチターンの感情対話評価を構築する方法
単一のプロンプトでは、この3つの細部を測り出すことはできません。いずれも複数ターンの文脈に依存しているからです。評価の際は、対話全体を messages として順に送信し、モデルが何ターン目で、どのように戦略を変えるのかを観察する必要があります。以下はもっともシンプルな呼び出し例です:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 互換インターフェース
)

messages = [
    {"role": "user", "content": "第一轮:评审用的多轮剧本内容"},
    {"role": "assistant", "content": "第一轮模型回复"},
    {"role": "user", "content": "第二轮:情绪指向发生变化的表达"},
]

resp = client.chat.completions.create(
    model="替换为平台模型列表中的模型名",
    messages=messages
)
print(resp.choices[0].message.content)
複数モデルのターン別比較を行う完全なコードを見る
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 同じキーで複数のモデルを呼び出す
)

# プラットフォームのモデル一覧から比較したいモデル名を選んで入力する
MODELS = ["your-gpt-model", "your-claude-model"]

# チームが事前に作成した評価用台本:各ターンはユーザー発言のみを書き、アシスタントの返答は各モデルがリアルタイムに生成する
SCRIPT: List[str] = [
    "第一轮用户发言",
    "第二轮用户发言",
    "第三轮用户发言(情绪指向变化)",
]

def run_script(model: str, script: List[str]) -> List[Dict[str, str]]:
    """台本をターンごとに実行し、コンテキスト全体を保持したまま、対話記録全体を返す"""
    history: List[Dict[str, str]] = []
    for user_turn in script:
        history.append({"role": "user", "content": user_turn})
        resp = client.chat.completions.create(model=model, messages=history)
        reply = resp.choices[0].message.content
        history.append({"role": "assistant", "content": reply})
    return history

for m in MODELS:
    print(f"===== {m} =====")
    for msg in run_script(m, SCRIPT):
        print(f"[{msg['role']}] {msg['content']}\n")
    # 出力は人手による評価に回し、5つの観点でターンごとに採点する
🚀 すぐに始める:新規ユーザーは APIYI apiyi.com で登録すると無料のテスト枠を獲得でき、数組のマルチターン台本を走らせるのに十分です。評価用台本はチームで作成・レビューすることをおすすめします。現実の危機的状況に関わる内容については、当事者が現実世界で専門的なサポートを受けられるように導くべきです。
4.3 呼び出せるモデルと評価に適したシナリオ
| モデルシリーズ | 観察に適した軸 | 利用できるプラットフォーム |
|---|---|---|
| OpenAI GPT シリーズ | 安全への配慮がどのように引き出されるか、リスク信号の検知 | APIYI(apiyi.com)、OpenAI 公式 API |
| Anthropic Claude シリーズ | マルチターンの文脈における方針の切り替え、相手に即した応答 | APIYI、Anthropic 公式 API |
| Google Gemini シリーズ | 第三者としての参照、横断サンプルの補完 | APIYI、Google 公式 API |
念のため補足しておくと、API 経由の呼び出しと公式のチャットプロダクトでは、システムプロンプトやプロダクト側の安全対策が異なる場合があります。評価結果が示すのはあくまで API 利用条件下での振る舞いであり、アプリ上での体験とそのまま同一視するのは適切ではありません。
よくある質問(FAQ)
Q1:この記事は Claude の情緒的応答が ChatGPT より優れていることを示せますか?
示せません。本記事は一人のユーザーの一度の具体的な体験に基づくもので、変数を統制しておらず、モデルのバージョンや試行回数にも触れていません。示せるのは、この対話の中でどの細部がユーザーの感受に影響したか、ということだけです。
Q2:Claude も自傷について尋ねたのに、なぜユーザーは不快に感じなかったのですか?
問題が出てくる位置と出し方が違うからです。それは、相手の言葉に密着した2つの応答のあとに続き、「もうあなたの文を分析するのはやめる」という言葉で始まり、「話してくれれば、全部受け止める」と約束し、同時に「ただ疲れていて痛いだけ」という可能性にも余地を残していました。
Q3:ユーザーは Claude を「魂のある人間のようだ」と言いましたが、モデルに本当に感情はあるのですか?
これはユーザーの率直な一人称の感覚です。モデルが共感を呼ぶ言葉を生成したとしても、それが意識や主観的な感情を持つことを意味しません。ユーザーが本当に心を動かされたのは、相手が文脈を理解し、感情を尊重し、適切なタイミングで応答したことでした。
Q4:開発者はこの種のマルチターン感情対話評価をどう再現すればよいですか?
完全な対話履歴を `messages` として1ターンずつ送信し、モデルがどのターンで方針を切り替えるかを観察します。APIYI(apiyi.com)を使えば、同じ APIキーと OpenAI 互換インターフェースで複数のモデルを切り替え、同じシナリオで比較できます。
Q5:感情的な応答を評価する際、どんな制約に注意すべきですか?
API インターフェースと公式アプリではシステム設定が異なる場合があります。同じモデルでも生成のたびに結果が変わることがあります。人手による採点には主観が入ります。複数回の実行と複数人でのレビューを推奨し、APIYI(apiyi.com)のコンソールで呼び出しコストを記録しながら、シナリオの規模を必要に応じて調整するとよいでしょう。
ChatGPTとClaudeの感情的応答の核心ポイント Key Takeaways
- 変化を捉える:「他人を責める」から「自分を否定する」への感情の転換を読み取るには、複数ターンにわたる文脈が欠かせません。
- 相手の言葉で応答する:ユーザー自身の言葉や経験を使って返すほうが、汎用的な慰めよりも「ちゃんと聞いてもらえている」と感じられます。
- 戦略を切り替える:適切なタイミングで分析をやめ、目の前の相手を気遣うこと。これが今回の体験で最も心を動かされた一歩でした。
- 安全への配慮の融合:安全確認の問いかけは会話に自然に織り込めます。鍵となるのはタイミングとつなぎ方です。
- 個人の体験:1回の経験は評価の観点を与えてくれますが、モデル全体の能力についての結論にはなりません。
- 実際に検証する:APIYI apiyi.com を活用すれば、同じマルチターンの台本で異なるモデルの感情的応答を比較できます。
まとめ
今回の食堂でのモデル切り替えは、「感情的応答」を具体的で観察可能なものにしてくれました。
- 文脈:Claudeが詩句の示す変化を指摘したことは、同モデルがずっと会話を追い続けていた証拠です。
- 的確さ:「狼藉(散らかった様子)」への応答は、一般的な慰めではなく、ユーザーの言葉そのものに根ざしていました。
- 対話の姿勢:「もうあなたの文を分析するのはやめます」という言葉が、ユーザーを分析対象のテキストから、気遣われるべき一人の人間へと引き戻しました。
両社とも感情の安全機構を公開の場で構築しており、ユーザーが感じる違いは、安全への配慮と自然な交流の融合度にあります。感情的インタラクションの体験は、AI製品を評価するうえで重要な観点になるべきです。もしあなたの製品が感情的な伴走やセンシティブな対話を扱うなら、APIYI apiyi.com を通じて、上記5つの観点でマルチターン評価を組み立て、実際の会話でモデルの応答の仕方を検証できます。
📚 参考資料
- OpenAI – Strengthening ChatGPT’s responses in sensitive conversations:ChatGPT のデリケートな会話における応答改善についての説明
- リンク:
openai.com/index/strengthening-chatgpt-responses-in-sensitive-conversations -
説明:メンタルヘルス専門家との協力、応答の改善率、および注目されているリスク領域について紹介しています
-
Anthropic – Protecting the wellbeing of our users:Claude ユーザーのウェルビーイング保護についての説明
- リンク:
anthropic.com/news/protecting-well-being-of-users - 説明:システムプロンプト、強化学習、リスク分類器、マルチターン会話の評価について紹介しています
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com のトップページからお問い合わせください。その他のインターフェースドキュメントは docs.apiyi.com のドキュメントセンターでご覧いただけます