Ringkasan: Google Decisions API memberikan skor langsung pada pilihan tetap tanpa menghasilkan teks. Artikel ini menggunakan harga publik untuk menghitung biayanya dalam tugas klasifikasi, moderasi, dan perutean, serta menjelaskan batas penerapannya berdasarkan data resmi dan pihak ketiga.
Kesimpulan di awal: Google merilis Gemini Decisions API pada 11 November 2026 (ID model gemini-decision-1). API ini dapat menyelesaikan 1 hingga 1.000 penilaian independen terhadap input yang sama dalam satu permintaan, dengan harga input $0,10 per juta Token dan tanpa biaya Token output generatif. Berdasarkan perhitungan harga publik, ketika memeriksa 1.000 aturan pada dokumen 10K Token yang sama, biayanya sekitar 1/20 dari Gemini 3.5 Flash-Lite, dengan penghematan teoretis 94,9%. Untuk 1.000 pesan yang masing-masing diklasifikasikan sekali, penghematan teoretisnya 73,1%. Pengujian resmi Google menunjukkan keunggulan biaya sekitar 4,7 kali. Dalam pengujian pihak ketiga pada satu pertanyaan tunggal, keunggulan ini sekitar 1,5 kali. Tugas yang hanya melakukan klasifikasi, moderasi, atau perutean, dan jawabannya dapat dibatasi pada pilihan tetap sejak awal, adalah yang paling cocok untuk menggunakan API ini guna menekan biaya.
Bagian selanjutnya pertama-tama menjelaskan mekanisme kerja antarmuka ini dan tiga jenis penilaian, kemudian menggunakan rumus yang dapat dihitung ulang untuk mengukur biaya tiga jenis bisnis tipikal, serta menjelaskan kesenjangan antara klaim resmi “sekitar 5 kali” dan pengujian pihak ketiga. Setelah itu, artikel membandingkan data kecepatan yang dipublikasikan Google dengan evaluasi independen Artificial Analysis untuk membahas apakah akurasi memenuhi persyaratan produksi. Terakhir, diberikan contoh pemanggilan minimal, tabel pemilihan, dan daftar periksa biaya sebelum peluncuran.
To Know: Pengetahuan Dasar Istilah
| Istilah | Penjelasan |
|---|---|
| Decisions API | Antarmuka keputusan dari Google yang langsung memberikan hasil dan probabilitas untuk opsi yang sudah ditetapkan |
| Gemini Decision 1 | Model khusus yang mendukung antarmuka tersebut, dengan ID model gemini-decision-1 |
| Token | Unit dasar pemrosesan dan penagihan model; teks, gambar, dan lainnya dikonversi menjadi Token |
| Input Bersama (Shared Input) | Konten input yang dipakai bersama oleh semua keputusan dalam satu permintaan |
| Keputusan himpunan tertutup (Closed-set Decision) | Keputusan yang cakupan jawabannya sudah dibatasi sebelumnya, misalnya “ya/tidak” atau memilih satu dari “A/B/C” |
| noul | Keputusan biner yang mengembalikan probabilitas “Yes” |
| choice | Memilih satu item dari 2–255 opsi yang sudah ditetapkan |
| score | Penilaian berdasarkan tingkat terurut yang telah ditetapkan; hasilnya berupa nilai ekspektasi berbobot |
| Keyakinan (Confidence) | Estimasi probabilitas model bahwa hasil yang dipilih memang benar |
| Single Forward Pass | Model memberi skor tiap opsi dalam satu kali komputasi, tanpa perlu menghasilkan teks token demi token |
| Jendela konteks (Context Window) | Total konten yang bisa ditampung dalam satu permintaan; untuk model ini 262,144 Token |
| TPM / RPM | Jumlah Token / permintaan yang bisa diproses per menit, yaitu batas throughput |
1 Apa yang Dirilis Google: Gemini Decisions API yang Dirancang untuk Pertanyaan dengan Jawaban Tertutup
1.1 Perbedaan Gemini Decision 1 dengan Model Generatif Tradisional
Gemini Decisions API dibuka pada 11 November 2026 melalui Gemini Developer API v1beta, dengan endpoint REST POST https://generativelanguage.googleapis.com/v1beta/decisions. Fungsi intinya adalah membuat keputusan probabilistik atas opsi yang sudah ditetapkan, lalu mengembalikan hasil keputusan, probabilitas setiap opsi, tingkat keyakinan, dan pemakaian Token. Inputnya mendukung teks, gambar, audio, video, dan PDF.
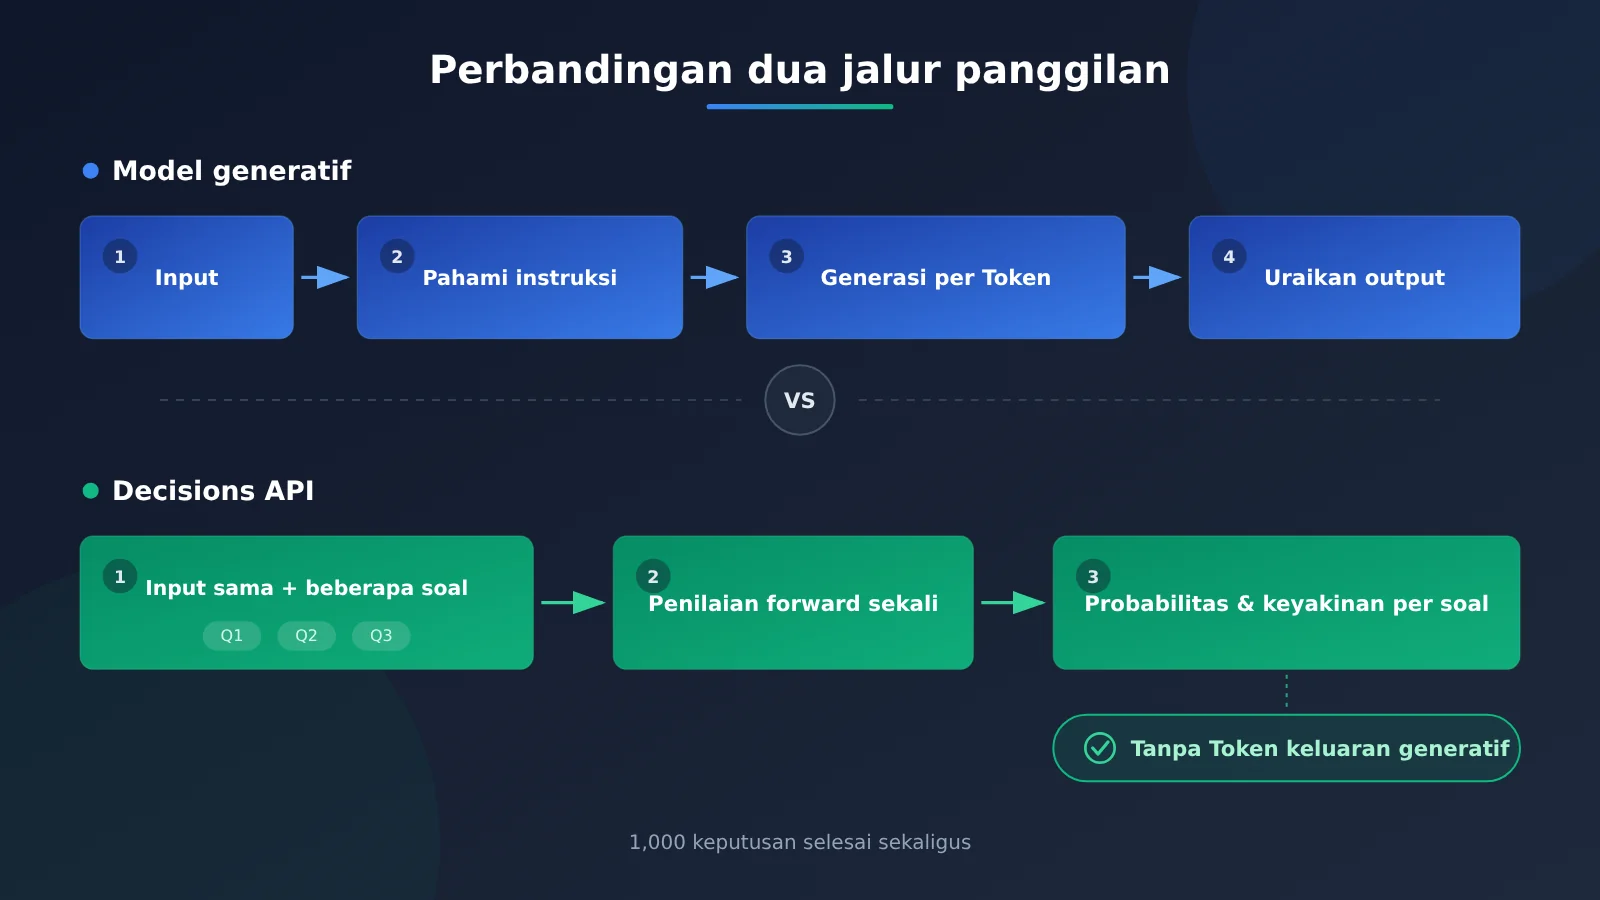
Alur model generatif tradisional saat menangani tugas klasifikasi adalah: membaca konten, memahami instruksi, lalu menghasilkan jawaban token demi token, dan pengembang masih harus mem-parsing jawaban itu. Decisions API mengubah alur tersebut menjadi membaca konten bersama, kemudian langsung memberi skor pada opsi yang sudah ditetapkan untuk setiap pertanyaan. Tugas seperti klasifikasi, moderasi, dan perutean hanya butuh satu label atau satu “ya/tidak”; jawaban panjang justru memakan biaya output dan memperlambat respons. Menghilangkan langkah ini adalah sumber penurunan biaya dan latensi.
1.2 Tiga Cara Keputusan di Decisions API dan Cakupan Tugasnya
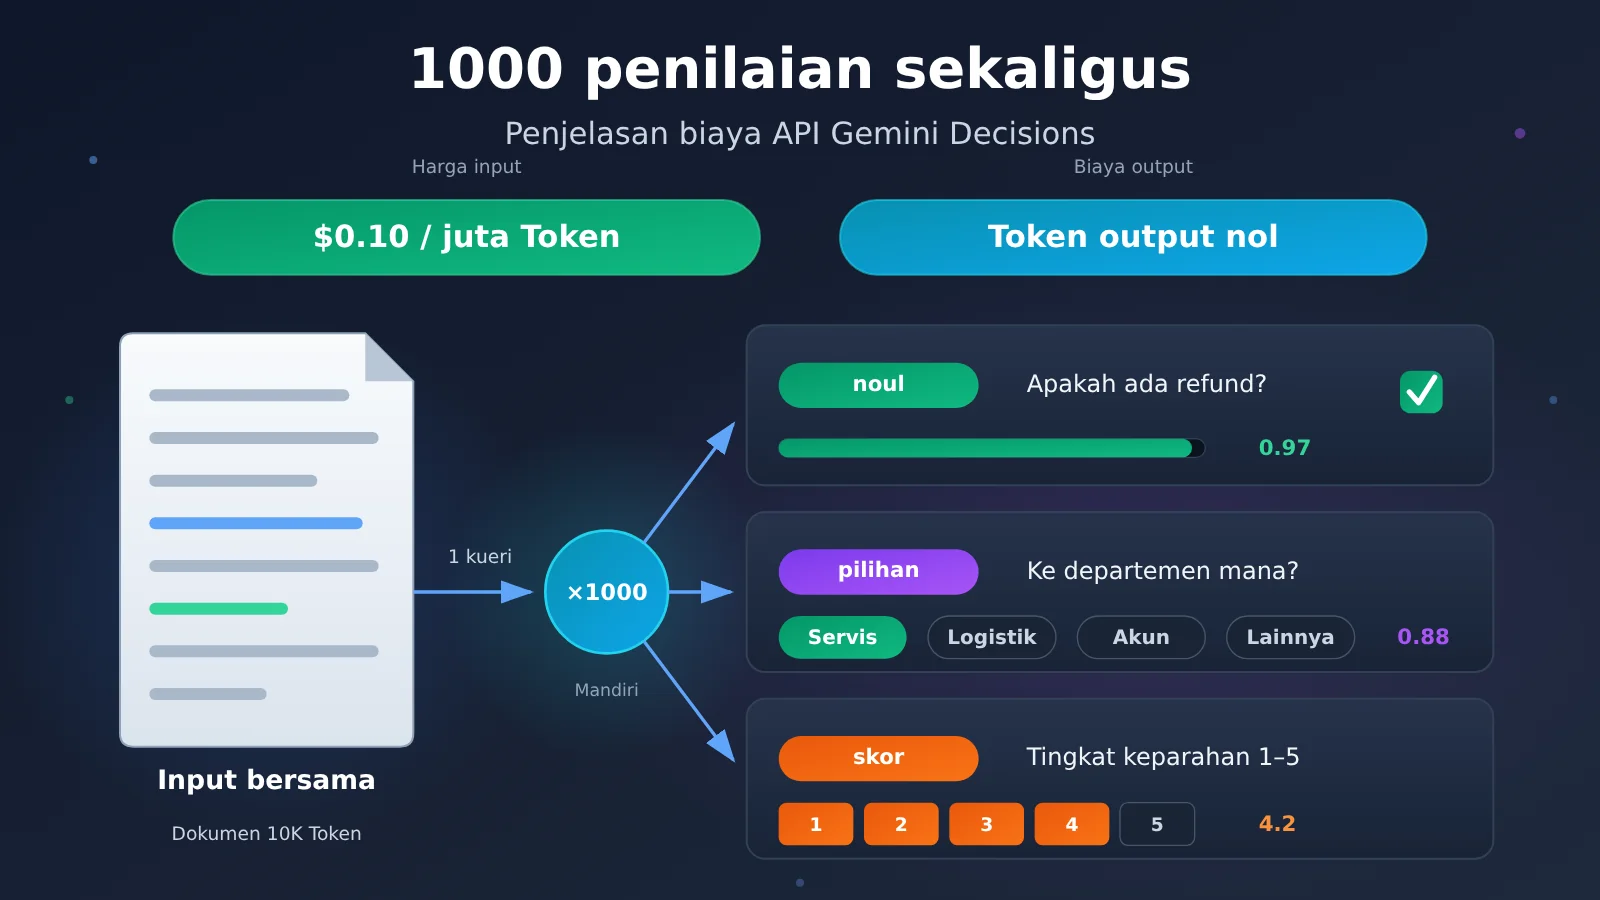
Ambil satu contoh pesan layanan pelanggan: “Headphone yang saya beli minggu lalu, sisi kiri tidak mengeluarkan suara. Saya sudah mengajukan pengembalian dana tiga hari lalu tapi belum ada yang menanggapi. Kalau tidak segera ditangani, saya akan melapor ke platform.” Untuk satu pesan ini, dalam permintaan yang sama kita bisa mengajukan tiga pertanyaan yang saling independen.
| Jenis keputusan | Contoh pertanyaan | Isi yang dikembalikan | Tugas tipikal |
|---|---|---|---|
| noul | Apakah pesan ini berkaitan dengan pengembalian dana? | Probabilitas “Yes”, misalnya 0.97 | Apakah melanggar aturan, apakah menyebut harga, apakah perlu eskalasi peninjauan |
| choice | Harus diteruskan ke departemen mana: purnajual / logistik / akun / lainnya? | Memilih “purnajual”, sekaligus probabilitas tiap opsi | Perutean tiket, klasifikasi artikel, pemilihan tool Agent |
| score | Seberapa berat keluhan ini pada skala 1–5? | Nilai ekspektasi berbobot yang dihitung dari probabilitas tiap level, misalnya 4.2 | Skor relevansi, tingkat keparahan, prioritas prospek |
choice mendukung 2–255 opsi, sedangkan score mendukung 2–255 level. Karena score mengembalikan nilai ekspektasi yang dihitung dari probabilitas tiap level, hasilnya bisa langsung dipakai untuk pengurutan atau penetapan ambang batas, tanpa perlu mengekstrak angka dari sebuah teks ulasan.
2 Berapa Banyak Biaya Google Decisions API yang Dapat Dihemat: Perhitungan untuk Tiga Skenario Bisnis
2.1 Mengapa Input Bersama Dapat Mengurangi Konsumsi Token
Struktur penagihan Decisions API memiliki tiga karakteristik: input bersama hanya ditagih sekali dalam satu permintaan, instruksi untuk setiap pertanyaan tetap ditagih sebagai token input, dan hasil keputusan tidak menghasilkan biaya output generatif. Sebagai pembanding, harga standar resmi Gemini 3.5 Flash-Lite adalah 0,30 dolar AS per juta token input dan 2,50 dolar AS per juta token output (harga resmi per 13 November 2026).
Misalkan S adalah jumlah token dari satu bagian input bersama, Q adalah jumlah pertanyaan independen terhadap input tersebut, Tq adalah rata-rata jumlah token per pertanyaan, To adalah rata-rata jumlah token output per pertanyaan dari model generatif, dan N adalah jumlah bagian input. Dengan asumsi sederhana bahwa “token input yang dapat ditagih pada kedua antarmuka sama”:
Biaya Decisions API  C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Biaya Flash-Lite     C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
Tingkat penghematan  = (1 − C_D / C_F) × 100%
Ini adalah model perhitungan untuk memahami mekanismenya; Google tidak memberikan tingkat penghematan yang tetap. Kedua antarmuka memiliki pengodean instruksi dan overhead formatnya masing-masing, sehingga biaya aktual mengacu pada token penagihan yang dikembalikan oleh masing-masing antarmuka.
2.2 Dari 1 penilaian menjadi 1,000 penilaian, bagaimana perubahan biayanya
Tabel berikut adalah contoh teoretis yang diturunkan dari harga publik, bukan hasil uji beban aktual. Pada Skenario ①, 1,000 penilaian semuanya ditujukan pada dokumen yang sama: 1,000 pertanyaan independen terhadap satu input, yang merupakan beban kerja sangat berbeda dari “1,000 dokumen masing-masing dianalisis satu kali”.
| Skenario bisnis | Asumsi utama | Decisions API | Flash-Lite | Penghematan teoretis |
|---|---|---|---|---|
| ① Satu dokumen memeriksa 1,000 aturan | Dokumen 10K Token, setiap aturan 20 Token, Flash-Lite menghasilkan 20 Token per aturan, keduanya digabungkan menjadi satu permintaan | $0.003 | $0.059 | 94.9% |
| ② 1,000 pesan masing-masing diklasifikasikan 1 kali | Setiap pesan 300 Token, instruksi penilaian 50 Token, output Flash-Lite 10 Token | $0.035 | $0.130 | 73.1% |
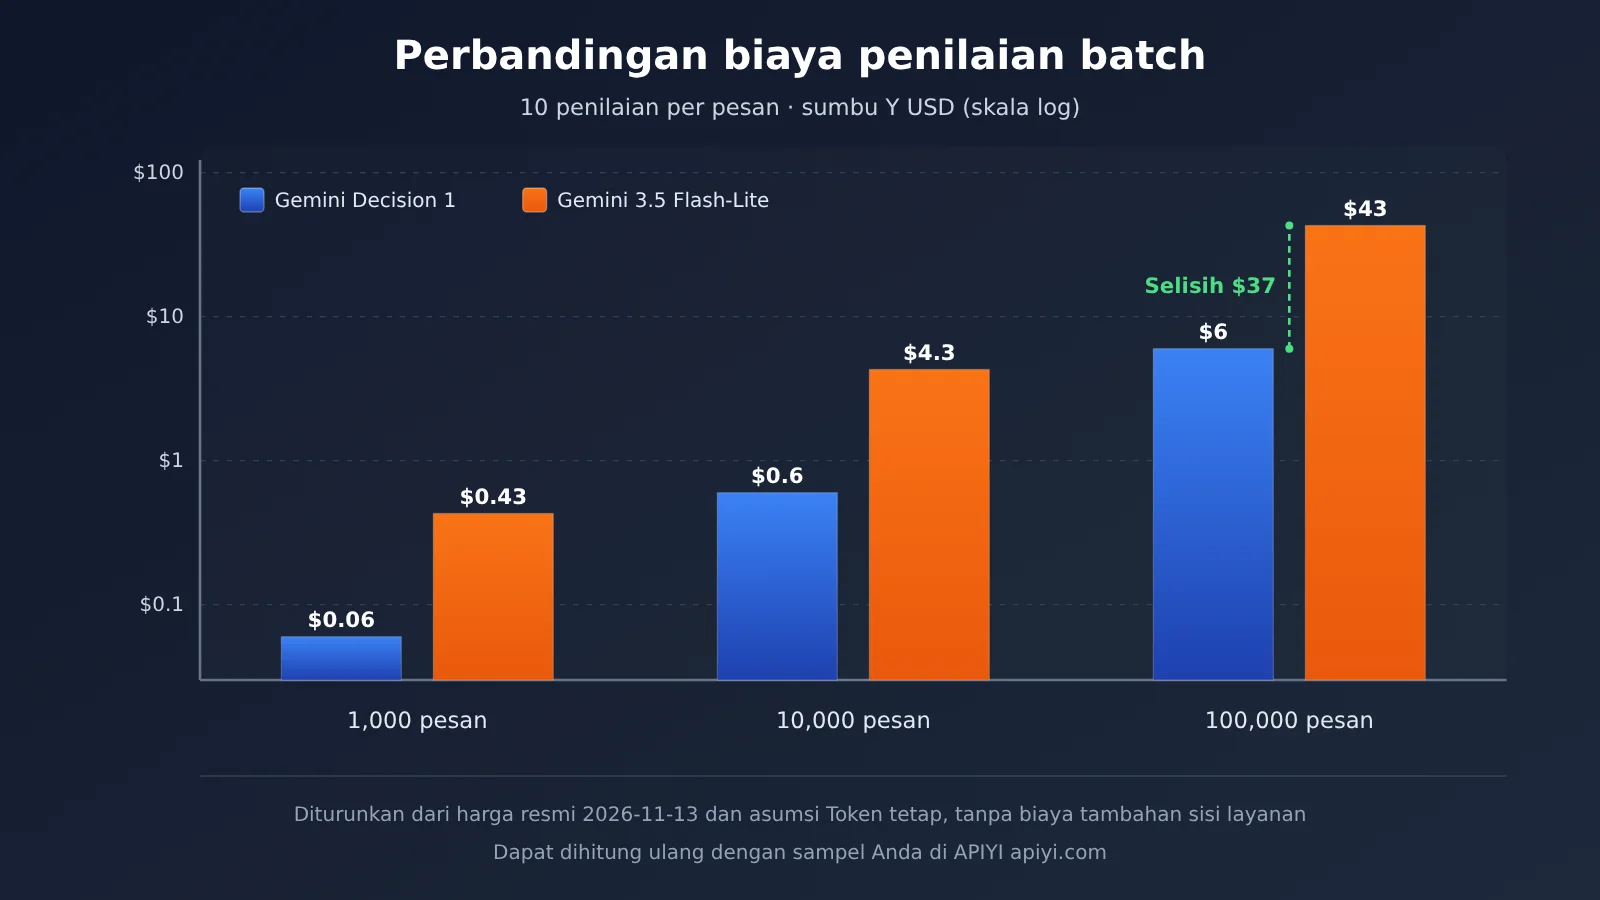
| ③ 1,000 pesan masing-masing menjalani 10 penilaian | Setiap pesan 300 Token, setiap penilaian 30 Token, Flash-Lite menghasilkan 10 Token per penilaian, satu permintaan per pesan | $0.060 | $0.430 | 86.0% |
Ketiga skenario menunjukkan dua hal. Pada Skenario ②, setiap permintaan hanya berisi satu pertanyaan, tetapi masih ada penghematan teoretis sebesar 73.1%; sumbernya adalah harga satuan input turun menjadi sepertiga dan biaya output menjadi nol. Penghematan pada Skenario ① dan ③ lebih tinggi karena input bersama dibagi ke banyak pertanyaan, sementara Flash-Lite harus menghasilkan output untuk setiap pertanyaan.
Dengan parameter Skenario ③ dan skala yang diperbesar: memproses 100,000 pesan dengan total 1,000,000 penilaian, biaya pemanggilan model Decisions API adalah 6 dolar, sedangkan Flash-Lite 43 dolar, selisih 37 dolar. Angka ini hanya mencakup biaya pemanggilan model, belum termasuk retry, peninjauan manusia setelah kesalahan penilaian, upgrade ke model yang lebih kuat, biaya transmisi dan penyimpanan, serta biaya perubahan teknis.
Jika ingin menghitung ulang dengan sampel bisnis Anda sendiri, Anda bisa menjalankan kumpulan data yang sama melalui model generatif terlebih dahulu, mencatat Token input dan output aktual, lalu memasukkannya ke rumus di atas. APIYI apiyi.com memungkinkan Anda memanggil Gemini, GPT, Claude, dan berbagai model generatif lain hanya dengan satu Key, sehingga lebih mudah membangun baseline biaya ini.
2.3 Mengapa “sekitar 5 kali lipat” dari Google bukan jawaban yang berlaku umum
Saat peluncuran, Google mengumumkan bahwa dalam pengujian resmi, biaya Decision 1 sekitar 1/4.7 dari Gemini 3.5 Flash-Lite. Penguji independen RanThis pada 12 November 2026 memberikan angka lain melalui pemanggilan API nyata: 100 pesan berbahasa Inggris dan 20 pesan berbahasa Vietnam, dengan setiap permintaan hanya melakukan satu penilaian biner.
- Akurasi: dari 100 penilaian berbahasa Inggris, Decision 1 menjawab benar 99, sedangkan Flash-Lite menjawab benar 98.
- Biaya: perkiraan biaya per seribu penilaian berbahasa Inggris masing-masing adalah $0.0113 dan $0.0166; Decision 1 sekitar 32% lebih murah, atau selisih sekitar 1,5 kali lipat.
- Latensi: median latensi per permintaan masing-masing adalah 0.18 detik dan 0.58 detik.
- Overhead Token: Decision 1 rata-rata ditagihkan sekitar 113 Token input per permintaan, sedangkan Flash-Lite sekitar 47 Token input ditambah 1 Token output.
Penyebab selisihnya jelas: overhead instruksi dan format dari antarmuka Decisions sendiri membuat Token input yang ditagih menjadi lebih dari dua kali lipat, sehingga meniadakan sebagian keunggulan harga satuan. Ketika input sangat pendek, setiap permintaan hanya menanyakan satu pertanyaan, dan model generatif hanya perlu menghasilkan satu Token, penghematannya paling kecil. Saat RanThis menggabungkan 10 pertanyaan dari email yang sama ke dalam satu permintaan Decision 1 dan membandingkannya dengan 10 permintaan Flash-Lite terpisah, selisihnya melebar menjadi sekitar 5.4 kali lipat; dalam perbandingan ini Flash-Lite tidak melakukan penggabungan yang sama, sehingga yang dibandingkan adalah metode permintaan yang berbeda.
Jadi, variabel yang memengaruhi penghematan aktual adalah: panjang input bersama, jumlah pertanyaan per input, panjang output model generatif, apakah kedua sisi sama-sama melakukan penggabungan permintaan, serta overhead tetap dari antarmuka itu sendiri. Turunan rumus, tolok ukur resmi, dan pengujian aktual pihak ketiga berasal dari kondisi yang berbeda, sehingga saat memilih model, masing-masing perlu dilihat secara terpisah.
3 Menyelesaikan 1,000 keputusan dalam sekali jalan, pekerjaan apa yang sebenarnya cocok untuk Decisions API?
3.1 Peninjauan dokumen: satu materi dicocokkan dengan banyak aturan
Yang paling bisa memanfaatkan keunggulan input bersama adalah “materi panjang + banyak aturan”. Sebuah kontrak, dokumen tender, atau manual produk perlu diperiksa satu per satu terhadap daftar periksa kepatuhan: apakah memuat klausul wanprestasi, apakah mengatur transfer data lintas batas, apakah siklus pembayaran melebihi 60 hari, apakah tidak memiliki tanggal penandatanganan, dan sebagainya. Semakin panjang materi dan semakin banyak aturan, semakin merata input bersama dibagi, dan penghematan teoretis 94.9% pada skenario ① adalah hasil dari struktur semacam ini.
Keunggulan lain dari jenis tugas ini adalah hasilnya bisa langsung dimasukkan ke tabel. Setiap aturan menghasilkan satu keputusan noul, yang mengembalikan probabilitas dan tingkat keyakinan; program dapat menandai berdasarkan ambang batas “lolos / tidak lolos / menunggu tinjauan”, dan peninjau hanya melihat item yang perlu ditinjau ulang.
3.2 Perutean Agent dan klasifikasi konten
Agent pada setiap langkah harus memutuskan tindakan berikutnya: apakah perlu mencari di web, apakah perlu menjalankan kode, apakah harus meneruskan ke alat lain. Keputusan semacam ini memiliki opsi tetap, pemanggilan sering, dan sensitif terhadap latensi, sehingga cocok diselesaikan sekaligus dengan choice. Penggunaan internal yang diungkap Google juga terpusat di sini: Gemini Notebook memakainya untuk memilih model dan tingkat pemikiran berdasarkan sifat pertanyaan, dengan latensi kueri biasa turun hingga 40%; Google Search memakainya untuk pemeriksaan keamanan alat MCP, mengidentifikasi konten adversarial; CC memilih reaksi dengan cepat dari lebih dari 200 kandidat Emoji. Ini adalah data Google sendiri; hasil nyata bagi pengembang eksternal bergantung pada beban masing-masing.
Alur kerja produksi konten adalah skenario perluasan lainnya. Setelah satu berita AI terkumpul, sistem perlu menilai apakah ini peristiwa baru, apakah relevan bagi pengembang, apakah menyangkut harga API, apakah ada sumber resmi, apakah cocok dijadikan tutorial, dan memberi skor nilai konten. Keenam kondisi ini saling independen dan dapat dimasukkan ke satu permintaan Decisions untuk menyelesaikan penyaringan; topik yang lolos penyaringan kemudian diserahkan ke model generatif untuk riset, penulisan, dan penyuntingan. Ini adalah contoh solusi yang dirancang berdasarkan kemampuan antarmuka. Tahap generasi di bagian akhir dapat beralih antar model sesuai kebutuhan melalui APIYI apiyi.com, serta membandingkan kualitas tulisan dan biaya.
3.3 Tiga batas untuk 1,000 pertanyaan
- Pertanyaan harus saling independen. Keputusan dalam permintaan yang sama tidak dapat membaca hasil satu sama lain. Alur yang memiliki dependensi berurutan seperti “pertama tentukan apakah ini keluhan, lalu klasifikasikan berdasarkan jenis keluhan” memerlukan program untuk menggabungkan hasil, dan bila perlu mengirim permintaan berikutnya.
- 1,000 pertanyaan berbagi jendela konteks 262,144 Token. Input bersama dan seluruh pertanyaan menggunakan jendela ini bersama-sama; semakin panjang instruksi untuk setiap pertanyaan, semakin pendek materi yang dapat dimuat.
- Data latensi rendah resmi hanya mencakup permintaan berskala kecil. Dalam pengujian Google, rentang latensi yang relatif stabil adalah 1–100 pertanyaan per permintaan dengan konteks di bawah 16K Token. Saat 1,000 pertanyaan disertai konteks yang mendekati kapasitas penuh, latensi perlu diukur sendiri.
4 Selain murah, apakah akurasi dan kecepatan Gemini Decisions API dapat memenuhi kebutuhan produksi?
4.1 Kecepatan yang dipublikasikan Google dan data aplikasi internal
Google mempublikasikan median waktu komputasi model sebesar 50–100 ms, dengan latency end-to-end 150–250 ms, pada kondisi pengujian 1–100 pertanyaan per permintaan dan konteks tidak melebihi 16K Token. Data ini menunjukkan bahwa model tersebut cocok ditempatkan dalam jalur real-time, misalnya untuk routing setiap langkah Agent atau penyortiran langsung pesan pengguna. Latency median 0.18 detik yang diukur RanThis pada soal tunggal juga berada di sekitar rentang tersebut.
4.2 Apa yang disampaikan pengujian pihak ketiga
Hasil awal Decision Index v2.1 dari Artificial Analysis, dihitung berdasarkan campuran skor mentah dan tugas aktual. Biaya dalam tabel di bawah adalah biaya campuran untuk tugas benchmark ini, yang merupakan ukuran berbeda dari “harga per juta Token”.
| Model keputusan | Skor keseluruhan | Waktu per tugas | Estimasi biaya per juta tugas | Tingkat akurasi penuh 15 item AA-Paperclip |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
Dua informasi patut diperhatikan. Pertama, harga satuan Token Gemini Decision 1 rendah, tetapi pada distribusi tugas ini, estimasi biaya per juta tugasnya lebih tinggi daripada Drex Max dan Jev, yang menunjukkan bahwa cara permintaan dan struktur tugas dapat mengubah ekonomi akhirnya. Kedua, dalam pengujian dokumen AA-Paperclip, proporsi dokumen di mana Decision 1 menyelesaikan semua 15 penilaian dalam satu kali dan semuanya benar adalah 33%. Menyelesaikan beberapa penilaian sekaligus menghemat biaya, namun akurasi setiap item tetap perlu diverifikasi secara terpisah.
4.3 Menggunakan tingkat keyakinan untuk mencegah kesalahan dieksekusi otomatis
Tingkat keyakinan adalah estimasi probabilitas model terhadap hasilnya sendiri, yang dapat digunakan untuk menentukan hasil mana yang dieksekusi otomatis dan mana yang diserahkan ke manusia. Saat peluncuran, disarankan menerapkan tiga praktik berikut:
- Tetapkan ambang batas keyakinan: misalnya, jika keyakinan penilaian refund di bawah 0.85, alihkan ke manusia; jika di atas ambang batas, baru otomatis beri label atau kirim tugas.
- Tambahkan opsi other untuk choice: ketika semua opsi tidak cocok, model tetap akan memilih salah satunya; menambahkan “lainnya / tidak dapat menentukan” dapat menahan sebagian input di luar batas, dan juga dapat menambahkan satu noul secara terpisah untuk pemeriksaan cakupan.
- Pertahankan batasan kode untuk operasi berisiko tinggi: tindakan seperti jumlah refund, pemblokiran akun, intersepsi kepatuhan, selain penilaian model juga harus memiliki aturan hardcode dan peninjauan manusia.
5 Bagaimana developer menggunakan dan memilih Gemini Decisions API?
5.1 Bagaimana cara mengirim permintaan pertama
Dokumentasi resmi mensyaratkan Python SDK google-genai versi 3.2 atau lebih baru; SDK JavaScript dan REST juga didukung. Untuk mengaksesnya, Anda memerlukan kunci API dari Google AI Studio. Contoh di bawah ini disusun berdasarkan struktur SDK resmi. Untuk berita yang sama, contoh ini sekaligus membuat satu penilaian biner dan satu penilaian klasifikasi. Contoh belum benar-benar dipanggil dan diverifikasi dalam artikel ini, jadi untuk nama field, ikuti panduan developer resmi.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input: input bersama yang dipakai semua pertanyaan, hanya ditagih sekali
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions: penilaian yang saling independen, nama kunci adalah ID pertanyaan
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # hasil penilaian tiap pertanyaan, probabilitas tiap opsi, dan tingkat keyakinan
print(result.usage)    # penggunaan Token yang ditagih, dasar perhitungan biaya
Empat field kunci berfungsi sebagai berikut: input menyimpan konten bersama, questions menyimpan pertanyaan independen (untuk cara penulisan definisi level pada tipe score, lihat panduan resmi), answers membaca hasil penilaian dan probabilitas, sedangkan usage membaca Token yang ditagih. Saat menghitung biaya, pastikan memakai nilai aktual dari usage; bagian 2.3 sudah menjelaskan bahwa biaya tetap antarmuka akan berpengaruh signifikan terhadap biaya per pertanyaan.
Untuk membandingkan biaya, kita juga memerlukan baseline dari model generatif. Berikut ini kita memakai antarmuka kompatibel OpenAI melalui APIYI untuk memanggil Flash-Lite, melakukan klasifikasi yang sama, dan mencatat penggunaan Token:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # antarmuka kompatibel OpenAI APIYI
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # gunakan nama aktual dalam daftar model platform
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Token input dan output, untuk dimasukkan ke rumus bagian 2.1
Lihat skrip perbandingan batch: hitung biaya kedua antarmuka secara terpisah untuk kumpulan sampel yang sama
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # harga standar resmi Flash-Lite, USD/juta Token
DECISION_IN = 0.10                 # harga input Decision 1, output tidak ditagih

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """Gabungkan seluruh pertanyaan untuk setiap sampel menjadi satu permintaan generatif, lalu akumulasikan biaya penagihan aktual"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Masukkan daftar Token input usage yang dikembalikan setiap panggilan Decisions API, lalu hitung total biaya"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 Saran untuk memulai cepat: Pilih dulu 200–500 sampel bisnis nyata, jalankan dengan model generatif untuk memperoleh akurasi baseline dan jumlah Token yang terpakai, lalu bandingkan dengan
usagedari Decisions API. APIYI apiyi.com menyediakan antarmuka kompatibel OpenAI dan kuota uji coba gratis untuk pengguna baru, cocok untuk menyelesaikan pengujian baseline ini dengan cepat.
5.2 Kapan memilih Decisions API, dan kapan tetap memakai model generatif
| Jenis tugas | Rekomendasi | Alasan |
|---|---|---|
| Mengaudit satu dokumen panjang terhadap banyak aturan sekaligus | Decisions API | Input dibagikan sehingga biaya menipis, penilaian saling independen |
| Routing alat Agent, pemilihan model | Decisions API | Opsinya tetap, latensi rendah |
| Pemeriksaan keamanan konten dan pelanggaran | Decisions API | Beberapa kondisi noul yang independen, bisa dipilah berdasarkan tingkat keyakinan |
| Klasifikasi tiket layanan pelanggan, label purna jual e-commerce | Decisions API | Kumpulan label tetap |
| Penyaringan topik, penilaian prioritas prospek | Decisions API | Cocok untuk score dengan skala yang sudah ditetapkan |
| Ringkasan, penulisan ulang, penulisan | Model generatif | Perlu output bahasa alami |
| Riset kompleks, argumentasi, mengajukan pandangan baru | Model generatif | Perlu penalaran terbuka |
| Alur yang penilaiannya saling bergantung secara berurutan | Orkestrasi program + beberapa permintaan, atau model generatif | Pertanyaan dalam satu permintaan yang sama tidak bisa saling merujuk |
Output terstruktur model generatif (JSON Schema) juga bisa mengunci jawaban ke format tetap, tetapi ia tetap menghasilkan konten Token demi Token dan menagih berdasarkan output, serta probabilitasnya butuh penanganan tambahan agar bisa didapatkan. Decisions API langsung mengembalikan probabilitas dan tingkat keyakinan tiap opsi, outputnya tidak ditagih, dengan konsekuensi hanya bisa menjawab pertanyaan yang pilihan jawabannya sudah dibatasi sebelumnya.
5.3 Biaya apa lagi yang perlu dihitung sebelum peluncuran
Selain harga satuan, beberapa hal berikut secara langsung memengaruhi “total biaya per keputusan yang benar”:
- Biaya Token aktual: mengacu pada
usage; pada skenario input pendek dengan satu pertanyaan, proporsi biaya tetap paling tinggi. - Batas permintaan: tingkat gratis adalah 200 RPM, 50.000 TPM, 10.000 RPD; Tier 1 berbayar adalah 1.500 RPM, 1 juta TPM, 50.000 RPD. Permintaan dengan konteks panjang sering kali lebih dulu memicu batas TPM.
- Tidak adanya cache dan pemrosesan batch: tidak mendukung Context Caching, Batch API, maupun inferensi Flex/Priority; saat dokumen panjang yang sama digunakan berulang kali, diskon cache tidak bisa dimanfaatkan.
- Batasan fungsional: instruksi pertanyaan tidak boleh memuat konten media, dan tidak bisa langsung memasukkan riwayat percakapan lengkap, blok pemikiran, atau blok pemanggilan alat; percakapan multi-giliran harus dirapikan dulu menjadi input teks.
- Kesalahan penilaian dan peninjauan manual: proporsi keyakinan rendah yang dialihkan ke manusia serta biaya pengerjaan ulang setelah kesalahan penilaian perlu dimasukkan ke biaya per unit.
- Ketentuan pemrosesan data: data penggunaan tingkat gratis mungkin digunakan untuk peningkatan produk Google; tabel harga resmi menunjukkan tingkat berbayar tidak digunakan untuk tujuan ini. Sebelum memproses dokumen pelanggan, pastikan tingkat yang digunakan.
- Perubahan rekayasa: menulis ulang petunjuk generatif menjadi pertanyaan
noul / choice / score, menetapkan ambang batas, dan membangun logika fallback semuanya memerlukan investasi pengembangan.
Jika berencana mengakses melalui platform API pihak ketiga, Anda perlu memastikan apakah platform tersebut mendukung endpoint khusus /v1beta/decisions; platform yang hanya mendukung Chat Completions tidak dapat memanggil Decisions API secara langsung. Sebelum menggunakan APIYI apiyi.com, Anda dapat terlebih dahulu memeriksa daftar model dan endpoint di pusat dokumentasi, atau menghubungi platform untuk memastikan dukungannya.
6 Kesimpulan: Tugas klasifikasi, moderasi, dan routing bisa diserahkan ke Gemini Decisions API
Kembali ke pertanyaan di judul, ada tiga kesimpulan:
- Tugas dengan opsi tetap layak memprioritaskan Decisions API. Berdasarkan harga publik, penghematan teoretis untuk klasifikasi satu pertanyaan sekitar 73%, sedangkan untuk moderasi seribu aturan pada satu dokumen panjang yang sama penghematan teoretisnya sekitar 95%; keunggulan dari pengujian aktual pihak ketiga untuk satu pertanyaan sekitar 32%.
- Struktur “satu input, banyak pertanyaan independen” adalah yang paling berpotensi menekan biaya. Input yang dibagi hanya ditagih sekali; semakin banyak pertanyaan, semakin panjang input, dan semakin panjang output model generatif, semakin besar selisihnya.
- Ukuran akhirnya adalah total biaya per keputusan yang benar di lingkungan produksi. Harga satuan token dan batas 1.000 pertanyaan hanyalah titik awal; akurasi, proporsi penanganan manual setelah pemisahan berdasarkan tingkat keyakinan, kuota, dan biaya rekayasa bersama-sama menentukan keuntungan nyata.
Jalur yang cukup aman adalah: jalankan dulu baseline model generatif dengan sampel nyata, lalu bandingkan usage dan akurasi di Decisions API, serta rancang lapisan keputusan terpisah dari lapisan generasi. Untuk pemilihan model dan perbandingan biaya di lapisan generasi, semuanya bisa dilakukan lewat APIYI apiyi.com dengan antarmuka terpadu.
📚 Referensi
- Panduan developer dan tabel harga Google Gemini Decisions API: kemampuan antarmuka, batasan, kuota, dan harga resmi
- Tautan:
ai.google.dev -
Keterangan: ID model, jenis pertanyaan, jendela konteks, batas laju, dan cara pakai SDK
-
Artikel blog resmi Google: tanggal rilis, data latensi, dan studi kasus penggunaan internal
- Tautan:
blog.google -
Keterangan: waktu komputasi 50–100 ms, keunggulan biaya sekitar 4,7 kali, serta studi kasus seperti Gemini Notebook
-
Endpoint REST Gemini Decisions API
- Tautan:
generativelanguage.googleapis.com/v1beta/decisions -
Keterangan: endpoint resmi untuk pemanggilan via REST
-
Artificial Analysis Decision Index v2.1: evaluasi model keputusan pihak ketiga
- Tautan:
artificialanalysis.ai -
Keterangan: skor komprehensif, waktu pengerjaan tugas, biaya per juta tugas, dan tingkat benar penuh AA-Paperclip
-
Pengujian independen RanThis (2026-11-12): pengujian skala kecil berbasis pemanggilan nyata
- Keterangan: perbandingan biaya per pertanyaan, latensi, dan pengeluaran token, serta hasil dari permintaan gabungan beberapa pertanyaan
Penulis: Tim Teknis APIYI
Kontak teknis: Silakan hubungi kami di beranda APIYI apiyi.com, materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com