Catatan penulis: Artikel ini merangkum daftar periksa mandiri dan templat petunjuk sebelum menggabungkan PR, dengan berlandaskan gagasan Addy Osmani tentang “penyerahan kognitif” dan “utang pemahaman”. Kita juga akan membandingkannya dengan pendekatan peninjauan LobeHub yang mengandalkan laporan penerimaan, agar kamu bisa menentukan tingkat peninjauan sesuai risikonya.
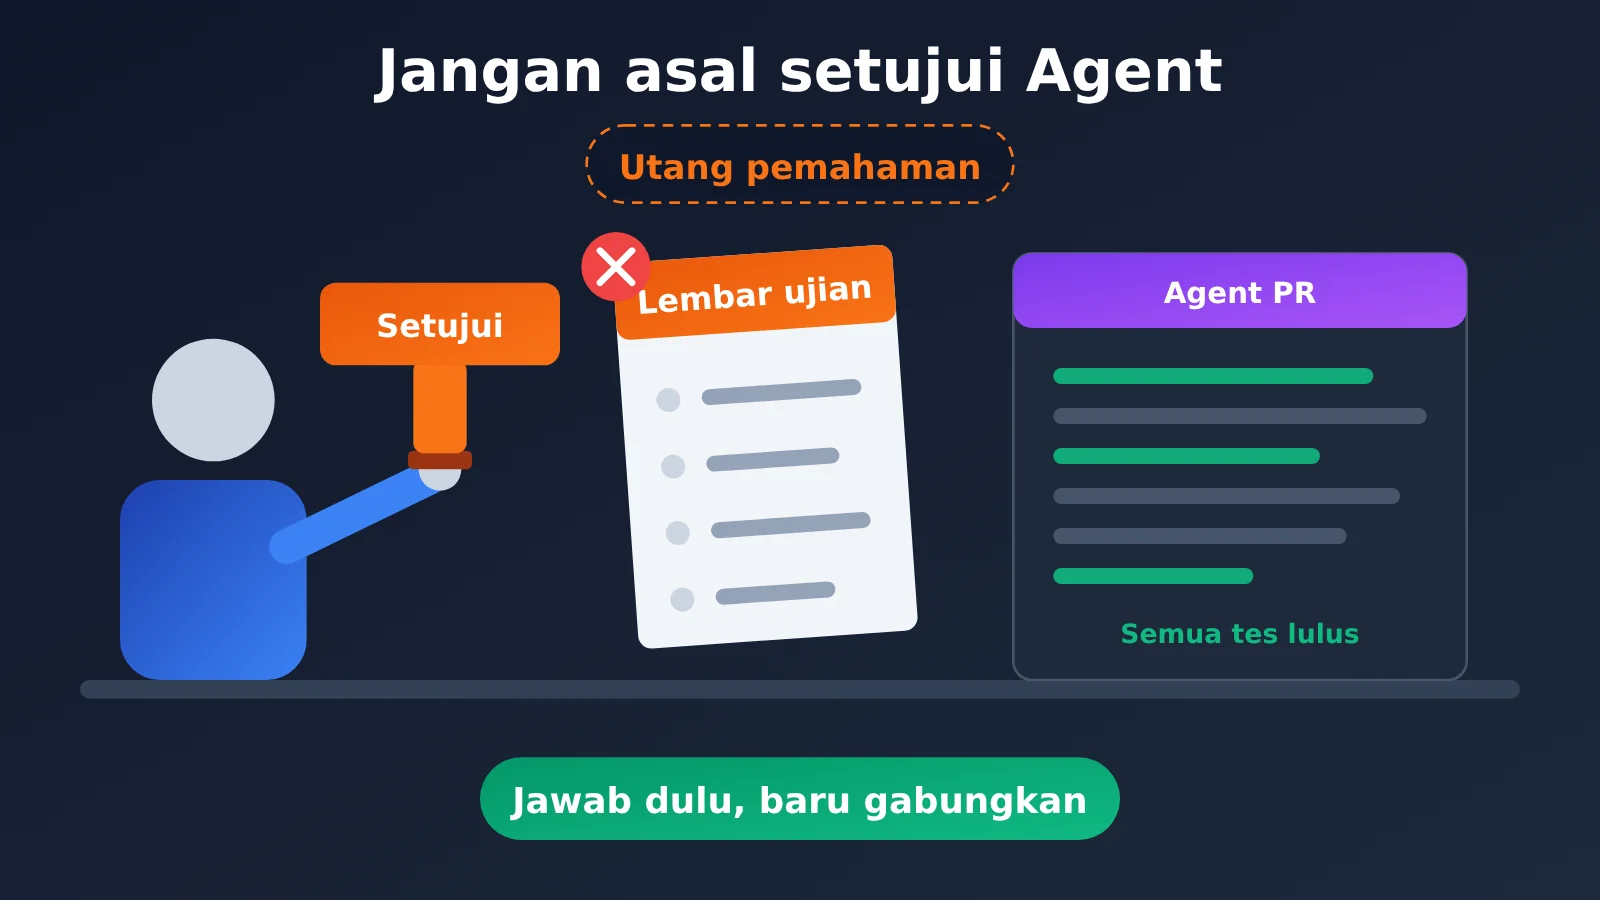
Kalau kamu setiap hari menggunakan Claude Code, Cursor, atau Cline untuk menghasilkan kode, mungkin kamu pernah mengalami ini: dalam beberapa menit, Agent menghasilkan PR sepanjang ratusan baris dengan penamaan yang konsisten, struktur yang jelas, dan semua tes lolos. Kamu pun mengeklik “Setujui”. Beberapa minggu kemudian, seseorang bertanya mengapa logikanya ditulis seperti itu, tetapi kamu tidak bisa menjawab. Artikel ini membahas langkah pemeriksaan yang bisa langsung dilakukan, seperti “meminta AI menguji pemahamanmu”, agar kamu tetap bertanggung jawab atas setiap perubahan yang kamu setujui tanpa harus meninjau setiap baris.
Ini bukan artikel yang mengajakmu kembali menulis kode secara manual. Engineer Claude Code, Addy Osmani, sendiri menegaskan bahwa tidak ada yang meminta engineer menghafal seluruh basis kode. Masalahnya bukan apakah kamu membaca setiap baris, melainkan apakah kamu tahu apa yang kamu pahami dan apa yang belum.
Manfaat utama: Setelah membaca artikel ini, kamu akan memahami peralihan dari “mendelegasikan beban kognitif”, “menyerahkan penilaian”, hingga “penyerahan kognitif”. Kamu juga akan mendapatkan daftar pertanyaan dan templat petunjuk yang bisa langsung disalin sebelum menggabungkan PR, serta belajar memilih tingkat peninjauan berdasarkan risiko perubahan.
Jangan Asal Menyetujui Hasil Agent: Pokok-Pokok Utang Pemahaman
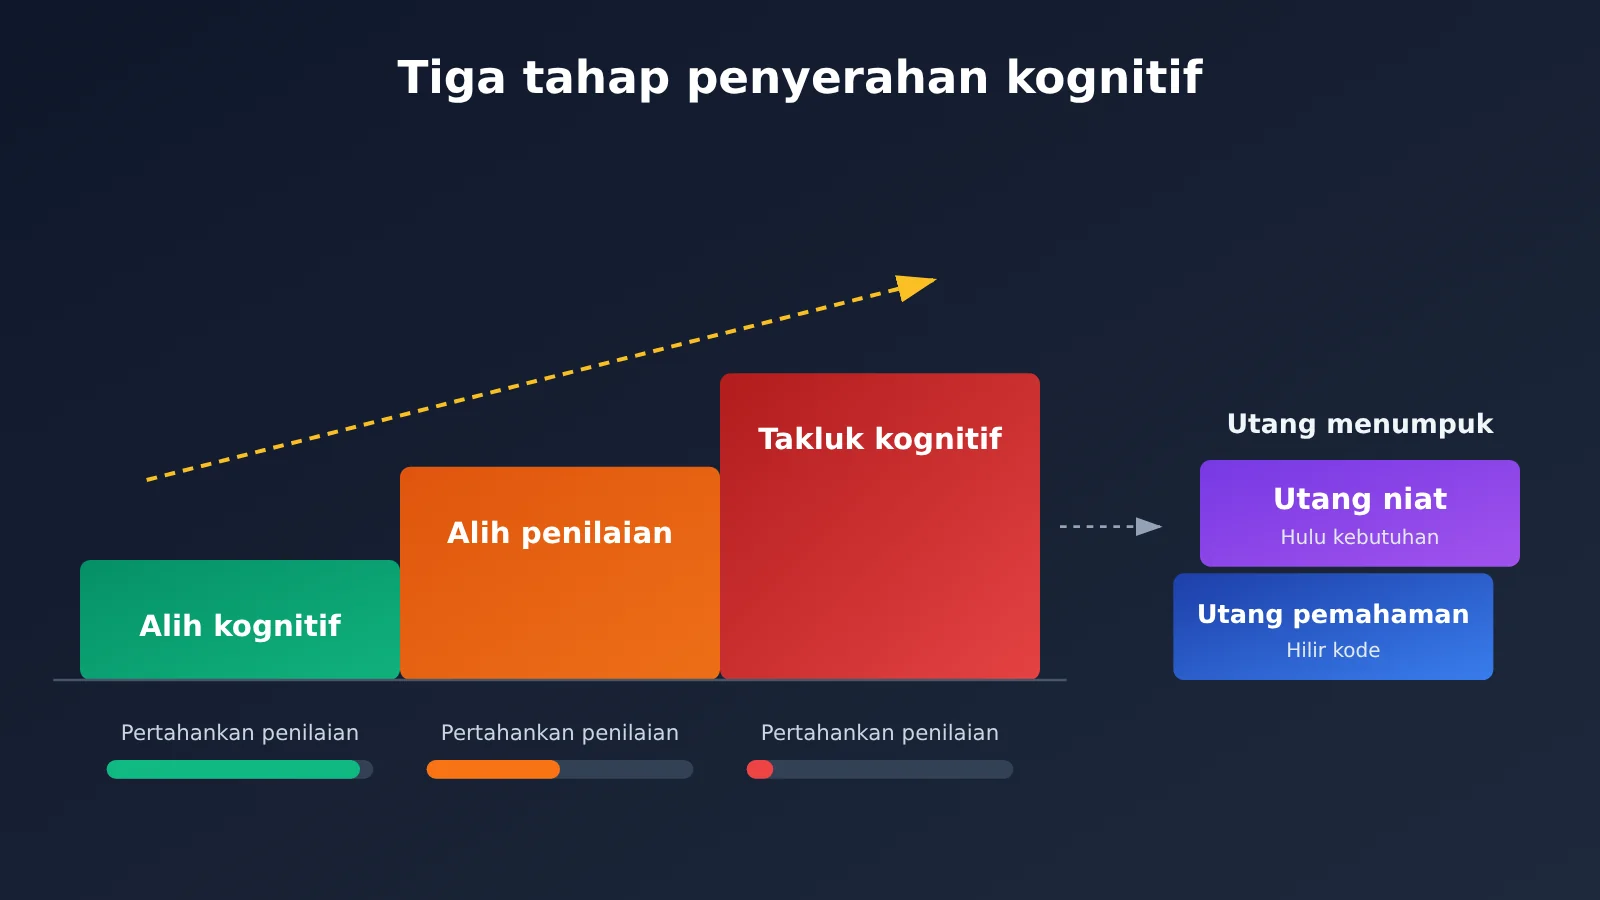
Menurut laporan QbitAI yang dimuat ulang oleh 36Kr, Addy Osmani, mantan insinyur Google yang kini terlibat dalam Claude Code, membahas masalah yang mengusik: semakin andal hasil buatan AI, semakin jarang manusia memeriksanya dengan saksama. Ia membagi proses ini menjadi beberapa tahap dan mengemukakan dua jenis “utang” baru. Perlu dicatat, konsep-konsep berikut berasal dari pemberitaan media; untuk istilah persisnya, silakan merujuk pada tulisan asli Addy.
| Konsep | Makna | Contoh umum |
|---|---|---|
| Pelimpahan kognitif | Menyerahkan pekerjaan tertentu kepada AI, tetapi tetap memahami tugas dan mampu menilai hasilnya | Meminta Agent menulis kode boilerplate, sementara kamu paham apa yang dilakukannya |
| Penyerahan penilaian | Jawaban AI perlahan menjadi dasar default untuk langkah berikutnya | Pada kesempatan berikutnya, kamu hanya memeriksa sekilas dan langsung mengikuti apa pun yang dikatakan Agent |
| Penyerahan kognitif | Bahkan penilaian yang seharusnya dilakukan sendiri pun diserahkan | “Apa kata AI pasti masuk akal”, lalu langsung menggabungkan kode karena semua tes lulus |
| Utang pemahaman | Kompleksitas kode dan sistem bertambah, tetapi pemahaman pengembang tidak mengimbanginya | Saat fitur perlu diubah, tidak ada yang benar-benar memahami struktur internalnya |
| Utang maksud | Tujuan, batasan, dan kompromi yang tidak dijelaskan dalam kebutuhan diputuskan oleh AI untukmu | Kamu sendiri belum jelas menginginkan apa, tetapi Agent sudah menyerahkan hasil yang tampak meyakinkan |
Bagaimana penyerahan kognitif dan utang pemahaman berkembang
Penyerahan kognitif tidak terjadi dalam semalam. Awalnya, kamu hanya “melimpahkan” pekerjaan tertentu. Itu sendiri tidak masalah, seperti menggunakan compiler alih-alih menulis assembly sendiri. Bahayanya muncul pada tahap kedua: setelah keluaran Agent beberapa kali terbukti andal, kesimpulannya diam-diam menjadi asumsi default dan kamu mulai melewatkan verifikasi. Pada tahap ketiga, tombol “setujui” berubah menjadi sekadar stempel; peranmu bergeser dari insinyur menjadi pemberi stempel.
Addy pernah memberikan contoh yang menggambarkan hal ini: Agent menyerahkan 600 baris kode sekaligus, dengan struktur yang rapi dan tes yang lulus, lalu pengembang menggabungkannya tanpa khawatir. Namun, Agent mungkin mengubah urutan pemrosesan transaksi di bagian yang luput dari perhatian, atau menyesuaikan suatu kondisi batas. Perubahan ini tidak langsung menimbulkan kesalahan. Baru ketika sistem benar-benar bermasalah, pengembang sadar bahwa ia tidak bisa menjelaskan mengapa kode berjalan seperti itu. Inilah “bunga” dari utang pemahaman, yang selalu jatuh tempo pada saat yang paling tidak tepat.
Utang maksud muncul lebih awal lagi. Agent saat ini sangat mahir melengkapi kebutuhan. Sekalipun kamu belum memikirkannya dengan matang, Agent bisa menghasilkan sesuatu yang tampak masuk akal. Masalahnya, tujuan, cakupan, dan kompromi yang belum kamu jelaskan sudah diam-diam diputuskan oleh AI. Utang maksud dan utang pemahaman sering muncul bersamaan: kamu tidak jelas tentang apa yang awalnya kamu inginkan, sekaligus tidak paham apa yang akhirnya dikerjakan Agent.
6 cara melunasi utang pemahaman
Dalam artikel panjangnya, Addy membagikan banyak saran praktis. Berikut rangkumannya dalam 6 metode, beserta jenis utang yang ditangani dan kapan menggunakannya dalam alur kerja.
| Metode | Waktu penggunaan | Utang utama yang ditangani | Langkah singkat |
|---|---|---|---|
| 1. Minta Agent menguji pemahamanmu | Setelah perubahan besar selesai, sebelum digabungkan | Utang pemahaman | Minta rangkuman perubahan dan alasannya, lalu jawab semua pertanyaan dengan benar sebelum menggabungkan |
| 2. Tulis daftar kebutuhan sebelum mulai | Sebelum menulis petunjuk | Utang niat | Jelaskan siapa penggunanya, masalah yang diselesaikan, apa yang tidak dikerjakan, dan kriteria penyelesaiannya |
| 3. Tanyakan keputusan yang tidak diizinkan | Saat tugas panjang selesai | Utang pemahaman, utang niat | Tanyakan keputusan apa yang dibuat tanpa izinmu dan asumsi apa yang digunakan |
| 4. Tanyakan apa yang belum diuji | Saat meninjau hasil pengujian | Utang pemahaman | Lihat pengujian yang benar-benar dijalankan dan hasilnya sebelum membaca rangkuman AI |
| 5. Simpan materi asli | Saat beberapa Agent bekerja secara paralel | Utang pemahaman | Simpan materi asli dan bukti verifikasi untuk tugas penting; kurangi pekerjaan paralel jika tak sanggup meninjaunya |
| 6. Berlatih secara offline secara rutin | Setiap minggu dan bulan | Penurunan kemampuan | Lakukan coding tanpa Agent sekali seminggu dan tinjau keterampilan apa saja yang diserahkan ke Agent setiap bulan |
Minta AI menguji pemahamanmu: pemeriksaan utang pemahaman yang paling penting
Ini cara paling menarik dari seluruh metode tersebut. Setelah Agent menyelesaikan perubahan besar, jangan langsung menyetujuinya. Minta Agent berperan sebagai penguji: rangkum bagian yang diubah dan alasannya, lalu buat beberapa pertanyaan berdasarkan perubahan tersebut. Tetapkan aturan bahwa perubahan baru boleh digabungkan jika semua pertanyaan dijawab dengan benar.
Nilainya ada pada perubahan dari perasaan samar seperti “sepertinya saya sudah paham” menjadi hasil yang bisa diuji. Pertanyaan yang tidak bisa kamu jawab menunjukkan bagian spesifik yang masih menjadi utang pemahamanmu.
Tanyakan keputusan yang tidak diizinkan dan apa yang belum diuji
Dalam tugas yang berjalan lama, Agent bisa memilih parameter default, mengubah cakupan implementasi, bahkan menentukan prioritas saat ada kebutuhan yang saling bertentangan. Keputusan ini belum tentu masuk ke rangkuman akhir karena dianggap “terlalu wajar”. Jadi, alih-alih hanya bertanya “sudah selesai?”, lebih efektif untuk bertanya: keputusan apa yang kamu buat tanpa izin eksplisit saya? Bagian mana yang bergantung pada asumsi kamu sendiri? Apa yang belum diverifikasi? Perubahan mana yang mungkin memengaruhi fungsi lain?
Hal yang sama berlaku untuk pengujian. Addy mengingatkan bahwa hasil pengujian yang hijau hanya membuktikan bahwa kondisi yang tercakup dalam pengujian berhasil lolos. Jika kasus batas tidak dimasukkan, laporannya tetap bisa terlihat bagus. Urutan yang tepat adalah memeriksa pengujian yang benar-benar dijalankan dan hasilnya terlebih dahulu, baru membaca rangkuman buatan AI. Untuk perubahan berisiko tinggi, kamu juga bisa meminta Agent lain mencari masalah secara independen dari sudut pandang berbeda.
Panduan cepat pemeriksaan sebelum merge: 5 langkah agar tidak asal menyetujui hasil Agent
Gabungkan cara-cara di atas menjadi satu alur yang bisa dijalankan sebelum setiap PR di-merge. Kamu tidak perlu memeriksa setiap baris, tetapi setiap langkah harus menunjukkan bahwa kamu benar-benar memikirkan hasilnya.
- Tulis ekspektasi sebelum mulai: Jelaskan kebutuhan dan hasil yang kamu harapkan dengan kata-katamu sendiri. Jika setelah dua kali menyesuaikan petunjuk hasilnya masih belum memuaskan, tinjau kembali kebutuhannya alih-alih terus menambah petunjuk.
- Minta penjelasan keputusan: Setelah tugas selesai, minta Agent mencantumkan keputusan yang tidak kamu izinkan secara eksplisit, asumsi, dan hal-hal yang belum diverifikasi.
- Periksa pengujian yang benar-benar dijalankan: Lihat perintah pengujian dan output yang sebenarnya, lalu tanyakan kondisi batas apa saja yang belum tercakup.
- Minta Agent membuat soal: Minta soal berdasarkan diff untuk menguji pemahamanmu. Jika ada jawaban yang salah, kembali baca bagian kodenya sampai jelas.
- Cari satu hal yang terlewat: Setelah Agent menyerahkan hasilnya, cari secara aktif setidaknya satu hal yang mungkin belum diperiksanya.
Contoh petunjuk sederhana untuk memeriksa utang pemahaman
Berikut petunjuk “buatkan soal untuk saya” yang paling umum digunakan. Kamu bisa langsung menempelkannya di percakapan Claude Code, Cursor, atau Cline:
在我合并这次改动之前,请先做两件事:
1. 用不超过 10 条要点总结本次改了哪些文件、每处改动的原因。
2. 根据本次 diff 给我出 5 道题,重点覆盖:事务/调用顺序、
   边界条件、错误处理、对其他模块的影响。
   先只给题目,等我作答后再批改,并指出我答错的地方对应哪段代码。
规则:我没有全部答对之前,不要建议合并。
Lihat templat lengkap petunjuk sebelum merge
# 阶段 A:开工前(偿还意图债,由我先填写)
需求说明:
- 面向谁:
- 要解决的问题:
- 明确不做的事:
- 完成标准(做到什么程度算完成):
- 我预期的改动范围和结果:

# 阶段 B:任务结束后(请 Agent 逐条回答)
1. 你做了哪些我没有明确授权的决定?请列出决定内容和理由。
2. 哪些地方依赖了你自己的假设?假设不成立时会发生什么?
3. 还有哪些内容没有验证?
4. 哪些改动可能影响其他功能或模块?
5. 你实际运行了哪些测试命令?请贴出原始输出,而不是总结。
6. 哪些边界情况没有写进测试?

# 阶段 C:出题考核(偿还理解债)
请根据本次 diff 出 5 道题,先只给题目。
我作答后请批改,答错的题请定位到具体代码行。
我未全部答对前,不要建议合并。

# 阶段 D:高风险改动追加(可交给另一个独立会话)
请你作为独立审查者,不参考上一个会话的总结,
只基于原始需求和 diff,找出最可能出问题的 3 个地方。
🎯 Saran penggunaan: Pastikan kamu mengisi tahap A sendiri sebelum mulai, bukan meminta Agent melakukannya. Untuk tahap D, sebaiknya buka sesi baru agar peninjau independen tidak terpengaruh oleh rangkuman Agent sebelumnya. Ini juga sejalan dengan pengingat Addy tentang informasi yang bisa hilang saat diteruskan antar-Agent.
Daftar pertanyaan sebelum merge
| Tahap | Pertanyaan wajib | Tanda belum layak |
|---|---|---|
| Sebelum mulai | Bisakah saya menjelaskan kebutuhan dan kriteria penyelesaian dengan kata-kata sendiri? | Tidak bisa menuliskan apa yang “tidak akan dikerjakan” |
| Setelah penyerahan | Keputusan apa yang dibuat Agent tanpa izin? | Menjawab “tidak ada”, padahal diff jelas melampaui cakupan |
| Pengujian | Pengujian apa yang benar-benar dijalankan? Apa yang belum diuji? | Hanya ada ringkasan, tanpa output asli |
| Evaluasi | Bisakah saya menjawab semua soal dengan benar? | Salah menjawab soal tentang urutan transaksi atau kondisi batas |
| Penutup | Bisakah saya menemukan satu hal yang luput diperiksa? | Tidak terpikir satu pun |
AI membuat soal untuk menguji Anda vs. peninjauan berbasis laporan penerimaan
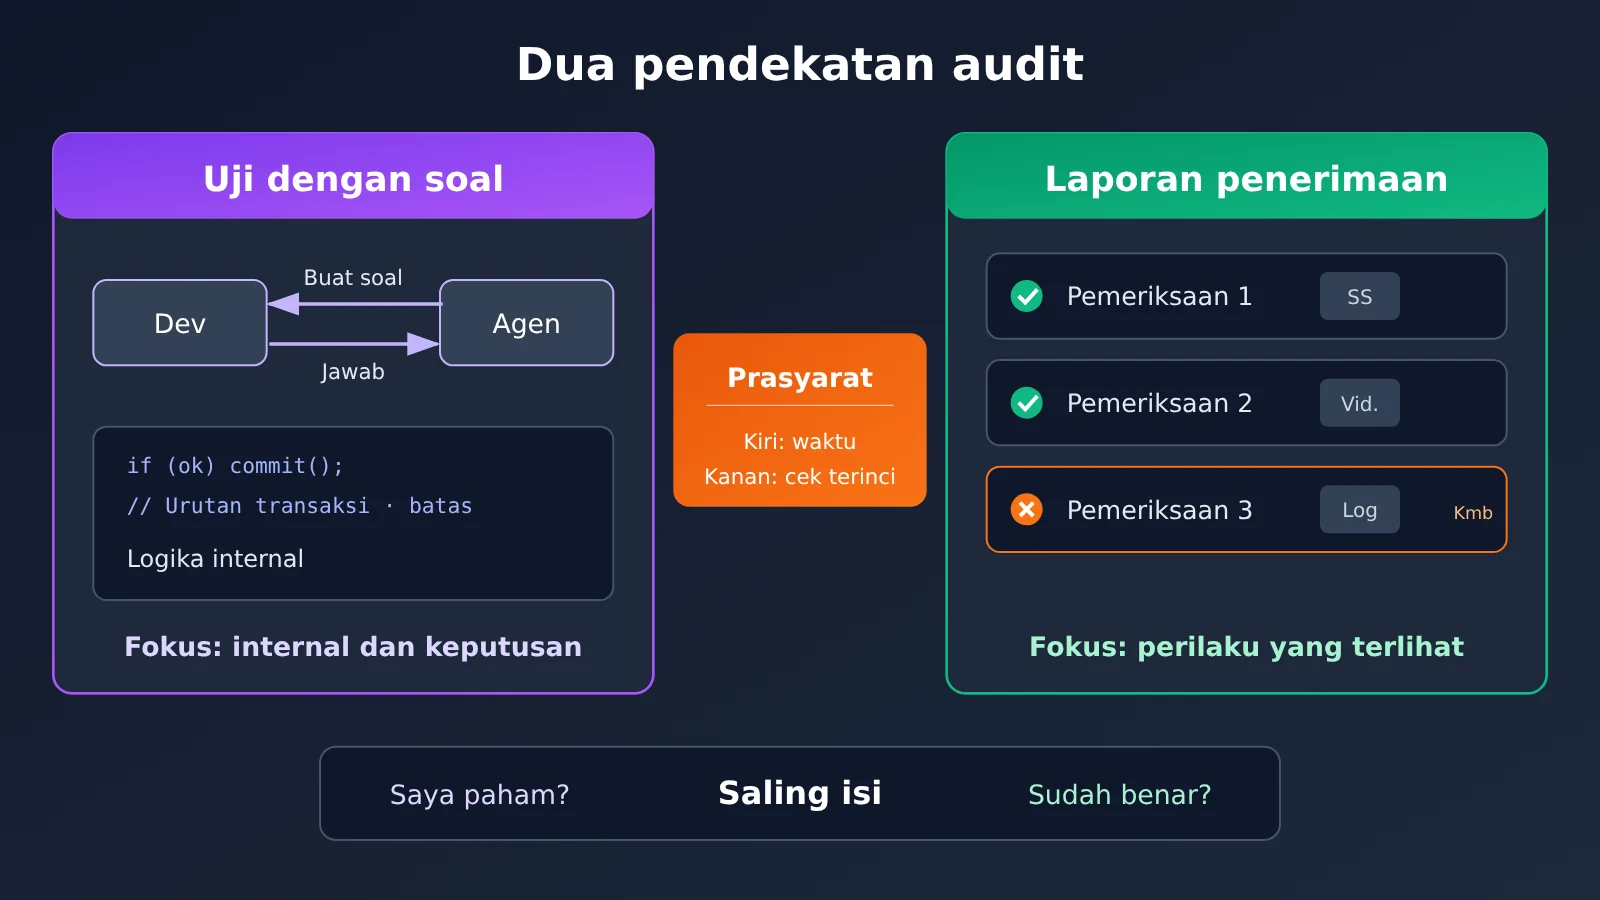
Pendekatan lain yang sangat berbeda datang dari LobeHub, platform kolaborasi Agent sumber terbuka dengan sekitar 84 ribu bintang di GitHub. Menurut laporan White Whale Lab, tim tersebut mengaku “hampir tidak lagi melihat kode” dan lebih berfokus pada laporan penerimaan multimodal dari Agent. Mereka menggunakan Acceptance, alat buatan sendiri yang dibuka sumbernya pada September tahun ini. Sebelum menyerahkan hasil, Agent memecah kebutuhan menjadi butir pemeriksaan yang bisa diamati secara langsung, menjalankannya satu per satu di produk nyata, lalu merangkumnya dalam laporan daring lengkap dengan tangkapan layar, rekaman layar, dan log. Manusia bisa menyetujui seluruhnya atau mengembalikan satu butir tertentu untuk diperbaiki.
| Dimensi | AI membuat soal untuk menguji Anda | Peninjauan berbasis laporan penerimaan |
|---|---|---|
| Fokus | Logika internal kode, keputusan tanpa izin, dan asumsi | Perilaku eksternal produk yang dapat diamati |
| Bentuk bukti | Tanya jawab dan hasil penilaian | Tangkapan layar, rekaman layar, log, dan catatan perintah |
| Masalah yang dapat ditemukan | Urutan transaksi, kondisi batas, dan pertimbangan implisit | Kesesuaian antarmuka, interaksi, dan fungsi dengan kebutuhan |
| Masalah yang mudah terlewat | Hal-hal yang tidak terpikir untuk dijadikan soal | Logika internal yang tidak terlihat dan potensi masalah arsitektur |
| Prasyarat | Pengembang bersedia meluangkan waktu untuk memahami perubahan | Kebutuhan bisa dipecah menjadi butir pemeriksaan yang dapat diamati, dan tersedia lingkungan eksekusi otomatis |
| Peran manusia | Memahami dan bertanggung jawab atas perubahan spesifik | Menentukan kriteria penerimaan dan membuat penilaian akhir |
Analisis perbandingan kedua pendekatan
Peninjauan berbasis laporan penerimaan: Laporan penerimaan sangat efisien untuk memverifikasi perilaku yang dapat diamati, dan umpan balik perbaikan bisa diarahkan tepat ke satu butir pemeriksaan. Dalam pengujian yang dilaporkan, peninjau hanya mengembalikan butir latar belakang gelap, dan Agent hanya mengubah satu baris CSS tanpa mengubah file lain. Namun, pendekatan ini bergantung pada kemampuan memecah kebutuhan menjadi butir pemeriksaan yang dapat diamati. Laporan tersebut juga menyebutkan bahwa untuk tugas yang lebih kompleks, keamanan, arsitektur, dan kualitas akhir masih memerlukan penilaian manusia. Ada pula bagian dari proses penyampaian umpan balik yang masih perlu ditangani secara manual. Klaim “hampir tidak lagi melihat kode” berasal dari tim itu sendiri dan belum diverifikasi secara independen.
AI membuat soal untuk menguji Anda: Pengujian dengan soal lebih efektif mengungkap masalah yang “tidak terlihat di antarmuka”, seperti urutan transaksi dan kondisi batas. Ini tepat untuk melengkapi titik buta laporan penerimaan. Namun, efektivitasnya bergantung pada kualitas soal dan kesediaan pengembang untuk benar-benar meluangkan waktu memahami perubahan. Keduanya tidak saling bertentangan. Pendekatan yang lebih masuk akal adalah menggunakan laporan penerimaan untuk memastikan “apakah hasilnya sudah benar”, lalu menggunakan soal untuk memastikan “apakah saya memahami alasan di balik cara kerjanya”.
Pilih Intensitas Peninjauan Utang Pemahaman Berdasarkan Risiko Perubahan
Tidak semua PR perlu melewati proses lengkap. Addy juga mengingatkan bahwa ketika konten yang kamu hasilkan sudah terlalu banyak untuk dipertanggungjawabkan, kamu tidak lagi melakukan peninjauan—kamu hanya bertaruh bahwa semuanya baik-baik saja. Tabel berikut bisa menjadi panduan berdasarkan tingkat risiko, tetapi batasnya perlu disesuaikan dengan kondisi tim.
| Tingkat risiko | Contoh perubahan | Intensitas peninjauan yang disarankan |
|---|---|---|
| Rendah | Teks, gaya tampilan, skrip mandiri, prototipe | Cukup dengan laporan penerimaan atau pemeriksaan manual, serta catat hasil yang diharapkan |
| Sedang | Fitur bisnis biasa, penambahan antarmuka | Tanyakan lebih lanjut soal keputusan tanpa otorisasi + periksa output pengujian yang sebenarnya |
| Tinggi | Transaksi, izin akses, pembayaran, migrasi data | Proses lengkap 5 langkah + uji pemahaman dengan pertanyaan + peninjauan oleh Agent independen |
| Melebihi kapasitas | Hasil paralel dari banyak Agent yang tak sempat ditinjau | Tambahkan pemeriksaan otomatis, atau kurangi jumlah proses paralel |
💡 Saran: Jika tim kamu sudah memiliki proses penerimaan otomatis yang matang, fokuskan uji pemahaman pada perubahan berisiko tinggi. Jika belum, setidaknya terapkan aturan “jawab dengan benar sebelum merge” untuk PR yang menyangkut konsistensi data dan izin akses.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa itu utang pemahaman? Apa bedanya dengan utang teknis?
Utang pemahaman muncul ketika kompleksitas kode dan sistem terus bertambah, tetapi pemahaman developer tidak berkembang seiring dengan itu. Utang teknis biasanya berkaitan dengan kualitas kode yang buruk. Sebaliknya, utang pemahaman bisa muncul meskipun kualitas kodenya bagus: masalahnya ada pada “orang yang tidak memahami kode”, dan baru terlihat jelas saat kode perlu diubah.
Q2: Apa bedanya meminta AI membuat soal untuk menguji kita dengan langsung meminta AI menjelaskan kode?
Saat AI menjelaskan, kita menerima informasi secara pasif dan mudah merasa seolah-olah sudah paham. Pengujian dengan soal mengharuskan kita menjawab secara aktif. Jawaban yang salah bisa ditelusuri ke bagian kode tertentu, sehingga pemahaman yang masih kabur menjadi sesuatu yang bisa diuji.
Q3: Apakah tidak langsung menyetujui hasil Agent berarti harus memeriksa kode AI baris demi baris?
Tidak. Menurut laporan, tim Claude Code tidak meminta engineer mengingat seluruh codebase. Saat perlu mengubah suatu bagian, mereka menggunakan Claude untuk memahami kembali logika terkait. Kuncinya adalah mengetahui apa yang sudah dan belum kamu pahami, lalu menentukan kedalaman pemeriksaan berdasarkan risikonya.
Q4: Metode ini cocok untuk skenario pengembangan seperti apa?
Metode ini terutama cocok untuk skenario berikut:
– **Tugas Agent yang berjalan lama**: rentan menghasilkan keputusan tanpa persetujuan, sehingga cocok diperiksa dengan daftar pertanyaan lanjutan
– **Perubahan backend yang melibatkan transaksi dan kondisi batas**: cocok diuji dengan soal
– **Pengembangan paralel oleh beberapa Agent**: cocok menerapkan penyimpanan materi asli dan pembatasan jumlah proses paralel
– **Code Review dalam kolaborasi tim**: daftar pertanyaan bisa dimasukkan ke template PR
Q5: Bagaimana menerapkan alur pemeriksaan utang pemahaman ini di Claude Code, Cursor, dan Cline?
Metode ini tidak bergantung pada alat tertentu. Intinya ada pada petunjuk dan alur kerja:
1. Simpan template petunjuk lengkap dalam artikel ini sebagai cuplikan yang bisa digunakan ulang oleh tim
2. Tulis tahap A secara manual sebelum mulai bekerja, lalu tempelkan tahap B dan C setelah tugas selesai
3. Untuk perubahan berisiko tinggi, buka sesi baru yang terpisah untuk menjalankan tahap D
Kamu juga bisa memasukkan aturan “hanya merge jika jawaban benar” ke standar pemeriksaan PR tim.
Q6: Apa saja keterbatasan metode ini yang sudah diketahui?
Ada beberapa hal yang perlu dilihat secara objektif:
– **Data efektivitas**: saat ini belum ada data publik yang membuktikan seberapa besar metode ini mengurangi tingkat cacat atau meningkatkan efisiensi
– **Biaya waktu**: alur lengkap akan memperpanjang siklus merge dan tidak cocok untuk semua PR
– **Titik buta soal**: Agent mungkin tidak membuat soal tentang masalah yang tidak disadarinya sendiri, jadi langkah “cari satu hal yang terlewat” tidak boleh dilewatkan
– **Keterangan sumber**: pandangan Addy berasal dari pemberitaan media; redaksi aslinya perlu diverifikasi sendiri
Q7: Apakah latihan coding offline setiap minggu benar-benar diperlukan?
Menurut Addy, keterampilan yang lama tidak digunakan bisa berangsur menurun. Sesekali menyelesaikan tugas secara mandiri tanpa Agent dapat membantumu mengukur kemampuan yang sebenarnya. Setiap bulan, tinjau juga keterampilan mana yang sudah diserahkan kepada AI dan mana yang harus tetap kamu kuasai. Biayanya tidak besar, tetapi bisa mencegah kita diam-diam menyerahkan proses berpikir kepada AI.
Jangan Asal Menyetujui Hasil Agent: Poin Penting tentang Utang Pemahaman
- Penyerahan kendali kognitif terjadi bertahap: dari mengalihkan beban berpikir, menyerahkan sebagian penilaian, hingga menyerahkan seluruh penilaian
- Utang pemahaman dikenai bunga belakangan: semakin cepat kode ditulis, semakin banyak bagian yang tidak dipahami dan baru menjadi masalah saat perlu diubah
- Utang niat muncul sejak awal: tulis sendiri daftar kebutuhan sebelum mulai; jika dua kali petunjuk tidak membuahkan hasil yang memuaskan, susun ulang kebutuhan
- Ujian pemahaman adalah langkah utama: minta Agent merangkum perubahan dan membuat pertanyaan; gabungkan kode hanya setelah semua pertanyaan terjawab dengan benar
- Semua pengujian lolos bukan berarti tidak ada masalah: periksa dulu hasil pengujian yang benar-benar dijalankan, lalu tanyakan apa saja yang belum diuji
- Laporan penerimaan dan ujian pemahaman saling melengkapi: laporan memverifikasi perilaku eksternal, sedangkan pertanyaan menguji pemahaman Anda terhadap logika internal
- Tinjau berdasarkan tingkat risiko: jika kewalahan meninjau, tambahkan otomatisasi atau kurangi pekerjaan paralel, jangan mengandalkan untung-untungan
Kesimpulan
Poin penting agar tidak asal menyetujui hasil Agent:
- Kenali tahapannya: waspadai pergeseran dari “menyerahkan pekerjaan ke AI” menjadi “menyerahkan penilaian ke AI”. Utang pemahaman dan utang niat sama-sama merupakan dampak dari proses ini
- Lakukan langkah nyata: tulis ekspektasi sebelum mulai, tanyakan keputusan yang dibuat tanpa izin dan hal-hal yang belum diuji saat hasil diserahkan, lalu minta AI menguji pemahaman Anda sebelum kode digabungkan
- Sesuaikan dengan tingkat risiko: untuk perubahan berisiko rendah, gunakan laporan penerimaan atau pemeriksaan singkat; untuk perubahan berisiko tinggi, jalankan proses lengkap dan tambahkan peninjauan independen
Kecepatan AI dalam menulis kode akan terus meningkat, tetapi yang bertanggung jawab atas perubahan tetaplah orang yang menyetujuinya. Sebelum mengeklik “setujui” lain kali, coba minta Agent membuat 5 pertanyaan dan lihat berapa yang bisa Anda jawab dengan benar.
📚 Referensi
- QbitAI: Panduan Lengkap Agent untuk Engineer Claude (dimuat ulang oleh 36Kr): Membahas pandangan dan metode praktis Addy Osmani tentang penyerahan kognitif, utang pemahaman, dan utang niat.
- Tautan:
36kr.com/p/4056027738116995 -
Keterangan: Sumber utama metodologi artikel ini, berupa pemberitaan ulang oleh media.
-
Unggahan asli Addy Osmani: Sumber asli yang dikutip dalam pemberitaan.
- Tautan:
x.com/addyosmani/status/2117512471930167377 -
Keterangan: Rujuk teks asli untuk redaksi yang tepat; tautan perlu diverifikasi sendiri.
-
Beluga Lab: Perusahaan AI dengan 80 ribu Star memutuskan menyerahkan kendali kepada AI (dimuat ulang oleh 36Kr): Membahas arsitektur Agent pengawas LobeHub dan praktik laporan Acceptance untuk penerimaan hasil.
- Tautan:
36kr.com/p/4056040123945860 - Keterangan: Sumber pembanding untuk peninjauan berbasis laporan penerimaan; klaim “hampir tidak melihat kode” berasal dari pernyataan tim tersebut.
Penulis: Tim Teknis APIYI