Catatan penulis: Artikel ini disusun berdasarkan presentasi publik dari YC Paper Club Harness Night, merangkum satu set metode evaluasi model yang bisa langsung diterapkan, untuk membantu tim memilah apakah selisih skor benar-benar berasal dari model atau dari Harness.
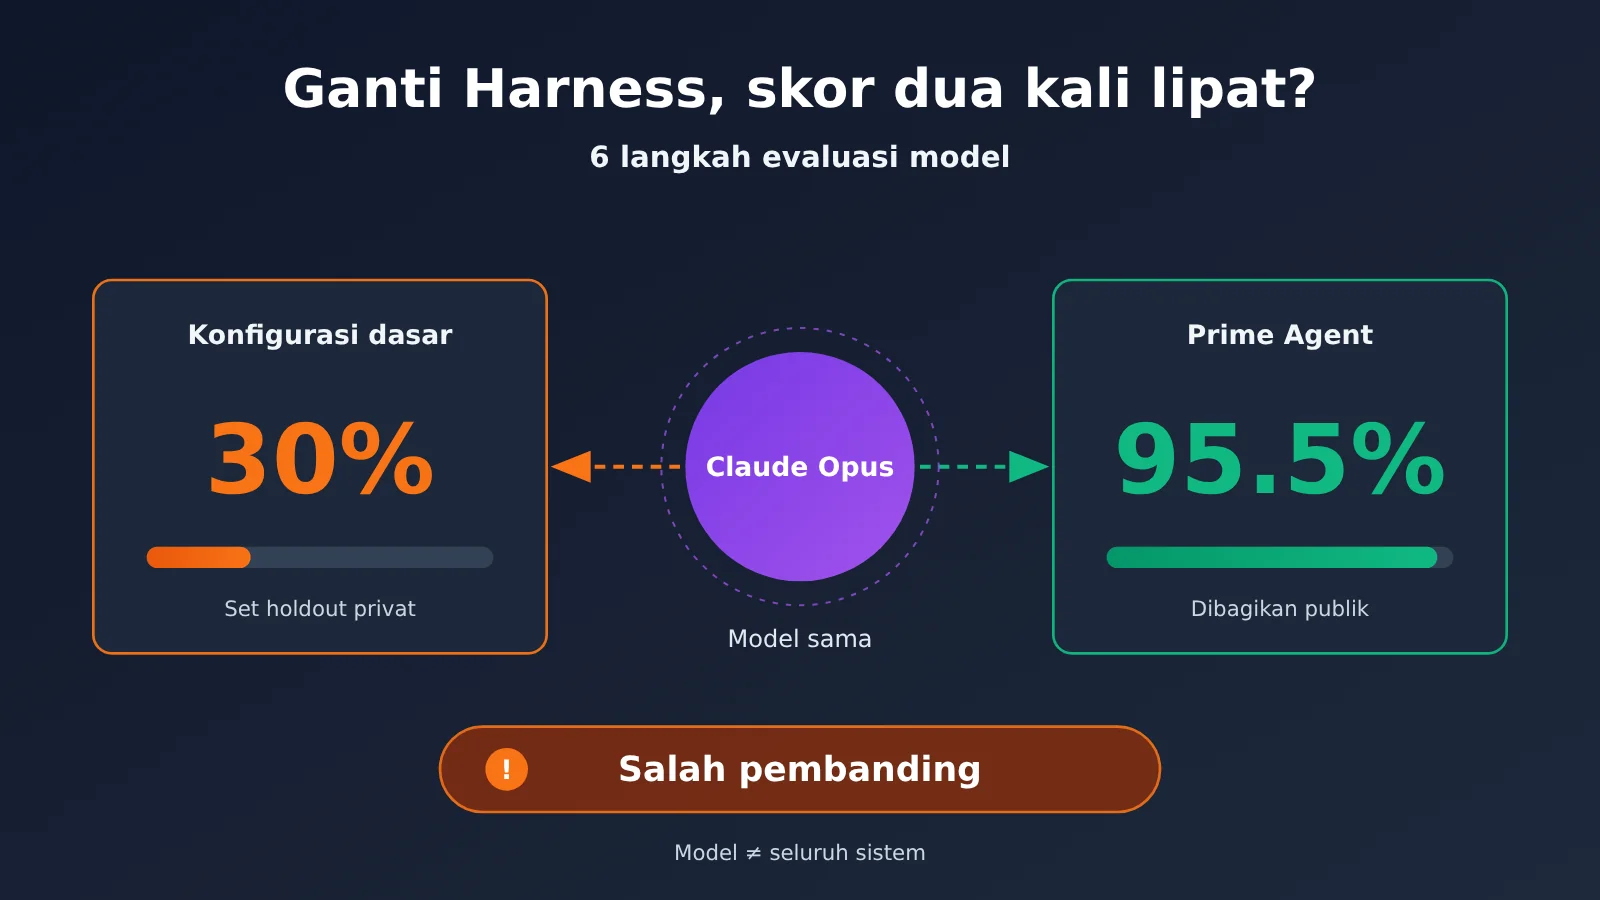
Claude Opus yang sama, skor terbaiknya pada private holdout set adalah 30%; setelah dimasukkan ke Prime Agent, skor yang disebut dalam presentasi publik menjadi 95.5%. Kalau hanya melihat leaderboard, kamu mungkin mengira modelnya telah berubah secara kualitatif. Namun angka ini pertama-tama mengingatkan kita: evaluasi model sering kali membandingkan keseluruhan sistem, bukan hanya modelnya.
Ini bukan artikel yang mengajakmu meninggalkan leaderboard, dan juga bukan klaim bahwa Harness bisa menaikkan skor model apa pun tanpa batas. Artikel ini tidak melakukan pengujian ulang secara independen; semua skor yang dikutip berasal dari konten presentasi yang dirangkum oleh InfoQ. Fokusnya adalah mengubah pengalaman tersebut menjadi alur evaluasi yang bisa dijalankan.
Nilai inti: Setelah membaca artikel ini, kamu akan bisa merancang eksperimen kontrol antara model dan Harness melalui 6 langkah, menentukan dari mana selisih skor berasal, dan menarik kesimpulan pemilihan model yang lebih andal.
Ganti Harness, Skor Berlipat: Poin Penting Evaluasi Model
Harness adalah lapisan sistem antara LLM dan dunia luar yang bertugas menyediakan status persisten, alat, dan kemampuan komputasi. Seth Karten menggunakan analogi: LLM telanjang seperti mesin Turing, sedangkan Harness seperti komputer von Neumann yang dapat membaca dan menulis memori eksternal. Saat mengevaluasi sebuah Agent, kemampuan penalaran model dan daya ekspresif lapisan sistem ini sama-sama memengaruhi hasil.
Tabel berikut mencantumkan sebagian data publik terkait ARC-AGI dari paparan. Skor ini berasal dari model, Harness, atau konfigurasi evaluasi yang berbeda, sehingga tidak bisa langsung dipakai sebagai peringkat model.
| Konfigurasi | Skor publik | Hal yang perlu diperhatikan saat membaca |
|---|---|---|
| Claude Opus, validasi pada set privat yang disisihkan | Skor terbaik 30% | Ini adalah baseline dalam paparan, tidak mewakili semua kondisi eksekusi |
| Prime Agent + Opus | 95.5% | Materi tidak merinci semua perbedaannya dari baseline, jadi tidak tepat hanya diatribusikan pada satu variabel |
| Prime Agent + GPT-5.6 Sol | 78% | Ini adalah skor setelah isolasi sandbox selesai |
| Prime Agent + GPT-5.6 Terra | 25.7% | Di bawah Harness yang sama, selisih antar model tetap terlihat jelas |
| Nvidia AVO | 100% | Paparan hanya memberikan hasil; sebelum membandingkan, konfigurasi spesifik tetap perlu diperiksa |
Hubungan Harness dengan Evaluasi Model
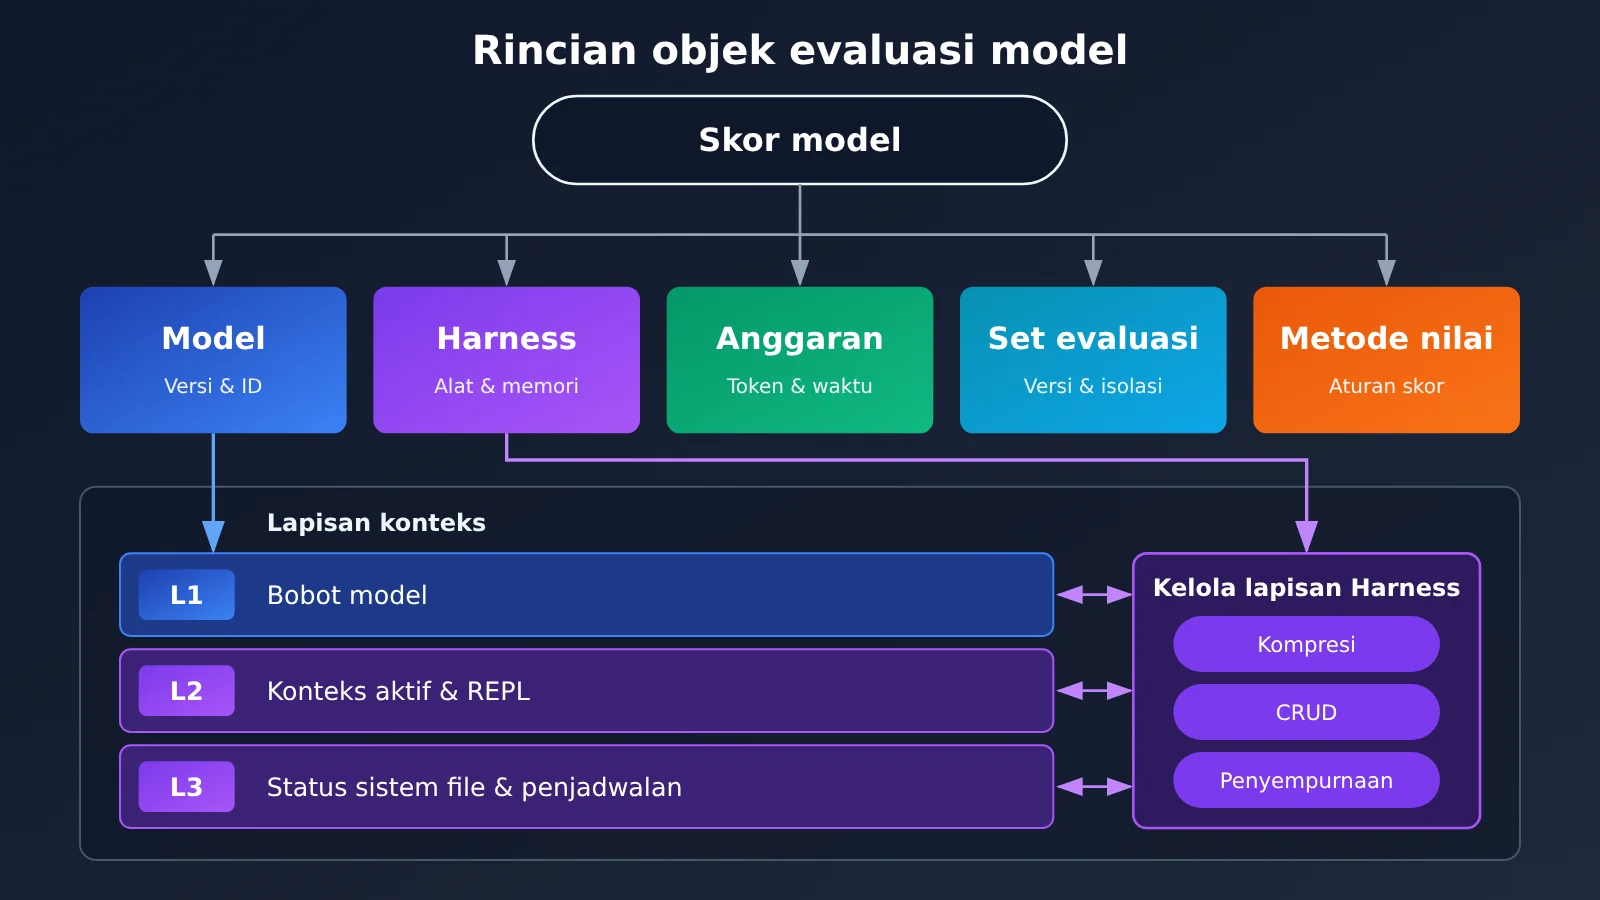
Prime Agent membagi konteks menjadi tiga lapisan: L1 adalah bobot model, L2 adalah konteks aktif dan REPL, L3 adalah status penjadwalan seperti sistem berkas. Harness melakukan kompresi, operasi CRUD, dan refinement antar lapisan, fungsinya mirip cache plus garbage collection. Artinya, jika model yang sama diganti dengan Harness lain, memori dan kemampuan komputasi yang dapat digunakan bisa berubah.
Namun ini bukan berarti model tidak penting. Prime Agent menonjol pada ARC-AGI, tetapi pada evaluasi jangka panjang seperti Oolong dan Emulator Bench hasilnya terutama setara atau sedikit lebih baik, sedangkan tugas kernel GPU juga kira-kira setara. Jenis tugas menentukan seberapa besar Harness dapat memperbesar selisih, jadi hasil dari satu pengujian tidak bisa digeneralisasi ke semua skenario.
5 Variabel yang Paling Mudah Salah Dibandingkan dalam Evaluasi Model
| Variabel | Perbandingan yang sering keliru | Apa yang harus dicatat |
|---|---|---|
| Model | Hanya menulis nama seri, tanpa versi spesifik | ID model, catatan pemanggilan aktual, kondisi fallback atau pergantian |
| Harness | Menganggap konfigurasi default sebagai kemampuan model | Alat, system prompt, sub-Agent, memori, dan mekanisme kompresi |
| Anggaran | A dijalankan sampai plateau, B berhenti lebih awal | Token, waktu aktual, biaya, kondisi berhenti lebih awal |
| Set evaluasi | Membandingkan skor set publik dengan skor set privat | Versi dataset, metode isolasi, ada tidaknya kebocoran informasi |
| Metode penilaian | Hanya meminta LLM menilai apakah perbaikan atau jawaban berhasil | Aturan penilaian, proporsi sampling manual, sampel yang diperdebatkan |
Saran praktis: Jika ingin membandingkan beberapa model dalam alur evaluasi yang sama, Anda dapat memanggil model yang dibahas di artikel ini melalui APIYI apiyi.com untuk mengurangi perbedaan integrasi. APIYI kompatibel dengan format API OpenAI dan Anthropic; untuk nama model spesifik dan cara integrasi, silakan merujuk ke dokumentasi docs.apiyi.com.
Panduan Cepat Evaluasi Model Harness: 6 Langkah
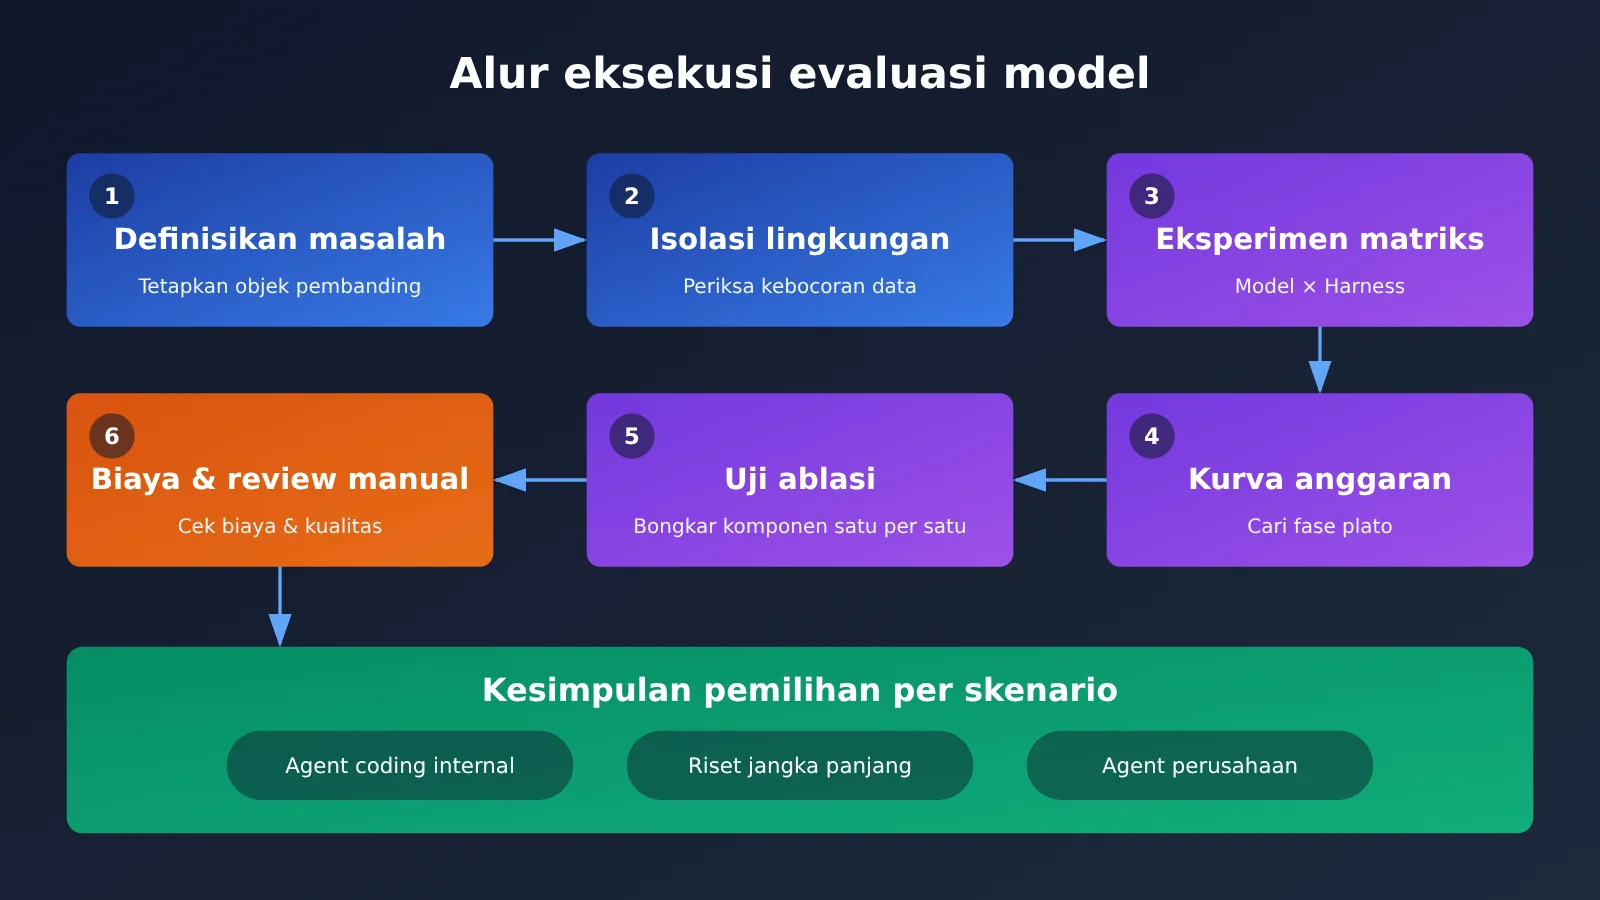
Alur di bawah ini cocok untuk pemilihan model, peningkatan Agent, dan pengujian benchmark internal. Anda tidak perlu langsung membangun platform evaluasi yang besar; catat dulu semua variabel secara lengkap, lalu tambahkan tugas dan model secara bertahap.
Langkah 1: Tulis dengan jelas objek perbandingan evaluasi model
Mulailah dengan mendefinisikan pertanyaan eksperimen dalam satu kalimat, misalnya “dalam Harness dan anggaran yang sama, bandingkan kemampuan dua model dalam menyelesaikan tugas coding internal”. Jika pertanyaannya ditulis sebagai “Agent mana yang lebih baik”, maka objek perbandingannya adalah kombinasi model dan Harness, dan kesimpulannya juga tidak boleh ditulis sebagai “model mana yang lebih kuat”.
Spesifikasi evaluasi setidaknya harus menetapkan model, petunjuk sistem, daftar tool, max_tokens, jumlah putaran maksimum, dan anggaran total. Jika Harness memungkinkan Agent memilih runtime secara mandiri, catat juga model yang benar-benar digunakan di setiap langkah. Desain QM memang memungkinkan Agent beralih ke model lain saat menghadapi penolakan; pada saat itu skor akhir sudah tidak lagi mencerminkan satu model tunggal.
Langkah 2: Isolasi lingkungan evaluasi dan data Harness
Seth pernah memasukkan system prompt dari leaderboard komunitas ke Prime Agent, dan pada eksekusi pertama hasilnya 99.9%. Setelah memeriksa log, ia menyadari bahwa dirinya sedang curang, lalu menghabiskan satu hari untuk melakukan isolasi sandbox, dan skor GPT-5.6 Sol berubah menjadi 78%. Skor tinggi belum tentu salah, tetapi skor yang luar biasa tinggi harus diperiksa log-nya terlebih dahulu.
Saat memeriksa, ada tiga hal yang perlu diperhatikan: apakah Agent bisa membaca jawaban atau hasil historis, apakah petunjuk memuat informasi khusus untuk set evaluasi, dan apakah pemanggilan tool melampaui izin yang sudah ditentukan. Untuk tugas di luar benchmark publik, sediakan juga satu set sampel cadangan yang tidak ikut dituning, untuk mencegah petunjuk dan Harness mengalami overfitting.
Langkah 3: Bandingkan dengan matriks “model × Harness”
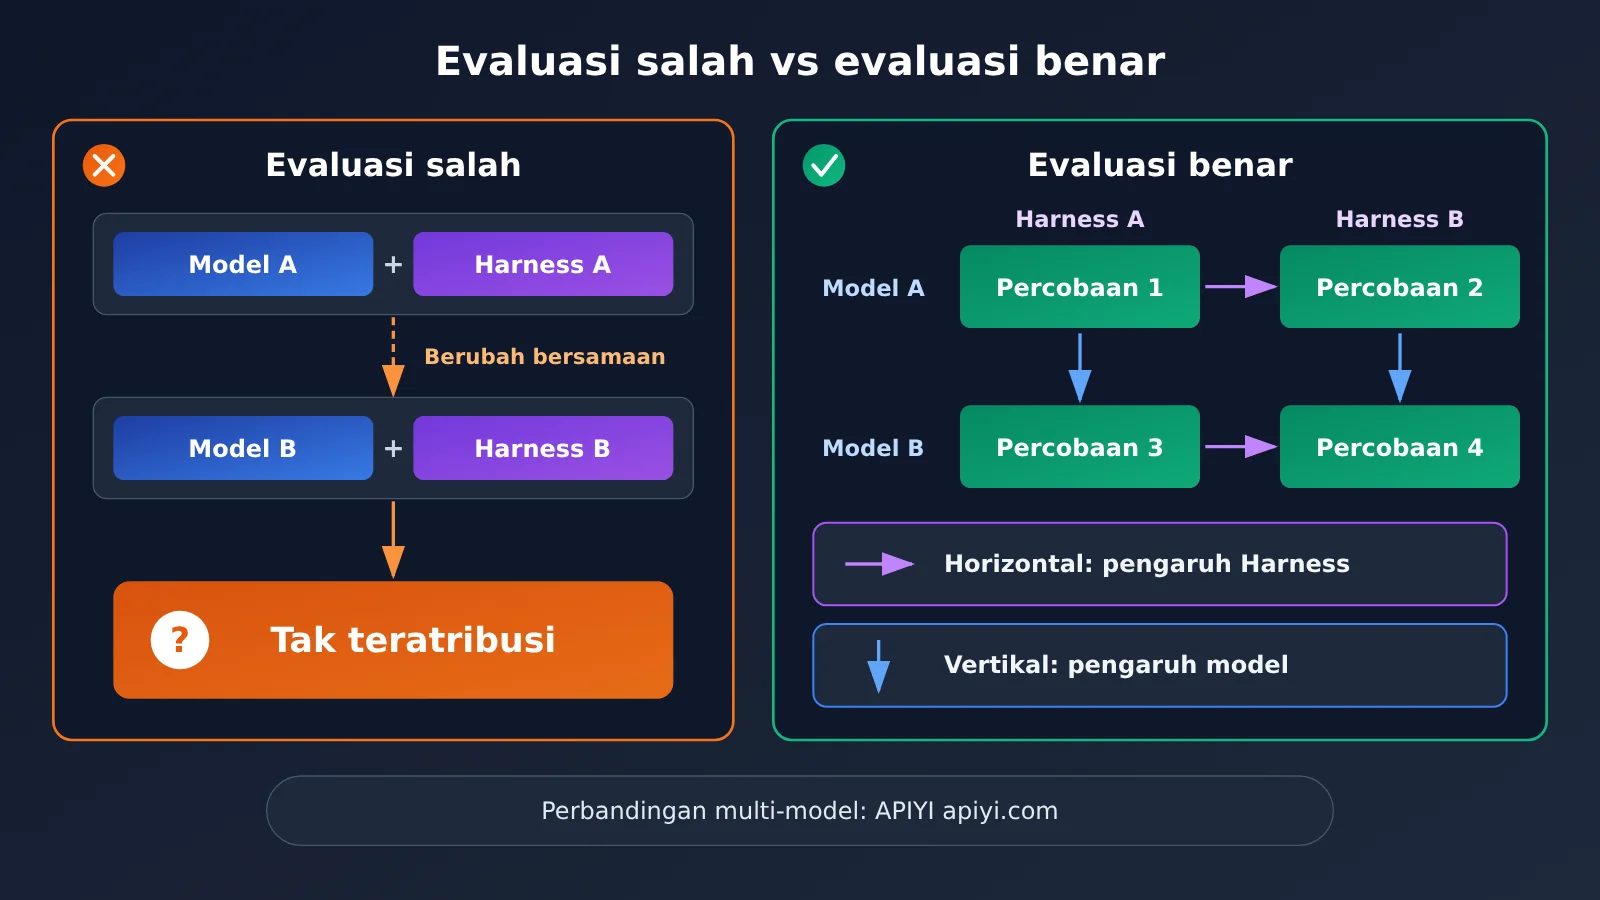
Jangan hanya menjalankan “Model A + Harness A” dan “Model B + Harness B”, karena dua variabel berubah bersamaan sehingga penyebabnya tidak bisa dilacak. Skema minimalnya adalah matriks 2 × 2: dua model dijalankan pada dua set Harness, dengan set tugas dan anggaran yang tetap sama.
| Hasil matriks | Penjelasan yang lebih mungkin | Tindakan selanjutnya |
|---|---|---|
| Ganti model perubahannya jelas, ganti Harness perubahannya kecil | Tugas saat ini lebih bergantung pada kemampuan model | Prioritaskan pemilihan model |
| Ganti Harness perubahannya jelas, ganti model perubahannya kecil | Kemampuan sistem adalah bottleneck utama | Prioritaskan perbaikan tool dan manajemen konteks |
| Keduanya saling memengaruhi secara jelas | Ada relasi kesesuaian antara model dan Harness | Pilih berdasarkan kombinasi, jangan menulis satu peringkat tunggal |
| Keduanya tidak menunjukkan perubahan yang jelas | Tugas terlalu mudah, terlalu sulit, atau penilaiannya tidak sensitif | Rancang ulang set evaluasi dan metrik |
Saran eksperimen kontrol: eksperimen matriks memerlukan pergantian model yang cukup sering. Anda bisa memakai APIYI apiyi.com untuk memanggil berbagai model dengan akun dan konfigurasi antarmuka yang terpadu, serta menyimpan model ID di catatan eksperimen agar mudah ditelusuri kembali.
Langkah 4: Menyelaraskan anggaran dan mengamati periode plateau kinerja model
Dalam presentasinya, Seth menunjukkan bahwa jika suatu model tidak berjalan cukup lama, atau berhenti setelah anggaran habis, sementara model lain terus bekerja, Anda tidak membandingkan dengan pengeluaran yang sama, dan juga menyembunyikan kinerja sebenarnya. Pendekatan yang lebih masuk akal adalah menetapkan beberapa titik anggaran dan mengamati kurva skor seiring bertambahnya Token atau waktu.
Pengalaman tim QM juga menunjukkan pentingnya anggaran. Mereka menemukan bahwa Agent sering menyerah terlalu cepat, sehingga mereka mencoba “mengasah alat”: menetapkan anggaran untuk target, dan tidak mengizinkan menyerah sebelum waktu atau konsumsi Token aktual tercapai, sehingga output riset menjadi lebih baik. Jadi, spesifikasi evaluasi tidak hanya perlu menuliskan batas atas anggaran, tetapi juga menjelaskan dengan jelas apakah ada persyaratan investasi minimum.
Langkah 5: Melakukan uji ablasi pada Harness
Setelah melihat Harness memberikan peningkatan, langkah berikutnya adalah mencari tahu kemampuan mana yang menghasilkan peningkatan tersebut. Prime Agent menekankan ekspresivitas, dan berpendapat bahwa kompresi, Python REPL, sub-Agent terprogram, akses status, dan mekanisme umpan balik tidak boleh dengan mudah dihapus, tetapi dalam tugas Anda, kontribusi aktual setiap kemampuan tetap perlu diuji.
Caranya adalah menonaktifkan satu kemampuan pada satu waktu, misalnya menonaktifkan REPL, menonaktifkan sub-Agent, atau menonaktifkan memori jangka panjang, sementara konfigurasi lain tetap sama. Jika setelah dinonaktifkan skor pada dasarnya tidak berubah tetapi biaya turun secara signifikan, kemampuan tersebut mungkin untuk sementara tidak layak dipertahankan. Untuk tugas dengan varians tinggi seperti riset otomatis, perlu menjalankan berulang kali dalam beberapa putaran, karena Seth juga menyebutkan bahwa tugas semacam ini sulit diatribusikan secara langsung ke Harness atau model.
Langkah 6: Hitung biaya dan tambahkan tinjauan manual
Seth juga menyebutkan bahwa saat menjalankan evaluasi dengan Hermes Agent, ia cepat menghabiskan 5,000 dolar AS tetapi tidak melihat peningkatan yang jelas, sehingga harus menghentikannya. Ini bukan berarti batas kemampuan Hermes Agent, tetapi cukup menunjukkan bahwa rasio biaya-kinerja harus masuk ke kesimpulan evaluasi. Laporan akhir disarankan mencantumkan tingkat keberhasilan, waktu penyelesaian, konsumsi Token, dan biaya per keberhasilan.
Saat menghitung biaya, jangan menuliskan harga secara hard-code di keterangan skrip evaluasi. Untuk harga satuan input/output model, harga cache, dan dasar penagihan, gunakan data aktual di halaman harga APIYI https://docs.apiyi.com/models sebagai acuan, dan cantumkan tanggal pengecekan di laporan.
Tahap penilaian juga harus tetap menyertakan pemeriksaan sampel manual. Tim QM menemukan bahwa saat LLM diminta menilai hasil perbaikan, muncul “sindrom tokoh utama”: ia hanya melihat sebagian dari gajah, bukan keseluruhan sistem. Saat menyangkut alur bisnis, uji juga batas izin, karena Agent kurang memahami konteks sosial sehingga informasi istimewa bisa bocor ke konteks yang tidak seharusnya.
Cara menerapkan matriks evaluasi model dengan API
Dalam praktiknya, sebaiknya pecah evaluasi menjadi tiga bagian: kumpulan tugas, konfigurasi eksekusi, dan pencatatan hasil. Dengan begitu, saat mengganti model atau Harness, Anda hanya perlu mengubah satu item konfigurasi tanpa harus menulis ulang seluruh alur.
| Item konfigurasi | Isi yang disarankan untuk dicatat | Keterangan |
|---|---|---|
| Format antarmuka | Format yang kompatibel dengan OpenAI atau format Anthropic | Pemanggilan alat dan struktur pesan dapat berbeda antarformat, sehingga perlu diverifikasi secara terpisah |
| Alamat akses dan kunci | base_url, nama variabel lingkungan |
Alamat mengikuti dokumentasi docs.apiyi.com; kunci jangan ditulis ke dalam laporan evaluasi |
| Parameter eksekusi | model, max_tokens, jumlah putaran maksimum, jumlah pengulangan |
Pastikan setiap eksperimen dapat direproduksi |
| Dasar perhitungan biaya | Input, output, cache, dan tanggal pengecekan | Gunakan data aktual dari halaman harga APIYI docs.apiyi.com/models sebagai acuan |
| Hasil eksekusi | Skor, alasan kegagalan, Token, durasi, log pemanggilan | Untuk menganalisis fase plateau dan rasio biaya-kinerja |
Jika Harness Anda mendukung kedua format antarmuka sekaligus, disarankan lebih dulu melakukan perbandingan format dengan model yang sama. Dengan begitu, Anda dapat memastikan konversi pesan, definisi alat, dan pengembalian streaming tidak memengaruhi hasil, sehingga masalah integrasi tidak keliru dianggap sebagai perbedaan kemampuan model.
Tips integrasi: APIYI menyediakan pemanggilan API untuk model yang dibahas dalam artikel ini, kompatibel dengan format antarmuka OpenAI dan Anthropic. Sebelum memulai eksperimen, periksa model yang tersedia saat ini dan cara pemanggilannya di docs.apiyi.com, lalu tulis ID model ke dalam spesifikasi evaluasi.
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Apa itu Harness dalam evaluasi model?
Harness adalah lapisan sistem yang menghubungkan model dengan dunia luar, biasanya mencakup kontrol loop, manajemen konteks, alat, sub-Agent, memori, dan akses status. Harness menentukan apa yang bisa dilihat model, apa yang bisa dipanggilnya, dan berapa lama ia bisa berjalan.
Q2: Jika skor Harness lebih tinggi, apakah itu berarti model menjadi lebih kuat?
Tidak. Ketika bobot model tidak berubah, kenaikan skor lebih mungkin menunjukkan bahwa sistem telah melepaskan lebih banyak kemampuan, atau konfigurasinya lebih cocok untuk tugas tersebut. Jika Harness, anggaran, dan model berubah secara bersamaan, kita tidak bisa mengatribusikannya secara terpisah, dan bisa juga ada kebocoran di lingkungan evaluasi.
Q3: Kapan evaluasi model perlu dilakukan ulang?
Evaluasi harus dilakukan ulang ketika versi model, petunjuk sistem, izin alat, strategi kompresi, atau tugas bisnis berubah. Bidang Harness berkembang sangat cepat; data dalam artikel ini berasal dari rangkuman yang diterbitkan InfoQ pada November 2026, dan hasilnya bisa berubah di kemudian hari.
Q4: Metode evaluasi model ini cocok untuk skenario apa saja?
Terutama cocok untuk skenario berikut:
– **Pemilihan Agent pengkodean internal**: membandingkan tingkat penyelesaian tugas dari kombinasi model dan Harness.
– **Tugas riset jangka panjang**: mengamati fase plateau dan varians hasil setelah anggaran ditingkatkan.
– **Validasi sebelum peluncuran Agent perusahaan**: menguji kualitas, biaya, dan batas izin secara bersamaan.
Q5: Bagaimana cara cepat mengintegrasikan beberapa model untuk perbandingan Harness?
Anda bisa terlebih dahulu menentukan tugas evaluasi dan daftar model, lalu mengintegrasikannya melalui APIYI apiyi.com. Platform ini menyediakan pemanggilan API untuk model-model yang dibahas dalam artikel ini, dan kompatibel dengan format antarmuka OpenAI serta Anthropic. Untuk ID model spesifik dan cara konfigurasi, silakan lihat dokumentasi di docs.apiyi.com, dan jaga variabel lain tetap konstan selama eksperimen.
Q6: Bagaimana sebaiknya menuliskan harga model dalam laporan evaluasi?
Disarankan hanya mengutip data harga yang sudah terverifikasi, dan mencantumkan tanggal pengecekan. Harga satuan input dan output model, harga cache, dan dasar penagihan harus mengacu pada data aktual di halaman harga APIYI https://docs.apiyi.com/models, jangan menggunakan tabel lama atau nilai perkiraan.
Q7: Apa saja keterbatasan metode evaluasi Harness ini?
Eksperimen matriks, pengulangan eksekusi, dan tinjauan manual semuanya akan menambah waktu dan biaya. Varians tugas jangka panjang juga bisa sangat tinggi, dan bahkan setelah mengendalikan variabel utama, tetap sulit melakukan atribusi secara presisi. Karena itu, metode ini lebih cocok untuk mendukung pengambilan keputusan, dan hasil sekali pengujian tidak seharusnya dianggap sebagai peringkat absolut.
Poin-Poin Penting Evaluasi Model Harness
- Tentukan dulu objek perbandingan: bedakan apakah yang dibandingkan adalah model, atau kombinasi model dengan Harness.
- Skor tinggi tak wajar, periksa log dulu: 99.9% kasus menunjukkan bahwa lingkungan terisolasi adalah prasyarat evaluasi.
- Pisahkan variabel dengan matriks: akses beberapa model melalui APIYI, lalu lakukan perbandingan model × Harness.
- Anggaran harus selaras: amati kurva pada beberapa titik anggaran untuk menemukan plateau yang sesungguhnya.
- Ablasi untuk melacak kontribusi: matikan satu kemampuan setiap kali untuk memastikan dari mana peningkatan berasal.
- Data biaya wajib diverifikasi: harga dan dasar penagihan mengacu pada halaman harga APIYI.
- Tetap pertahankan penilaian manusia: penilaian LLM bisa sepihak, dan risiko izin juga perlu diuji secara khusus.
Ringkasan
“Ganti Harness, skor langsung dua kali lipat” memang layak diperhatikan, tetapi jangan disederhanakan menjadi “model tidak penting”. Data dalam paparan tersebut menunjukkan efek penggandaan dari Harness, sekaligus memperlihatkan bahwa masih ada kesenjangan nyata antar model dan antar tugas; kesimpulan yang andal harus dibangun di atas eksperimen terkontrol.
Saat menerapkannya, setidaknya ada tiga hal yang perlu diingat lebih dulu:
- Objek evaluasi harus ditulis jelas: catat model, Harness, anggaran, set evaluasi, dan cara penilaian.
- Desain eksperimen harus bisa diatribusikan: pisahkan variabel lewat eksperimen matriks dan uji ablasi, serta isolasi lingkungan evaluasi.
- Kesimpulan harus berorientasi pada skenario: perhatikan sekaligus plateau, rasio biaya-kinerja, hasil tinjauan manusia, dan risiko izin.
Jika Anda ingin memverifikasi kombinasi model Anda sendiri, Anda bisa mengakses model yang dibahas di artikel ini melalui APIYI apiyi.com, lalu menyelesaikan konfigurasi mengikuti dokumentasi docs.apiyi.com. Untuk perhitungan biaya, silakan buka https://docs.apiyi.com/models guna mendapatkan data harga terkini.
📚 Referensi
- InfoQ: Model yang Sama dari 30 Poin ke 95 Poin — Yang Membedakan Bukan Modelnya, Melainkan Harness
- Tautan:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
Keterangan: Skor, studi kasus, dan pandangan desain yang dikutip dalam artikel ini semuanya bersumber dari artikel rangkuman tersebut.
-
Video Presentasi YC Paper Club Harness Night
- Tautan:
youtube.com/watch?v=n9xKblqyQ28 -
Keterangan: Menyajikan konteks lengkap dari tiga sesi berbagi, yaitu Prime Agent, OpenJarvis, dan QM.
-
Pusat Dokumentasi APIYI
- Tautan:
docs.apiyi.com -
Keterangan: Digunakan untuk memverifikasi model yang tersedia, format antarmuka API, dan konfigurasi integrasi.
-
Halaman Harga Model APIYI
- Tautan:
docs.apiyi.com/models - Keterangan: Harga satuan model, harga cache, dan dasar penagihan semuanya mengacu pada data aktual di halaman ini.
Penulis: Tim Teknis APIYI
Diskusi Teknis: Jika Anda ingin mengetahui cara mengintegrasikan model, silakan kunjungi situs resmi APIYI di apiyi.com. Materi lainnya dapat dilihat di pusat dokumentasi docs.apiyi.com.