Catatan penulis: Dengan Meta Muse sebagai studi kasus, artikel ini menjelaskan apa saja yang perlu dipoles secara spesifik saat menyempurnakan agen AI, dengan fokus pada penyetelan perilaku dan visibilitas status, serta memberikan langkah-langkah yang bisa diikuti.
Banyak tim yang membangun agen AI mengalami situasi yang sama: kemampuan model sudah memadai, demo berjalan lancar, tetapi pengguna berhenti memakainya setelah beberapa hari. Masalahnya biasanya bukan pada model itu sendiri, melainkan pada penyetelan perilaku dan visibilitas status yang belum dipoles dengan baik. Artikel ini menggunakan Muse dari Meta sebagai studi kasus untuk membedah apa yang sebenarnya dipoles dalam pemolesan agen AI.
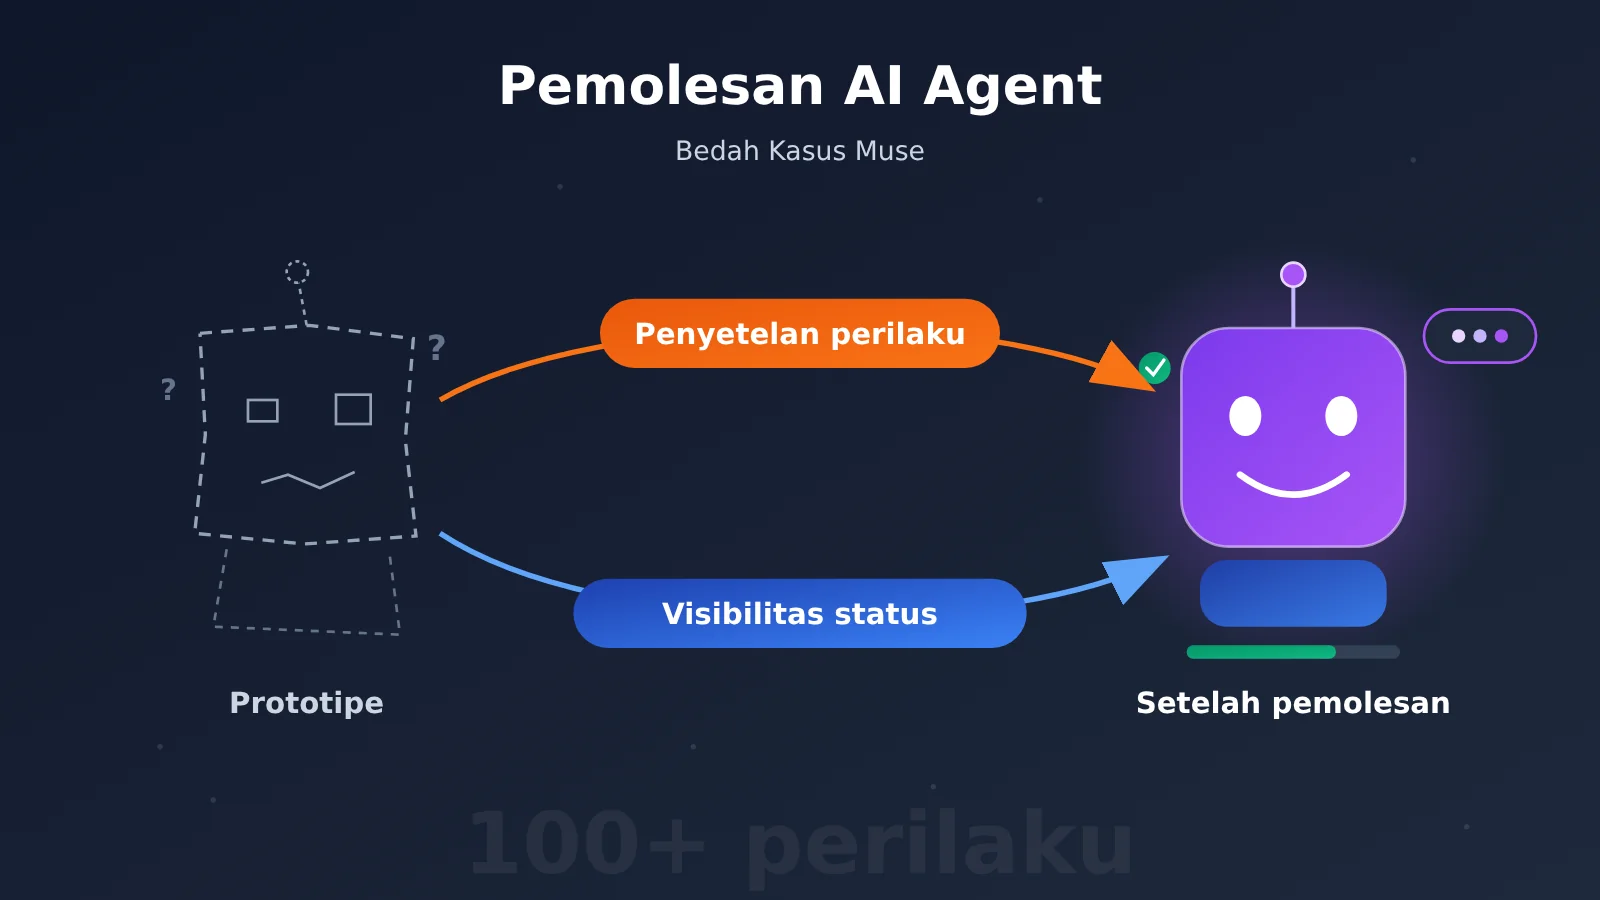
Ini bukan artikel opini kosong lain yang mengatakan “detail menentukan segalanya”. Menurut laporan publik, tim Muse menguji dan menyesuaikan lebih dari seratus perilaku model yang spesifik sebelum peluncuran, dan membuat avatar menunjukkan secara langsung apa yang sedang dilakukan agen saat itu melalui ekspresi dan gerakan. Kedua hal ini dapat dipecah menjadi tugas rekayasa yang konkret.
Nilai inti: Setelah membaca artikel ini, Anda dapat mengubah “pemolesan” menjadi daftar periksa perilaku, tabel sinyal status, dan alur pengujian, lalu langsung menerapkannya pada produk agen AI Anda.
Latar belakang penyempurnaan AI agent: mengapa Muse layak dibedah
Sebagai awalan, mari kita bahas konteks kasusnya. Menurut laporan, divisi Reality Labs Meta yang menangani VR/AR merugi sekitar 19,2 miliar dolar AS hanya pada tahun 2025 saja, dan jalur metaverse secara umum dipandang publik sebagai kegagalan yang sangat mahal. Setelah itu Zuckerberg tidak menyusut kembali ke bisnis utama iklan, melainkan terus berinvestasi di arah AI agent. Muse diluncurkan sekitar enam minggu lalu, dan menurut laporan jumlah penggunanya sudah mencapai 10 juta.
Ada dua detail dari proyek ini yang berkaitan langsung dengan “penyempurnaan”. Pertama, tim dipimpin oleh Alexander Wang dan Nat Friedman yang berasal dari Scale AI; menurut penuturan Wang sendiri, jalur model dan jalur produk jika digabung berjumlah kurang dari 200 orang. Tim kecil ini memang disengaja, tujuannya untuk menghindari kompromi dan ketidakkonsistenan pengalaman yang muncul ketika tim besar mengambil keputusan berdasarkan konsensus. Kedua, Muse tidak diposisikan sebagai “model terpintar di pasaran”; keunggulannya terletak pada menyempitnya jarak antara “apa yang secara teknis bisa dilakukan model” dan “bagaimana rasanya bagi orang biasa saat benar-benar memakainya”, misalnya tugas sehari-hari seperti membatalkan langganan dan memantau tagihan.
Bagi developer, pendapatan dan skala Muse tidak terlalu penting sebagai acuan. Yang layak dijadikan acuan adalah cara Muse memahami “penyempurnaan”: penyempurnaan adalah sekumpulan perilaku konkret yang bisa diuji, bukan istilah pemasaran.
Poin inti penyempurnaan AI agent
Jika pendekatan Muse diabstraksikan, penyempurnaan AI agent dapat dikelompokkan ke dalam beberapa arah berikut:
| Poin | Penjelasan | Manfaat bagi pengguna |
|---|---|---|
| Penyetelan perilaku | Menguji dan menyesuaikan perilaku model secara spesifik satu per satu sebelum peluncuran (Muse lebih dari seratus item) | Reaksi agent dapat diprediksi, tidak berubah-ubah |
| Batas keputusan | Memperjelas situasi mana yang dijalankan sendiri dan mana yang harus ditanyakan kepada pengguna lebih dulu | Lebih sedikit gangguan, sekaligus tidak melampaui kewenangan |
| Visibilitas status | Menampilkan apa yang sedang dilakukan agent melalui sinyal visual atau teks | Pengguna tidak perlu menebak “apakah ia paham, apakah ia sedang bekerja” |
| Konsistensi pengalaman | Perilaku tetap konsisten di berbagai titik masuk dan halaman | Gesekan kecil tidak menumpuk menjadi biaya penggunaan yang terasa |
| Kasus tepi | Menangani error, interupsi, tab kedua dan ketiga dengan serius | Tetap nyaman saat digunakan berulang kali sehari-hari |
Poin utama penyempurnaan AI agent 1: penyetelan perilaku bukan berarti “model lebih pintar”
“Model sangat pintar” dan “agent sangat berguna” adalah dua hal yang berbeda. Model dengan kemampuan tinggi tetap bisa membuat pengguna kesal jika tidak tahu kapan harus berhenti untuk meminta konfirmasi, kapan bisa langsung bertindak, dan bagaimana melaporkan progres. Lebih dari seratus perilaku yang disetel oleh tim Muse terutama mencakup hal-hal ini.
Objek penyetelan perilaku adalah cara bereaksi dalam konteks tertentu, bukan parameter model. Misalnya, ketika pengguna berkata “tolong batalkan langganan itu”, apakah agent harus lebih dulu menampilkan langganan yang ditemukan dan meminta konfirmasi, atau langsung mengeksekusi? Saat mencapai halaman pembayaran, apakah perlu konfirmasi sekali lagi? Setiap titik keputusan seperti ini adalah perilaku yang perlu diuji dan ditetapkan.
Poin utama penyempurnaan AI agent 2: visibilitas status adalah pekerjaan desain
Avatar Muse akan menampilkan animasi kecil untuk memberi tahu bahwa ia sedang mengerjakan tugas saat ini; pengguna tidak perlu membaca pesan status teknis. Ini menjawab pertanyaan yang dimiliki setiap orang yang menyerahkan tugas kepada AI: apakah ia memahami maksud saya? Apakah ia benar-benar mengerjakannya?
Menghilangkan rasa tidak pasti ini termasuk pekerjaan desain, dan harus mencakup setiap sudut produk, bukan hanya dalam alur demo. Menurut laporan, sebelum merilis aplikasi ponsel, Meta telah mengembangkan teknologi pembuatan ekspresi wajah dan gerakan yang tersinkronisasi dengan suara, sebagai persiapan untuk pengalaman suara real-time dan perangkat wearable di masa depan. Sebagian besar perusahaan menunda lapisan ini sampai “ide inti tervalidasi”, tetapi Muse mengerjakannya lebih awal.
Memoles AI agent dengan cepat: 6 langkah praktis
Berikut cara mengadaptasi pendekatan Muse menjadi alur kerja yang bisa dijalankan tim kecil dan menengah. Tidak perlu ratusan orang, tidak perlu anggaran ratusan miliar — yang dibutuhkan adalah kesabaran untuk terus mengerjakan “putaran kedua, putaran ketiga”.
Langkah 1: Susun daftar perilaku AI agent
Mulailah dengan mendaftar titik-titik keputusan yang akan dihadapi agent dalam tugas nyata, lalu tuliskan dengan jelas untuk setiap item: “kondisi pemicu, perilaku yang diharapkan, dan contoh kasus yang salah”. Di awal, cukup daftarkan 30 sampai 50 item, setelah itu terus tambahkan seiring umpan balik dari pengujian. Berikut referensi kategorinya:
| Kategori perilaku | Titik keputusan tipikal | Standar pemolesan |
|---|---|---|
| Konfirmasi niat | Instruksi ambigu, misalnya “batalkan langganan itu” | Jika ada beberapa kandidat, tampilkan agar pengguna memilih, jangan menebak sendiri |
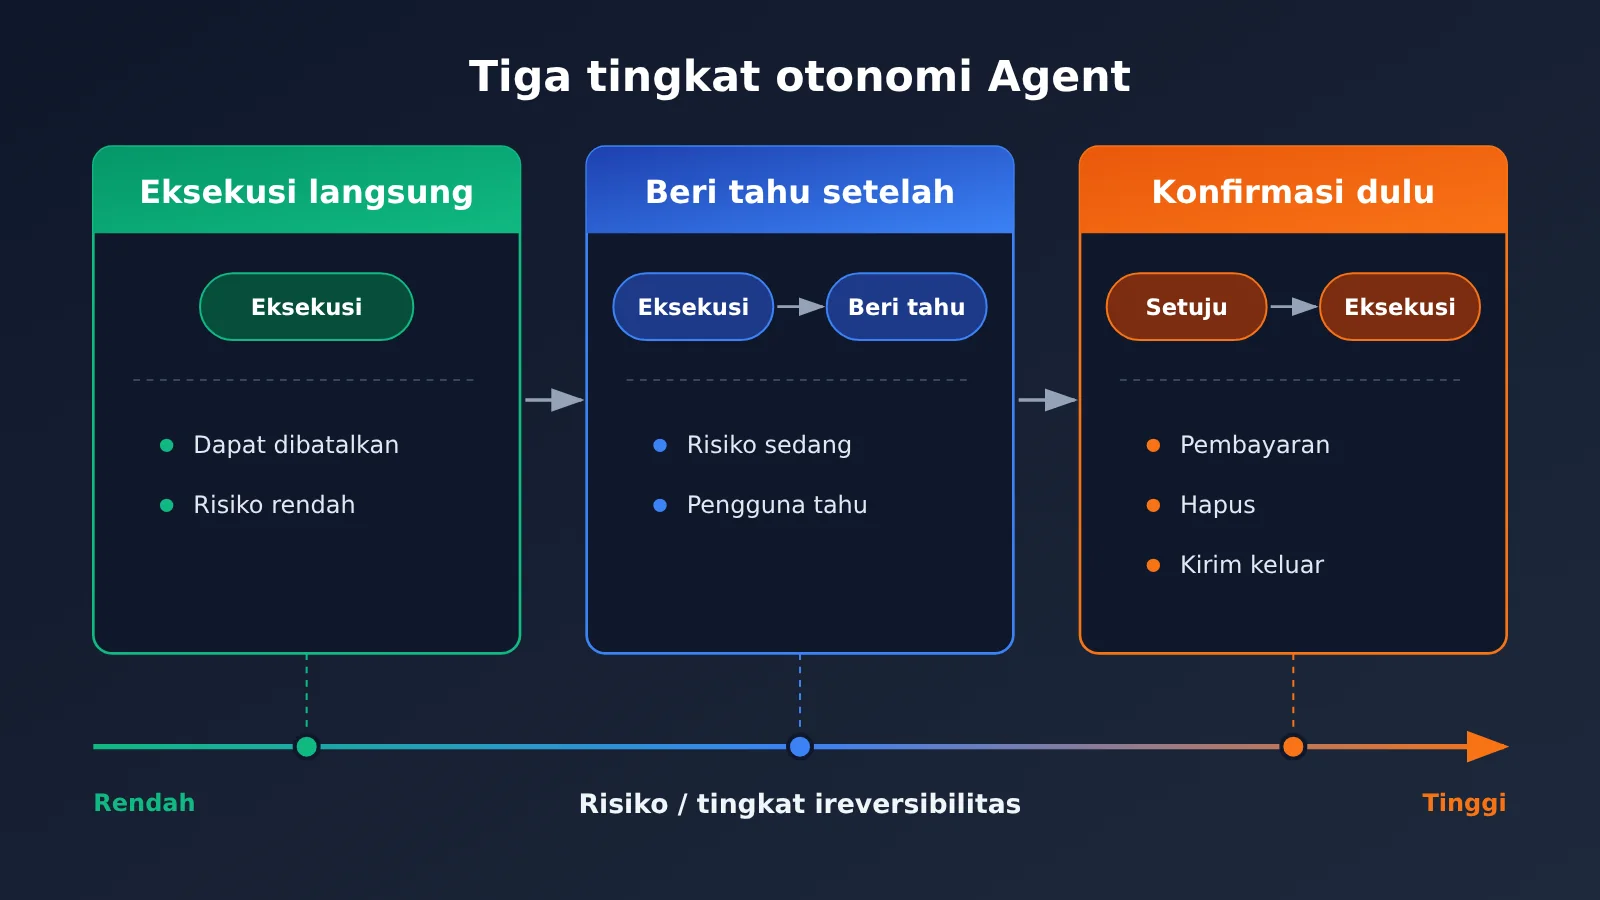
| Eksekusi mandiri | Operasi berisiko rendah yang bisa dibatalkan | Langsung jalankan, lalu beri ringkasan singkat setelah selesai |
| Pencegahan risiko tinggi | Melibatkan pembayaran, penghapusan, pengiriman ke pihak luar | Wajib konfirmasi ulang, dan jelaskan konsekuensinya |
| Pelaporan progres | Tugas multi-langkah yang memakan waktu lama | Berikan umpan balik yang terlihat di setiap langkah kunci |
| Penanganan kegagalan | Situs web tidak bisa dibuka, izin tidak memadai | Jelaskan penyebab dan saran langkah berikutnya, jangan gagal secara diam-diam |
| Penutupan tugas | Tugas selesai | Berikan sinyal “selesai” yang jelas dan ringkasan hasil |
Langkah 2: Menetapkan batas antara otonomi dan konfirmasi AI agent
Setelah daftar disusun, tetapkan “tingkat otonomi” untuk setiap jenis operasi. Pembagian yang umum adalah tiga tingkat: eksekusi langsung, eksekusi lalu beri tahu, dan konfirmasi sebelum eksekusi. Dasar penilaiannya terutama dua hal: apakah operasi bisa dibatalkan, dan seberapa besar biaya jika gagal.
Langkah ini paling rentan menimbulkan perbedaan pendapat di dalam tim. Inilah alasan Muse menggunakan tim kecil: masalah batas perlu ada satu orang yang bertanggung jawab atas keseluruhan pengalaman dan mengambil keputusan, tidak bisa dibiarkan setiap modul memutuskan sendiri dengan cara yang “masuk akal secara lokal”. Kalau tidak, akan muncul situasi di mana operasi yang sama minta konfirmasi di halaman A, tapi langsung dieksekusi di halaman B.
Langkah 3: Memetakan status internal AI agent menjadi sinyal yang terlihat oleh pengguna
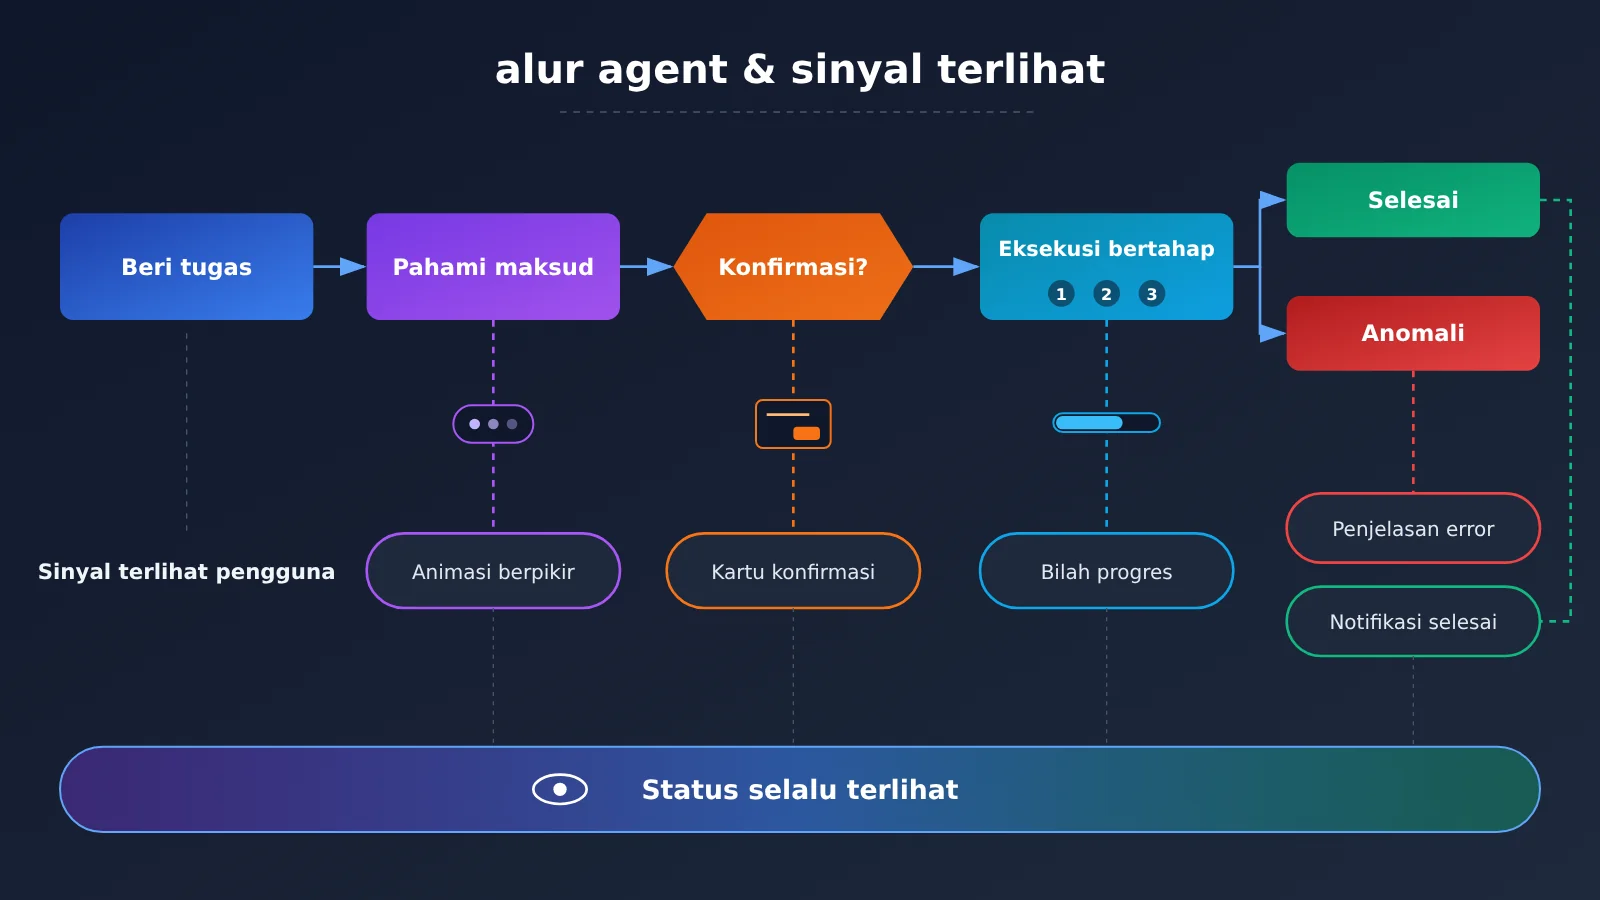
Agent punya banyak status internal, tapi pengguna hanya peduli pada beberapa saja. Praktiknya adalah menggabungkan status internal menjadi 5 sampai 6 status yang bisa dipahami pengguna, lalu merancang sinyal tetap untuk setiap status:
| Status internal agent | Sinyal yang terlihat pengguna | Contoh kesalahan umum |
|---|---|---|
| Mengurai maksud / merencanakan | Animasi berpikir atau “sedang memahami kebutuhan Anda” | Layar kosong beberapa detik, pengguna mengira macet |
| Memanggil alat / mengakses layanan eksternal | Menampilkan nama langkah saat ini, seperti “sedang membuka halaman langganan” | Menampilkan nama alat mentah atau JSON secara langsung |
| Menunggu konfirmasi pengguna | Menyorot kartu konfirmasi, tuliskan konsekuensinya | Menyembunyikan pertanyaan konfirmasi di dalam balasan panjang |
| Sedang mengeksekusi (multilangkah) | Progres per langkah, tandai yang sudah selesai dan sedang berjalan | Hanya ada satu ikon berputar |
| Selesai | Tanda selesai yang jelas dan ringkasan hasil | Balasan berakhir, tapi tidak bilang apakah tugas berhasil |
| Error / terputus | Jelaskan penyebab dengan bahasa manusia dan opsi tindakan | Error teknis, atau tidak ada umpan balik sama sekali |
Secara teknis, Anda bisa memanfaatkan output streaming dari antarmuka model untuk menggerakkan sinyal-sinyal ini. Format yang kompatibel dengan OpenAI, setelah mengaktifkan stream, akan mengembalikan konten dan pemanggilan alat secara bertahap; event streaming format Anthropic Messages akan membedakan blok teks dan blok tool_use. Frontend cukup mendengarkan event-event ini dan beralih ke status terlihat yang sesuai, tidak perlu menunggu seluruh balasan selesai.
Langkah 4: Merancang set pengujian perilaku AI agent
Setiap perilaku harus memiliki kasus uji yang sesuai, setidaknya mencakup tiga situasi: “input normal, input ambigu, lingkungan abnormal”. Saat menguji, jangan hanya melihat apakah jawabannya benar, tetapi juga perhatikan:
- Apakah ada konfirmasi di tempat yang seharusnya dikonfirmasi, dan apakah ada pertanyaan berlebihan di tempat yang seharusnya tidak mengganggu;
- Apakah sinyal status muncul tepat waktu di setiap tahap;
- Apakah perilaku konsisten ketika tugas yang sama dimulai dari berbagai pintu masuk;
- Setelah terjadi kesalahan, apakah pengguna dapat memahami dan mengetahui langkah selanjutnya yang harus dilakukan.
Sebaiknya set pengujian ini dibekukan, dan setiap kali mengubah petunjuk, mengganti model, atau menyesuaikan alat, jalankan seluruh rangkaian pengujian secara lengkap, agar tidak terjadi perbaikan satu hal tetapi merusak tiga hal lainnya.
Langkah 5: Melakukan perbandingan pada berbagai model dasar AI agent
Muse menjelaskan satu hal: nilai dari lapisan penyempurnaan tidak bergantung pada “model terkuat”. Daftar perilaku yang sama akan menunjukkan performa berbeda pada model yang berbeda, sehingga perlu perbandingan horizontal untuk menemukan kombinasi yang memenuhi standar perilaku dengan biaya yang sesuai.
| Tahap penyempurnaan | Kebutuhan utama terhadap model | Pendekatan pemilihan | Platform yang tersedia |
|---|---|---|---|
| Parsing niat dan perencanaan | Penalaran stabil, mengikuti instruksi | Prioritaskan model unggulan atau model penalaran | APIYI apiyi.com, API resmi |
| Eksekusi pemanggilan alat | Format pemanggilan fungsi stabil | Pilih model dengan performa pemanggilan alat yang andal | APIYI apiyi.com, API resmi |
| Teks progres / pemberitahuan status | Respons cepat, biaya rendah | Pilih model ringan dan cepat | APIYI apiyi.com, API resmi |
| Evaluasi batch set pengujian | Volume besar, dapat direproduksi | Pilih model dengan rasio harga-kinerja tinggi sebagai penilai | APIYI apiyi.com, API resmi |
🎯 Saran teknis: Saat melakukan perbandingan multi-model, Anda dapat memanggil secara terpadu melalui APIYI apiyi.com. APIYI menyediakan API Model Bahasa Besar utama yang dibahas dalam artikel ini, sekaligus kompatibel dengan dua format antarmuka yaitu OpenAI dan Anthropic. Dengan kode agent yang sama, cukup mengganti parameter
modeluntuk membandingkan, tanpa perlu menulis lapisan adaptasi terpisah untuk setiap vendor. Cara integrasi dan alamat antarmuka mengacu pada pusat dokumentasi APIYI di docs.apiyi.com.
Langkah 6: Terus lakukan “putaran kedua dan ketiga” pada pengalaman AI agent
Di materi referensi ada sebuah perumpamaan: merenovasi tampak depan restoran saja tidak cukup, kamar mandinya juga harus dibersihkan. Alat AI sekarang bisa dengan cepat menghasilkan versi pertama yang cantik, dan justru itu yang membuat orang cenderung terus membuat versi pertama baru, bukan memperbaiki bagian produk yang sudah ada—bagian yang “bisa dipakai tapi tidak nyaman digunakan”.
Saran saya, setiap minggu pilih dari catatan penggunaan nyata potongan-potongan saat pengguna ragu, mengulang pertanyaan, atau berhenti di tengah jalan, lalu kembali ke Langkah 1 untuk melengkapi daftar perilaku. Produk yang benar-benar sering dipakai justru lahir dari putaran kedua dan ketiga yang tidak mencolok ini.
💰 Catatan biaya: Kumpulan tes perilaku perlu dijalankan berulang kali, jadi volume pemanggilannya tidak sedikit. Untuk harga input dan output tiap model serta cara perhitungan biaya cache, silakan mengacu pada data aktual di halaman harga APIYI https://docs.apiyi.com/models. Artikel ini tidak mencantumkan harga spesifik.
Perbandingan pendekatan penyempurnaan AI agent
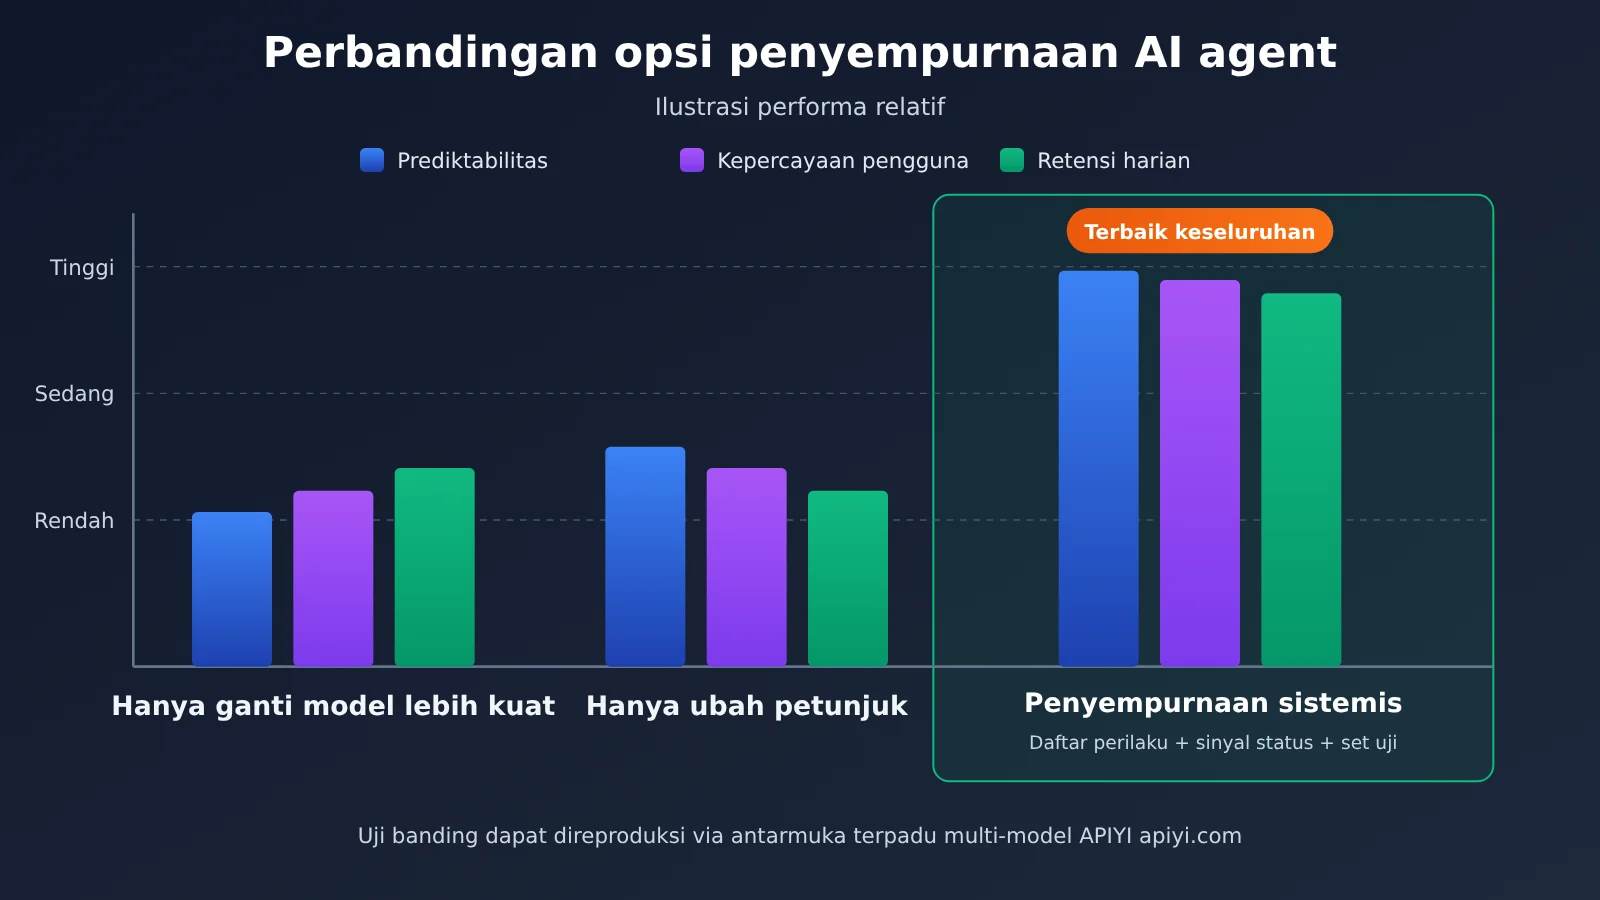
| Pendekatan | Praktik inti | Skenario penggunaan | Keterbatasan utama |
|---|---|---|---|
| Hanya ganti model yang lebih kuat | Tingkatkan model dasar, berharap pengalaman membaik dengan sendirinya | Prototipe awal yang kemampuannya jelas kurang | Biaya naik, masalah perilaku seperti konfirmasi dan pelaporan tetap ada |
| Hanya ubah petunjuk | Menumpuk aturan di dalam petunjuk sistem | Perbaikan kecil untuk masalah tertentu | Aturan makin menumpuk dan berantakan, mudah saling bertentangan saat tidak ada tes |
| Penyempurnaan sistematis | Daftar perilaku + batas otonomi + sinyal status + kumpulan tes | Agent berbasis tugas harian untuk pengguna nyata | Investasi awal besar, perlu orang khusus yang bertanggung jawab atas keseluruhan pengalaman |
Interpretasi pembanding pendekatan penyempurnaan AI agent
Analisis pembanding “hanya ganti model”: Model yang lebih kuat memang unggul dalam penalaran kompleks, tetapi ia tidak tahu sendiri operasi mana di produk Anda yang harus dikonfirmasi lebih dulu atau bagaimana progres harus ditampilkan. Sebaliknya, penyempurnaan sistematis langsung menangani gesekan yang dirasakan pengguna. Muse pun tidak bergantung pada model terkuat, tapi tetap mencatat pertumbuhan awal yang baik—itu salah satu buktinya.
Analisis pembanding “hanya ubah petunjuk”: Menambal petunjuk cepat terasa hasilnya dan cocok untuk menyelesaikan masalah titik tunggal. Tapi tanpa daftar perilaku dan kumpulan tes, aturan mudah saling bertentangan: satu hal diperbaiki, hal lain ikut terkena. Untuk agent yang akan dioperasikan jangka panjang, penyempurnaan sistematis lebih aman.
💡 Catatan perbandingan: Perbedaan pendekatan di atas sebaiknya diverifikasi pada data bisnis Anda sendiri. Anda bisa menjalankan pengujian pembanding dengan kumpulan tes yang sama pada beberapa model melalui APIYI apiyi.com, lalu menilai hasil terhadap biaya dengan bantuan data di halaman harga.
FAQ Pertanyaan Umum Seputar Penyempurnaan AI Agent
Q1: Apa sebenarnya yang dimaksud dengan penyempurnaan AI agent?
Maksudnya adalah menguji perilaku agent dalam tugas nyata satu per satu, lalu menyesuaikan dan mematikannya menjadi tetap—termasuk kapan harus mengonfirmasi, kapan harus menjalankan secara mandiri, bagaimana melaporkan progres, dan bagaimana menjelaskan saat terjadi kesalahan—sekaligus membuat pengguna selalu bisa melihat status agent saat itu. Ini adalah kerja rekayasa yang dapat diuji, bukan sekadar “mengoptimalkan pengalaman” secara umum.
Q2: Apa perbedaan antara penyetelan perilaku dan rekayasa petunjuk?
Rekayasa petunjuk adalah salah satu caranya, sedangkan penyetelan perilaku adalah tujuan dan metodologinya. Penyetelan perilaku pertama-tama mendefinisikan “daftar perilaku yang diharapkan” dan set pengujian, lalu mewujudkannya melalui berbagai cara seperti petunjuk, desain alat, interaksi front-end, serta melakukan verifikasi regresi secara terus-menerus. Hanya mengubah petunjuk tanpa membangun set pengujian akan sulit menjamin konsistensi.
Q3: Bagaimana skala pengguna dan skala tim Muse?
Menurut laporan, Muse mencapai 10 juta pengguna sekitar enam minggu setelah diluncurkan. Menurut Alexander Wang, tim model dan produk secara keseluruhan berjumlah kurang dari 200 orang. Untuk skala miliaran pengguna yang biasa ditangani Meta, ini baru pencapaian awal; ke depannya masih perlu menurunkan biaya layanan dan memperluas skala.
Q4: Skenario agent apa yang paling cocok untuk visibilitas status?
Terutama cocok untuk skenario berikut:
– **Tugas berbasis to-do**: operasi multi-langkah seperti membatalkan langganan, melacak tagihan, dan mengisi formulir;
– **Tugas yang memakan waktu**: perlu mengakses beberapa situs web atau memanggil beberapa alat, sehingga waktu eksekusinya lebih lama;
– **Operasi berisiko tinggi**: alur yang melibatkan pembayaran, penghapusan, atau pengiriman ke pihak luar yang memerlukan konfirmasi eksplisit dari pengguna.
Q5: Bagaimana cara cepat membangun lingkungan pengujian penyempurnaan agent multi-model?
Anda bisa mengikuti langkah-langkah berikut:
1. Daftar di APIYI apiyi.com dan dapatkan kunci API;
2. Lihat pusat dokumentasi docs.apiyi.com, lalu integrasikan sesuai format kompatibel OpenAI atau Anthropic;
3. Gunakan set pengujian perilaku yang sama, bergantian mengganti parameter `model` untuk menjalankan perbandingan;
4. Kombinasikan dengan data penagihan aktual di halaman harga https://docs.apiyi.com/models untuk memilih kombinasi model yang sesuai.
Q6: Apa saja biaya dan keterbatasan dari penyempurnaan yang sistematis?
– **Investasi awal**: membangun daftar perilaku dan set pengujian membutuhkan waktu, sehingga dalam jangka pendek tidak terlihat adanya “fitur baru”;
– **Biaya pemanggilan**: pengujian regresi akan memanggil model berulang kali, dan penagihan mengacu pada halaman harga platform yang digunakan;
– **Persyaratan organisasi**: perlu ada seseorang yang mengambil keputusan akhir atas pengalaman keseluruhan, jika tidak aturan batas akan menjadi tidak konsisten karena kompromi dari berbagai pihak;
– **Keterbatasan**: penyempurnaan tidak dapat menutupi kekurangan mendasar pada kemampuan model; ketika kemampuan jelas tidak memadai, tetap perlu mengganti model.
Poin-Poin Utama dalam Menyempurnakan AI Agent (Key Takeaways)
- Penyempurnaan bisa diuji: Sebelum Muse dirilis, lebih dari seratus perilaku model spesifik telah disesuaikan;
- Mudah dipakai bukan berarti paling pintar: Keunggulan Muse adalah mengurangi friksi penggunaan, bukan kemampuan model yang paling unggul;
- Batas harus diputuskan oleh manusia: Aturan untuk eksekusi otonom dan konfirmasi terlebih dahulu perlu diseragamkan, tidak boleh setiap modul memutuskan sendiri;
- Status harus terlihat: Gunakan sinyal untuk menjawab pertanyaan pengguna “apakah ia sudah paham, sedang mengerjakan, atau sudah selesai”;
- Detail pinggiran sama pentingnya: Penanganan error, interupsi, tab kedua, dan alur demo diperlakukan setara;
- Perbandingan multi-model lebih stabil: Lewat antarmuka terpadu APIYI, bandingkan berbagai model dengan set pengujian yang sama.
Ringkasan
Poin-poin inti dalam menyempurnakan AI agent:
- Penyetelan perilaku: Susun titik-titik keputusan menjadi daftar periksa, setiap item mencantumkan kondisi pemicu, perilaku yang diharapkan, dan contoh kontra, lalu lakukan regresi berkelanjutan dengan set pengujian;
- Visibilitas status: Gabungkan status internal menjadi beberapa sinyal yang bisa dipahami pengguna, mencakup seluruh alur pemahaman, eksekusi, konfirmasi, penyelesaian, dan kesalahan;
- Iterasi berkelanjutan: Temukan titik friksi dari catatan penggunaan nyata, tekun mengerjakan versi kedua dan ketiga, bukan terus mengulang versi pertama.
Pengalaman Muse juga berlaku untuk tim kecil dan menengah: tim kecil yang bertanggung jawab atas keputusan kunci, menganggap serius detail yang membosankan, dan setelah gagal mengubah hal yang benar-benar penting lalu mencoba lagi. Semua ini tidak perlu kehilangan puluhan miliar dulu.
Jika Anda siap membangun set pengujian perilaku untuk agent Anda sendiri, Anda bisa dengan cepat membandingkan berbagai model melalui APIYI apiyi.com. Platform ini kompatibel dengan format antarmuka OpenAI dan Anthropic, petunjuk integrasi ada di docs.apiyi.com, dan penagihan mengacu pada halaman harga https://docs.apiyi.com/models.
📚 Referensi
- MindStudio – Studi Kasus Meta’s Muse: Latar belakang Muse, tim, dan detail penyempurnaannya
- Tautan:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
Keterangan: Sumber utama fakta kasus dalam artikel ini, diterbitkan pada 4 November 2026
-
Pusat Dokumentasi APIYI: Panduan integrasi terpadu berbagai model
- Tautan:
docs.apiyi.com -
Keterangan: Cara integrasi dengan format kompatibel OpenAI dan Anthropic
-
Halaman Harga Model APIYI: Skema penagihan dan harga satuan tiap model
- Tautan:
docs.apiyi.com/models - Keterangan: Harga input, output, dan cache mengacu pada data aktual di halaman ini
Penulis: Tim Teknis APIYI
Diskusi Teknis: Silakan hubungi kami melalui situs resmi APIYI di apiyi.com untuk berdiskusi seputar praktik penyempurnaan agent, materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com