Catatan penulis: Berangkat dari uji publik tiga Agent personal, artikel ini membedah masalah lapisan antarmuka di balik kelemahan eksekusi Agent, sekaligus menyajikan daftar perbaikan untuk pemanggilan tool, retry yang toleran terhadap kesalahan, kompatibilitas format, dan kontrol biaya.
Pada 4 November 2026, 36Kr menerbitkan 《个人Agent上桌,谁先露了怯?》, yang menempatkan tiga Agent personal di meja yang sama untuk diuji secara langsung. Kesimpulan dari uji silang semacam ini biasanya cukup konsisten: Agent tidak kekurangan kemampuan “berbicara”, yang kurang adalah kemampuan “menyelesaikan pekerjaan”. Fokus utama artikel ini adalah kelemahan eksekusi Agent sebagian besar berasal dari lapisan antarmuka, bukan semata-mata dari modelnya sendiri.
Ini bukan artikel peringkat “Agent mana yang lebih pintar” lainnya. Kami tidak mengulang skor spesifik dari artikel asli, melainkan merangkum kegagalan eksekusi yang umum muncul dalam uji semacam itu menjadi 5 kategori, lalu memetakannya satu per satu ke bagian desain antarmuka Agent yang bisa diperbaiki.
Nilai inti: Setelah membaca artikel ini, Anda akan tahu parameter antarmuka mana yang perlu diperiksa lebih dulu saat membangun Agent sendiri, bagaimana menangani kegagalan, serta bagaimana beralih dengan mulus antara dua format antarmuka, yaitu OpenAI dan Anthropic.
Poin Inti Kelemahan Eksekusi Antarmuka Agent
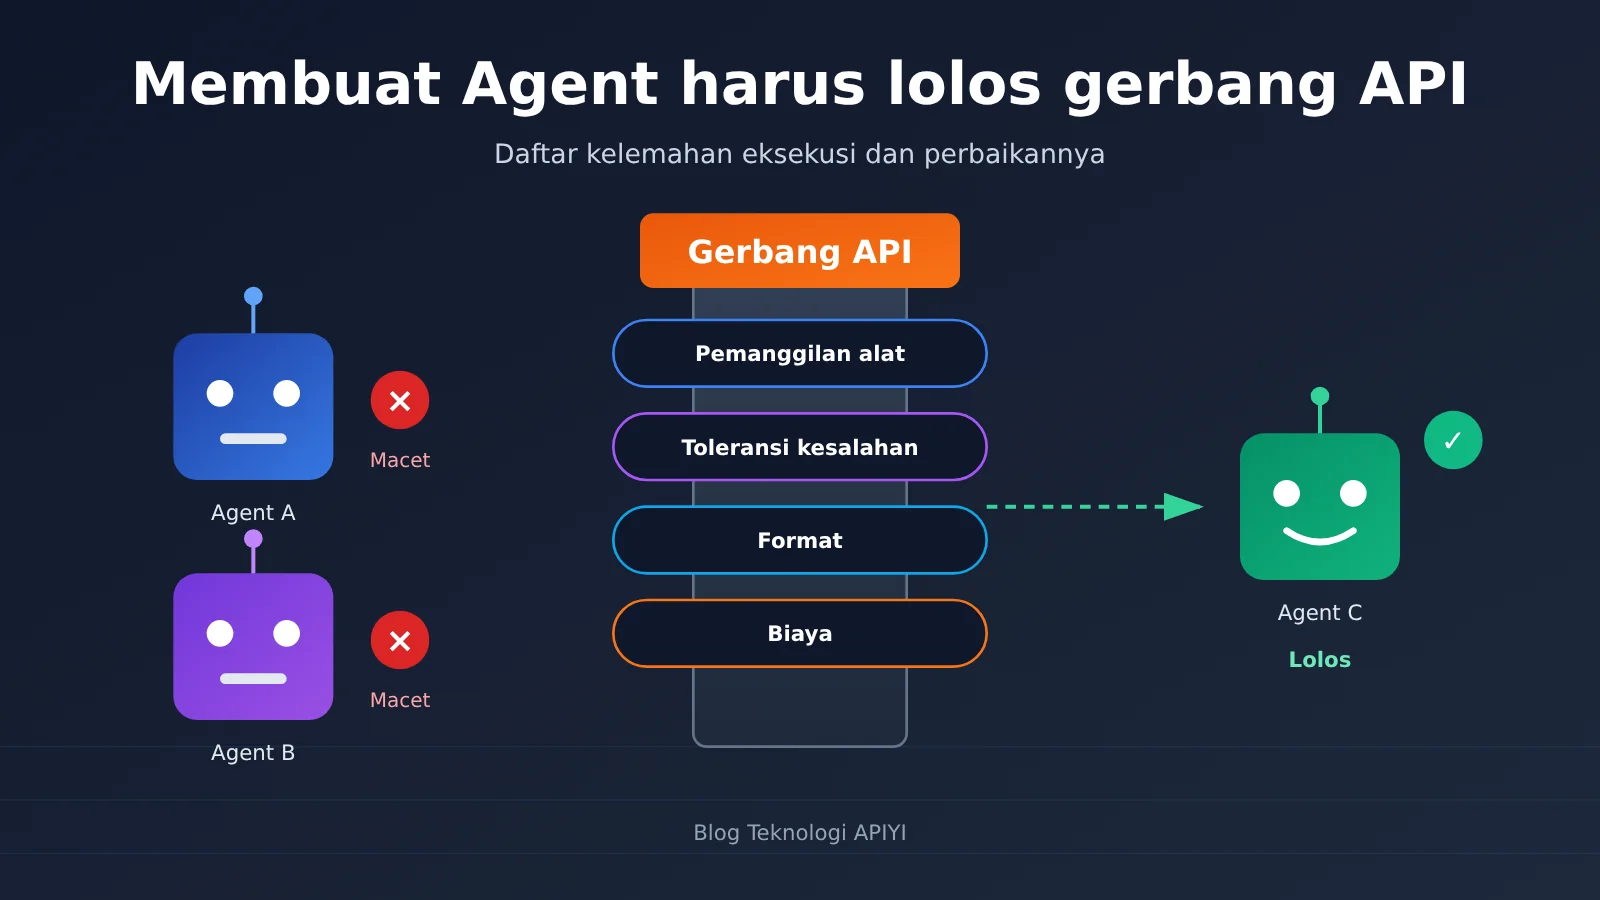
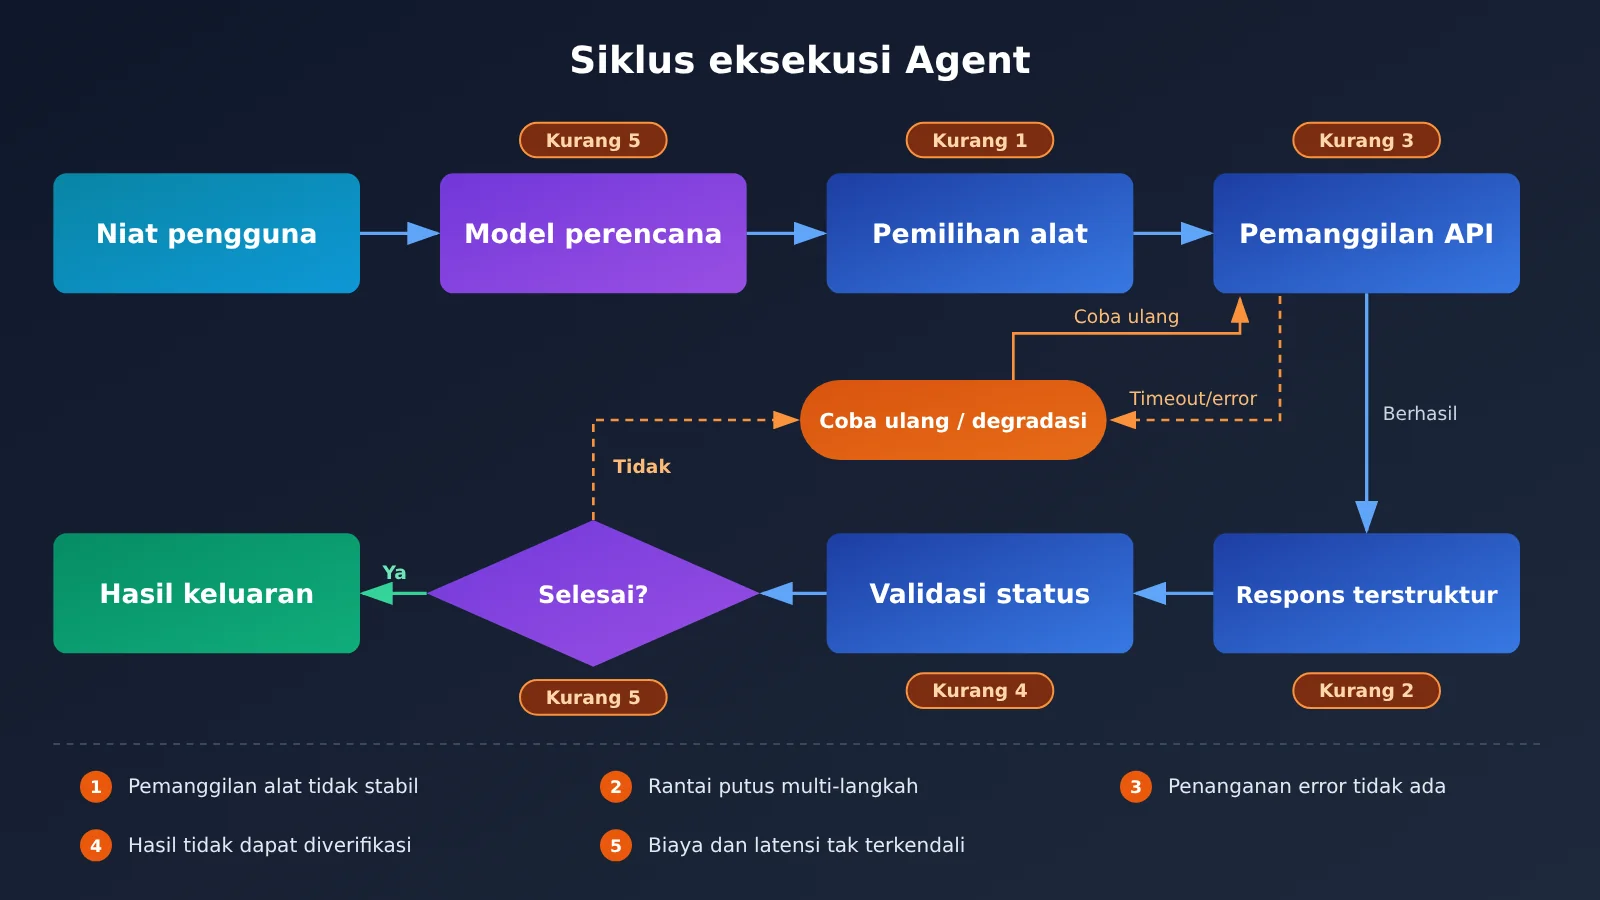
Tujuan Agent pribadi adalah menyelesaikan seluruh tugas untuk pengguna, misalnya memesan tiket, merapikan email, merangkum materi, atau mengoperasikan halaman web. Jika satu langkah di tengah gagal, yang dirasakan pengguna adalah “tugasnya belum selesai”. Jika kita telusuri fenomena kegagalan umum dalam pengujian nyata, hampir semuanya bermuara pada 5 jenis masalah antarmuka berikut.
| Kelemahan Eksekusi | Gejala Umum | Akar Masalah di Lapisan Antarmuka | Arah Perbaikan |
|---|---|---|---|
| Pemanggilan alat tidak stabil | Memilih alat yang salah, parameter kurang field, format tidak valid | Deskripsi alat kabur, schema tidak membatasi | Rampingkan set alat, tulis schema parameter yang ketat |
| Rantai tugas multi-langkah terputus | Di langkah ketiga atau keempat lupa tujuan | Manajemen konteks kasar, hasil alat tidak dikembalikan dengan benar | Standarkan riwayat pesan, ringkas hasil antara |
| Kegagalan eksternal tanpa fallback | Menyerah begitu kena rate limit atau timeout, atau mengklaim selesai padahal tidak | Tidak membedakan jenis error, tidak ada strategi retry | Retry berjenjang berdasarkan status code, tambahkan timeout dan degradasi |
| Hasil tidak dapat diverifikasi | Membalas “selesai”, padahal tidak melakukan apa pun | Tidak ada tanda terima eksekusi dan validasi status | Setiap langkah memerlukan tanda terima terstruktur |
| Biaya dan latensi tak terkendali | Pemanggilan berulang, satu tugas menghabiskan banyak token | Tidak ada batas langkah, tidak memanfaatkan cache | Tetapkan jumlah putaran maksimum, gunakan model berlapis, manfaatkan cache |
Penjelasan Rinci Kelemahan Antarmuka Agent
Dua jenis kelemahan pertama terlihat seperti masalah kemampuan model, tetapi sebenarnya sebagian besar bisa diselesaikan dengan pendekatan engineering. Pemanggilan alat yang tidak stabil paling sering disebabkan karena memberi model puluhan alat sekaligus dengan deskripsi yang saling tumpang tindih, sehingga model tentu memilih dengan salah. Rampingkan alat ke cakupan yang benar-benar dibutuhkan tugas saat ini, tulis tipe, nilai enum, dan status wajib untuk setiap parameter, biasanya tingkat error akan turun secara signifikan. Rantai multi-langkah yang terputus sering kali muncul pada pengembalian hasil alat: jika hasil tidak diikat ke ID pemanggilan yang sesuai menurut protokol, model tidak dapat memastikan apakah langkah sebelumnya benar-benar berhasil.
Tiga jenis kelemahan terakhir murni masalah engineering. Agent yang layak harus jelas tentang “apa yang harus dilakukan jika gagal” dan “bagaimana membuktikan tugas selesai”. Dalam pengujian nyata, hal yang paling mengecewakan pengguna bukanlah kegagalan itu sendiri, melainkan berpura-pura berhasil setelah gagal. Karena itu, mekanisme tanda terima dan klasifikasi error di lapisan antarmuka lebih berguna daripada mengganti ke model yang lebih besar.
Panduan Cepat Antarmuka Agent: Daftar Periksa 5 Langkah
Langkah-langkah berikut tidak bergantung pada framework tertentu, jadi tetap berlaku baik Anda menulis loop Agent sendiri maupun memakai framework Agent yang sudah ada. Sesuai ketentuan artikel ini, tidak ada kode yang disertakan di sini; semua konfigurasi penting dijelaskan dalam tabel.
Langkah 1: Satukan Titik Masuk Antarmuka Agent
Agent biasanya memerlukan kombinasi “model kuat untuk perencanaan, model cepat untuk eksekusi”. Jika setiap model terhubung ke vendor yang berbeda, autentikasi, format error, dan skema penagihan akan berbeda-beda, sehingga biaya troubleshooting menjadi tinggi. Cara yang lebih praktis adalah menggunakan satu titik masuk terpadu yang kompatibel dengan format antarmuka OpenAI dan Anthropic; cukup ubah base_url, api_key, dan model untuk berganti model.
| Item konfigurasi | Fungsi | Nilai yang disarankan |
|---|---|---|
base_url |
Alamat antarmuka | Mengikuti dokumentasi penyedia layanan, misalnya alamat yang tercantum di dokumentasi APIYI docs.apiyi.com |
api_key |
Kredensial autentikasi | Simpan di variabel lingkungan, jangan masukkan ke petunjuk atau log |
model |
Nama model | Konfigurasikan perencanaan dan eksekusi secara terpisah agar mudah diganti sendiri-sendiri |
timeout |
Batas waktu satu permintaan | Sesuaikan dengan jenis tugas; untuk tugas dengan output panjang, longgarkan secukupnya |
max_retries |
Jumlah retry otomatis SDK | Jaga nilainya tetap kecil; lapisan bisnis melakukan retry bertingkat sendiri |
🚀 Mulai cepat: APIYI menyediakan pemanggilan API Model Bahasa Besar populer yang dibahas dalam artikel ini, serta kompatibel dengan dua format antarmuka OpenAI dan Anthropic. SDK yang sudah ada cukup mengubah
base_urluntuk terhubung. Petunjuk integrasi tersedia di pusat dokumentasi APIYI: docs.apiyi.com.
Langkah 2: Tulis parameter pemanggilan tool Agent dengan ketat
Pemanggilan tool adalah gerbang pertama daya eksekusi Agent. Semakin ketat parameter ditulis, semakin kecil ruang “improvisasi” model, dan semakin rendah pula tingkat kesalahannya.
| Parameter | Arti | Saran praktik |
|---|---|---|
tools |
Daftar tool yang dapat dipanggil | Dalam satu putaran, hanya ekspos tool yang dibutuhkan tahap saat ini; tulis deskripsi dengan jelas “kapan dipakai, kapan tidak dipakai” |
tool_choice |
Strategi pemilihan tool | Tentukan tool saat perlu memaksa eksekusi suatu aksi; atur ke otomatis untuk tanya-jawab terbuka |
| Skema parameter | Struktur parameter input tool | Tulis field wajib ke required; kalau bisa pakai enum, jangan pakai teks bebas |
response_format |
Output terstruktur | Balasan akhir diminta dalam struktur JSON agar mudah diverifikasi program |
max_tokens |
Batas atas output | Wajib pada format Anthropic, perlu diperkirakan sesuai task |
temperature |
Tingkat keacakan | Turunkan untuk langkah eksekusi, kurangi kasus input sama menghasilkan aksi berbeda |
Langkah 3: Tangani perbedaan format OpenAI dan Anthropic
Banyak Agent yang “tiba-tiba bodoh” setelah berganti model, padahal penyebabnya bukan model, melainkan protokol tool pada kedua format yang berbeda sehingga hasil balikannya salah posisi. Tabel berikut mencantumkan beberapa perbedaan yang paling rawan bikin masalah.
| Item perbandingan | Format OpenAI Chat Completions | Format Anthropic Messages |
|---|---|---|
| Posisi system prompt | Diletakkan di dalam messages dengan role system |
Memakai parameter system di level teratas |
| Definisi tool | type: function ditambah objek function |
name, description, input_schema |
| Model memulai pemanggilan | tool_calls di dalam pesan assistant |
Blok konten dengan tipe tool_use |
| Pengembalian hasil tool | Pesan dengan role tool yang membawa tool_call_id |
Blok konten tool_result di dalam pesan user, terkait dengan tool_use_id |
| Batas output | max_tokens opsional |
max_tokens wajib |
Kedua format tidak ada yang lebih unggul; yang penting adalah di dalam Agent hanya memelihara satu representasi perantara, lalu mengonversinya ke format yang sesuai saat请求 dikirim. Jika memakai gerbang yang kompatibel dengan kedua format sekaligus, misalnya APIYI, maka seri Claude bisa memakai format Anthropic native dan model lain memakai format OpenAI, masing-masing tetap mempertahankan kemampuan pemanggilan tool yang paling lengkap.
Langkah 4: Merancang fallback untuk kegagalan antarmuka Agent
“Dulu gagal, ya sudah menyerah” dan “gagal tapi pura-pura berhasil” adalah dua perilaku yang paling merusak pengalaman pengguna berdasarkan pengujian nyata. Cara yang benar adalah mengklasifikasikan dulu berdasarkan jenis error, baru memutuskan apakah akan retry, degradasi, atau memberi tahu pengguna apa adanya.
| Jenis error | Penyebab umum | Strategi penanganan Agent |
|---|---|---|
| Error parameter 400 | Parameter tool tidak valid, format pesan tidak sesuai | Jangan langsung retry membabi buta; kembalikan pesan error ke model agar memperbaikinya satu kali |
| Autentikasi 401 / 403 | Key kedaluwarsa atau izin kurang | Hentikan segera, minta pengguna memeriksa konfigurasi |
| Rate limit 429 | Konkurensi terlalu tinggi atau kuota habis | Retry dengan exponential backoff, bila perlu beralih ke model cadangan |
| Error server 5xx | Fluktuasi layanan upstream | Retry dalam jumlah terbatas, jika melewati batas lakukan degradasi |
| Timeout | Output panjang atau jaringan tidak stabil | Ubah ke output streaming, atau pecah tugas menjadi lebih kecil lalu retry |
Ada satu detail yang mudah terlewat: tool yang punya efek samping wajib bersifat idempoten. Operasi seperti mengirim email, membuat pesanan, atau menulis ke database harus dipastikan dulu apakah percobaan sebelumnya sudah berhasil sebelum retry, kalau tidak Agent akan melakukan hal yang sama dua kali.
Langkah 5: Beri Agent tanda terima dan gerbang biaya
Setiap tool yang selesai dieksekusi harus mengembalikan tanda terima terstruktur, minimal berisi tiga field: “berhasil atau tidak, apa yang dilakukan, dan identitas hasil kunci”. Sebelum Agent menyatakan tugas selesai, yang memverifikasi tanda terima harus program, bukan model — dengan begitu “klaim palsu selesai” bisa dicegah secara mekanis.
Untuk biaya, disarankan menambahkan tiga gerbang: jumlah putaran loop maksimum, anggaran token per tugas, dan deteksi pemanggilan berulang. Pekerjaan seperti perencanaan, eksekusi, dan klasifikasi bisa dibagi ke model dengan kelas berbeda; system prompt panjang dan definisi tool sebaiknya dijaga tetap stabil agar bisa memanfaatkan prompt caching. Untuk harga satuan input, output, dan cache yang konkret, serta dasar penghitungan biayanya, silakan mengacu pada data aktual di halaman harga APIYI https://docs.apiyi.com/models — artikel ini tidak mencantumkan angka harga apa pun yang belum terverifikasi.
💡 Saran: Pada tahap pembangunan, jalankan dulu seluruh siklus tertutup dengan trafik kecil, baru tambahkan tool secara bertahap. Melalui APIYI apiyi.com Anda bisa dengan cepat membandingkan stabilitas berbagai model dalam pemanggilan tool di bawah satu Key yang sama, dan beralih model cukup dengan mengubah field
model.
Referensi Pemilihan Antarmuka Agent Berdasarkan Lapisan
Agent dengan eksekusi yang kuat jarang hanya memakai satu model. Membagi berdasarkan lapisan tanggung jawab tidak hanya meningkatkan stabilitas, tetapi juga memudahkan pengendalian biaya.
| Lapisan Tanggung Jawab | Kebutuhan Kemampuan | Pendekatan Pemilihan | Platform yang Tersedia | Referensi Harga |
|---|---|---|---|---|
| Lapisan perencanaan | Konteks panjang, penalaran kompleks, pemecahan tugas | Pilih model flagship dengan kemampuan penalaran kuat | APIYI apiyi.com, API resmi | Mengacu pada halaman harga APIYI |
| Lapisan eksekusi | Pemanggilan tool yang stabil, respons cepat | Pilih model kelas menengah dengan performa pemanggilan tool yang stabil | APIYI apiyi.com, API resmi | Mengacu pada halaman harga APIYI |
| Lapisan ringan | Klasifikasi intent, validasi format, kompresi ringkasan | Pilih model kecil dengan latensi rendah dan biaya rendah | APIYI apiyi.com, API resmi | Mengacu pada halaman harga APIYI |
Untuk mengetahui model apa saja yang tersedia dan nama model terbaru, silakan lihat dokumentasi APIYI di docs.apiyi.com. Sebaiknya jalankan sekumpulan sampel dengan tugas nyata Anda sendiri, lalu hitung tingkat keberhasilan pemanggilan tool, rata-rata jumlah putaran, dan konsumsi per tugas, baru tentukan model untuk setiap lapisan. Jangan hanya melihat leaderboard publik.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa yang dimaksud dengan “gerbang antarmuka” pada Agent?
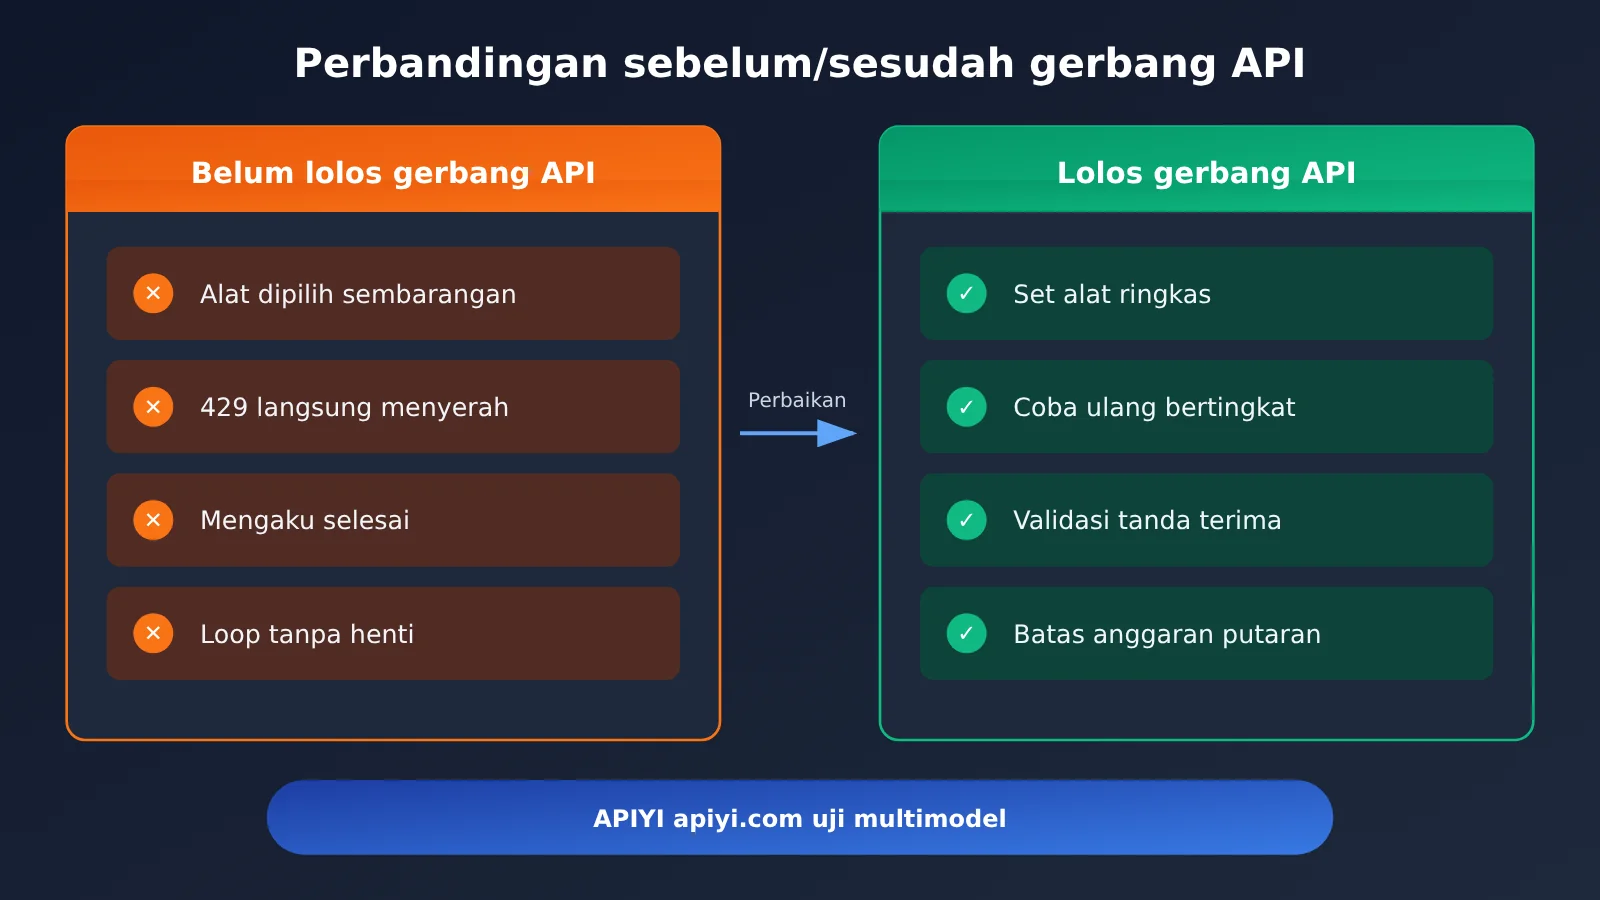
Ini merujuk pada lapisan rekayasa yang harus dilalui Agent antara “sudah berpikir jelas” dan “selesai mengerjakan”, mencakup definisi tool, protokol pemanggilan, penanganan error, tanda terima hasil, dan kontrol biaya. Model bertanggung jawab atas pengambilan keputusan, sementara lapisan antarmuka bertanggung jawab merealisasikan keputusan itu secara andal. Kalau gerbang ini tidak terlewati, model sekuat apa pun tetap akan tampil dengan eksekusi yang buruk.
Q2: Eksekusi yang buruk itu masalah model atau masalah antarmuka?
Keduanya ada, tetapi masalah antarmuka lebih sering diremehkan. Salah memilih tool, format parameter keliru, rantai yang terputus, hingga mengaku selesai padahal gagal — sebagian besar bisa diredam dengan memperketat schema, menstandarkan pengembalian hasil, dan menambah validasi tanda terima. Sebaiknya rapikan dulu lapisan antarmuka, baru kemudian menilai apakah benar-benar perlu ganti model.
Q3: Apa tren yang ditunjukkan uji coba tiga produk Agent personal?
Laporan uji coba 36氪 pada November 2026 menunjukkan bahwa Agent personal sudah masuk tahap “siapa yang benar-benar bisa menyelesaikan pekerjaan”, dengan titik fokus bergeser dari kualitas percakapan ke siklus eksekusi yang tertutup. Untuk performa spesifik tiap produk, silakan merujuk ke artikel aslinya; tulisan ini hanya mengambil pelajaran rekayasa yang bersifat umum.
Q4: Format OpenAI atau format Anthropic, pilih yang mana?
Pilih berdasarkan model. Seri Claude menggunakan format Anthropic native sehingga bisa memakai fitur tool calling dan caching secara penuh, sedangkan sebagian besar model lain lebih universal dengan format OpenAI. APIYI kompatibel dengan kedua format, sehingga Anda bisa memelihara representasi perantara yang seragam di dalam Agent, lalu mengonversinya sesuai model saat mengirim permintaan.
Q5: Bagaimana cara cepat menghubungkan Agent saya ke banyak model?
1. Daftar di APIYI apiyi.com dan dapatkan API Key;
2. Konfigurasikan `base_url` sesuai dokumentasi di docs.apiyi.com;
3. Isi `model` secara terpisah untuk lapisan perencanaan dan lapisan eksekusi, lalu lakukan uji perbandingan dengan kumpulan tugas yang sama.
Seluruh proses tidak memerlukan perubahan SDK, cukup menyesuaikan item konfigurasi.
Q6: Bagaimana memperkirakan biaya Agent, dan di mana melihat harganya?
Pertama hitung rata-rata jumlah putaran per tugas, token input, dan token output, lalu kalikan dengan harga satuan model yang bersangkutan. Harga input, output, cache, serta dasar penagihan mengacu pada data aktual di halaman harga APIYI https://docs.apiyi.com/models — perbedaannya cukup besar antar model, jadi pastikan menghitung berdasarkan halaman yang sebenarnya.
Q7: Semakin banyak tool, Agent jadi semakin tidak stabil. Bagaimana mengatasinya?
Ekspos tool secara dinamis sesuai tahap tugas, dan berikan hanya sedikit tool yang relevan per putaran. Anda juga bisa memakai model ringan lebih dulu untuk klasifikasi routing, lalu menyerahkan subset tool yang sesuai ke model eksekutor. Menuliskan batas penggunaan dengan jelas di deskripsi tool lebih efektif daripada menumpuk lebih banyak contoh.
Q8: Setelah lapisan antarmuka dirapikan, batasan apa lagi yang tersisa?
Lapisan antarmuka dapat meningkatkan stabilitas secara signifikan, tetapi tidak bisa mengatasi batas penalaran model itu sendiri, dan juga tidak bisa mengatasi perubahan pada situs atau layanan pihak ketiga. Untuk tugas dengan rantai panjang, tetap disarankan menyediakan titik konfirmasi manual, terutama untuk operasi yang tidak dapat dibatalkan seperti pembayaran, penghapusan, dan pengiriman ke pihak eksternal.
Poin Penting Eksekusi Antarmuka Agent
- Kelemahan eksekusi paling sering ada di lapisan antarmuka: salah memilih alat, rantai terputus, mengaku selesai — sebagian besar punya solusi rekayasa
- Kumpulan alat lebih baik sedikit daripada banyak: ekspos alat secara bertahap, semakin ketat schema parameter semakin stabil
- Perbedaan format harus diisolasi: representasi internal diseragamkan, baru dikonversi ke format OpenAI atau Anthropic saat request
- Error wajib diklasifikasikan: 400 diperbaiki, 429 backoff, 5xx degradasi; operasi yang punya efek samping harus idempoten
- Penyelesaian ditentukan oleh program: tanda terima terstruktur plus validasi status, mencegah “selesai palsu”
- Biaya harus diberi gerbang: batas jumlah putaran, anggaran token, pemakaian model berlapis; harga mengacu pada halaman harga APIYI
- Jalur memulai: akses berbagai model lewat pintu masuk terpadu APIYI, cukup ubah
base_urldanmodeluntuk membandingkan
Ringkasan
Pengujian nyata terhadap tiga Agent personal memberi sinyal kepada developer: titik berat persaingan Agent sedang bergeser dari “bisa mengobrol” ke “bisa menyelesaikan”. Untuk menutup celah eksekusi, investasi yang paling menguntungkan adalah lulus dulu ujian antarmuka:
- Pemanggilan alat: rampingkan alat, perketat schema, standarkan pengembalian hasil;
- Toleransi kesalahan: klasifikasi error, retry terbatas, perlindungan idempoten;
- Dapat diverifikasi dan terkendali: tanda terima terstruktur, validasi program, gerbang biaya.
Saran: jalankan dulu satu tugas nyata sampai siklus penuh berjalan, baru perluas kemampuan secara bertahap. Direkomendasikan untuk terhubung melalui APIYI apiyi.com, yang kompatibel dengan format antarmuka OpenAI dan Anthropic sehingga memudahkan perbandingan stabilitas eksekusi antar model. Dokumentasi ada di docs.apiyi.com, sedangkan harga mengacu pada https://docs.apiyi.com/models.
📚 Referensi
- 36Kr: Agent pribadi masuk ke meja, siapa yang lebih dulu gentar?: Laporan pengujian langsung tiga Agent pribadi
- Tautan:
36kr.com/p/4055385191224452 -
Keterangan: Sumber topik artikel ini, untuk detail produk dan hasil pengujian langsung silakan merujuk ke artikel aslinya
-
Pusat Dokumentasi APIYI: Konfigurasi integrasi dan penjelasan model yang tersedia
- Tautan:
docs.apiyi.com -
Keterangan: Konfigurasi
base_url, cara integrasi dengan format OpenAI dan Anthropic -
Halaman Harga Model APIYI: Harga satuan model dan dasar penagihan
- Tautan:
docs.apiyi.com/models - Keterangan: Semua konten terkait harga dalam artikel ini mengacu pada data aktual di halaman tersebut
Penulis: Tim Teknis APIYI
Komunikasi Teknis: Silakan hubungi kami melalui situs resmi APIYI di apiyi.com, materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com