Catatan penulis: Skor di papan peringkat publik bisa terdongkrak lewat optimasi yang ditargetkan. Artikel ini membahas penyebab benchmaxing, lima pemeriksaan kredibilitas, dan empat langkah membuat kumpulan soal privat dari tugas Anda sendiri.
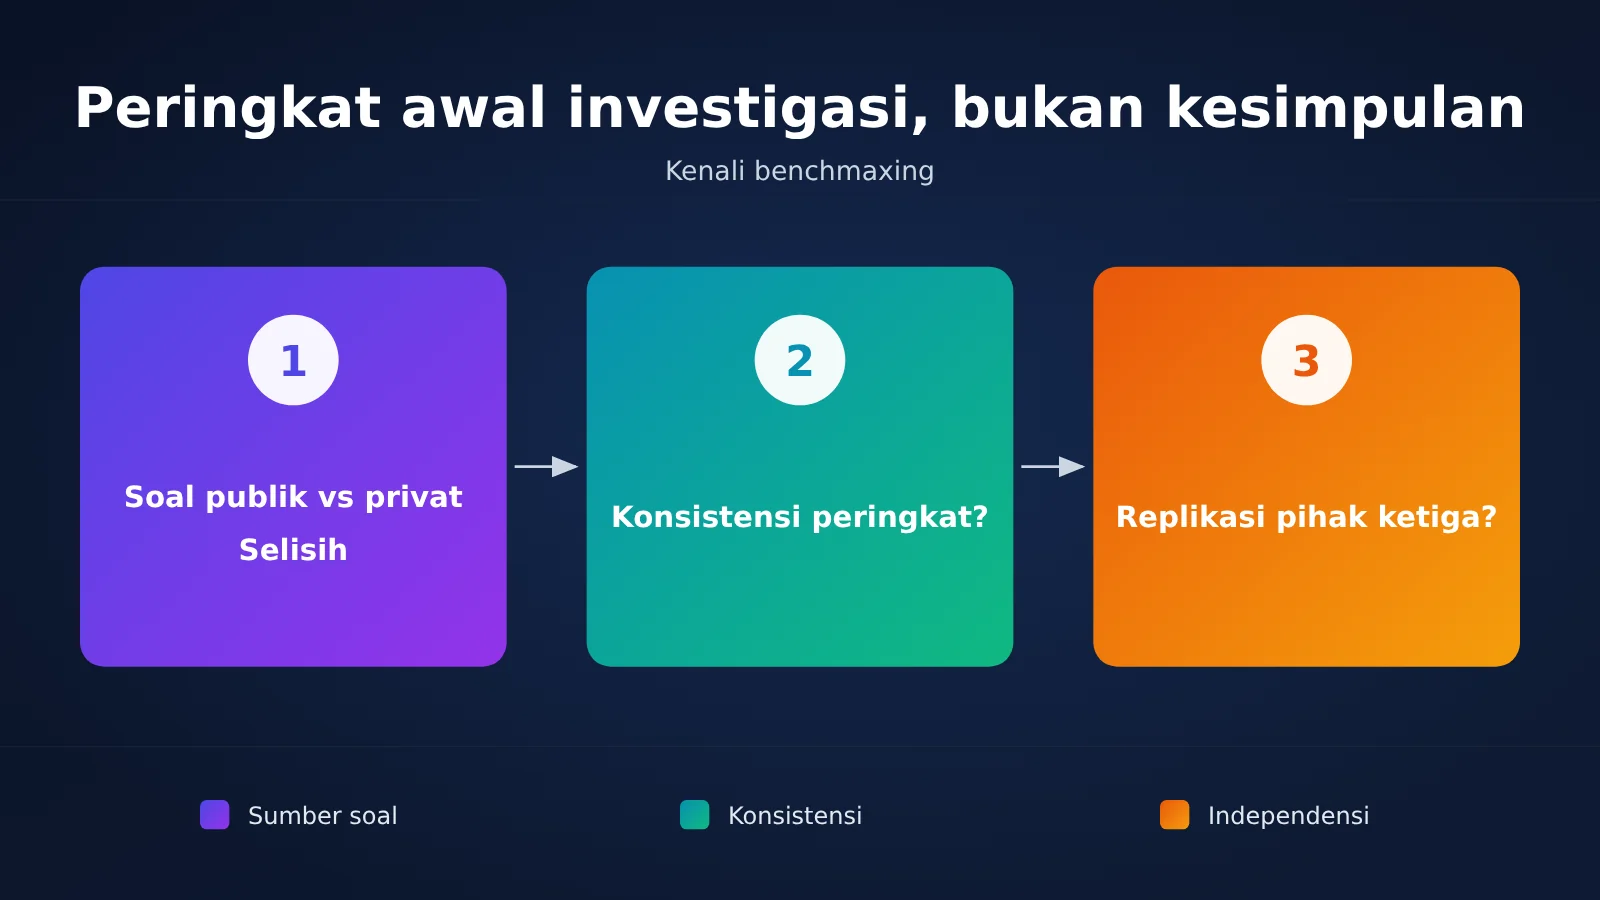
Kesimpulannya: skor papan peringkat bisa menjadi titik awal penyelidikan, tetapi jangan langsung dijadikan dasar keputusan memilih model. Model-model teratas di papan peringkat umum sering kali hanya terpaut beberapa poin, dan selisih itu saja bisa mengubah posisi puncak. Ketika selisihnya sekecil ini, optimasi yang ditujukan pada soal pengujian mudah memengaruhi peringkat. Fenomena ini disebut benchmaxing.
Yang benar-benar menentukan pilihan adalah performa model kandidat pada tugas bisnis Anda sendiri. Artikel ini tidak membuat peringkat model atau menilai siapa yang “curang”. Pembahasannya terbagi menjadi tiga bagian: cara mengenali skor yang mungkin terlalu tinggi, cara membuat kumpulan soal privat berskala kecil dari tiket kerja nyata, dan situasi ketika papan peringkat tidak mencakup metrik yang Anda butuhkan.
Apa itu benchmaxing: 3 penyebab skor benchmark tampak lebih tinggi dari kemampuan sebenarnya
Menurut artikel MindStudio pada 1 November 2026, benchmaxing adalah praktik melatih atau menyetel model agar mendapat skor tinggi pada benchmark yang sudah dikenal, alih-alih meningkatkan kemampuan umum. Ciri khasnya: model tampil mengesankan di papan peringkat, tetapi performanya menurun drastis saat menghadapi soal baru yang menguji kemampuan yang sama.
| Penyebab | Cara terjadi | Petunjuk untuk mengenalinya |
|---|---|---|
| Soal masuk ke data pelatihan | Soal benchmark atau variasi yang sangat mirip masuk ke korpus pelatihan, baik sengaja maupun tidak | Skor tinggi pada soal asli, tetapi turun setelah soal ditulis ulang |
| Penyetelan khusus berdasarkan jenis soal | Model dioptimalkan khusus untuk format dan pola penalaran yang diutamakan oleh benchmark tertentu | Hanya menonjol di satu papan peringkat, sementara hasil di papan peringkat lain biasa saja |
| Soal publik beredar dalam waktu lama | Soal dibahas di forum dan blog, lalu akhirnya masuk ke data hasil perayapan web | Semakin lama benchmark tersedia untuk umum, semakin mendekati titik jenuh skornya |
Benchmaxing tidak selalu didasari niat buruk
Artikel aslinya menekankan bahwa ketiga kondisi ini bisa terjadi tanpa niat buruk. Sebuah laboratorium mungkin benar-benar merasa sedang meningkatkan kemampuan penalaran umum, padahal modelnya mengalami overfitting pada beberapa jenis soal yang terkenal. Semakin lama sebuah benchmark tersedia untuk umum, semakin kecil kemampuannya untuk mengukur kemampuan sebenarnya—dan semakin mirip dengan soal latihan yang sudah pernah dikerjakan model sebelumnya.
Jadi, saat menilai, perhatikan buktinya, bukan motifnya. Yang perlu dilihat adalah apakah skor tersebut mencerminkan kemampuan model saat menghadapi soal baru, bukan siapa yang mungkin sengaja melakukannya.
Mengapa benchmaxing muncul: ritme peluncuran dan narasi perbandingan
Skor adalah cara termudah bagi laboratorium untuk menunjukkan kemajuan kepada investor, pengembang, dan publik, tanpa perlu membuka akses untuk audit independen secara menyeluruh. Angka seperti “skor indeks komposit 59” mudah dimasukkan ke dalam siaran pers dan dibandingkan dengan angka dari produk pesaing. Semakin sederhana angkanya, semakin besar pula tekanan untuk mengoptimalkannya.
Faktor kedua adalah ritme peluncuran. Menurut artikel MindStudio yang sama, salah satu model dalam seri Google Gemini mendapat skor 50 pada Artificial Analysis Index. Sekitar sebulan kemudian, model penerus dari perusahaan yang sama mendapat skor 59 dan menempati posisi teratas. Data ini saat ini hanya berasal dari satu sumber dan belum diverifikasi secara independen untuk artikel ini. Poin yang ingin disampaikan artikel aslinya adalah: iterasi berlangsung dalam hitungan minggu, selisih di posisi teratas hanya beberapa poin, dan cara apa pun yang bisa memperlebar jarak menjadi menarik.
Klasifikasikan fakta sebelum membaca papan peringkat
Saat mengutip skor, pahami dulu termasuk kategori mana skor tersebut. Tabel berikut menggunakan contoh kasus yang dibahas dalam artikel ini:
| Jenis fakta | Contoh dalam artikel ini | Cara menyikapi |
|---|---|---|
| Laporan resmi / prediksi lisan | Musk menyebut Grok 5 mungkin mendapat “skor hampir sempurna” di Humanity’s Last Exam; ia juga menyebut Grok 4 mendapat sekitar 52% pada bagian teks tes tersebut | Ini adalah prediksi dan klaim sendiri, bukan hasil tes independen |
| Tes independen oleh pihak ketiga | Artificial Analysis Index menggabungkan tes penalaran, pemrograman, sains, matematika, dan lainnya | Bisa dijadikan sinyal referensi, tetapi tanggal pengutipan perlu dicantumkan |
| Laporan dari satu media | Skor indeks dan hasil Terminal-Bench Grok 4.7, serta perubahan skor Gemini dari 50→59 | Hanya bersumber dari MindStudio dan belum diverifikasi secara independen |
| Belum diketahui | Waktu pasti dan cakupan peralihan Artificial Analysis ke soal privat | Mengacu pada penjelasan resminya; artikel ini tidak membuat dugaan |
Menurut laporan MindStudio, Grok 4.7 tertinggal dari model-model teratas baik pada indeks komposit independen maupun Terminal-Bench. Artikel aslinya menggunakan “kesenjangan antara ekspektasi publik dan hasil tes independen” ini sebagai sinyal untuk dicermati, serta secara tegas menyatakan bahwa hal itu tidak berarti xAI lebih bermasalah dibandingkan penyedia lain. Artikel ini juga hanya menggunakannya dalam konteks tersebut, tanpa menarik kesimpulan apa pun.
5 tanda untuk menilai kredibilitas skor di papan peringkat
Pendekatan lembaga evaluasi independen cukup sederhana: jangan publikasikan soal. Jika soal tidak pernah dirilis, tidak ada pihak yang bisa melatih model secara khusus untuk mengerjakannya. Menurut MindStudio, lembaga seperti Artificial Analysis sudah beralih ke soal privat. Untuk kategori kemampuan yang sama, selisih antara skor pada soal publik dan soal baru yang privat dianggap sebagai salah satu sinyal paling jujur untuk mendeteksi benchmaxing.
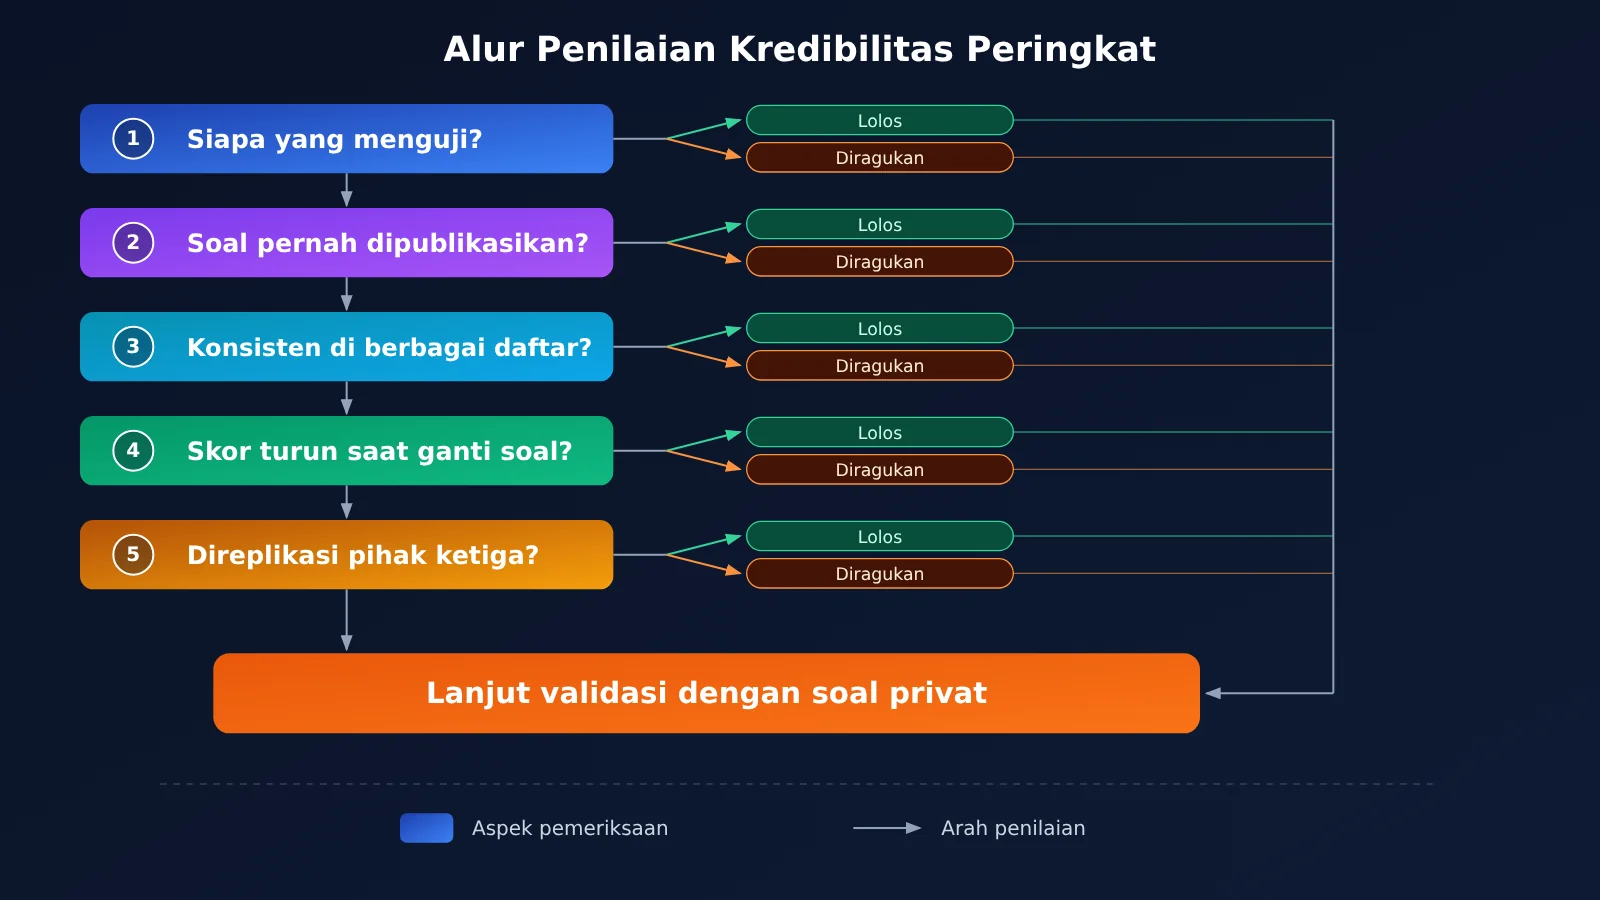
Berdasarkan saran dalam artikel asli, cara menilainya bisa dirangkum dalam daftar periksa berikut:
| No. | Hal yang diperiksa | Cara memeriksa | Sinyal positif | Sinyal yang perlu diwaspadai |
|---|---|---|---|---|
| 1 | Siapa yang menjalankan pengujian | Periksa apakah hasilnya berasal dari laporan teknis vendor atau halaman evaluasi pihak ketiga | Dijalankan secara independen oleh pihak ketiga | Hanya dilaporkan oleh vendor |
| 2 | Apakah soalnya pernah dipublikasikan | Periksa apakah benchmark dirilis sebelum tanggal batas data pelatihan model | Soal privat atau soal baru yang dirilis setelah pelatihan | Soal lama yang sudah bertahun-tahun dipublikasikan |
| 3 | Apakah hasilnya konsisten di berbagai papan peringkat | Bandingkan berbagai benchmark, seperti penalaran, pemrograman, dan matematika | Peringkatnya secara umum konsisten | Hanya menonjol di satu papan peringkat |
| 4 | Apakah skor turun saat soal untuk kemampuan yang sama diganti | Bandingkan kumpulan soal publik dan privat, serta soal asli dan versi yang ditulis ulang | Selisih skor kecil setelah soal diganti | Skor turun signifikan setelah soal diganti |
| 5 | Apakah hasilnya direproduksi oleh pihak ketiga | Cari laporan reproduksi independen dan periksa pengaturan evaluasinya | Direproduksi oleh beberapa pihak dengan pengaturan yang transparan | Tidak dapat direproduksi atau pengaturannya tidak dipublikasikan |
Mengapa indeks gabungan lebih sulit dimanipulasi
Menurut artikel asli, nilai Artificial Analysis Index terletak pada penggabungan berbagai jenis tes menjadi satu skor. Model mungkin saja mengalami overfitting pada satu tes, tetapi jauh lebih sulit untuk mengalami overfitting sekaligus pada beberapa tes penalaran, pemrograman, sains, dan matematika, apalagi jika sebagian soalnya tidak dipublikasikan. Karena itu, poin ke-3, “konsistensi di berbagai papan peringkat”, bisa diberi bobot lebih tinggi.
Menyusun kumpulan soal privat dari tugas sendiri: alur 4 langkah
Seobjektif apa pun papan peringkat, soal yang diuji tetap milik orang lain. Untuk memilih model yang tepat, andalkan kumpulan soal privat Anda sendiri. Keunggulannya: tidak ada laboratorium yang pernah melihat soal-soal ini.
| Langkah | Tujuan | Cara melakukannya | Hasil |
|---|---|---|---|
| ① Ambil sampel | Ambil soal dari pekerjaan nyata | Gunakan tiket layanan, kasus kegagalan dalam log produksi, dan percakapan keluhan pengguna. Kelompokkan berdasarkan jenis tugas, mulai dari 20–50 contoh per jenis | Kumpulan soal mentah berlabel |
| ② Tetapkan kriteria penerimaan | Tentukan lebih dulu apa yang dianggap “cukup baik” | Prioritaskan keluaran yang bisa dinilai secara objektif, seperti field JSON, label klasifikasi, atau hasil uji unit. Untuk jawaban terbuka, gunakan rubrik penilaian dan lakukan pemeriksaan manual pada sampel dengan proporsi tetap | Skrip penilaian + rubrik penilaian |
| ③ Jalankan beberapa model | Bandingkan model dengan variabel yang terkendali | Gunakan petunjuk, parameter, serta penilai atau aturan penilaian yang sama. Catat skor, latensi, dan penggunaan token | Tabel hasil perbandingan |
| ④ Perbarui secara berkala | Cegah kumpulan soal berubah menjadi sekadar soal latihan | Tambahkan kasus kegagalan baru setiap bulan, dan hapus soal yang mendapat skor sempurna dari semua model. Sisihkan sebagian sebagai set pengujian yang tidak digunakan untuk menyetel parameter | Kumpulan soal dengan versi |
Pengambilan sampel dan kriteria penerimaan untuk kumpulan soal privat
Saat mengambil sampel, kasus kegagalan lebih berharga daripada kasus keberhasilan. Percakapan yang membuat pengguna bertanya ulang, memerlukan intervensi manusia, atau mendapat penilaian buruk paling jelas menunjukkan perbedaan antar model. Kriteria penerimaan perlu ditetapkan sebelum menjalankan model agar tidak disesuaikan setelah melihat hasilnya.
Definisi “cukup baik” harus bisa diukur. Misalnya, “akurasi field hasil ekstraksi terstruktur mencapai ambang tertentu” atau “jawaban layanan pelanggan tidak mengandung kesalahan fakta berdasarkan pemeriksaan sampel oleh manusia”. Tentukan proporsi sampel berdasarkan risiko: untuk bisnis berisiko tinggi, periksa lebih banyak sampel; untuk tugas berisiko rendah, utamakan penilaian otomatis.
Cara mengendalikan variabel saat membandingkan beberapa model
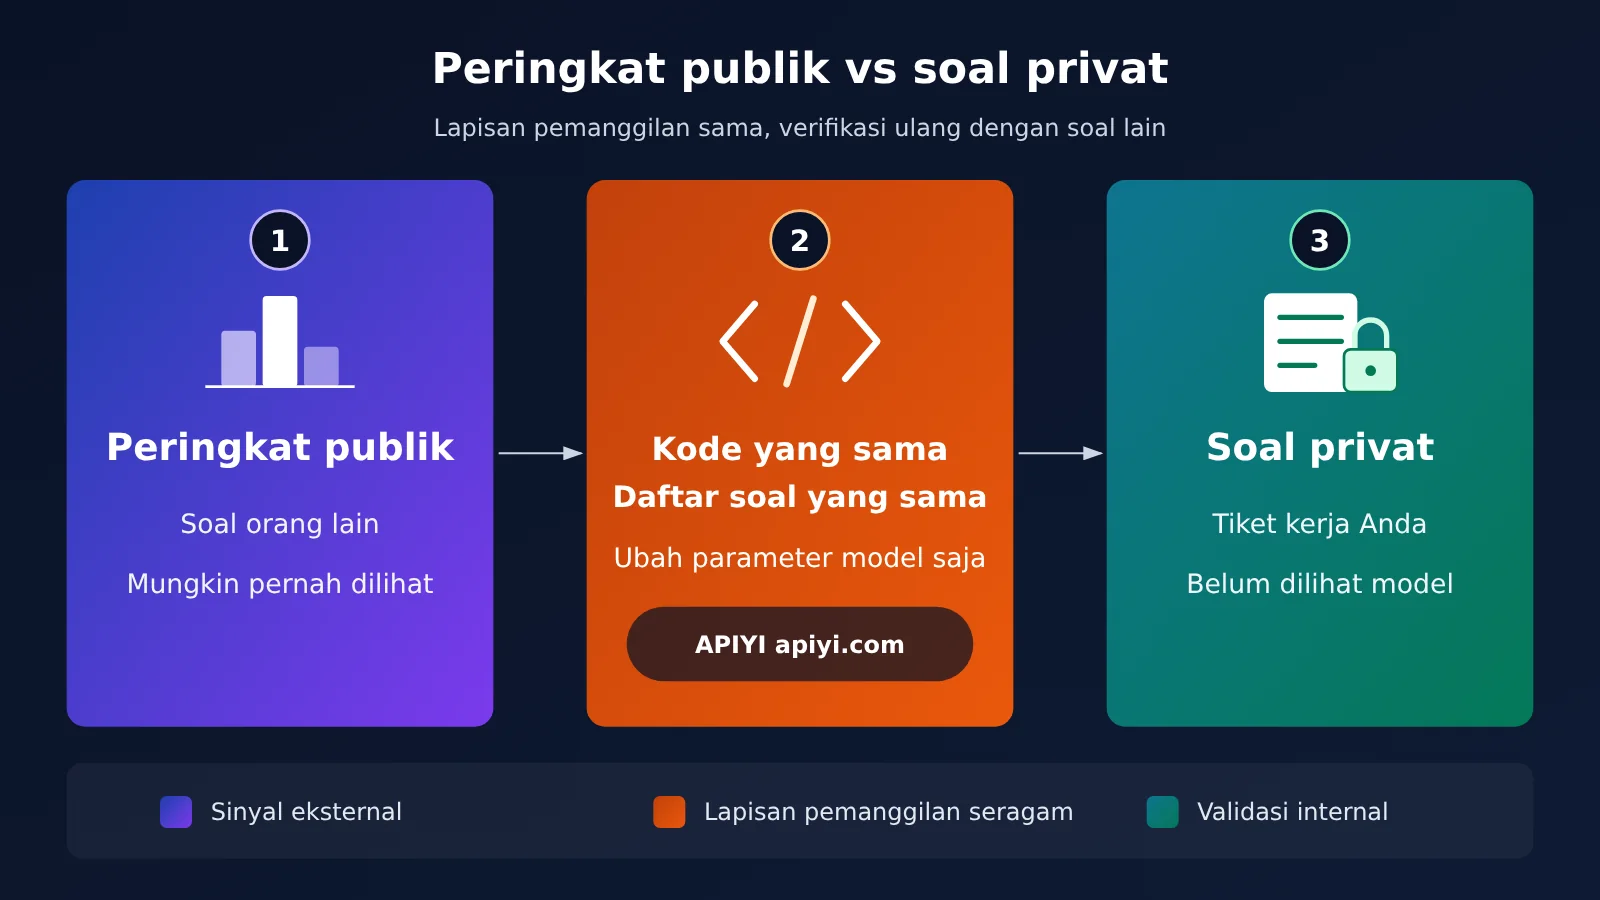
Masalah paling umum dalam perbandingan antar model adalah variabel yang tidak dikendalikan: model A diberi petunjuk yang sudah disempurnakan, sementara model B menggunakan petunjuk bawaan. Cara yang tepat adalah memakai kode dan kumpulan soal yang sama, lalu hanya mengganti nama model.
Jika model kandidat berasal dari beberapa penyedia, mengelola beberapa SDK bisa merepotkan. APIYI kompatibel dengan format OpenAI. Satu token bisa digunakan untuk memanggil model dari berbagai penyedia, dan saat berganti model, Anda hanya perlu mengubah parameter model. Ini cocok untuk menjalankan kumpulan soal yang sama dalam satu skrip evaluasi. Konfigurasinya sebagai berikut:
- SDK Python resmi OpenAI: saat menginisialisasi klien, atur
base_urlkehttps://api.apiyi.com/v1dan isiapi_keydengan token platform - Pergantian model dalam siklus evaluasi: cukup ubah field
model, dengan nama model sesuai daftar model di APIYI apiyi.com - Samakan parameter sampling: atur
temperature=0dan gunakanmax_tokensyang sama untuk semua model agar pengaruh keacakan berkurang - Catat penggunaan: baca field
usagedalam respons, lalu rekap konsumsi token setiap model untuk seluruh kumpulan soal
🚀 Mulai cepat: Pilih 3–4 model kandidat yang menempati posisi teratas di papan peringkat dan lolos lima pemeriksaan di atas. Panggil model tersebut satu per satu melalui APIYI apiyi.com menggunakan token yang sama. Dalam satu sore, Anda bisa mendapatkan hasil perbandingan pertama berdasarkan 50 tiket nyata.
Hindari mengutak-atik parameter demi skor tinggi pada daftar soal sendiri
Kamu juga bisa tanpa sadar melakukan benchmaxing pada daftar soal sendiri. Terus mengubah petunjuk sampai suatu model mendapat nilai sempurna pada 50 soal tersebut pada dasarnya tidak berbeda dari vendor yang mengejar peringkat. Beberapa langkah berikut bisa membantu mencegahnya:
- Pisahkan set uji: sisihkan sekitar 30% soal, gunakan hanya set pengembangan untuk menyesuaikan parameter, lalu gunakan set uji untuk keputusan akhir
- Bekukan petunjuk: setelah perbandingan resmi dimulai, bekukan petunjuk berdasarkan nomor versi. Jika ada perubahan, jalankan ulang semua model
- Perbarui soal secara berkala: setiap kali memperbarui daftar soal, tambahkan kasus kegagalan terbaru agar daftar tetap mengikuti perubahan kebutuhan bisnis
Kapan skor papan peringkat tidak cukup
Meski skor papan peringkat sepenuhnya tepercaya, bisa jadi skor tersebut tidak mengukur hal yang kamu butuhkan. Dalam beberapa situasi berikut, papan peringkat sebaiknya hanya dijadikan referensi tambahan:
| Skenario | Mengapa papan peringkat tidak mencakupnya | Evaluasi tambahan yang diperlukan |
|---|---|---|
| Tugas khusus yang jarang ditemui | Istilah industri, format internal, dan bahasa dengan sedikit penutur jarang muncul dalam benchmark umum | Daftar soal privat yang disusun dari data bisnis asli |
| Pemanggilan alat dan Agent | Stabilitas pemanggilan beberapa langkah dan ketepatan format parameter tidak bisa diukur lewat tanya jawab satu putaran | Tingkat keberhasilan tugas end-to-end dan tingkat kesalahan format pemanggilan fungsi |
| Biaya dan latensi | Papan peringkat hanya mengurutkan kemampuan, tanpa mempertimbangkan biaya per permintaan dan latensi token pertama | Catat penggunaan token dan waktu respons untuk setiap soal |
| Stabilitas | Satu kali pengujian tidak menggambarkan fluktuasi saat digunakan | Jalankan soal yang sama beberapa kali dan periksa konsistensi hasilnya |
Prinsip praktisnya: setelah kemampuan memenuhi kebutuhan, bandingkan efisiensi biaya dan stabilitasnya. Model peringkat pertama dan ketiga mungkin sama-sama memenuhi kebutuhan pada daftar soalmu. Dalam situasi itu, model dengan latensi lebih rendah dan biaya yang lebih terkendali sering kali lebih cocok. Dengan akses terpadu melalui APIYI apiyi.com, kamu bisa membandingkan kemampuan, waktu respons, dan penggunaan secara berdampingan dalam satu tabel hasil.
Pertanyaan Umum (FAQ)
Q1: Apakah benchmaxing sama dengan model yang curang?
Tidak. Soal bisa saja masuk ke data pelatihan tanpa sengaja melalui perayap web. Optimasi berdasarkan jenis soal juga mungkin dilakukan karena tim benar-benar yakin bahwa hal itu meningkatkan kemampuan penalaran. Untuk menilainya, lihat saja apakah skor tetap bertahan setelah soalnya diganti, tanpa menyimpulkan motifnya.
Q2: Dalam kondisi apa skor di papan peringkat masih bisa dipercaya?
Skor masih menjadi indikator yang bermakna jika memenuhi kondisi berikut: soal bersifat privat atau baru muncul setelah tanggal batas data pelatihan, pengujian dijalankan secara independen oleh pihak ketiga, kesimpulannya konsisten di beberapa papan peringkat, dan hasilnya berhasil direplikasi. Indeks yang menggabungkan berbagai jenis tes lebih sulit dimanipulasi agar skornya tinggi dibandingkan satu benchmark saja.
Q3: Berapa jumlah minimum soal untuk kumpulan soal privat?
Tidak ada standar yang berlaku untuk semua kasus. Sebagai patokan awal, ambil 20–50 sampel nyata untuk setiap jenis tugas. Jumlah ini cukup untuk melihat perbedaan yang jelas. Jika perbedaannya belum terlihat, tambah jumlah soal dan sisihkan sebagian sebagai set holdout.
Q4: Bagaimana cara membandingkan model dari berbagai penyedia dengan satu set kode?
Cara paling praktis adalah menggunakan antarmuka yang kompatibel dengan OpenAI. Setelah mendapatkan token melalui APIYI apiyi.com, arahkan `base_url` ke alamat platform. Dalam loop, cukup ganti parameter `model` untuk membandingkan model menggunakan kumpulan soal yang sama. Model yang tersedia mengikuti daftar model di platform.
Q5: Apakah skor Grok 5 di Humanity’s Last Exam mendekati sempurna?
Hingga tanggal artikel ini, itu adalah prediksi publik dari Musk, bukan hasil pengujian. Jika skor tersebut benar-benar tercapai di masa depan, sebaiknya tetap periksa dengan daftar 5 poin, terutama performa kemampuan yang sama pada soal baru yang privat. Lalu, gunakan kumpulan soal sendiri melalui APIYI apiyi.com untuk memverifikasi apakah model tersebut cocok untuk kebutuhan bisnismu.
Poin Penting tentang Benchmaxing dan Evaluasi Tugas Sendiri
- Definisi: benchmaxing adalah optimasi terhadap soal yang sudah diketahui, sehingga skor di papan peringkat lebih tinggi daripada kemampuan sebenarnya.
- Penyebab: soal masuk ke data pelatihan, fine-tuning berdasarkan jenis soal, dan soal publik yang beredar dalam waktu lama. Ketiganya bisa terjadi tanpa niat buruk.
- Sinyal utama: skor turun ketika kemampuan yang sama diuji dengan soal baru. Ini adalah tanda peringatan paling langsung.
- 5 pemeriksaan: siapa yang menjalankan pengujian, apakah soalnya pernah dipublikasikan, apakah hasilnya konsisten di beberapa papan peringkat, apakah skor turun saat soalnya diganti, dan apakah ada reproduksi hasil oleh pihak ketiga.
- 4 langkah menyusun daftar soal: ambil sampel, tetapkan kriteria penerimaan, uji beberapa model, dan perbarui secara berkala. Sisihkan juga set pengujian terpisah untuk mencegah overfitting pada evaluasi sendiri.
- Pemanggilan terpadu: dengan antarmuka kompatibel OpenAI dari APIYI apiyi.com, cukup ubah parameter
modeluntuk berganti model.
Kesimpulan: Papan Peringkat Adalah Titik Awal Investigasi, Bukan Kesimpulan
Ada tiga hal yang bisa langsung kamu lakukan hari ini. Pertama, periksa setiap skor papan peringkat yang kamu pertimbangkan menggunakan daftar 5 pemeriksaan, lalu catat jenis fakta dan tanggal rujukannya. Kedua, pilih 50 kasus kegagalan dari log selama sebulan terakhir, lalu tulis kriteria penerimaannya sebelum menjalankan model. Ketiga, uji 3–4 model kandidat dengan kode dan parameter yang sama, sambil mencatat skor, latensi, dan penggunaan.
Gunakan APIYI apiyi.com untuk membandingkan beberapa model dengan satu token, lalu perbarui daftar soal setiap bulan. Keputusan pemilihan model sebaiknya berasal dari daftar soal kamu sendiri, bukan dari soal ujian orang lain.
📚 Referensi
- MindStudio: What Is Benchmaxing? Why AI Labs Are Hiding Test Questions(2026-11-01)
- Tautan:
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
Keterangan: Definisi dan penyebab benchmaxing, tren penggunaan soal privat, serta satu-satunya sumber data terkait Gemini dan Grok dalam artikel ini
-
Situs resmi Artificial Analysis: Evaluasi model independen dan indeks komprehensif
- Tautan:
artificialanalysis.ai - Keterangan: Untuk waktu dan cakupan peralihan ke soal privat, silakan merujuk pada keterangan resminya
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs APIYI di apiyi.com. Untuk informasi integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com