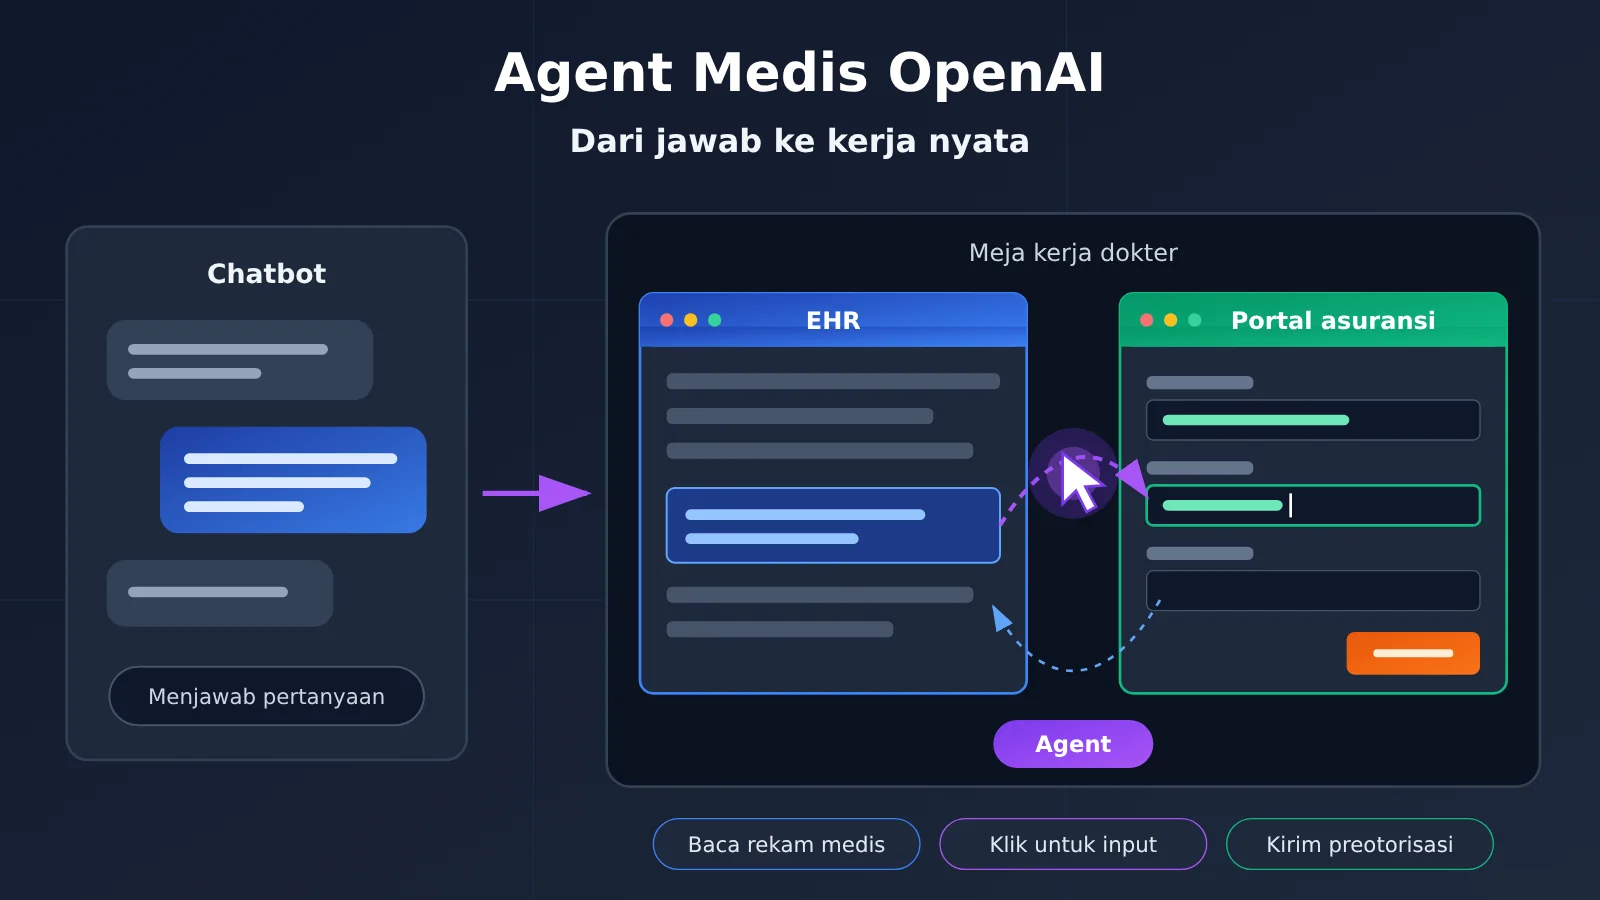
Kemajuan penting dari Computer-use Agent medis OpenAI terletak pada kemampuannya masuk ke sistem perangkat lunak yang sudah dipakai oleh institusi medis, membaca informasi rekam medis longitudinal pasien, lalu menyiapkan catatan medis, draf order medis, balasan untuk pasien, dan materi pra-otorisasi asuransi berdasarkan data itu. Nilai AI sedang bergerak dari sekadar menjawab pertanyaan profesional ke menjalankan proses bisnis yang sesungguhnya. Titik fokus persaingan AI medis pun ikut bergeser: tidak lagi terbatas pada tanya jawab pengetahuan medis, melainkan sudah masuk ke dalam alur kerja klinis dan administratif itu sendiri. Perlu ditegaskan bahwa materi seperti ini, baik dalam demo maupun studi kasus publik, selalu ditinjau oleh dokter atau staf terkait; AI tidak memiliki hak otonom atas resep maupun keputusan medis.
Apa yang bisa Anda dapatkan setelah membaca artikel ini?
- Rantai operasi lengkap Agent dalam demo MRI, mulai dari membaca rekam medis hingga menyiapkan permohonan pra-otorisasi.
- Cakupan penilaian dari masing-masing tiga set data — 99% keamanan, 93% tingkat persetujuan tinggi dari dokter, dan 94,3% rubric points — serta perbedaannya dengan hasil makalah Stanford HealthAdminBench.
- Posisi CVS Health, Cigna, Abridge, dan Ambience: apakah masih di tahap demo sintetis, deployment produksi, atau pengembangan.
- Bagaimana hak persetujuan klinis dipisahkan dari hak eksekusi Agent, dan bagaimana pengembang semestinya menghitung biaya penuh Agent.
Daftar Isi
Bagian fakta objektif disusun dengan urutan berikut: pertama, merekonstruksi apa yang dilakukan OpenAI dengan AI dalam inisiatif ini; kedua, membandingkan perbedaan antara Chatbot dan Computer-use Agent; ketiga, mengurai makna dari hasil evaluasi; keempat, merangkum cara penerapan di perusahaan seperti CVS, Cigna, Abridge, dan Ambience; terakhir, memperkenalkan mekanisme pengendalian risiko Agent medis. Bagian analisis dan penilaian akan membahas mengapa industri medis sangat membutuhkan kemampuan ini, bagaimana pengembang dan institusi medis seharusnya mengambil keputusan, serta apa arti Computer Use bagi keseluruhan industri aplikasi AI.
To Know: Sekilas Konsep Terkait Agent Medis
| Konsep | Penjelasan Singkat |
|---|---|
| Computer Use | Kemampuan menyelesaikan tugas dengan mengamati dan mengoperasikan antarmuka perangkat lunak (screenshot, klik, input) |
| EHR | Sistem rekam kesehatan elektronik, perangkat lunak inti rumah sakit untuk menyimpan informasi kunjungan pasien, obat-obatan, citra medis, dan lain-lain |
| Payer Portal | Portal pembayar asuransi, tempat fasilitas kesehatan mengajukan pra-otorisasi dan memverifikasi kelayakan asuransi |
| Prior Authorization | Pra-otorisasi, sebagian pemeriksaan atau pengobatan perlu mendapat persetujuan pihak asuransi sebelum dilaksanakan |
| MCP | Protokol standar untuk menemukan dan memanggil alat eksternal |
| RPA | Cara otomasi proses berulang melalui aturan atau skrip yang telah dikonfigurasi sebelumnya |
| Rubric points | Poin penilaian yang dipecah berdasarkan aturan evaluasi, mengukur tercapainya sebagian persyaratan |
| Tingkat keberhasilan end-to-end | Proporsi tugas lengkap yang memenuhi seluruh kondisi keberhasilan |
| Trace | Bukti jejak yang mencatat proses eksekusi, tindakan operasi, dan status antarmuka |
| BAA | Perjanjian mitra bisnis, menetapkan tanggung jawab penyedia layanan dalam menangani informasi kesehatan terlindungi (PHI) |
| RBAC | Kontrol akses berbasis peran, menetapkan data dan operasi yang dapat diakses menurut posisi jabatan |
Sekilas Dampak Agent Medis
- Pengembang dan penanggung jawab teknis: Fokusnya bukan lagi apakah model bisa menjawab pertanyaan medis dengan benar, melainkan memverifikasi mekanisme eksekusi, tingkat penyelesaian end-to-end, dan biaya menyeluruh berdasarkan tugas spesifik. Screenshot termasuk input gambar, panggilan multi-putaran, alat, dan lingkungan runtime semuanya akan ditagih, jadi tidak bisa hanya melihat harga satuan Token teks.
- Fasilitas kesehatan dan penanggung jawab alur kerja: Perlu membedakan mana yang merupakan demo data sintetis, evaluasi vendor, uji coba perusahaan, dan kasus produksi. Saat diluncurkan juga harus menerapkan persetujuan manusia, konfigurasi izin, dan log audit; efek demo tidak bisa langsung dijadikan dasar pengadaan.
- Tenaga klinis: Dalam jangka pendek, yang lebih mungkin dirasakan adalah penurunan beban administratif, misalnya persiapan materi pra-otorisasi dan pencarian informasi lintas sistem. Penilaian klinis dan tanggung jawab tanda tangan tetap berada di tangan dokter.
Fakta Objektif: Apa yang Dirilis Agent Medis OpenAI Kali Ini
Apa yang AI lakukan lewat Agent Medis OpenAI kali ini?
Pada 16 November 2026, OpenAI merilis perkembangan baru untuk Agent operasi komputer yang ditujukan bagi tim medis. Bersamaan dengan itu, OpenAI mengungkap hasil evaluasi alur kerja klinis dan administratif, serta praktik kerja sama dengan perusahaan seperti CVS Health, Abridge, Ambience, dan Cigna Healthcare. Selama HLTH 2026, Karan Singhal, pimpinan OpenAI Health AI, juga memaparkan perkembangan terkait.
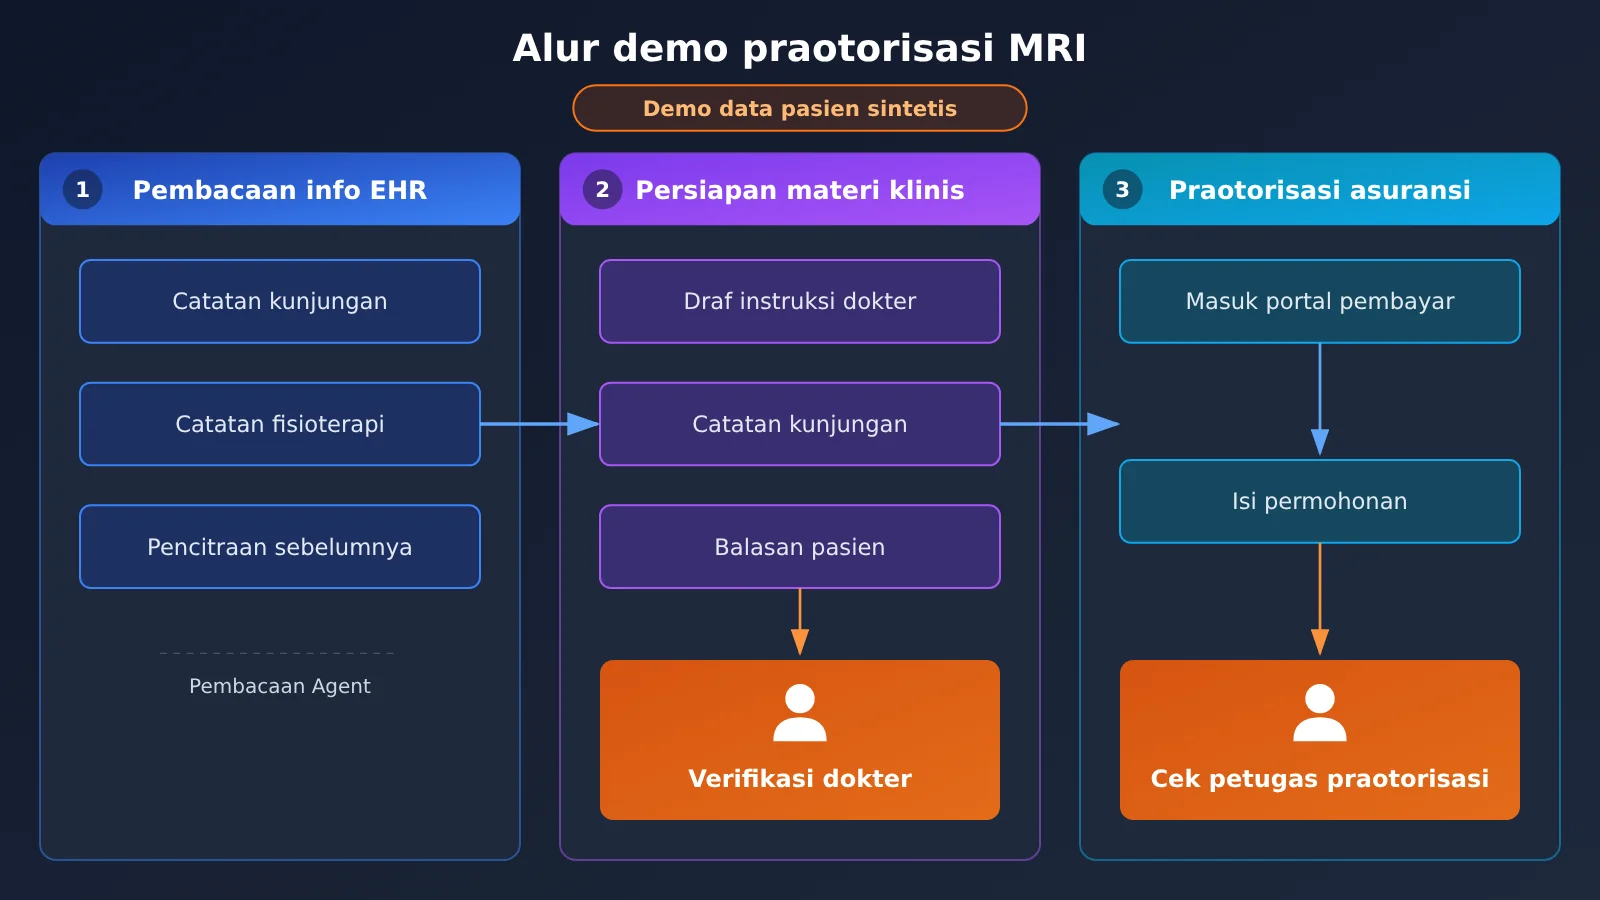
Contoh yang paling jelas menggambarkan perubahan ini adalah alur kerja MRI yang ditampilkan secara resmi. Seorang pasien mengirim pesan kepada dokter karena nyeri punggung bawah, dan dokter mempertimbangkan pemeriksaan MRI. Setelah itu, Agent menyelesaikan pekerjaan dalam tiga tahap di antara EHR dan portal asuransi:
- Pembacaan informasi EHR: meninjau catatan kunjungan pasien, catatan fisioterapi, dan data pencitraan sebelumnya.
- Persiapan materi klinis: menyusun perintah pemeriksaan MRI, catatan kunjungan kali ini, dan balasan untuk pasien, yang seluruhnya diserahkan kepada dokter untuk ditinjau.
- Preotorisasi asuransi: menggunakan catatan pasien yang sama, masuk ke portal pembayar asuransi untuk menyiapkan permohonan preotorisasi MRI, lalu menyerahkannya kepada staf preotorisasi untuk ditinjau.
Perlu dijelaskan bahwa demonstrasi ini menggunakan Data Pasien Sintetis (Synthetic Patient Data), bukan operasi produksi terhadap pasien nyata. Demonstrasi ini menunjukkan rangkaian kemampuan, bukan berarti rumah sakit mana pun telah menangani kasus nyata dengan alur tersebut.
OpenAI juga menampilkan kasus konsultasi obat setelah seorang anak mengalami patah tulang. Keluarga menanyakan dosis ibuprofen untuk anak, lalu Agent memeriksa catatan kunjungan dan data pencitraan, membaca berat badan serta dosis yang diberikan di klinik sebagaimana tercatat dalam rekam medis, dan berdasarkan itu menyusun penjelasan obat, instruksi perawatan gips, serta gejala peringatan yang memerlukan penanganan darurat. Agent menyimpan catatan medis dalam status belum ditandatangani, dan menyimpan balasan untuk keluarga sebagai draf yang belum dikirim, yang pada akhirnya disetujui oleh dokter. Elevated PSA dan Digoxin refill (isi ulang digoksin) juga dicantumkan sebagai jenis tugas di EHR Inbox, tetapi OpenAI tidak mempublikasikan catatan operasi lengkap dan penilaian independen untuk kedua jenis tugas tersebut.
Dari Chatbot hingga Agent Medis Computer-use, di Mana Letak Perubahannya?
Chatbot tanya-jawab medis tradisional menjawab pengetahuan umum, sedangkan pembuatan dokumen medis mampu menulis draf, tetapi isinya masih harus disalin manual ke dalam sistem. Yang membedakan Computer-use Agent adalah ia masuk langsung ke perangkat lunak yang sudah ada melalui siklus “amati tangkapan layar → rencanakan → klik atau ketik → tangkapan layar lagi untuk verifikasi”, menyelesaikan tugas multi-langkah lintas aplikasi, dan berpotensi mengubah status bisnis di dalam perangkat lunak.
| Bentuk kemampuan | Keluaran utama | Menyentuh sistem bisnis? | Skenario medis tipikal | Titik risiko utama |
|---|---|---|---|---|
| Chatbot tanya-jawab medis | Jawaban teks | Tidak | Pencarian pengetahuan medis, penelusuran bukti | Akurasi konten |
| Pembuatan dokumen medis | Draf catatan, surat | Tidak langsung, perlu input manual | Instruksi pulang, surat praotorisasi | Konten tidak konsisten dengan rekam medis |
| Computer-use Agent | Operasi antarmuka dan perubahan status sistem | Ya, langsung mengoperasikan EHR dan portal | Pengisian praotorisasi, pembaruan status rujukan, pengambilan data lintas sistem | Klik salah, tertukarnya pasien, penyebaran kesalahan |
Dalam OpenAI API, Computer Use terutama diimplementasikan melalui Responses API, yang mendukung aksi click, type, scroll, keypress, drag, screenshot, dan lain-lain. Dokumentasi resmi memperkenalkan dua jalur: pertama, Computer Tool, di mana model mengembalikan aksi mouse dan keyboard terstruktur yang kemudian dieksekusi oleh aplikasi; kedua, Code Execution, di mana model menghasilkan kode yang memanggil alat seperti Playwright, PyAutoGUI, dan sebagainya. Untuk GPT-6 Astra, dokumentasi resmi saat ini merekomendasikan pendekatan Code Execution. Dokumentasi juga secara khusus menekankan bahwa model telah menghasilkan instruksi operasi bukan berarti operasi sudah berhasil; aplikasi harus mengeksekusi aksi tersebut, lalu memverifikasi hasilnya melalui tangkapan layar baru atau cara lain.
Apa arti hasil evaluasi Agent medis OpenAI?
OpenAI telah merilis tiga kelompok data inti. Penyebut (denominator) dan dimensi penilaian masing-masing berbeda, tidak bisa digabungkan menjadi satu “akurasi komprehensif”, dan ketiganya bukan akurasi diagnosis medis.
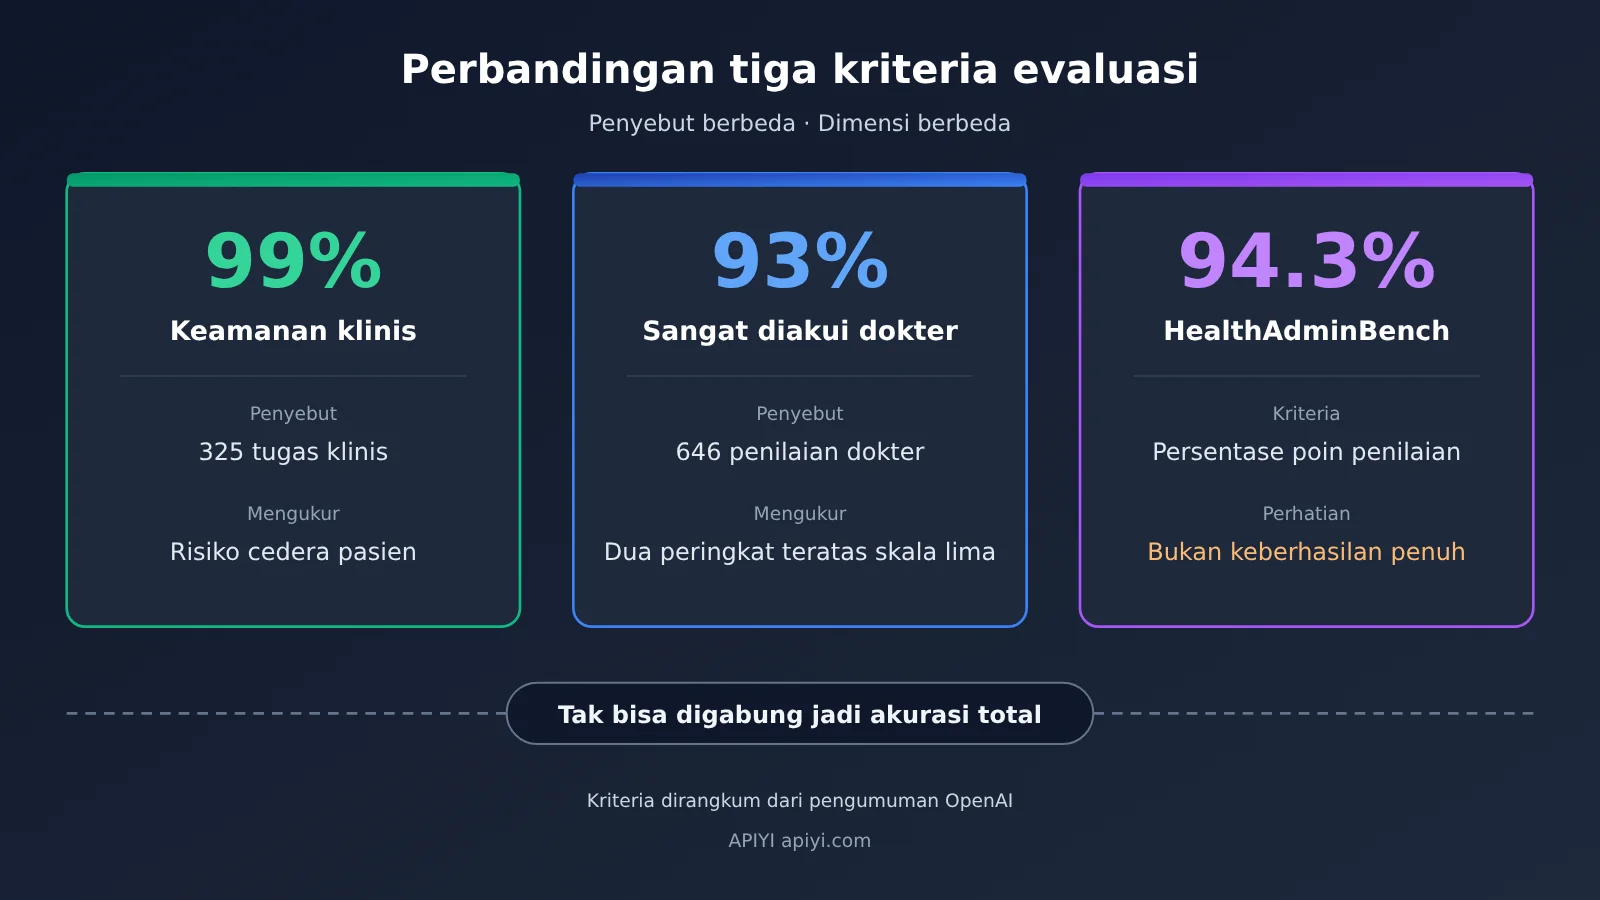
| Metrik | Nilai | Objek evaluasi | Penyebut / cakupan | Tidak boleh dipahami sebagai |
|---|---|---|---|---|
| Keamanan tugas klinis | 99% | GPT-6 Astra | 325 tugas yang telah ditinjau, menilai apakah kesalahan, kelalaian, atau tindakan berpotensi membahayakan pasien | Akurasi diagnosis, nol kesalahan |
| Persetujuan tinggi dokter | 93% | GPT-6 Astra | 646 penilaian, proporsi gabungan Very / Extremely Helpful pada skala lima tingkat | Tingkat keberhasilan tugas, 646 dokter |
| HealthAdminBench | 94.3% | GPT-6 Astra | Proporsi rubric points, maximum reasoning effort | Tingkat keberhasilan tugas utuh |
| HealthAdminBench | 91.8% | GPT-6 Luna | Proporsi rubric points, maximum reasoning effort | Tingkat keberhasilan tugas utuh |
| Biaya per tugas | $0.085 | GPT-6 Luna | Kondisi evaluasi tertentu, 98% lebih rendah dari Astra | Penawaran harga deployment produksi |
Penilaian klinis tidak hanya melihat teks yang dihasilkan pada akhirnya, tetapi juga memeriksa tindakan yang benar-benar dijalankan Agent, catatan medis yang dihasilkan, instruksi dokter, dan pesan kepada pasien. Artinya, evaluasi mencakup kualitas konten sekaligus proses operasi perangkat lunak. Namun, pihak resmi tidak mengungkapkan jumlah dokter independen yang terkait dengan 646 penilaian tersebut, dan teks pengumuman juga tidak memberikan interval kepercayaan, hasil per tugas, maupun contoh kegagalan lengkap.
HealthAdminBench adalah benchmark Agent administrasi medis yang diusulkan oleh Shah Lab Stanford. Berdasarkan makalah 2604.09937v1, benchmark ini mencakup 135 tugas dan 1698 subtugas, di mana 1177 subtugas memakai penilaian deterministik dan 521 memakai juri model; dalam makalah tersebut, tingkat keberhasilan tugas utuh tertinggi adalah Claude Opus 4.6 CUA sebesar 36.3%, sedangkan tingkat keberhasilan subtugas tertinggi adalah GPT-5.4 CUA sebesar 82.8%. Versi awal situs web Shah Lab berisi 70 tugas dan 947 titik penilaian, dengan tingkat keberhasilan tugas utuh tertinggi yang dilaporkan saat itu sebesar 22.9%, yang dapat dijadikan pembanding historis.
Angka-angka ini berasal dari versi, model, tanggal, kondisi eksekusi, dan metrik yang berbeda, tidak dapat disusun dalam satu papan peringkat yang sama. Angka 94.3% dari OpenAI memakai cakupan rubric points, sedangkan 36.3% dari makalah adalah tingkat keberhasilan utuh end-to-end. Selisih antara keduanya sendiri sudah menjadi petunjuk: “melakukan langkah-langkah lokal dengan benar” dan “menyelesaikan seluruh pekerjaan” pada Agent medis bisa sangat jauh berbeda.
Bagaimana CVS, Cigna, Abridge, dan Ambience Menerapkan Agent Medis?
Tingkat kematangan studi kasus perusahaan sangat bervariasi. Berikut ini dikelompokkan berdasarkan status yang diungkapkan secara publik. Angka-angka tersebut terutama berasal dari pengungkapan perusahaan dan OpenAI; liputan media berfungsi sebagai verifikasi silang, tetapi tidak setara dengan audit pihak ketiga.
| Perusahaan | Skenario | Status pengungkapan | Fakta utama |
|---|---|---|---|
| CVS Health | Mengirim dokumen, rujukan, dan konsultasi spesialis lintas sistem klinis | Alur kerja produksi | Dalam satu akhir pekan membersihkan tumpukan dokumen yang telah berlangsung selama berbulan-bulan; Agent lain setiap hari memproses puluhan ribu langkah operasi sistem terkait konsultasi |
| Cigna Healthcare | Integrasi informasi lintas sistem sebelum manajemen perawatan | Sudah diterapkan | Staf perawatan sebelumnya perlu menelusuri lebih dari 10 sistem; dari konsep hingga penerapan kurang dari 8 minggu |
| Abridge | Koordinasi hambatan pemulangan pasien | Dalam pengembangan | Dokter melalui Abridge Assistant meminta Agent untuk mengoordinasikan secara paralel perolehan obat dan perawatan di rumah |
| Ambience Healthcare | Permohonan preotorisasi asuransi | Demonstrasi solusi tata kelola | Berhenti dan bertanya kepada dokter ketika catatan medis ambigu; baru mengirimkan setelah mendapat persetujuan |
| Assort | Penyelesaian alur rujukan | Studi kasus resmi | API menulis informasi rujukan, Computer Use melengkapi pembaruan status di antarmuka Athena |
“Puluhan ribu” yang disebut CVS merujuk pada beban kerja yang melibatkan langkah operasi sistem, bukan berarti puluhan ribu keputusan klinis diselesaikan sepenuhnya oleh AI secara mandiri. CVS juga merilis CUA Agent Kit sebagai sumber terbuka (lisensi Apache-2.0), dengan arsitektur dua tahap: pertama, Computer-use Agent mengeksplorasi alur kerja berdasarkan bahasa alami dan merekam bukti Trace seperti tangkapan layar, aksi, dan lokasi target; kemudian Codex Skill mengubah jejak yang berhasil menjadi kode deterministik, yang setelah ditinjau oleh insinyur dapat dieksekusi berulang kali. Menurut README, tahap eksekusi deterministik tidak memerlukan kunci API model.
Studi kasus Assort menjelaskan posisi Computer Use: Assort sudah dapat menulis informasi rujukan ke dalam catatan medis melalui Athena API, tetapi untuk menutup alur secara penuh masih ada satu langkah operasi antarmuka yang tersisa. Agent langsung memilih dokter rujukan di antarmuka Athena, mengisi detail, dan memperbarui status menjadi Visit Scheduled; rujukan tersebut kemudian dihapus dari daftar tindak lanjut staf. API menangani operasi terstruktur, sedangkan Computer Use melengkapi bagian yang tidak tercakup API.
Bagaimana Agent medis mengendalikan risiko?
Kemampuan tata kelola yang diumumkan OpenAI mencakup RBAC, log audit, konfigurasi cakupan akses aplikasi, persetujuan manusia sebelum operasi kritis, serta mekanisme kontrol yang membatasi Agent pada alur kerja tertentu. Institusi medis dapat menjeda Agent kapan saja dan meninjau log operasi langkah demi langkah.
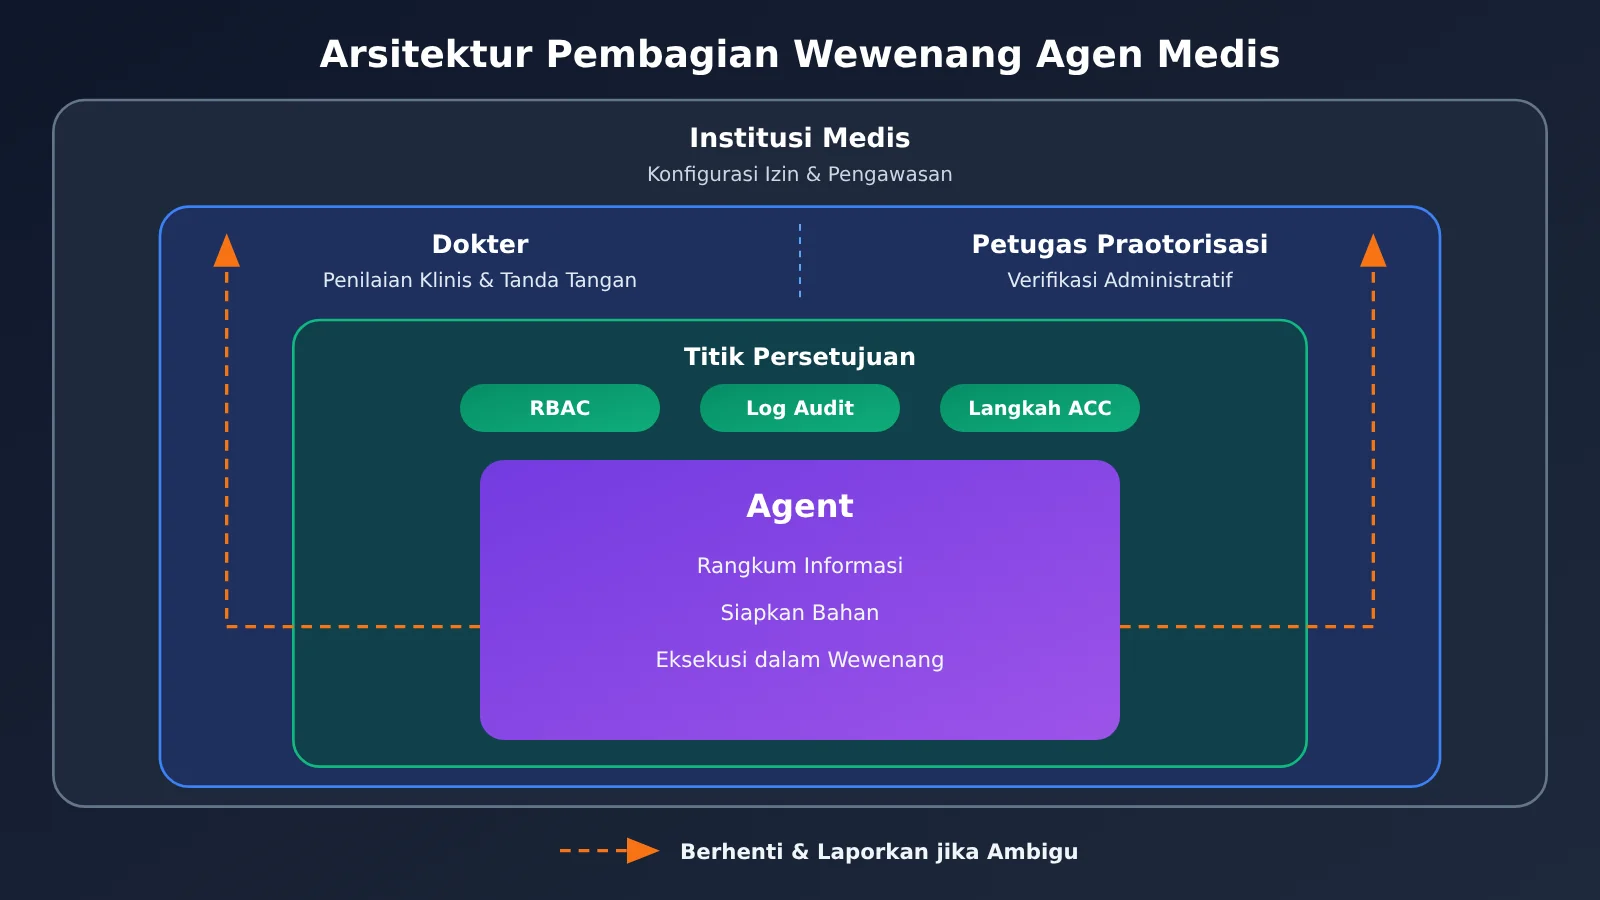
Ini sebenarnya adalah desain pemisahan wewenang: AI bertugas merapikan informasi, menyiapkan materi, dan menjalankan operasi dalam batas wewenangnya; dokter bertanggung jawab atas penilaian klinis; staf praotorisasi bertanggung jawab atas peninjauan administratif; dan institusi medis bertanggung jawab mengonfigurasi izin serta proses pengawasan. Wewenang Agent harus selaras dengan batas tanggung jawab klinis.
Dalam hal kepatuhan data, OpenAI menyatakan bahwa data organisasi di ChatGPT for Healthcare tidak digunakan untuk melatih model dasar, dan CVS juga menyatakan data produksi terkait tetap berada di infrastruktur milik mereka sendiri. Namun, untuk mendukung alur kerja kepatuhan HIPAA yang melibatkan PHI, organisasi medis perlu menggunakan layanan yang memenuhi syarat, memastikan layanan tercakup oleh BAA yang ditandatangani dengan OpenAI, mengonfigurasi pengaturan keamanan dan kebijakan retensi data, serta membatasi catatan dan operasi yang dapat diakses Agent melalui izin organisasi. Jadi, “mendukung alur kerja HIPAA” tidak sama dengan “semua panggilan OpenAI API otomatis patuh”.
Soal saluran yang tersedia, kemampuan terkait dapat diakses melalui OpenAI API, ChatGPT for Healthcare, ChatGPT for Clinicians, ChatGPT Work, dan Codex. Tenaga klinis AS yang memenuhi syarat dapat mengajukan ChatGPT for Clinicians secara gratis, dan kebijakan gratis ini memiliki batasan wilayah serta kualifikasi. ChatGPT for Healthcare tidak memiliki harga langganan tetap yang dipublikasikan secara seragam.
Analisis dan Pertimbangan: Kompromi Agent Medis dan Makna Industrinya
Mengapa industri medis sangat membutuhkan Agent bertipe Computer Use?
Fragmentasi informasi dalam layanan medis sangat khas. Satu kunjungan dokter bisa melibatkan EHR, sistem pencitraan, sistem resep, portal asuransi, sistem rujukan, dan platform manajemen pulang secara bersamaan, dan sistem-sistem ini sering berasal dari vendor berbeda dengan antarmuka yang tidak lengkap. Preotorisasi MRI adalah contoh kecilnya: dokter hanya membuat satu penilaian klinis, tetapi staf harus berulang kali berpindah, menyalin, dan mengunggah data di antara rekam medis, catatan fisioterapi, materi pencitraan, dan portal asuransi.
Dari sudut pandang ini, yang dipecahkan Computer Use bukanlah “apakah AI memahami ilmu kedokteran”, melainkan “apakah informasi dapat mengalir antar sistem”. Penilaian penulis adalah bahwa otomatisasi administrasi medis sangat mungkin mencapai skala komersial lebih awal daripada otomatisasi diagnosis klinis. Alasannya, tugas administrasi bervolume besar, sangat berulang, batasnya jelas, hasilnya dapat diverifikasi melalui formulir dan status sistem, serta risiko tanggung jawabnya relatif terkendali. Kasus Cigna yang memampatkan pencarian informasi lintas lebih dari 10 sistem menjadi hitungan detik mencerminkan jalur “kurangi beban dulu, jangan menggantikan” ini.
Namun, benchmark Stanford juga mengungkap kesulitan sebenarnya. Penelitian awal menemukan bahwa transfer data antar aplikasi dan pemrosesan dokumen adalah sumber kegagalan Agent yang penting; bahkan ketika informasi pasien telah dipahami, kesalahan masih bisa terjadi saat mengunggah file, mengisi kolom, atau memperbarui status. Dalam skenario medis, kesalahan di satu sistem juga bisa tersalin ke berbagai sistem hilir, dan inilah tepatnya alasan mengapa persetujuan manual serta verifikasi status pascaoperasi tidak dapat dihilangkan.
Bagaimana pengembang mengevaluasi biaya dan kelayakan Agent medis?
Bagi pengembang, langkah pertama tidak harus langsung memakai Computer Use. Pendekatan yang lebih aman adalah memecah alur kerja terlebih dahulu: bagian teks murni seperti ekstraksi informasi dan penyusunan dokumen bisa divalidasi kualitasnya lebih dulu dengan antarmuka model biasa; bagian operasi antarmuka kemudian dievaluasi tingkat keberhasilannya secara terpisah. Contoh berikut memakai materi sintetis untuk memvalidasi bagian teks “ekstraksi field yang dibutuhkan untuk pre-otorisasi”, hanya sebagai demonstrasi teknis dan bukan merupakan saran diagnosis atau pengobatan apa pun:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Sesuai daftar model yang benar-benar tersedia di platform
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
Lihat kode lengkap dengan statistik biaya Token
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Harga satuan: dolar / juta Token, isi sesuai model yang benar-benar kamu pakai
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 Saran validasi cepat: sebelum terhubung resmi ke sistem medis, kamu bisa lebih dulu membandingkan performa beberapa model dalam hal ekstraksi field, penyusunan dokumen, dan bagian teks lainnya lewat APIYI apiyi.com dengan satu kunci API. Pengguna baru mendapat kuota uji gratis, cocok untuk menjalankan skrip evaluasi lebih dulu dan mengumpulkan data tingkat tugas.
Soal biaya, harga Standard konteks pendek yang dikueri pada 17 November 2026 (dolar/juta Token) adalah sebagai berikut: GPT-6 Astra input 10, output 50, cached input 1; GPT-6 Luna input 0.10, output 0.50, cached input 0.01. Kecepatan pemrosesan, panjang konteks, dan wilayah juga memengaruhi tagihan aktual. Dengan membalik perhitungan dari 0.085 dolar per tugas untuk Luna dan proporsi “lebih rendah 98%”, Astra kira-kira 4.25 dolar per tugas, tetapi ini nilai estimasi dan hanya biaya pada kondisi baseline, jadi tidak bisa dijadikan penawaran harga produksi.
Perhitungan lengkap seharusnya mencatat input visual dan teks serta output berbayar di setiap putaran secara terpisah, lalu menambahkan pemanggilan tool, lingkungan runtime, dan pemeliharaan rekayasa. Kalau Token dari percobaan ulang sudah terakumulasi ke total, jangan ditambahkan sekali lagi. Selisih harga hampir 50 kali antara dua tingkat model juga memberi petunjuk strategi berlapis: penalaran kompleks diserahkan ke model berkemampuan tinggi, langkah terstruktur dan berfrekuensi tinggi diserahkan ke model berbiaya rendah, sedangkan alur yang sudah stabil dieksplorasi bisa dibekukan menjadi kode deterministik seperti yang dilakukan CVS.
💰 Tips optimasi biaya: Saat melakukan pelapisan model, Anda bisa lebih dulu memakai kode yang kompatibel dengan OpenAI yang sama di APIYI apiyi.com untuk beralih antar model di berbagai tingkat harga, mengukur kualitas dan konsumsi Token untuk setiap jenis subtugas, lalu memutuskan bagian mana yang layak menggunakan model berkapasitas tinggi.
| Tahap validasi | Pertanyaan yang harus dijawab | Bukti yang disarankan | Alat referensi |
|---|---|---|---|
| Tahap teks | Apakah kualitas ekstraksi dan penyusunan draf stabil | Perbandingan anotasi manual, tingkat pemicu NEED_HUMAN | Perbandingan multi-model APIYI apiyi.com |
| Operasi antarmuka | Berapa tingkat penyelesaian end-to-end | Tangkapan layar dan Trace, verifikasi status setelah operasi | Dokumentasi OpenAI Computer Use dan lingkungan sandbox |
| Pemantapan alur | Langkah mana yang dapat diubah menjadi kode deterministik | Tingkat reproduksi lintasan yang berhasil | Arsitektur dua fase seperti CUA Agent Kit |
| Tata kelola peluncuran | Apakah izin dan persetujuan mencakup tindakan kunci | Konfigurasi RBAC, pemeriksaan sampel log audit | Sistem izin dan kepatuhan internal institusi |
Apakah Agent medis dan RPA saling menggantikan atau berfusi?
RPA tradisional bergantung pada aturan tetap dan posisi elemen antarmuka; begitu antarmuka berubah, skrip bisa langsung tidak berfungsi. Computer-use Agent dapat memahami bahasa alami, mengamati antarmuka saat ini, dan beradaptasi terhadap perubahan, tetapi setiap kali melakukan penalaran ulang akan menimbulkan biaya dan fluktuasi hasil. Dalam sebuah penelitian yang membandingkan kedua jenis teknologi (DOI: 10.1080/23311975.2026.2724760), alur P2 dan P3 masing-masing dijalankan 10 kali untuk setiap teknologi; pada alur P1, Agent hanya mencatat 1 kegagalan dan tidak dimasukkan ke statistik selanjutnya, jadi tidak bisa secara umum dikatakan bahwa semua tugas dijalankan 10 kali. Penelitian tersebut menggunakan konfigurasi alat dari tahun 2025 dan tidak dapat secara langsung mewakili performa model tahun 2026.
Menurut penulis, pendekatan CVS “AI mengeksplorasi, kode memantapkan, eksekusi berulang” lebih mungkin menjadi bentuk rekayasa arus utama: Agent bertugas menemukan dan memahami alur yang belum dikenal, kode deterministik bertugas mengulang alur yang sudah diketahui secara stabil, API terus menangani interaksi frekuensi tinggi dan terstruktur, serta persetujuan manusia menjaga titik-titik kunci. Menggabungkan API, Computer Use, kode deterministik, dan persetujuan manusia jauh lebih realistis daripada bertumpu pada satu teknologi saja.
Apa arti Agent medis bagi seluruh industri AI?
Kesehatan hanyalah ajang uji dengan ambang masuk yang tinggi. Fragmentasi sistem, persyaratan kepatuhan, dan batas tanggung jawabnya lebih ketat daripada perusahaan biasa. Jika Agent yang mengeksekusi mampu membangun cara operasi yang dapat diaudit, dapat dijeda, dan selaras dengan izin di sini, pendekatan itu bisa dimigrasikan ke asuransi, keuangan, pemerintahan, dan industri lain yang juga bergantung pada sistem lama.
Ini juga berarti dimensi persaingan industri sedang berubah. Dulu yang dibandingkan adalah apakah model bisa menulis konten bagus; ke depan yang lebih penting adalah apakah model bisa menyelesaikan pekerjaan di sistem nyata, berhenti tepat waktu saat terjadi kesalahan, dan meninggalkan jejak yang dapat ditelusuri di setiap langkah. Bagi vendor perangkat lunak, Computer Use memungkinkan perusahaan AI ikut serta dalam alur kerja tanpa harus sepenuhnya mengendalikan perangkat lunak di bawahnya. Ini menurunkan ambang integrasi sekaligus memberi tekanan pada pola lama “menunggu vendor membuka API”. Namun, interaksi yang sangat andal dan berfrekuensi tinggi tetap lebih cocok untuk API; Computer Use lebih merupakan pelengkap, bukan pengganti.
Ke depan, beberapa hal layak diperhatikan: apakah OpenAI akan mempublikasikan data evaluasi per tugas dan konfigurasi eksperimen lengkap; apakah versi makalah HealthAdminBench dapat menjadi standar perbandingan yang seragam bagi semua pihak; apakah solusi koordinasi pemulangan pasien Abridge dapat beralih dari pengembangan ke penerapan; dan apakah data produksi dari lebih banyak rumah sakit dapat membuktikan bahwa tingkat penyelesaian end-to-end benar-benar dapat digunakan. Sebelum bukti-bukti itu muncul, demo dan skor hanyalah titik awal, bukan kesimpulan.
Agent medis telah membuktikan bahwa dirinya mampu “bertindak”, tetapi apakah ia benar-benar dapat meringankan beban klinis dan administratif masih bergantung pada tingkat penyelesaian end-to-end dalam alur kerja nyata, kemampuan berhenti saat terjadi kesalahan, dan biaya jangka panjang. Seperti kata peribahasa Inggris: The proof of the pudding is in the eating. (Efek nyata harus diuji melalui praktik.)
Referensi
- Pengumuman resmi OpenAI: Advancing computer-use agents for healthcare teams
- Tautan:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Tautan:
- Dokumentasi bantuan ChatGPT for Healthcare: Kemampuan produk, BAA, dan penjelasan plugin
- Tautan:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- Tautan:
- Dokumentasi pengembangan OpenAI Computer Use: Computer Tool dan jalur Code Execution
- Tautan:
developers.openai.com/api/docs/guides/tools-computer-use
- Tautan:
- Makalah HealthAdminBench: Tugas dan metrik versi 2604.09937v1
- Tautan:
arxiv.org/html/2604.09937v1
- Tautan:
- CVS Health CUA Agent Kit: Arsitektur dua tahap, yaitu eksplorasi dan konsolidasi
- Tautan:
github.com/cvs-health/cua-agent-kit
- Tautan:
- Laporan Fierce Healthcare: Mitra dan skenario penerapan HLTH26
- Tautan:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- Tautan:
- Cambridge Dictionary: Pemeriksaan teks asli peribahasa
- Tautan:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika Anda ingin membandingkan performa berbagai Model Bahasa Besar pada bagian teks Agent, silakan kunjungi APIYI apiyi.com untuk mendapatkan kuota pengujian. Untuk penjelasan integrasi lebih lanjut, Anda dapat melihat pusat dokumentasi docs.apiyi.com