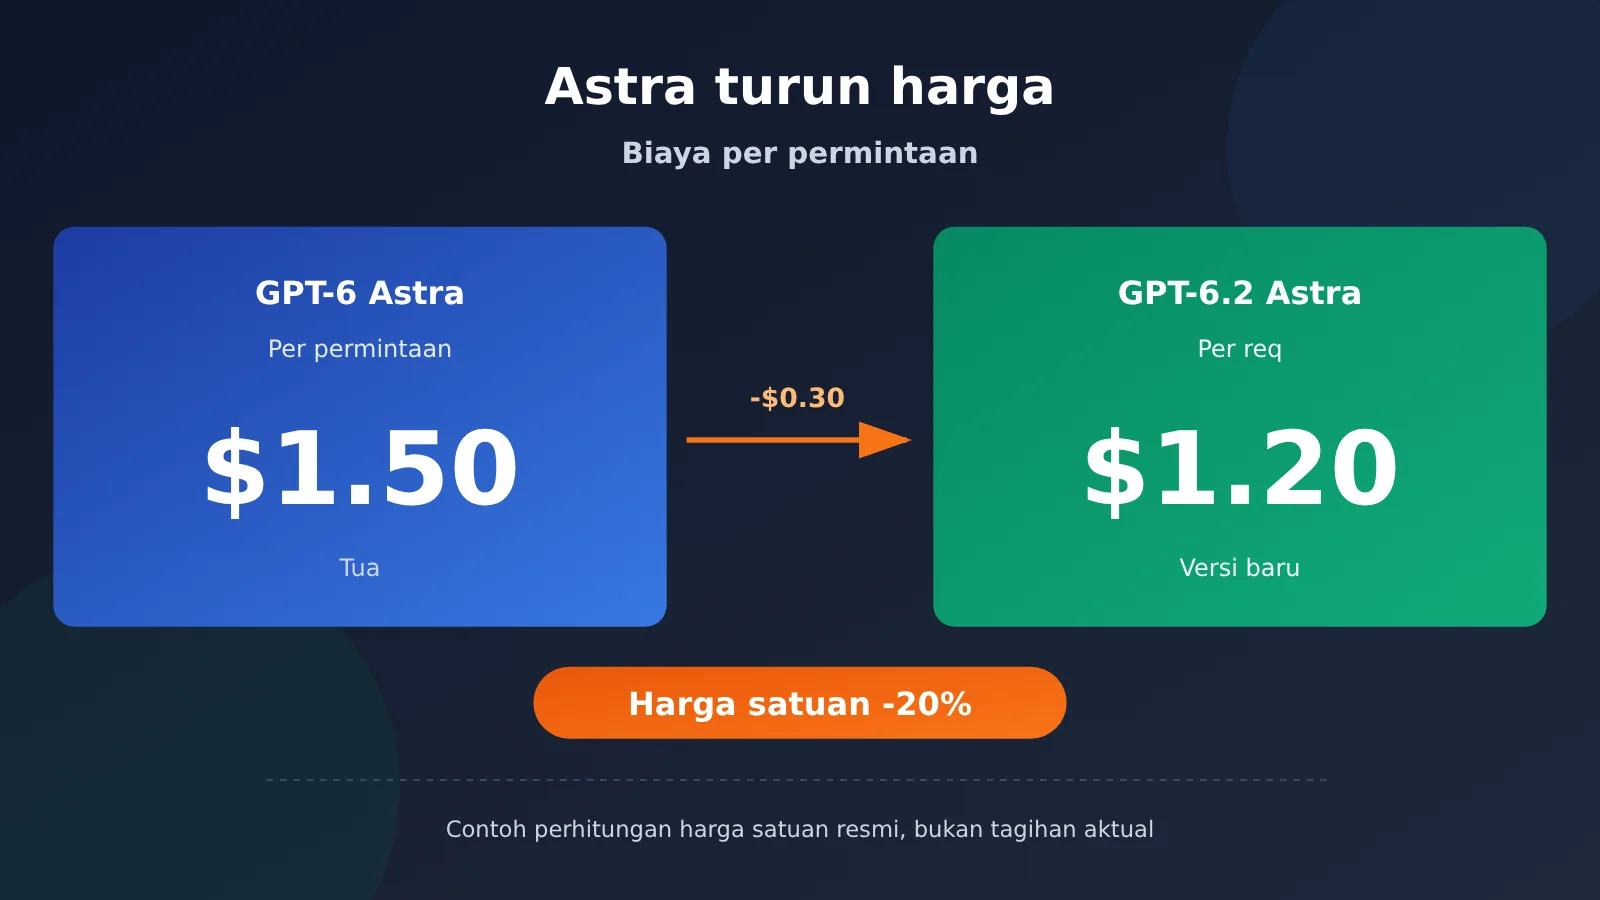
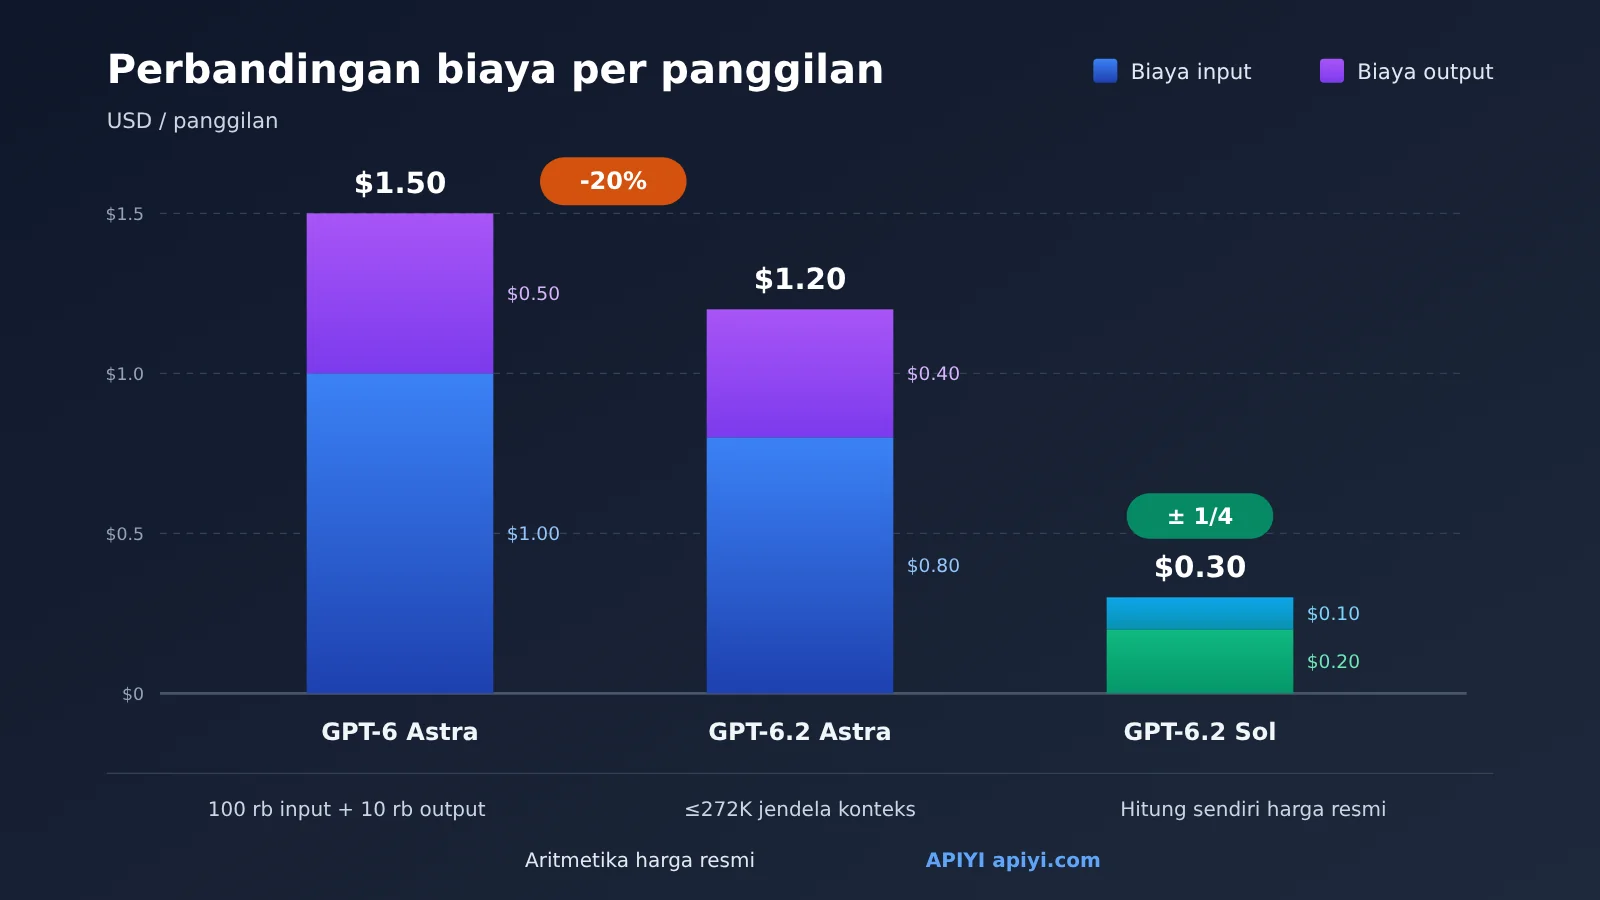
Sebagai contoh, mari ambil satu permintaan standar dengan input non-cache 100 ribu token + output 10 ribu token, dan input tidak melebihi 272K: jika dihitung berdasarkan harga satuan resmi, GPT-6 Astra membutuhkan sekitar $1.50, sedangkan GPT-6.2 Astra sekitar $1.20. Setiap permintaan menghemat $0.30, tepat 20%. Dengan jumlah token yang sama, beralih ke GPT-6.2 Sol hanya membutuhkan sekitar $0.30. Perlu diperhatikan bahwa ini adalah “penurunan harga satuan sebesar 20%”. Faktor seperti cache, tingkatan konteks panjang, volume output penalaran, dan pemanggilan tool akan memengaruhi biaya akhir; tagihan aktual belum tentu turun secara proporsional sebesar 20%.
Apa yang bisa Anda pelajari setelah membaca artikel ini?
- Berapa harga standar resmi GPT-6.2 Astra dan Sol yang dirilis OpenAI pada 17 November 2026.
- Bagaimana menghitung biaya satu permintaan API: setiap langkah perkalian, konversi unit, dan asumsi yang mendasarinya.
- Seberapa jauh pembacaan cache, konteks panjang di atas 272K, dan perubahan token output membuat biaya aktual menyimpang dari “penurunan harga 20%”.
- Bagaimana pengembang dan penanggung jawab anggaran harus menghitung ulang biaya pemanggilan mereka.
Daftar isi: Artikel ini dimulai dengan tabel konsep dan ringkasan dampak untuk memberikan latar belakang; bagian pertama “Fakta Objektif” merangkum informasi rilis resmi, tabel harga, dan ulasan resmi, serta memberikan tiga contoh perhitungan sendiri berdasarkan harga satuan resmi; bagian kedua “Analisis dan Penilaian” menjelaskan selisih antara penurunan harga satuan dan penurunan tagihan, memberikan saran respons untuk berbagai peran, dan menyertakan kode estimasi biaya yang dapat langsung dijalankan.
Konsep Terkait Penurunan Harga GPT-6.2 Astra yang Perlu Diketahui
| Konsep | Penjelasan Singkat |
|---|---|
| Token | Unit dasar untuk penagihan model dan pemrosesan teks; API diberi harga per “sejuta token” |
| Input non-cache | Dalam artikel ini, bagian input biasa yang tidak ditagih sebagai pembacaan cache maupun penulisan cache |
| Pembacaan cache | Bagian dari permintaan yang cocok dengan cache petunjuk; harga satuannya jauh lebih rendah daripada input non-cache |
| Penulisan cache | Penulisan token menggunakan tarif total tersendiri; token yang sama tidak lagi dikenai biaya input biasa secara tambahan |
| Tingkatan konteks panjang | Saat input melebihi 272K token, tarif input dan cache untuk keseluruhan permintaan menjadi 2 kali lipat, sedangkan tarif output menjadi 1.5 kali lipat |
| Tingkat penalaran | Intensitas penalaran yang digunakan model sebelum menjawab; semakin tinggi tingkatnya, biasanya semakin banyak token yang dikonsumsi |
| GDPval v2 / ALE / FrontierCode 2.0 | Tiga evaluasi yang dikutip OpenAI dalam pengumuman; objek dan cakupan evaluasinya berbeda, sehingga hasilnya tidak dapat saling dikonversi |
Ringkasan Cepat Dampak Penurunan Harga GPT-6.2 Astra sebesar 20%
| Kelompok | Dampak Utama |
|---|---|
| Pengembang API | Pada permintaan dengan panjang normal, harga satuan input dan output Astra sama-sama turun 20%, sehingga biaya untuk volume pemanggilan yang sama ikut menurun; permintaan dengan konteks sangat panjang perlu dihitung terpisah |
| Penanggung jawab anggaran | Anggaran harga satuan Astra dapat dievaluasi ulang berdasarkan angka 20%, tetapi penurunan biaya sebenarnya perlu mempertimbangkan rasio hit cache, panjang konteks, dan volume output, lalu diverifikasi dengan data tagihan |
| Tim yang sedang melakukan seleksi | Harga satuan standar Sol sekitar 1/4 dari Astra, sehingga tugas yang sensitif terhadap biaya mendapat satu opsi tambahan yang layak dievaluasi |
| Pengguna ChatGPT biasa | Putaran ini terutama dibuka secara bertahap untuk ChatGPT Work, Codex, dan API; Chat biasa tidak termasuk dalam cakupan peluncuran putaran ini |
1. Fakta objektif penurunan harga GPT-6.2 Astra sebesar 20%
Konten berikut berasal dari halaman rilis resmi OpenAI, dokumentasi model, dan halaman harga, dengan tanggal verifikasi 18 November 2026. Semua data evaluasi adalah laporan resmi, bukan hasil pengujian tim kami sendiri.
1.1 Informasi dasar peluncuran GPT-6.2 Astra dan Sol
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 17 November 2026. Kedua model ini mendukung input berupa teks dan gambar, dengan output berupa teks, dan tidak dapat menghasilkan video secara native.
Mengenai cakupan peluncuran, pihak resmi menyatakan bahwa model baru akan dibuka secara bertahap untuk pengguna ChatGPT Work, Codex, dan API, sementara Chat biasa tidak termasuk dalam cakupan rilis putaran ini. Ritme pembukaan spesifik mengacu pada dokumentasi bantuan OpenAI.
1.2 Harga Standar API Resmi GPT-6.2 Astra
Tabel di bawah ini menunjukkan harga resmi OpenAI pada tingkat Standard, saat input tidak melebihi 272K token, dengan satuan dolar per juta token — bukan harga dari APIYI. Volume output dihitung berdasarkan total output yang ditagih dalam usage, termasuk token penalaran, dan tidak sama dengan panjang teks yang terlihat.
| Model | Input non-cache | Pembacaan cache | Output | Sumber data |
|---|---|---|---|---|
| GPT-6 Astra (generasi sebelumnya) | $10 | $1.00 | $50 | Halaman model OpenAI |
| GPT-6.2 Astra | $8 | $0.4 | $40 | Halaman model / halaman harga OpenAI |
| GPT-6.2 Sol | $2 | $0.1 | $10 | Halaman model / halaman harga OpenAI |
Ada dua aturan penagihan resmi lagi yang perlu diperhatikan:
- Penulisan cache ditagih dengan tarif total tersendiri: biaya penulisan Astra untuk konteks pendek Standard adalah $10/juta token untuk 30 menit dan $20/juta token untuk 12 jam — bukan berarti biaya ini ditambahkan di atas tarif input biasa $8. Token input yang sama harus masuk ke salah satu kategori: input biasa, pembacaan cache, atau penulisan cache dengan masa hidup yang sesuai, dan tidak boleh ditagih dua kali.
- Ketika input melebihi 272K token, tarif input dan tarif cache untuk seluruh permintaan dihitung 2 kali lipat, sedangkan tarif output dihitung 1,5 kali lipat.
Dibandingkan dengan generasi sebelumnya, input non-cache Astra turun dari $10 menjadi $8, dan output turun dari $50 menjadi $40 — keduanya turun 20%. Inilah makna akurat dari “penurunan harga 20%”: harga satuan standar turun 20%.
1.3 Data evaluasi resmi GPT-6.2 Astra (bukan hasil pengukuran tim ini)
OpenAI memberikan beberapa hasil evaluasi dalam pengumumannya. Setiap evaluasi memiliki dasar pengukuran yang berbeda, jadi tidak bisa digabungkan begitu saja:
- GDPval v2: GPT-6.2 Astra lebih tinggi 6,2 poin persentase dibandingkan GPT-6 Astra, dengan output token 22% lebih sedikit; GPT-6.2 Sol lebih tinggi 5,3 poin persentase dibandingkan GPT-6.1 Sol.
- ALE: GPT-6.2 Astra meningkat 5,2 poin. Ini adalah evaluasi lain, sehingga tidak bisa dijumlahkan atau dibandingkan dengan poin persentase GDPval.
- FrontierCode 2.0: pada tingkat penalaran max, skor Sol lebih rendah 0,5 poin dibandingkan Astra, dengan biaya tugas sekitar 1/5 biaya Astra. Ini hanya berlaku untuk pengujian dan tingkat tersebut, dan tidak bisa dijadikan kesimpulan biaya secara umum.
1.4 Contoh Perhitungan Sendiri Biaya Satu Permintaan GPT-6.2 Astra
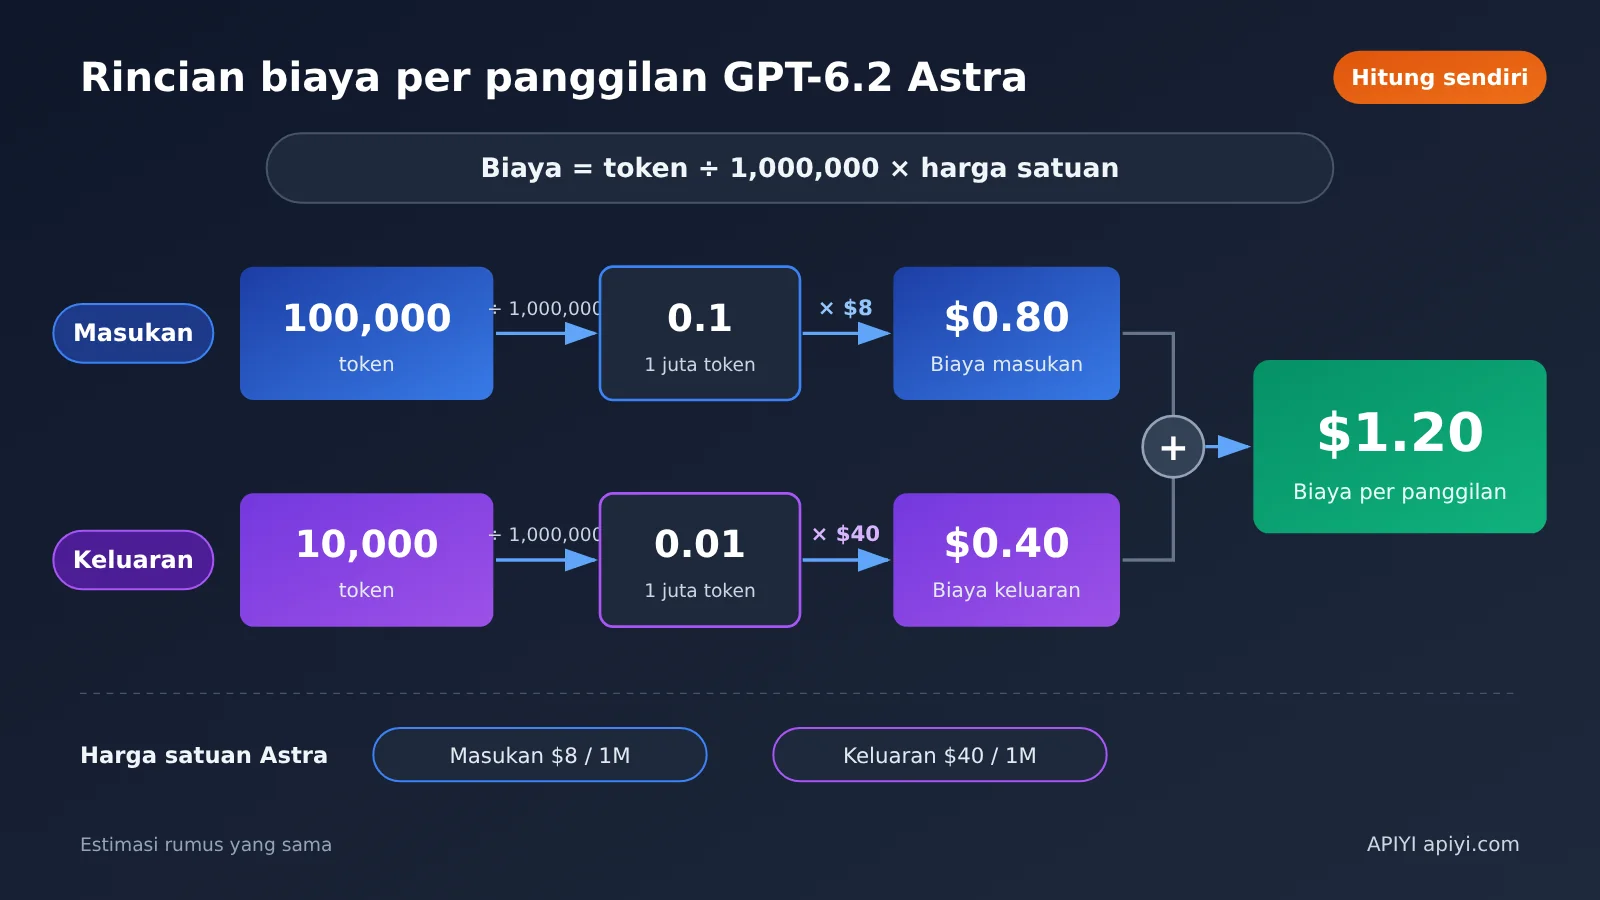
Tiga kelompok contoh perhitungan berikut adalah aritmetika yang kami lakukan berdasarkan harga satuan standar dari situs resmi, bukan hasil pengukuran API, dan juga tidak mewakili tagihan aktual akun mana pun. Rumus perhitungannya adalah:
Biaya = jumlah token ÷ 1,000,000 × harga per juta token
Contoh perhitungan 1: Permintaan standar, perbandingan Astra lama dan baru serta Sol
Asumsi awal: input non-cache 100,000 token, output 10,000 token, input tidak melebihi 272K, tidak ada pembacaan atau penulisan cache, tidak ada pemanggilan tool, dihitung dengan harga standar.
| Item | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Biaya input | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| Biaya output | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| Total per permintaan | $1.50 | $1.20 | $0.30 |
| Relatif terhadap GPT-6 Astra | Basis | Lebih murah $0.30 (-20%) | Lebih murah $1.20 (-80%) |
Angka “0.1” dalam tabel berarti 100,000 ÷ 1,000,000, dan “0.01” berarti 10,000 ÷ 1,000,000. Jika setiap bulan mengirim 10,000 permintaan yang sama, dengan asumsi kelompok ini, GPT-6 Astra sekitar $15,000, sedangkan GPT-6.2 Astra sekitar $12,000. Hasil ini hanyalah ekstrapolasi linear dan bukan merupakan komitmen biaya apa pun.
Contoh perhitungan 2: Permintaan GPT-6.2 Astra dengan cache hit
Asumsi awal: total input 100,000 token, di antaranya 80,000 token merupakan pembacaan cache hit, 20,000 token adalah input biasa yang tidak ditulis ke cache, output 10,000 token; volume penulisan cache kali ini dianggap nol, dan biaya pembentukan cache historis tidak dihitung dalam contoh perhitungan ini.
- Input non-cache: 0.02 × $8 = $0.16
- Pembacaan cache: 0.08 × $0.4 = $0.032
- Output: 0.01 × $40 = $0.40
- Total: sekitar $0.592
Harga pembacaan cache GPT-6 Astra generasi sebelumnya adalah $1.00/juta token, sedangkan versi baru $0.40, turun 60%. Dengan jumlah token yang sama, biaya generasi sebelumnya adalah $0.20 + $0.08 + $0.50 = $0.78; versi baru $0.592, lebih murah $0.188, sekitar turun 24.1%. Keduanya belum menghitung penulisan cache, tool, dan biaya lain, sehingga tidak dapat dianggap sebagai tagihan lengkap.
Contoh perhitungan 3: Permintaan konteks panjang GPT-6.2 Astra yang melebihi 272K
Asumsi awal: input biasa 300,000 token (melebihi 272K), output 10,000 token, volume pembacaan dan penulisan cache keduanya nol.
- Input: 0.3 × ($8 × 2) = $4.80
- Output: 0.01 × ($40 × 1.5) = $0.60
- Total: $5.40
Perhatikan bahwa tarif bertingkat dihitung berdasarkan keseluruhan permintaan. Begitu input melebihi 272K, seluruh input dalam permintaan tersebut ditagih dengan tarif 2 kali lipat, bukan hanya bagian yang melebihi batas yang dikenakan harga lebih tinggi.
Konfigurasi masa hidup cache menggunakan prompt_cache_options.ttl pada Responses API: default "30m", bisa dipilih "12h", dan satu breakpoint eksplisit dapat ditimpa lewat prompt_cache_breakpoint.ttl. Nilai ini menunjukkan masa hidup cache minimum, bukan batas waktu penghapusan data, dan tidak boleh dicampur dengan parameter prompt_cache_retention milik model lama.
Saat input melebihi 272K, untuk Astra tingkat Standard, biaya input reguler, pembacaan cache, penulisan 30 menit, penulisan 12 jam, dan output masing-masing $16, $0.80, $20, $40, dan $60 per juta token; faktor pengali berlaku untuk keseluruhan permintaan, bukan hanya bagian yang melebihi.
1.5 Sumber resmi GPT-6.2 Astra
-
Pengumuman OpenAI: openai.com/index/introducing-gpt-6-2-astra-sol/
- Dokumen model GPT-6 Astra: Harga resmi model lama
- Dokumen model GPT-6.2 Astra: Harga resmi model baru dan ketentuan tarif
- Dokumen model GPT-6.2 Sol: developers.openai.com/api/docs/models/gpt-6.2-sol
- Halaman harga OpenAI API: developers.openai.com/api/docs/pricing
- Dokumentasi bantuan ChatGPT Work dan Codex: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
2. Analisis dan penilaian atas penurunan harga GPT-6.2 Astra sebesar 20%
Berikut adalah tafsiran editor berdasarkan fakta-fakta di atas. Ini merupakan analisis dan penilaian, bukan kesimpulan resmi.
2.1 Harga satuan turun 20%, mengapa tagihan belum tentu ikut turun 20%
Contoh perhitungan pertama bisa menghasilkan angka 20% yang persis karena hanya mencakup dua komponen, yakni input non-cache dan output standar, dan keduanya kebetulan turun tepat 20%. Tagihan bisnis nyata biasanya terdiri dari bermacam-macam biaya, sehingga perubahan proporsi pada satu komponen saja sudah cukup membuat penurunan keseluruhan menyimpang dari 20%.
| Faktor biaya | Kemungkinan dampak terhadap tagihan aktual | Dasar penilaian |
|---|---|---|
| Pembacaan dan penulisan cache | Harga satuan pembacaan cache turun 60%, berbeda dari 20% pada input non-cache; harus dihitung berdasarkan jumlah token masing-masing, tidak bisa mengasumsikan penurunan keseluruhan; penulisan cache memakai tarif total tersendiri dan tidak ditumpuk dengan biaya input biasa | Tabel harga resmi |
| Tingkatan konteks panjang | Bila melebihi 272K, tarif untuk keseluruhan permintaan naik, sehingga biaya per permintaan pada skenario dokumen panjang bisa jauh lebih tinggi daripada contoh perhitungan pertama | Aturan penagihan resmi |
| Jumlah token output / reasoning | Pihak resmi melaporkan output token 22% lebih sedikit pada GDPval v2; jika tugas Anda mengalami perubahan serupa, penghematan bisa melebihi 20%; jika tingkat reasoning lebih tinggi, biayanya juga bisa lebih mahal | Evaluasi resmi (tugas tertentu) |
| Pemanggilan tool dan tingkat kecepatan | Fast pada GPT-6.2 Astra adalah 2 kali tarif Standard untuk konteks yang sama, sedangkan Batch 50%; biaya tool dihitung terpisah sesuai tool yang digunakan | Halaman model dan halaman harga resmi |
| Saluran pemanggilan | Saat memanggil lewat platform pihak ketiga seperti APIYI apiyi.com, yang berlaku adalah penagihan aktual yang diumumkan platform, harga resmi tidak bisa langsung dipakai | Perbedaan saluran |
Satu hal yang mudah terlewat adalah “output 22% lebih sedikit”. Angka ini berasal dari satu evaluasi, yaitu GDPval v2. Jika langsung diterapkan ke semua bisnis lalu ditarik kesimpulan “praktis hemat lebih dari 30%”, berarti hasil resmi pada evaluasi tertentu diperlakukan sebagai aturan umum. Pendekatan yang lebih aman adalah melakukan uji sampel kecil dengan permintaan nyata Anda sendiri, mencatat jumlah token pada field usage, lalu baru membuat penilaian.
2.2 Penilaian Pemilihan GPT-6.2 Astra vs Sol
Dari harga satuan standar, setiap pos harga Sol kira-kira 1/4 dari Astra. Pada contoh perhitungan pertama, biaya sekali pakai Sol hanya seperempat dari Astra. Hasil FrontierCode 2.0 menunjukkan bahwa pada tingkat penalaran max, selisih skor Sol dengan Astra sangat kecil, tetapi pihak resmi tidak menjelaskan apakah kesimpulan ini dapat digeneralisasi ke tugas lain.
Jadi penilaian kami adalah: untuk skenario yang sensitif terhadap biaya dengan tingkat kesulitan tugas menengah, Sol layak dievaluasi lebih dulu; untuk skenario yang menuntut kualitas tinggi atau tugas kompleks, ambang Astra juga menurun setelah harganya diturunkan. Mana yang akhirnya dipilih sebaiknya ditentukan melalui perbandingan A/B menggunakan kumpulan tugas Anda sendiri.
💡 Saran pemilihan: Jika perlu membandingkan konsumsi token dan kualitas output beberapa model dalam satu basis kode yang sama, Anda bisa mempertimbangkan beralih model melalui antarmuka agregasi yang kompatibel dengan OpenAI seperti APIYI apiyi.com. Apakah seri GPT-6.2 sudah tersedia di platform dan berapa harganya, silakan mengacu pada daftar model dan halaman penagihan platform.
2.3 Kode Estimasi Biaya GPT-6.2 Astra
Skrip di bawah ini hanya melakukan aritmetika lokal, tidak memanggil API. Input dipecah menjadi empat kategori yang tidak saling tumpang tindih: input biasa, pembacaan cache, penulisan 30 menit, dan penulisan 12 jam; total volume input digunakan untuk menentukan tier 272K. Tarif penulisan adalah tarif total, bukan lagi menambahkan biaya input biasa ke token penulisan.
# Tarif OpenAI Standard, dolar per juta token; tidak termasuk biaya alat, pajak, dan tier lainnya
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# Input 100 ribu yang sama semuanya ditagih sebagai penulisan 30 menit: bukan 1.2 ditambah 1.0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
Untuk usage pada Responses, pertama identifikasi jumlah pembacaan cache dan jumlah penulisan, lalu kurangi keduanya dari total input untuk mendapatkan input biasa. Saat mencampur masa simpan 30 menit dan 12 jam, jumlah penulisan juga perlu dialokasikan sesuai rincian penagihan aktual; tidak boleh menerapkan satu tarif untuk semua penulisan. Jika channel tidak memiliki rincian penulisan atau dasar penagihannya berbeda, gunakan tagihan channel tersebut untuk verifikasi, dan jangan menganggap jumlah penulisan nol secara default. Ketika output yang ditagih sudah mencakup token penalaran, jangan menambahkan jumlah penalaran lagi. Artikel ini tidak melakukan pemanggilan API secara aktual; apakah platform pihak ketiga mendukung konfigurasi ini dan bagaimana penagihannya, silakan mengacu pada dokumentasi mereka.
2.4 Saran Penanganan Setelah Penurunan Harga GPT-6.2 Astra
Untuk pengembang: Pertama, hitung distribusi panjang input dari permintaan yang ada, lalu lihat berapa banyak permintaan yang mendekati atau melebihi 272K. Jika proporsi permintaan konteks panjang tinggi, Anda dapat mengendalikan input agar berada dalam batas tingkatan melalui pemotongan retrieval, kompresi ringkasan, dan cara lainnya. Dengan begitu, biaya yang dihemat bisa lebih besar daripada penurunan harga 20%. Pada saat yang sama, letakkan petunjuk sistem tetap di bagian awal permintaan untuk meningkatkan tingkat cache hit.
Untuk penanggung jawab anggaran: Anda dapat memakai “penurunan harga satuan standar Astra sebesar 20%” sebagai acuan dasar anggaran pada volume input dan output non-cache yang sama, bukan sebagai batas atas penurunan aktual atau jumlah penghematan yang pasti. Disarankan untuk membandingkan tagihan nyata dari periode sebelum dan sesudah migrasi, lalu mencantumkan perubahan cache, konteks panjang, dan token output secara terpisah. Tim yang memanggil melalui platform seperti APIYI apiyi.com juga harus berpedoman pada dasar penagihan dari tagihan platform.
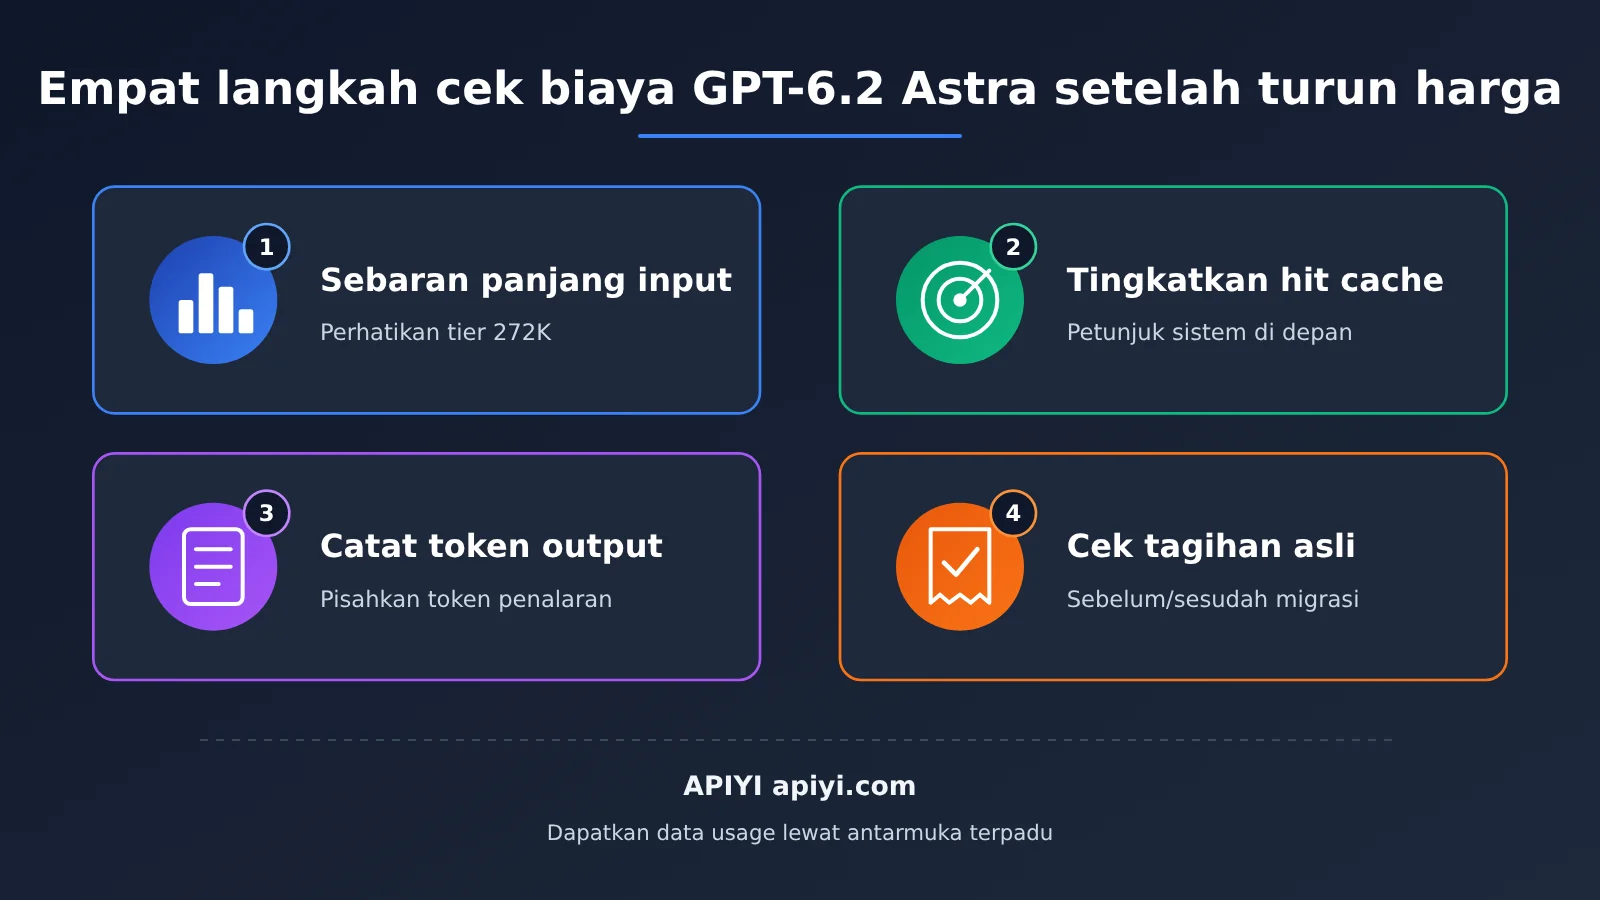
Perubahan lanjutan yang masih perlu diperhatikan: Pembaruan harga resmi, progres pembukaan saluran, serta apakah evaluasi independen pihak ketiga dapat mereproduksi data resmi. Pihak resmi telah mencantumkan tarif penulisan cache dan tingkat kecepatan, sehingga saat mengestimasi Anda harus memverifikasi tingkat yang dipilih dan tidak menganggapnya belum diumumkan. Astra baru pada Standard konteks pendek memiliki penulisan cache dengan masa retensi 30 menit sebesar $10/juta token, dan 12 jam sebesar $20/juta token; tiga kelompok contoh perhitungan utama dalam artikel ini semuanya mengasumsikan volume penulisan cache kali ini nol, yang bukan berarti permintaan API default pasti tidak memiliki penulisan.
Jika ingin lebih dulu menjalankan alur verifikasi penagihan, Anda dapat menggunakan kumpulan kode yang sama di APIYI apiyi.com untuk membandingkan data usage dari berbagai model. Setelah seri GPT-6.2 tersedia di saluran yang Anda gunakan, Anda dapat langsung memasukkan jumlah token nyata ke dalam fungsi estimasi di atas.
Penurunan harga 20% adalah sinyal yang jelas, tetapi angka pada tagihan bergantung pada seberapa panjang input di setiap permintaan, berapa banyak cache hit, dan berapa banyak output. Menghitung setiap perkalian dengan cermat lebih berguna daripada sekadar mengingat satu persentase.
“Beware of little expenses; a small leak will sink a great ship.”
——Benjamin Franklin, Poor Richard’s Almanack
(Perhatikan pengeluaran kecil, kebocoran kecil saja sudah cukup untuk menenggelamkan kapal besar.)