Catatan penulis: Tim yang menggunakan OpenAI, Claude, Gemini, dan Qwen secara bersamaan bisa memisahkan token per proyek dalam satu akun, lalu menetapkan kuota, masa berlaku, allowlist model, dan grup untuk setiap token, serta mencocokkan tagihan melalui log token.
Penanggung jawab R&D yang mengintegrasikan beberapa model sekaligus biasanya menghadapi tiga masalah. Pertama, kunci API tersebar di backend masing-masing vendor, sehingga sulit memastikan siapa memegang kunci API yang mana. Kedua, tagihan akhir bulan tidak cocok dengan proyek, dan tidak diketahui proyek mana yang menghabiskan berapa banyak. Ketiga, setelah satu kunci API diberikan kepada banyak orang, untuk menghentikan akses satu orang saja, seluruh kunci API harus dicabut. Artikel ini membahas cara pengelolaan akun APIYI + token yang dipisah per proyek, sehingga pengelolaan multi-model perusahaan dapat diturunkan menjadi langkah konfigurasi yang bisa dijalankan.
Ini bukan artikel penjelasan “mengapa perlu layanan proksi API” yang lain. Setiap item konfigurasi di bawah ini mengacu pada penjelasan token dan grup di dokumentasi APIYI apiyi.com. Semua angka yang terkait rate dan grup akan ditandai berasal dari teks asli dokumentasi.
Nilai inti: Setelah membaca artikel ini, Anda dapat membuat token independen untuk setiap proyek, membatasi berapa biaya yang boleh dipakai, berapa lama masa berlakunya, model mana yang boleh dipanggil, dan grup mana yang digunakan, serta melihat konsumsi setiap proyek di log token.
Poin Inti Manajemen Multi-Model Perusahaan: Pisahkan Kunci, Kuota, dan Log per Proyek
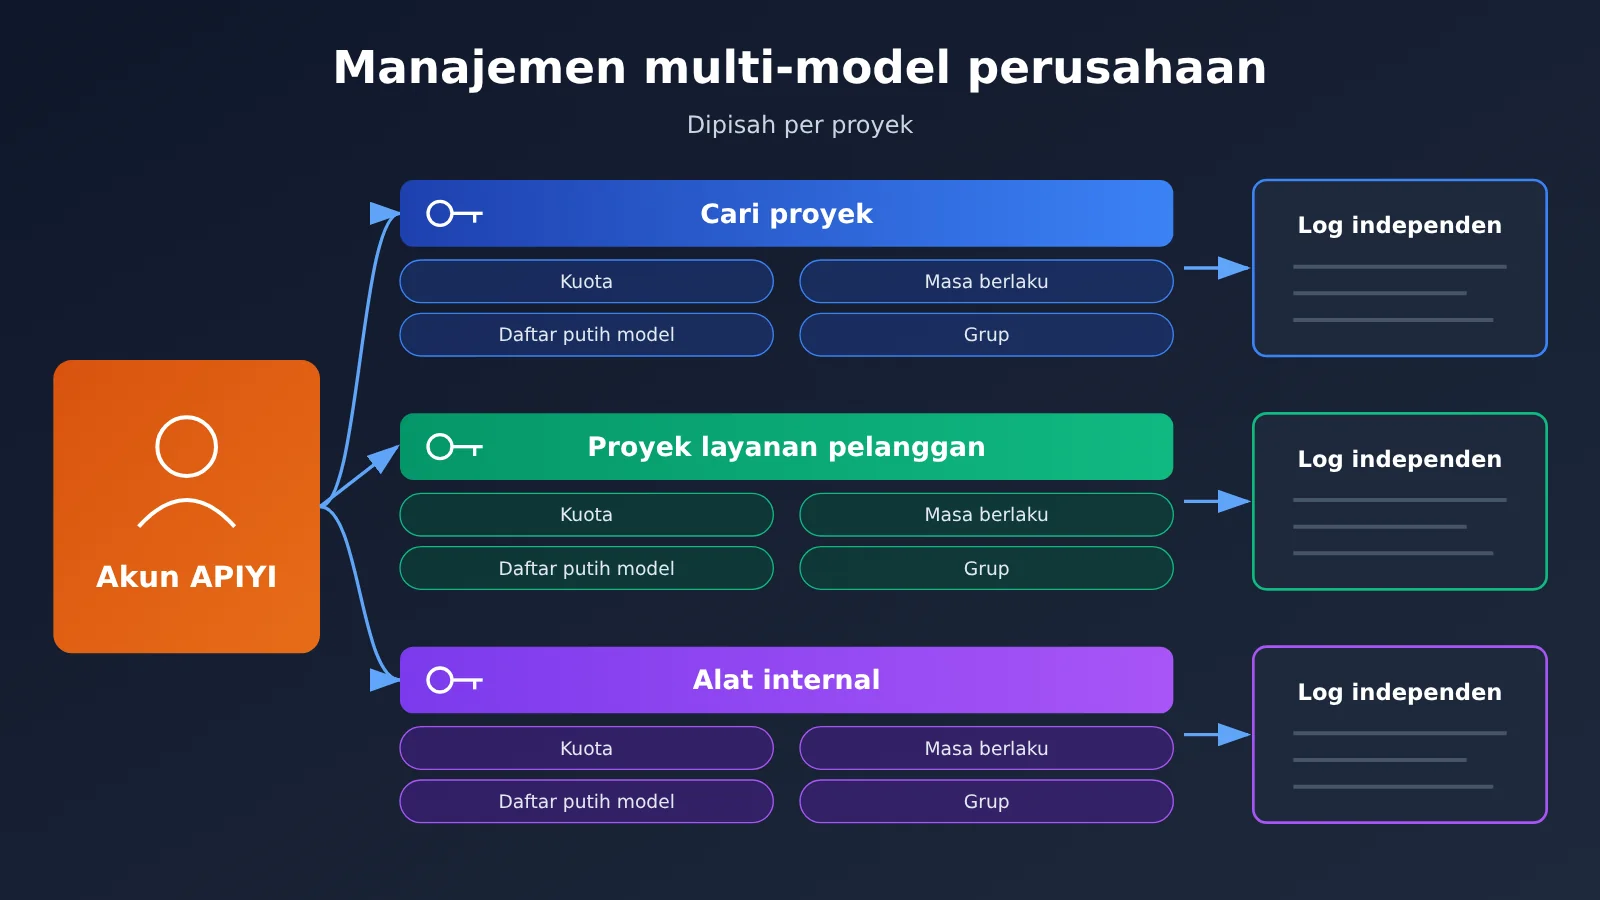
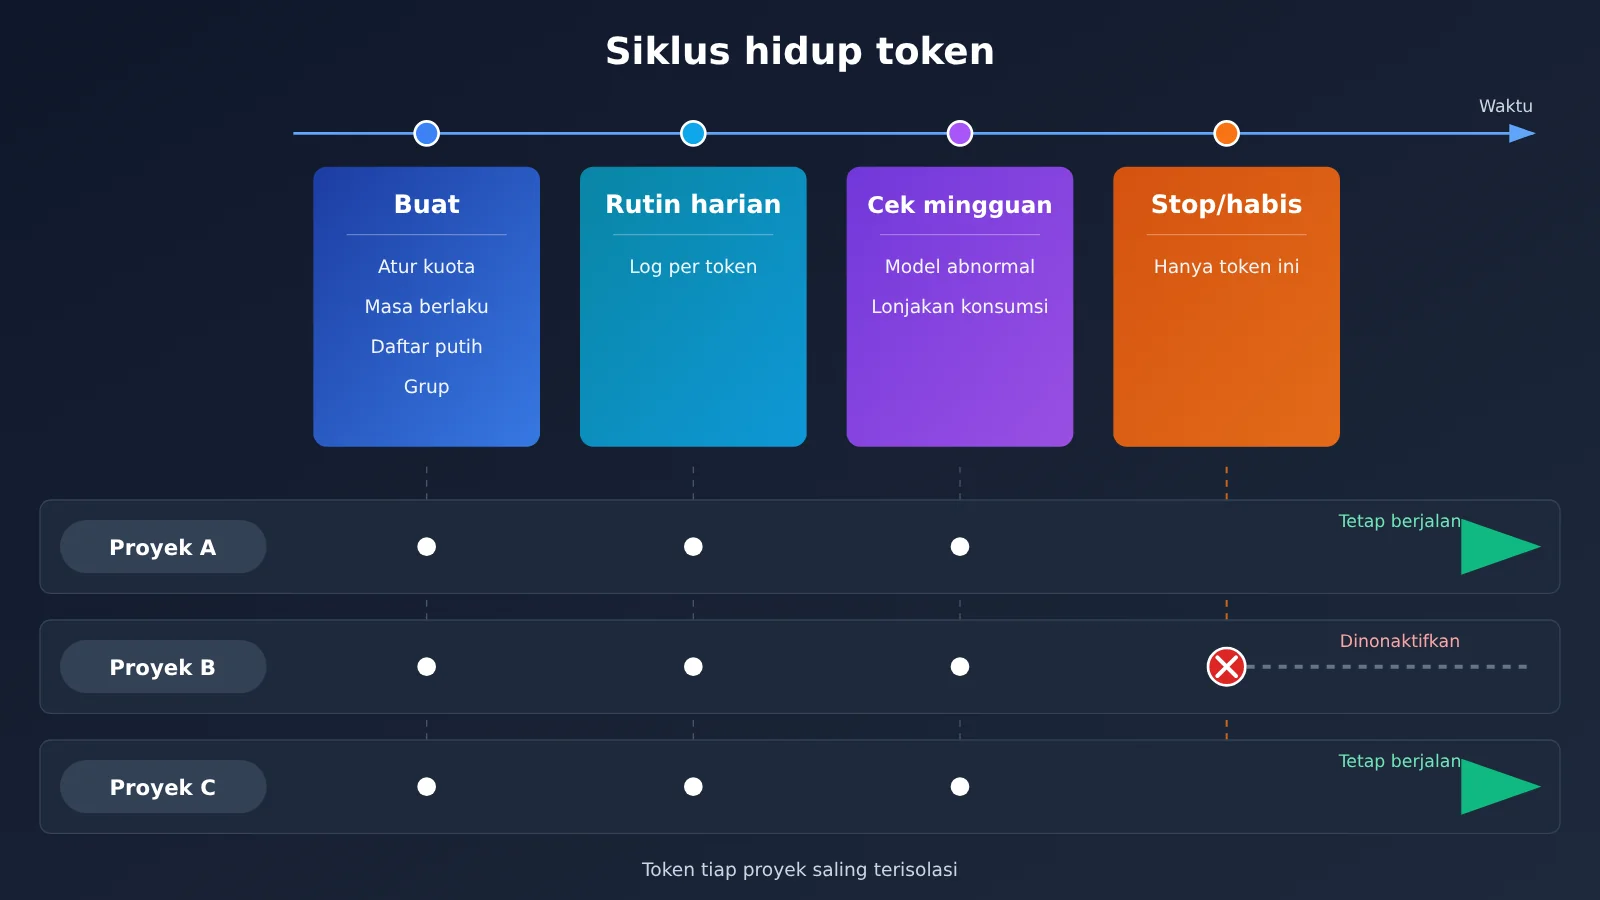
Kunci manajemen multi-model di perusahaan terletak pada memisahkan batas-batas pengelolaan, bukan menyatukan semuanya menjadi satu kunci serba bisa. Di APIYI, token adalah API Key, diawali dengan sk-. Dokumentasi menjelaskan bahwa setiap token dapat diatur kuota, waktu kedaluwarsa, model yang tersedia, dan grupnya secara terpisah; konsumsi, kuota tersisa, dan log pemanggilan juga dicatat secara terpisah.
| Poin | Penjelasan | Nilai bagi pimpinan R&D |
|---|---|---|
| Buat token per proyek | Setelah mendaftar sudah ada satu token default; Anda bisa membuat token lain untuk proyek maupun anggota yang berbeda | Saat menonaktifkan seseorang atau sebuah proyek, pemanggil lain tidak terpengaruh |
| Atur kuota dan masa berlaku secara terpisah | Setiap token dapat diberi batas kuota dan waktu kedaluwarsa | Dua masalah—anggaran yang membengkak dan kontrak outsourcing yang berakhir—bisa dibatasi sejak awal |
| Daftar putih model | Tanpa daftar putih, tersedia 200+ model pilihan di seluruh platform (kutipan dokumentasi); setelah diatur, hanya model yang ditentukan yang bisa dipakai | Mencegah proyek diam-diam beralih ke model berbiaya tinggi |
| Grup menentukan jalur dan pengali tarif | Grup menentukan upstream, model yang tersedia, dan pengali penagihan | Model yang sama di grup berbeda bisa menghasilkan tagihan aktual yang berbeda |
| Log dipisah per token | Konsumsi dan log pemanggilan setiap token dilihat secara terpisah | Rekonsiliasi akhir bulan bisa langsung dipetakan ke proyek |
Mengapa Manajemen Multi-Model Perusahaan Memisahkan Token per Proyek
Ada satu hal dalam dokumentasi yang perlu dijelaskan lebih dulu: saat satu token dipakai bersama oleh banyak orang, pembatasan laju mengikuti akun, bukan jumlah token. Dokumentasi menyebutkan bahwa untuk satu akun, umumnya tidak ada masalah selama di bawah 100 RPM, dan TPM tidak diukur. Ini adalah pernyataan dalam dokumentasi, bukan hasil uji tekanan, dan tidak merupakan SLA.
Karena itu, tujuan memisahkan token bukan untuk menghindari pembatasan laju, melainkan untuk melakukan isolasi pengelolaan. Satu token mewakili satu proyek atau satu anggota; jika ada masalah, hanya token itu yang perlu dihentikan, dan saat memeriksa tagihan hanya token itu yang perlu dilihat. Jika semua orang memakai token default yang sama, konsumsi dalam log akan tercampur, tidak bisa dipisahkan per proyek, dan tidak mungkin menghentikan satu pemanggil tertentu secara presisi.
Grup dan Aturan Cadangan dalam Manajemen Multi-Model Perusahaan
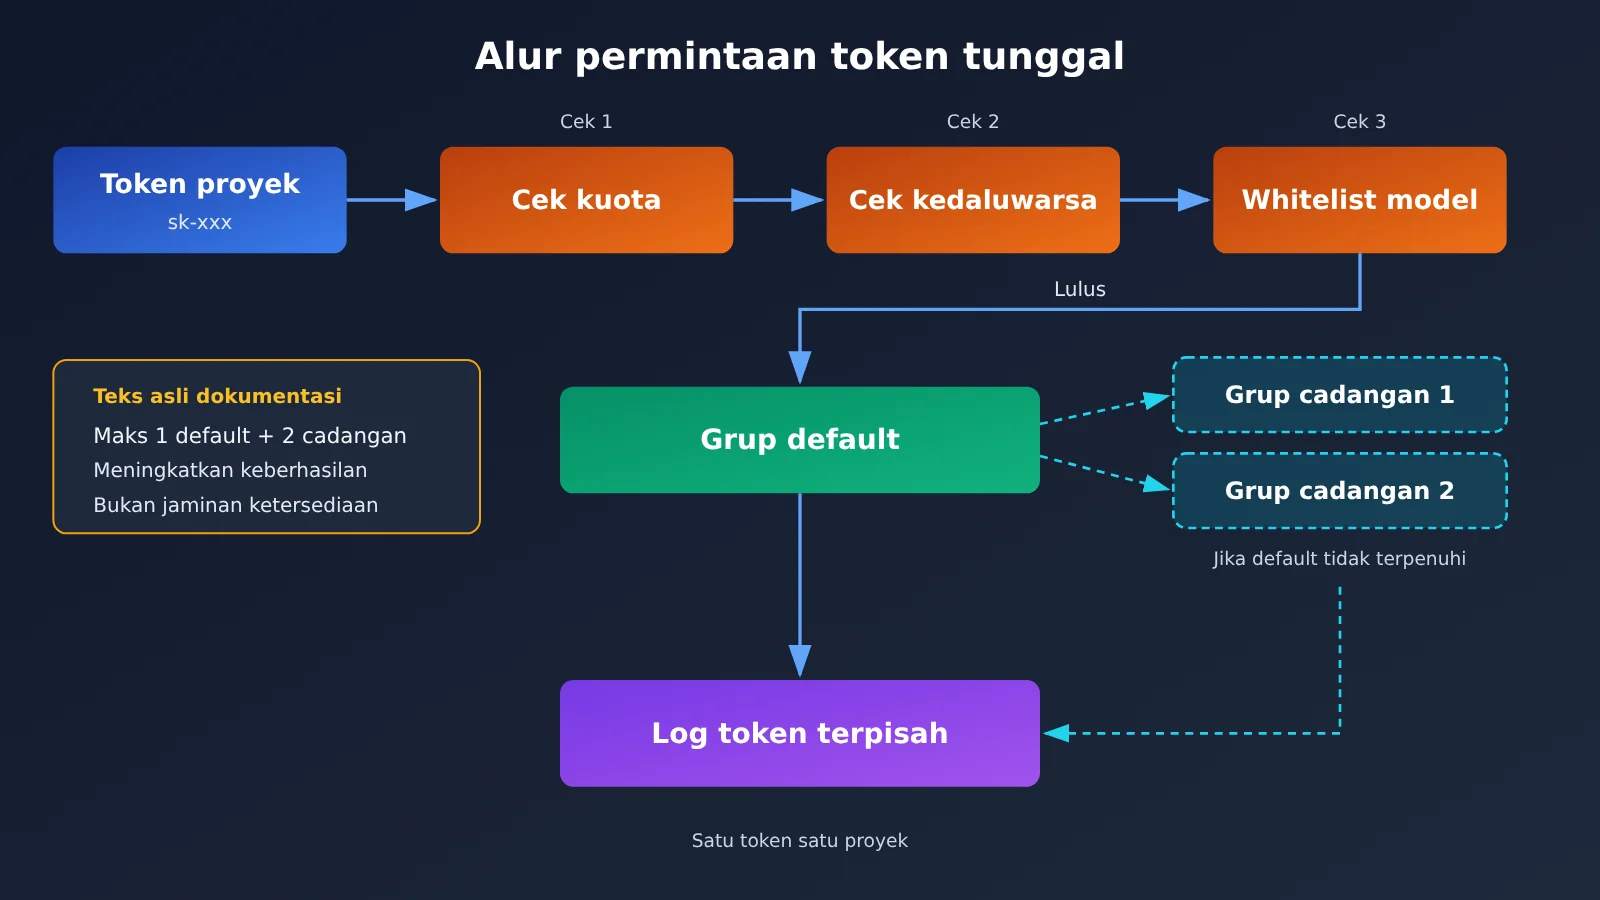
Grup adalah jalur sumber daya. Menurut dokumentasi, satu token paling banyak dapat dikonfigurasi dengan 1 grup default dan 2 grup cadangan. Arti cadangan adalah: ketika grup default tidak dapat memenuhi permintaan, sistem otomatis beralih ke grup cadangan. Dokumentasi mendeskripsikan cadangan sebagai “meningkatkan tingkat keberhasilan pemanggilan”, bukan janji ketersediaan, jadi jangan memahaminya sebagai “tidak akan pernah gagal”.
Sebagian besar model teks cukup menggunakan grup Default. Model khusus seperti video perlu memilih grup lain; jika token tidak memiliki grup tersebut, model terkait tidak dapat dipanggil. Perlu juga diperhatikan bahwa “200+ model” mengacu pada total model pilihan di seluruh platform, bukan berarti setiap model ada di grup Default; untuk memastikan, lihat grup yang tercantum di halaman masing-masing model.
Mulai Cepat Manajemen Multi-Model Perusahaan: 5 Langkah Membuat Token per Proyek
Berikut adalah contoh tim dengan tiga proyek: proyek pencarian yang ditingkatkan, proyek chatbot layanan pelanggan, dan alat penulisan internal, untuk mendemonstrasikan alur konfigurasi lengkap. Pintu masuk operasi adalah halaman token https://api.apiyi.com/token.
Langkah 1: Rencanakan token, satu proyek atau satu orang menggunakan satu token
Buat dulu tabel perencanaan token, lalu buat di backend. Ini menghindari membuat sambil mengubah, yang akhirnya kembali ke keadaan “satu kunci dipakai bersama”.
| Nama Token | Pengguna | Daftar Putih Model | Grup Default | Grup Cadangan | Saran Kuota dan Masa Berlaku |
|---|---|---|---|---|---|
proj-search |
Layanan pencarian yang ditingkatkan | gemini-3.8-flash, qwen3.8-max |
Default |
Konfigurasi grup opsional sesuai halaman model | Tetapkan kuota sesuai anggaran bulanan, berlaku jangka panjang |
proj-support |
Chatbot layanan pelanggan | claude-sonnet-5-5 |
Default |
Konfigurasi grup opsional sesuai halaman model | Tetapkan kuota sesuai anggaran bulanan |
team-writing-zhang |
Alat pribadi anggota | claude-opus-5-5 |
Default |
Tidak disetel | Kuota kecil, tetapkan waktu kedaluwarsa |
vendor-outsource |
Tim outsourcing | Hanya model yang dibutuhkan untuk pengiriman | Default |
Tidak disetel | Kuota diselaraskan dengan siklus kontrak, otomatis kedaluwarsa saat berakhir |
Saran manajemen dalam tabel adalah penilaian kami. Grup mana setiap model secara spesifik termasuk di dalamnya, harus mengacu pada halaman model tersebut, jangan menyalin tabel ini begitu saja.
Langkah kedua: membuat token dan mengatur empat batasan
Saat membuat token baru di halaman token, isi empat hal berikut secara berurutan:
- Kuota: isi sesuai anggaran bulanan proyek. Setelah kuota habis, token ini berhenti menagih biaya dan token lain tidak terpengaruh.
- Waktu kedaluwarsa: wajib diatur untuk vendor outsourcing dan anggota sementara. Setelah kedaluwarsa, tidak perlu dicabut secara manual.
- Model yang tersedia (whitelist): centang hanya model yang benar-benar dibutuhkan proyek. Jika dikosongkan, berarti semua model di seluruh situs terbuka; ini tidak disarankan.
- Grup: pilih grup default terlebih dahulu, lalu tambahkan maksimal 2 grup cadangan sesuai kebutuhan.
Langkah ketiga: menempatkan kunci ke variabel lingkungan dan membedakan nama variabel per proyek
Jangan hardcode kunci di kode atau repositori. Sebaiknya setiap proyek menggunakan nama variabel lingkungan tersendiri, misalnya dengan mengatur APIYI_KEY_SEARCH=sk-... dan APIYI_KEY_SUPPORT=sk-... di lingkungan deployment, lalu dibaca oleh masing-masing layanan. Dengan begitu, saat merotasi kunci untuk suatu proyek, Anda hanya perlu mengubah satu variabel.
Langkah 4: Panggil dengan antarmuka yang kompatibel dengan OpenAI
APIYI menyediakan antarmuka yang kompatibel dengan OpenAI. Saat mengintegrasikan, hanya ada dua hal yang perlu diubah:
- Atur
base_urlmenjadihttps://api.apiyi.com/v1 api_keydibaca dari environment variable milik proyek sendiri, misalnyaos.environ["APIYI_KEY_SEARCH"]
Saat memakai SDK resmi Python, intinya ada pada satu baris inisialisasi: client = OpenAI(api_key=os.environ["APIYI_KEY_SEARCH"], base_url="https://api.apiyi.com/v1"). Setelah itu, cukup panggil client.chat.completions.create(model="gemini-3.8-flash", messages=[...]). Jika model diganti dengan model di luar whitelist, token tersebut tidak akan bisa melakukan pemanggilan. Itulah efek yang ingin dicapai oleh whitelist.
Langkah 5: Periksa log token setiap minggu, rekonsiliasi per token di akhir bulan
Penggunaan, kuota tersisa, dan log pemanggilan setiap token dapat dilihat secara terpisah. Sebaiknya periksa log masing-masing token sekali seminggu, dengan fokus pada dua hal: apakah ada model yang tidak diharapkan muncul, dan apakah kurva konsumsi tiba-tiba naik. Di akhir bulan, rekap per token akan memberikan biaya yang terpisah berdasarkan proyek.
🎯 Saran teknis: Saat pertama kali menerapkan, sebaiknya matikan token default atau sisakan hanya untuk admin, lalu buat token satu per satu di halaman token APIYI apiyi.com sesuai tabel rencana di atas. Dengan begitu, sejak hari pertama semua pemanggilan bisa dilacak ke proyek tertentu di log.
Tagihan pengelolaan multi-model di perusahaan: ganti model, tagihan ikut berubah
Hal yang paling mudah terlewat oleh tim multi-model: ganti satu model, ganti satu grup, tagihan ikut berubah. Harga di bawah berasal dari tabel model APIYI, semuanya harga default per juta token, data diperbarui pada 2026-11-16 09:39 (UTC+8).
| Model ID | Harga input | Harga output | Baca cache | Endpoint / grup yang ditandai dokumentasi | Platform yang tersedia |
|---|---|---|---|---|---|
claude-opus-5-5 |
$4 | $20 | $0.2 | Endpoint chat dan messages | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | Sesuai halaman model | APIYI |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Endpoint chat dan messages; grup ClaudeCode, Default, SVIP | APIYI |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse pengali 0.5×, Default dan SVIP 1× | APIYI |
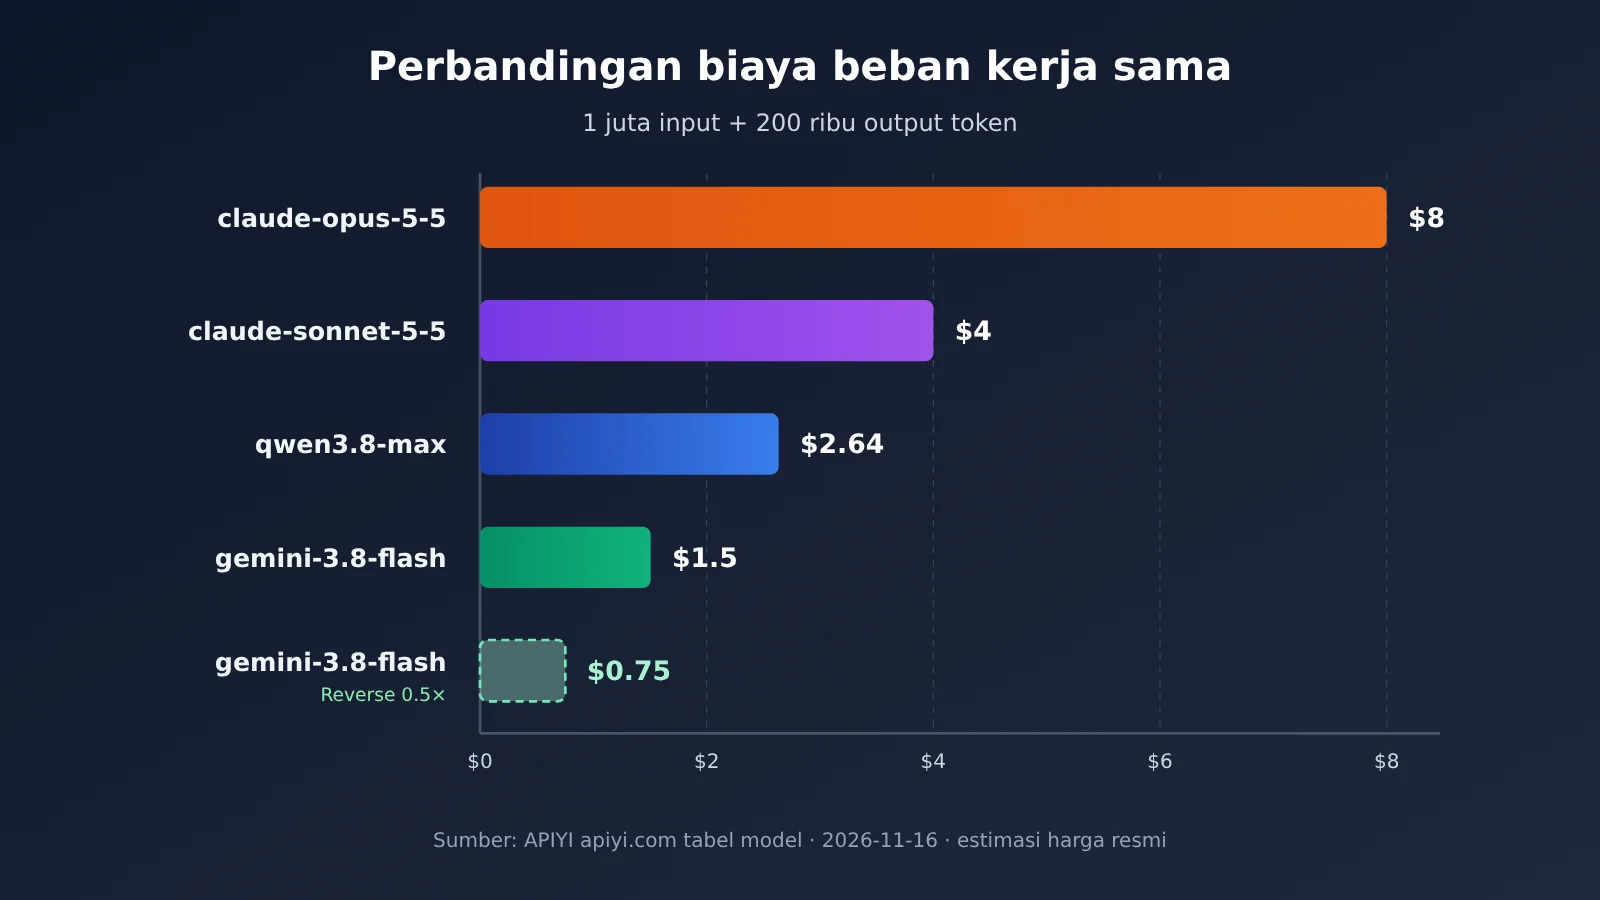
Menurut dokumentasi, rumus penagihan berbasis pemakaian adalah: token input × harga input + token output × harga output. Misalkan sebuah proyek mengonsumsi 1 juta token input dan 200 ribu token output per bulan, estimasi berdasarkan harga default:
claude-opus-5-5: 4 + 0.2 × 20 = $8claude-sonnet-5-5: 2 + 0.2 × 10 = $4qwen3.8-max: 1.65 + 0.2 × 4.95 = $2.64gemini-3.8-flash(Default, 1×): 0.75 + 0.2 × 3.75 = $1.5; jika lewat Gemini_Reverse (0.5×), setelah dikonversi dengan pengali kira-kira $0.75
Terlihat bahwa untuk beban kerja yang sama, mengganti model bisa membuat biaya berbeda beberapa kali lipat, dan mengganti grup juga langsung mengubah pemotongan biaya sebenarnya. Jadi menetapkan whitelist dan grup untuk token pada dasarnya adalah menetapkan batas atas harga satuan proyek. Saat memeriksa model dan membandingkan harga, gunakan daftar model di APIYI apiyi.com sebagai acuan. Setelah memastikan suatu model ada di grup mana dan berapa pengalinya, baru tambahkan ke token yang sesuai. Alamat pemanggilan seragamnya adalah https://api.apiyi.com/v1, mengganti model hanya perlu mengubah parameter model, tidak perlu mengganti base_url.
Jika tim sedang mengevaluasi model baru yang baru dirilis, misalnya qwen4-max yang dirilis Alibaba Cloud pada 2026-11-16, perlu diperhatikan bahwa model ini saat ini belum ada di tabel utama, dan juga tidak dapat ditemukan di antarmuka harga platform. Belum tersedia di platform; kami akan segera menghadirkan model ini. Model dan harga mengacu pada daftar model platform. Sebelum tersedia, jangan memasukkannya ke dalam perencanaan whitelist token mana pun.
Pola penagihan dalam pengelolaan multi-model perusahaan: jangan campur hitungan berbasis volume dengan per permintaan
Dokumentasi menyarankan agar model teks memakai «prioritas berbasis volume». Penagihan per permintaan adalah harga tetap untuk setiap permintaan, dan terutama dipakai untuk gambar serta video. Kalau satu token yang sama dipakai untuk teks sekaligus pembuatan gambar, log akan memunculkan dua jenis catatan sekaligus—penagihan per token dan penagihan per permintaan—satuannya berbeda, jadi keduanya tidak bisa langsung dijumlahkan.
Cara yang lebih aman: buat token terpisah untuk proyek teks dan proyek pembuatan gambar/video. Model khusus seperti video memang sudah butuh grup tersendiri; setelah dipisahkan, konfigurasi grup dan satuan tagihan jadi jauh lebih jelas.
| Cara penagihan | Cara perhitungan (sesuai dokumentasi) | Penggunaan umum | Saran pemisahan token |
|---|---|---|---|
| Berbasis volume | token masukan × harga masukan + token keluaran × harga keluaran | Percakapan teks, kode, ringkasan | Satu token khusus proyek teks, dokumentasi menyarankan prioritas berbasis volume |
| Per permintaan | Harga tetap per permintaan | Pembuatan gambar, video | Token terpisah untuk gambar/video, sekaligus pasang grup khususnya |
Soal penyelesaian pembayaran, dokumentasi menyebutkan bahwa top-up dihitung dengan kurs tetap 1:7 dan bisa digabung dengan promo top-up; potongan biaya sebenarnya tetap mengacu pada konsol. Proses pengadaan, kontrak, dan faktur tidak dibahas dalam artikel ini—jika perlu, konfirmasikan langsung ke platform.
💡 Saran pemilihan: buat token kecil terpisah untuk model berharga tinggi (misalnya
claude-opus-5-5), lalu bagikan hanya kepada yang benar-benar membutuhkannya. Token untuk tugas batch sehari-hari cukup diisi model dengan harga satuan rendah. Di APIYI apiyi.com, cocokkan grup dan rasio pengali pada daftar model sebelum mengalokasikan—ini menghindari tagihan tak terduga di akhir bulan.
FAQ Umum: Manajemen Multi-Model Perusahaan
Q1: Apa itu manajemen multi-model perusahaan dengan pemisahan token per proyek?
Maksudnya, dalam satu akun Anda membuat kunci API (token) terpisah untuk setiap proyek atau anggota; setiap token diberi kuota, waktu kedaluwarsa, whitelist model, dan grup tersendiri. Konsumsi dan log panggilan dicatat terpisah per token, sehingga penonaktifan dan rekonsiliasi bisa presisi hingga tingkat proyek.
Q2: Kalau saya membuat banyak token, apakah rate limit-nya ikut berlipat?
Tidak. Dokumentasi menyatakan dengan jelas bahwa rate limit mengikuti akun, tidak bergantung pada jumlah token. Dokumentasi menyebutkan satu akun umumnya aman dalam 100 RPM, dan TPM tidak diuji. Ini hanya pernyataan dokumentasi, bukan SLA. Memecah token bertujuan untuk isolasi manajemen, bukan untuk menaikkan kuota.
Q3: Kalau grup cadangan sudah dikonfigurasi, apakah pasti tidak akan gagal?
Tidak. Sesuai dokumentasi, satu token maksimal memiliki 1 grup default ditambah 2 grup cadangan; cadangan beralih otomatis ketika grup default tidak dapat memenuhi permintaan, tujuannya meningkatkan tingkat keberhasilan panggilan. Sisi bisnis tetap harus mempertahankan logika retry dan degradasi.
Q4: Apa yang terjadi jika tidak memasang whitelist model?
Kutipan dokumentasi: tanpa whitelist, token dapat memakai 200+ model pilihan di seluruh situs. Untuk manajemen, ini cukup berisiko karena proyek bisa saja langsung beralih ke model berharga mahal. Untuk skenario perusahaan, disarankan setiap token hanya memuat model yang benar-benar dibutuhkan proyek.
Q5: Saya sudah punya kode dengan OpenAI SDK, bagaimana mengubahnya agar memanggil dengan token per proyek?
Cukup ubah dua hal: set `base_url` menjadi `https://api.apiyi.com/v1`, dan ubah `api_key` agar dibaca dari variabel lingkungan milik proyek sendiri. Token dibuat di halaman token APIYI apiyi.com; untuk mengganti model cukup ubah parameter `model`.
Q6: Kenapa model video tertentu tidak bisa dipanggil di token saya?
Model khusus seperti video memerlukan grup tersendiri. Jika token tidak dikonfigurasi dengan grup tersebut, model menjadi tidak tersedia. Silakan buka halaman model terkait untuk melihat grupnya, lalu tambahkan ke pengaturan grup token; bisa juga membuat token khusus untuk bisnis video.
Q7: Kenapa model yang sama ditagih berbeda di proyek berbeda?
Biasanya karena rasio pengali grup berbeda. Misalnya halaman model `gemini-3.8-flash` mencantumkan grup Gemini_Reverse dengan pengali 0.5×, sedangkan Default dan SVIP 1×. Saat rekonsiliasi, cocokkan model dan grup secara bersamaan, jangan hanya melihat harga tercantum.
Q8: Apa saja keterbatasan pendekatan ini?
Pemisahan token menyelesaikan isolasi kunci, kuota, dan log, tetapi tidak dapat menaikkan rate limit akun, juga tidak dapat menggantikan retry dan monitoring di sisi bisnis. Model yang baru dirilis perlu menunggu tersedia di platform sebelum bisa ditambahkan ke whitelist. Harga dan grup spesifik mengacu pada daftar model di APIYI apiyi.com.
Poin Penting Manajemen Multi-Model Perusahaan
- Token adalah kunci: dimulai dengan
sk-, buat satu token untuk setiap proyek atau anggota agar mudah dinonaktifkan secara terpisah. - Setel empat batasan sekaligus: kuota, waktu kedaluwarsa, daftar putih model, dan grup. Jika satu saja terlewat, akan ada celah dalam pengelolaan.
- Batas laju mengikuti akun: dokumen asli menyebutkan bahwa dalam 100 RPM umumnya tidak ada masalah dan TPM tidak diperhitungkan; membuat token terpisah tidak akan menambah kuota.
- Fallback bukan jaminan: maksimal 1 grup default + 2 grup fallback (dokumen asli), fungsinya untuk meningkatkan tingkat keberhasilan.
- Mengganti model mengubah tagihan: harga satuan model dan pengali grup bersama-sama menentukan biaya aktual; rekonsiliasi per token membuatnya lebih jelas.
- Teks dan pembuatan gambar dipisahkan: satuan untuk berbasis jumlah dan berbasis per panggilan berbeda; pengelolaan dengan token terpisah lebih memudahkan rekonsiliasi.
- Pintu masuk terpadu: semua proyek menggunakan
https://api.apiyi.com/v1; hanya token yang membedakan izin dan tagihan.
Ringkasan
Manajemen multi-model perusahaan tidak memerlukan satu kunci master yang bisa membuka backend semua vendor. Sebaliknya, pisahkan izin berdasarkan proyek:
- Kunci dipisah per proyek: satu token per proyek atau per orang; penonaktifan dan rotasi tidak saling memengaruhi.
- Kuota dan model dibatasi: gunakan kuota untuk mengendalikan total pengeluaran, lalu gunakan daftar putih dan grup untuk mengendalikan harga satuan.
- Log direkonsiliasi per token: periksa anomali setiap minggu, lalu rangkum biaya per token di akhir bulan.
Disarankan untuk terlebih dahulu membuat tabel perencanaan token sesuai langkah pertama artikel ini, lalu membuatnya satu per satu di halaman token APIYI apiyi.com. Saat memeriksa model, harga, dan grup, gunakan daftar model platform sebagai acuan. Dengan begitu, sekali implementasi, tagihan multi-model bisa Anda rapikan dengan jelas.
📚 Referensi
-
Pusat Dokumentasi APIYI: token dan grup, mode penagihan, tabel lengkap model
- Tautan:
docs.apiyi.com - Keterangan: sesuai dengan jalur
/faq/token-and-groups.md,/faq/token-billing-modes.md,/models.md,/models/gemini-3-8-flash.md; informasi token, grup, dan harga dalam artikel ini mengacu pada sumber tersebut
- Tautan:
-
Dokumentasi Alibaba Cloud Bailian Qwen4-Max: informasi rilis dari vendor
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max - Keterangan: model ini dirilis oleh vendor pada 2026-11-16; status ketersediaannya di platform mengacu pada daftar model
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Penjelasan lebih lanjut mengenai konfigurasi token dan grup dapat dilihat di pusat dokumentasi.