Note de l’auteur : cet article examine une donnée publiée dans les résultats d’Alphabet pour le troisième trimestre 2026 : « les API de modèles propriétaires traitent près de 32 milliards de tokens par minute ». Il distingue les conclusions étayées par des données des points qui restent inconnus.
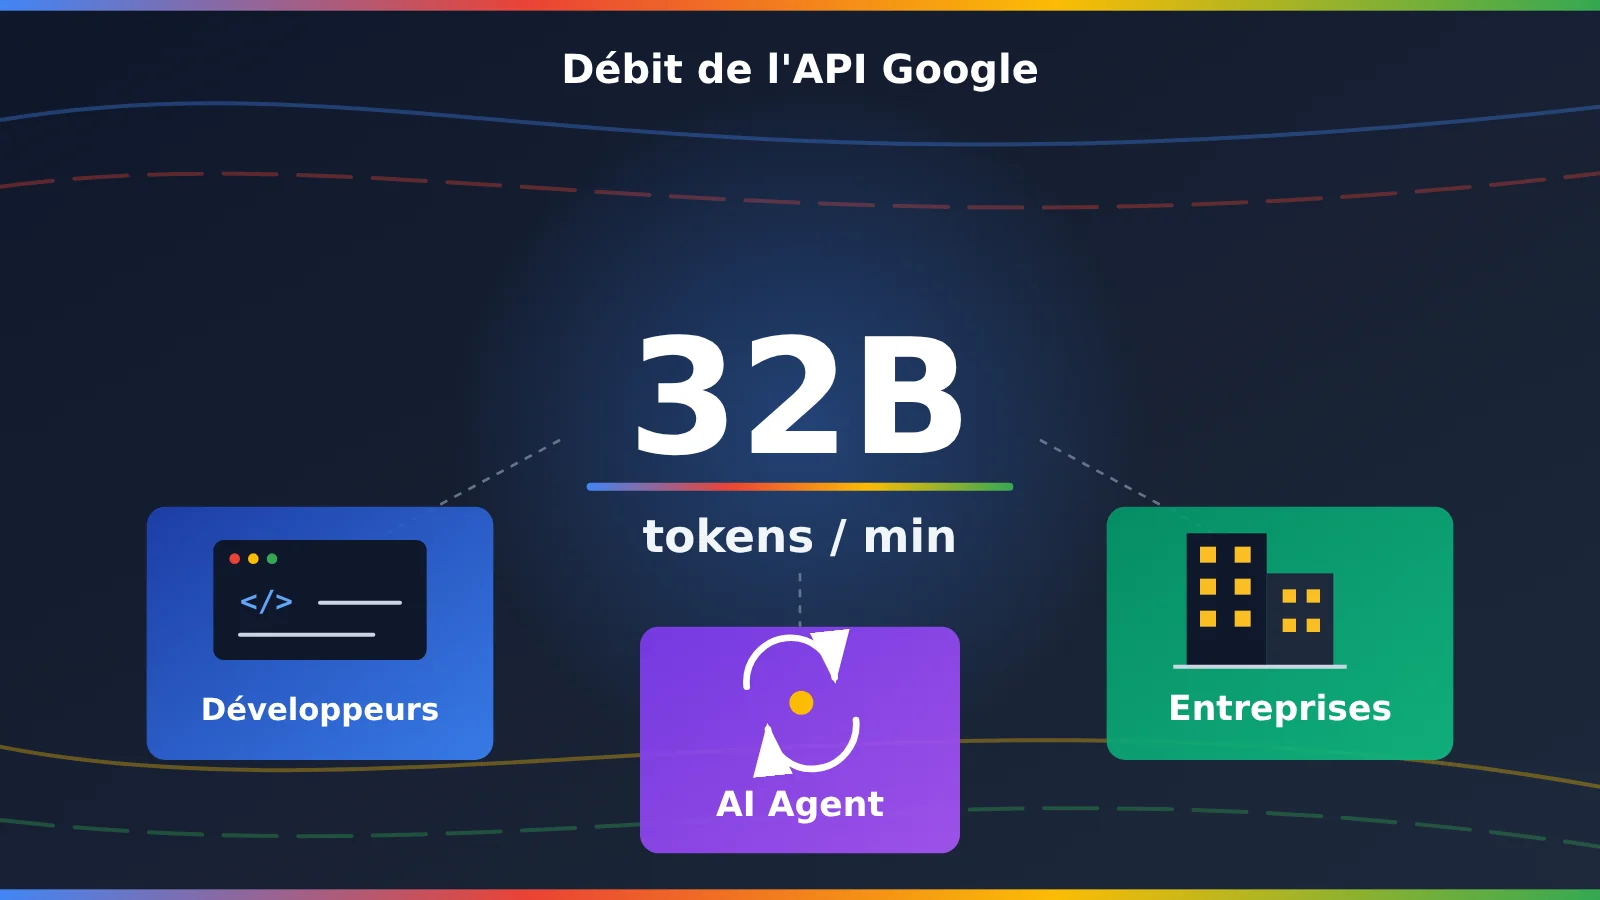
Le 28 octobre 2026, heure américaine, Alphabet a publié ses résultats du troisième trimestre. Dans son intervention, le PDG Sundar Pichai a donné un chiffre : les API des modèles propriétaires de Google traitent près de 32 milliards de tokens par minute. C’est environ 40 % de plus que le chiffre annoncé au trimestre précédent, et plus de quatre fois le niveau d’un an auparavant.
Ce n’est pas une estimation officieuse : les mots exacts figurent dans l’intervention du PDG publiée sur le blog officiel de Google : « Our first-party model APIs are now processing nearly 32 billion tokens per minute ». Mais ce chiffre se prête facilement à des erreurs d’interprétation : il ne correspond ni à 32 milliards d’appels, ni à l’utilisation de l’application Gemini.
L’essentiel : en 3 minutes, comprenez ce que mesurent ces 32 milliards de tokens, comment ce volume évolue et où les développeurs, les entreprises et les agents IA consomment cette puissance de calcul.
Google API : les chiffres clés des 32 milliards de jetons
Commençons par les faits annoncés. L’analyse qui suit s’appuie sur ces informations.
| Élément | Détails |
|---|---|
| Date de l’annonce | 28 octobre 2026, conférence téléphonique sur les résultats du troisième trimestre d’Alphabet |
| Annonceur | Sundar Pichai, PDG d’Alphabet |
| Chiffre clé | Les API des modèles propriétaires traitent près de 32 milliards de jetons par minute |
| Évolution trimestrielle | Hausse d’environ 40 % par rapport au chiffre annoncé le trimestre précédent, selon les données officielles |
| Évolution annuelle | Plus de 4 fois le niveau d’il y a un an |
| Périmètre | Ensemble des API des modèles propriétaires de Google, et non un modèle Gemini en particulier |
| Données non divulguées | Répartition par modèle, client, secteur et produit API |
Ce que mesurent les 32 milliards de jetons de Google API
Pour comprendre cette annonce, il faut d’abord distinguer plusieurs indicateurs souvent confondus. Les 32 milliards correspondent à un nombre de jetons, pas à un nombre de requêtes API : une seule requête d’analyse d’un long document peut contenir des centaines de milliers de jetons. Il s’agit aussi du débit actuel annoncé le 28 octobre, et non d’une moyenne sur l’ensemble du troisième trimestre.
Les résultats financiers et la conférence téléphonique mentionnent aussi le nombre de développeurs, les licences d’entreprise et l’utilisation de Gemini Enterprise. Ces indicateurs ont des périmètres différents : on ne peut ni les additionner ni déduire l’un à partir de l’autre.
| Indicateur | Chiffre et date | Périmètre | Peut-on l’ajouter aux 32 milliards de jetons/minute ? |
|---|---|---|---|
| Débit des API des modèles propriétaires | Près de 32 milliards de jetons/minute (28 octobre 2026) | Débit actuel | C’est l’indicateur principal lui-même |
| Développeurs actifs mensuels | Plus de 9 millions/mois (chiffre annoncé au deuxième trimestre) | Développeurs utilisant les API de modèles et les principaux produits pour développeurs | Non, il s’agit d’un nombre de personnes, pas de clients payants |
| Jetons des outils pour développeurs | Plus de 3 000 milliards par jour (documents de juin 2026) | Utilisation liée aux outils pour développeurs | Non, le périmètre est différent |
| Clients à forte utilisation de Gemini Enterprise | Plus de 2 600 clients ayant utilisé au moins 100 milliards de jetons (sur les 12 derniers mois) | Utilisation des clients du produit d’entreprise | Non |
| Licences pour les travailleurs du savoir | Plus de 100 millions vendues au total | Ensemble des services d’IA de Google | Non, il s’agit de licences, pas de clients API |
Autre précision importante : ce chiffre ne permet pas d’affirmer que l’application Gemini consomme 32 milliards de jetons par minute. L’application, Search, les licences d’entreprise et les jetons API correspondent à des activités et à des indicateurs distincts.
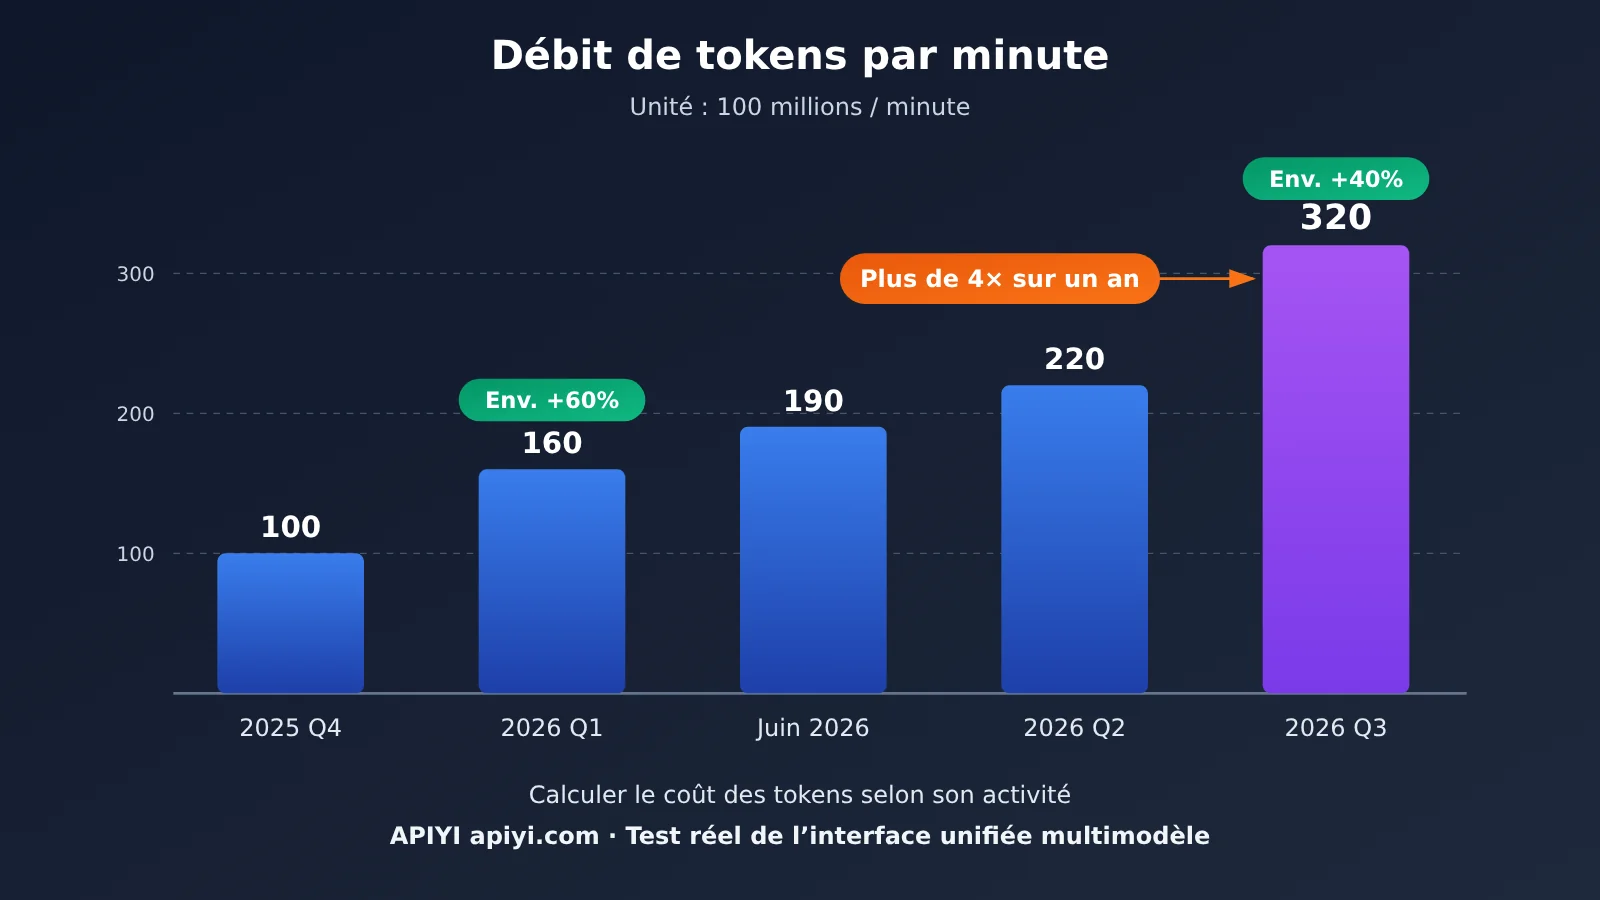
Évolution du débit de tokens de l’API Google
En reliant les dernières données publiées, la pente de la courbe en dit plus long qu’un chiffre pris isolément.
| Date de publication | Contexte | Tokens/minute | Remarques |
|---|---|---|---|
| T4 2025 | Publication trimestrielle | Environ 10 milliards | Point de départ |
| 2026-04-29 | Résultats du T1 | Plus de 16 milliards | Hausse d’environ 60 % par rapport au trimestre précédent |
| Juin 2026 | Présentation aux investisseurs | Environ 19 milliards | Donnée de milieu de trimestre |
| 2026-07-22 | Résultats du T2 | Environ 22 milliards | — |
| 2026-10-28 | Conférence téléphonique sur les résultats du T3 | Près de 32 milliards | Selon Google, hausse d’environ 40 % sur un trimestre et plus de quatre fois le niveau de l’année précédente |
Si l’on calcule directement l’écart entre 22 et 32 milliards, la hausse est d’environ 45,5 %. Mais ces deux chiffres sont approximatifs (« environ », « près de ») : il faut donc retenir la formulation officielle de Google, « environ 40 % ». Cela ne signifie pas que Google s’est trompé dans son calcul.
À quoi correspondent 32 milliards de tokens par minute ?
Pour mieux saisir l’échelle, voici une conversion mathématique à débit constant. Les chiffres par jour et par mois sont des projections fondées sur cette hypothèse, et non des données d’utilisation réelles publiées par Google.
- Par seconde : environ 533 millions de tokens
- Par heure : environ 1 920 milliards de tokens
- Sur 24 heures à débit constant : environ 46 080 milliards de tokens
- Sur 30 jours à débit constant : environ 1 382 400 milliards de tokens
Qui consomme les 32 milliards de tokens de l’API Google ?
C’est précisément la question posée dans le titre. D’après les informations publiées par Google, on peut identifier trois grandes catégories d’utilisateurs, mais la part exacte de chacune n’a pas été rendue publique.
Première catégorie : l’écosystème de développeurs des API Google
Les résultats financiers du deuxième trimestre indiquent que plus de 9 millions de développeurs créent chaque mois des applications à l’aide des API de modèles et des principaux produits pour développeurs de Google. Ce chiffre montre que la communauté de développeurs potentiels est immense, mais il ne correspond pas à 9 millions de clients payants et ne signifie pas non plus que chaque développeur utilise directement l’API Gemini.
Sur la même période, la plateforme de développement d’agents Antigravity comptait plus de 2,4 millions d’utilisateurs actifs par semaine. Les développeurs consomment notamment des tokens dans les cas suivants :
- Programmation et développement logiciel : lecture de dépôts de code, refactorisation, génération de tests, recherche d’erreurs et appels répétés par des agents de programmation
- Développement d’applications d’IA : chatbots sur les sites web et dans les applications, automatisation du service client, recherche interne en entreprise, analyse de PDF et de longs documents
- Workflows d’agents : planification des tâches, appel d’outils externes, lecture de leurs résultats, correction des erreurs et exécution des étapes suivantes
Deuxième catégorie : les clients professionnels de Gemini Enterprise
Thomas Kurian, PDG de Google Cloud, a communiqué des chiffres sur les entreprises lors de la conférence téléphonique du troisième trimestre. Au cours des 12 derniers mois, plus de 2 600 clients ont utilisé au moins 100 milliards de tokens sur Gemini Enterprise, dont environ 75 qui ont dépassé les 10 000 milliards de tokens. Près de 90 % des entreprises du Fortune 100 utilisent Gemini Enterprise.
Autre signal à noter : la hausse des dépenses. Les clients qui utilisaient déjà Gemini Enterprise au troisième trimestre 2025 ont multiplié leurs dépenses par plus de quatre au troisième trimestre 2026, sur un an. Cela montre que l’IA en entreprise passe des essais à petite échelle aux déploiements à grande échelle. Toutefois, l’usage de Gemini Enterprise et les 32 milliards de tokens des API des modèles propriétaires reposent sur des périmètres différents : on ne peut pas supposer que ces 2 600 clients en représentent la majeure partie.
Troisième catégorie : les agents sectoriels et les processus métier complexes
Google a présenté plusieurs déploiements sectoriels lors de sa conférence téléphonique et sur son blog Cloud. Tous les résultats ci-dessous proviennent des données publiées par Google et n’ont pas été vérifiés par un tiers indépendant. Google n’a pas non plus indiqué le nombre de tokens consommés par chacune de ces entreprises.
| Entreprise | Secteur | Déploiement présenté par Google | Résultats communiqués par Google |
|---|---|---|---|
| BNP Paribas | Services financiers | Déploiement de Gemini Enterprise auprès de plus de 65 000 employés | Simplification des processus, tout en préservant la sécurité et la gouvernance des données |
| Tata Steel | Industrie manufacturière | Déploiement en neuf mois de plus de 300 agents spécialisés dans la sécurité, la chaîne d’approvisionnement et les réclamations clients | Réduction d’environ 50 % du délai de traitement des réclamations |
| Ulta Beauty | Commerce de détail | Assistant d’achat basé sur l’IA | Taux de conversion environ trois fois supérieur à celui de la navigation classique sur le site |
| Hitachi HMAX | Opérations industrielles | Création par les techniciens de terrain de plus de 200 cas d’usage d’agents, notamment pour comparer des photos prises avant et après une intervention | Gain de productivité pouvant atteindre environ 30 % dans les cas concernés |
| NTT DOCOMO | Analyse de données | Agent d’analyse de données | Obtention de certaines analyses en temps quasi réel au lieu de deux semaines, avec une économie estimée à environ 450 000 heures par an |
Le point commun de ces exemples : les modèles ne servent plus seulement à discuter, mais s’intègrent à des processus concrets de sécurité, de chaîne d’approvisionnement, de décision d’achat et d’analyse de données. Le facteur trois cité pour Ulta Beauty concerne le taux de conversion de l’assistant d’achat : il ne signifie pas que les ventes totales ont triplé.
Multimodal : un autre facteur de consommation des tokens de l’API Google
Les échanges textuels, l’examen de contrats, l’analyse de dépôts de code entiers, la compréhension d’images et de vidéos ou encore la transcription vocale consomment des tokens de façons très différentes. Le nombre d’images, la durée des vidéos et la taille des fichiers ne peuvent pas être directement convertis en tokens sur la base du nombre de caractères d’un texte ordinaire.
Google n’a pas publié la répartition des 32 milliards de tokens entre le texte, les images, les vidéos et l’audio. L’entreprise n’a pas non plus précisé combien correspondent aux entrées, aux sorties ou au processus de réflexion interne du modèle.
Pourquoi les agents augmentent la consommation de tokens de l’API Google
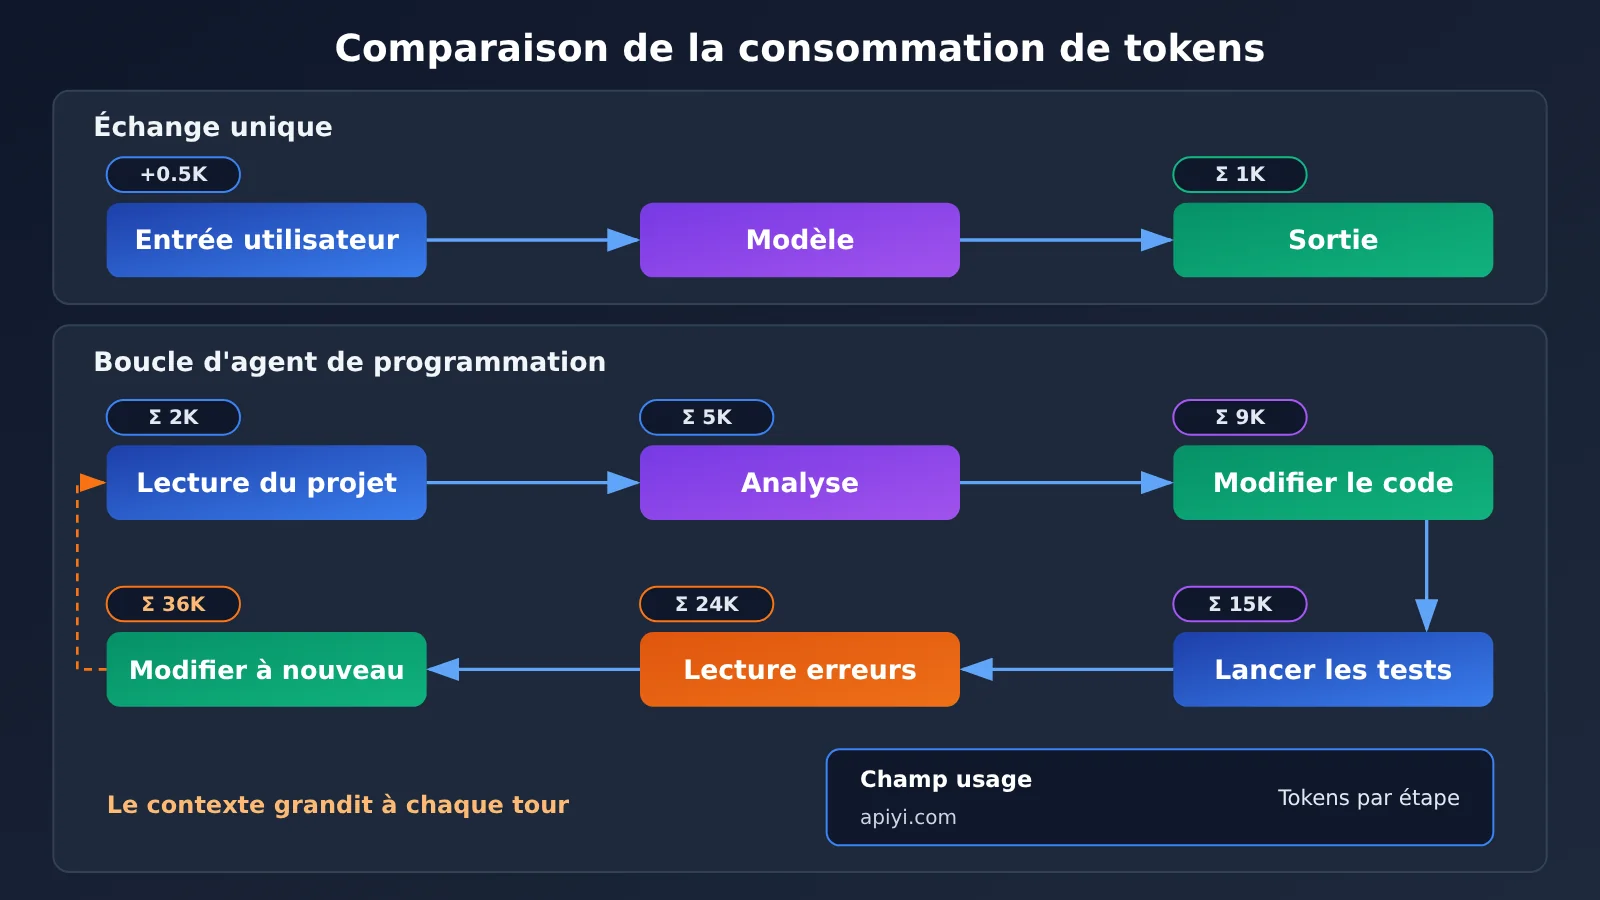
Une conversation classique peut se limiter à un seul échange. Pour accomplir une tâche, un agent de programmation peut en revanche lire des fichiers, analyser le problème, modifier le code, exécuter des tests, lire les erreurs, puis modifier et tester à nouveau le code. Chaque étape peut déclencher une invocation du modèle, généralement en lui transmettant à nouveau le contexte accumulé jusque-là.
Dire que « les agents sont une source potentiellement importante de demande » repose donc sur une analyse plausible du mécanisme. En revanche, aucune donnée publique ne permet d’affirmer qu’ils « représentent la majeure partie des 32 milliards de tokens ». Dans vos analyses comme dans vos décisions, il est important de distinguer ces deux affirmations.
Observer l’accumulation de tokens d’un agent avec du code
Pour comprendre concrètement ce phénomène, le plus simple est de relever le champ usage renvoyé à chaque appel. L’exemple ci-dessous simule un processus de correction en plusieurs étapes et affiche les tokens d’entrée et de sortie de chaque appel :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "写一个计算斐波那契数列的 Python 函数"}]
resp = client.chat.completions.create(model="YOUR_GEMINI_MODEL", messages=messages)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)
Voir le code de suivi des tokens dans une boucle d’agent à plusieurs étapes
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "YOUR_GEMINI_MODEL"  # 替换为平台模型列表中的 Gemini 模型名称

steps = [
    "写一个计算斐波那契数列的 Python 函数",
    "为这个函数补充单元测试",
    "测试报错:输入负数时没有处理,请修复",
    "再检查一遍边界条件并给出最终版本",
]

messages = [{"role": "system", "content": "你是一个严谨的编程助手"}]
total_in, total_out = 0, 0

for i, step in enumerate(steps, 1):
    messages.append({"role": "user", "content": step})
    resp = client.chat.completions.create(model=MODEL, messages=messages)
    reply = resp.choices[0].message.content
    messages.append({"role": "assistant", "content": reply})

    usage = resp.usage
    total_in += usage.prompt_tokens
    total_out += usage.completion_tokens
    print(f"第 {i} 步:输入 {usage.prompt_tokens},输出 {usage.completion_tokens}")

print(f"累计输入 {total_in},累计输出 {total_out}")
À l’exécution, vous constaterez que le nombre de tokens d’entrée augmente à chaque étape à mesure que l’historique s’accumule. C’est ce qui rend la consommation de tokens d’un workflow d’agent bien plus complexe que celle d’un simple échange.
🚀 Pour vous lancer : si vous souhaitez mesurer vous-même l’évolution de la consommation de tokens de différents modèles dans une boucle d’agent, vous pouvez vous inscrire sur APIYI apiyi.com pour obtenir des crédits d’essai gratuits. Utilisez la même clé API pour passer d’un modèle à l’autre, notamment Gemini, Claude et GPT, et comparer leur consommation sur une même tâche.
Analyse de l’impact des 32 milliards de tokens de l’API Google
Impact pour les développeurs
- Les coûts passent d’une logique « par appel » à une logique « par chaîne de traitement » : le coût d’une tâche confiée à un agent dépend du nombre d’itérations et de la longueur du contexte. Les développeurs doivent prévoir un budget de tokens dès la conception, notamment en réduisant l’historique du contexte et en mettant en cache les contenus inchangés
- Le choix de modèles adaptés à chaque tâche devient plus important : modèles performants et modèles économiques coexistent. Confier la planification complexe à un modèle puissant et la classification en masse à un modèle économique est une pratique courante pour maîtriser les coûts
- La facturation multimodale doit être évaluée séparément : le calcul des tokens pour les images, les vidéos et l’audio diffère de celui du texte. Mieux vaut effectuer des mesures sur des échantillons réels avant la mise en production
💡 Conseil : pour une même tâche, la consommation de tokens et les résultats peuvent varier considérablement d’un modèle à l’autre. Testez des échantillons réels via l’interface unifiée d’APIYI apiyi.com avant de choisir votre combinaison de modèles pour la production.
Impact sur le secteur et sur Google Cloud
Lors de la conférence téléphonique, Kurian a précisé que les entreprises qui construisent des agents ont souvent besoin, en plus de l’invocation du modèle, de ressources de calcul, de services pour stocker la mémoire des agents et de bases de données pour leur fournir du contexte. L’adoption des modèles pourrait donc aussi stimuler la croissance d’autres produits cloud.
| Indicateur financier (T3 clos le 30 septembre 2026) | Valeur | Précisions |
|---|---|---|
| Chiffre d’affaires total d’Alphabet | 127,577 milliards de dollars, en hausse de 25 % sur un an | Ensemble du groupe |
| Chiffre d’affaires de Google Cloud | 30,709 milliards de dollars, en hausse de 103 % sur un an | Inclut l’infrastructure IA pour les entreprises, les solutions IA, les services GCP de base et les ventes de systèmes TPU |
| Résultat d’exploitation de Google Cloud | 11,121 milliards de dollars | Marge d’exploitation trimestrielle d’environ 36,2 % |
| Chiffre d’affaires propre à l’API Gemini | Non communiqué | Le chiffre d’affaires de Cloud ne peut pas lui être substitué |
Deux points méritent d’être soulignés. Les 30,7 milliards de dollars correspondent au chiffre d’affaires de l’ensemble de Google Cloud, et non à celui de l’API Gemini. Il n’est pas non plus possible d’estimer les revenus API de Google en multipliant 32 milliards de tokens par les tarifs publics de l’API : la répartition entre les modèles n’est pas connue, leurs prix diffèrent et les clients professionnels peuvent bénéficier de traitements par lots, de mise en cache, de contrats spécifiques et de remises.
Un piège chronologique à éviter
Le troisième trimestre financier d’Alphabet couvre la période du 1er juillet au 30 septembre 2026 ; Gemini 4 Argon a été officiellement lancé le 13 octobre 2026 ; le chiffre de 32 milliards de tokens par minute a été communiqué le 28 octobre. On ne peut donc pas considérer ces 32 milliards comme un débit moyen du troisième trimestre, et encore moins affirmer que la croissance de l’API sur l’ensemble du T3 a été principalement portée par Argon, lancé seulement en octobre. Une formulation plus prudente serait la suivante : le lancement d’Argon et le cap des 32 milliards de tokens illustrent ensemble les avancées de Google en matière de modèles et de développement commercial en octobre 2026.
Questions fréquentes (FAQ)
Q1 : Que signifie le chiffre de 32 milliards de tokens par minute pour les API Google ?
Il s’agit du débit global de traitement des API de modèles de Google, tel qu’indiqué par l’entreprise le 28 octobre 2026. Ce chiffre est exprimé en tokens, pas en nombre de requêtes, et ne correspond pas à l’usage d’un modèle Gemini en particulier ni de l’application Gemini.
Q2 : Qui contribue principalement à ces 32 milliards de tokens ?
Parmi les utilisateurs identifiés figurent plus de 9 millions de développeurs chaque mois, plus de 2 600 clients Gemini Enterprise ayant un usage élevé, ainsi que des déploiements d’agents dans la finance, l’industrie manufacturière, le commerce de détail et sur des sites industriels. Google n’a toutefois pas communiqué la part précise de chaque groupe, secteur ou modèle. Les données publiques ne permettent donc pas d’affirmer qu’une catégorie d’utilisateurs contribue à elle seule à la majeure partie du volume.
Q3 : Y a-t-il un lien entre ces 32 milliards de tokens et Gemini 4 Argon ?
Argon a été lancé le 13 octobre 2026, tandis que les 32 milliards correspondent au débit constaté le 28 octobre. Les deux s’inscrivent dans les avancées de Google au cours du mois d’octobre. Mais la période statistique du troisième trimestre s’est arrêtée le 30 septembre : on ne peut donc pas attribuer la croissance de tout le trimestre à Argon.
Q4 : Comment les développeurs peuvent-ils estimer la consommation de tokens de leur activité ?
La méthode la plus fiable consiste à effectuer des tests sur des échantillons réels, en relevant le champ `usage` renvoyé à chaque appel. Vous pouvez obtenir un crédit de test gratuit auprès d’APIYI sur apiyi.com, puis utiliser le code de cet article en définissant `base_url` sur `https://api.apiyi.com/v1`. Testez séparément les scénarios de texte, de documents longs et d’agents à plusieurs tours, puis estimez les coûts à partir des volumes prévus.
Q5 : Peut-on déduire les revenus API de Google à partir des 32 milliards de tokens ?
Non. La répartition entre les modèles, les prix réellement appliqués, les réductions liées au traitement par lots et à la mise en cache, ainsi que les contrats propres aux entreprises ne sont pas publics. Google n’a pas non plus communiqué les revenus et les bénéfices de Gemini API séparément.
Q6 : Quelles sont les limites connues des données disponibles sur cette actualité ?
Il y en a trois principales : l’absence de répartition par client, secteur et modèle ; l’absence de ventilation entre texte, image, vidéo et audio ; et l’absence de distinction entre les tokens d’entrée, de sortie et de raisonnement interne. Par ailleurs, les résultats des cas d’usage en entreprise proviennent tous de communications officielles de Google et n’ont pas été vérifiés de manière indépendante par des tiers.
Google API : les 32 milliards de tokens en bref
- Le chiffre clé : les API des modèles de Google traitent près de 32 milliards de tokens par minute, soit plus de quatre fois le volume d’il y a un an
- La croissance : le volume est passé d’environ 10 milliards à près de 32 milliards en un an environ
- Trois catégories d’utilisateurs : l’écosystème de développeurs, les clients professionnels de Gemini Enterprise et les déploiements d’agents dans différents secteurs
- Le fonctionnement des agents : les cycles répétés et l’accumulation du contexte multiplient la consommation de tokens pour une seule tâche
- Des indicateurs distincts : tokens, nombre de requêtes, licences, nombre de développeurs et revenus Cloud ne sont ni interchangeables ni additionnables
- La grande inconnue : Google n’a pas encore précisé la répartition de ces 32 milliards de tokens par client et par cas d’usage
- Conseil pratique : utilisez l’interface unifiée d’APIYI apiyi.com pour mesurer la consommation réelle de tokens de vos applications
En résumé
Voici ce qu’il faut retenir des 32 milliards de tokens par minute traités par les API de Google :
- L’échelle augmente rapidement : une croissance de plus de quatre fois en un an montre que l’invocation du modèle passe de l’expérimentation à une utilisation à grande échelle
- Les sources de demande sont identifiables : les développeurs, les clients professionnels et les agents déployés dans différents secteurs représentent tous des groupes à forte consommation
- Leur part reste inconnue : Google n’a pas publié de données détaillées ; reconnaître cette limite permet d’interpréter correctement les chiffres
- La valeur commerciale reste à suivre : la vraie question est de savoir quelle part de ces invocations se traduira par des applications professionnelles durables et rentables
Pour les développeurs, la leçon est directe : les agents et le multimodal rendront le budget de tokens encore plus important. Le choix des modèles et la gestion du contexte doivent donc être intégrés tôt dans la conception de l’architecture. Avec APIYI apiyi.com, vous pouvez utiliser une seule clé API pour comparer les résultats et la consommation de plusieurs modèles populaires avant de choisir la solution adaptée à vos besoins.
📚 Références
- Résultats financiers d’Alphabet pour le T3 2026 (SEC) : source primaire des données financières
- Lien :
sec.gov/Archives/edgar/data/1652044/000165204426000080/googexhibit991q32026.htm -
Contenu : chiffre d’affaires, chiffre d’affaires et bénéfice d’exploitation de Google Cloud
-
Déclaration du PDG de Google sur les résultats du T3 2026 : source du chiffre de 32 milliards de tokens par minute
- Lien :
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Contenu : chiffres clés et indicateurs officiels de croissance
-
Transcription de la conférence téléphonique d’Alphabet sur les résultats du T3 2026 : données et exemples de clients professionnels
- Lien :
fool.com/earnings/call-transcripts/2026/10/29/alphabet-googl-q3-2026-earnings-call-transcript/ -
Contenu : données sur Gemini Enterprise communiquées par Thomas Kurian
-
Déclaration du PDG de Google sur les résultats du T2 2026 : données sur les développeurs et les 22 milliards de tokens
- Lien :
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q2-2026/ -
Contenu : 9 millions de développeurs actifs par mois et données sur les utilisateurs actifs hebdomadaires d’Antigravity
-
Déclaration du PDG de Google sur les résultats du T1 2026 : données sur les 16 milliards de tokens
- Lien :
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q1-2026/ -
Contenu : jalon dans la chronologie de croissance
-
Présentation de Google aux investisseurs de juin 2026 : 19 milliards de tokens et utilisation des outils pour développeurs
- Lien :
blog.google/alphabet/investor-presentation-june-2026/ -
Contenu : plus de 3 000 milliards de tokens par jour pour les outils destinés aux développeurs
-
Google Cloud : Gemini at Work 2026 : exemples d’utilisation d’agents en entreprise
- Lien :
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Contenu : exemples de déploiement chez Hitachi et d’autres entreprises
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel d’APIYI. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.