
Note de l’auteur : décryptage des données d’usage de ChatGPT sur 165 catégories d’activités professionnelles publiées dans le cadre d’OpenAI Signals v3.0 — clarification du périmètre statistique et analyse de leur intérêt concret pour les développeurs et les applications d’IA en entreprise.
Le 26 octobre 2026, l’équipe de recherche économique d’OpenAI a publié « ChatGPT’s expanding world of work » (titre officiel en chinois : « L’univers professionnel de ChatGPT ne cesse de s’étendre »), qui rend publiques des données d’usage de ChatGPT couvrant près de 100 pays et régions, 165 catégories d’activités professionnelles et 7 trimestres consécutifs. Ce jeu de données s’inscrit dans le programme OpenAI Signals v3.0 et est téléchargeable gratuitement sous licence CC BY 4.0 : les chercheurs peuvent directement réutiliser les fichiers CSV pour des analyses secondaires.
Il ne s’agit pas de l’annonce d’un nouveau modèle ni d’une nouvelle fonctionnalité, mais d’un ensemble de données économiques sur les usages, destiné aux chercheurs. L’annonce officielle, le dictionnaire de données et les vérifications des médias tiers sur les CSV bruts sont désormais disponibles en parallèle, et les chiffres se recoupent. Cet article distingue clairement les conclusions officielles des calculs indépendants, pour éviter de confondre « part des messages » et « remplacement de postes ».
L’essentiel : comprendre en quelques minutes ce que mesurent réellement les données d’OpenAI sur les 165 catégories d’activités professionnelles, ce qu’elles révèlent, et ce qu’elles apportent concrètement aux développeurs d’applications d’IA.
Aperçu des informations clés sur les données d’OpenAI relatives à 165 catégories d’activités professionnelles
Commençons par un tableau qui pose les faits de base de cette publication sur l’usage de ChatGPT :
| Élément | Détail |
|---|---|
| Date de publication | 26 octobre 2026 |
| Émetteur | Équipe de recherche économique d’OpenAI (OpenAI Signals v3.0) |
| Système de classification | Activités professionnelles de niveau intermédiaire (IWA) de l’O*NET américain |
| Périmètre | Près de 100 pays et régions, 165 catégories d’activités professionnelles |
| Période couverte | Du premier trimestre 2025 au troisième trimestre 2026, soit 7 trimestres |
| Source des échantillons | Comptes personnels Free, Go, Plus et Pro, dont l’âge déclaré est de 18 ans ou plus |
| Exclusions | ChatGPT Enterprise, Codex, comptes supprimés, échantillons non autorisés pour l’entraînement |
| Licence des données | CC BY 4.0, consultation gratuite et téléchargement CSV, avec attribution |
Les 165 catégories d’activités professionnelles ne correspondent pas à 165 métiers
C’est l’erreur la plus courante quand on interprète ces données d’OpenAI. O*NET est une base de données d’information sur les métiers soutenue officiellement par les États-Unis. Elle décompose les « métiers » en plusieurs niveaux d’« activités professionnelles ». Par exemple, l’activité « réviser des documents écrits » apparaît aussi bien dans le travail d’un professionnel de l’édition que dans le quotidien d’un enseignant, d’un avocat, d’un ingénieur ou d’un professionnel de la finance.
OpenAI compte donc ce que les gens font avec ChatGPT, et non quels métiers utilisent ChatGPT. Les IWA (Intermediate Work Activities, activités professionnelles de niveau intermédiaire) se situent entre les grandes catégories de comportements au travail et les tâches très précises. Le référentiel O*NET en compte 332 au total.
OpenAI ne publie séparément que les activités courantes qui atteignent le seuil d’échantillon ; les activités peu fréquentes sont regroupées. D’après la vérification du CSV brut par PPC Land, le tableau public compte en réalité 164 catégories nommées plus 1 catégorie fusionnée « Other IWA », soit 165 résultats de classification. On ne peut donc pas dire qu’OpenAI a couvert de façon exhaustive les 332 catégories d’IWA.
Comment les données sont collectées et classées
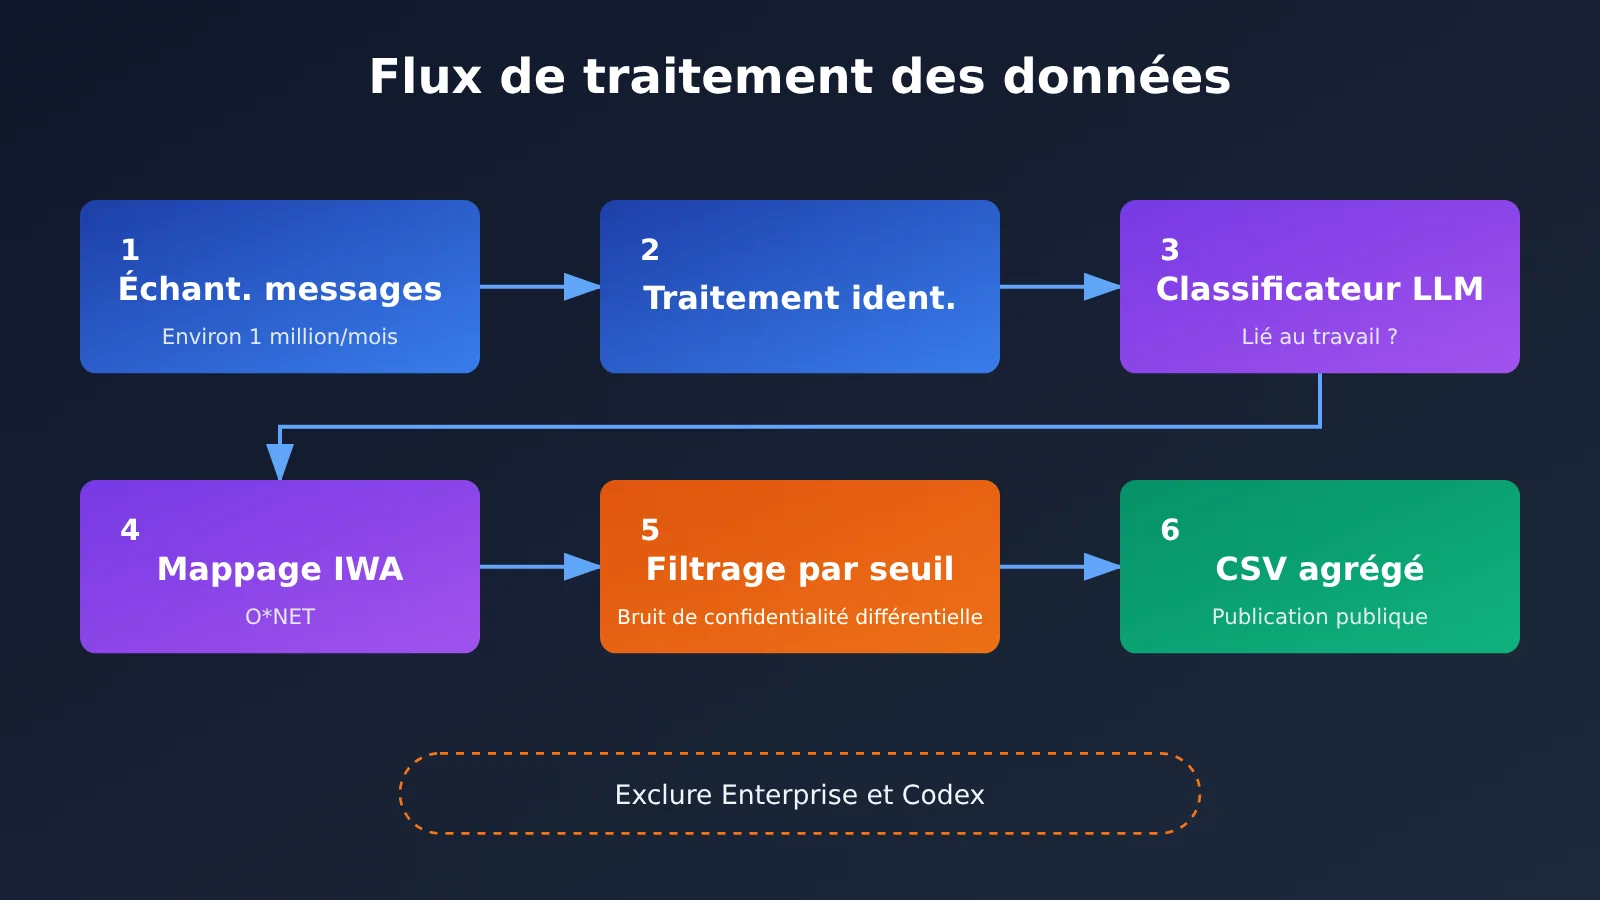
Signals v3.0 prélève chaque mois un échantillon d’environ 1 million de messages ChatGPT. Sur l’ensemble, la période va de juillet 2024 à septembre 2026, soit 27 mois, pour un total d’environ 27 millions d’échantillons classés. Attention : ces 27 millions correspondent à la somme des échantillons mensuels. Ce total ne correspond pas au nombre d’utilisateurs uniques et ne signifie pas non plus que tous les messages sont liés au travail.
La classification est réalisée par un classificateur automatisé à base de modèle de langage : il détermine d’abord si le message est lié au travail, puis le rattache à une activité professionnelle O*NET, en annotant également le thème, l’intention, la dimension temporelle et la région. En matière de confidentialité, OpenAI indique que les chercheurs ne lisent pas directement les conversations brutes : les informations d’identité sont traitées avant la classification, seuls des résultats agrégés sont publiés, les petits échantillons sont masqués et du bruit de confidentialité différentielle est ajouté. La répartition trimestrielle des activités professionnelles par pays n’est publiée que si l’on dispose d’au moins 1 000 messages valides.
La découverte la plus importante dans les données d’usage de ChatGPT : des usages professionnels plus dispersés
La conclusion phare publiée par OpenAI est la suivante : les particuliers utilisent ChatGPT pour un éventail de tâches professionnelles de plus en plus large. Dans les 74 pays et régions disposant d’un historique complet sur 7 trimestres, la part moyenne des dix principales catégories d’activités professionnelles — rapportée à l’ensemble des messages professionnels classés dans chaque pays — a nettement reculé.
| Période | Part moyenne des dix principales activités professionnelles par pays |
|---|---|
| Premier trimestre 2025 | 56,0 % |
| Troisième trimestre 2026 | 51,1 % |
| Variation | -4,9 points de pourcentage |
Deux précisions méthodologiques s’imposent ici. Premièrement, ces 51,1 % ne correspondent pas à la part d’un top 10 mondial unifié : on calcule d’abord le top 10 propre à chaque pays, puis on fait la moyenne sur les 74 pays — les dix premières catégories peuvent donc différer d’un pays à l’autre. Deuxièmement, une baisse de part ne signifie pas une baisse du volume de messages : si l’usage global progresse, le nombre absolu de requêtes sur les activités de tête peut très bien augmenter.
Autrement dit, davantage d’activités professionnelles « de longue traîne » captent une part plus importante. Et attention : les 74 pays et les près de 100 pays renvoient à deux échantillons de portée différente — il ne faut pas les confondre quand on cite ces chiffres.
Quelles activités professionnelles spécifiques sont les plus courantes
PPC Land a réalisé le 27 octobre 2026 un calcul indépendant à partir de l’ensemble des CSV publics, en établissant des statistiques pays par pays pour 74 pays puis en faisant la moyenne. Voici les six activités professionnelles nommées les plus fréquentes au troisième trimestre 2026 (calcul tiers, et non liste directement publiée par OpenAI) :
| Rang | Activité professionnelle | Part moyenne des messages sur 74 pays |
|---|---|---|
| 1 | Rédaction de documents ou de contenus écrits | 15,0 % |
| 2 | Création de visuels ou de contenus de présentation | 7,9 % |
| 3 | Élaboration de supports marketing ou promotionnels | 5,1 % |
| 4 | Explication d’informations linguistiques ou culturelles | 4,0 % |
| 5 | Préparation de supports d’information ou pédagogiques | 3,2 % |
| 6 | Programmation de systèmes informatiques ou d’équipements de production | 3,1 % |
La rédaction de documents reste l’usage professionnel le plus répandu, et le design visuel est désormais en deuxième position. Les contenus marketing, les supports pédagogiques et la compréhension interlangue répondent à des besoins bien réels, tandis que la programmation, malgré son importance, n’occupe pas la part la plus importante dans cet échantillon de comptes personnels.
Le design visuel progresse, la programmation recule
Selon les calculs de PPC Land, la part moyenne sur 74 pays de « création de visuels ou de contenus de présentation » est passée de 3,1 % au premier trimestre 2025 à 7,9 % au troisième trimestre 2026, soit une hausse de 4,8 points de pourcentage : c’est l’activité précise qui enregistre la plus forte progression parmi 165 catégories. Aux États-Unis, elle est passée de 2,4 % à 7,6 % sur la même période, et au troisième trimestre 2026, le Brésil atteint 11,2 % et l’Inde 8,7 %.
À l’inverse, « programmation de systèmes informatiques ou d’équipements de production » est passée de 7,8 % à 3,1 %, les États-Unis de 6,7 % à 2,4 %, tandis que l’Inde affiche encore 5,8 % au troisième trimestre 2026. Les activités connexes, comme la résolution de problèmes informatiques ou la recherche de conceptions techniques, reculent également. Une hypothèse raisonnable est que les développeurs se sont tournés vers des agents de programmation spécialisés comme Codex, mais les données elles-mêmes ne prouvent pas ce transfert. La formulation la plus prudente est donc la suivante : dans ces données qui excluent Codex et les comptes d’entreprise, la part des messages liés au travail de programmation baisse nettement.
Le marketing est un autre signal à surveiller. La part moyenne de « production de supports marketing ou promotionnels » passe de 5,2 % à 5,1 %, soit quasiment stable, l’Argentine, le Pakistan, le Nigeria et d’autres pays atteignant environ 9 % au troisième trimestre 2026. Autrement dit, si la part de la rédaction générale diminue, la demande de contenus marketing spécialisés reste stable.
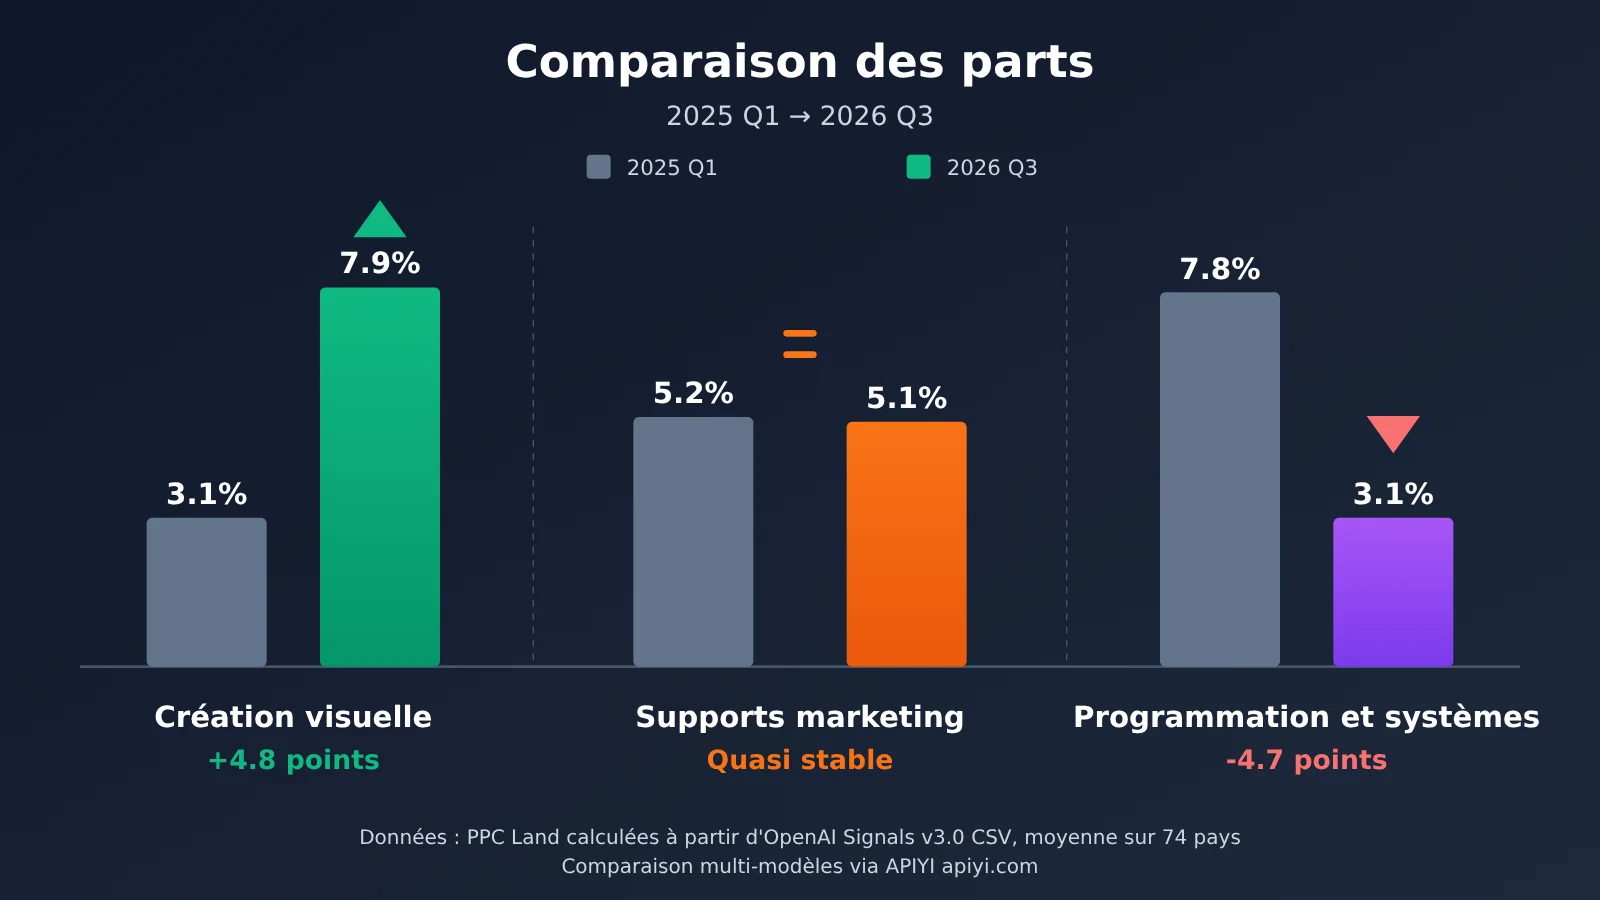
📊 Note sur le graphique : les données ci-dessus proviennent d’un recalcul par PPC Land des CSV publics d’OpenAI. Si vous voulez vérifier dans votre propre activité à quel modèle conviennent respectivement les requêtes de type « design », « rédaction » et « programmation », vous pouvez passer d’OpenAI à Claude, Gemini et autres modèles avec la même clé API via APIYI apiyi.com, et faire une comparaison à petite échelle.
Comparaison des structures de travail avec ChatGPT aux États-Unis et en Allemagne
PPC Land a également examiné, point par point, les catégories plus larges de « Generalized Work Activities » (activités professionnelles généralisées) dans les graphiques interactifs d’OpenAI — à noter qu’il ne s’agit pas du même niveau que les IWA mentionnés plus haut, et qu’on ne peut donc pas les mélanger. La mesure statistique correspond à la part des messages liés au travail dans chaque pays :
| Activité professionnelle générale | États-Unis Q1 2025 | États-Unis Q1 2026 | Allemagne Q1 2025 | Allemagne Q1 2026 |
|---|---|---|---|---|
| Prendre des décisions et résoudre des problèmes | 22,8 % | 21,6 % | 22,0 % | 19,4 % |
| Réflexion créative | 11,8 % | 15,6 % | 11,3 % | 13,1 % |
| Consigner des informations | 10,6 % | 11,8 % | 10,3 % | 11,4 % |
| Utiliser un ordinateur | 11,7 % | 6,7 % | 12,7 % | 8,4 % |
| Fournir des conseils et des recommandations | 5,5 % | 9,0 % | 7,1 % | 11,7 % |
| Expliquer des informations à autrui | 5,1 % | 4,0 % | 9,5 % | 8,6 % |
Dans les deux pays, « prendre des décisions et résoudre des problèmes » apparaît comme un usage majeur, et la part de la « réflexion créative » ainsi que des « conseils et recommandations » progresse nettement. Il s’agit là du type de requêtes formulées par les utilisateurs : cela ne signifie pas que ChatGPT prend seul des décisions commerciales, ni qu’il fournit des conseils d’expert validés.
Entre les pays, l’indicateur de différence de distribution transnationale (distance de variation totale) relevé par PPC Land est passé d’environ 22,2 % à environ 23,0 %. OpenAI reconnaît d’ailleurs que ces écarts peuvent provenir de la structure du travail, de la langue et de la culture, de la disponibilité des outils ou encore des habitudes d’usage — les données actuelles ne suffisent pas à établir un lien de causalité.
Analyse de l’impact des données sur 165 catégories d’activités professionnelles pour les développeurs
Impact sur les développeurs d’applications IA
- Des besoins qui s’élargissent : les utilisateurs ne se contentent plus de modifier des documents avec ChatGPT ; le design visuel, le marketing, le matériel pédagogique et les conseils représentent désormais une part non négligeable des usages. Les outils IA mono-fonction doivent donc prendre en compte des scénarios multi-tâches.
- Le multimodal gagne en importance : le design visuel est l’activité qui progresse le plus. Sur la même période, le thème « multimédia » est passé de 2,0 % à 8,8 % de l’ensemble des messages personnels (calcul de PPC Land). Les capacités d’image méritent donc d’être intégrées à la feuille de route produit.
- La programmation évolue vers des usages spécialisés : la part des messages liés à la programmation dans les chats généralistes diminue. Les besoins de développement assisté par invite se déroulent probablement davantage dans des agents dédiés ou des environnements d’entreprise ; mieux vaut les prendre en charge avec des modèles de code et des workflows spécialisés.
- Une méthode de classification réutilisable : OpenAI utilise un classificateur LLM pour mapper les messages à un référentiel de tâches standard. Cette approche peut aussi s’appliquer à l’analyse des journaux de votre propre produit.
Impact sur le déploiement de l’IA en entreprise
Les données des comptes personnels ne représentent pas l’usage en entreprise. Une autre analyse d’OpenAI, Enterprise Signals, montre qu’en juin 2026, parmi les clients entreprises étudiés, Codex représentait 64 % des tokens de sortie combinés de ChatGPT et Codex. Cela signifie que la structure d’usage côté entreprise peut être très différente de celle des comptes personnels. Pour évaluer une solution d’IA interne, mieux vaut se baser sur ses propres journaux de tâches plutôt que d’appliquer directement les données personnelles de Signals.
🚀 Démarrage rapide : si vous voulez, comme OpenAI, étiqueter les requêtes métier de votre entreprise par « activité professionnelle », je vous conseille de prototyper rapidement avec APIYI apiyi.com. La plateforme propose une interface compatible OpenAI, les nouveaux utilisateurs disposent d’un quota de test gratuit, et vous pouvez faire tourner l’exemple ci-dessous en quelques minutes.
Reproduire l’approche de « classification des activités professionnelles » avec l’API
Voici un exemple minimal : utiliser un grand modèle de langage pour classer une requête utilisateur dans quelques étiquettes d’activité professionnelle. Le principe est le même que celui du classificateur d’OpenAI (les étiquettes sont simplifiées, elles ne reprennent pas la taxonomie complète O*NET) :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d’APIYI
)

labels = "rédaction de documents, design visuel, marketing, explication linguistique, supports pédagogiques, programmation, analyse décisionnelle, autre"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"Choisis une seule étiquette parmi [{labels}] pour décrire cette demande professionnelle, et n’affiche que l’étiquette : rédige-moi un post WeChat pour le lancement d’un nouveau produit"}]
)
print(resp.choices[0].message.content)
Voir le code complet pour la classification par lot et le calcul des parts
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Une seule clé permet de changer de modèle
)

LABELS = ["rédaction de documents", "design visuel", "marketing", "explication linguistique",
          "supports pédagogiques", "programmation", "analyse décisionnelle", "non professionnel", "autre"]

SYSTEM = (
    "Tu es un classificateur d’activités professionnelles. Détermine d’abord si la demande est liée au travail, "
    f"puis choisis une seule étiquette parmi : {', '.join(LABELS)}. N’affiche que l’étiquette elle-même."
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "autre"
    except Exception as e:
        print(f"Error: {e}")
        return "autre"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "non professionnel"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "Peux-tu polir ce rapport trimestriel ?",
        "Donne-moi des idées de composition pour une série d’affiches d’événement",
        "Pourquoi ce code Python n’arrive-t-il pas à lire les données ?",
        "Où est-ce qu’on peut camper ce week-end ?",
    ]
    print(activity_share(logs))
Comme dans la méthode d’OpenAI, cette classification automatique peut se tromper, et une tâche peut aussi être découpée en plusieurs messages. La « part des messages » calculée ne correspond donc pas directement à la charge de travail ni à la valeur métier.
Référence pour le choix du modèle selon l’activité professionnelle
En s’appuyant sur les activités les plus représentées dans les données, on peut esquisser un premier choix selon le type de tâche — les résultats concrets restant à vérifier sur vos propres données :
| Activité professionnelle | Compétence clé | Piste de sélection | Plateformes disponibles |
|---|---|---|---|
| Rédaction et édition de documents | Compréhension et reformulation de texte | Modèle conversationnel généraliste au bon rapport qualité-prix | APIYI apiyi.com, API officielle |
| Design visuel et présentation | Génération et compréhension d’images | Modèle multimodal / d’images | APIYI apiyi.com, API officielle |
| Supports marketing et promotion | Créativité et maîtrise du style | Modèle phare au style d’écriture stable | APIYI apiyi.com, API officielle |
| Programmation et débogage | Raisonnement sur le code | Modèle à forte capacité de code ou agent spécialisé | APIYI apiyi.com, API officielle |
| Décision et conseil | Raisonnement sur contexte long | Modèle de raisonnement, avec relecture humaine | APIYI apiyi.com, API officielle |
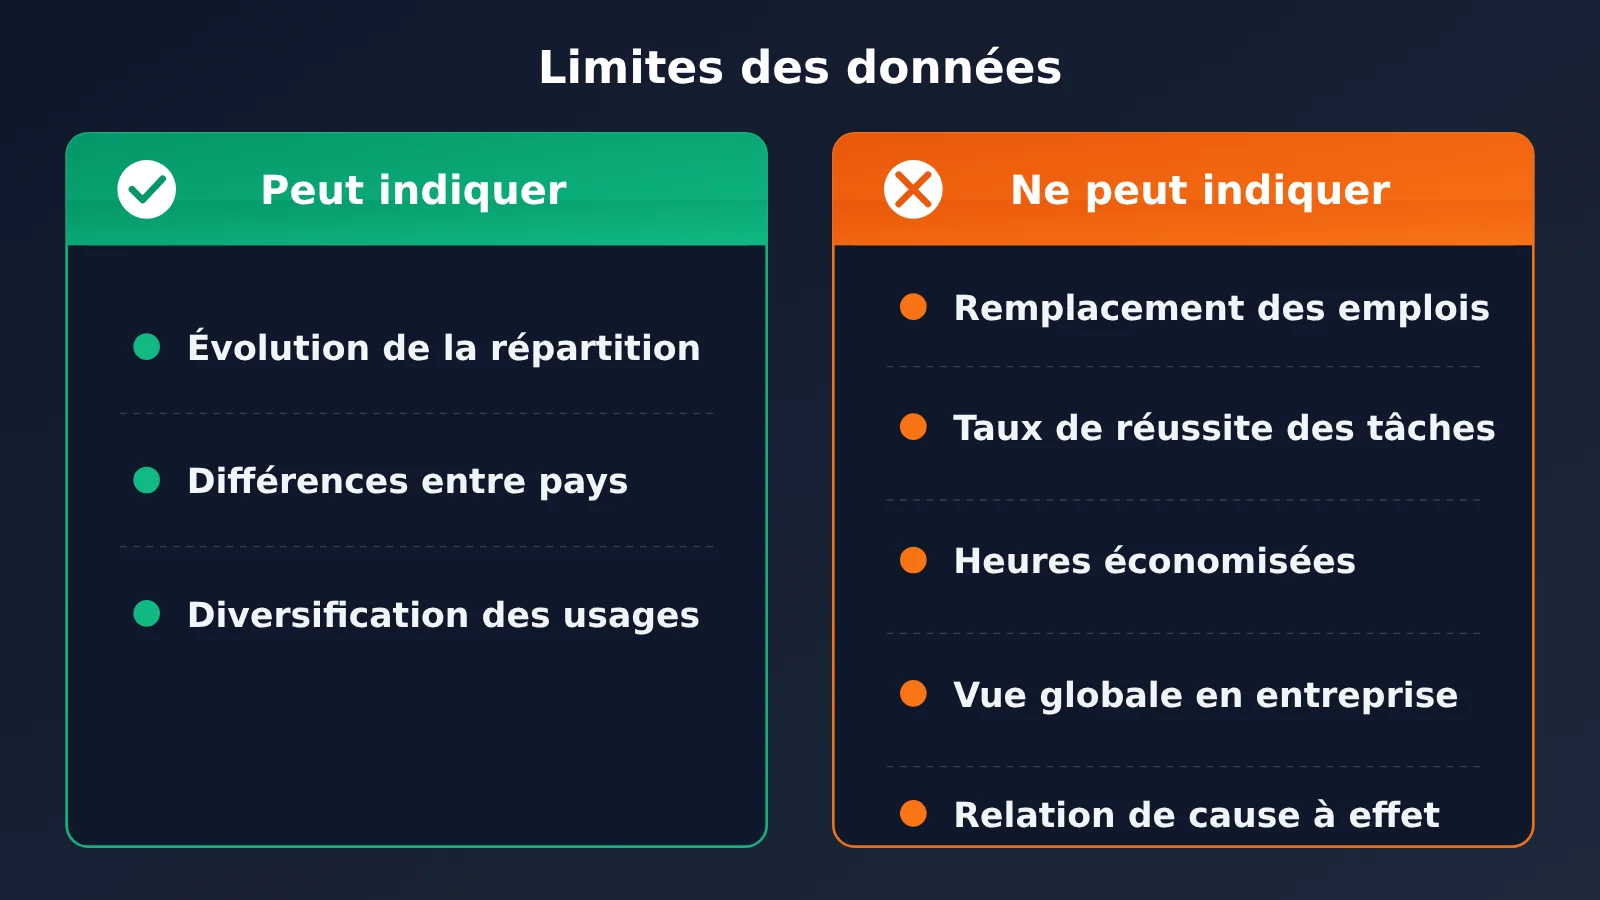
Les limites des données OpenAI sur 165 catégories d’activités professionnelles
Ces données ont une vraie valeur, mais leurs limites sont tout aussi nettes. Voici les points à garder en tête avant de les citer :
- L’échantillon ne contient que des comptes personnels d’adultes : Enterprise et Codex sont exclus, il ne peut donc pas représenter l’ensemble des usages professionnels des produits OpenAI pour les entreprises.
- La classification est automatique : un classificateur LLM peut se tromper sur l’intention — « concevoir un plan de communication pour un événement » peut relever d’un vrai travail marketing comme d’un simple intérêt personnel.
- La part de messages ne correspond pas à la production : elle ne dit rien du nombre de tâches, du temps de travail, du nombre d’utilisateurs, des heures gagnées ni du taux de réussite.
- Bruit de confidentialité et seuils d’échantillon : les résultats sur petits échantillons sont masqués, et du bruit de confidentialité différentiel est ajouté.
- Pas de correspondance exacte avec l’économie réelle : pondérée par le nombre d’emplois, environ 43 % des activités professionnelles réelles aux États-Unis tombent dans la catégorie « Other IWA ». Cela ne signifie ni que 43 % des emplois ne peuvent pas être réalisés par l’IA, ni que les 57 % restants sont déjà couverts par ChatGPT.
Par ailleurs, les calculs de PPC Land montrent que la proportion de messages personnels étiquetés comme liés au travail est passée d’environ 51,6 % en juillet 2024 à environ 32,2 % en septembre 2026. Cela s’explique plus probablement par l’arrivée massive d’utilisateurs non professionnels et par le transfert d’une partie du travail spécialisé vers des comptes entreprise et des agents dédiés — on ne peut donc pas en conclure que ChatGPT perd de son importance pour le monde du travail.
FAQ – Questions fréquentes
Q1 : Que sont les données sur les 165 catégories d’activités professionnelles publiées par OpenAI ?
Il s’agit d’un jeu de données agrégées rendu public dans le cadre du programme OpenAI Signals v3.0. Il associe les messages liés au travail des utilisateurs particuliers de ChatGPT aux 165 catégories d’activités professionnelles de niveau intermédiaire de l’O*NET, couvrant près de 100 pays et régions, sur 7 trimestres allant du premier trimestre 2025 au troisième trimestre 2026. Le fichier CSV est téléchargeable gratuitement.
Q2 : Quelle est la différence entre les 165 catégories d’activités professionnelles et les 165 métiers ?
Une activité professionnelle, c’est « ce qu’on fait » ; un métier, c’est « le poste qu’on occupe ». Une même activité (rédiger un document, par exemple) peut apparaître dans plusieurs métiers. Ces données décrivent donc les types de tâches pour lesquelles ChatGPT est utilisé, et non le taux d’utilisation par métier. On ne peut surtout pas en déduire quels métiers seront remplacés.
Q3 : Quand ces données ont-elles été publiées, et seront-elles mises à jour ?
OpenAI les a publiées le 26 octobre 2026, avec des données arrêtées au troisième trimestre 2026. L’éditeur suit les évolutions trimestre par trimestre ; la poursuite éventuelle des mises à jour dépendra des annonces publiées sur la page de données OpenAI Signals. Cet article ne fait aucune supposition à ce sujet.
Q4 : La baisse de la part des messages liés à la programmation signifie-t-elle que le besoin d’IA pour coder recule ?
On ne peut pas en tirer cette conclusion. Ces données excluent Codex et les comptes entreprise, alors qu’Enterprise Signals montre une part très élevée de tokens de sortie produits par Codex côté entreprise. Le besoin de programmation a peut-être migré vers des agents spécialisés, ou cela peut refléter un changement dans la structure des utilisateurs : les données seules ne permettent pas de trancher.
Q5 : Comment reproduire une analyse de classification par activité professionnelle avec l’API ?
Vous pouvez vous appuyer sur l’exemple de code de cet article pour étiqueter vos propres requêtes utilisateur avec un grand modèle de langage, puis calculer les proportions :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et récupérer une clé API
2. Profitez du crédit de test gratuit réservé aux nouveaux utilisateurs
3. Dans le code, définissez base_url sur `https://api.apiyi.com/v1` pour comparer les résultats de classification de différents modèles
Q6 : Existe-t-il un moyen simple de comparer différents modèles sur des tâches de design, de rédaction ou de programmation ?
Le plus simple reste d’appeler plusieurs modèles via une interface unifiée, de faire tourner le même lot d’invites, puis d’évaluer manuellement. Avec APIYI apiyi.com, une seule clé API suffit pour appeler OpenAI, Claude, Gemini et d’autres modèles, avec facturation à l’usage : parfait pour ce genre d’expérimentation comparative à petite échelle.
Points clés des données OpenAI sur 165 catégories d’activités professionnelles
- On mesure des activités, pas des métiers : les 165 catégories correspondent aux activités professionnelles O*NET, avec une catégorie « autre » qui regroupe plusieurs cas.
- Des usages plus dispersés : dans les 74 pays étudiés, la part moyenne des dix activités les plus fréquentes passe de 56,0 % à 51,1 %.
- Le design visuel progresse le plus : selon des calculs indépendants, sa part grimpe de 3,1 % à 7,9 %.
- Le poids du code recule, mais à interpréter avec prudence : l’échantillon exclut Codex et les comptes entreprise.
- La demande marketing reste stable : la part des supports de promotion et de communication tourne autour de 5 %.
- La part des messages ne mesure pas la production : on ne peut en déduire ni remplacement de postes, ni gain de temps, ni taux de réussite.
- La méthode de classification est réutilisable : avec l’interface multi-modèles d’APIYI apiyi.com, on peut monter rapidement sa propre analyse de classification des tâches.
En résumé
L’essentiel des données OpenAI sur l’usage de ChatGPT pour 165 catégories d’activités professionnelles :
- Nature des données : un jeu de données de recherche ouvert et gratuit, suivi chaque trimestre, qui recense « quelles activités professionnelles les gens réalisent avec ChatGPT » sur des comptes personnels.
- Principaux constats : les usages professionnels se diversifient, le design visuel, le conseil et la réflexion créative progressent, tandis que la part des messages de programmation générale recule.
- Limites d’interprétation : les données n’incluent ni les comptes entreprise ni Codex ; la part des messages ne équivaut pas à un volume de travail, à un impact sur l’emploi ou à une valeur économique.
Ce que ces données révèlent vraiment, ce n’est pas la liste des 165 métiers qui vont disparaître, mais la façon dont l’IA s’installe dans les flux de travail, de manière plus fine et plus variée, avec des différences selon les pays et les types de tâches. Pour un développeur, plutôt que de se demander « qui l’IA va remplacer », mieux vaut regarder quelles activités les utilisateurs confient réellement à l’IA, puis choisir le bon modèle et le bon workflow pour ces activités.
Nous vous recommandons de vérifier rapidement, via APIYI apiyi.com, les performances des différents modèles dans votre contexte métier : la plateforme offre un crédit de test gratuit et une interface unifiée pour plusieurs modèles.
📚 Références
- Annonce officielle d’OpenAI : ChatGPT’s expanding world of work : source principale de cette publication
- Lien :
openai.com/index/chatgpt-expanding-world-of-work -
Contenu : 165 catégories d’activités, près de 100 pays, conclusions officielles sur l’évolution de 56,0 % à 51,1 %, etc.
-
Téléchargement des données OpenAI Signals et méthodologie : point d’entrée vers les CSV bruts et le dictionnaire de données
- Lien :
openai.com/signals/data-download -
Contenu : précisions sur la portée de l’échantillon, le traitement de la confidentialité et la licence CC BY 4.0
-
PPC Land : L’écriture passe de 34 % à 21 % des requêtes ChatGPT depuis juillet 2024 : analyse de CSV par un tiers
- Lien :
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
Contenu : classement détaillé des activités, évolution de la part du design visuel et de la programmation
-
PPC Land : Les Américains utilisent surtout ChatGPT au travail pour prendre des décisions : lecture des graphiques croisés États-Unis / Allemagne
- Lien :
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
Contenu : données comparatives par pays pour les activités professionnelles au sens large
-
Site officiel O*NET : système de classification des activités professionnelles et des métiers
- Lien :
onetcenter.org -
Contenu : pour comprendre la définition des IWA et les 332 entrées de référence
-
OpenAI Enterprise Signals : données d’utilisation des comptes d’entreprise
- Lien :
openai.com/signals/enterprise-data - Contenu : pour distinguer les périmètres de données des particuliers et des entreprises
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com




